从 SOLO 挑战赛的 3300+ 提交作品来看,TRAE 已经帮大家打通了“从念头到产品”的开发闭环。但随之而来的新痛点是:产品或游戏做出来了,没有用户怎么办?该怎么推广?
在众多社媒平台中,我强烈建议将“小红书”作为首选的推广阵地(不是针对其他平台,而是确实分发机制不同)。虽然小红书的审核红线相对严格,但它的自然流推荐机制对“低粉新号”极其友好,这也是我专门针对小红书开发这个内容审核 Skill 的核心初衷。
Skill 地址:xiaohongshu-content-checker
既然是要帮大家写千赞笔记,那我还是先展示一下我之前通过摸爬滚打优化出的笔记成绩:
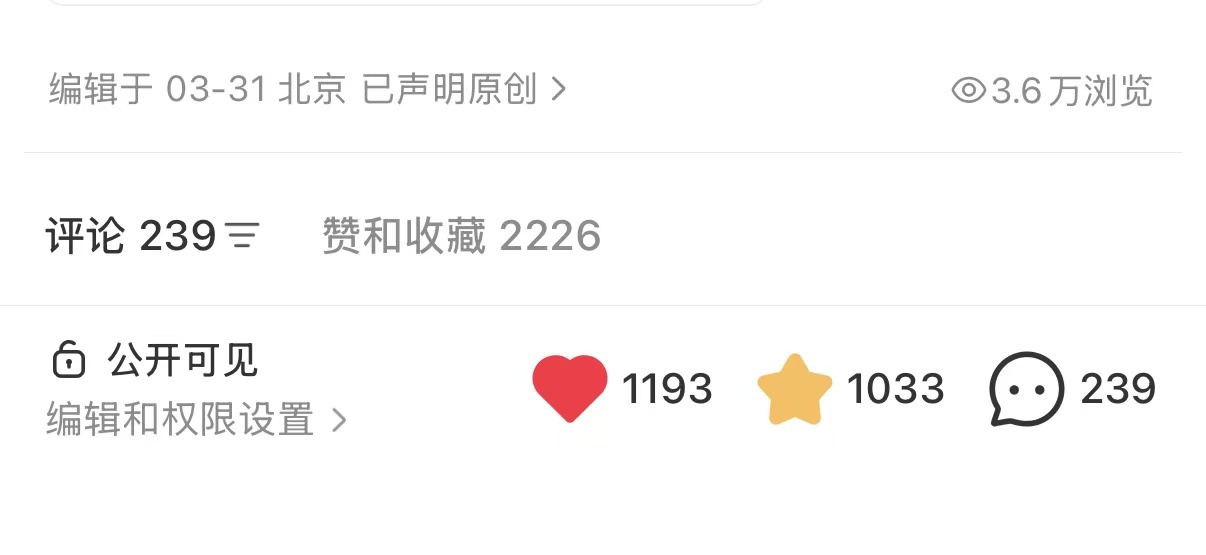
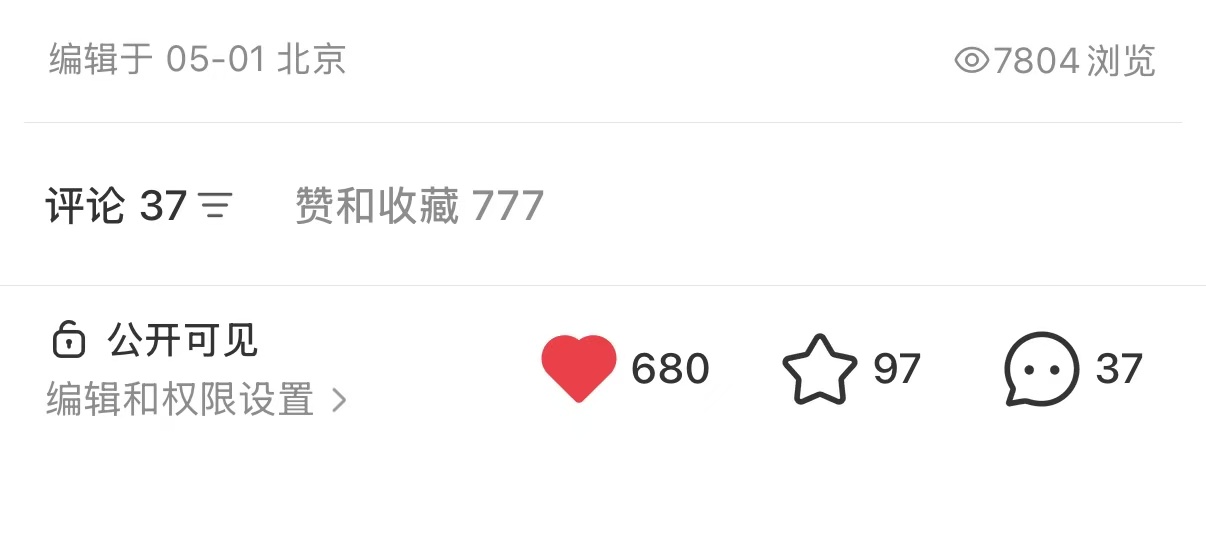
这些笔记也一定程度上持续为我的小程序带来客观的新增用户,虽然已经很久没有更新了,但是总用户数也来到了 3.6w。(300 日访问页面数 5000,你就说大家爱不爱玩吧)
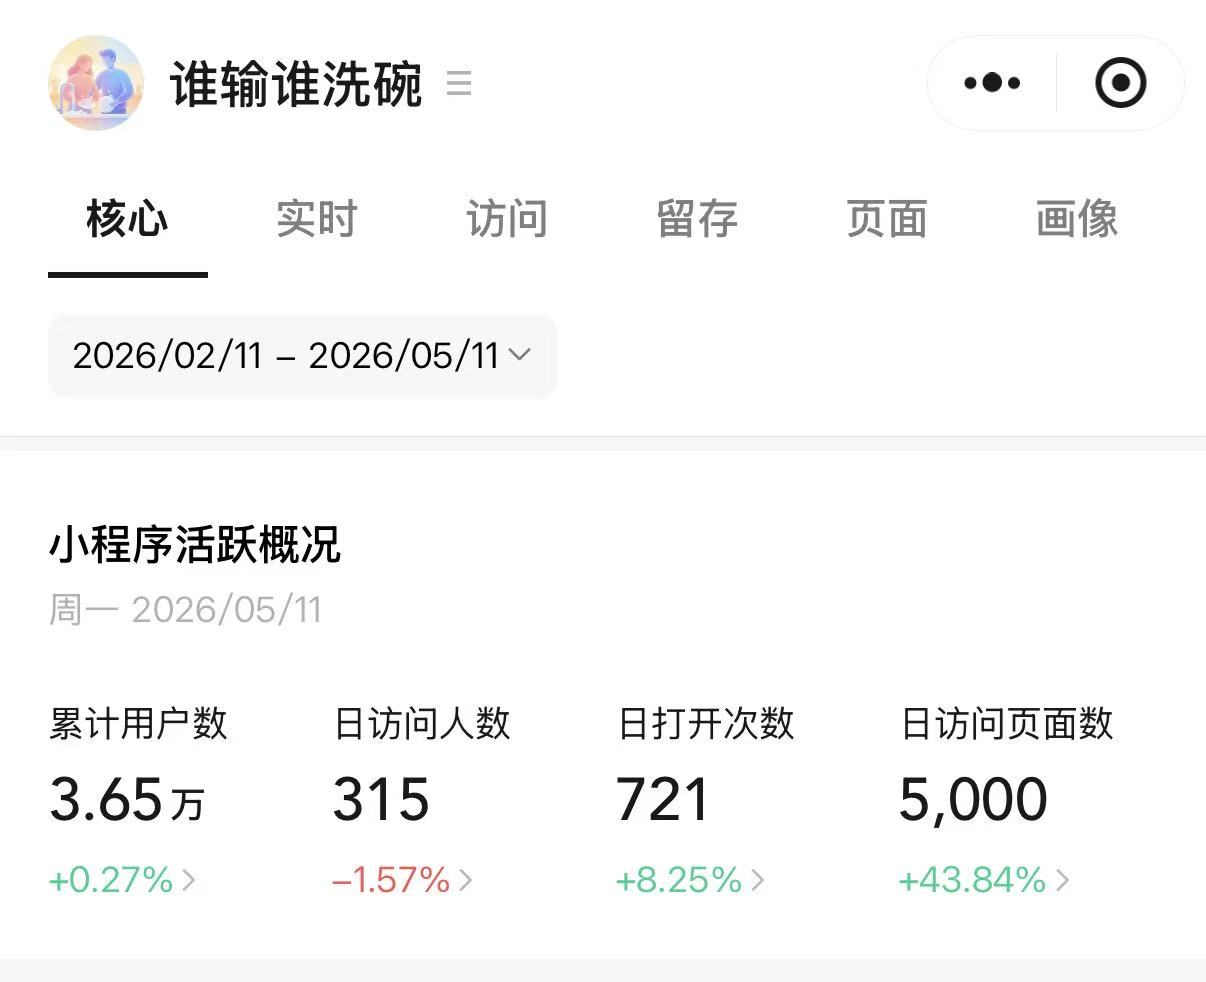
从我个人近两个月的经历来看,其实各个平台对于外部引流都有着非常严格的限制和处罚力度,很容易导致像我一样被封号处罚,除了外链之外,其实一些限定的词语,我们日常使用可能觉得没有什么,但在平台当前普遍机审的背景下,如果不注意就很容被限流,导致精心准备的内容打了水漂…
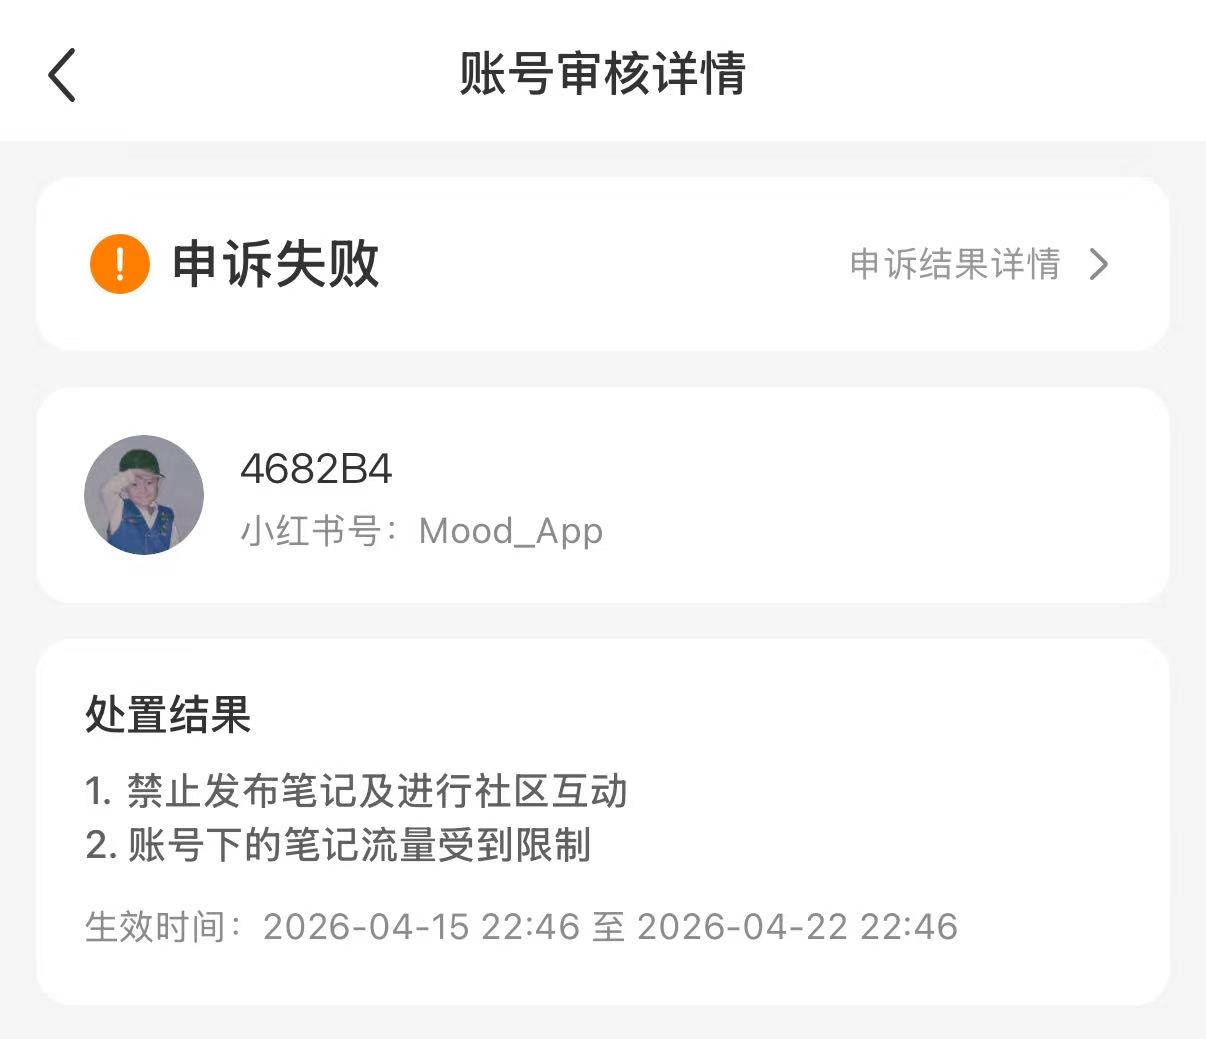
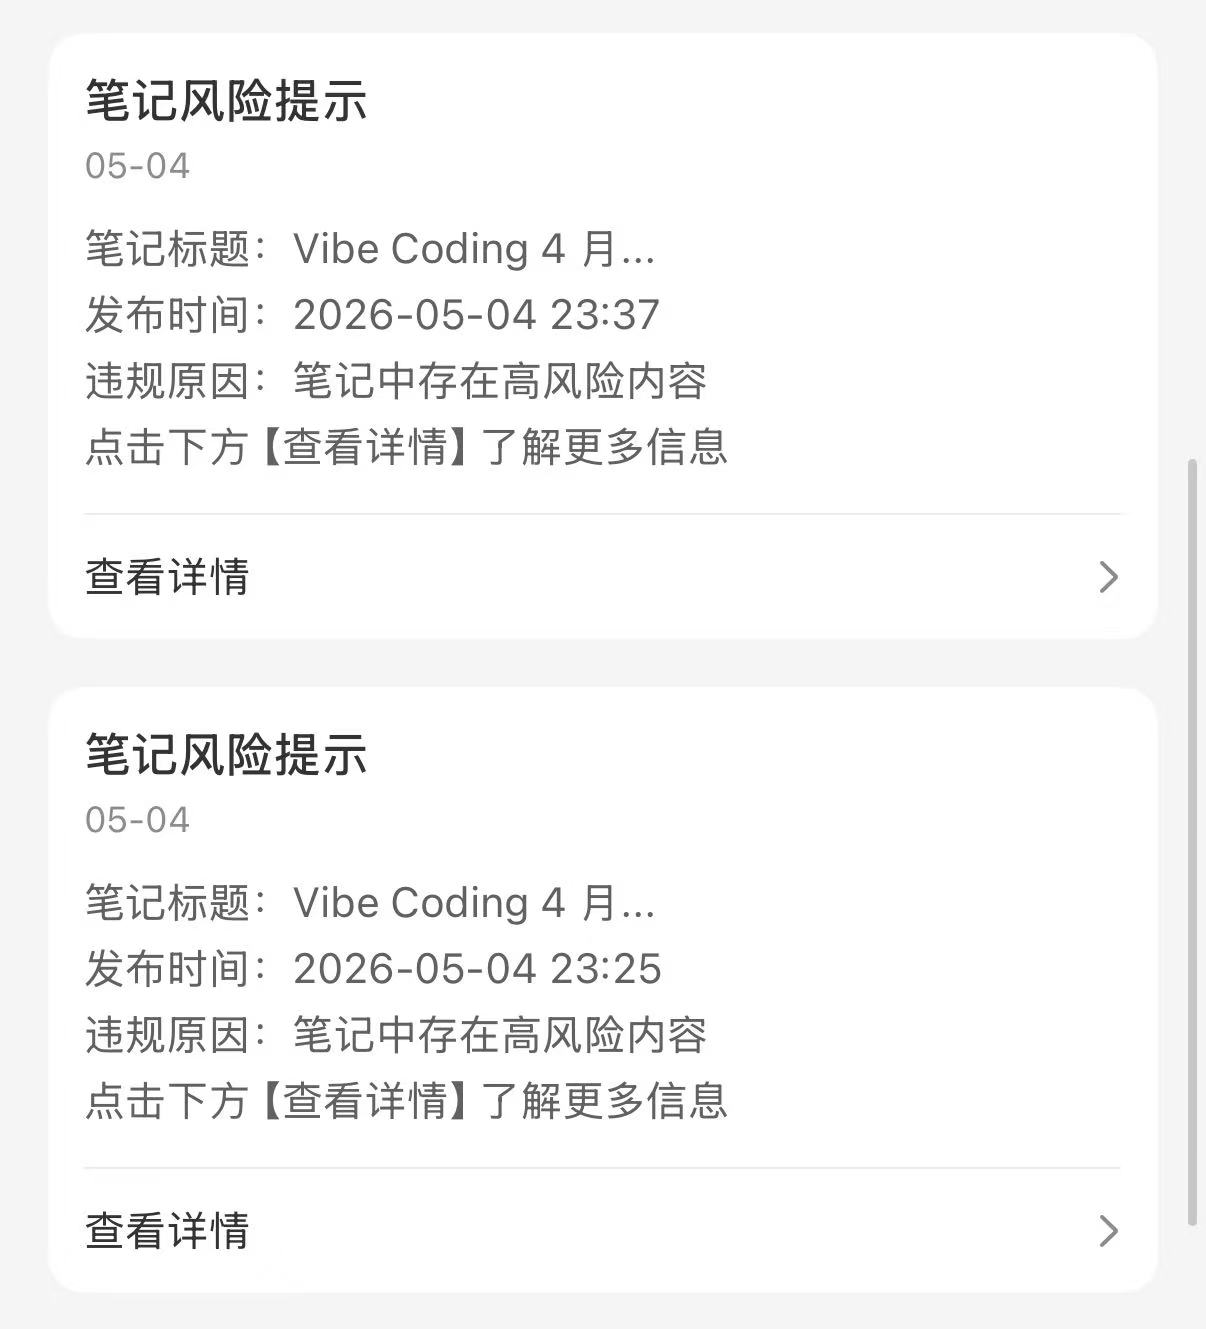
所以作为近两月有着多篇上万阅读和千赞笔记的小红书博主(最近确实发得少了,都在水论坛),我结合我自身与小红书审核申诉的历程,同时借鉴了最近比较火的 github 开源项目 andrej-karpathy-skills 的框架,搭建了这个小红书笔记敏感词检测与内容定位分析 Skill
Skill 简介
Skill 定位:小红书笔记文案敏感词检测与内容定位分析工具。
主要功能:检测敏感词、违禁词、极限用语,分析账号定位与内容匹配度,识别影响自然流的因素,提供针对性的优化建议。当用户需要检查小红书笔记合规性、避免限流、优化内容定位、提升自然流量时使用。
使用场景
其实就我个人体验来说,小红书的自然流受到非常多的因素影响,很多朋友在用一些付费的小红书笔记敏感词工具调整之后,流量也没有很明显的提升。
同时如果被官方限流,也仅仅是给你一个笔记风险提示而已,并不会直接指出你具体是封面有问题还是笔记内容有问题,这就导致你原本定时发布的笔记,在频繁修改调整审核之后,及时最后合规,也已经错过了最好的发布时间,同时因为频繁修改,也会被官方降权,导致传播效果大打折扣。
所以基于以上这类问题,以及我个人的实际的笔记经验总结,单纯的敏感词检验并不能根本性的解决笔记被限流的问题,而是应该采用"先定位、后检测、再优化"的标准工作流,给出结合官方内容的专业修改建议。
创作过程
第一步,开启任务
由于我希望借鉴 andrej-karpathy-skills 的结构,所以我在项目一开始就对做了说明。
这个 Skill 之所以极受欢迎,是因为它将 AI 巨头 Andrej Karpathy 对大模型辅助编程缺陷的深刻洞察,提炼成了极简且直击痛点(如 AI 爱瞎猜、过度设计、乱改无辜代码)的四条强约束原则,以最低的成本(一个单文件)极大地提升了 AI 编程的可靠性和可用性。
具体大家可以参考:andrej-karpathy-skills
我在使用 AI 直接对笔记内容调整的时候其实也有以上提到的问题,所以也是用 Skill 来进行约束的必要性。
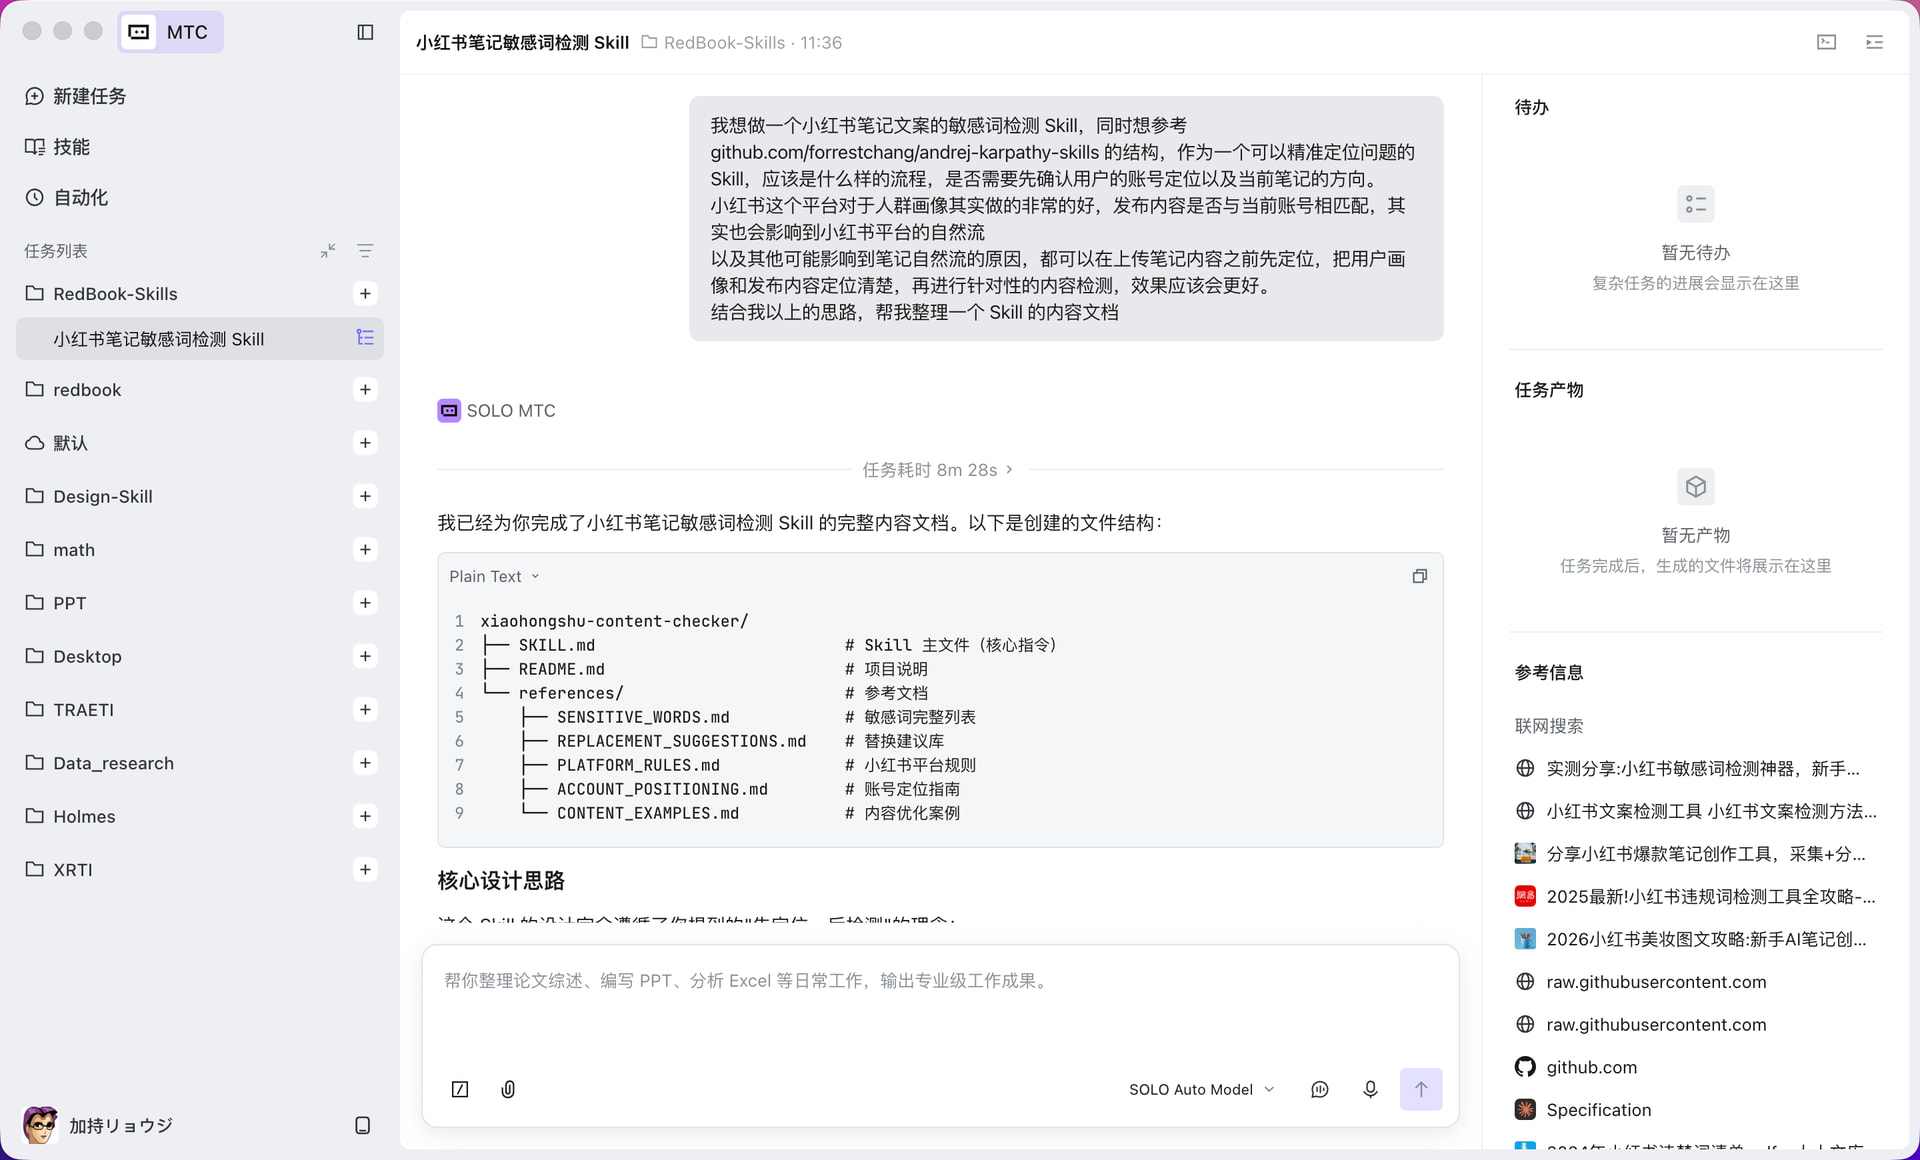
首先因为我对这个 Skill 的功能已经有了一个很详细的预设,所以我这里在 MTC 模式里直接输出了一个比较详细的 Prompt 让 SOLO 来启动项目
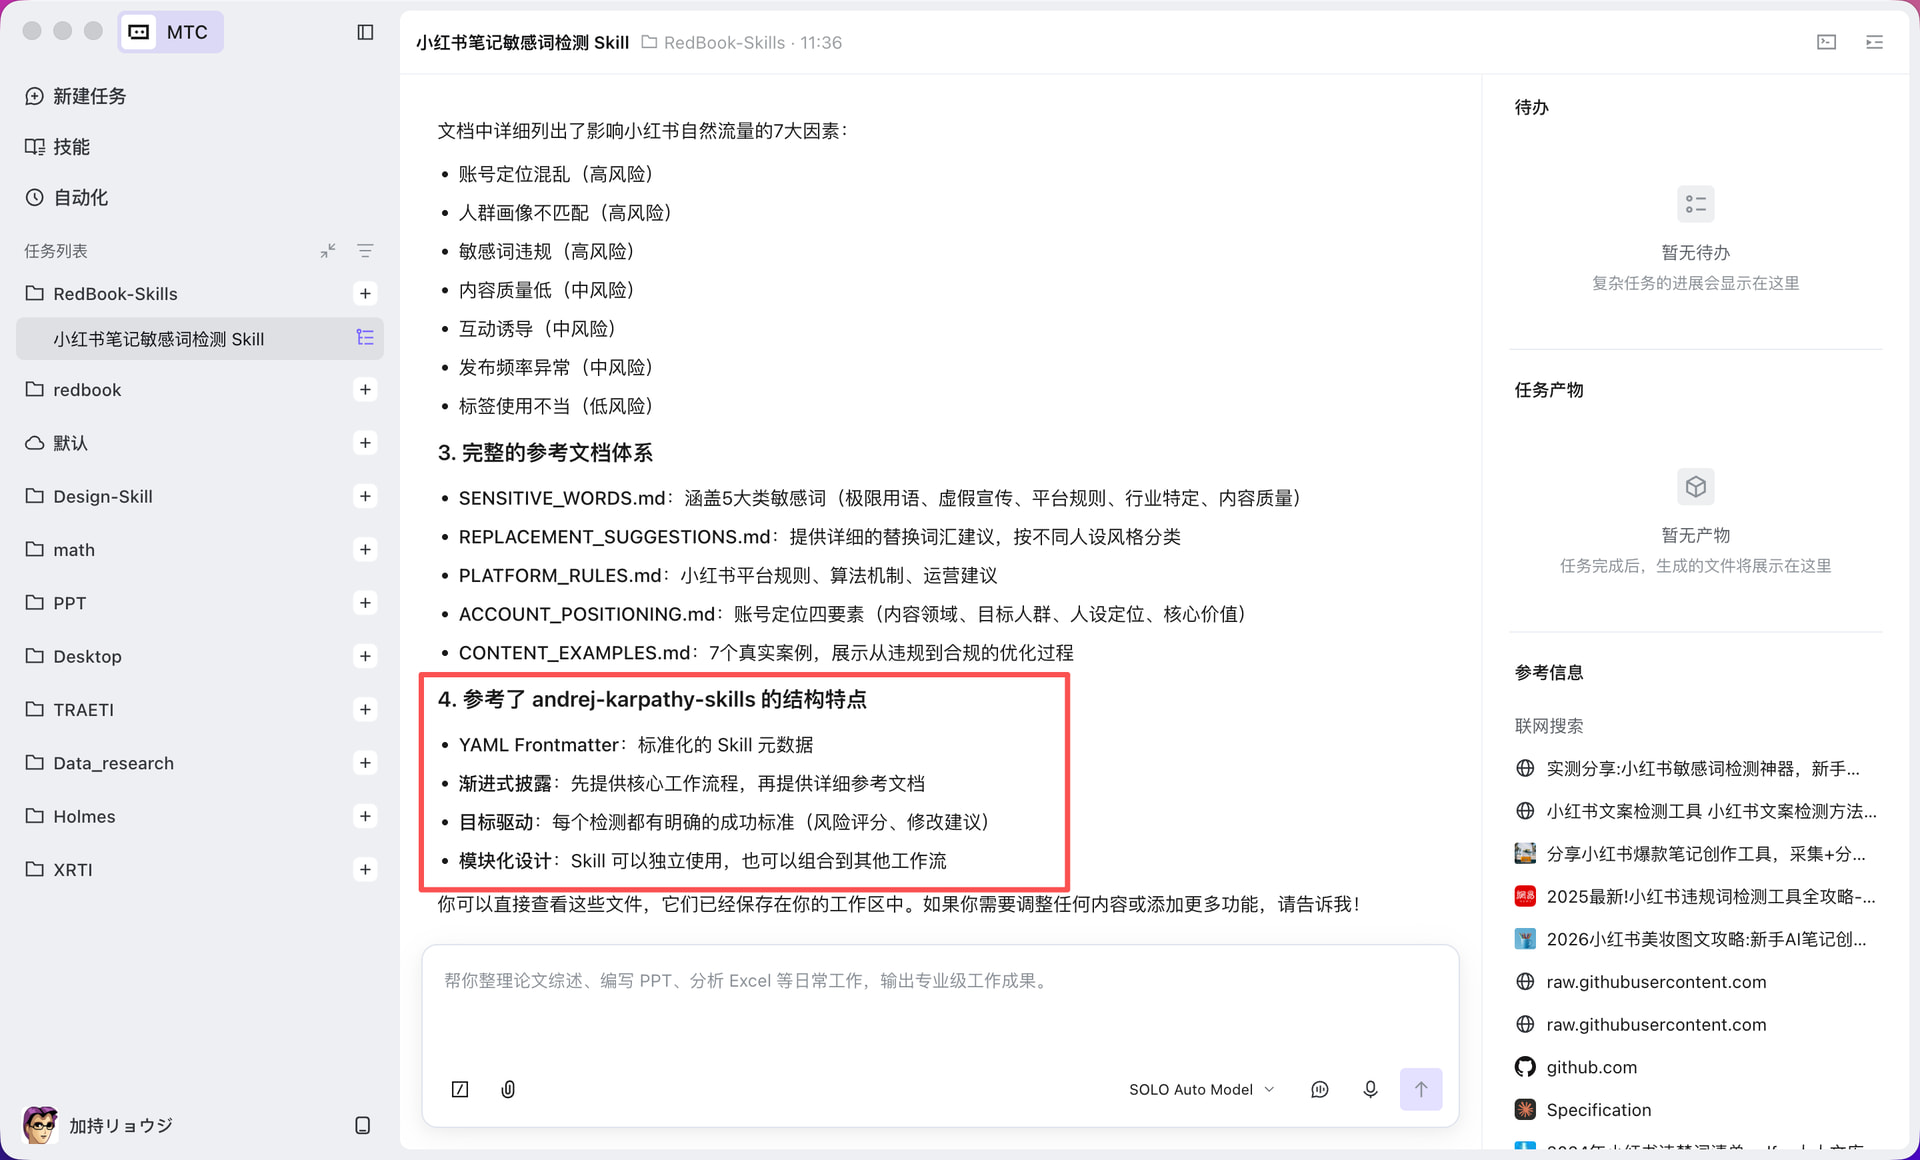
第一步执行完成后可以看到 SOLO 已经创建好了文件结构,同时在我框选的位置大家也可以看到整体的结构也参考了我引用的 github 项目。
第二步,交叉验证方案
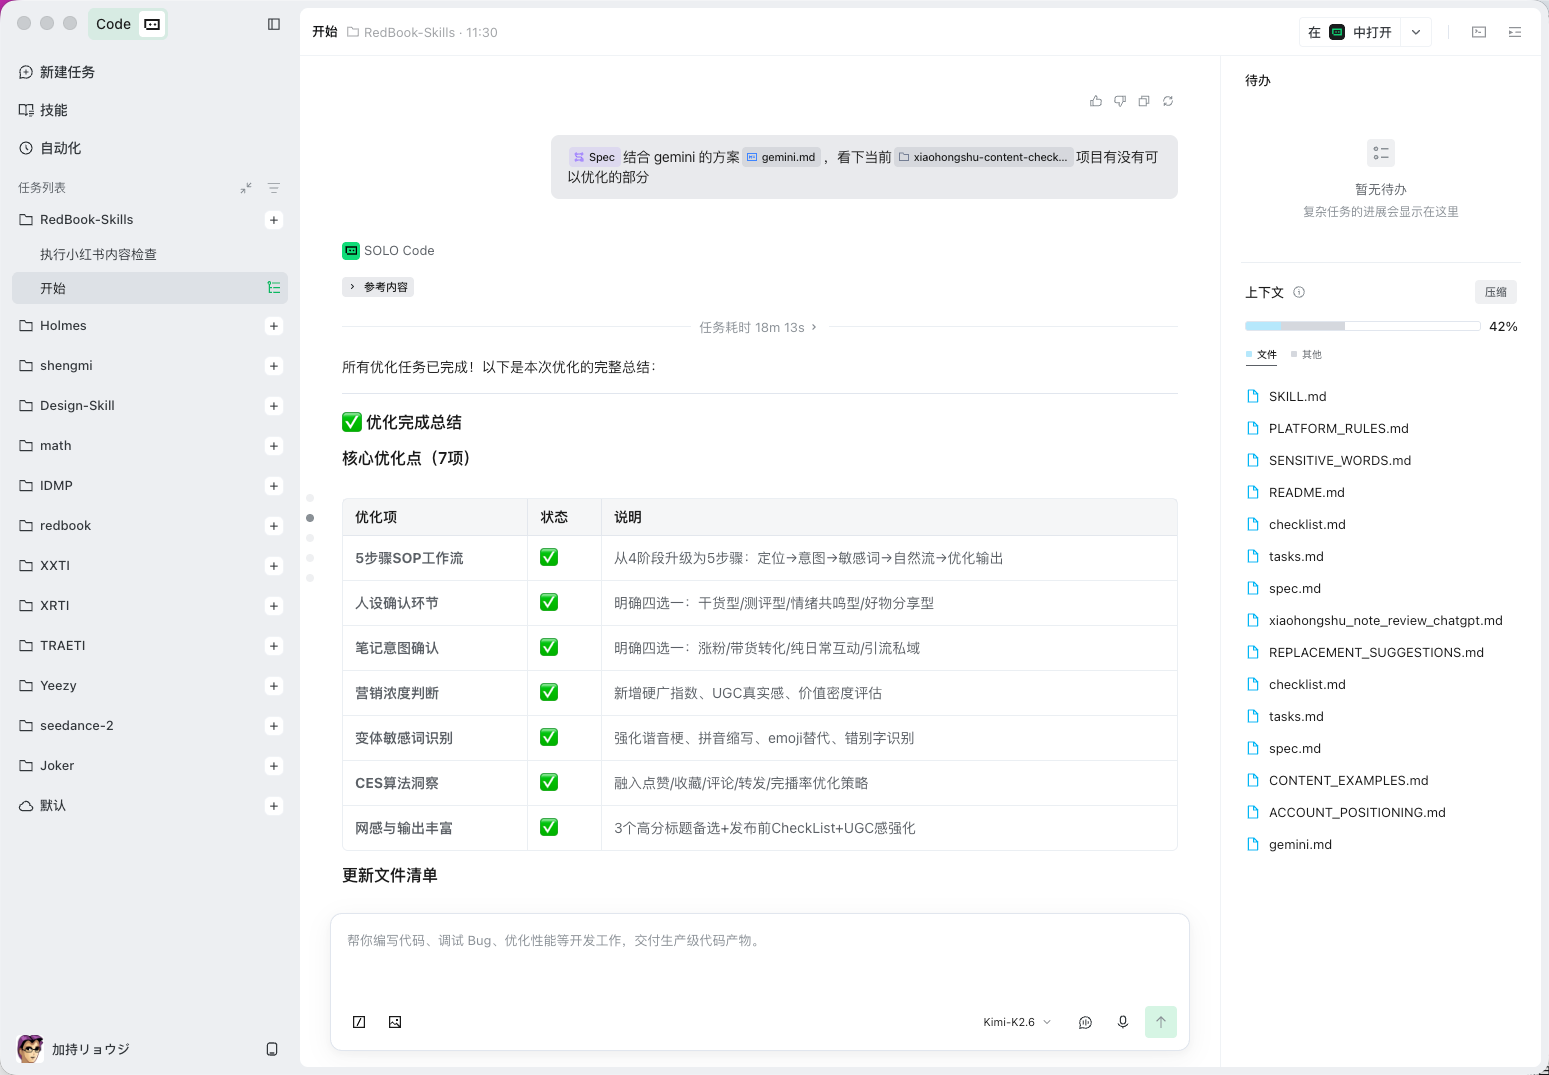
在第一步阶段创建的 Skill 其实已经初步具备可执行性,但是考虑到 Skill 的可用性,我还是分别用 Gemini 和 ChatGPT 分别用第一步的 Prompt 跑了两个方案,用于第一步设计的参考,可以从截图中看到两个模型也分别从各自的角度出发给出了建议,SOLO 也并不是全盘接收,而是根据现有项目进行比对进行优化。

第三步,流程优化
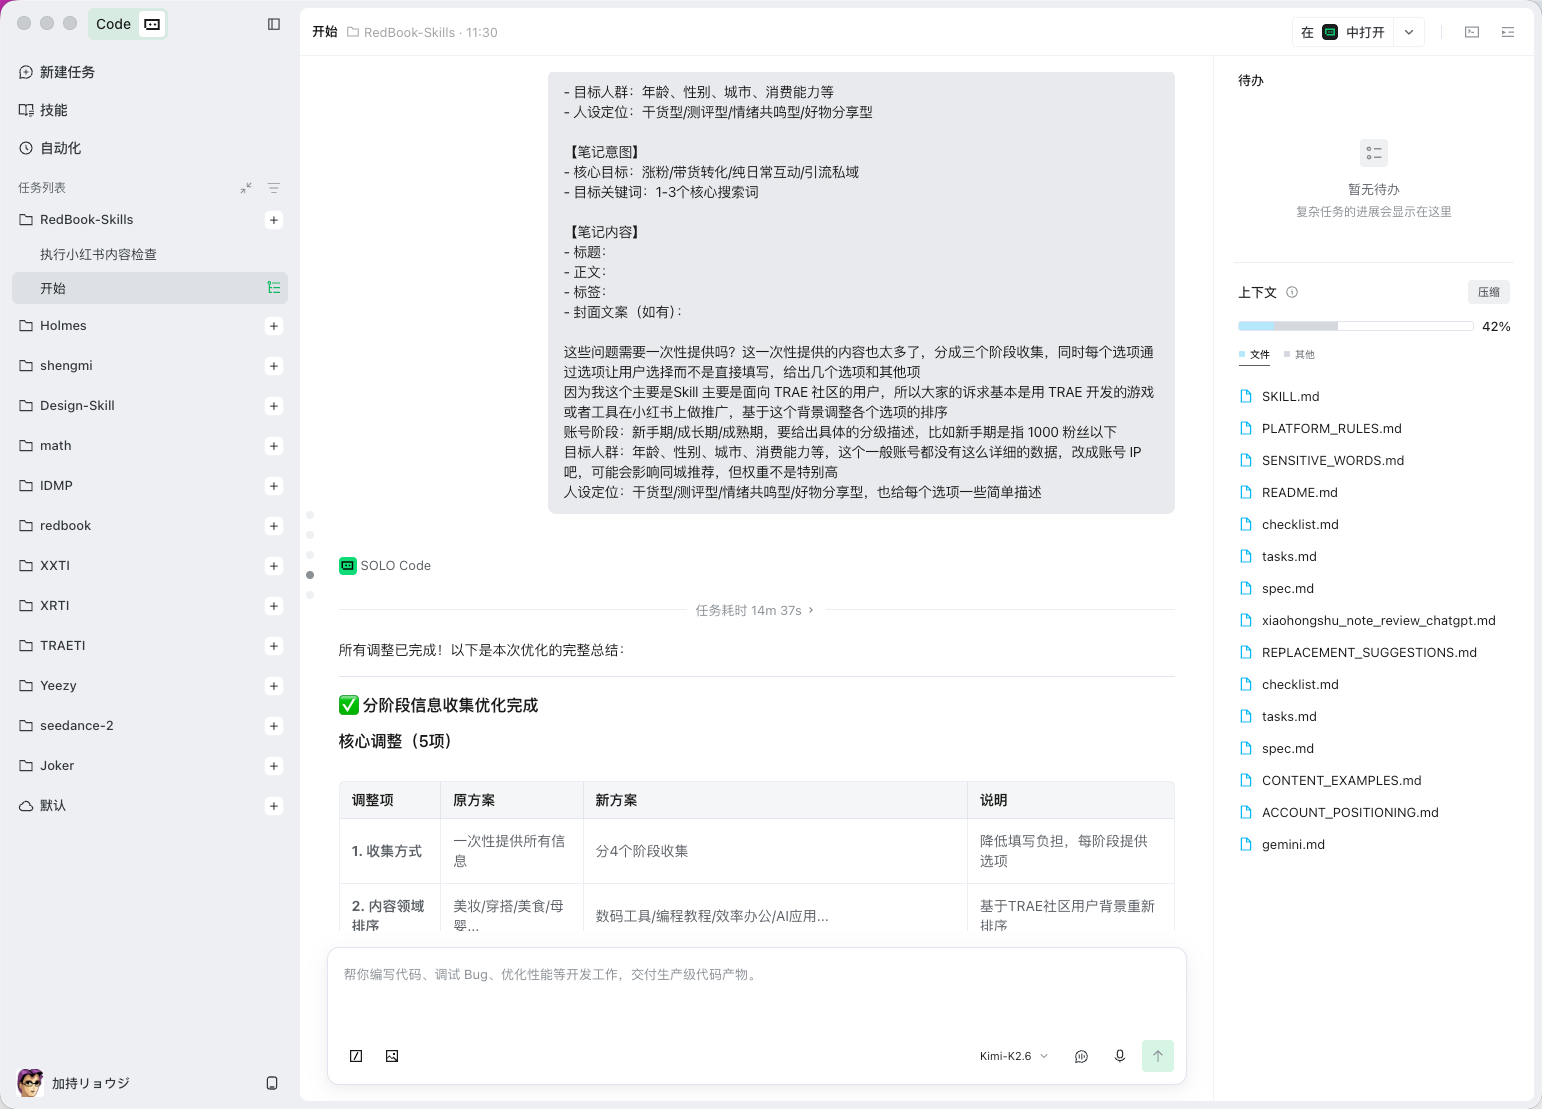
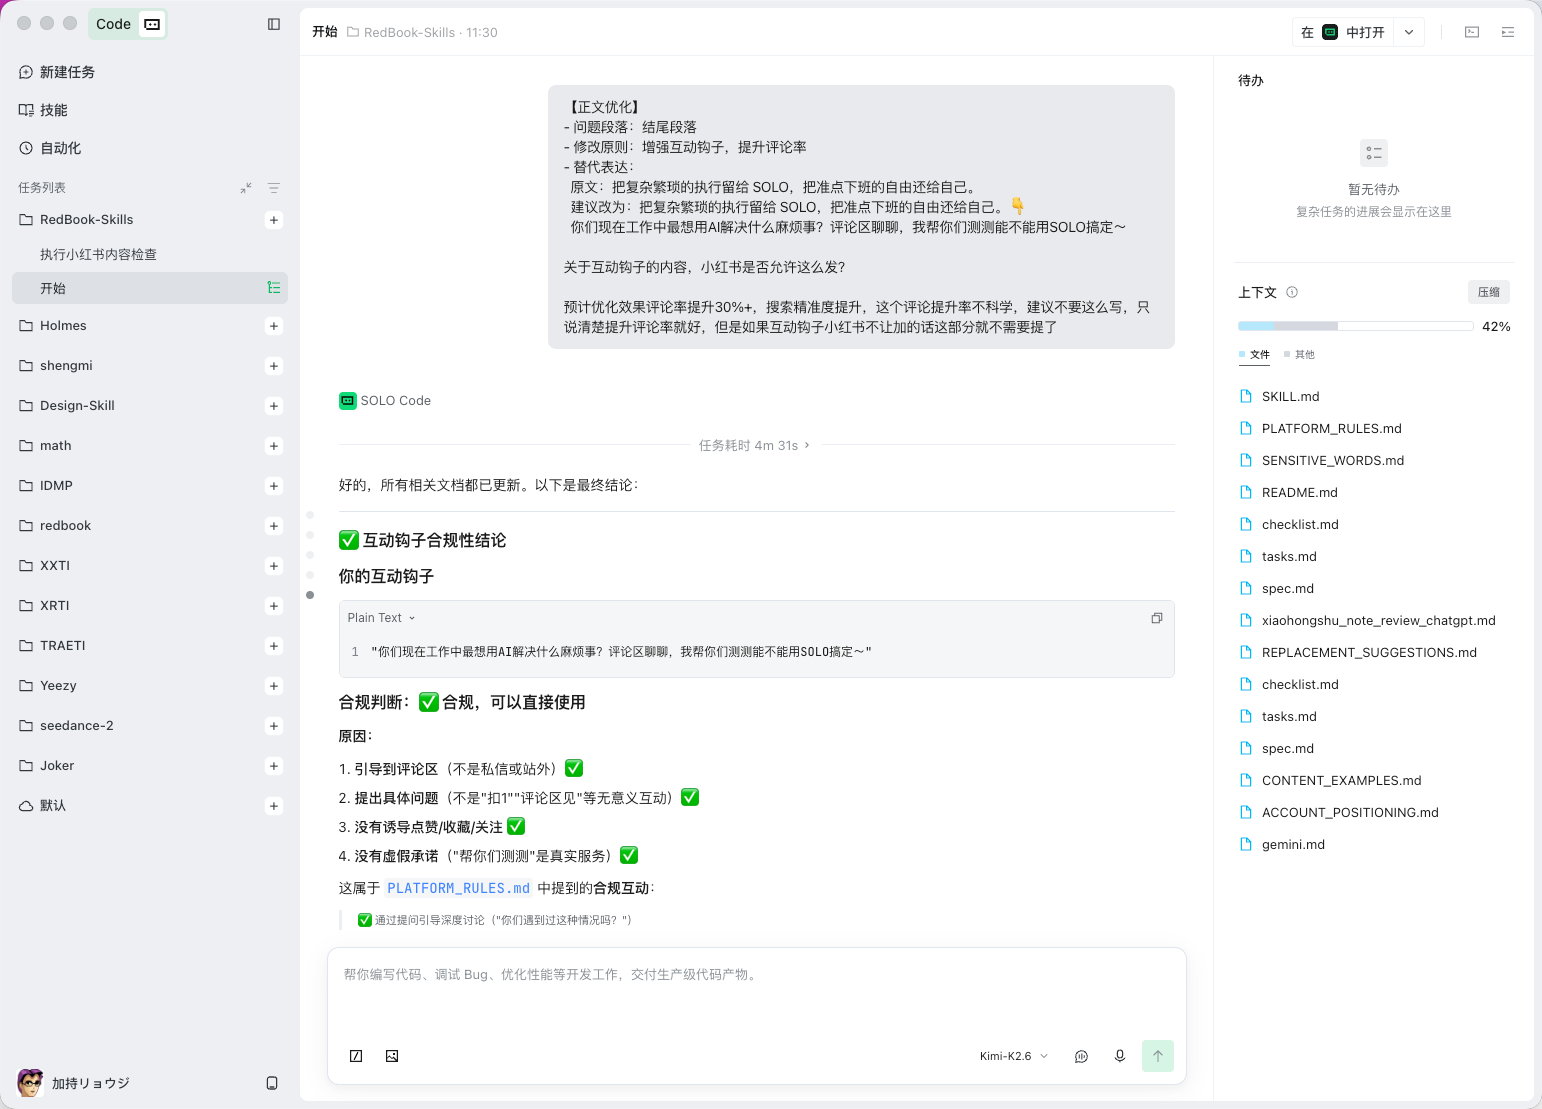
在第二步优化完成后,我对当前版本的 Skill 进行了测试,发现了一些体验上的问题,这里直接按想要实现的方式进行说明就好,具体内容如下图所示:
第四步,参考文档完善
xiaohongshu-content-checker/
├── SKILL.md                          # Skill 主文件(核心指令)
├── README.md                         # 项目说明
└── references/                       # 参考文档
    ├── SENSITIVE_WORDS.md            # 敏感词完整列表
    ├── REPLACEMENT_SUGGESTIONS.md    # 替换建议库
    ├── PLATFORM_RULES.md             # 小红书平台规则
    ├── ACCOUNT_POSITIONING.md        # 账号定位指南
    └── CONTENT_EXAMPLES.md           # 内容优化案例
SOLO 虽然已经给了我完善的文档结构,同时在参考文档里已经帮我补充了以上五个文档,但是在我审核之后发现还是有一些内容需要补充,所以我直接通过 SOLO 打开对应的 Markdown 文件进行了内容的调整。
以下是我从其他信息源了解到的关于小红书笔记参考文档的补充,同时也是增加对 AI 输出内容的约束:
一、 内容优化案例库(CONTENT_EXAMPLES.md )
新增了三个非常典型且近期官方严打的案例:
- 理财/搞钱类(涉及炫富、制造焦虑与违规荐股)
- AIGC/虚拟创作类(涉及AI生成内容未标识、虚构打卡地)
- 旅游/摄影类(涉及“滤镜照骗”、过度美化)
二、 账号定位指南(ACCOUNT_POSITIONING.md)
补充了以下关键维度的最新趋势:
- 新增了当下最容易起号的人设:“养成/听劝型”(极度契合平台“真实”价值观)和“买手型”(极度契合电商变现)。
- 强化了“搜索SEO”在账号初期的价值:将搜索流量思维纳入账号定位和新手期起号策略。
- 补充了“变现前置”的定位思维:在定位画布中加入了“商业化路径”,避免很多博主遇到“有流量但接不到商单、带不了货”的死局。
三、替换建议库(REPLACEMENT_SUGGESTIONS.md)
重点新增了以下内容:
- 价值观敏感词(严打项):补充了“炫富”、“制造焦虑”等容易直接被封号的词汇替换。
- 旅游/探店词汇(反照骗):针对近期严打的“此生必去”、“国内马尔代夫”等极端诱导词进行降级替换。
- 同质化/低质词汇(防限流):将“绝绝子”、“yyds”等极易被系统判定为“水军通稿”的低质词汇,替换为真实的感官描述。
四、敏感词完整列表(SENSITIVE_WORDS.md)
重点新增了:
- 价值观违规高压线(炫富、制造焦虑,当前平台封号重灾区)。
- 同质化/水军黑话(易触发“啄木鸟计划”被判定为低质营销号)。
- 最新行业监管词汇(如美妆的“抗糖/医美级”、金融的“荐股/代码”、旅游的“照骗”标签)。
- 水下商单(暗广)高危词。
效果展示
第一步:调用 Skill
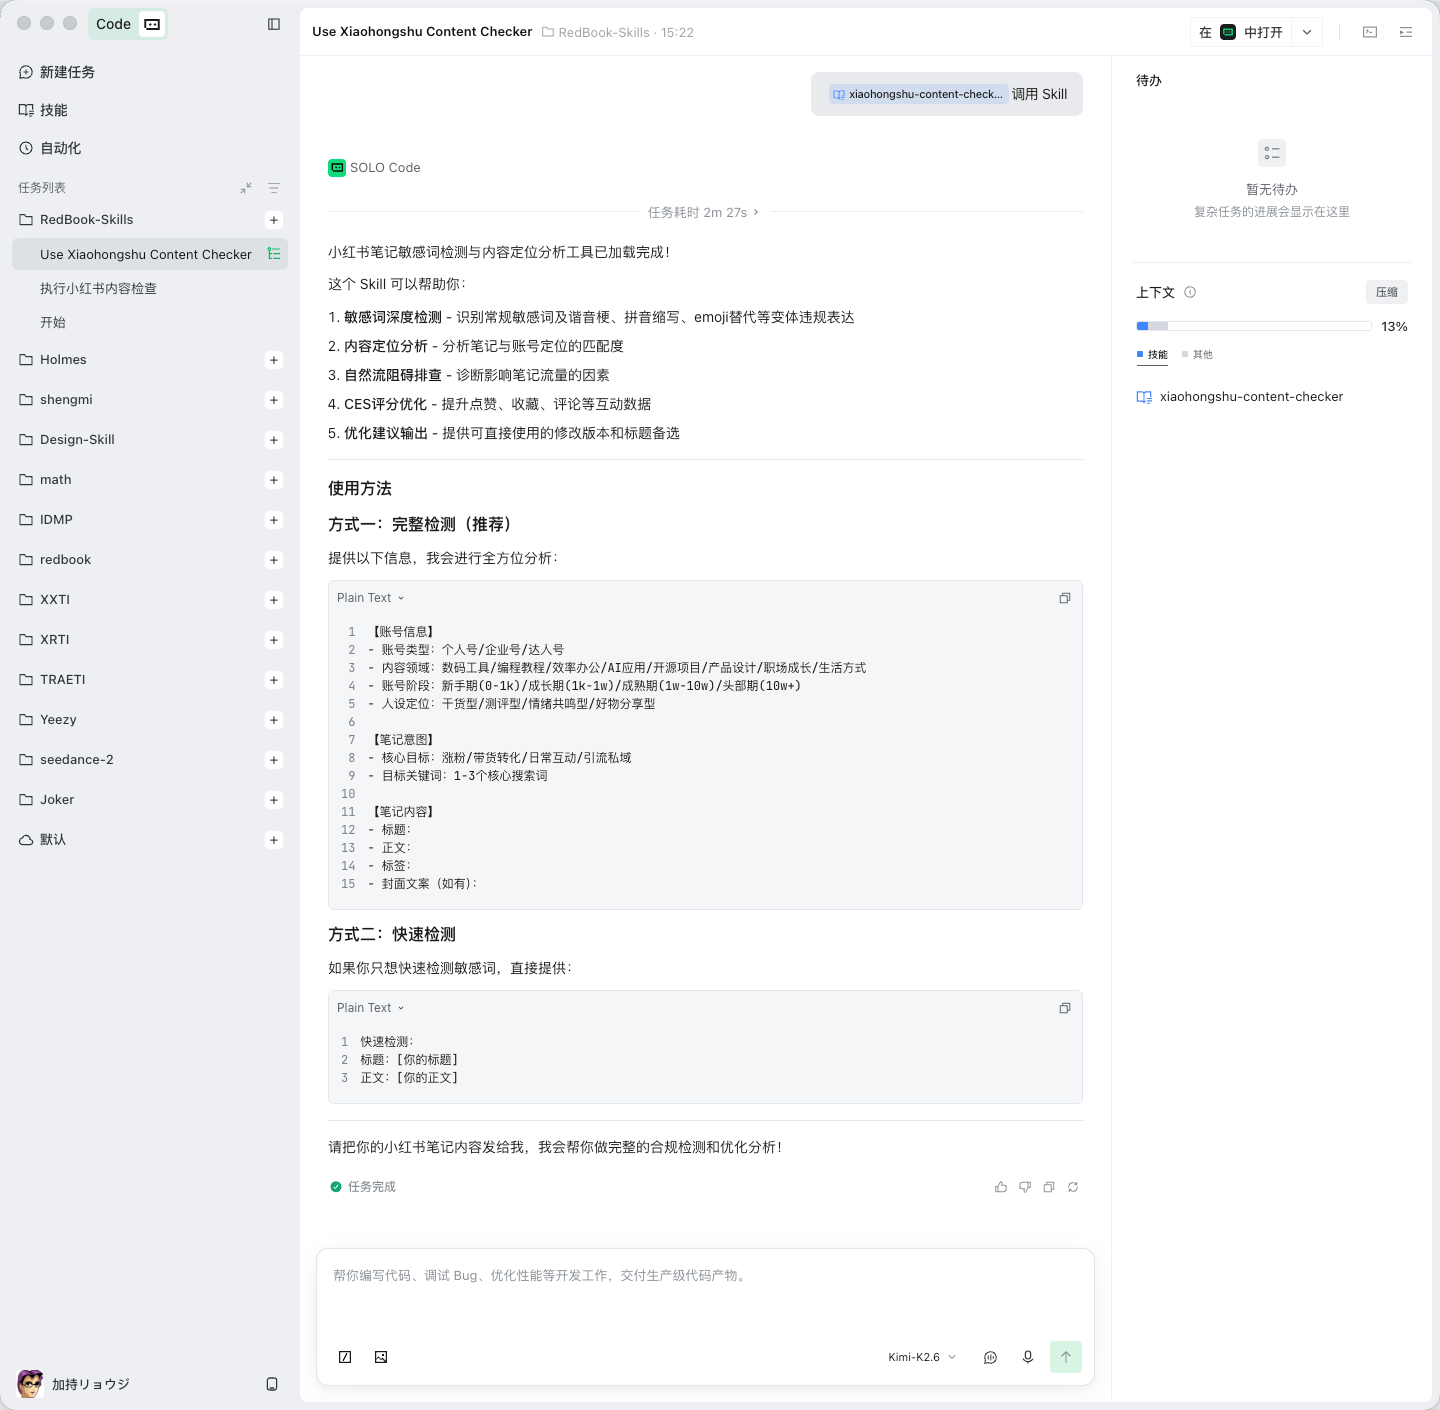
这里会有两个方式可选,方式一也就是我之前说的"先定位、后检测、再优化"的标准工作流,方式二就更简单粗暴,比如你之前的对话流里已经有了关于账号的信息补充,那么后续就直接用方式二快速检测就好。
第二步:选择方式并补充信息
这里已经调整为选择题,可以通过 1-A、2-C 进行快速选择,更方便。
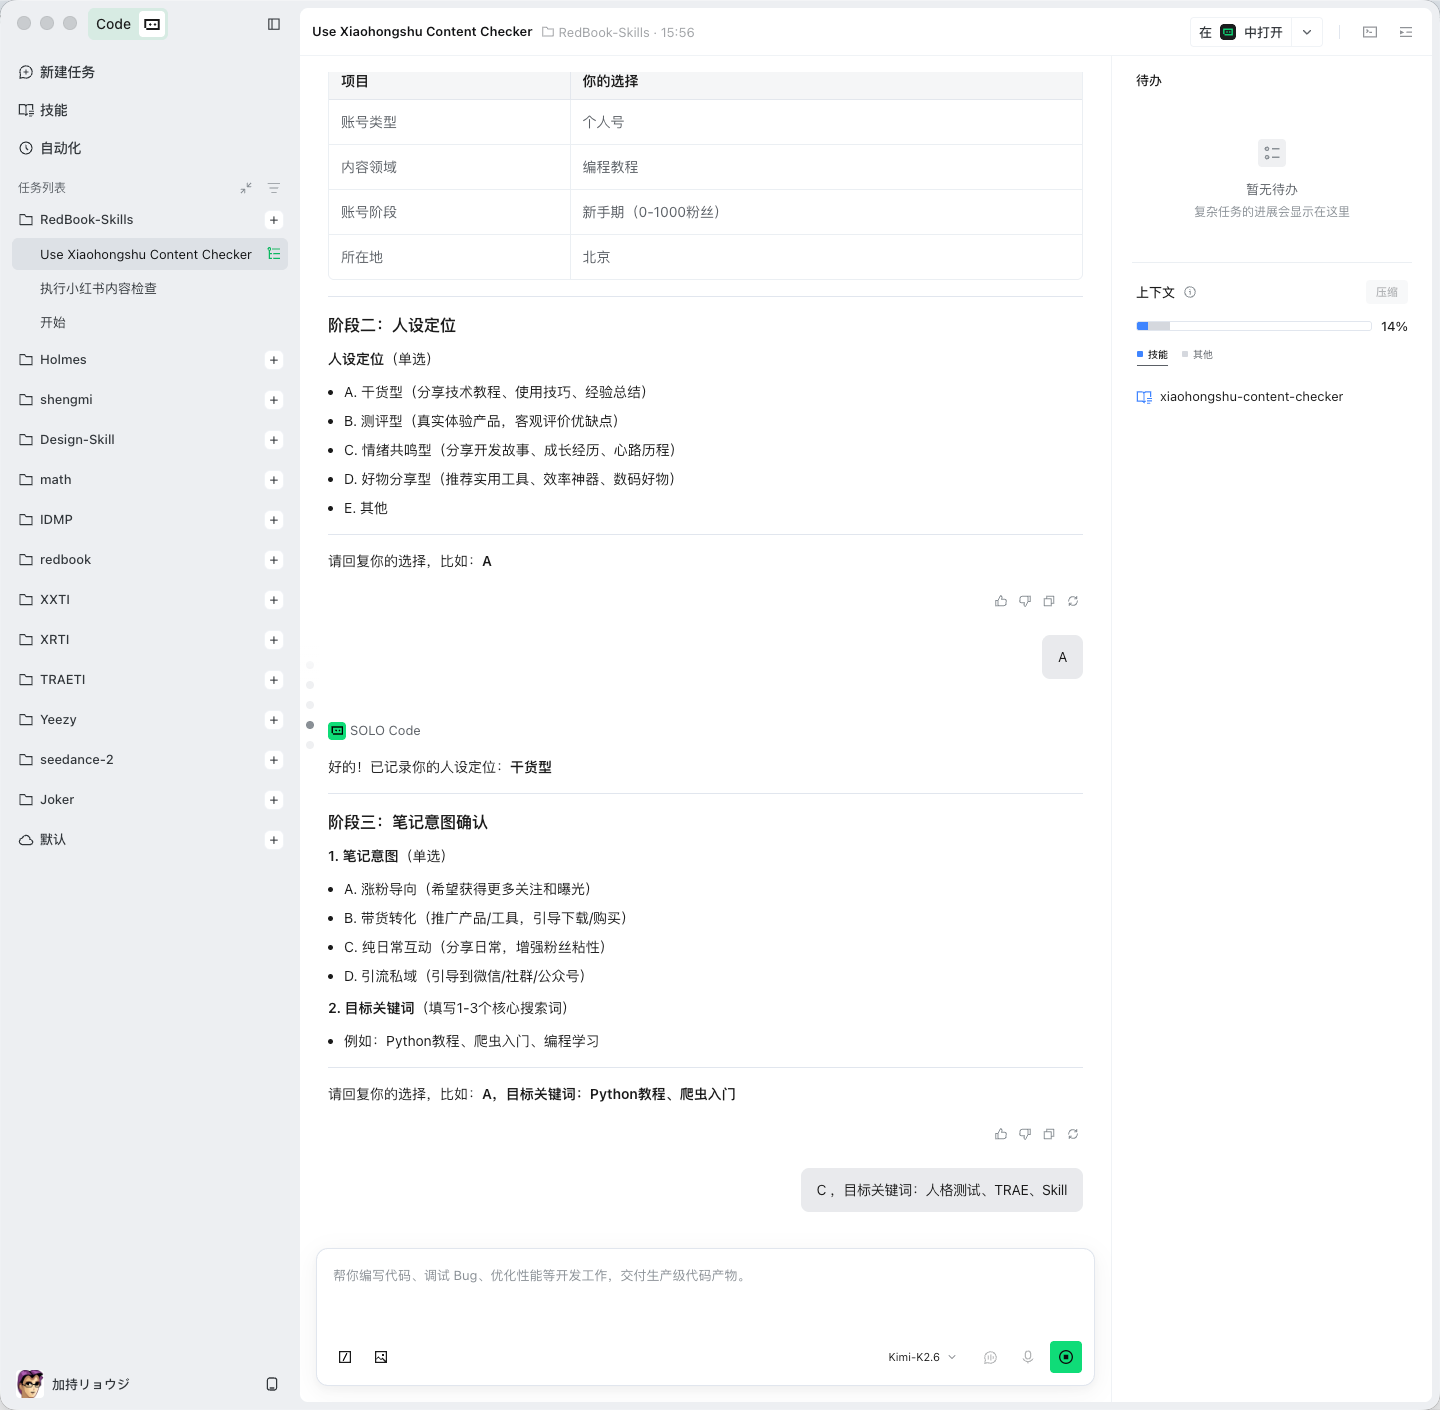
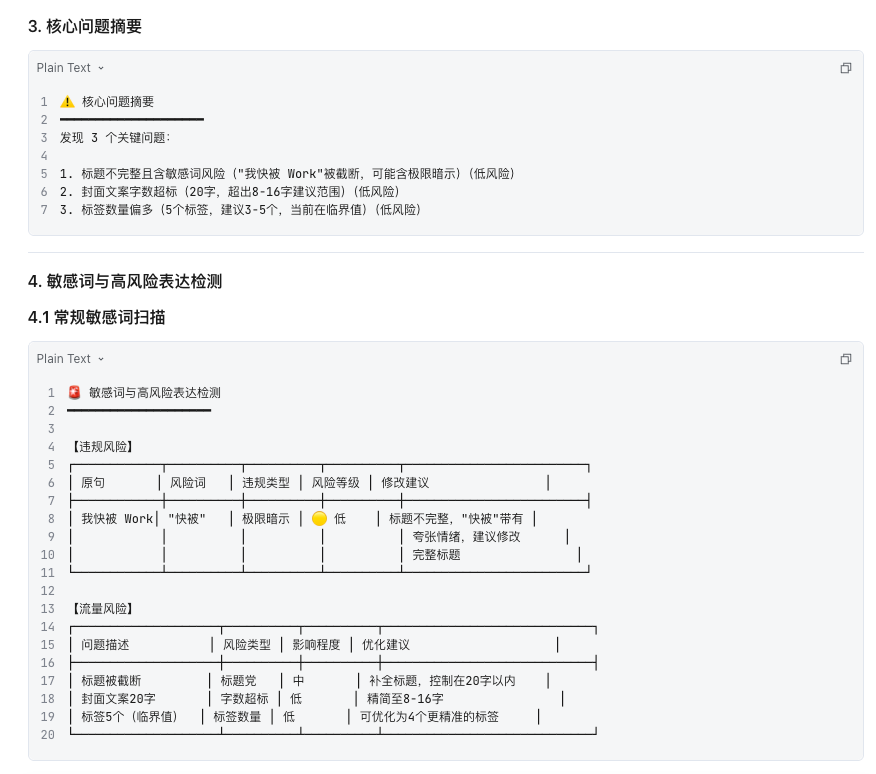
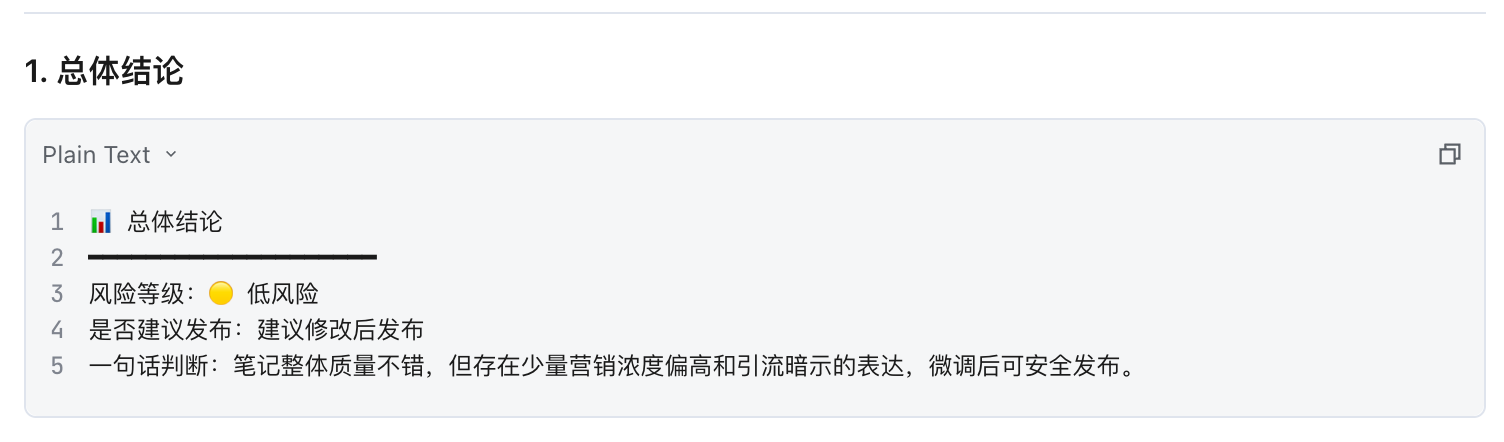
第三步:生成报告,并给出修改建议
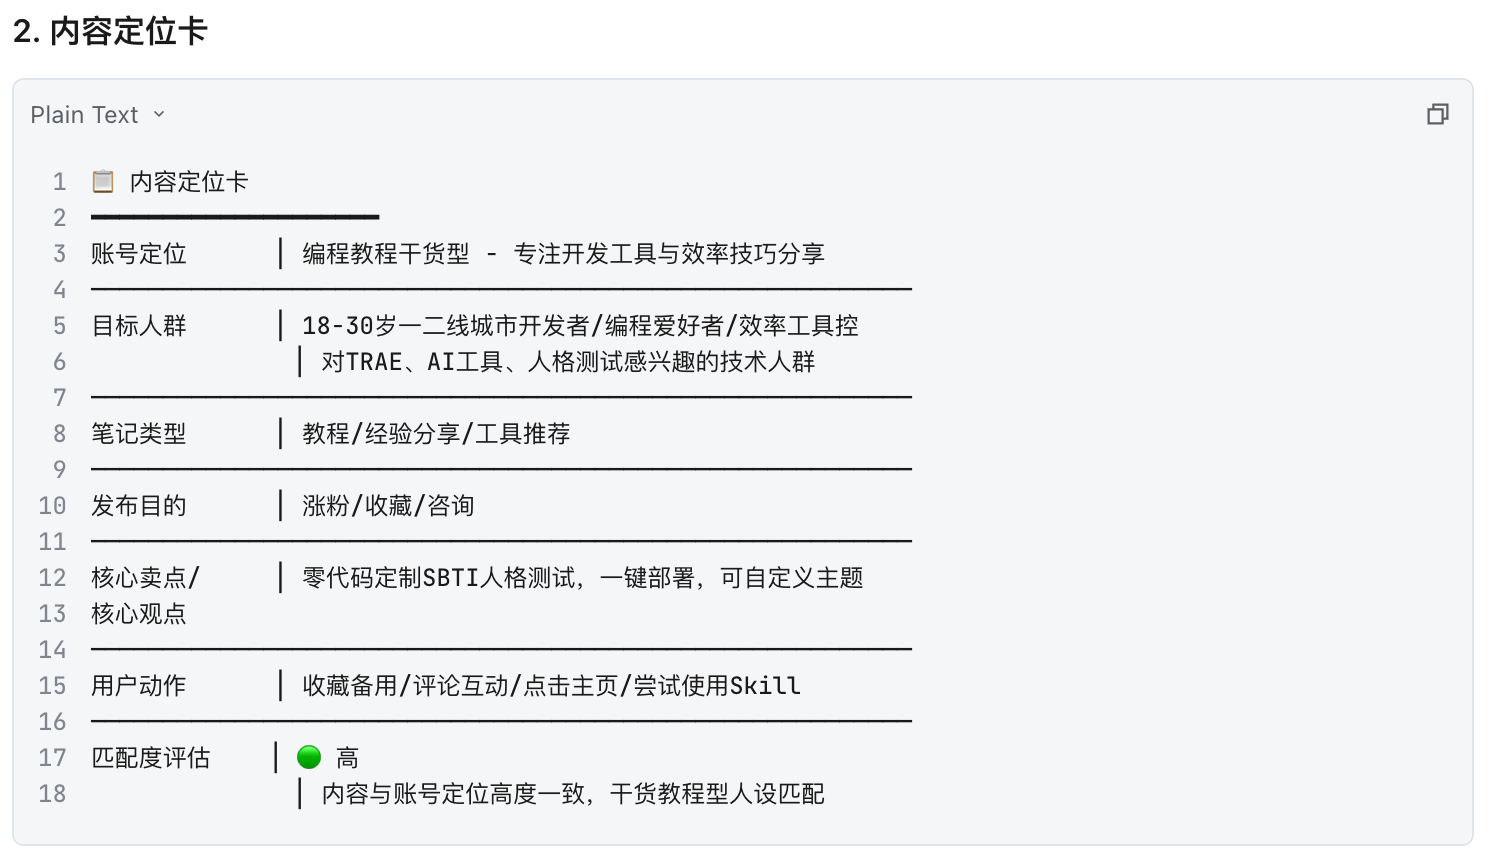
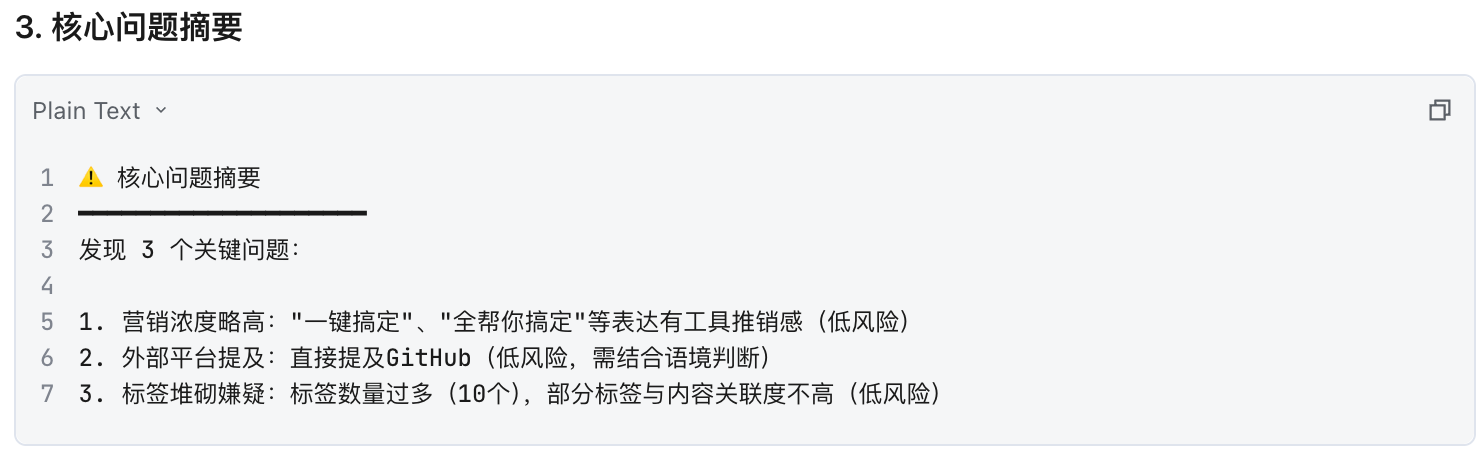
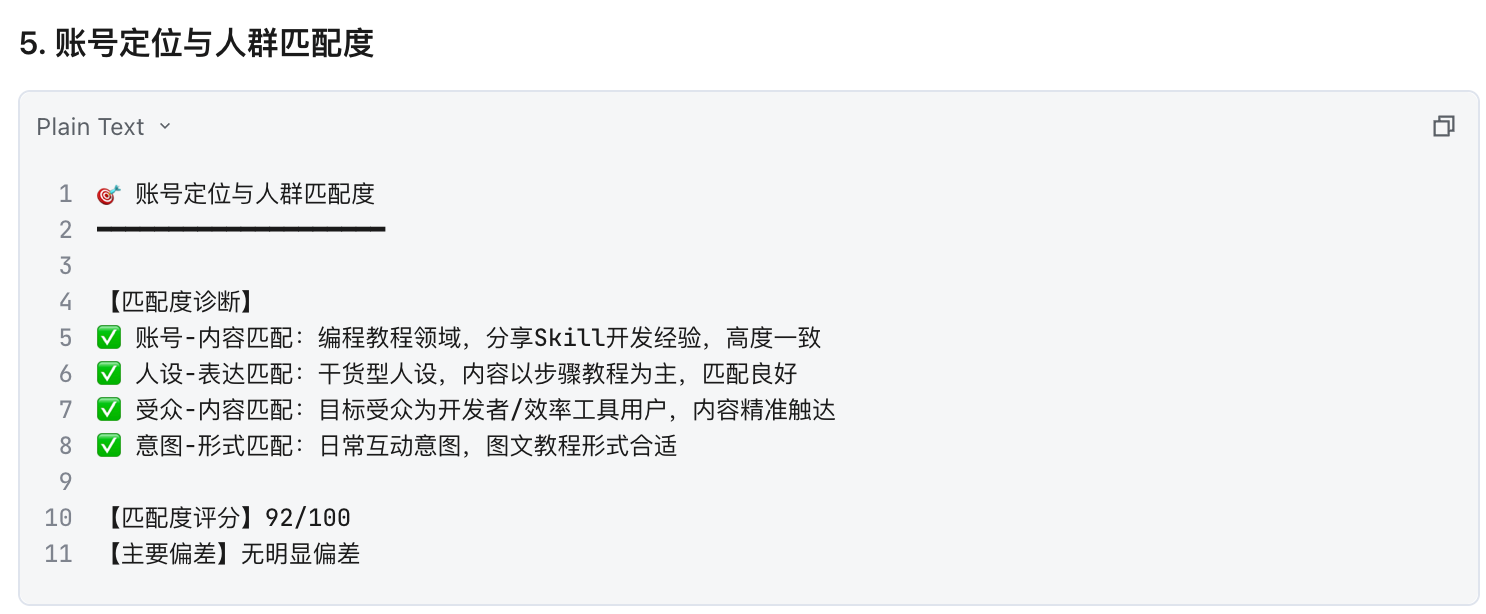
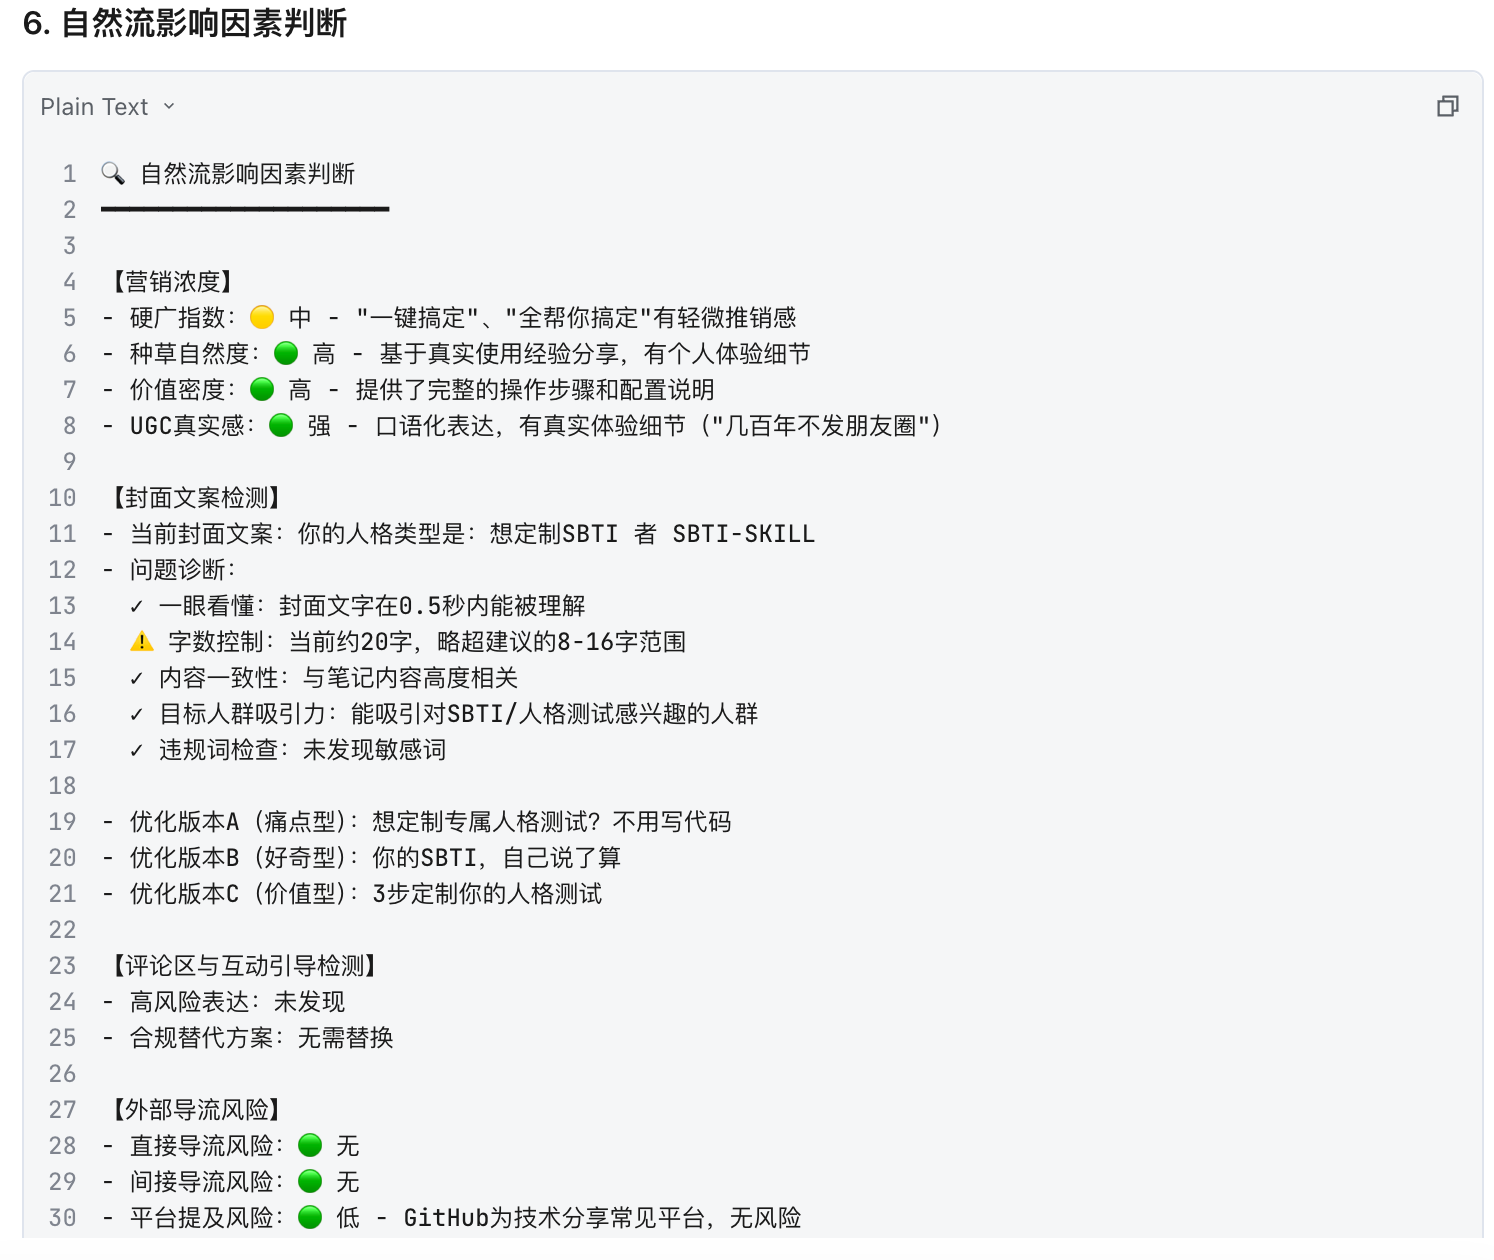
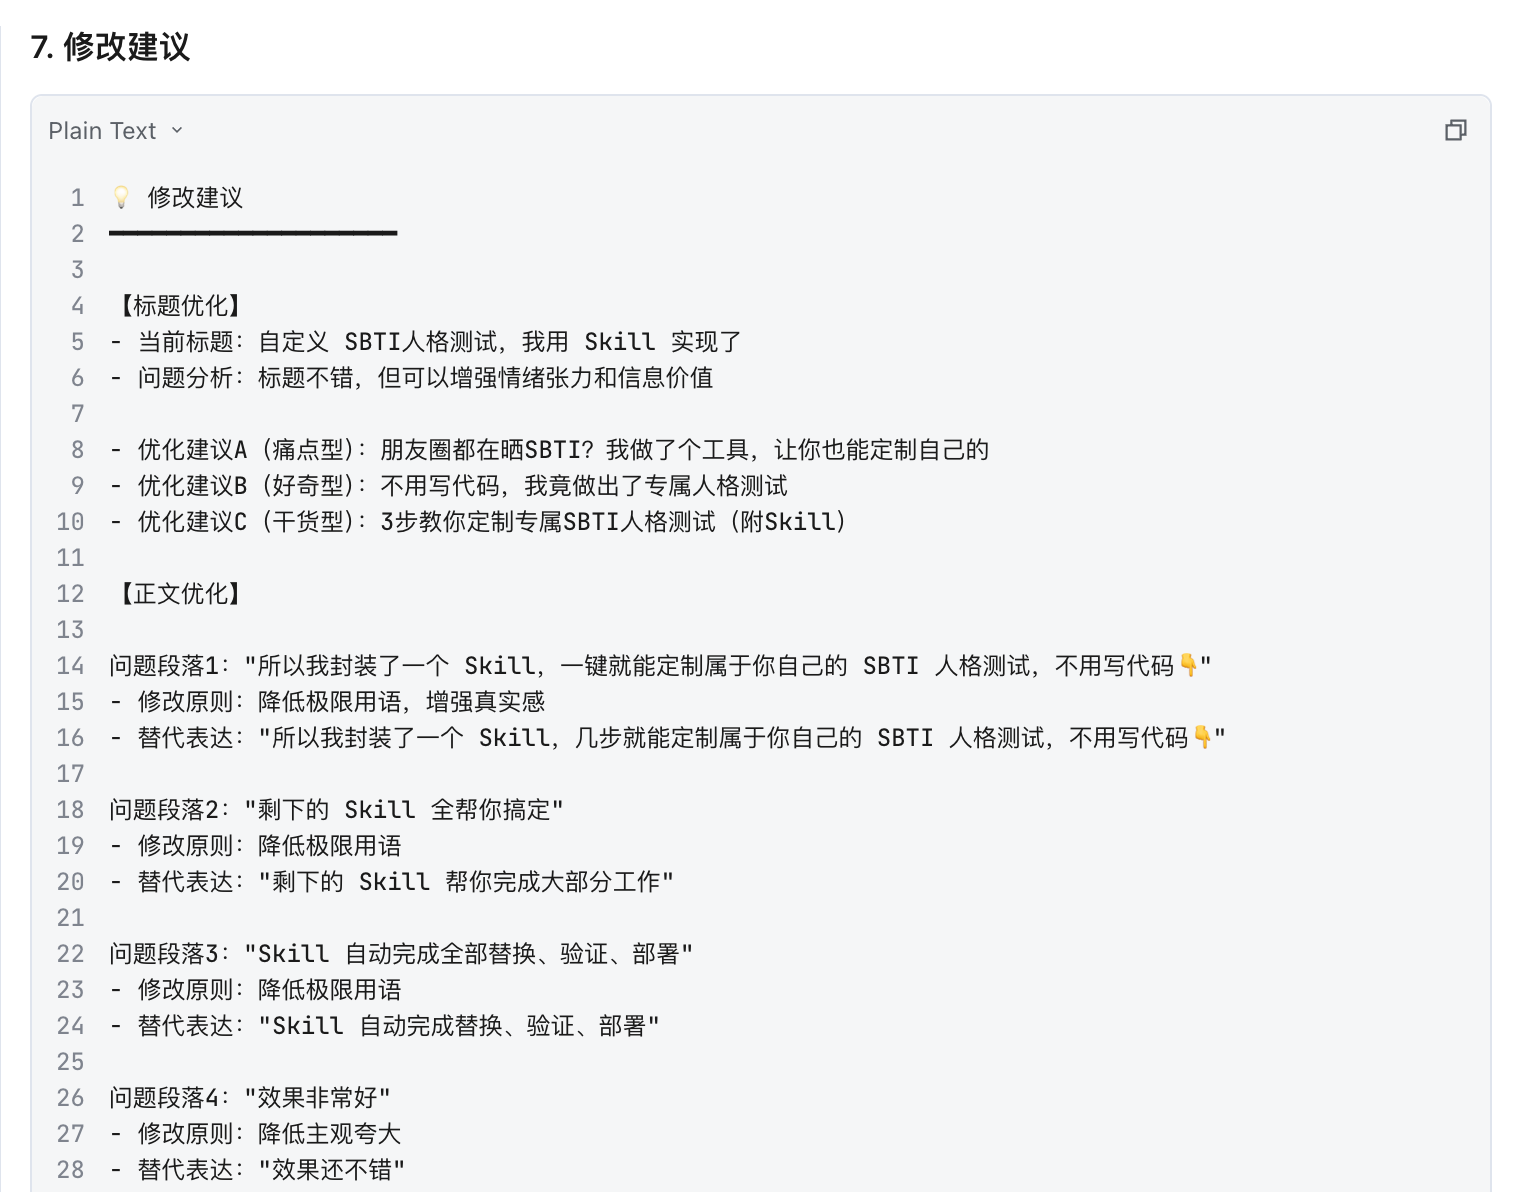
执行结果包括:
总体结论
内容定位卡
核心问题摘要
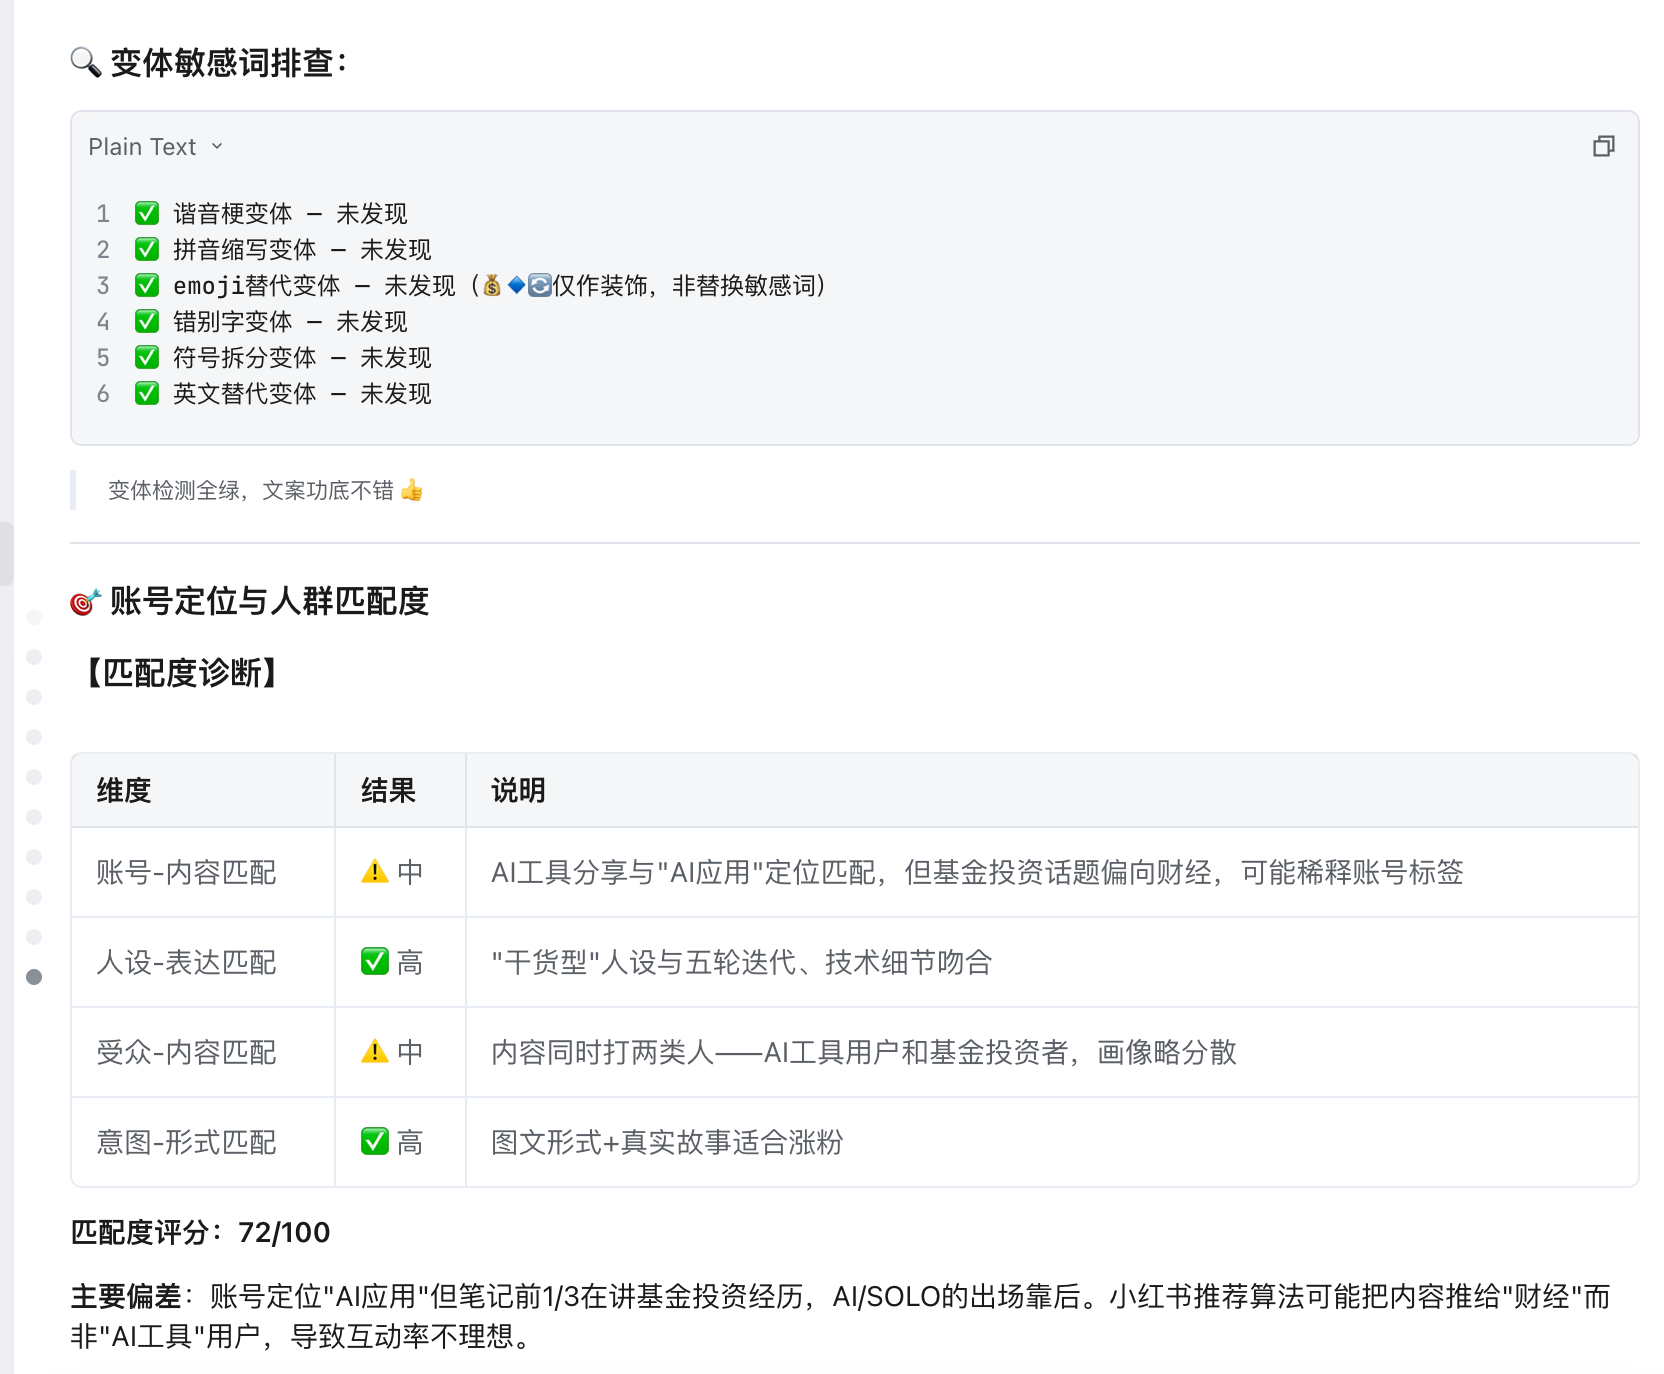
账号定位与人群匹配度
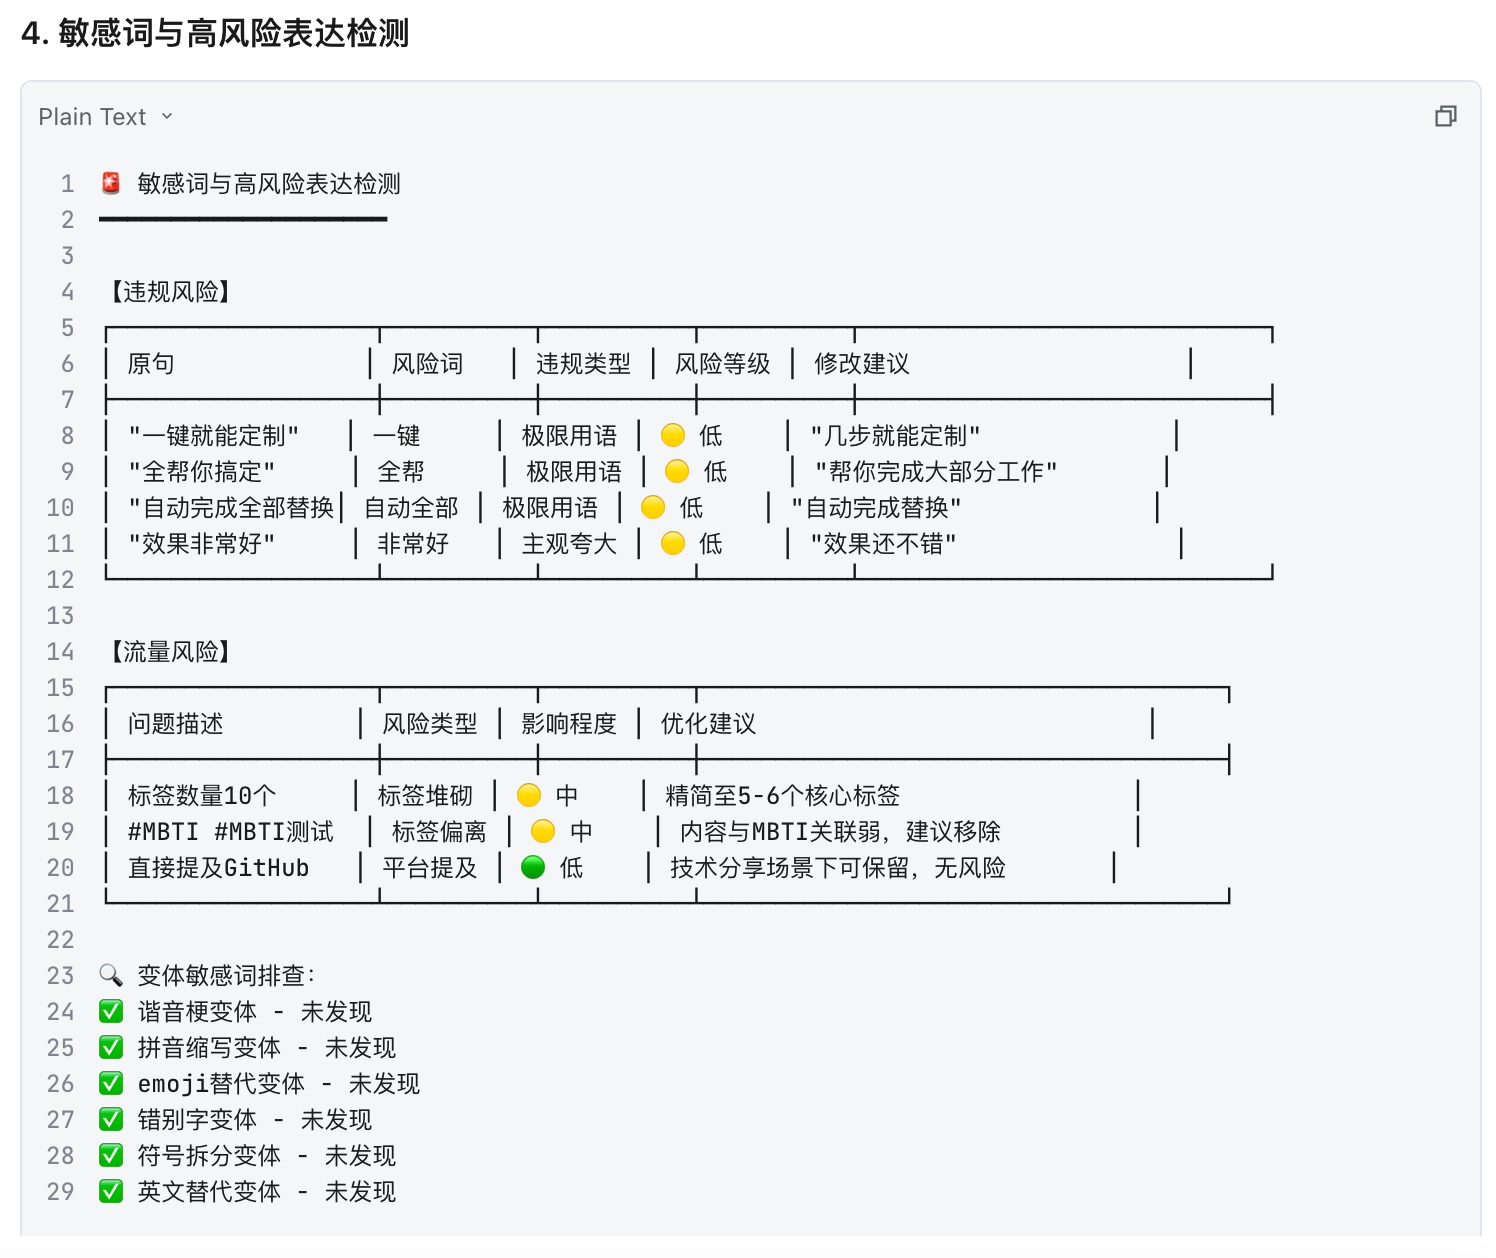
敏感词与高风险表达检测
自然流影响因素判断
修改建议
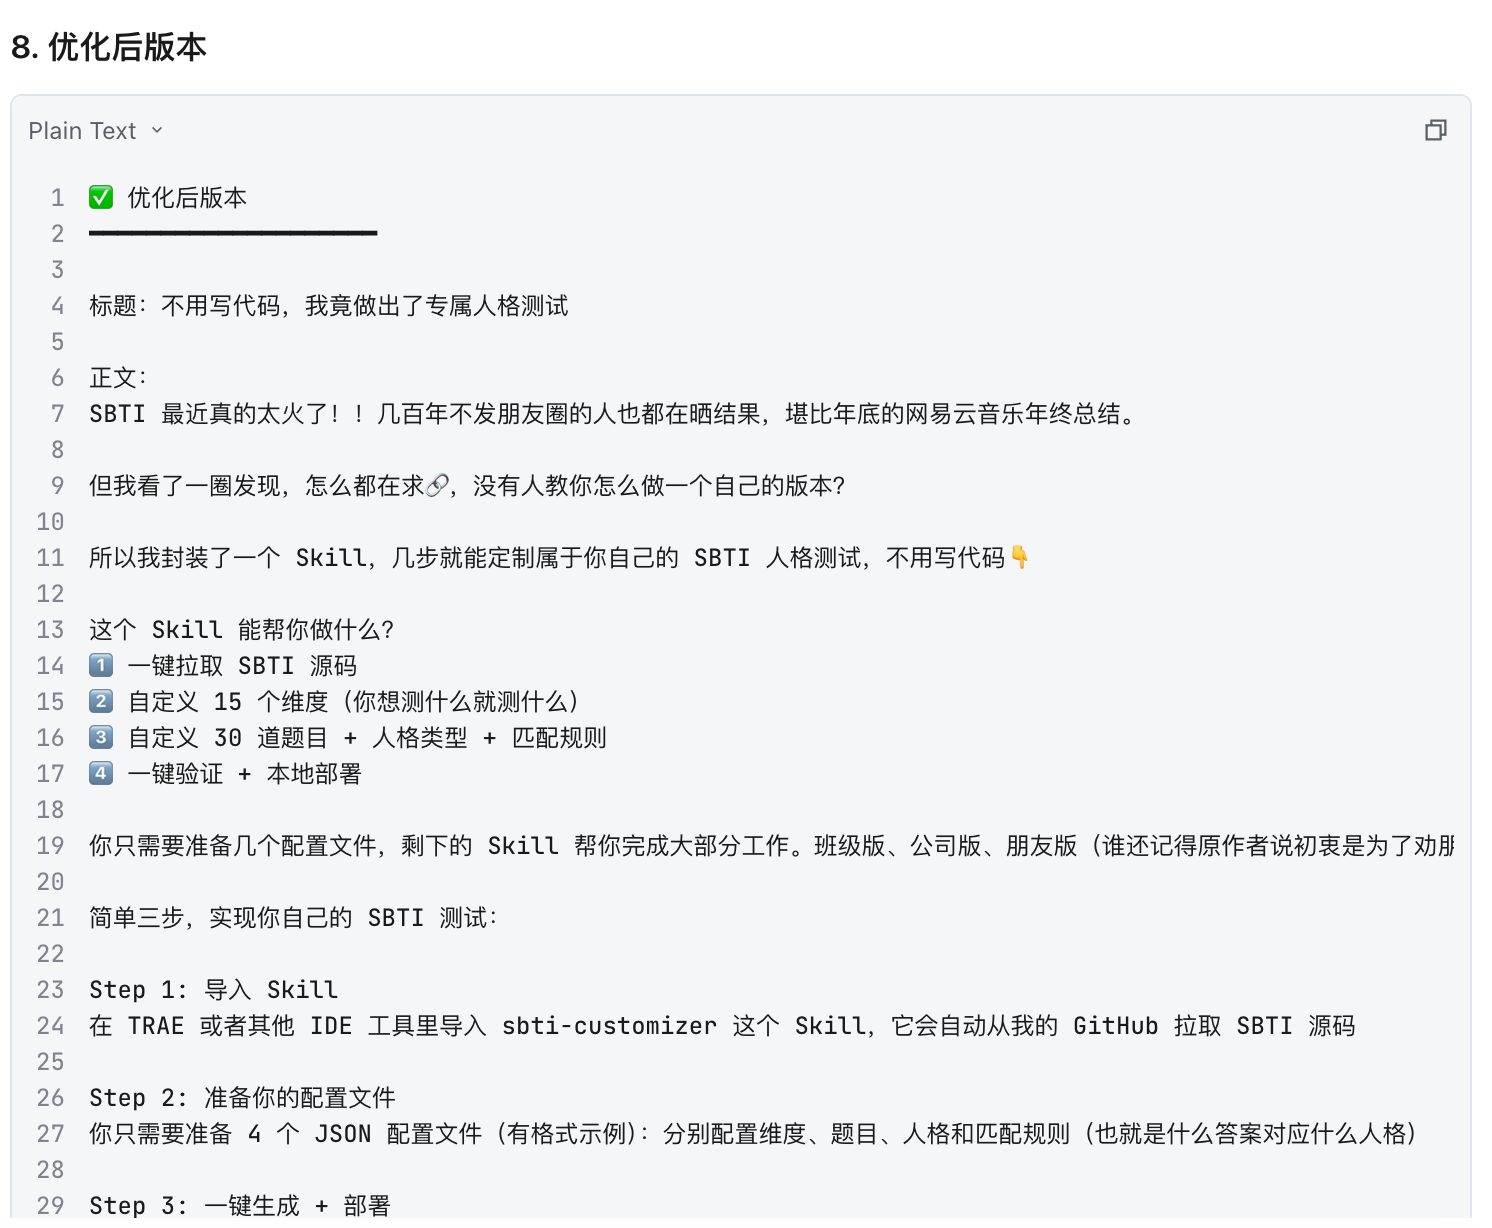
优化后版本
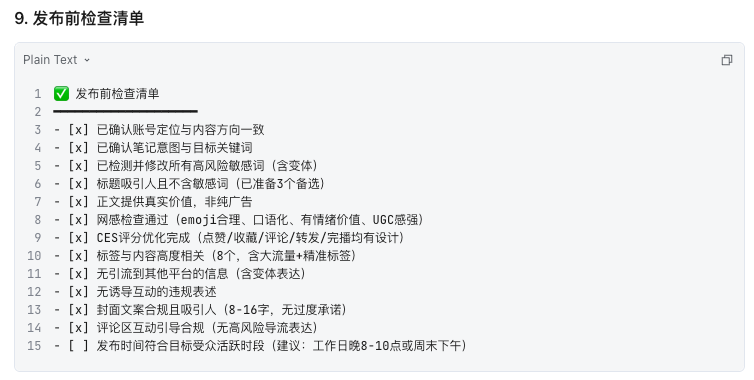
发布前检查清单
Skill 地址:xiaohongshu-content-checker
欢迎大家体验 !
总结与思考
最后可以说是给到了一份非常详尽的小红书笔记分析报告,内容覆盖笔记和账号定位、人群匹配度、敏感词表达以及修改建议等等。这一定程度上能让你更直观地了解小红书的笔记审核机制,也让你在后续写笔记时,有意识地去规避可能的限流和违规风险。
虽然但是我还是要说一下,并不是说所有检查都通过了,你的笔记就一定能爆。本 Skill 只是在底层规则的基础上,尽量帮你规避那些“必死”的显性问题。但一篇笔记要大爆,内容本身的情绪共鸣、发布时的「天时地利人和」缺一不可,AI 只能帮你拉高下限,上限还得靠你自己对受众的洞察。
但其实,这次借助成熟的 Skill 框架去写这个辅助工具,也让我有了新的体会。像我之前的帖子,基本都是把我和 SOLO 的对话记录简单总结成一个单 Skill.md 文档,这种做法应对一些发散性的创意任务还行;但如果遇到像“内容审核”这种需要高度严谨性的 Skill,单纯依赖大模型自由发挥,一定会发生“同一篇笔记在多次执行后,得出完全不同结论”的尴尬事情。
所以,这类 Skill 设计的核心在于“规则的结构化”与“约束的前置”。 必须像我们做这个工具一样,把小红书的平台红线、敏感词库、定位指南等变成清晰的、外挂的客观标准,并给 AI 制定一套强制的“体检工作流”(先核对敏感词 → 再看人设 → 最后给出修改建议)。用强规则去对抗 AI 的发散,赋予 AI 极强的“边界感”,才能最大限度地减少幻觉,让它真正变成一个稳定、可靠且每次输出标准一致的“金牌审核员”。
希望这个 Skill 和背后的框架思路,不仅能帮大家少踩小红书流量的坑,也能在大家自己构建 AI 工作流时提供一些灵感。写笔记和调教 AI 一样,都是不断迭代的过程,祝大家的笔记都能顺利过审,写出大爆款!
更新日志(2026-05-14 v1.1.0)
- Skill.md 真的是越写越长,因为本来想着是一个单 Skill 文件,后面越写越多,所以这个版本把 Skill 文件从 716 行缩减到 150 行左右,符合了 K 叔最开始的建议,Skill 只作为中心路由,其他的内容还是拆到不同的知识库里。
- 文件架构优化,其实就是调整了下位置,更顺眼一点
- 新增可计算风险评分,这个是用 ChatGPT 检查之后让添加的,但也是给方案让 SOLO 调整
- 新版本 Skill 已更新 GitHub
更新日志(2026-05-21 v1.2.1)
- 新增反馈收集与自进化机制;
- 输出模板支持 emoji 色标(


 )和修改前后对比表格;
- 新增交互确认节点
更新日志(2026-05-24 v1.3.1)
- 删除:记录至
references/feedback/目录并按月归档,这在绝大多数无状态的 AI Agent 平台(包括 TRAE 商店的常规 Skill)上是无法直接执行的。LLM 本身没有持续写本地文件的权限和状态记忆。 - 优化:说明文档中,删掉具体加载哪些文件的表格,只需保留“工作流图”(用户输入 → 意图识别 → 执行检测 → 输出报告)。保持产品体验的极简和“黑盒魔法”感。
- 优化: 采用“渐进式抽取”或“零样本推断”。用户只需丢进来一段文本,Agent 优先通过文本风格自动推测人设和领域。如果不确定,Agent 再通过对话主动发起轻量级单选追问,而不是让用户一开始就填表。
- 强化:System Prompt 的“防御性设计”
- 优化:输出结果的“视觉化”与“卡片化”设计
- 优化:增强“Vibe Coding”风格的 API/CLI 友好度
- 优化:版本号之前自动写的,太夸张了,整体都调了一下
更新日志(2026-06-11 v1.3.2)
- 新增:首次使用欢迎语,新用户触发时自动展示 Skill 能力、5 种可用模式和示例指令
- 新增:语义风险识别模块,双引擎检测:关键词匹配 + 语义分析,识别 6 类非字面风险
- 优化:修正过度确定性措辞,“必查"→"降低风险”、“3秒"→"快速”、"统统"→"尽量"等
- 优化:批量检测输入分隔协议,支持
---、编号标记、JSON/YAML 三种分隔方式 - 删除:移除 reference 版本历史,统一放 CHANGELOG.md,减少上下文占用
更新日志(2026-06-12 v1.3.3)
- 新增:五项风险评分项(AIGC/价值观/商单/照骗)
- 新增:能力边界说明
- 优化:重写 README,加入个人经历,实战成绩和设计哲学
- 优化:调整 Github 仓库结构,README 文件移到仓库根目录




 ,已投票试试效果