【学习工作赛道】Doc2LaTeX - 课件 PDF 转 LaTeX 智能排版工具
0. 先和大家打个招呼吧 
我是谁:一名在读大学生,平时课程多,老师发的课件都是 PDF,整理笔记时总是头疼。
我是怎么用 TRAE 把 Demo 做出来的:说实话,我没有正经的软件开发经验,之前从没部署过服务器,连 Docker 是什么都不太清楚。这个 Demo 完全是我把脑子里想做的事一句句讲给 TRAE 听,它帮我一点点做出来的。最神奇的一步是:我说「我想把 PDF 里的数学公式自动转成 LaTeX」,TRAE 就直接帮我把整段转换逻辑写出来了,代码量将近 1500 行。如果让我自己写,我估计一个月都搞不定。还有部署——我原本以为要把代码放到公网访问是一件很难的事,结果在 TRAE 的指导下,从买服务器到配置 systemd 服务,一步一步跟着做,最后真的打开了公网链接,那种成就感很难形容。
1. Demo 简介
是什么:Web 应用(基于 FastAPI + 原生前端单页应用)
面向谁:高校学生、教师、科研人员 —— 任何需要将课件 PDF 转为可编辑 LaTeX 文档的人
主要功能:
-
PDF 智能解析与结构化提取:自动识别 PDF 中的标题层级(章/节/小节)、正文段落、数学公式(希腊字母、上下标、积分、求和等 50+ 种数学符号)、选择题/填空题等题型结构,将非结构化的 PDF 转化为结构化的 LaTeX 源码。
-
三种打印排版模板:
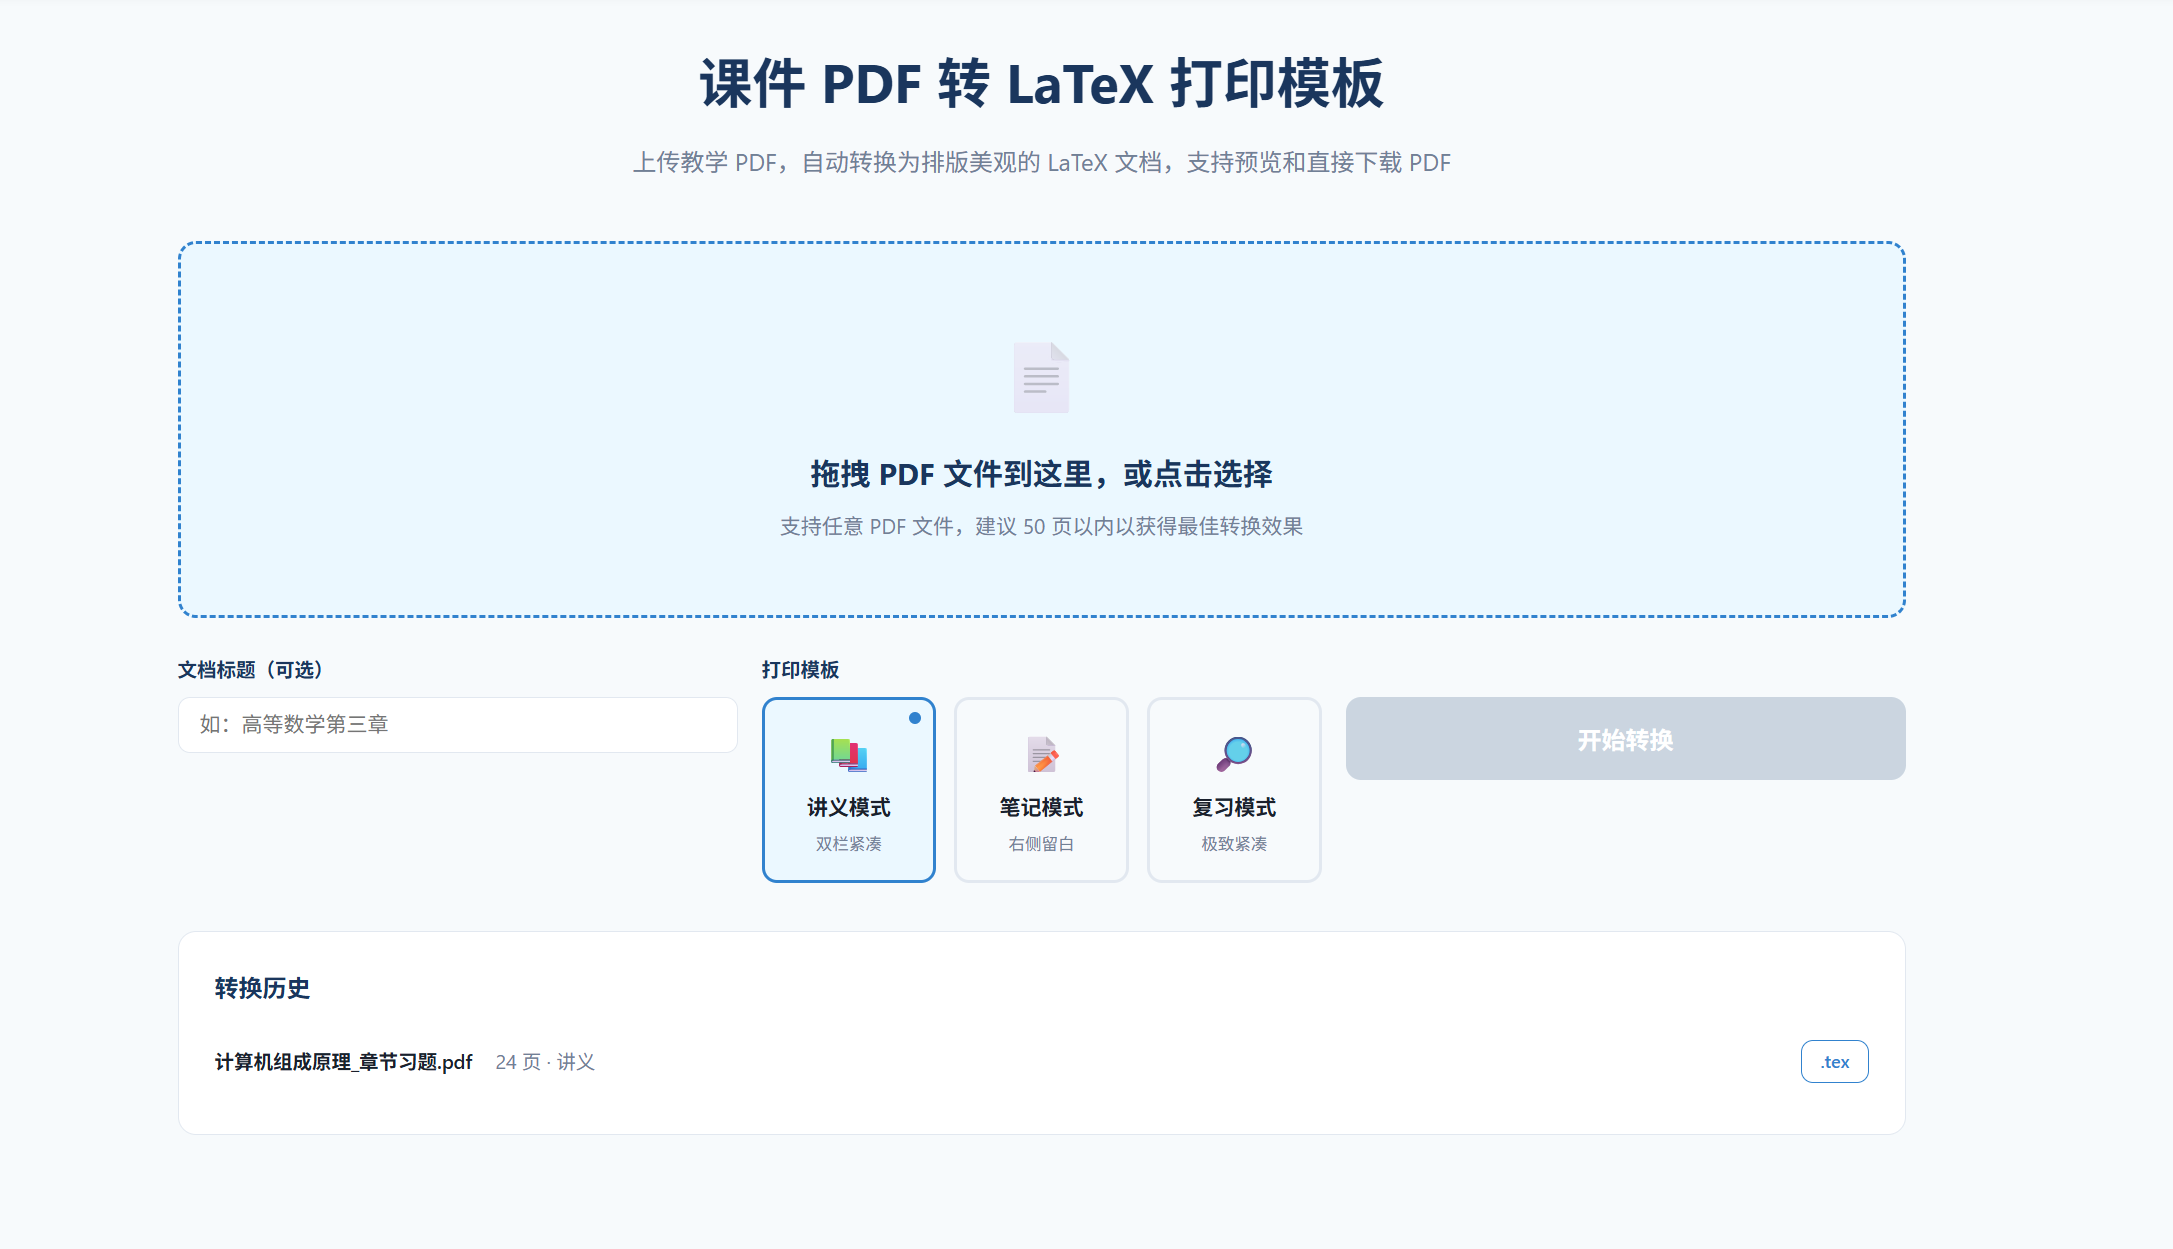
- 讲义模式:A4 双栏紧凑排版,适合课堂讲义打印,节省纸张;
- 笔记模式:单栏排版,右侧留白区域供手写补充笔记;
- 复习模式:9pt 字号极致紧凑,公式带高亮框,适合考前复习速览。
-
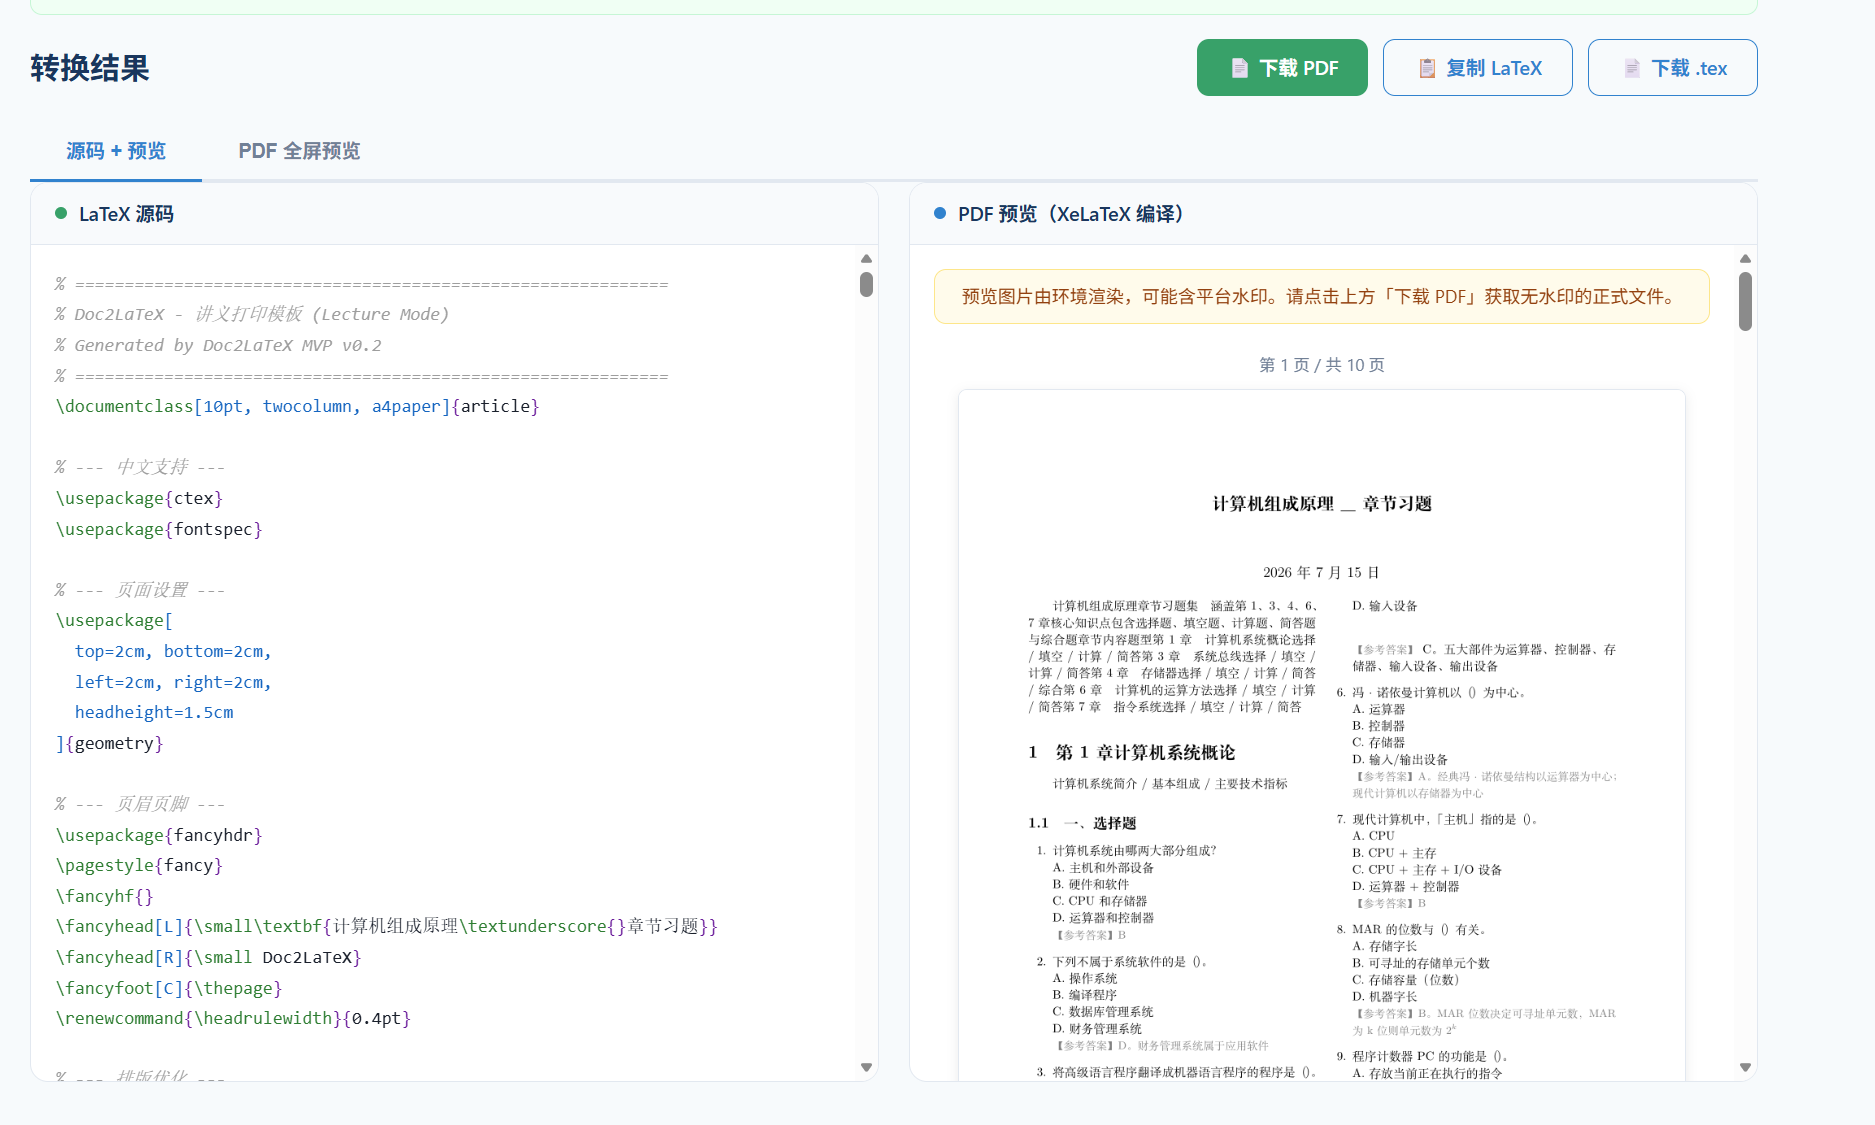
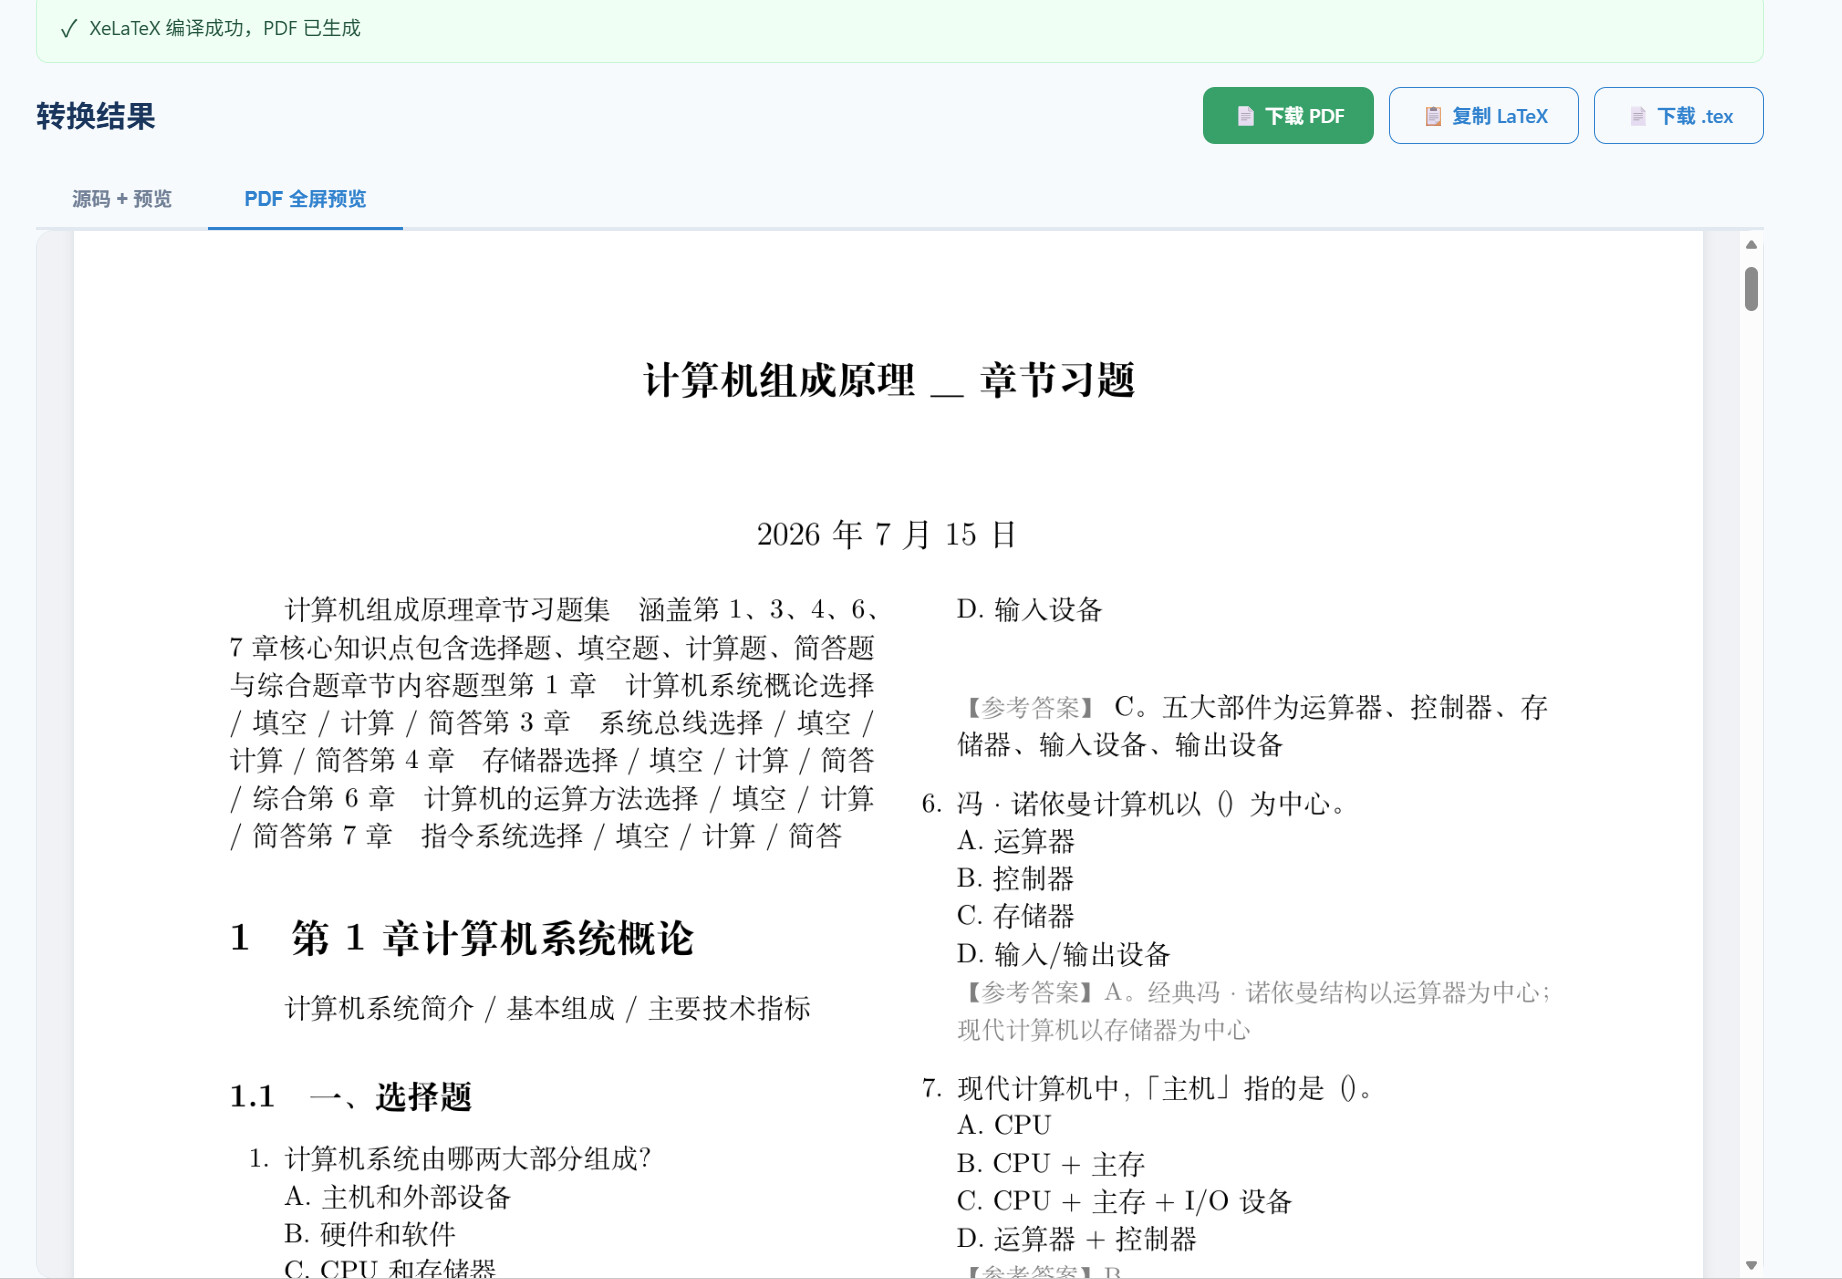
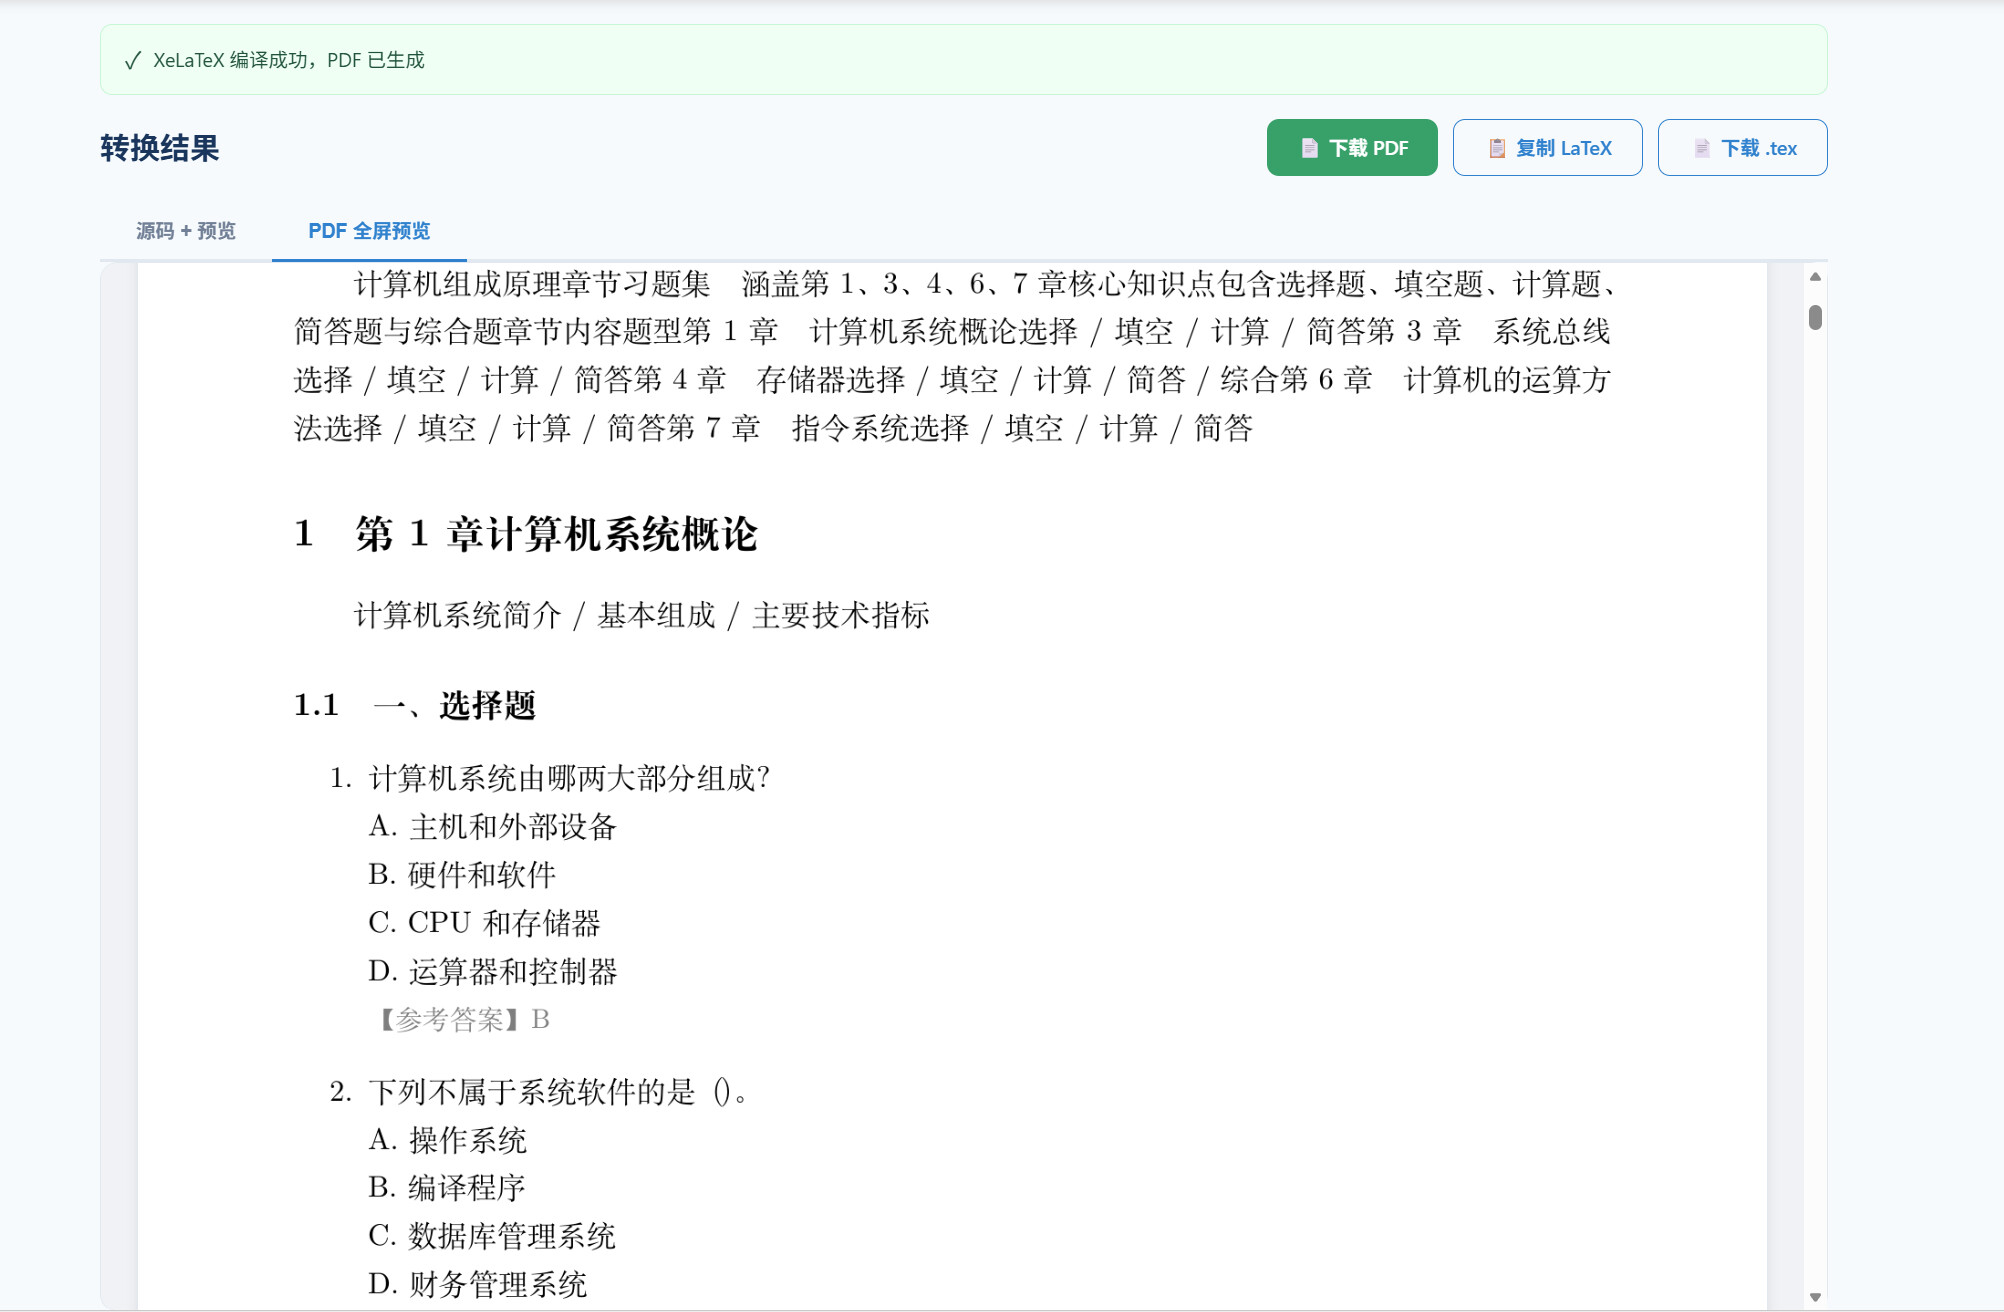
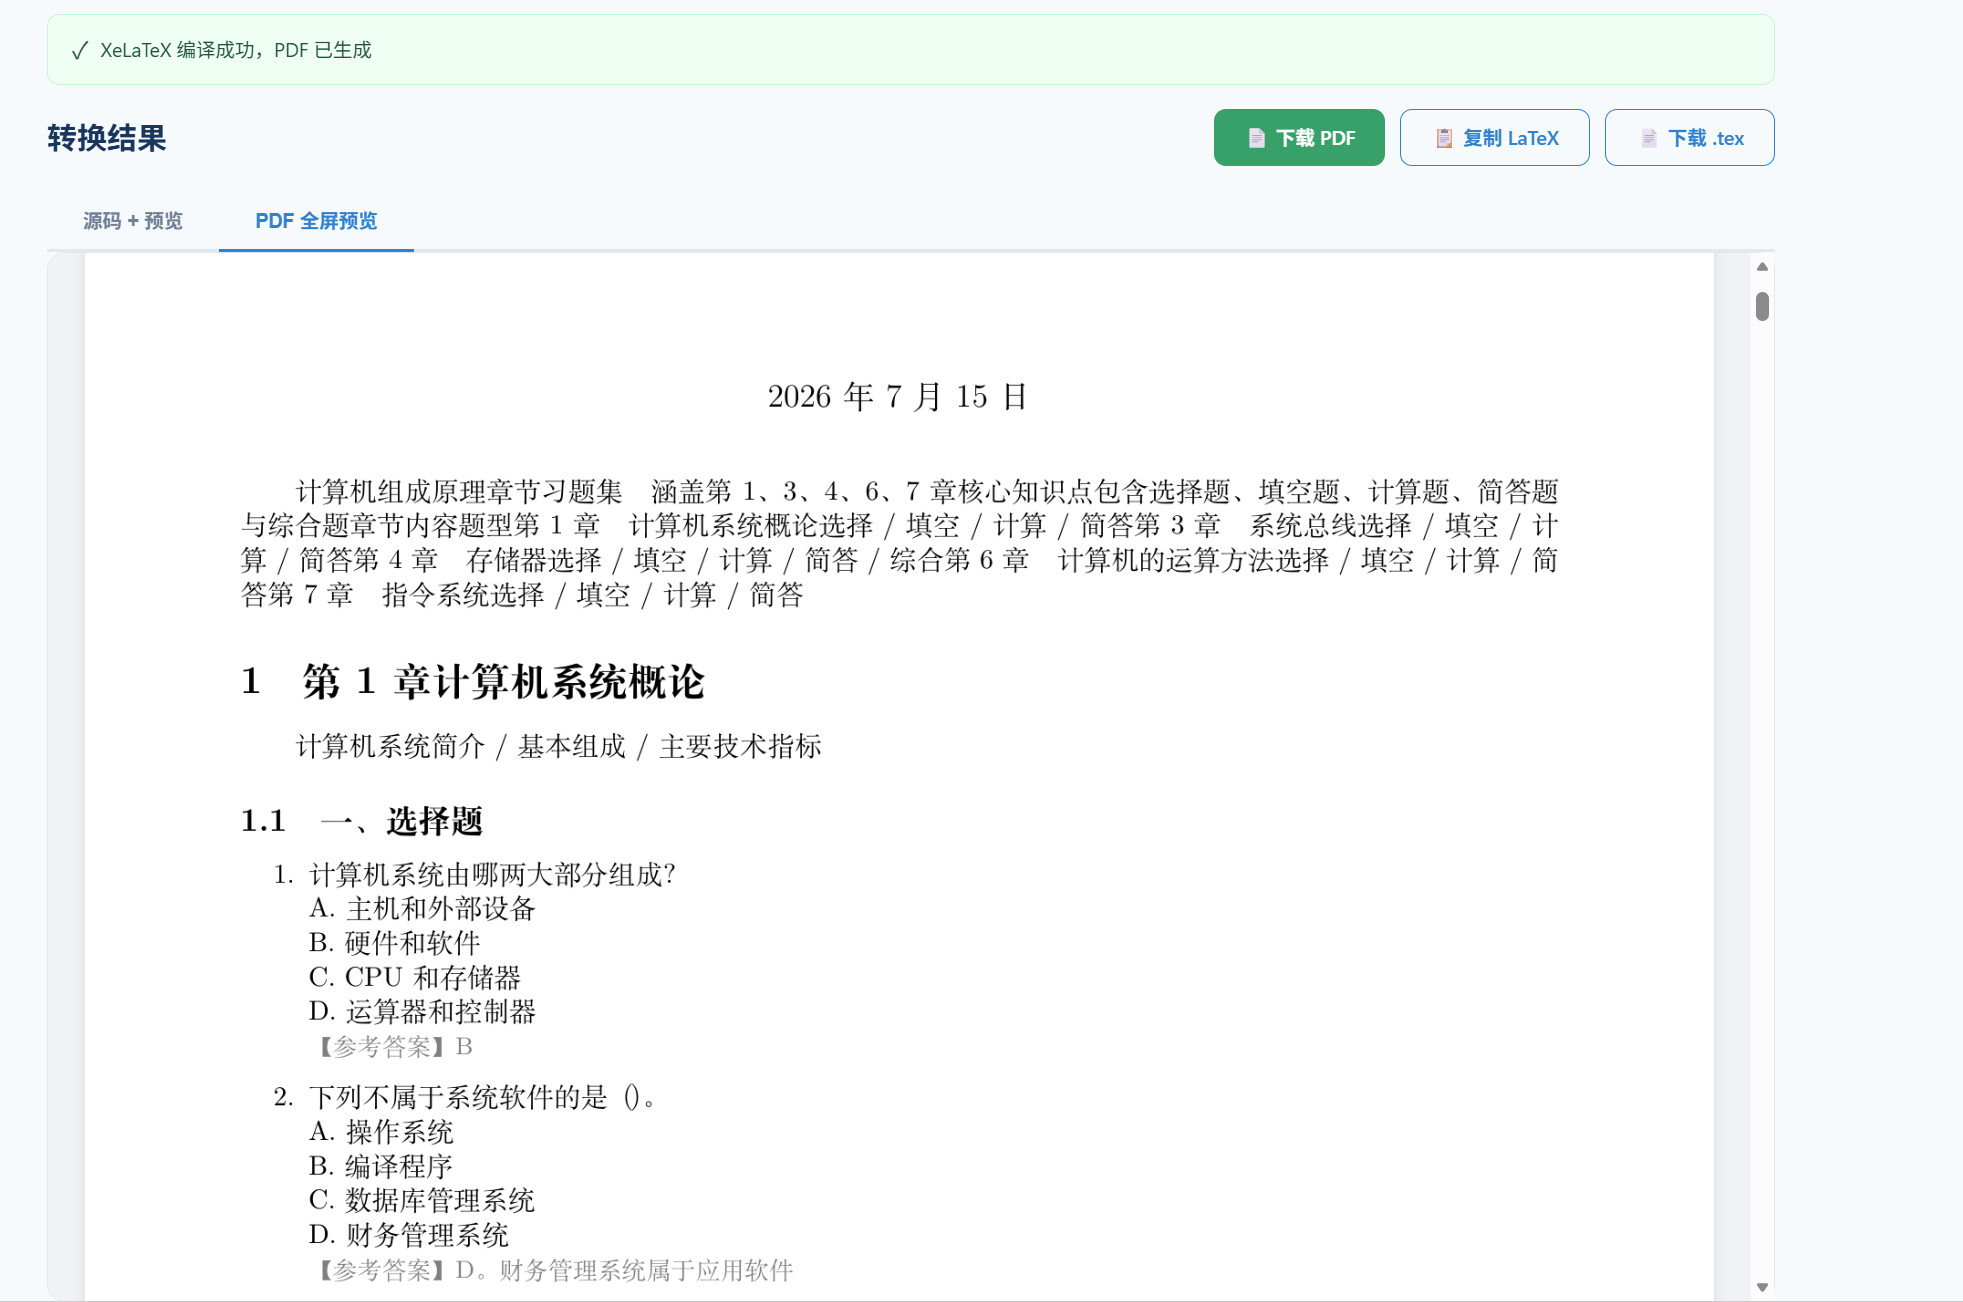
在线预览与一键下载:转换完成后支持 LaTeX 源码实时预览(语法高亮)、PDF 编译预览(XeLaTeX 编译,图片渲染避免水印)、一键下载
.tex源文件和编译后的 PDF 文件。
2. Demo 创作思路
灵感来源:在日常学习中,老师常以 PDF 格式发布课件。当需要对课件进行二次整理(合并多章节、添加个人笔记、重新排版打印)时,PDF 格式的不可编辑性成为很大障碍。手动用 LaTeX 重写公式和排版既耗时又容易出错。
想解决的问题:
- PDF 课件不可编辑,需要重新整理时只能手动重排;
- 课件中的数学公式(分数、积分、矩阵等)手动转写为 LaTeX 极其繁琐,容易出错;
- 不同场景(课堂听课、考前复习、笔记补充)对排版格式有不同需求,但 PDF 无法灵活调整;
- 现有的 PDF 转 LaTeX 工具(如 Mathpix)多为付费服务,对学生群体不够友好。
为什么做这个方向:LaTeX 是学术界和高校的通用排版语言,但学习门槛高、手动编写效率低。如果能自动将 PDF 转为 LaTeX 源码,用户就可以在源码层面自由编辑、重组、重新排版,大幅提升学习和科研效率。这是一个对高校学生有真实价值、同时技术上足够有挑战性的方向。
3. Demo 体验地址
公开访问链接:http://121.41.173.100:8080
打开链接后,上传任意 PDF 课件文件,选择模板,点击「开始转换」即可体验完整功能。
4. TRAE 实践过程
整个项目从零开始,完全使用 TRAE IDE 完成。以下是完整的开发流程:
第一步:需求架构与设计
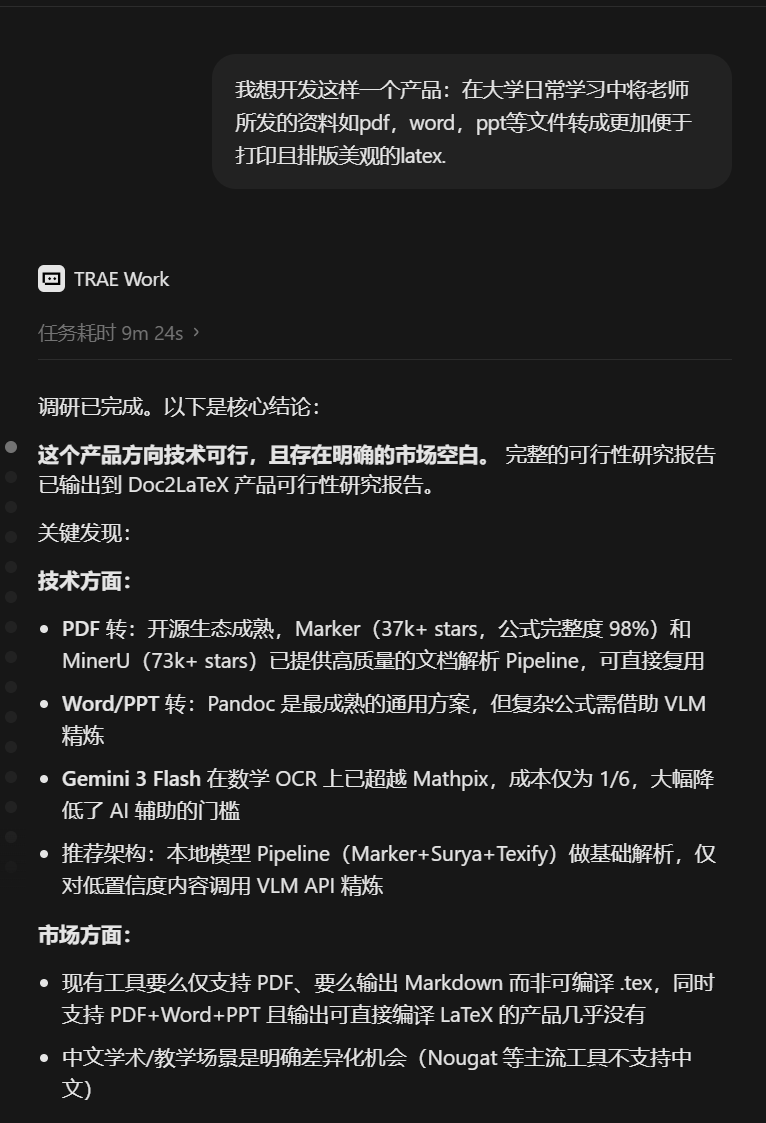
向 TRAE 描述了需求:「一个将课件 PDF 转为 LaTeX 排版文档的 Web 工具,支持多种打印模板」。TRAE 帮我分析了技术方案并确定了架构:
- 后端:Python + FastAPI,使用 PyMuPDF 逐页提取 PDF 文本、字体大小、加粗状态等格式信息
- 前端:原生 HTML/CSS/JavaScript 单页应用,无框架依赖,轻量高效
- 编译:XeLaTeX 编译 LaTeX 源码为 PDF,支持中文(ctex 宏包)
- 部署:Docker 容器化,systemd 服务管理
Session ID:1074693747247258:093d7513ca7e3a76a1992973f30d3ac9_6a5120599f9de36280d9c228.6a51205b4e3cdf0adb5b2db0.6a5120599f9de36280d9c229:TRAE Work CN.0.1.34.no_sid.no_ppe.T(2026/7/11 00:49:26)
第二步:直接生成 Demo
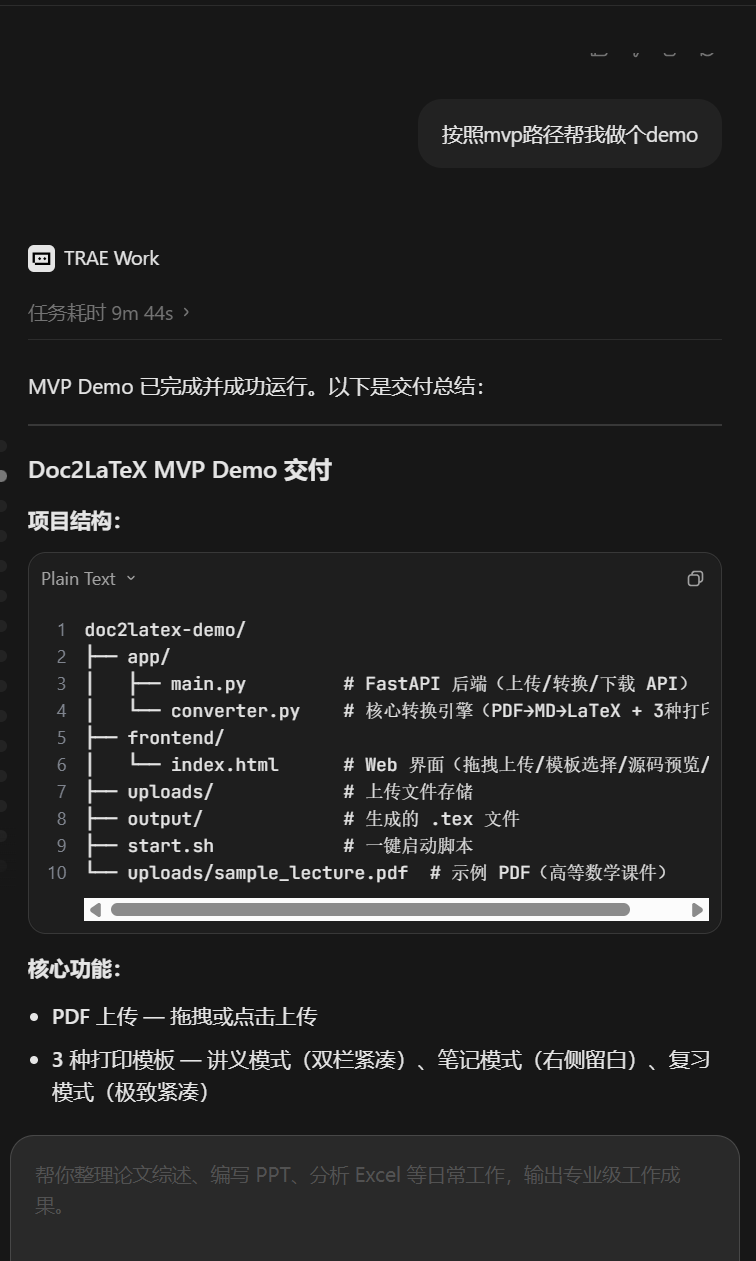
在架构确定后,TRAE 直接生成了完整的可运行 Demo,包括前后端全部代码。
后端核心引擎(约 1500 行 Python 代码):
- 数学公式检测与转换:建立了 15 组正则模式(涵盖函数符号、希腊字母、上下标 Unicode、数学运算符等)和 70+ 条符号替换规则,自动将 PDF 中的数学表达式转为 LaTeX 命令
- 智能标题识别:根据字体大小、加粗状态、文本模式(「第一章」、数字编号等)自动识别多级标题,正确归因父子层级关系
- 题型结构解析:专门处理选择题(题干与选项自动分行)、填空题、判断题等考试题型
- LaTeX 文档生成:根据选择的模板生成完整 LaTeX 文档(含导言区、文档类、宏包、几何参数配置)
- XeLaTeX 自动编译:转换完成后自动调用 XeLaTeX 编译为 PDF
前端界面(约 789 行代码):
- 拖拽上传:支持拖拽和点击两种方式选择 PDF 文件
- 可视化模板选择器:三种模板以卡片形式展示,带图标、名称和描述,点击即选
- LaTeX 语法高亮:自定义高亮引擎,区分命令、注释、花括号、数学环境等元素
- 双栏对比视图:左侧 LaTeX 源码、右侧 PDF 预览,支持「源码 + 预览」和「PDF 全屏预览」两种模式切换
- 转换历史记录:自动记录本次会话的转换历史,方便对比不同模板效果
Session ID:1074693747247258:675d5589104ee62c853672b8b514d961_6a5120599f9de36280d9c228.6a5123634e3cdf0adb5b2e9b.6a5123635a8ec826a7764bd8:TRAE Work CN.0.1.34.no_sid.no_ppe.T(2026/7/11 01:02:37)
第三步:修复 Bug 和修正错误
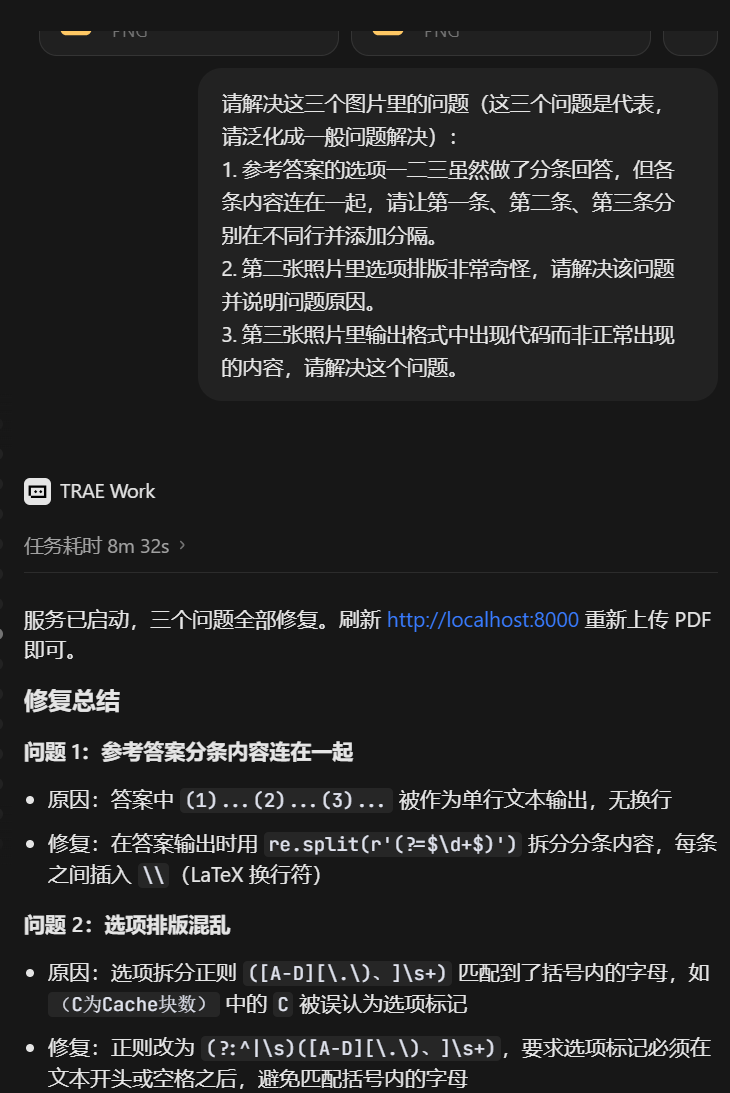
直接使用 TRAE 生成的初始版本后,在处理真实课件 PDF 时发现了多处格式问题。在 TRAE 的辅助下,逐一高效定位和修复:
- 答案格式修复:选择题答案中
[(1)]的额外标号被错误保留,通过优化正则表达式清洗逻辑解决 - 选项分行处理:选择题选项与题干混在同一行,通过解析选项结构调整为每个选项独立成行
- 子问题编号归因:
4.标号的内容为题干、5. 6. 7.为其子问题,通过优化标题识别逻辑正确归因层级关系 - 特殊字符处理:修复了
textasciicircum等特殊 LaTeX 字符的转义问题
【截图 - Bug 修复】:
Session ID:1074693747247258:9eb592fe43d33a7e8885853827c7c5a7_6a5120599f9de36280d9c228.6a560fd193c542a6c0cc91a3.6a560fd1bd19df054030228d:TRAE Work CN.0.1.34.no_sid.no_ppe.T(2026/7/14 18:39:18)
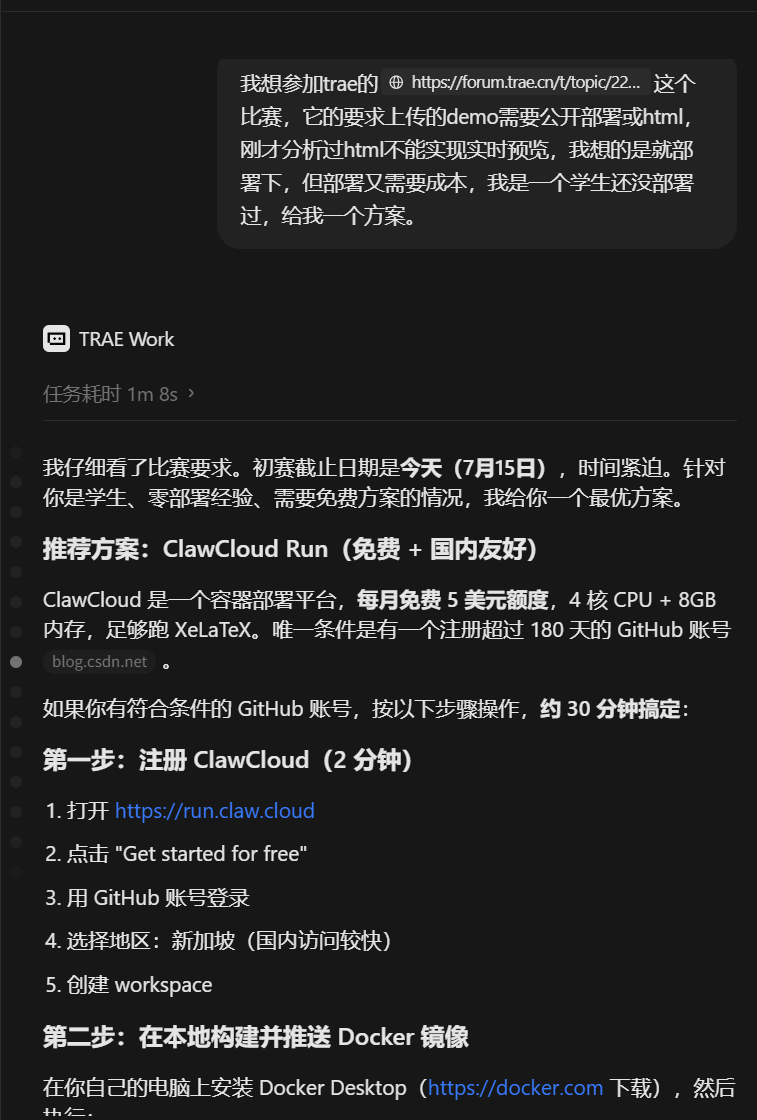
第四步:部署指导
项目完善后,在 TRAE 的指导下完成了线上部署:
- TRAE 编写了 Dockerfile(基于 Ubuntu 22.04,集成 Python 运行时 + XeLaTeX 编译环境 + 中文字体)
- 完成了阿里云 ECS 服务器的部署配置(systemd 服务管理、安全组端口开放)
- 部署过程中还发现了服务配置指向错误文件的问题(简化版 vs 完整版),在 TRAE 指导下修正了 systemd 的
ExecStart路径 - 最终项目成功运行在公网环境,可随时访问
【截图 - 部署指导】:
Session ID:1074693747247258:566abc061d1cf9ea7c3de8d5e3375e3d_6a5120599f9de36280d9c228.6a566719d02210703f849e62.6a5667191f62baf88966ab69:TRAE Work CN.0.1.34.no_sid.no_ppe.T(2026/7/15 00:44:15)