《字灵绘本冒险》:当汉字变成魔法咒语——四岁孩子喊出"船",河面上真的漂来了船
一个四岁的孩子对着屏幕喊"船"。
河面上,一艘小船真的飘了过来。
这不是动画特效。是识字。
字,从来都不是用来选对答案的。字是钥匙,是咒语,是孩子亲手推开故事大门的那只手。
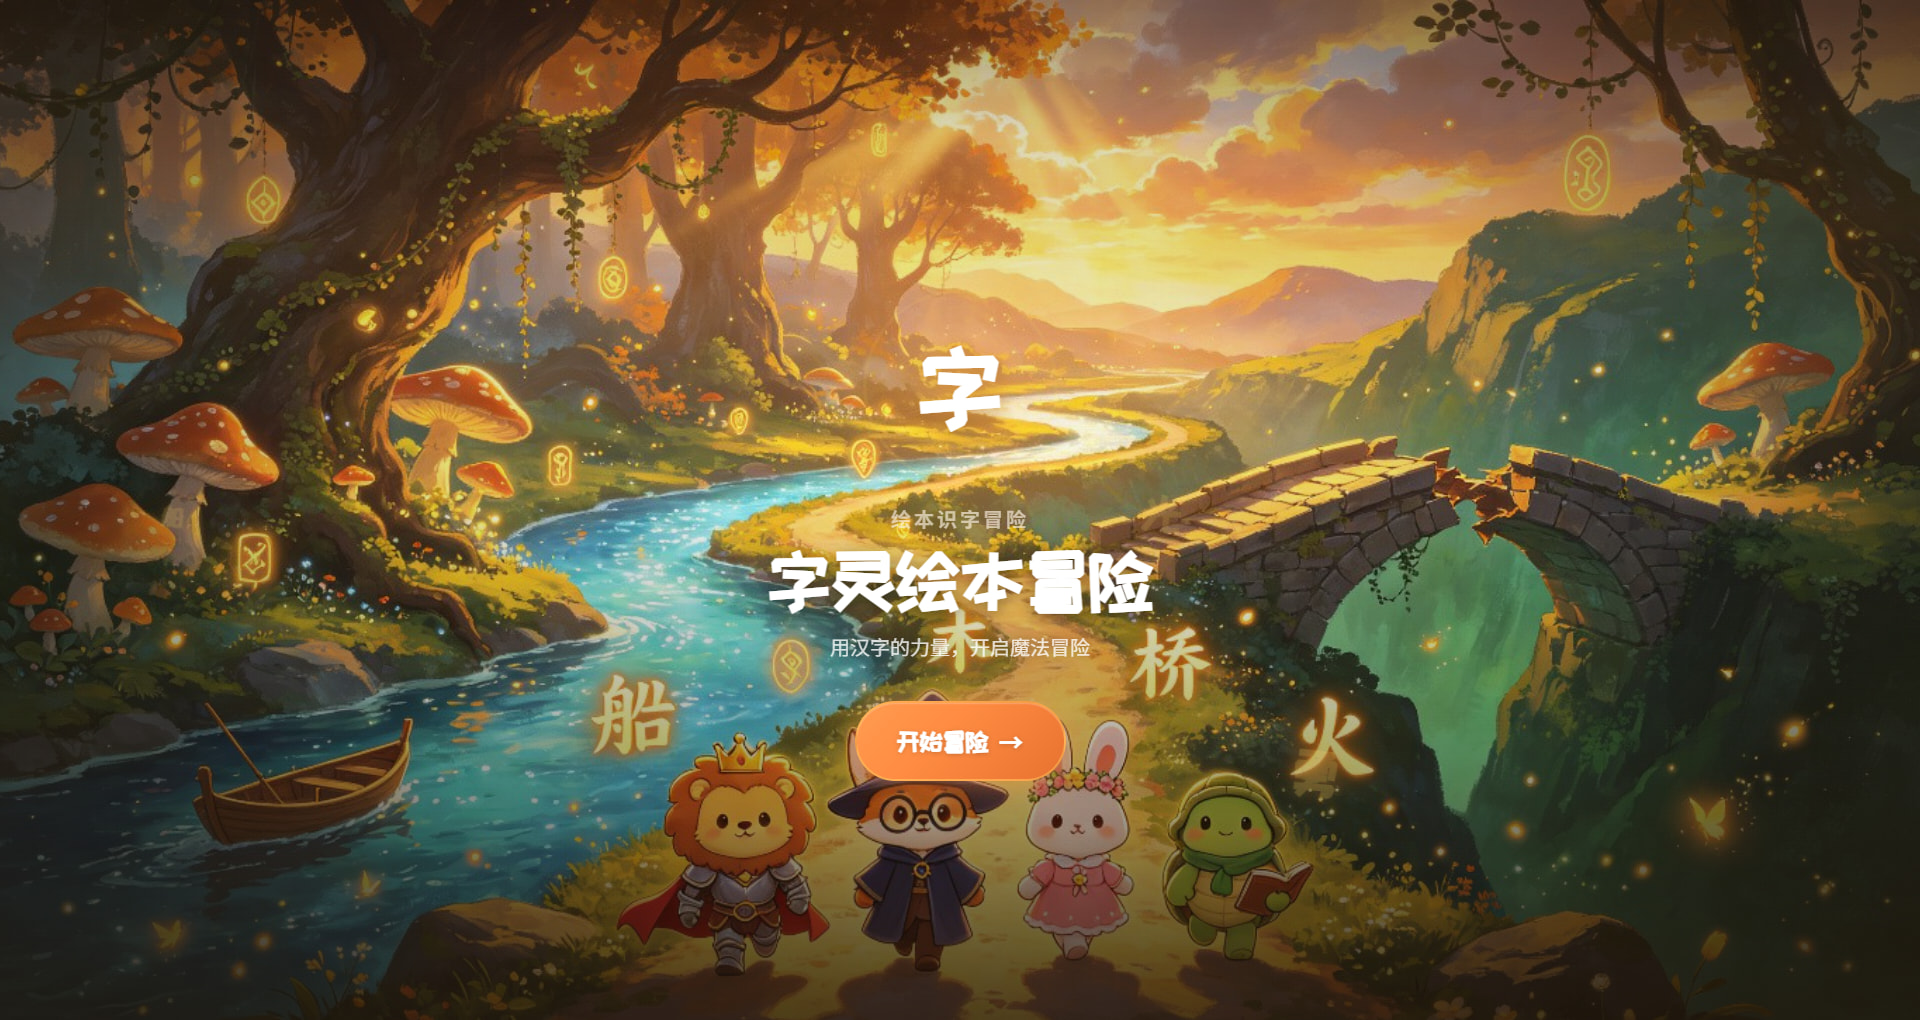
demo体验地址
魔搭
Cloudflare Pages
Github Pages
写在前面 
大家好。我是一个写了十多年后端的工程师,前端懂点皮毛,游戏——这是我这辈子做的第一个游戏。
生活里我是一个四岁男孩的爸爸。儿子正在认字的年纪,他在电视和平板上也用过一些识字APP,用下来总觉得哪里不对:每个字都是一关,他只盯着他喜欢的关卡玩,到了小测验又开始瞎选,字认了不少,积分拿了不少,但拿来一本书,问他这个词是啥意思,他还是说不知道。
这就是我做这个东西的起因。一个爸爸的吐槽。
一开始我脑子里只有一个模糊的念头:能不能让孩子喊一声字,屏幕里真的有东西回应他?就像魔法一样。剩下的我什么都不会——不会画水彩,不会做帧动画,不会搭游戏引擎,甚至连Svelte都是现学的。
整个Demo是我和TRAE一起做出来的,过程大概是这样:
- 先把想法聊清楚:最开始我只有那一个模糊的念头,我就一句句讲给它听——我想让字变成咒语,我不想让孩子做选择题,我怕排行榜把我儿子的兴趣磨没了。它陪着我头脑风暴,把一团混沌磨成了一个清晰的产品概念。
- 做调研、写规格:然后我们一起读竞品(洪恩、悟空、Duolingo ABC),翻儿童心理学论文(正字法意识、具身认知、自我决定论),对照义务教育语文课标,磨出了一份完整的需求规格书。我一个后端工程师,以前从来不知道做个儿童产品还要管这么多东西。
- 拆任务,而不是上来就写代码:拿到PRD我本来想直接开干,TRAE先给我用Wayfinder拆成了任务图——12个子任务,17条依赖关系,架构决策堵在最前面,不先定渲染模型,资产生成和UI都没法开工。我自己做肯定上来就写代码,写到一半返工是大概率事件。
- 把每个决定逼问到墙角:关键决策我都用Grilling逐项逼问。PRD里写的"CSS绘制场景"和"单文件inline JS",听起来都很轻量很合理对吧?逼问完两个都推翻了——CSS画不出统一的水彩手绘风格,单文件写到一百多行状态、音频、UI就全搅在一起了。最后定了PNG精灵图集+Svelte5+TypeScript,这些决定后来都记成了ADR(架构决策记录)。
- 然后才开始写代码:从项目骨架、状态管理、音频队列,到场景一的大河渡河——写着写着发现场景二逻辑大同小异,干脆抽出了一整套可复用的渲染内核,以后加新场景只改JSON剧本不用动代码。整个过程每推进一步都跑
svelte-check,保持零错误零警告往前走。
中间踩的坑一只手数不过来:文生图API直接发HTTP请求只能拿到176KB的占位图,调了半天以为是bug,最后才发现是异步渲染,要用Playwright模拟浏览器打开等它加载完才能拿到完整图片;Svelte 5的runes是新东西,$state在普通.ts文件里用不了,要改成.svelte.ts扩展名,这个小问题卡了我十几分钟;只是想把一个候选字从"桥"换成"冰",连锁改了八个文件。
说实话,没有TRAE的话,这个Demo我根本做不出来——不是"做得慢一点",是真的做不出来。一个后端要从零搭一个带帧动画、语音识别、数据驱动场景的游戏,跨的领域太多了。但它不是替我写代码这么简单,它帮我把"我想做什么"这件事,一步步磨成了"我知道该怎么做"。
一、作品简介
这是什么:一款 AI 驱动的儿童动态绘本识字游戏。给 4–8 岁识字敏感期的孩子,以及愿意蹲下来陪他们玩半小时的家长。
市面上的识字 App 把字做成了选择题。孩子点对了,打个勾,给个金币,下一题。
这不是孩子笨。是产品把识字教成了集邮。
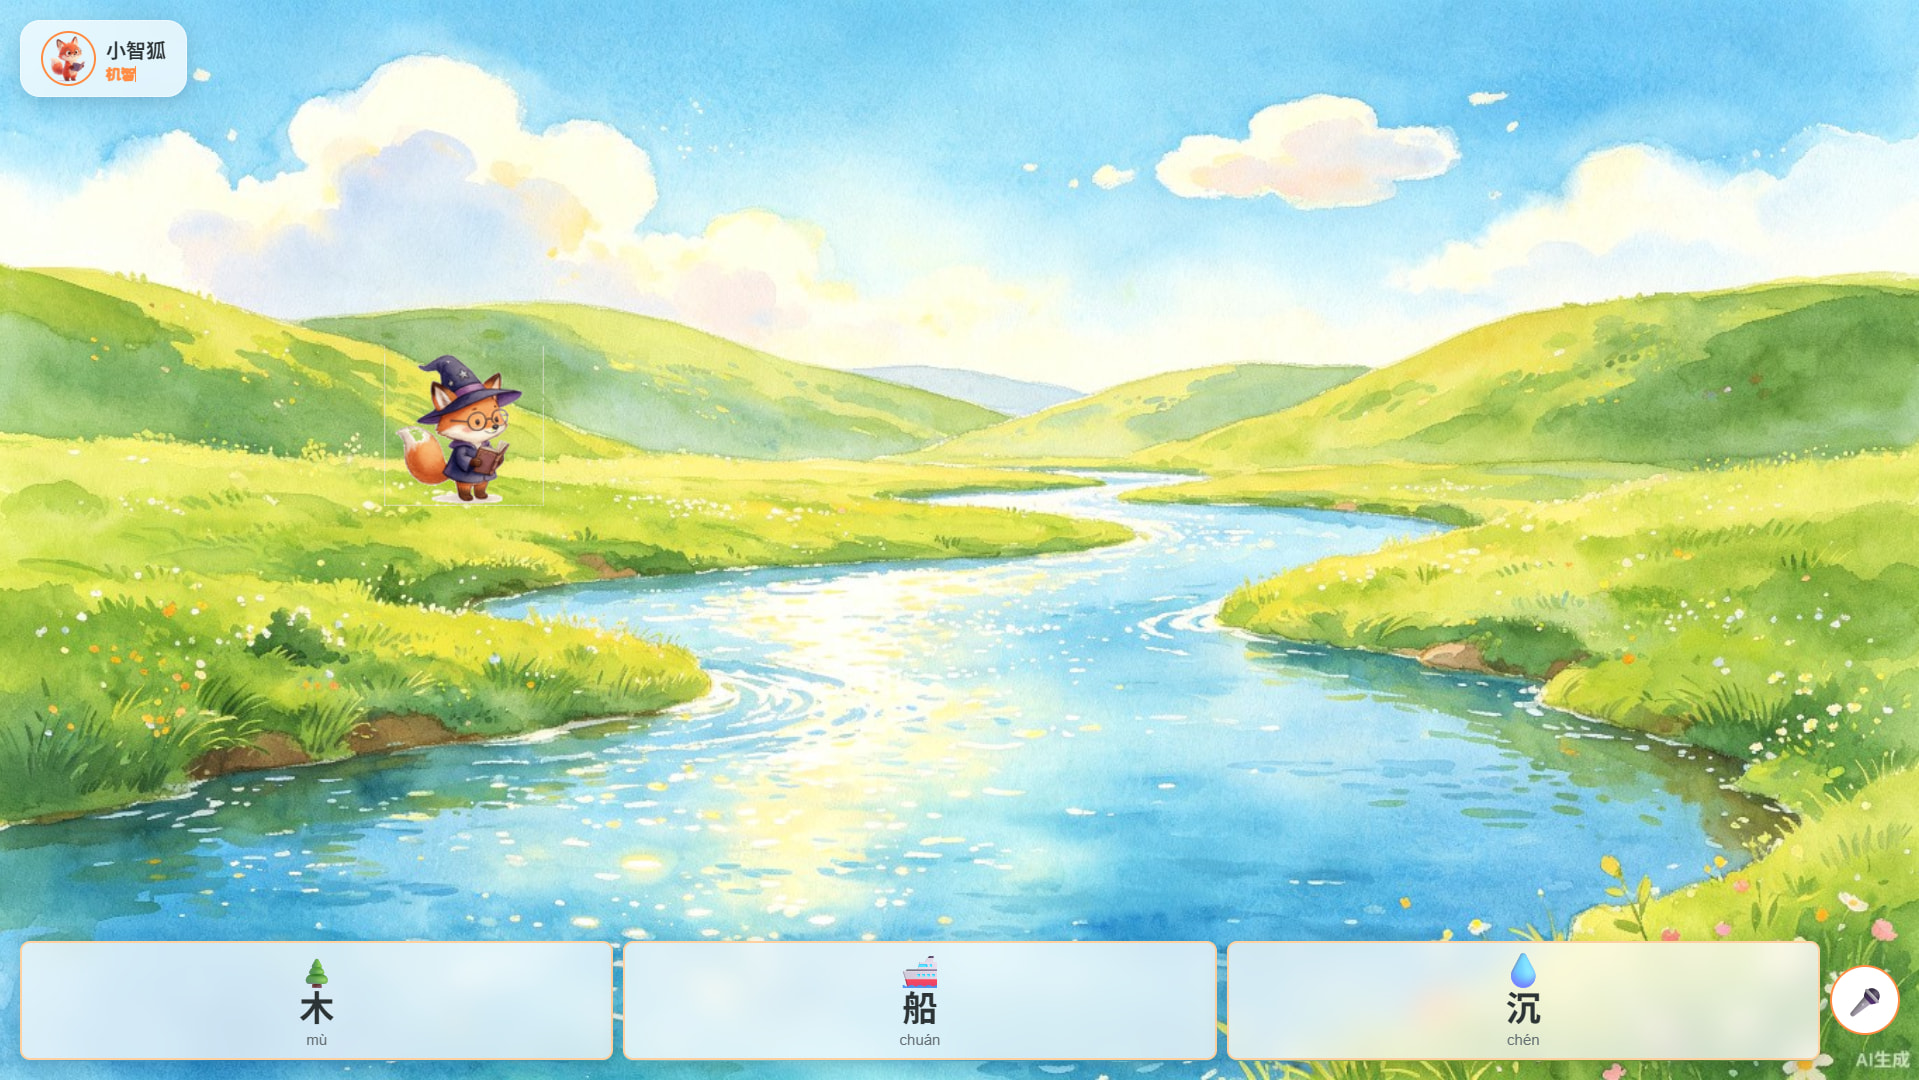
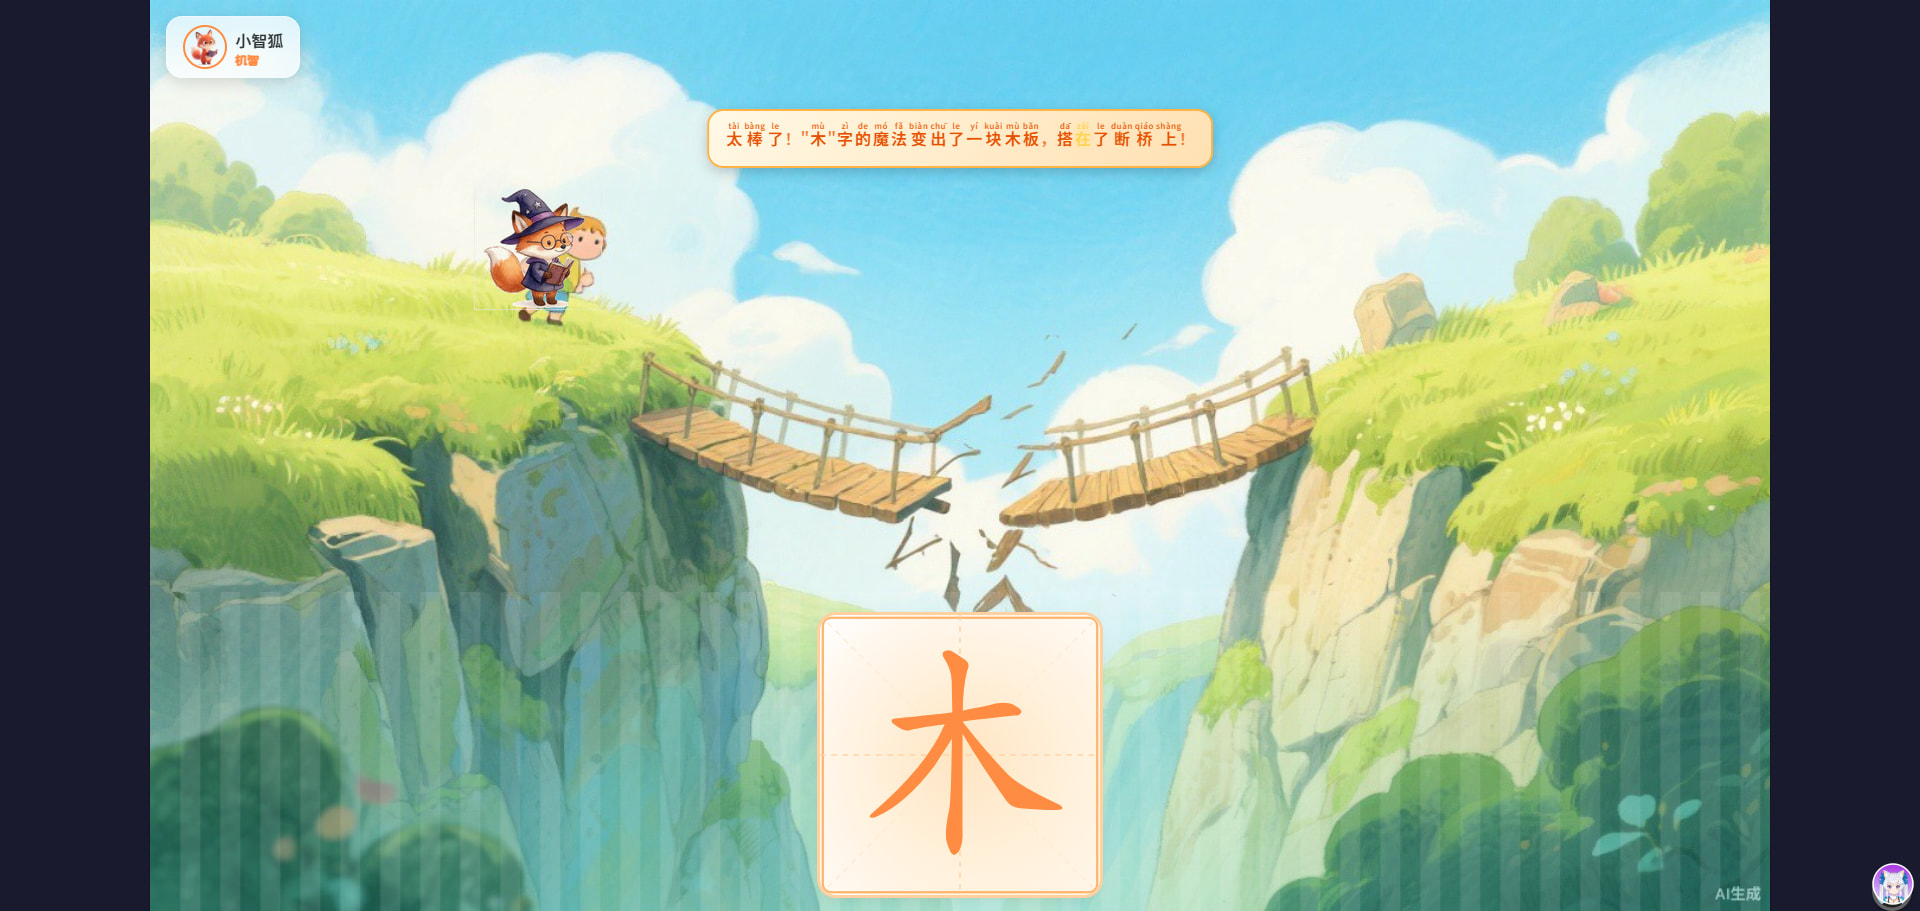
我们做的事情不一样:汉字是改变世界的魔法咒语。故事走到大河拦住去路,屏幕上浮出三个汉字——【木】【船】【沉】。孩子对着麦克风喊出"船",船就真的从水面漂过来,载着小狮子过河;喊"沉",一块石头扑通落水,溅主角一身水花。没有打叉,没有"答错了",世界直接用剧情回应孩子的选择。错误本身,就是字义教学。
不是孩子围着课程转,是故事围着孩子转。
面向谁:
- 核心:4–8 岁正在认字的孩子(学前中班到小学二年级)
- 共同用户:每天愿意陪 20 分钟、想知道"孩子到底学会了什么"的家长
- 这一次比赛 Demo:点开即玩的纯静态网页,任何设备、任何浏览器,不需要注册,不需要授权麦克风就能完整体验
核心功能:
1. 念字、写字,才算真的会
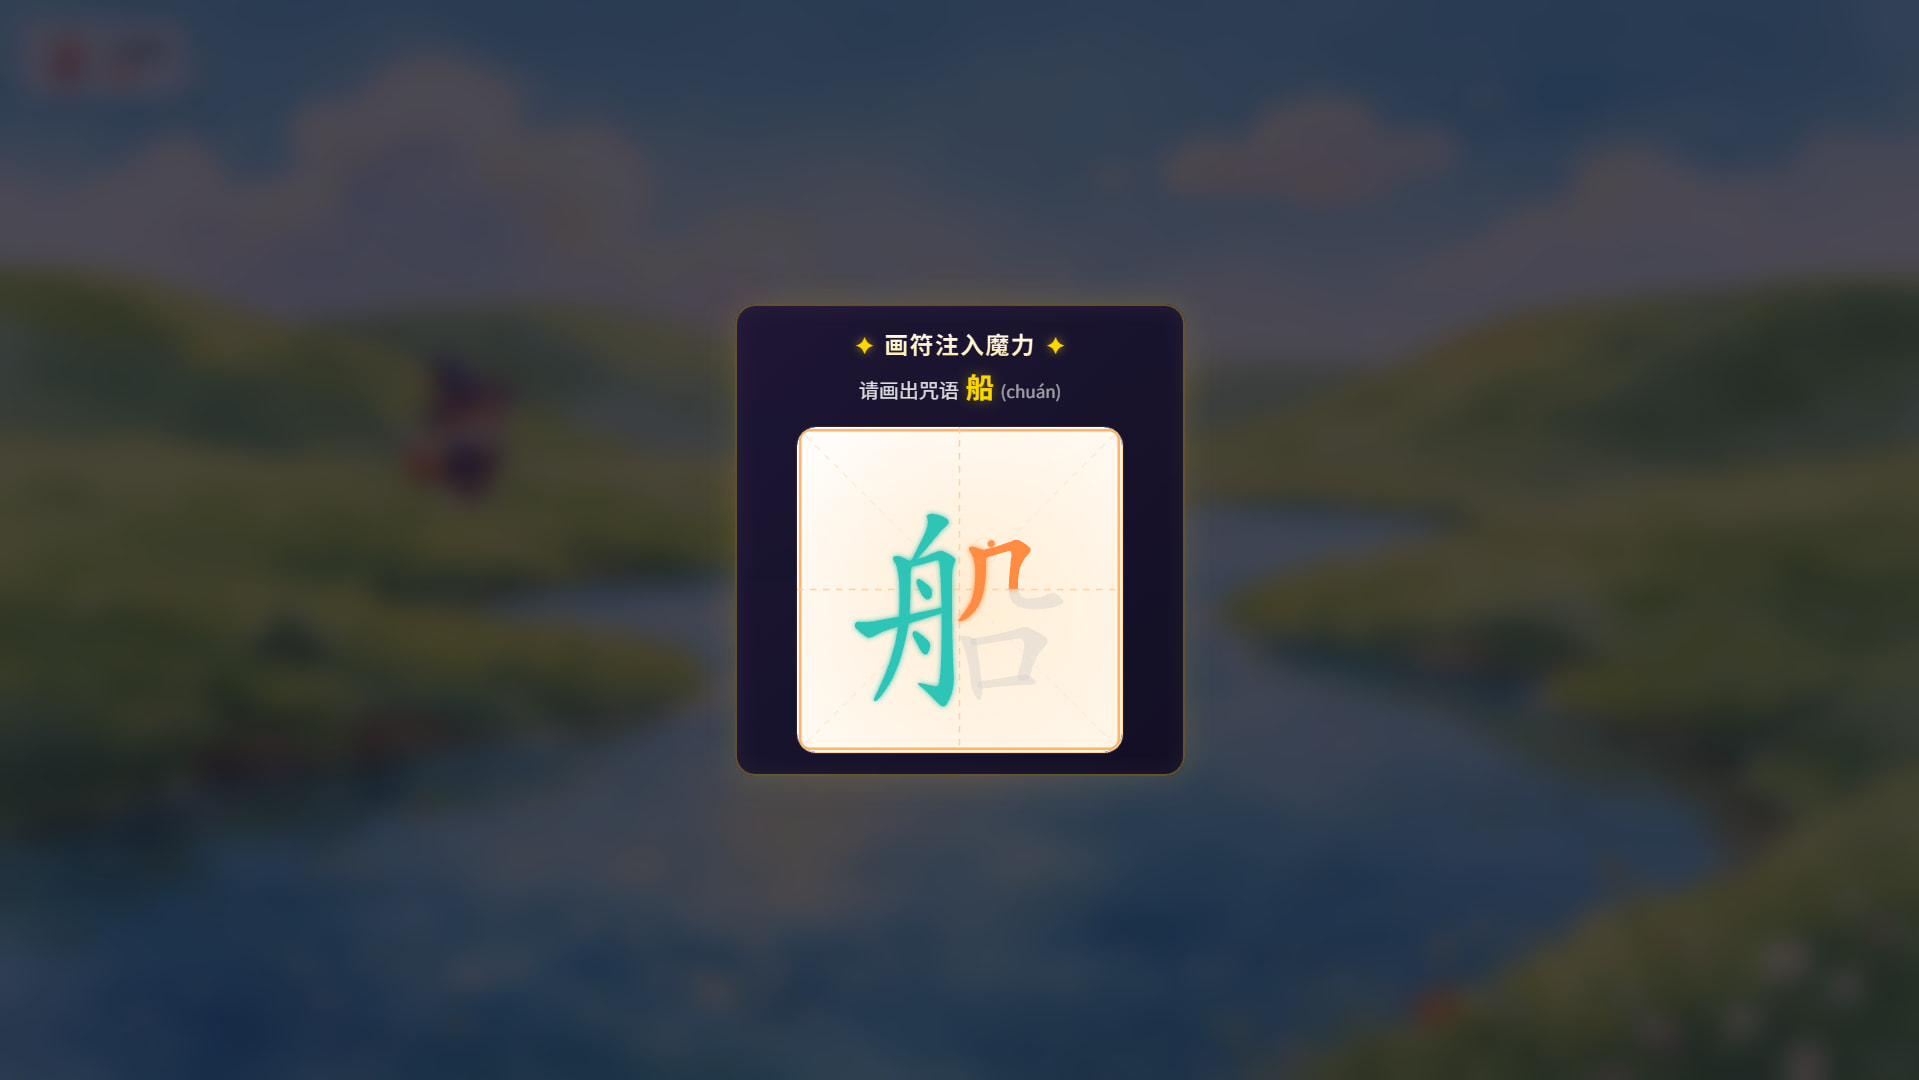
不做点选选择题。要么对着麦克风把字念出来,要么用手指在屏幕上把字写出来——浏览器端侧语音识别,不需要联网,童声方言做容错;手写只看骨架拓扑和笔顺逻辑,不逼四岁孩子写笔锋。说出来、写出来,字才是你的。
2. 每个孩子的故事,长得不一样
AI 动态故事引擎盯着孩子的识字图谱。该复习"火"字了,今天的剧情里就会遇到需要"火"才能解开的谜题;新学"桥"字,断桥就刚好横在面前。同一个故事,每个孩子遇到的关卡、需要的字、得到的反馈,全都是为他一个人编排的。上一代产品是一千个孩子走同一条路,我们是一条路为一千个孩子长出一千种分叉。
3. 选错了?世界会给你看答案
选"沉"不会跳出红叉说"错了再试"。石头直接沉底,溅主角一身水,孩子笑完就记住了"沉"是什么意思;选"飞",主角真的飘起来两米然后摔回地上。每一个错误选择,都会生成符合该字含义的喜剧性剧情后果。孩子不是在"排除错误选项",是在亲自试错每个字的重量。
4. 孩子是玩家,也是作者
每闯过一关,游戏自动生成一页属于这个孩子的绘本——记着他今天用了什么字、做了什么选择、造了什么句子。攒够几页就是一本专属绘本,可以翻,可以导出 PDF 打印。更棒的是"施法造句"时刻:孩子从自己已经认识的字里挑几个拼出一句话,AI 实时把这句话演成动画。识字的终点不是认了多少张字卡,是用字表达自己。
5. 给家长看的,不是打卡天数
家长端收到的报告不会写"今日学习 15 分钟,认识 3 个字"。它会写:"今天孩子用’船’字渡过了河,'桥’字犹豫了 8 秒,最后靠图像提示想起来了——建议今晚读绘本时,和他一起找找书里的’桥’字。“每个字按"认—听—说—写—用"五个维度分别记录掌握度,不是简单的"会/不会”。会认不一定会读,会读不一定会写,家长看得清清楚楚。
6. 我们明确不做
不做排行榜。不做连胜打卡。不做抽卡。不做任何形式的广告。不做诱导孩子"再玩五分钟"的成瘾机制。低龄儿童的内在动机,经不起竞争性激励的消耗。这件事写在产品红线上,不会改。
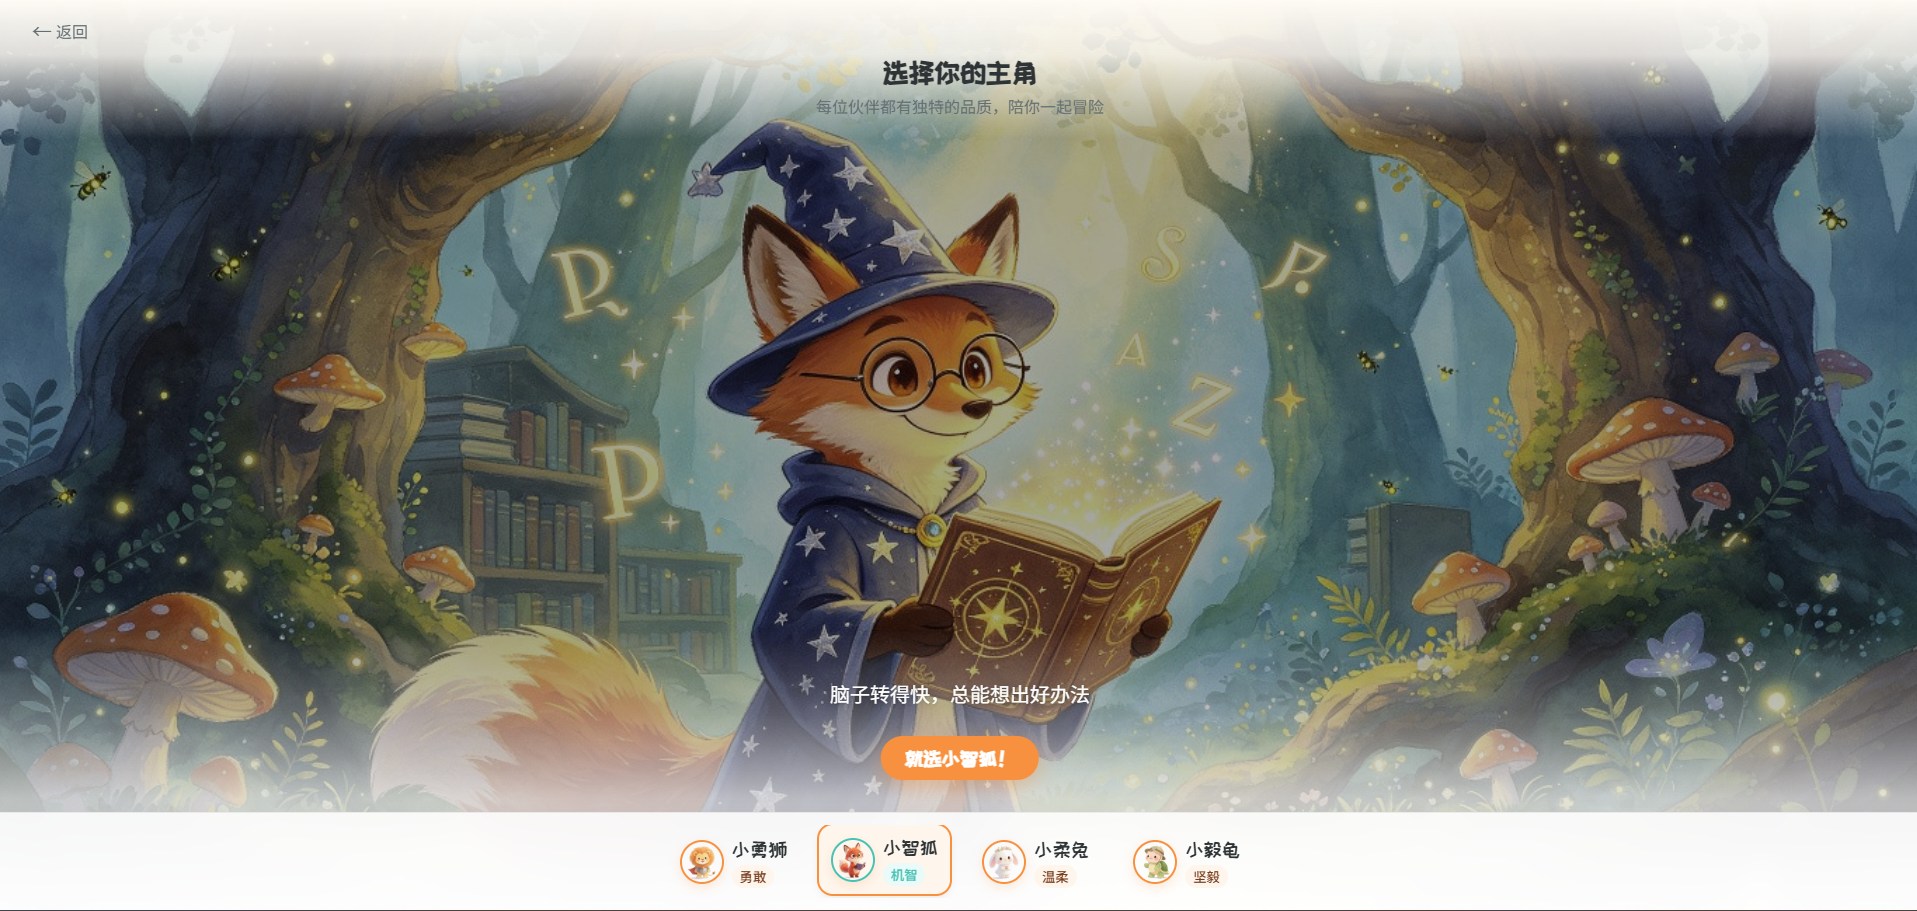
四个主角任选其一:小勇狮、小智狐、小柔兔、小毅龟。每个角色都有完整的帧动画,选谁谁就陪孩子走完整个冒险。
二、Demo 创作思路
我们不同意上一代识字产品的三个假设
洪恩识字、悟空识字、Duolingo ABC……我们调研了一圈,发现它们共享三个没说出口的假设:
- 所有孩子走同一条路。内容全预制,顺序固定,识字向自主阅读过渡弱。
- 点一下就算学会了。交互以点击选择题为主,"说出来、写出来才算会"没落地。
- 靠连胜和排行榜驱动。竞争性外部激励,侵蚀低龄孩子的内在动机。
AI 时代的机会是——让内容围着孩子转,而不是孩子迁就课程。
我们据此列了五条转变,作为产品的基本信念:
| # | 上一代 | 我们想做的 |
|---|---|---|
| 1 | 固定课程推着孩子走 | 故事被孩子的识字图谱实时改写 |
| 2 | 点击选择题为主 | 说出来、写出来才算会 |
| 3 | 学习报告 = 打卡天数 | AI 生成叙事化成长报告 |
| 4 | 孩子是内容消费者 | 孩子是作者:用已学的字"施法造句" |
| 5 | 学习困在屏幕里 | 屏幕连接现实:拍照寻字、亲子共读 |
要解决的问题
说一个真实的场景。
小满五岁,妈妈给他报了某识字 App,三个月认了两百个字。
妈妈很欣慰,直到有一天带小满去超市——
货架上写着"牛奶"两个字,小满盯着看了十秒,说"这两个字我都认识,但放在一起我不知道是什么。"
这不是个别现象。4–8 岁是正字法意识和部件意识发展的关键期,但市面的识字产品普遍存在三个断层:
- 字与词的断层:认了单个字,组合在一起就不认得了
- 认与用的断层:会认字,但不会在句子里用,更不会主动说
- 学与读的断层:刷了几百张字卡,还是没法自主读一本简单的绘本
根源在于:上一代产品把识字当成了目的本身。
而我们相信,识字的终点是自主阅读和表达,不是"认了多少张字卡"。
字是钥匙,不是收藏品——孩子需要知道这把钥匙能打开哪扇门。
为什么先做纯静态 Demo
完整愿景很大,但比赛交付,必须在评委面前零故障。
所以我们做了一个取舍:
用纯静态 Demo,先验证最核心的一条循环——"识字 → 施法 → 剧情推进"能不能让孩子第二天主动要求再玩。
剧情、角色、道具、TTS 配音,全部在开发期预生成。浏览器端纯前端运行,Cloudflare Pages 静态分发。
换来三个确定性:秒级加载、永不宕机、零 API 账单。
Demo 是产品愿景的垂直切片,不是一次性玩具——剧本 JSON 协议、精灵图集模型、Audio Manager 队列,都按可演进架构落地。以后接 Cocos 客户端、接自建后端,原样复用。
从 Demo 到正式产品:我们的三步路线图
这个双场景 Demo 只是第一步。我们规划了三个阶段,从比赛 Demo 逐步演进为完整的 AI 识字产品:
阶段一:比赛期(现在)—— 验证核心循环
就是你现在看到的这个纯静态 Demo。两个场景、四个角色、一条剧情线。
目标只有一个:验证"识字施法 → 剧情推进"的循环成立。
阶段二:客户端重建 —— 接入 AI 动态故事引擎
用 Cocos Creator 重建客户端,接入真正的 AI 能力:
- 动态挖空:同一个故事,每个孩子遇到的字不一样——系统根据孩子的识字图谱,实时决定这一关该复习什么字、学什么新字。该复习"火",剧情里就需要"火"来解谜。
- 五维掌握模型:每个字按"认—听—说—写—用"五个维度分别记录掌握度,不是简单的"会/不会"。会认不一定会读,会读不一定会写,每个维度单独追踪。
- 喜剧性错误反馈:选错字不打叉,AI 实时生成符合所选字含义的滑稽剧情——选"沉"就石头落水,选"飞"就主角飘起来。错误本身就是字义教学。
- 我的绘本集:每局游戏自动生成一页专属绘本,记录孩子学了什么字、做了什么选择、造了什么句子,可以翻,可以导出 PDF 打印。
阶段三:后端就位 —— 完整产品上线
自建后端,账号、图谱云同步、家长端全部就位:
- 叙事化成长报告:家长看到的不是"今日打卡 15 分钟、认识 3 个字",而是"孩子今天用’船’字渡了河,'桥’字犹豫了 8 秒,建议今晚读绘本时找找’桥’字"。
- 间隔重复调度(SRS):按遗忘曲线安排复习,但复习不做字卡速刷——而是把到期的字藏进新的故事里,孩子以为在玩新关卡,其实在复习。
- 孩子当作者:用已掌握的字"施法造句",AI 把孩子的句子实时变成动画绘本页。从"学字"到"用字创作",打通识字到表达的最后一步。
- 有边界的 AI 伴学:向导精灵明确自称"字灵"而不是"朋友",不诱导依恋、不套取个人信息、对话仅限学习情境。保护孩子,比"更像人"更重要。
- 明确不做清单:不做排行榜、不做连胜、不做抽卡、不做任何形式的广告。写入产品红线——低龄儿童的内在动机,经不起竞争性激励的消耗。
三阶段下来,Demo 的代码可能会全部重写,但剧本协议、精灵图集、提示词模板、TTS 音频——这些内容资产会一路复用。
代码可弃,内容资产不弃。
三、Demo 体验地址
魔搭
Cloudflare Pages
Github Pages
四、TRAE 实践过程
整个开发流程,我们深度使用了 TRAE 的以下能力:
- Wayfinder技能 任务拆解:把 PRD 拆成带依赖关系的任务图谱,搞清楚先干什么后干什么
- Grilling技能 需求逼问:对关键设计决策逐项拷问,避免拍脑袋
- Domain Modeling 领域建模:沉淀 ADR(架构决策记录)和术语表,让团队语言统一
- 代码生成与调试:从项目骨架到业务逻辑,边写边测边修
- 多轮迭代式开发:每个任务一个 session,
svelte-check零错误推进
整个开发不是线性推进的,是被四个关键决断塑造的。
每个决断之前,我们都有一个"想当然"的答案;每个决断之后,我们都改了方向。
决断一:12 张任务票,17 条依赖——先干什么
拿到 PRD 的第一反应是"开始写代码"。
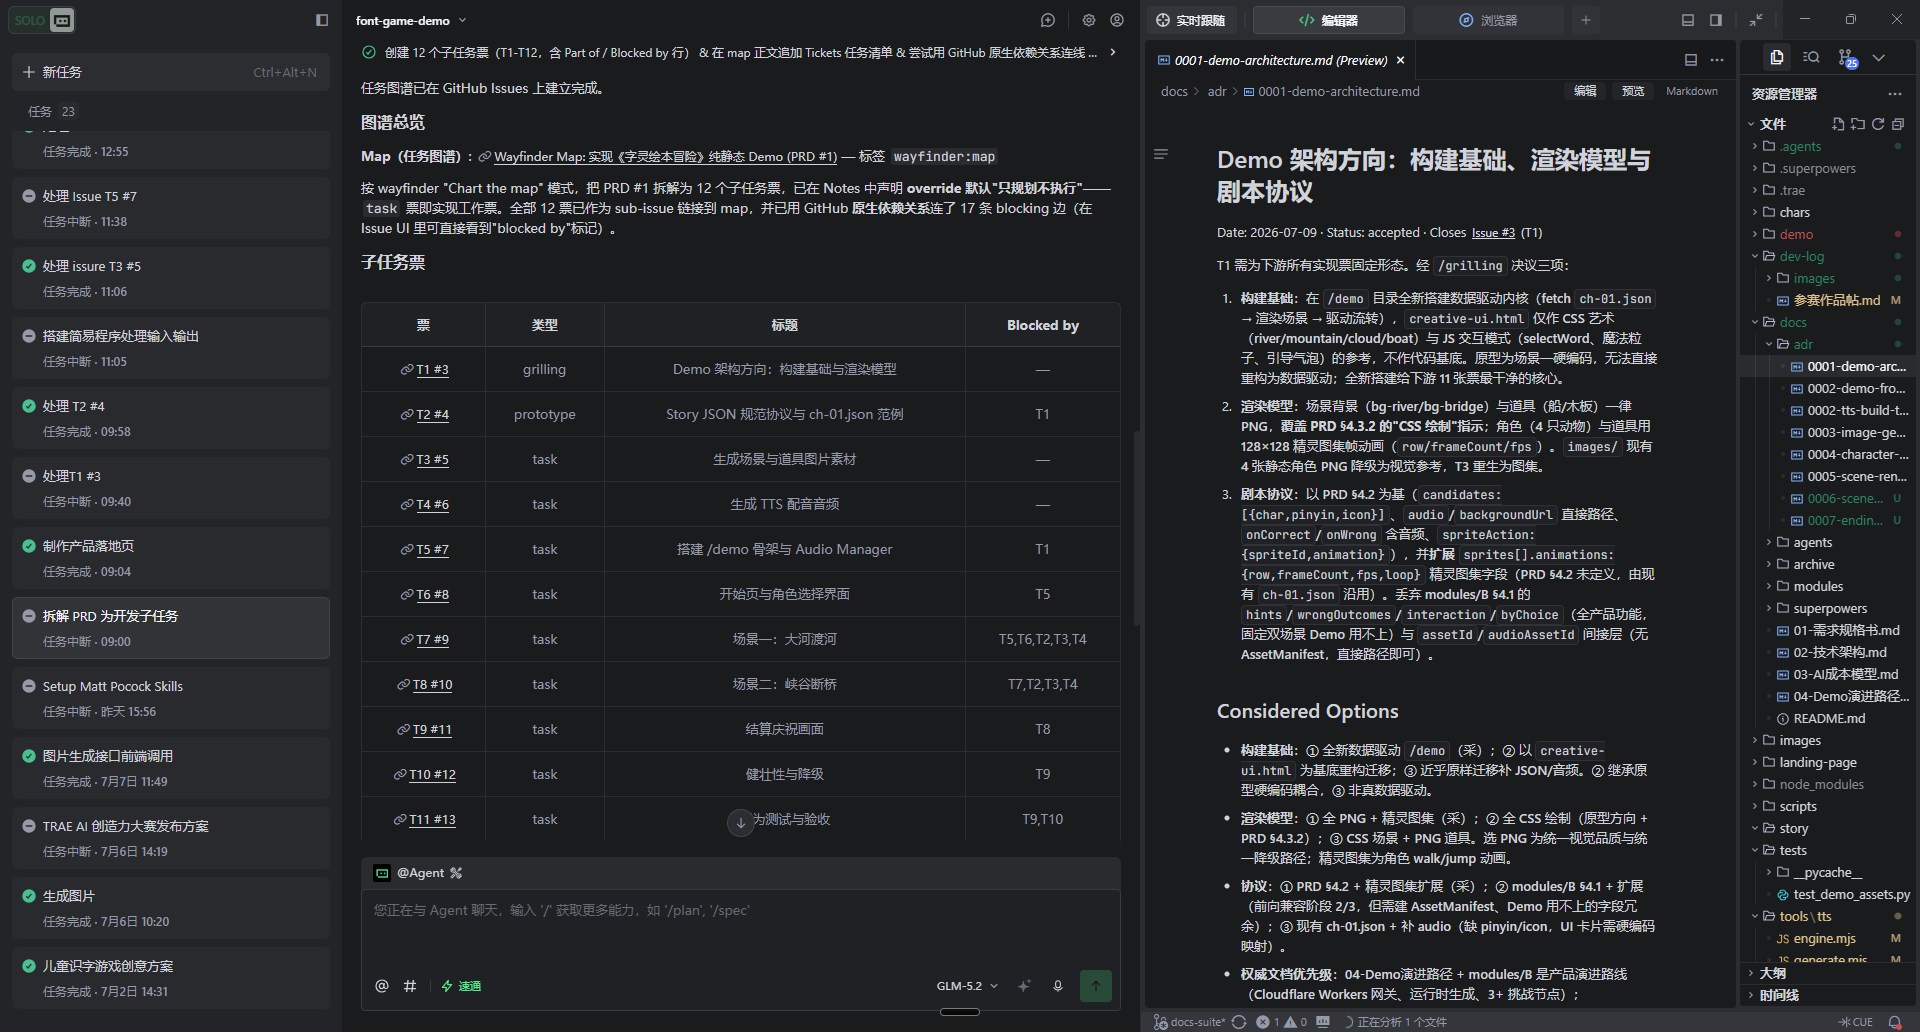
但我们停了一下,先用 /wayfinder 把 Issue #1 的 PRD 拆成了任务图。
拆完发现是 12 个子任务、17 条阻塞依赖,标在 GitHub Issue #2 里。
架构决策(T1)堵着最宽的下游——不先定渲染模型,资产生成和 UI 实现都没法开工。
如果凭直觉上来就写代码,后面大概率要返工。
Session ID:
.3489177922189940:e2e5d6f4df6188d63020b606a55067d6_6a4e24c16d9490241303f1f2.6a4e24f36d9490241303f222.6a4e24f31ad544c718c2031a:Trae CN.T(2026/7/8 18:22:43)
决断二:CSS 画场景,还是 PNG 精灵图?
踩过的坑:一开始差点按 PRD 直接开干 CSS 场景,写了一半发现不对。
PRD 里写的是"CSS 绘制场景"。听起来很轻量,很合理。
然后我们用 /grilling 逐项逼问,问出来两个之前没想到的问题:
- CSS 绘制能保证水彩手绘风格的视觉一致性吗?不能。每个角色每个场景都要重新调 CSS,调完还不统一。
- 角色的 idle / walk / jump 动画用 CSS 画,成本多高?高到不可接受。14 帧动画,CSS 要写几百行。
于是有了 ADR-0001:全 PNG + 128×128 精灵图集。
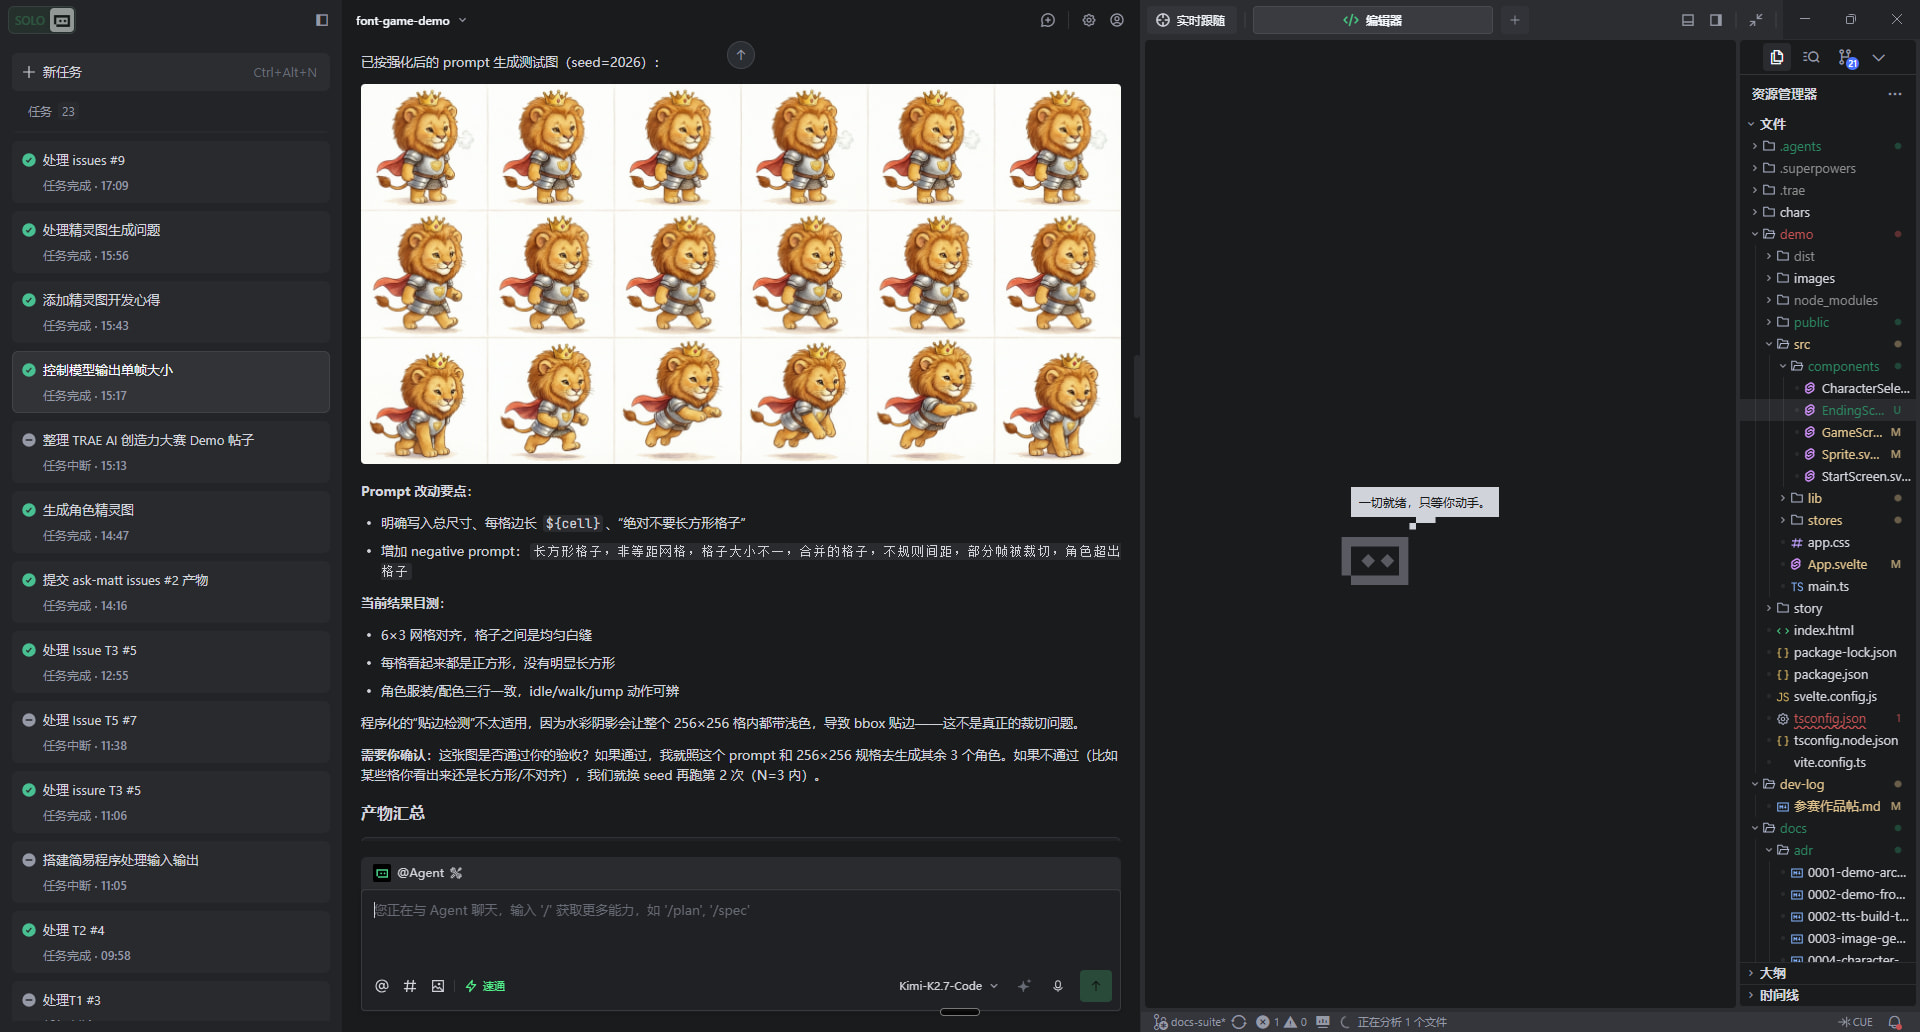
T3 资产生成的范围,也从 PRD 说的 4 张图,扩大到了 8 项资产——2 张场景背景 + 2 张道具精灵图 + 4 张角色精灵图集。
又踩了一个坑:text_to_image API 直接 HTTP 请求只能拿到 176KB 占位图,调了半天以为是代码 bug,最后才发现这个 API 是异步渲染的,必须用浏览器打开等它加载完。最后用 Node.js + Playwright 模拟浏览器访问才拿到完整图片。
Session ID:
.3489177922189940:f871cef15c2cf59757fcd47c618af9ca_6a4f455c67df6ba061a8310d.6a4f475767df6ba061a83132.6a4f4757f0f4371489d95076:Trae CN.T(2026/7/9 15:01:43)
决断三:单文件 inline JS,还是 Svelte 5?
踩过的坑:最初觉得单文件简单,写了一百多行就发现失控了——状态、音频、UI 逻辑全混在一起,再加一个功能都不知道往哪塞。
PRD 里写的是"单文件 inline JS",理由是"部署简单"。
grilling 之后我们推翻了这个决定,记录在 ADR-0002:
- 单文件撑不起 12 张任务票的协作——代码混在一起,任务没法并行。
- 没有类型检查,后期改协议成本太高。
- 产物还是纯静态的,不影响部署。
最后选了 Svelte 5(runes)+ Vite + TypeScript。
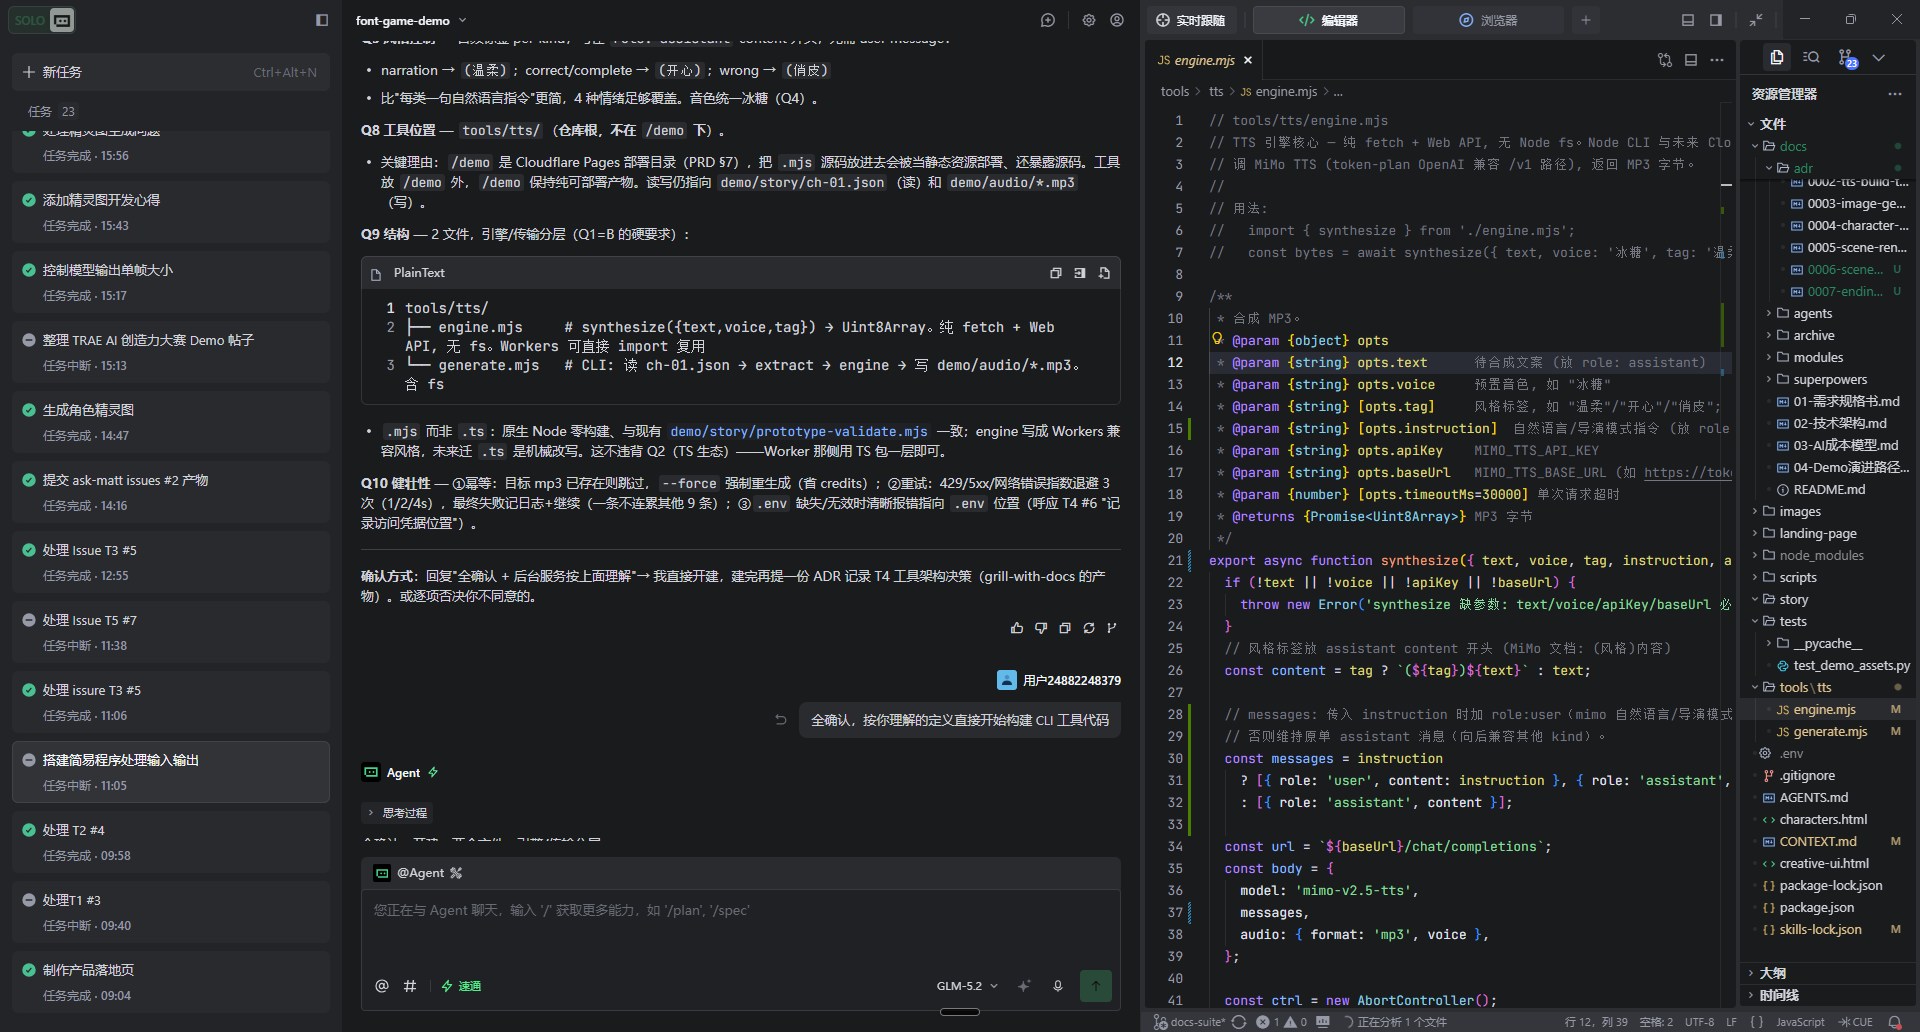
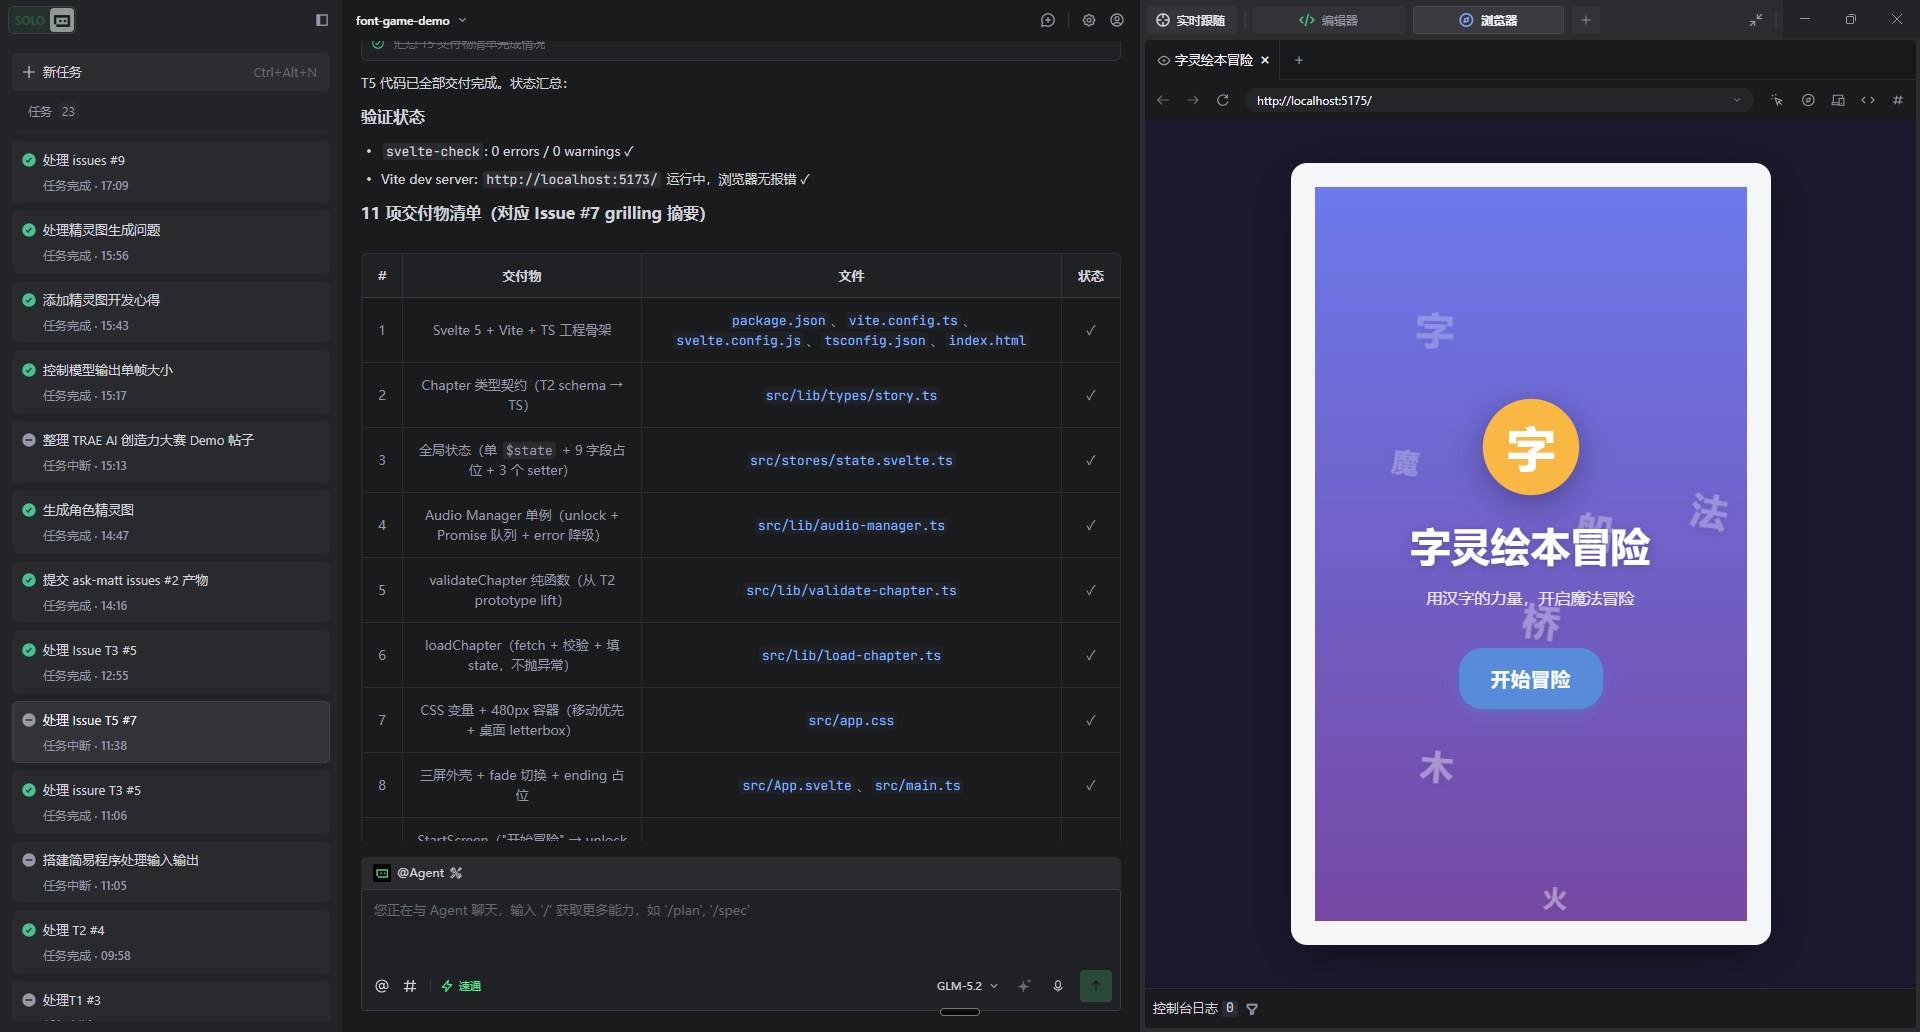
从项目骨架、状态管理、Audio Manager 到三个 UI 组件,一次性全部交付。
svelte-check 零错误零警告。
Session ID:.3489177922189940:61762cc397620769ed257993c518714c_6a4f028067df6ba061a8224b.6a4f0bb267df6ba061a82609.6a4f0bb2f0f4371489d9505a:Trae CN.T(2026/7/9 10:47:14)
决断四:写死第一个场景,还是抽渲染内核?
踩过的坑:第一个场景差点直接写死了,写着写着发现场景二的逻辑和场景一大同小异,复制粘贴又不甘心。
到了场景一·大河渡河,我们面临一个选择:
是直接写死第一个场景快速出效果,还是抽出可复用的渲染内核?
我们选了后者。因为还有场景二,以后还有更多场景。
一次性搭好了资产解析、答题判定、语音识别、喜剧反馈、精灵图组件、流程编排——一整套渲染内核。
过程中又踩了 Svelte 5 的新坑:runes 是新东西,网上资料少。$state 在普通 .ts 文件里用不了,得改成 .svelte.ts 扩展名;$derived 里引用变量要注意声明顺序,不然会拿到 undefined。都是小问题,但每个都排查了十几分钟。
但最后 svelte-check 还是零错误零警告。
这个内核的好处是:再加一个新场景,只需要改 JSON 剧本,不用动代码。
Session ID:.3489177922189940:a5dec658fe77ad694c5761d0b798be38_6a4f53ac67df6ba061a83648.6a4f551567df6ba061a8367c.6a4f5515f0f4371489d9507f:Trae CN.T(2026/7/9 16:00:21)
五、开发心得
六个反直觉的结论。每一个,都是我们踩过坑之后才信的。
1. 代码可弃,内容资产不弃
Demo 用 Svelte,以后大概率迁 Cocos Creator。
但剧本 JSON 协议、精灵图集模型、TTS 音频、提示词模板——这些内容资产,跨阶段原样复用。
这个认知让我们敢在比赛期用最顺手的栈快速交付,不被"以后要重构"绑架。
先让内容跑起来,代码可以换。
2. Grilling 不是挑刺,是帮你省钱
PRD 写的"单文件 inline JS"和"CSS 绘制场景",听起来都合理。
/grilling 逐项逼问之后,两个都推翻了。
如果没走这一步,做到一半发现走不通,返工成本是现在的三到五倍。
好需求不是写出来的,是问出来的。
拍脑袋决策的代价,永远在下游等着你。
3. 纯静态不是妥协,是工程判断
比赛 Demo 最怕什么?评委点开,500。
我们把所有 AI 能力前移到了开发期——TTS 预生成、图片预生成、语音识别用浏览器端侧 API。
换来的是:任何评委、任何设备、任何网络,都能完整体验。
这不是放弃 AI,是把 AI 用在内容生产管线,而不是运行时。
运行时的 AI,留给产品化阶段。
Demo 的第一功能是"能跑通",第二功能才是"有多酷"。
4. 改一个字,要动八个文件 —— 数据驱动的代价与红利
只是把一个候选字从"桥"换成"冰",看起来改一个字而已。
真动手才发现,连锁改了八个文件:剧本 JSON、动画映射、流程编排、精灵组件样式、TTS 音频生成、错误反馈逻辑……甚至还要清理掉根目录下一份旧版残留的 JSON 文件。
反直觉的地方在这里:
越数据驱动的架构,改一个数据点牵动的文件越多。
但这不是坏事——正因为所有逻辑都围绕数据协议组织,改完之后你知道哪些地方受了影响,哪些地方不用动。
反过来,如果逻辑是硬编码在代码里的,改一个字可能只改一行,但你永远不知道哪里还藏着另一份硬编码。
数据驱动的代价是"改一个点要动八个文件",红利是"你清清楚楚知道要动哪八个"。
5. 最耗时的不是写代码,是让 AI 画出一致的图
整个项目最耗时的环节,不是写业务逻辑,是生成角色精灵图集。
写场景渲染内核,半天。
调一套角色精灵图,三天。
文生图模型画单张画很惊艳,但画"同一个角色的 14 帧动画"完全是另一回事——
同一角色反复生成,会出现服装变色、姿态扭曲、风格漂移,甚至性别都变了。
网格对齐更是重灾区:你说要 6×3 等距网格,它给你画得歪歪扭扭,帧与帧之间对不齐。
三轮测试,换了三种分辨率,调了无数次 prompt,最后还要用 Python 脚本做后处理——去白底、缩放、裁切。
出来的结果也只能说"勉强能用"。
这件事彻底改变了我们对 AI 生产力的判断:
在"创造性"的任务上,AI 已经很强;
在"一致性"的任务上,AI 还很弱。
而工程化生产,恰恰最需要一致性。
AI 写代码的一致性,比 AI 画图的一致性,高了不止一个数量级。
6. Demo 阶段最该花时间的,不是写代码,是定协议
大部分人做 Demo 的直觉是:先跑起来再说,协议以后再定。
我们的经验正好相反。
剧本 JSON 协议怎么定、精灵图集的规格怎么定、资产命名规范怎么定——
这些东西看起来是"文档工作",不产生可运行的代码。
但协议一旦定下来,后面十几张任务票全在这个框架里走。
协议定对了,各个任务可以并行推进,互不阻塞;
协议定错了,写到一半发现走不通,所有依赖它的任务全部返工。
我们在 T1(架构决策)和 T2(JSON 协议规范)上花的时间,比写第一个场景的代码还多。
但正是因为前面定清楚了,后面 T5、T7、T8……每个任务都是拿到就能开工,不需要反复确认"这个字段是什么意思"。
前端快一天,后端快一天,不如协议定清楚,所有人都快十天。
六、深夜的 GLM 5.2
做这个 Demo 之前,我一直是个被 token 配额追着跑的人。
Claude Code、ChatGPT、Gemini,三家的会员都开着。日常干活,三家轮流用——这家额度烧完了换那家,那家限速了再换回来。ChatGPT 账号后来还惨遭封号,现在都还没申诉回来。一直处在"不够用"的状态。
借着这次比赛,我在深夜试了 GLM 5.2。
不排队。不限量。不用算这个 issue 还能聊几轮。
第一个晚上,我对着一个任务连续讨论了四个小时——从剧本协议到场景渲染,从 TTS 音色到精灵图网格。中间没有任何一次"额度不足,请稍后再试"。
鬼点子一个接一个往外冒。不是模型多聪明,是我终于不用在"要不要省着用"这件事上分神。
还有两件事让我意外:
一是国内平台的图片生成模型——画单张图的质感,已经不输海外主流模型。
二是 TTS 语音效果——字灵的配音就是国内平台预生成的,音色自然度让人意外。
最后说一句 Trae。Trae Work 和 Trae IDE 在 harness 层面下了真功夫——任务拆解、上下文管理、工具调用的编排,这些"看不见的部分"做得扎实。日常使用体验已经接近 Codex 和 Claude 桌面端。
不是"追上了",是"能放在一起聊了"。对一个国产工具来说,这已经是相当高的评价。
报名帖链接
07-11 15:00 又让AI扩展了一版,现在有了十个场景,变成了一个完整的故事,token用完了,还有更多鬼点子在路上,欢迎大家体验啊~

 从儿童产品设计的国际最佳实践来看,你们「明确不做排行榜、连胜、抽卡」的产品红线非常值得尊敬——这和American Academy of Pediatrics(美国儿科学会)关于「避免竞争性激励损害儿童内在动机」的建议完全一致。建议后续可以关注「多模态交互」的扩展:除了语音和手写,是否可以加入「拍照寻字」(把现实中的字拍下来,AI识别后触发对应魔法)?这会打通「屏幕学习」和「现实世界」的边界。