我是一个码农,每天上班都没有精力和时间去做自己想做的软件,AI时代给了我这样的机会,TRAE IDE和TRAE Work我一直在用,工作也经常用。现在有这样的机会,我正好就把我用它协作制作的软件来参加活动,希望可以获得较好成绩。
1. Demo 简介
-
是什么:IVO 是一款本地优先的 Windows 桌面端 AI 视频配音工具,将英文 / 日文 / 韩文视频对白重新配成自然的中文音频。
-
面向谁:
喜欢看海外影视/科普视频但不习惯看字幕的用户
需要将外语课程、技术教程转成中文配音的学习者
有批量视频配音需求的内容创作者和翻译团队 -
主要功能:
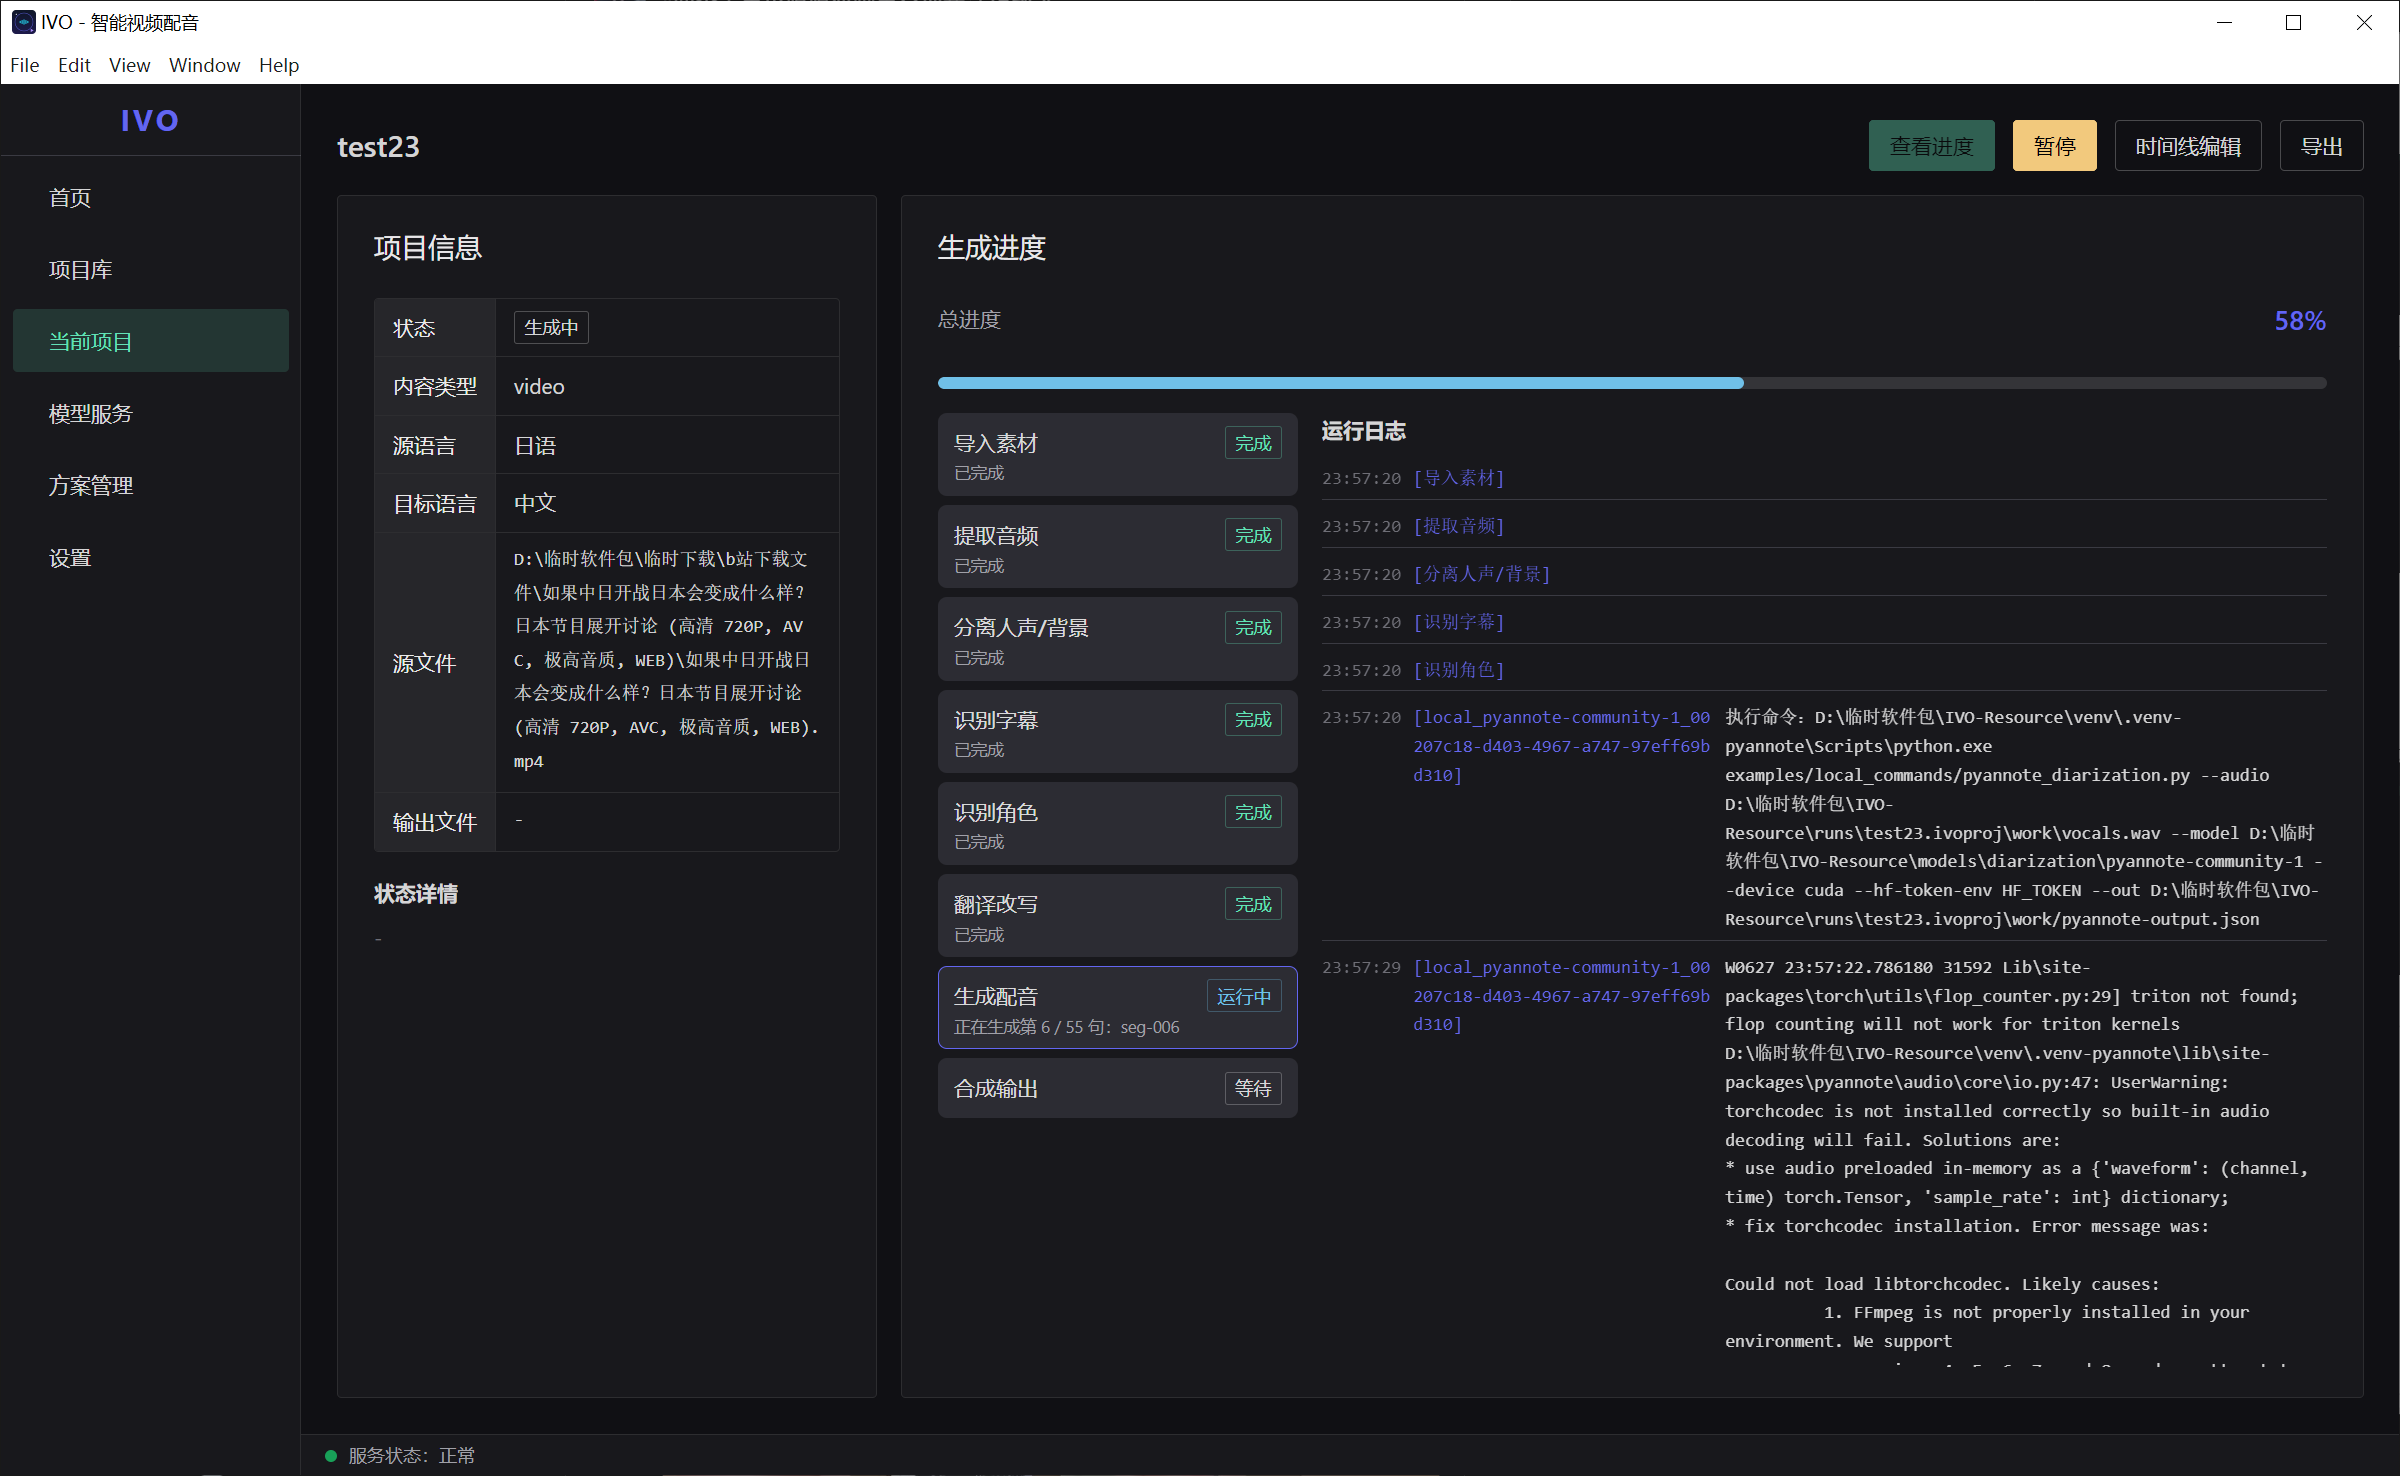
 一键智能配音
导入视频后自动完成「人声分离 → 语音识别 → 说话人分离 → 文本翻译 → 语音合成 → 混合导出」全流程,支持断点续跑,中途失败不浪费已完成的产物。主界面 - 项目概览 图:
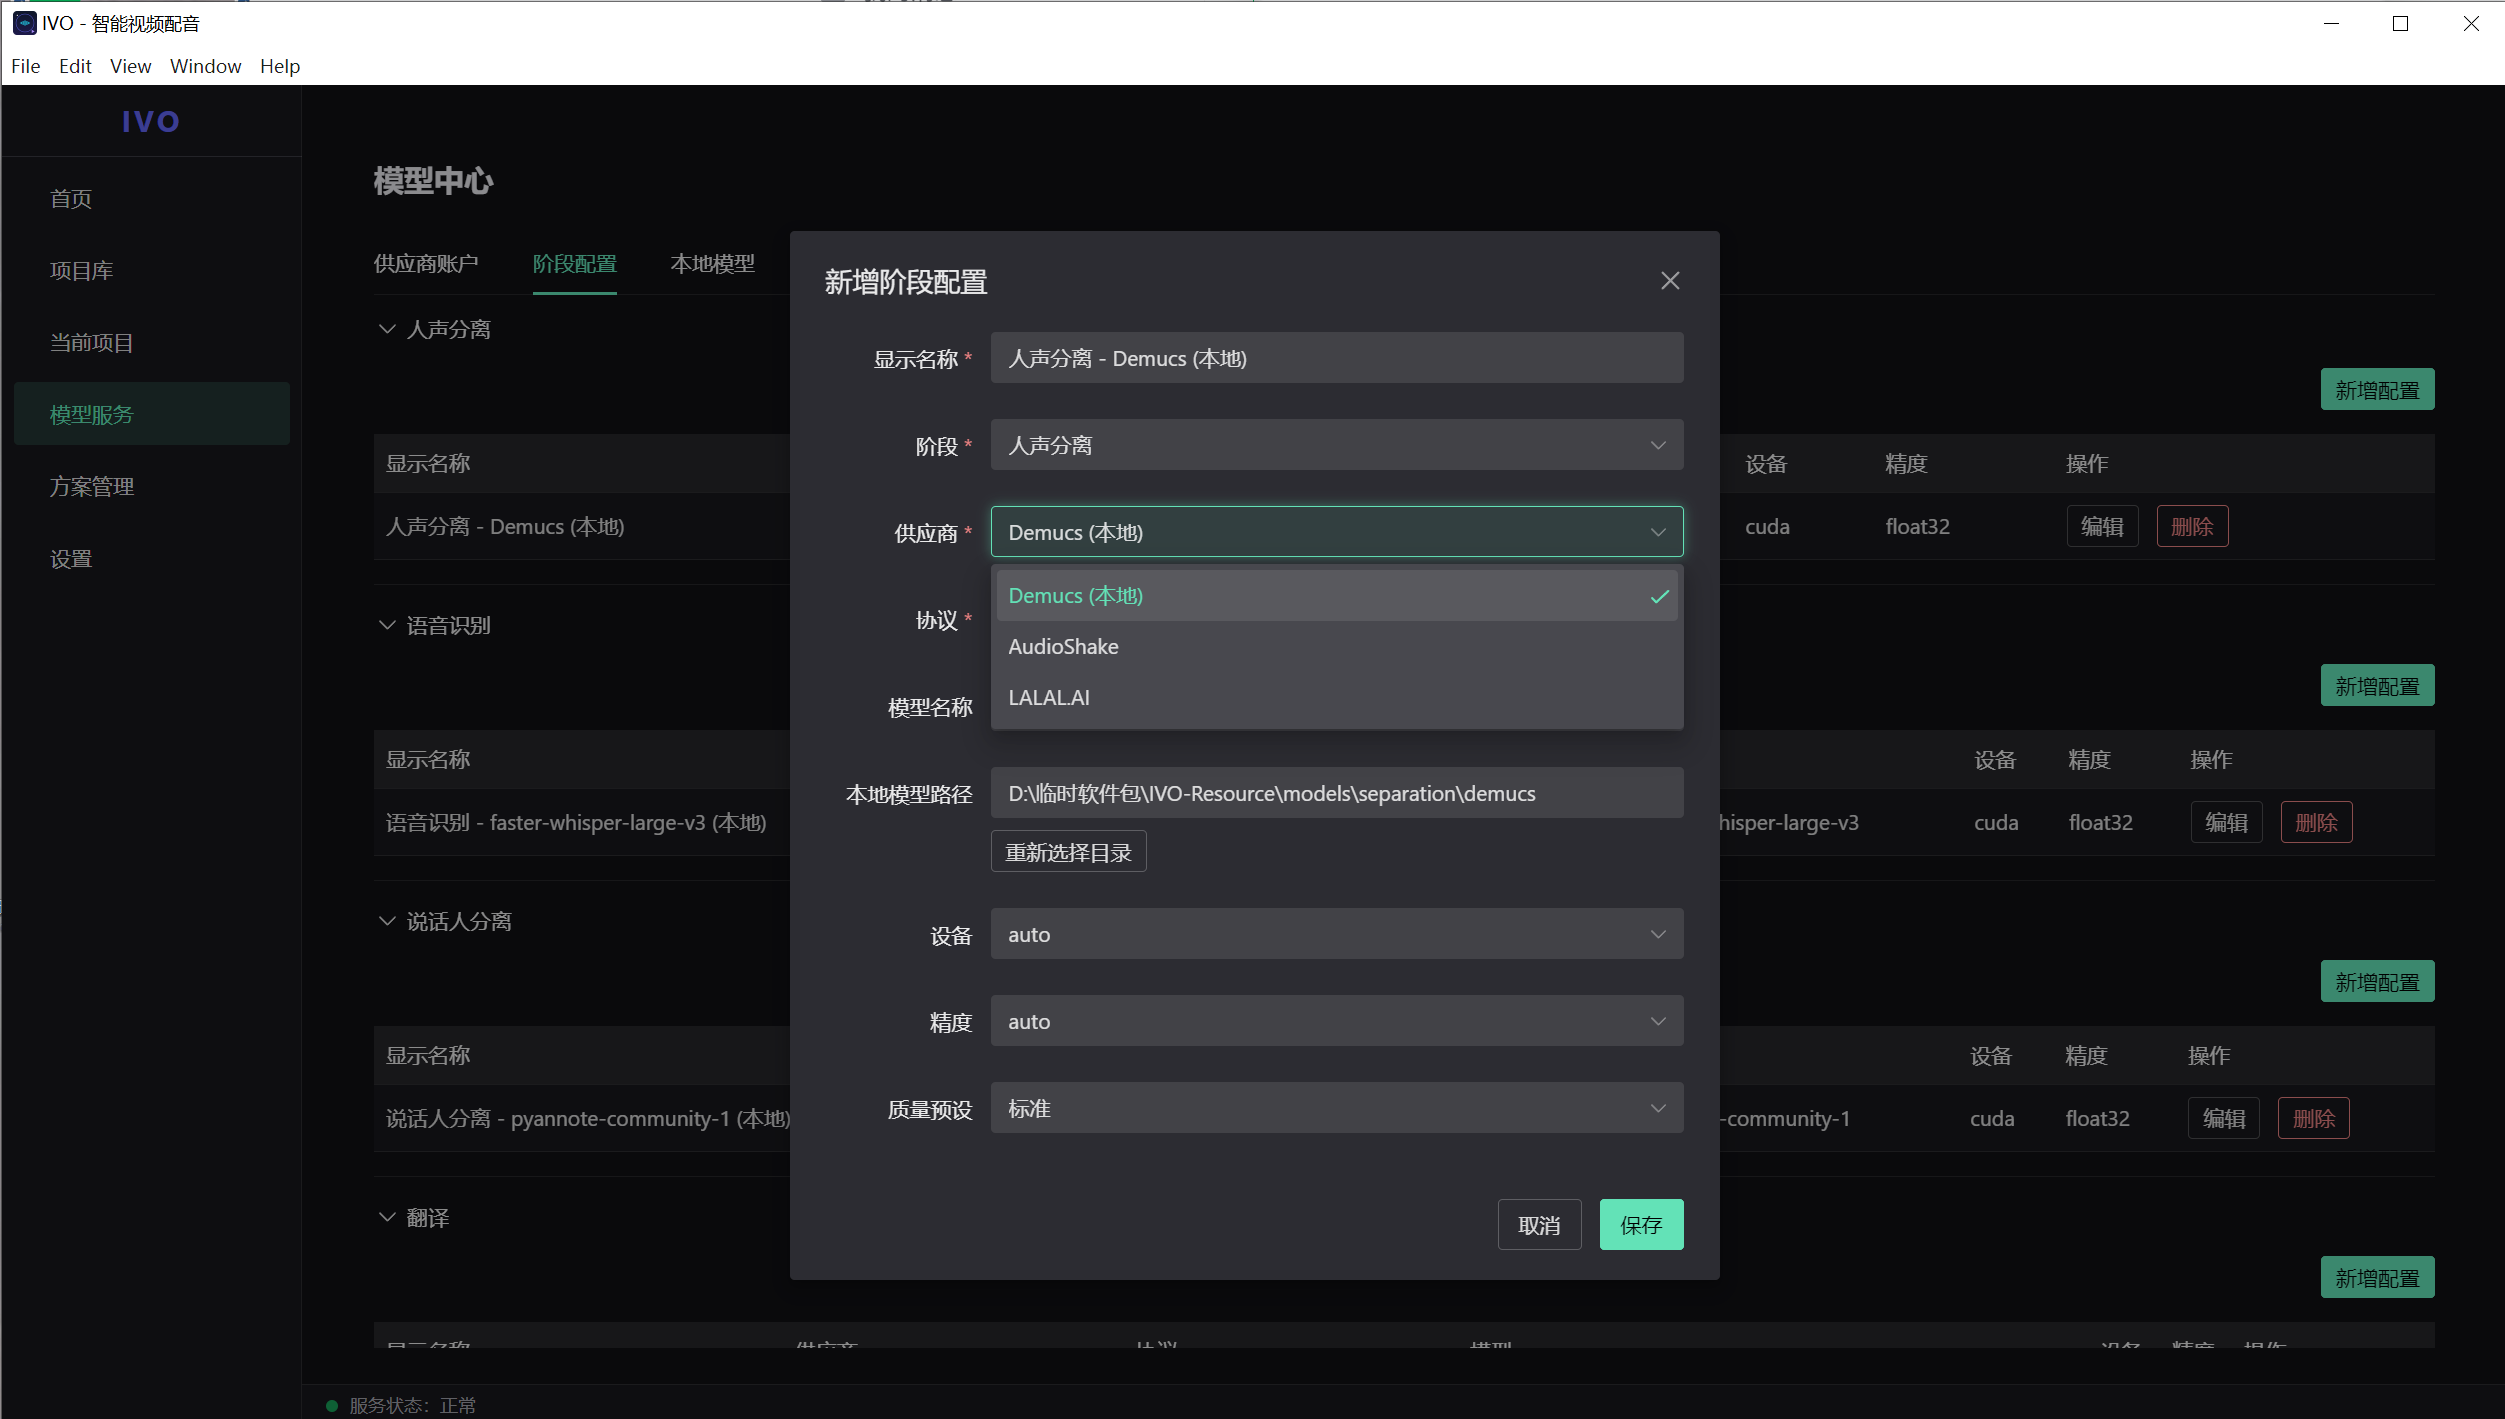
 双模式模型接入
既支持本地模型(Demucs / faster-whisper / pyannote / F5-TTS / CosyVoice),也支持自定义 HTTP API(OpenAI / Deepgram / ElevenLabs / 阿里云 / 讯飞等),用户可以根据自己的硬件条件和隐私需求灵活选择。模型配置 图:
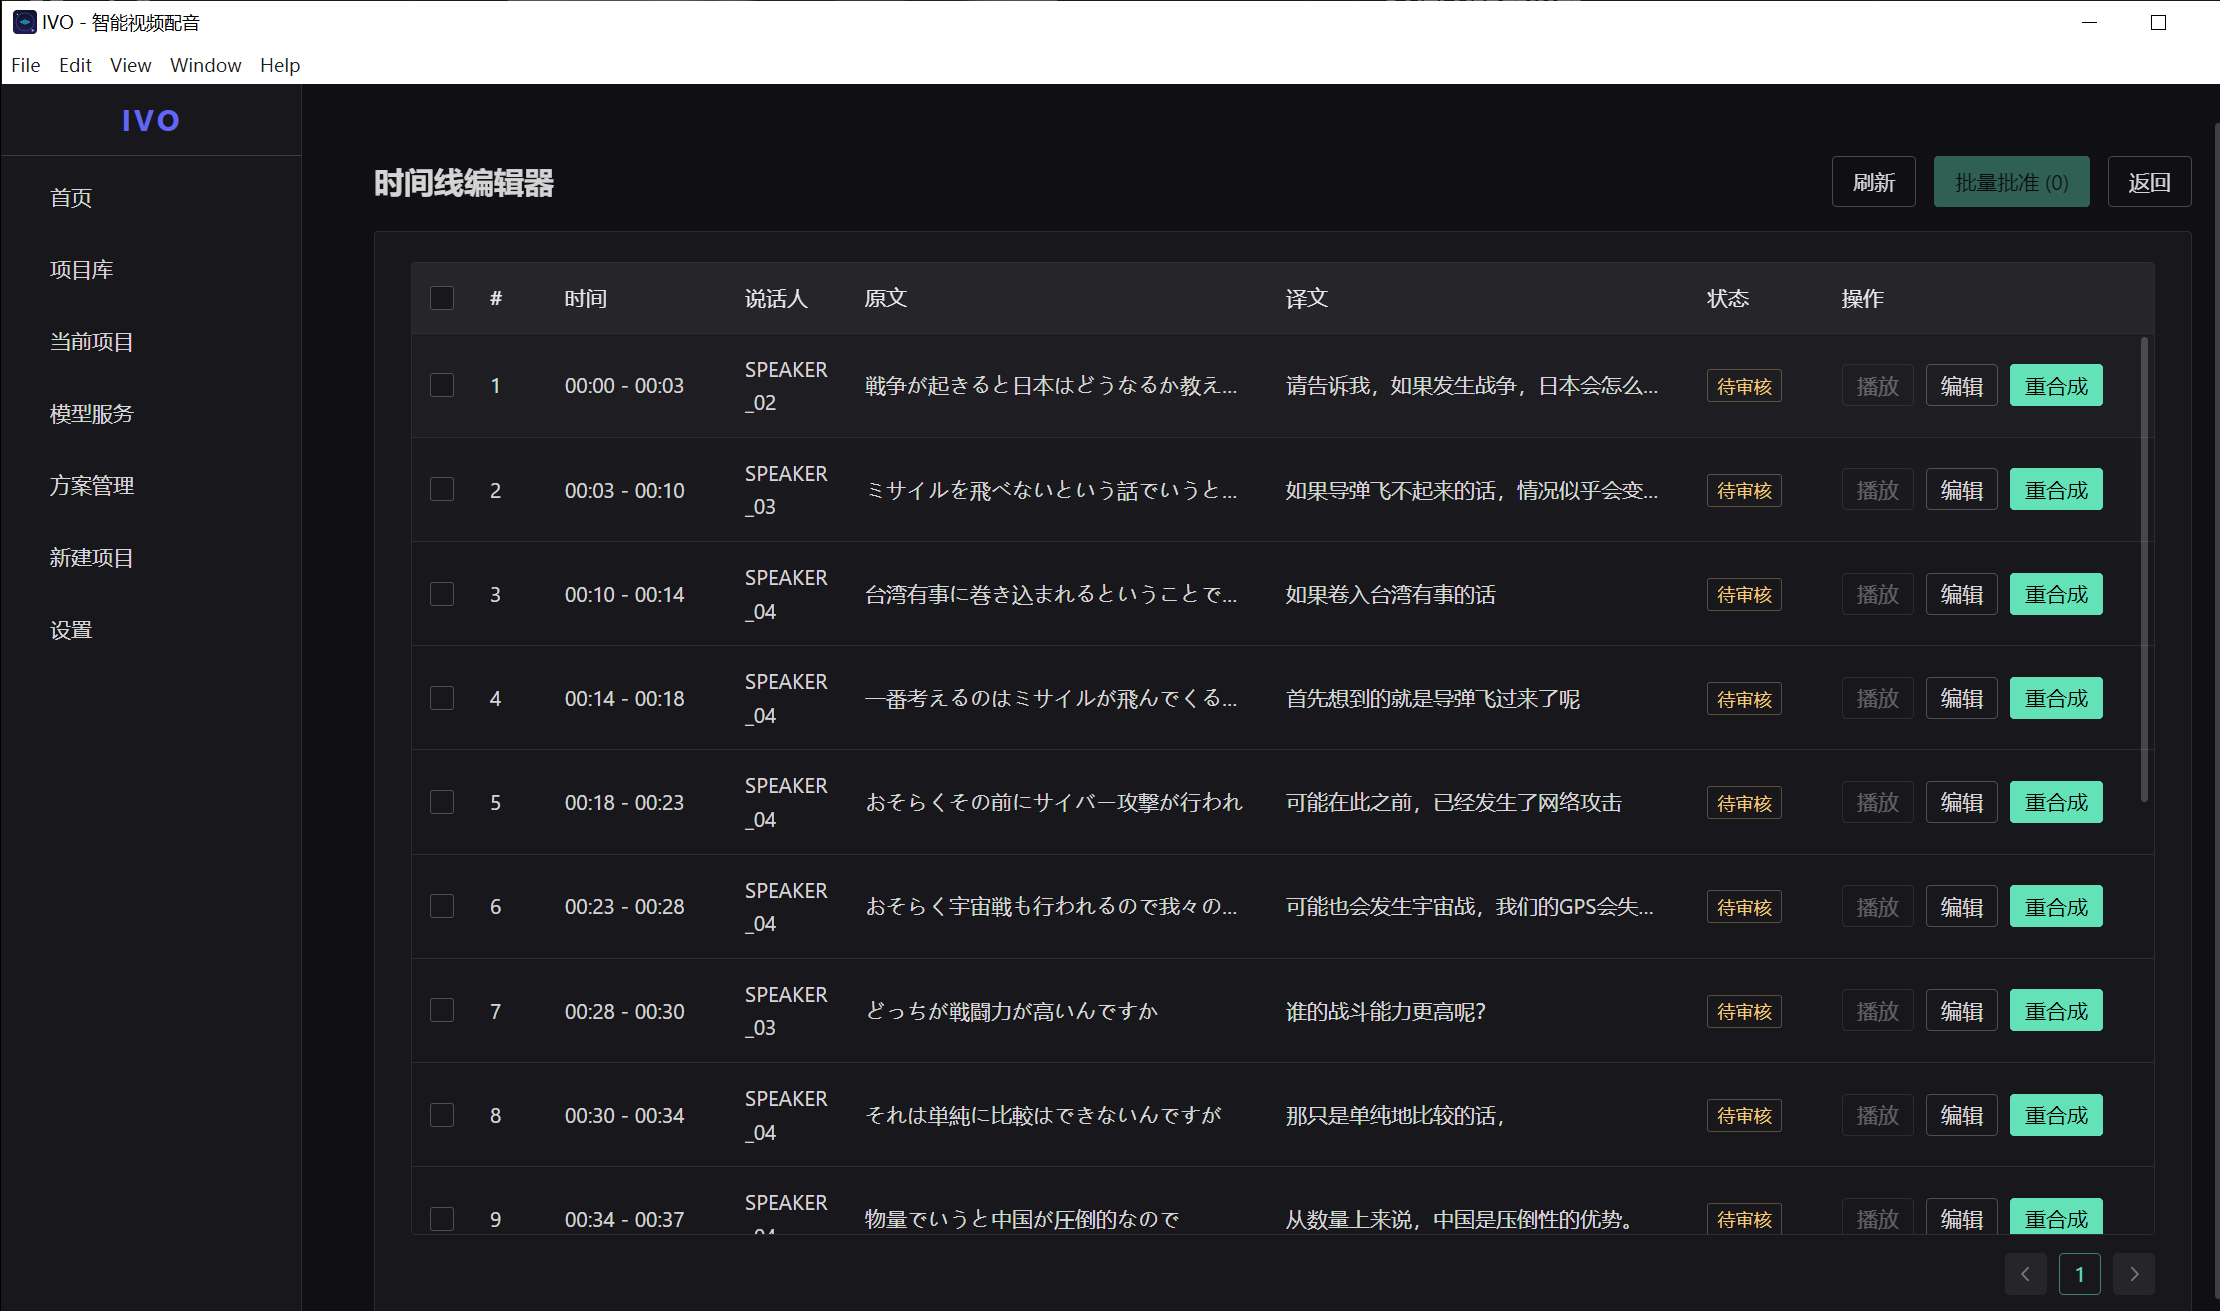
 可视化时间线编辑
识别和翻译结果以时间线形式展示,支持逐段修改文本、调整说话人、预览合成效果,导出前确认无误再一键生成。时间线编辑 图:
2. Demo 创作思路
-
灵感来源:
平时看大量海外技术教程、科普视频和纪录片,很多优质内容没有中文配音,只能盯着字幕看,体验不好。市面上的配音工具要么需要上传视频到云端(隐私顾虑),要么需要复杂的命令行操作(门槛高),所以想做一个本地运行 + 图形化界面的配音工具。 -
想解决的问题:
- 隐私问题:很多配音工具需要上传视频到云端,对一些敏感素材不放心
- 使用门槛高:开源模型功能强但需要命令行操作,普通用户不会用
- 流程割裂:分离、识别、翻译、合成各环节要用不同工具,手动拼接太麻烦
- 失败成本高:跑到一半出错就得重来,浪费时间
-
为什么做这个方向
- 刚需明确:外语视频中文化是真实存在的需求,尤其是 AI 能力起来后质量已可用
- 技术可行:Demucs + faster-whisper + F5-TTS 等开源模型组合起来就能完成全流程
- 差异化:现有工具要么是云端 SaaS(隐私问题),要么是纯命令行(门槛高),做一个本地优先 + 图形化界面的桌面工具有明确的用户价值
- 用 TRAE 正好合适:项目涉及 Python 后端 + Vue 前端 + Electron 桌面壳 + 本地模型集成,正好能发挥 TRAE 全栈开发和多文件协同的能力
3. Demo 体验地址(三选一)
-
客户端演示视频链接:https://b23.tv/A6lem2G
-
下载安装包体验:
前往 Releases 页面 下载最新版IVO.Setup.x.x.x.exe
请参照Releases 页面 和README.md说明进行环境安装和模型安装
4. TRAE 实践过程
-
4.1 项目架构设计
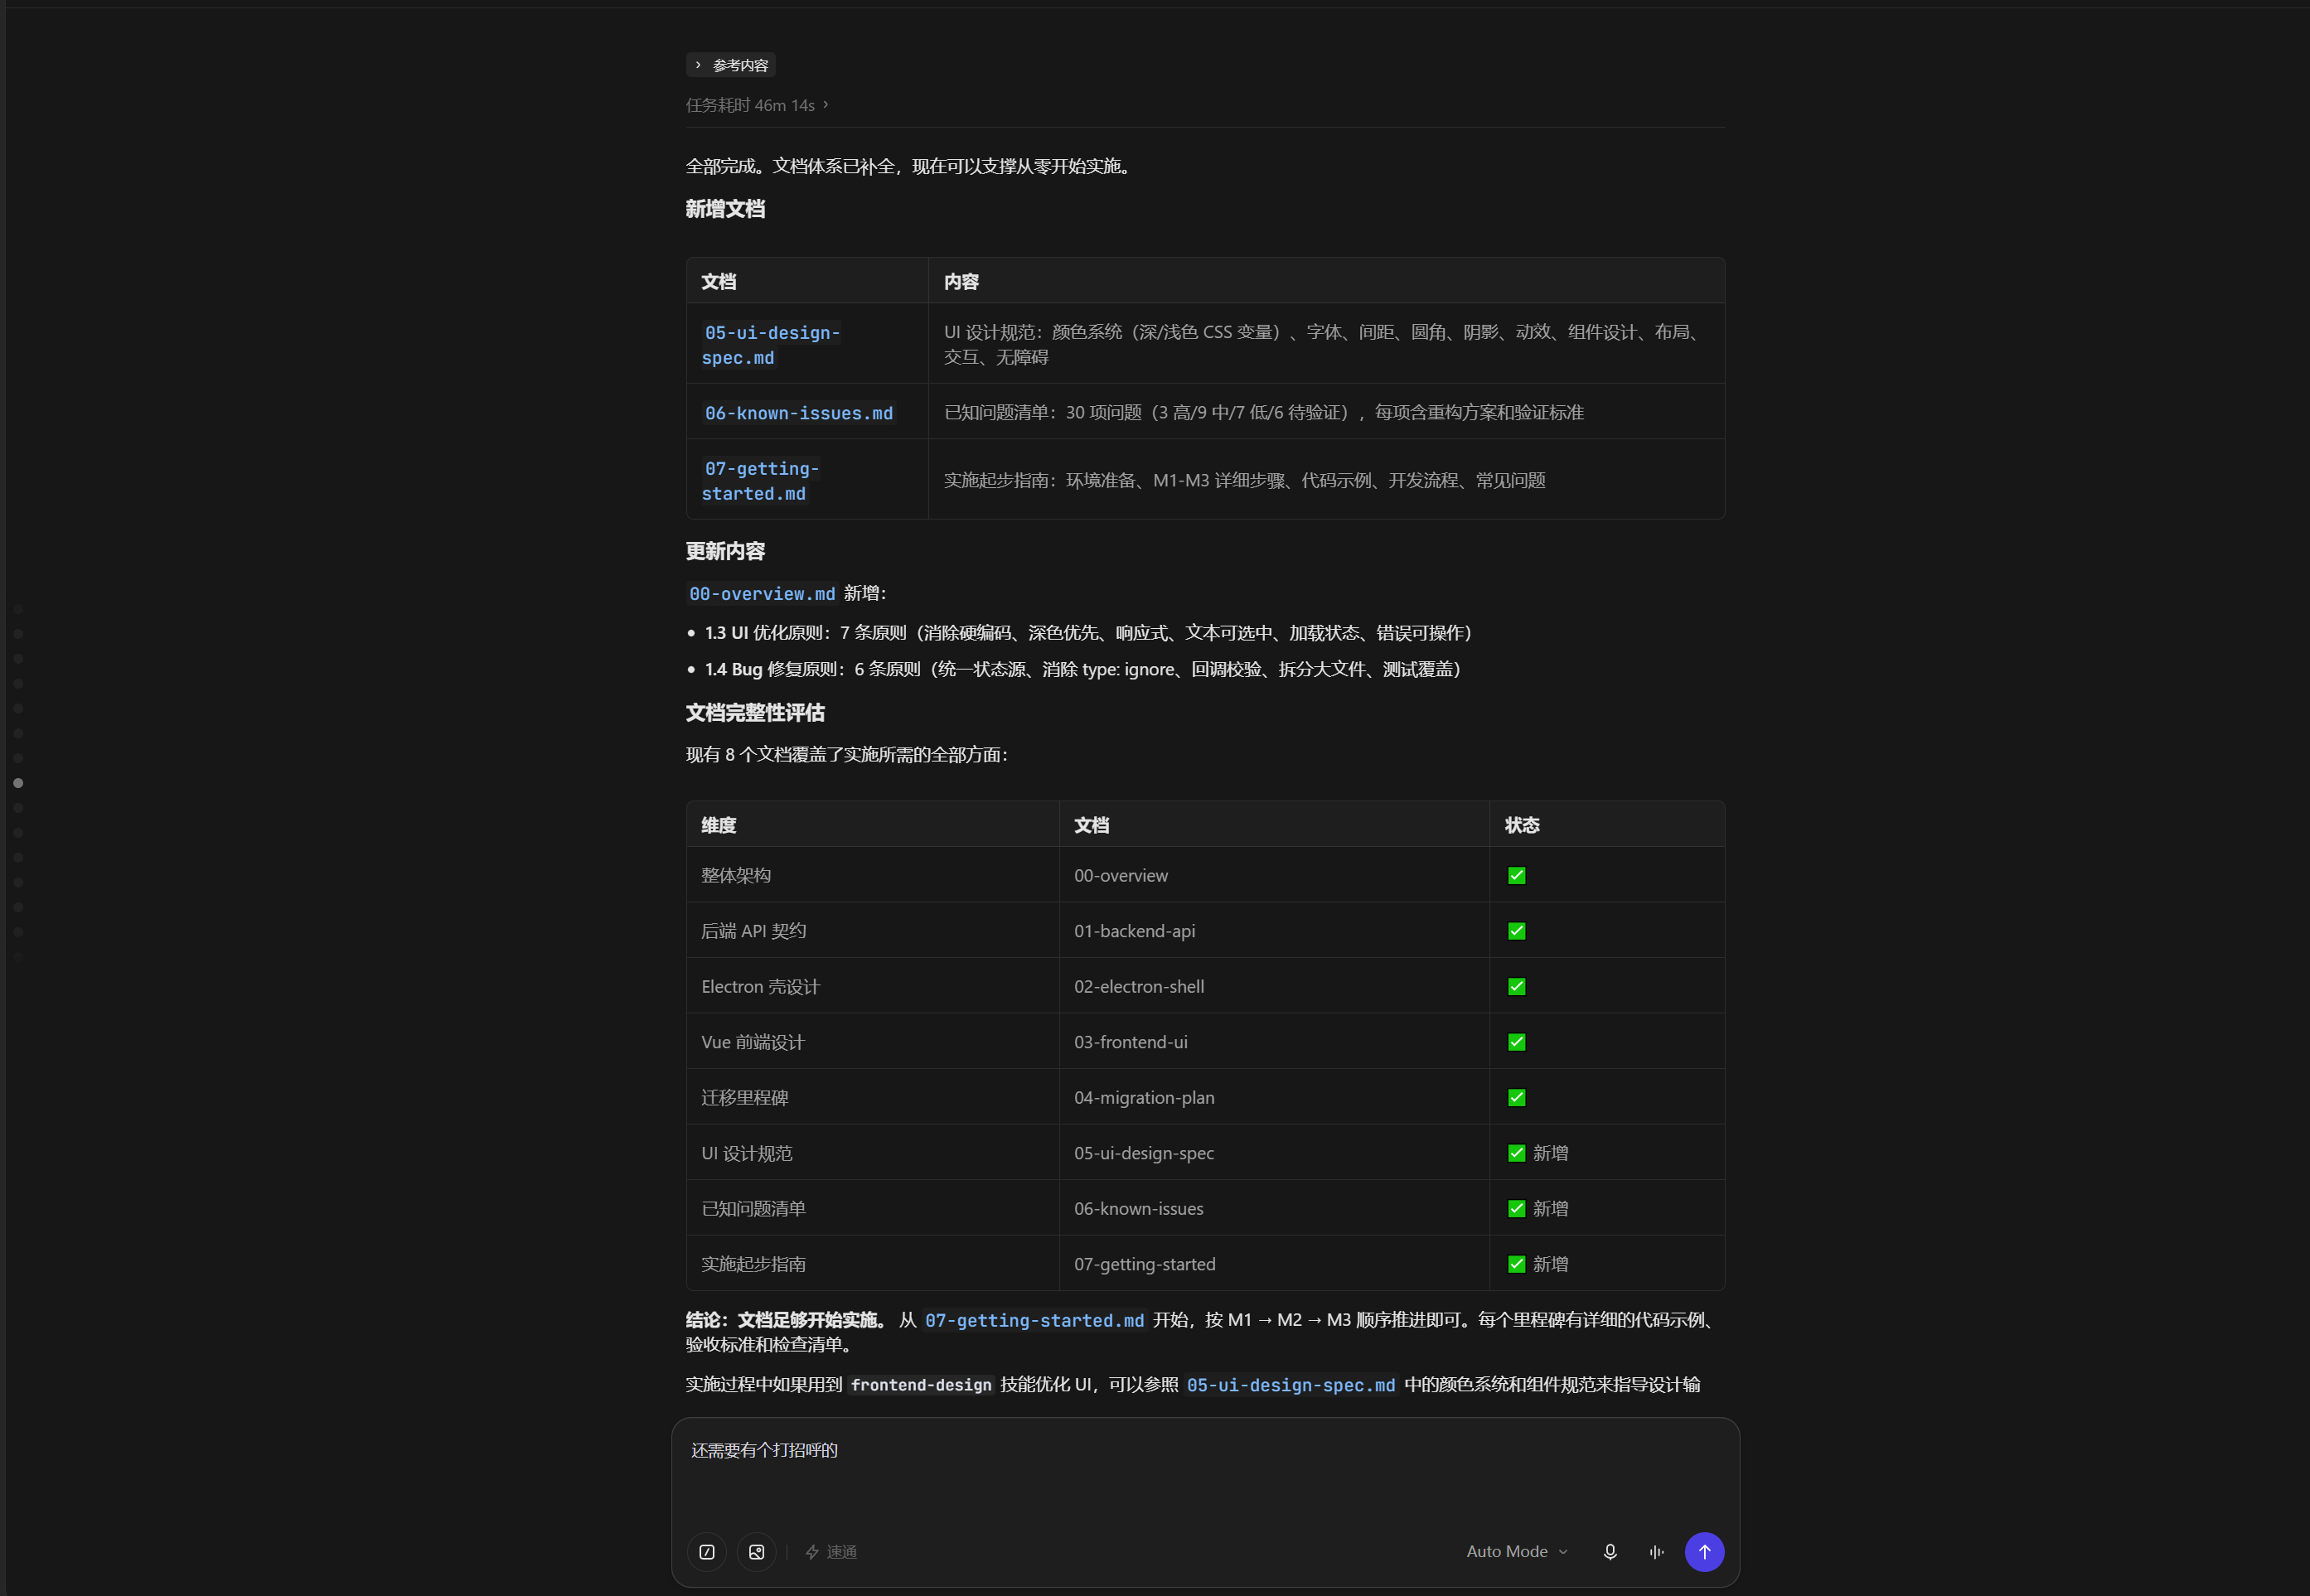
一开始先跟 TRAE 梳理清楚项目的分层架构:Electron 壳 + Vue 3 渲染层 + FastAPI 服务层 + 本地模型层,四层通过 HTTP/WebSocket 通信。TRAE 帮我设计了适配器模式(Adapter Pattern)来统一本地命令和 HTTP API 两种接入方式,让每个阶段(分离/识别/翻译/合成)都可以自由切换后端。
关键决策:
- 用 SQLite 存项目数据,不引入 ORM,保持轻量
- 流水线阶段化设计,每个阶段独立记录状态,支持断点续跑
- Pydantic v2 做数据校验,mypy strict 模式保证类型安全
4.2 桌面 UI 开发
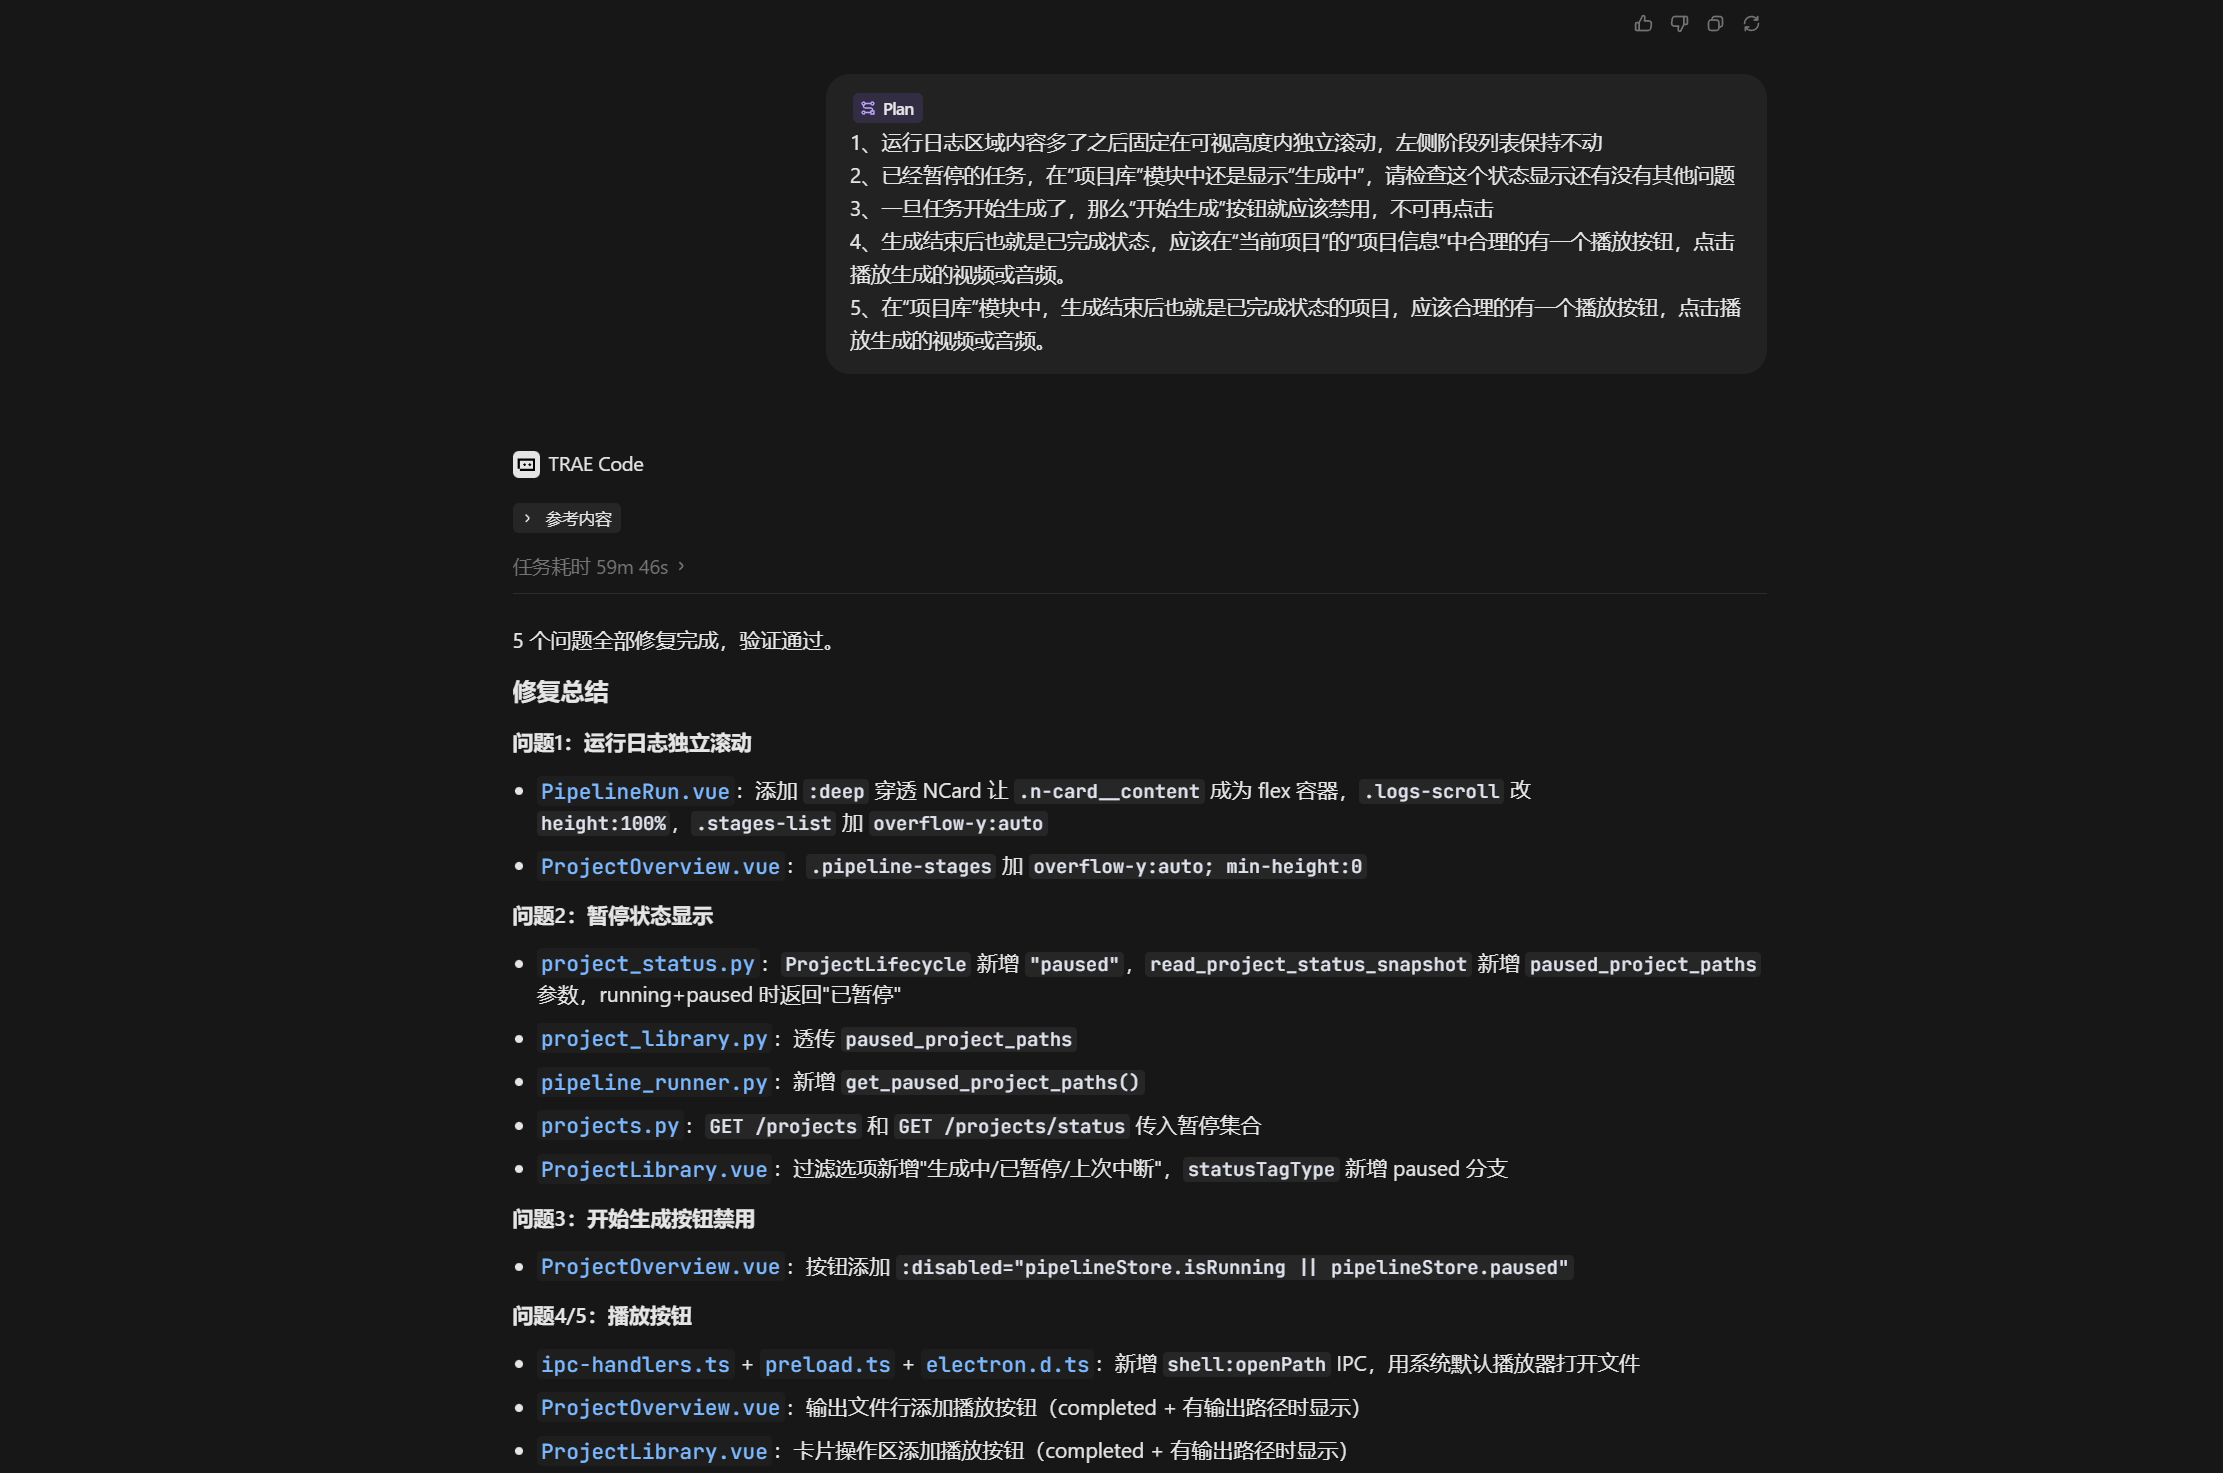
前端用 Vue 3 + Naive UI,从项目创建、模型配置、时间线编辑到运行日志,整个界面都是跟 TRAE 一步步迭代出来的。印象比较深的是运行日志页面的滚动交互,前后改了好几版才达到满意的效果——只有日志区域独立滚动,阶段列表和项目信息固定不动,TRAE 帮我从外层布局链一路排查到 grid 行高问题,最终解决。
4.3 本地模型集成
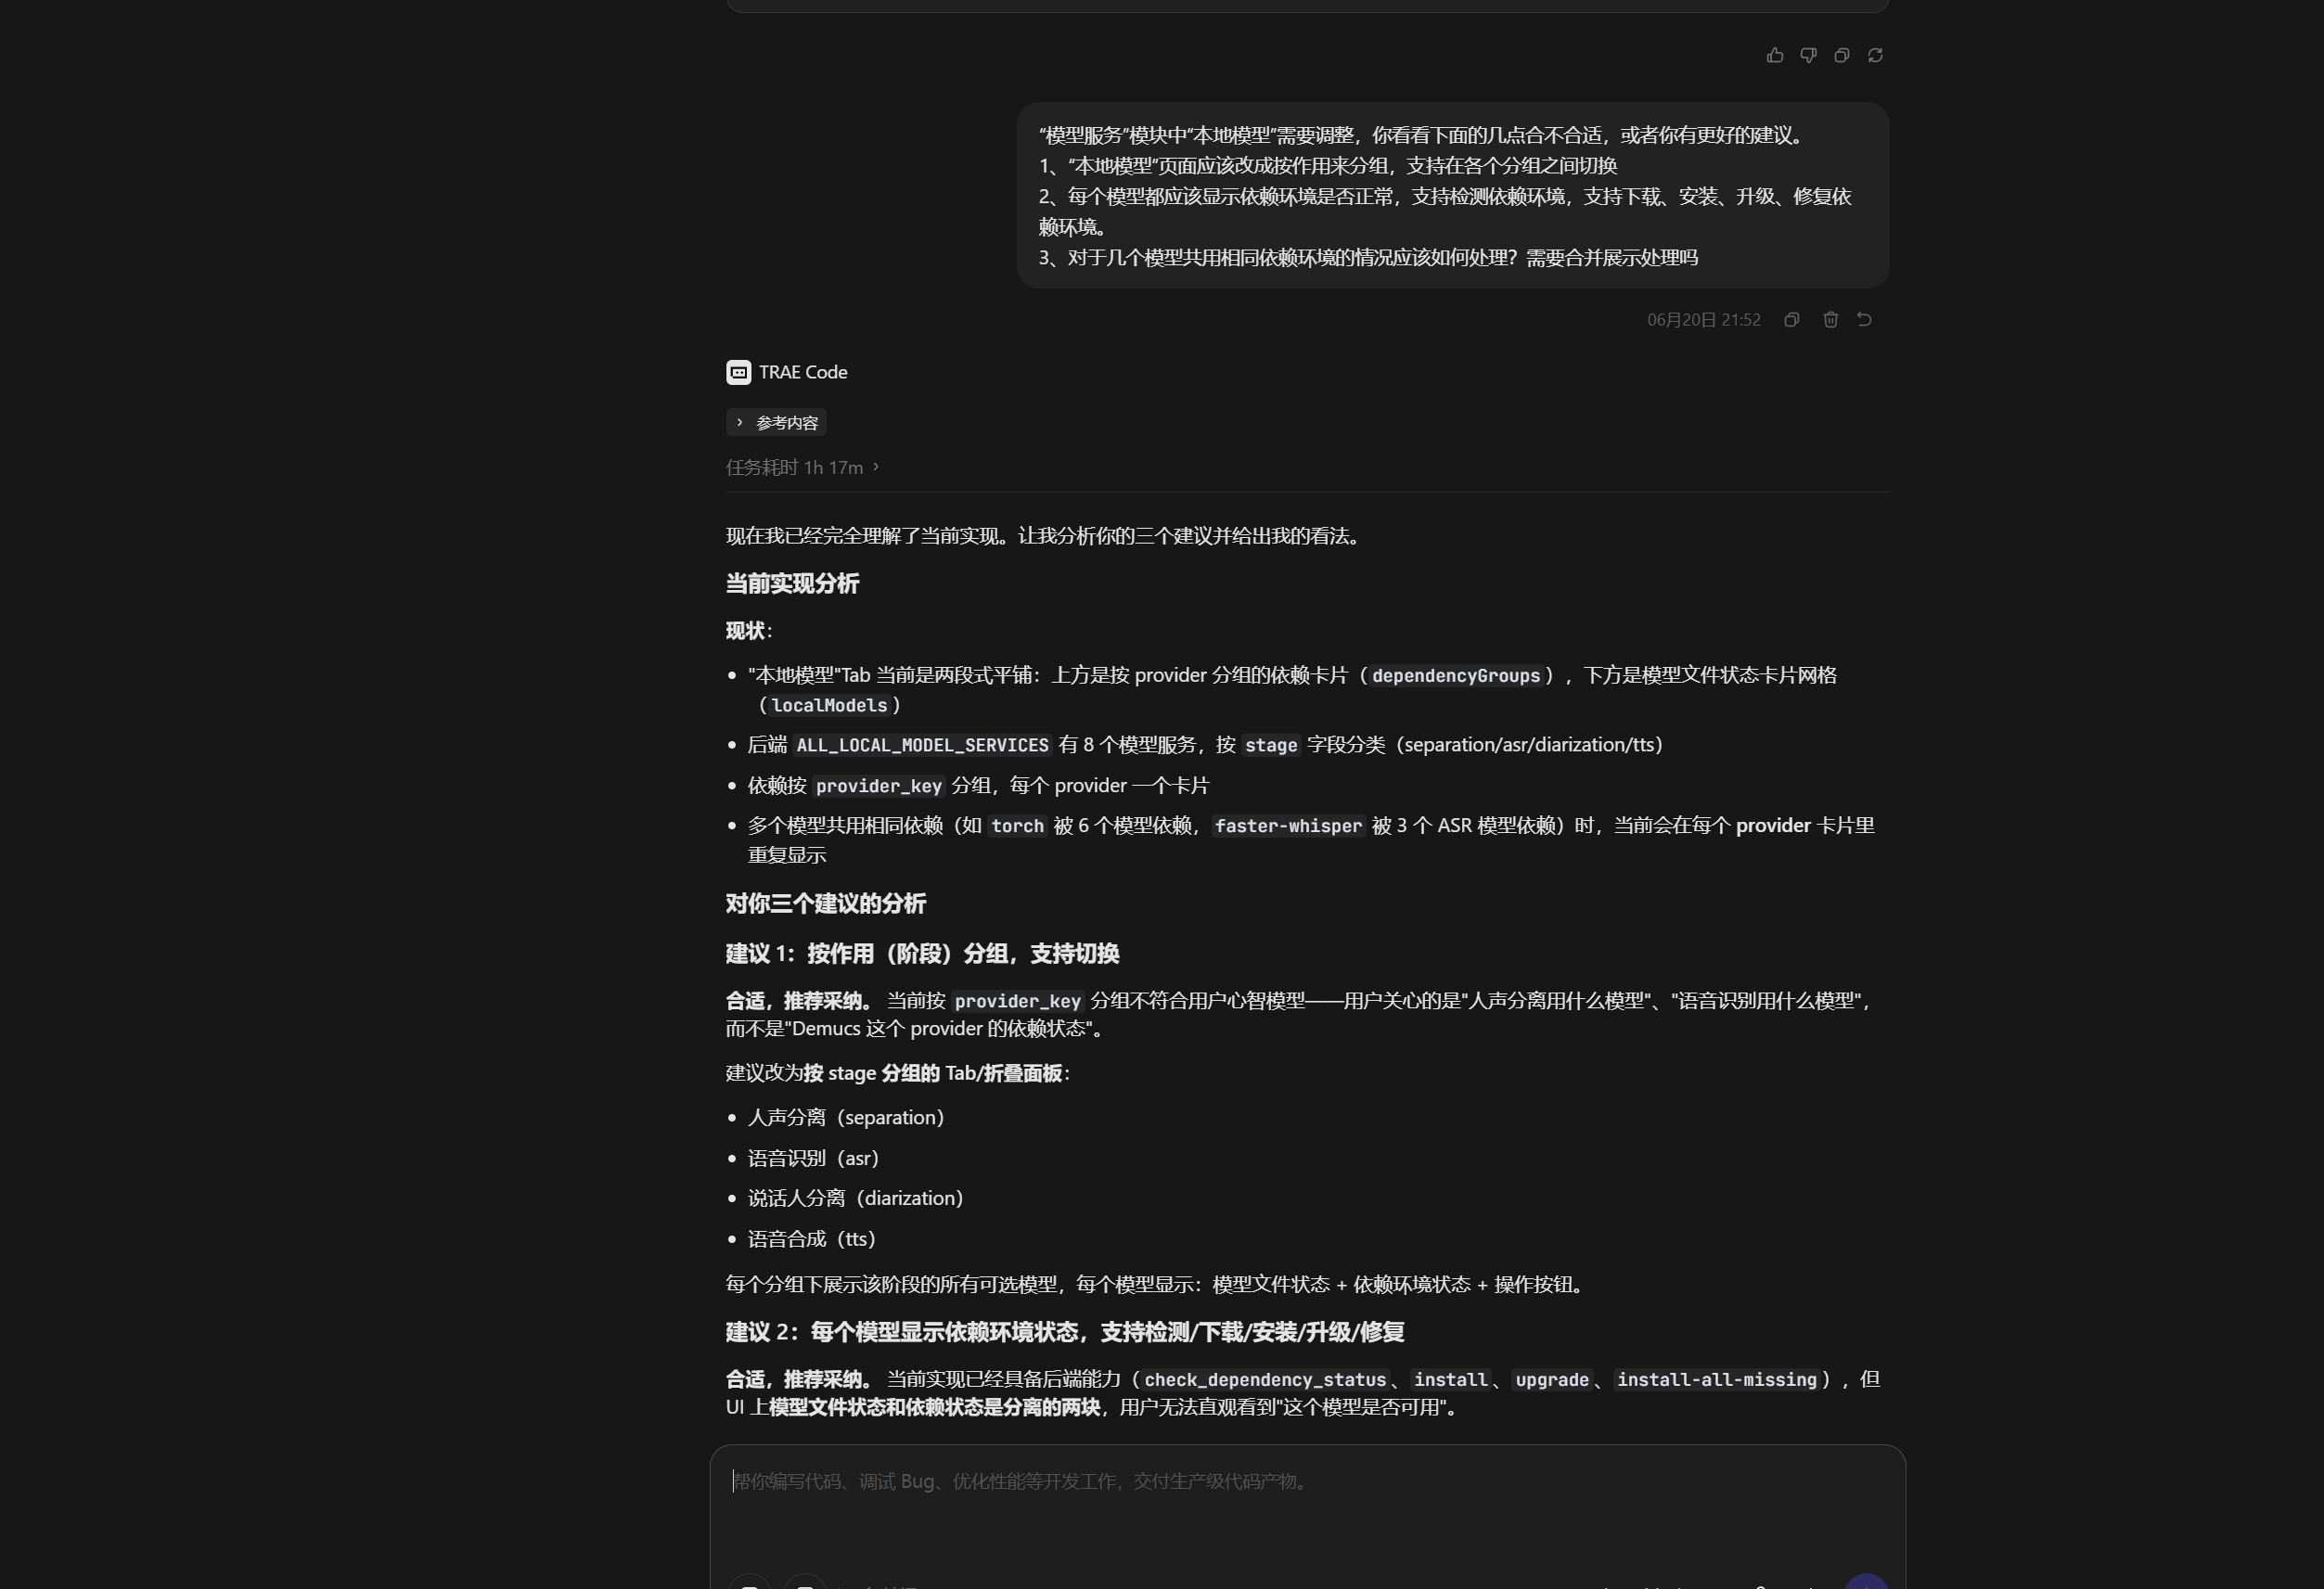
模型集成是最复杂的部分——每个模型有自己的 Python 环境依赖,互相冲突。TRAE 帮我设计了 LocalCommandAdapter(本地命令适配器),每个模型在自己的 venv 里跑,通过 Jinja2 模板渲染命令参数,读取输出 JSON。这样既解决了依赖冲突,又保持了统一的接口。
还做了一键安装脚本和模型状态检测,用户打开软件就能看到哪些模型装好了、哪些缺依赖,不用自己折腾环境。
4.4 迭代优化
开发过程中边做边测,发现了很多体验问题,都是跟 TRAE 一起快速迭代修复的,比如:
- 依赖检查太慢 → 改成异步并行检测,秒级出结果
- 播放按钮报错 → 原来是安全路径校验策略太严,从白名单改成黑名单
- 项目状态显示不对 → 新增 paused 生命周期状态,暂停的项目不再显示"生成中"
- 长文本不换行 → 加了 overflow-wrap 和 word-break 处理长 ID 显示
每次发现问题,跟 TRAE 说一下,它就能快速定位根因并给出修复方案,迭代效率非常高。
关键任务 Session ID
- 项目架构设计 — Session ID: 3546342377665370:f0a21826f4bec5c2482a5a162eb01cb4_6a27b116d58ee51e9408a792.6a336368935d0f49df7c98ef.6a336368935d0f49df7c98ed:TRAE Work CN.0.1.25.no_sid.no_ppe.T(2026/6/18 11:18:00)
- 前端 UI 开发与交互优化 — Session ID: 3546342377665370:7e5267f6851624e7486389073151ba61_6a27b116d58ee51e9408a792.6a3382a7935d0f49df7caf23.6a3382a6935d0f49df7caf21:TRAE Work CN.0.1.25.no_sid.no_ppe.T(2026/6/18 13:31:19)
- 本地模型集成与依赖管理 — Session ID: 3546342377665370:d8d41305e7a4f1e112e99a6f5d8f4d76_6a27b116d58ee51e9408a792.6a369b39456e86137a1afc1c.6a369b39456e86137a1afc1a:TRAE Work CN.0.1.25.no_sid.no_ppe.T(2026/6/20 21:52:57)
- Bug 修复与体验优化 — Session ID: 3546342377665370:63cdafcdcf5e7923f27e63421daf953d_6a27b116d58ee51e9408a792.6a37f74ff0af689376148e33.6a37f74ff0af689376148e31:TRAE Work CN.0.1.25.no_sid.no_ppe.T(2026/6/21 22:38:07)
5. 报名审核通过的帖子链接