标题
我希望 TraeCode 未来可以把智算网络「看不见的卡顿」变成一眼能读懂的可观测结论
介绍自己
从网络工程专业毕业到现在成为网络架构师,最熟的是一张张流量图——带宽、丢包、设备 CPU,图表绿了,人就安心。可最近有个画面让我心里发毛:智算集群那边训练慢得像卡壳,监控大屏却绿得发亮、一条告警都没有。那一刻我才意识到,自己这套"看图排障"的老手艺,在算力网络面前开始失明了。
我不是专业程序员,但靠 TraeCode 还是把《NetOps AI Hub 网络智能运维中台》从零做了出来,进了 AI 创造力大赛复赛 Top300。今天这个愿景,就说给那个"图表全绿、训练却慢"的深夜。
今天这个愿景,来自一个我越来越强烈的感受:当网络从"承载网页流量"变成"承载大模型训练",我们手里那套监控工具,已经开始"看不见"真正的故障了。
我对 TraeCode 的愿景
核心一句话:我希望 TraeCode 能成为智算网络的"无损网络体检医生"——把 RDMA 网络里那些藏在队列深处、流量图上根本看不出来的卡顿,一键诊断成能读懂、能定位的结论。
希望新增的功能:无损网络可观测 + 语义诊断
大模型训练的智算网络(Spine-Leaf + RoCEv2 无损以太网),有一个和传统网络完全相反的特性:训练变慢的时候,流量图往往一切正常。 因为真正的拥塞不体现在"带宽打满",而体现在以下这些传统监控看不到的地方:
-
PFC 暂停帧(优先级流控):某条队列触发了多少反压暂停,是本该"零丢包"却正在憋着不发的信号;
-
ECN 显式拥塞标记:交换机在拥塞时打了多少标记,是端到端拥塞的早期预警;
-
ECMP 哈希冲突:集合通信流量高度集中,五元组哈希一冲突就堆出"热点链路",形成木桶短板;
-
RDMA 丢包计数器与队列深度:RDMA 一旦丢包是 Go-Back-N 式重传,性能断崖,但丢的是"显存到显存"语义的包;
-
集合通信性能画像:AllReduce 等原语的带宽、时延、抖动趋势,才是训练"卡不卡"的真正体温计。
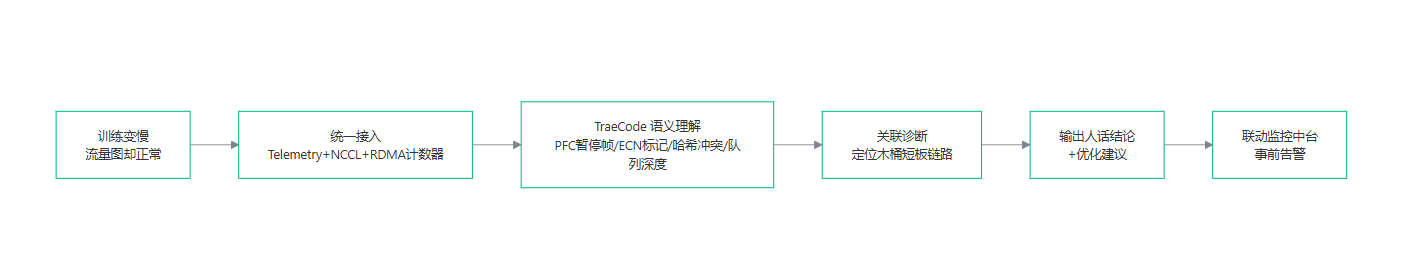
我希望 TraeCode 能把这些散落在交换机遥测、NCCL 日志、网卡计数器里的指标统一接进来,用"懂网络语义"的大脑把它们关联成一句人话结论——比如:“本次训练的短板在第 7 号 Pod 的 Leaf 上行链路,PFC 暂停帧激增 + ECN 标记占比 18%,疑似 ECMP 哈希冲突,建议调整该段哈希策略。”
为什么需要:现在这些数据我自己也能抓到,但每一次都要手动把交换机 Telemetry、NCCL 日志、RDMA 计数器拼起来"翻译"一遍。缺的是一个"看得懂 RDMA 语义、能把碎片拼成结论"的那一层。这就是 TraeCode 能补的——它不缺算力,缺的正是这种"懂你在看什么网络"的语义理解。
希望优化的场景:训练变慢的"盲区排障"
当前卡点:智算集群报"训练慢 20%",打开传统网管一看,流量平稳、无丢包、设备 CPU 正常——图表是绿的,但训练就是慢。传统 Unix 式监控刻舟求剑,因为它设计时就没想过"零丢包、微秒级抖动"这种需求。
期望优化:让 TraeCode 把"训练慢"这个现象,一路下钻到"哪条链路、哪个队列、哪种拥塞机制"出了问题的诊断路径,让排障从"逐台设备翻日志"变成"看结论定位"。
希望如何融入我的工作流
-
与交换机遥测打通:通过 gRPC/Telemetry 拉取 PFC/ECN/队列深度/丢包计数器的实时流;
-
与 NCCL / 训练框架日志打通:把集合通信的 AllReduce 性能数据对齐到网络指标上,形成"网络↔训练"的关联视角;
-
与我现有的监控中台衔接:作为 NetOps 中台里一个"算力网络"新面板,和已有的流量监控、告警能力同屏切换,不用另起炉灶;
-
与告警联动:PFC 暂停帧、ECN 占比越过阈值时自动提示,而不是等训练已经变慢才发现。
带来的价值:把算力网络的排障从"事后救火"变成"事前体检",让运营商在承接智算中心、算力网络这类新业务时,多一块别人没有的"可观测"招牌。
流程图
希望的形态
「算力网络可观测仪表盘 + 对话诊断」:左侧是 PFC/ECN/集合通信性能的实时面板,右侧对话式追问"这次训练慢在哪、为什么慢、怎么调"。让不懂 RDMA 细节的值班同事,也能在 TraeCode 的翻译下看懂算力网络。
结尾
传统网络监控"看见流量",我希望 TraeCode 让智算网络被"看懂拥塞"。算力网络是"算力放大器",而放大器只有先被看见,才谈得上被放大。