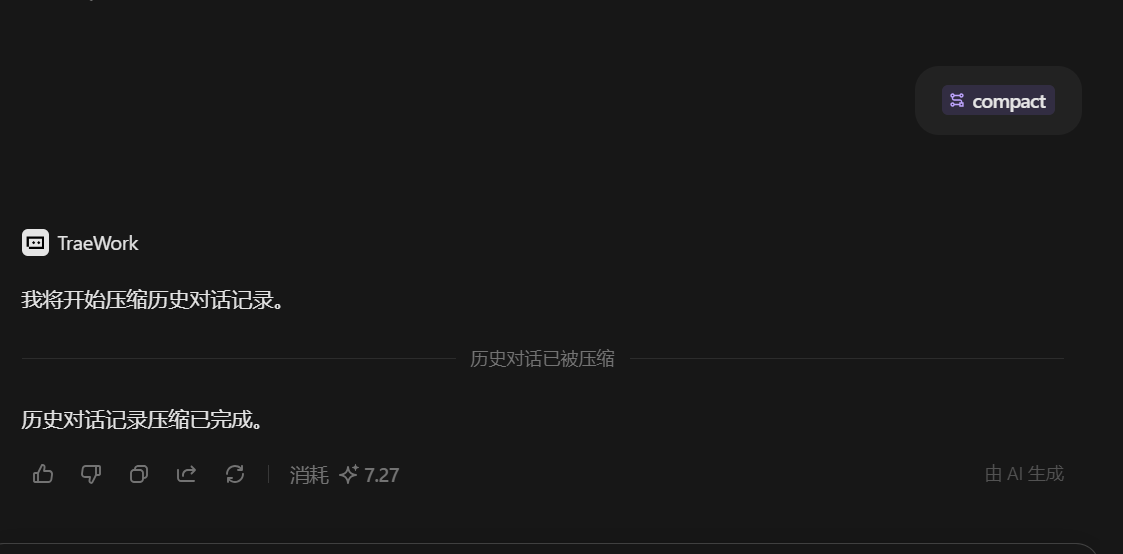
看到你的截图啦~确实,压缩上下文(compact)这个操作本身是会消耗积分的。
这是因为压缩并不是简单地把前面的记录「一刀切」删掉,而是让 AI 模型把之前的长对话完整阅读一遍,然后提炼总结成一份保留核心信息的「精简版会议纪要」。这个阅读和提炼的过程调用了模型,所以会产生 Token 消耗(也就是扣除积分)。
不过长远来看,压缩后历史记录变短了,你接下来再对话时,每次带入的上下文就会少很多。这其实能帮你省下后续交互的积分,也能防止模型因为上下文太长而「遗忘」关键信息。
至于 TRAE IDE,计费规则也是一样的哦:只要是调用模型来处理任务(包括这种需要模型去阅读和总结的操作),都会按实际消耗的 Token 来扣除积分。
如果不想在旧对话里花积分去压缩,最省积分的办法其实是直接新建一个对话(新开对话会清空上下文,不产生额外消耗)~你平时处理的长对话任务多吗?
 参考文档:
压缩上下文有很多策略
其中之一就是调用LLM去读你的对话内容,然后输出一个总结,大幅压缩上下文长度
如果我说用量管理的记录里没显示模型,怎么说呢?
建议不要压缩,压缩后会丢失很多信息,像失忆一样,直接让AI总结当前会话,生成提示词,然后新开一个会话继续
具体策略我不太清楚,但压缩不显示模型其实挺正常的。就像每个对话窗第一次发言后,左侧列表会自动生成一个标题,那也是后台调了个小模型完成的,但因为开销极小,一般来说不会单独显示在用量里面。
但你是主动进行的压缩上下文,它本质上得把你整个对话记录塞进去做总结,输入token量巨大,所以产生的费用会比较明显。而这类系统内部的压缩模型,应该是不会像你主动发起的对话那样,在用量明细里列出具体模型。所以体感上就是积分扣了,但记录里看不到模型。

不压缩,每轮对话消耗的积分更多
反正现在这个积分消耗和流水一样,够用什么,不调整的话,内置模型没法用了
目前还真不一定,现在trae的压缩机制有点迷,可以看看这个 TRAE Work 上下文压缩后丢失任务执行状态,导致浪费大量 Token ,我是明显感觉压缩后相当于失忆一样,什么都要重新说明和读取。
压缩上下文丢失问题已经在看了哈
问题是,新建一个任务,将之前的规则、经验、教训等带进新任务,同样要耗积分
你说得很对,把之前的规则和经验总结带入新任务,这部分内容确实会作为输入 Token 消耗积分。
但相比在旧的长对话里继续聊,这样依然更省积分。因为在旧对话中,你的每一次提问,模型都需要把之前所有的历史记录(包括反复修改、试错的冗余过程)作为上下文重新阅读一遍,这会造成每轮交互都产生大量的消耗。
而新建对话并只带入精简后的核心规则,等于卸下了历史包袱。虽然初始输入会消耗一次积分,但能大幅降低后续每一轮对话的成本。