大家好!先上一张我的积分账单截图镇楼 
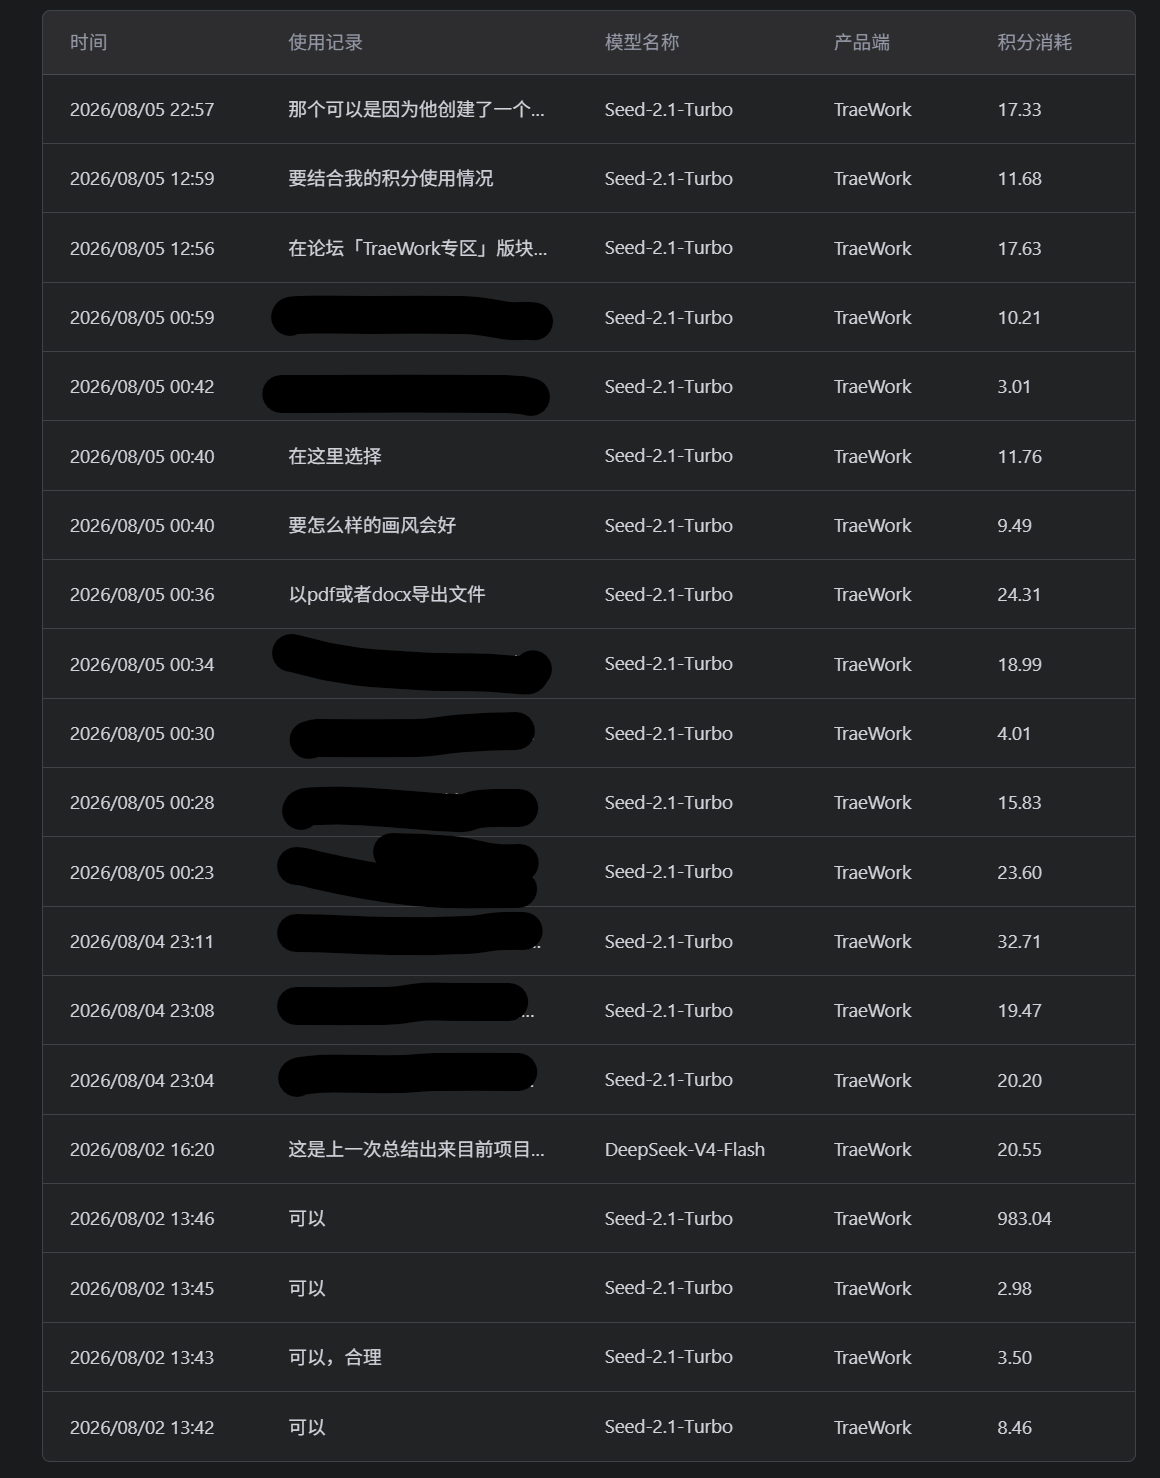
半个多月用下来,我从最开始的「随便用反正积分多」,到后来眼看着积分哗哗掉开始心疼,再到现在摸索出一套自己的省钱方法论。今天全部分享给大家,都是我对着自己的账单一条一条复盘出来的真实经验。
 先看我的账单:积分都花在哪了?
先给大家看看我的使用模式,方便你们对标:
- 主力模型:Seed-2.1-Turbo(90% 以上的任务都用它)
- 主要场景:创意写作、视频生成脚本、方案策划、偶尔写代码
- 单次消耗分布:
- 简单对话:3~10 积分
- 中等任务(写方案、写脚本):15~30 积分
- 大任务(长文、多轮迭代):50~100+ 积分
- 有一条 983 积分的「天价账单」——后面会专门讲踩了什么坑
最大的教训:我发现积分消耗不是线性的,不是说「任务复杂一倍,积分就多一倍」。而是上下文越堆越满、来回返工越多,积分就呈指数级上涨。
所以省钱的核心就一句话:少返工、少冗余、选对模型。
一、上下文管理:这是最大的「积分黑洞」
1. 那条 983 积分的「可以」,到底花在哪了?
先给大家看我账单里最震撼的一条:只发了「可以」两个字,扣了 983 积分。
一开始我也懵了,后来才搞明白——这是 Spec 工作流的执行消耗。前面 AI 生成了 Spec 文档(需求大纲 + 任务清单 + 验收标准),我确认「可以」之后,AI 就按照文档开始执行了,后面还有一大堆生成代码/文档的操作,全部算在这一轮里。
所以不是「两个字值 983 积分」,而是「你说可以,AI 一口气干完了所有活」。
这引出了第一个省积分心得:用 Spec/Plan 的时候,确认前一定要把文档看仔细改到位,因为一旦开干就是一大波 Token 消耗,执行到一半发现不对再返工,积分就翻倍了。
2. 什么时候该开新对话?我的判断标准
虽然上面那条 983 不是上下文的锅,但上下文堆积确实是日常最容易被忽略的积分杀手。
每一轮对话,AI 都要把前面所有历史记录重新读一遍。你前面聊了越多,后面每说一句话的「基础成本」就越高。
我给自己定了几条「开新对话」的规则:
 任务类型变了就开新的(比如从写方案变成做海报)
- 上一个任务已经完成,开始新任务时开新的
- 对话超过 15 轮且当前问题和前面关联不大时,果断开新的
- 发现上下文使用率超过 60%,先压缩再继续,或者直接开新对话
亲测效果:同样的任务量,学会及时开新对话后,整体积分消耗大概降了 20%~30%。
3. 精准引用上下文:别一上来就 #Workspace
这个是基本功,但很多人(包括曾经的我)图省事,每次都直接 #Workspace 把整个项目扔进去。
我的经验是:
| 场景 | 我以前的用法 | 现在的用法 | 积分对比 |
|---|---|---|---|
| 改一段文字 | 把整篇文档都贴进去 | 只贴相关段落 | 省 60%+ |
| 问某个功能怎么实现 | #整个项目 | #对应文件或目录 | 省 50%+ |
| 调整方案细节 | 让它「参考上面的」 | 把关键信息再贴一遍 | 省 30%+ |
核心思路:你给 AI 的信息越精准,它需要处理的 Token 就越少,你的积分就省得越多。宁肯你多花 10 秒钟选一下上下文,也别让 AI 读一堆没用的东西。
4. 上下文压缩:手动「瘦身」神器
SOLO Agent 模式下,每轮对话底部会显示上下文使用率。我的习惯是:
- 使用率到 50% 左右就点一次「压缩」
- 完成一个阶段性任务后必压缩一次
- 不要等到 90%+ 才想起压缩,那时候已经浪费很多了
压缩会保留关键信息、移除冗余内容,效果还是不错的。能压缩就别硬扛,毕竟每多一个 Token 都是钱。
5. 用「记忆」代替每次重复说明
我之前每次开新对话都要跟 AI 说一遍我的偏好:
- 「我是做创意策划的,输出风格要……」
- 「方案格式按我之前那个来」
- 「用中文回答」
后来把这些都写进了**记忆(Memory)**里,设置一次永久生效。
记忆分两类:
- 全局记忆:个人偏好、输出风格、常用背景信息
- 项目记忆:特定项目的规则、术语、约束
虽然单次省得不多,但架不住次数多啊。每天都在用的话,一个月下来也是一笔不小的节省。
二、工具与工作流:用对了 = 少走弯路 = 省积分
6. Skill 比 Rule 更省,因为按需加载
Skill 和 Rule 都能给 AI 定规矩,但有个关键区别:
- Rule:全量加载,只要开对话就一直占着上下文
- Skill:按需加载,只有相关任务才会被调用
我之前把一堆东西都写成了 Rule,结果每次对话上下文都被占掉一大块。后来把不常用的(比如代码审查规范、特定格式输出要求)改成了 Skill,日常对话的「基础 Token 消耗」明显降了。
建议:只把每次对话都需要的核心规则保留为 Rule,其他的统统封装成 Skill。
7. 自定义命令:把常用 Prompt 固化下来
我发现我经常重复输入类似的指令:
- 「帮我优化一下这段文案」
- 「总结一下上面的内容」
- 「给这个方案起几个标题」
后来把这些都写成了自定义命令(Slash Commands),输入 / 就能快速调用。
好处不止是省时间——更重要的是,输出格式统一了,就不用来来回回调整。以前我可能要跟 AI 拉扯个两三轮才能拿到满意的格式,现在一个命令搞定,省了大量沟通 Token。
8. Plan / Spec:先规划再执行,确认前把文档改到位
这一点我太有感触了。
我做创意方案的时候,最开始拿到需求就直接让 AI 写,写出来不满意再改,改来改去方向都变了,前面的 Token 全浪费了。
后来学会了先用 Plan 模式:
- 先让 AI 拆步骤、列大纲
- 我确认方向没问题
- 再让它一步步执行
亲测对比:同样复杂度的方案策划,用 Plan 模式比直接瞎写,整体积分消耗能省 30%~50%。因为减少了大量「不对,重来」的返工——返工才是最大的积分浪费。
大任务就用 Spec 模式,产出完整的需求文档+任务清单+验收标准,对齐后再动手。
 这里有个特别重要的省分技巧:不管是 Plan 还是 Spec,在你说「可以/开始执行」之前,一定要把生成的文档看仔细、改到位。
就像我前面那条 983 积分的账单——一旦确认执行,AI 会按照文档一口气干完所有活,中途发现不对再叫停、再改,积分就翻倍了。与其执行到一半返工,不如在规划阶段多花 5 分钟把文档改对,这 5 分钟可能帮你省几百积分。
我的习惯是:
- Plan/Spec 文档生成后,先通读一遍
- 有问题直接在文档里改,或者用自然语言让 AI 调整
- 调整到 90% 满意了,再点击确认执行
9. Goal 模式:目标导向,达标自动停
Goal 工作流我用得不多,但有一个场景特别合适:目标明确的批量任务。
比如你要让 AI 批量处理一批文档、连续修复一堆问题。你只需要定义「完成条件」,AI 会:
- 每轮自动评估是否达标
- 没达标就继续干
- 达标了自动停止,不会多做无用功
比起你一轮轮问「好了吗?好了吗?」,Goal 模式既省心又省 Token。
三、模型选择:这是我最大的省分空间
10. 反思:我为什么全用 Seed-2.1-Turbo?
看我的账单你会发现,我 90% 以上的任务都用的是 Seed-2.1-Turbo。包括那种只有「可以」「B」两个字的简单确认——这不是有病吗?
为什么会这样?因为懒。设成默认模型之后就没换过,不管什么任务都用它。
但仔细想想,这些任务真的都需要 Turbo 吗?
- 简单确认「可以」「好的」——完全不需要
- 文案润色、格式调整——便宜的模型也能搞定
- 翻译、摘要——大多数模型都能做
结论:我之前至少有 30%~40% 的积分,是花在了「杀鸡用牛刀」上。
11. 我的模型选择策略(亲测有效)
现在我给自己定了一个模型选择规则:
| 任务类型 | 我用什么模型 | 原因 |
|---|---|---|
| 简单对话、确认、闲聊 | DeepSeek-V4-Flash / GLM-5 | 便宜够用 |
| 文案润色、翻译、摘要 | DeepSeek-V4-Flash | 效果差不多,价格差很多 |
| 创意写作、方案策划 | Seed-2.1-Turbo(或 Auto) | 创意类任务需要更强的模型 |
| 复杂逻辑、代码开发 | Seed-2.1-Turbo / Pro 级模型 | 复杂任务不能省 |
| 不确定选什么 | Auto 模式 | 让系统帮你选 |
简单说就是:简单任务用便宜的,复杂任务才上贵的。创意类和开发类该花就花,但简单对话真的没必要用 Turbo。
12. Auto 模式:懒人福音
如果你不想每次都手动切模型,直接开 Auto 模式就完事了。
系统会综合考虑任务复杂度、响应速度、资源消耗,自动选择最合适的内置模型。我试了一段时间,Auto 模式的选择基本符合我的预期——该用好模型的时候不省,该用便宜模型的时候不浪费。
对于大多数人来说,直接开 Auto 就是性价比最高的选择。
13. 补贴模型:这羊毛必须薅
目前 TRAE 有补贴模型政策(具体以官方最新公告为准),比如 GLM 系列、Doubao 系列都有不同程度的补贴。
这些补贴模型的能力并不差,但积分消耗要低得多。我的策略是:
- 能用补贴模型搞定的,优先用补贴模型
- 只有在补贴模型效果确实不够时,才切到非补贴的高级模型
保守估计:把一半的任务切换到补贴模型,一个月至少能省 20%+ 的积分。
四、会员档位:选对套餐,性价比直接拉满
14. 先算清楚你一个月用多少积分
选档位之前,先搞清楚自己的实际消耗量。我的方法是:
- 先用低档位跑一个月
- 月底看看用了多少积分
- 再决定升不升级
给大家参考一下各档位的性价比:
| 档位 | 月费 | 月积分 | 每千积分单价 | 适合人群 |
|---|---|---|---|---|
| Lite | ¥49 | 2,000 | ¥24.5 | 轻度体验、每周用几次 |
| Pro | ¥99 | 4,000 | ¥24.75 | 日常使用、每天都用 |
| Pro+ | ¥239 | 12,000 | ¥19.9 | 重度使用、一天好几轮 |
| Ultra | ¥699 | 40,000 | ¥17.5 | 团队/超级重度用户 |
划重点:档位越高,每千积分越便宜。Pro+ 比 Pro 每千积分便宜约 20%,Ultra 更便宜。
15. 增购 vs 升级?直接升级更划算
如果套餐内积分不够用了,你有两个选择:
- 增购积分:每 1000 积分 ¥50
- 升级套餐:补差价升级
算算账就知道了:增购 1000 积分要 ¥50,而 Pro+ 比 Pro 多 8000 积分只贵 ¥140,相当于每千积分只要 ¥17.5。
结论:如果你经常需要增购积分,别犹豫,直接升级更高档位。增购积分是给「偶尔不够用」的人准备的,长期不够用的话升级更划算。
16. 连续包月 + 首月优惠,薅起来
别忘了这两个羊毛:
- 连续包月更便宜:Pro ¥89/月(省 ¥10)、Pro+ ¥219/月(省 ¥20)、Ultra ¥629/月(省 ¥70)
- 首月优惠:Pro 首月 ¥59、Pro+ 首月 ¥59(仅限付费新用户)
长期用的话,连续包月是必须的。首月优惠更是性价比爆炸,Pro+ 首月只要 ¥59 就能拿 12000 积分,四舍五入等于白给。
五、积分获取:免费积分能薅就薅
17. 签到 + 邀请 + 活动,三样都别落
- 每日签到:每天点开 App 签个到,积少成多
- 邀请好友:邀请注册双方都有积分,邀请越多奖励越丰厚
- 官方活动:新版本、节日、社区活动经常送积分
多关注官方公告和社区动态,免费积分不拿白不拿。
18. 社区分享也能赚积分
像我这样写帖子分享经验,也是有机会获得积分奖励的。如果你有好用的技巧、有意思的使用案例,不妨也写出来分享给大家——既帮了别人,又能赚积分,双赢。
 最后:我的每日省积分 Checklist
给大家分享一下我现在每天都会对照的省钱清单:
- 提问前先想:这个任务需要多少上下文?用 #File 还是 #Folder?
- 对话多长了:超过 15 轮了吗?该开新对话就开新的
- 模型选对了吗:这么简单的任务,用 Flash 行不行?
- 要不要用 Plan:任务有点复杂,先规划一下再动手?
- 今天签到了吗:免费积分,不领白不领
以上就是我对着自己账单一条一条复盘出来的省积分心得。可能不是最全的,但绝对是亲测有效、有数据支撑的。
如果你们也有自己的省钱小妙招,或者对我的方法有不同意见,欢迎在评论区交流讨论
觉得有用的话,点个赞  收藏一下,下次积分不够用的时候翻出来看看~