【标题】 【学习工作赛道】 Coding Ontology - 下一代软件工程应用范式
0. 先和大家打个招呼吧 
- 你是谁: 我是一名算法工程师,平时不光要负责算法训练,还需要做下游应用。
- 你是怎么用 TRAE 把 Demo 做出来的:已经有了一个核心思路,让Trae IDE帮我继续完善和测试,以及做可视化方便调试。
1. Demo 简介
-
是什么:这是一个后端项目,对外接口是一个MCP和一系列skill,部署在本地或局域网中,启动后可以接入Trae或其他coding agent;
-
面向谁:核心用户是需要维护大型企业级项目、需要面对大量文档和内部规则的开发团队;
-
主要功能:
-
1. 依据已有的文档、隐性知识等文本,构建数据本体
-
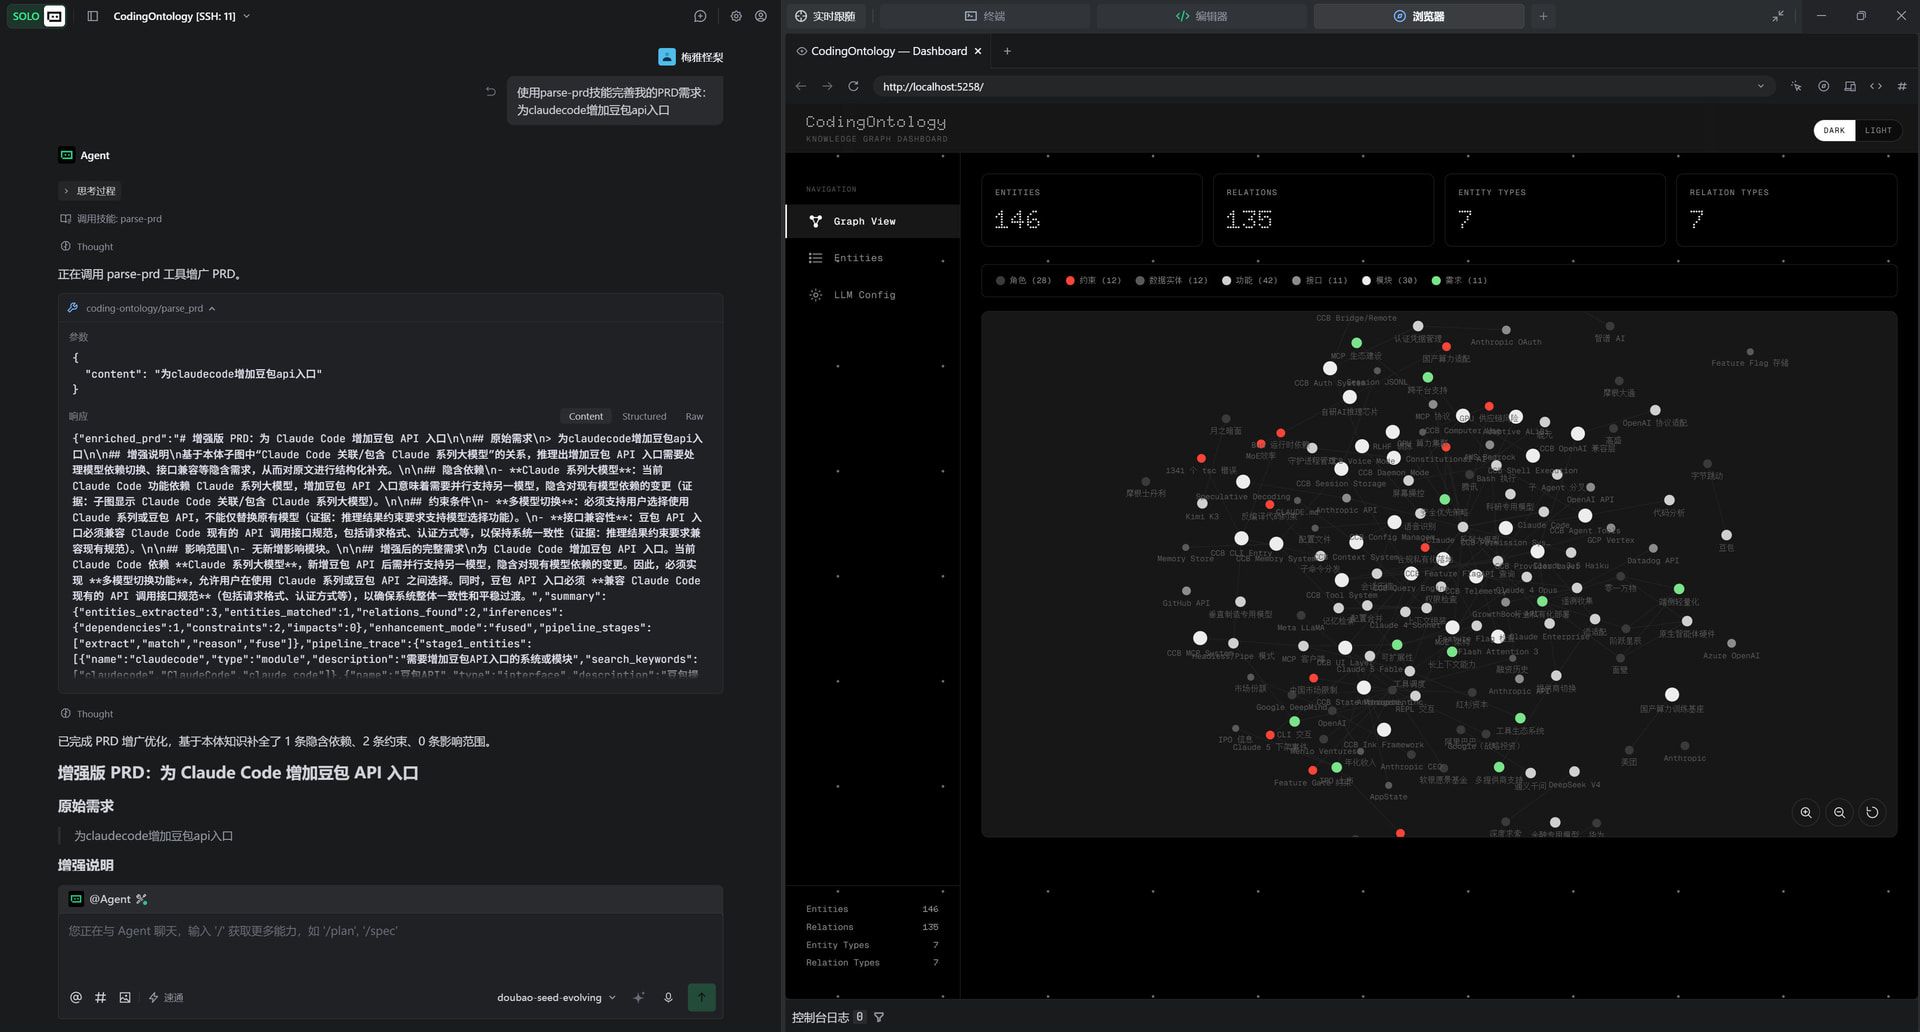
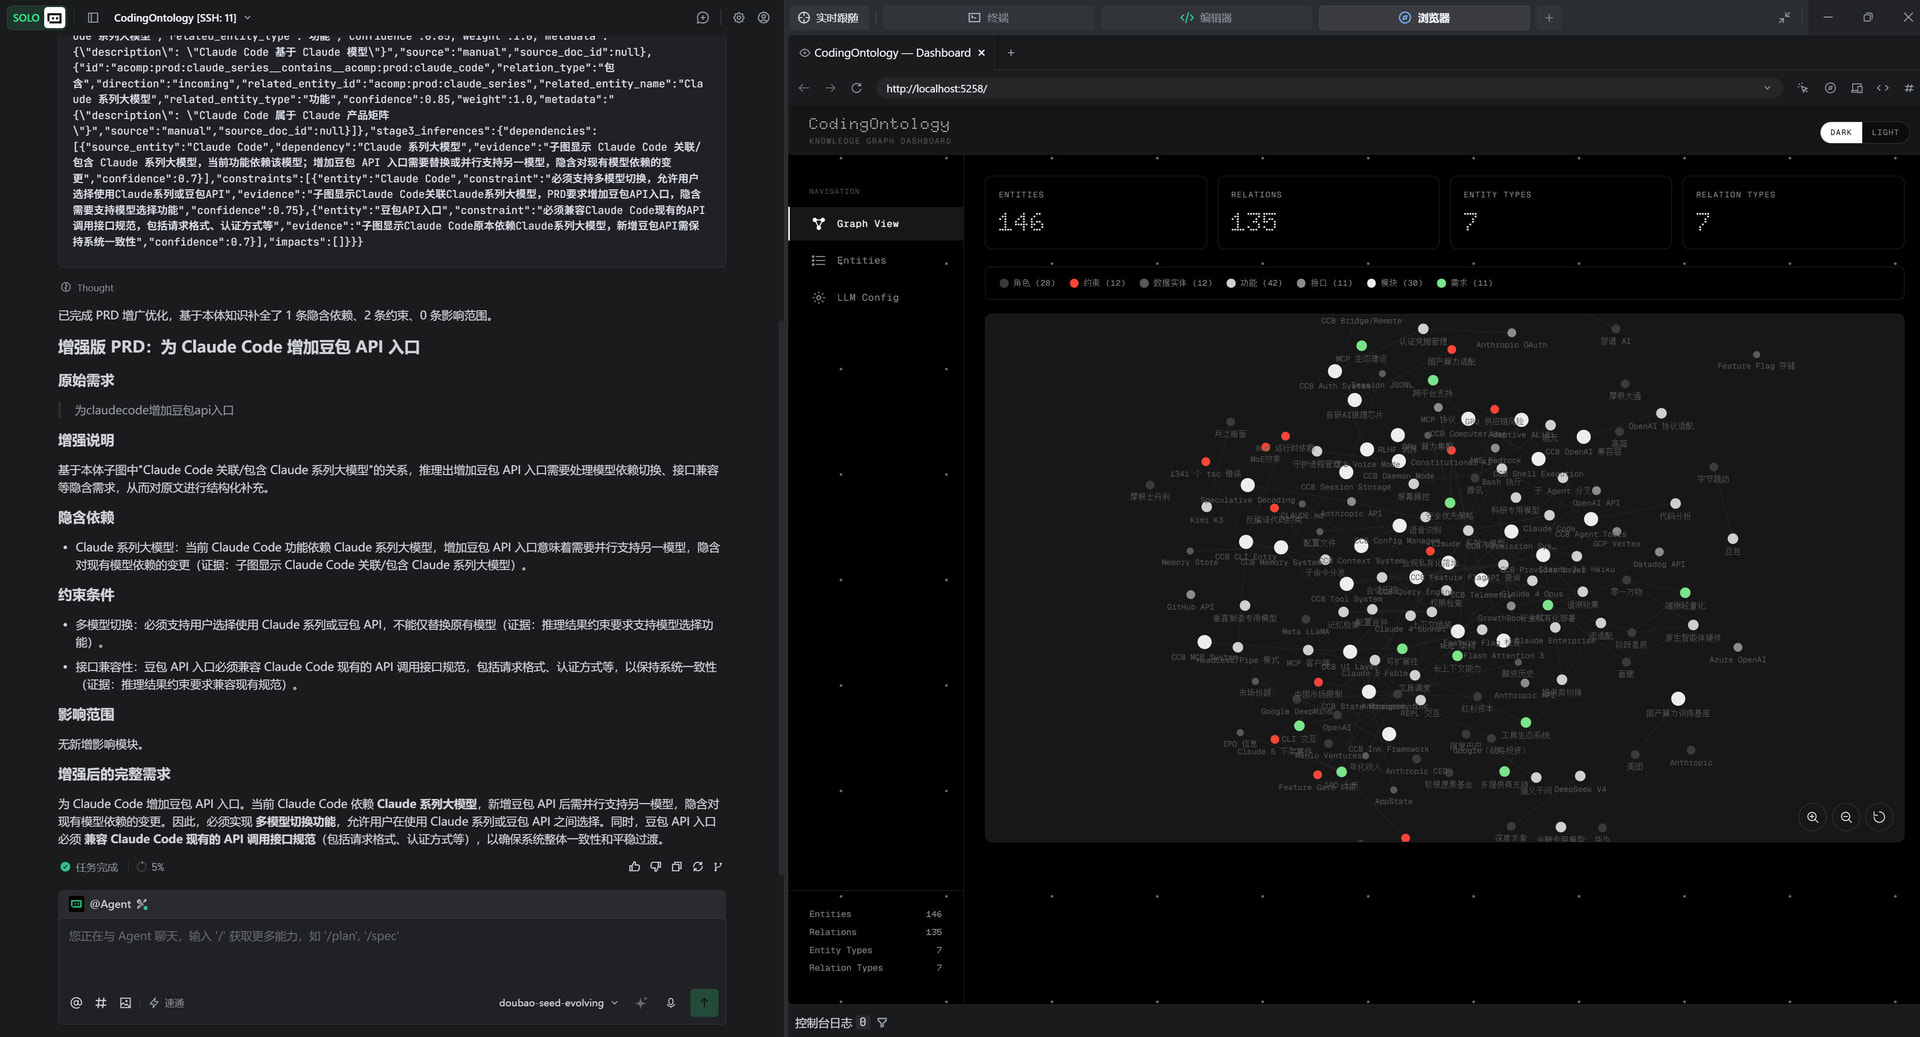
2. 调用这个MCP,输入你的PRD,它可以根据本体中已有的信息来对你的PRD信息增强,本体中的实体和关联存得越多,能发掘出的隐性关系越多。不同于使用大量文档的知识库,它对token消耗量极低。
-
3. 一个前端看板,可供随时检查本体中的每个实体和关联,可以使用内置技能通过本mcp对数据本体中的相关实体或关联关系进行CRUD。
2. Demo 创作思路
-
灵感来源:受Palanitr公司的Ontology方案启发,做了个这东西用于辅助PRD实施过程;
-
想解决的问题:面对超大代码库、海量文档的情况下,快速定位PRD想要增加或修改的部分,并进一步推演出它的影响,并非单纯代码库索引,而是代码库+文档库+海量隐性知识建立的本体;
-
为什么做这个方向:
 日常深耕算法训练与下游应用开发,团队承载着数个百万行代码量级的大型工程。每一套项目都被数十份设计、需求文档与规范层层约束,大量文档服务于整套巨型系统,而非单一软件研发。每当需求发生变动,在铺天盖地的碎片化信息里定位修改节点、厘清全部连带影响,是一件极具挑战的事。
 尝试过建立wiki文档知识库,但海量的文档会快速填满LLM的上下文,难以快速有效挖掘出相关关联信息,若开启多个subAgnet去遍历调研,则面临token成本与时间成本,同时带着海量信息去coding也会让执行效果大打折扣。
 我由此得出一套核心设计逻辑:所有历史检索资源应当留存复用,实体之间的潜在关联首次推演后即可随时调取,识别对应实体后自动触发后续执行流程,这与 Palantir Ontology 本体思想不谋而合。
- 我尝试建立一个专注于提升coding agent执行效率的轻量级本体,它有一部分Palantir和当前市面上很多仿造Palantir的公司所做的产品类似的能力—-构建一个企业数字孪生平台,从信息中发掘实体并标定关联,让关联数据为我所用,但更多的是为coding过程服务,coding agent在执行过程中只要关注起点、脚手架、终点即可,而我的方案就是尽可能快的从PRD中帮助coding agent找到终点,同时减少意外。
 我眼中的下一代软件工程,应该是尽量减少代码、功能模块等的存在感,让软件代码像日常流淌在电线里的电流一样自然与稀疏平常,编码过程就像低烈度的化学反应一样无感而迅速,人们不会去关心这个功能改了会不会把其他几个功能干到难以挽回的崩溃,只要在需要的时候把某个插头接到另一个插座上就行了,其他的Agent自有分寸。
 未来LLM能力的提升会内化掉本体吗?我认为只要那些大量无法公开的、内部的隐性知识依然存在且在源源不断被产生,本体的能力就不会消失。而相比于CPT、LORA或RAG等方式,本体反而要轻量且准确得多。
3. Demo 体验地址(三选一)
-
后端项目,需要本地运行,
项目源码包:
CodingOntology.zip (5.3 MB)
-
下载后需要依照README.md安装python依赖,然后启动前端与mcp服务器,配置自己的LLM api,再配置到trae中。
-
目前内置了一部分我生成的数据,用于测试核心功能。
-
也可直接去git下载项目,github仓库位于 https://github.com/dreandnought/CodingOntology.git
4. TRAE 实践过程
-
当前状态:目前已实现依据文本信息建立本体图谱、使用MCP调整实体与关系等功能,使用本体信息可增强PRD。
-
后续计划:(1)多用户访问鉴权 (2)实体与关系建立算法优化 (3)增加可用于推理的关联语义信息(4)本体检索与前向推理能力优化。
-
开发中遇到的问题:古法开发经验很丰富,而且TRAE已经用了一年半了,因此没有遇到什么大困难;但是这是第一次开发和使用MCP,发现开发完成的MCP即使重开了fastmcp也没有自动更新,必须手动在TRAE中重启一次才可以。
-
附开发关键步骤截图(不少于 3 张);
-
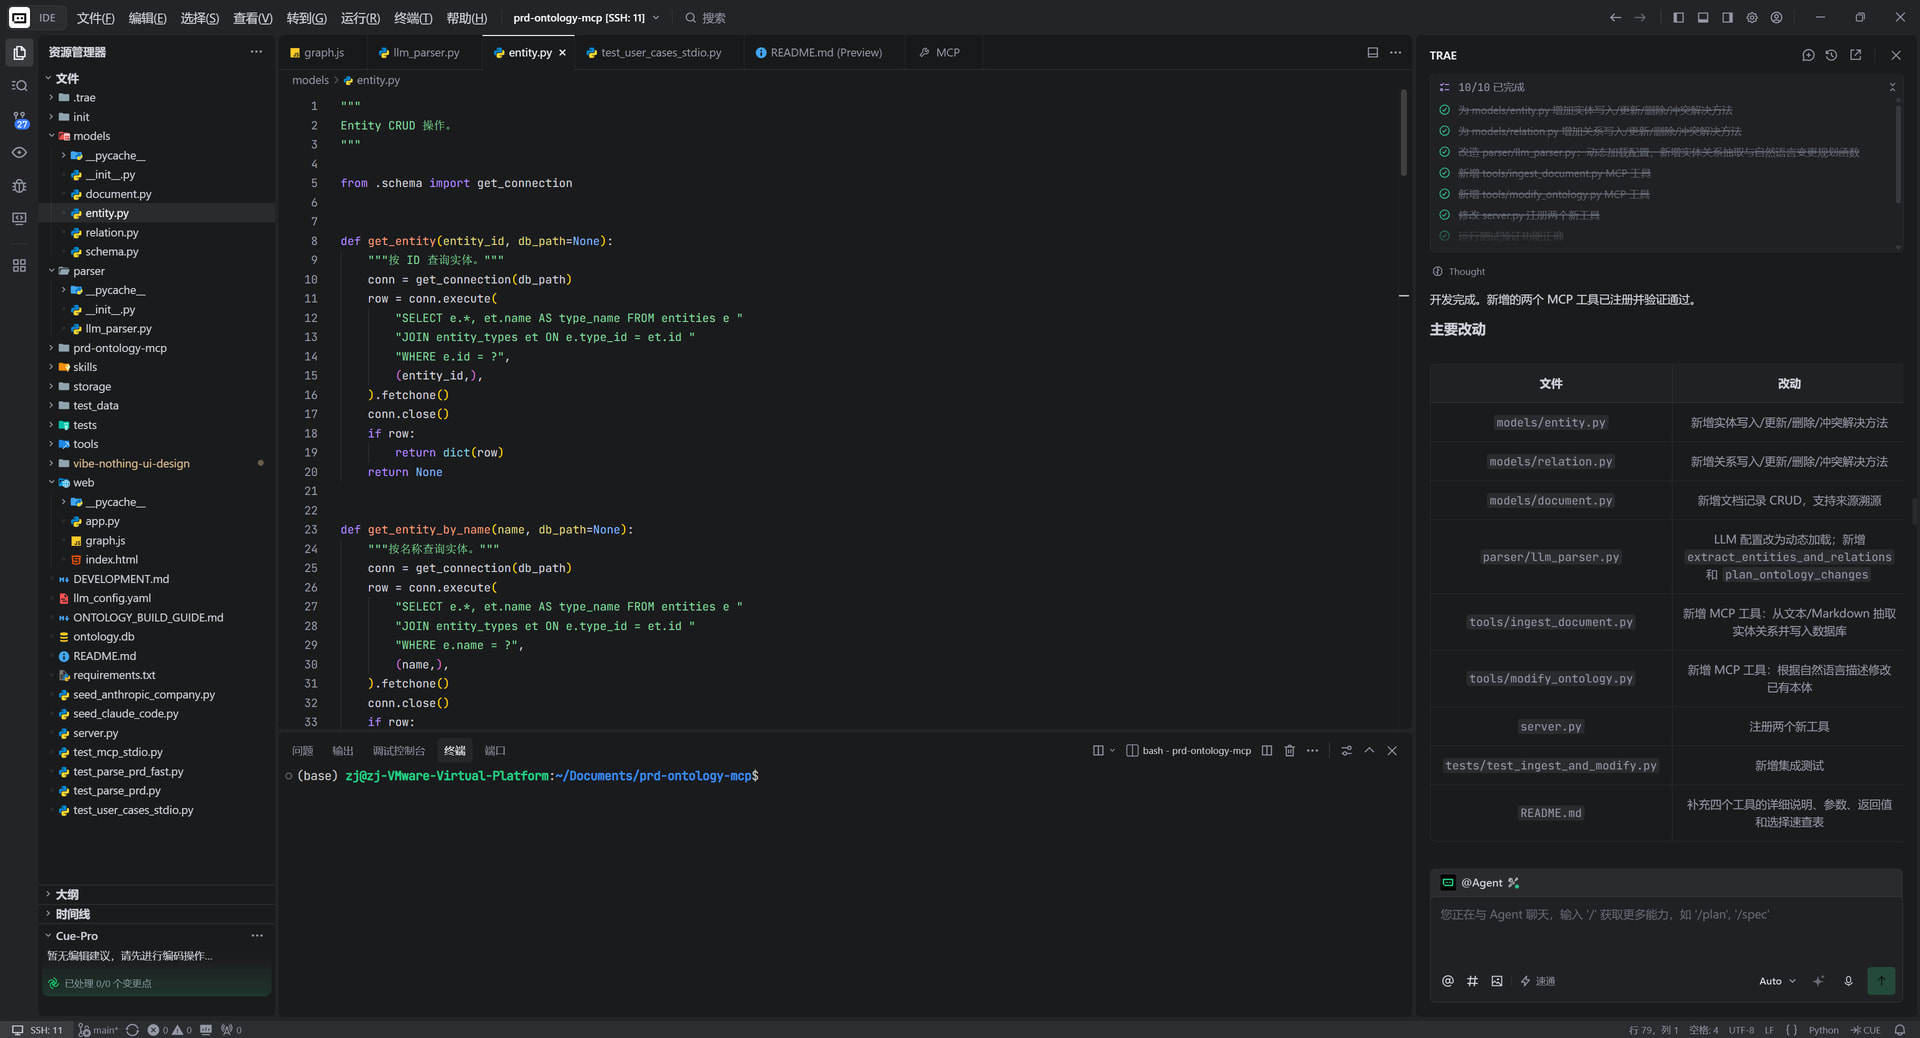
MCP核心工具构建:
-
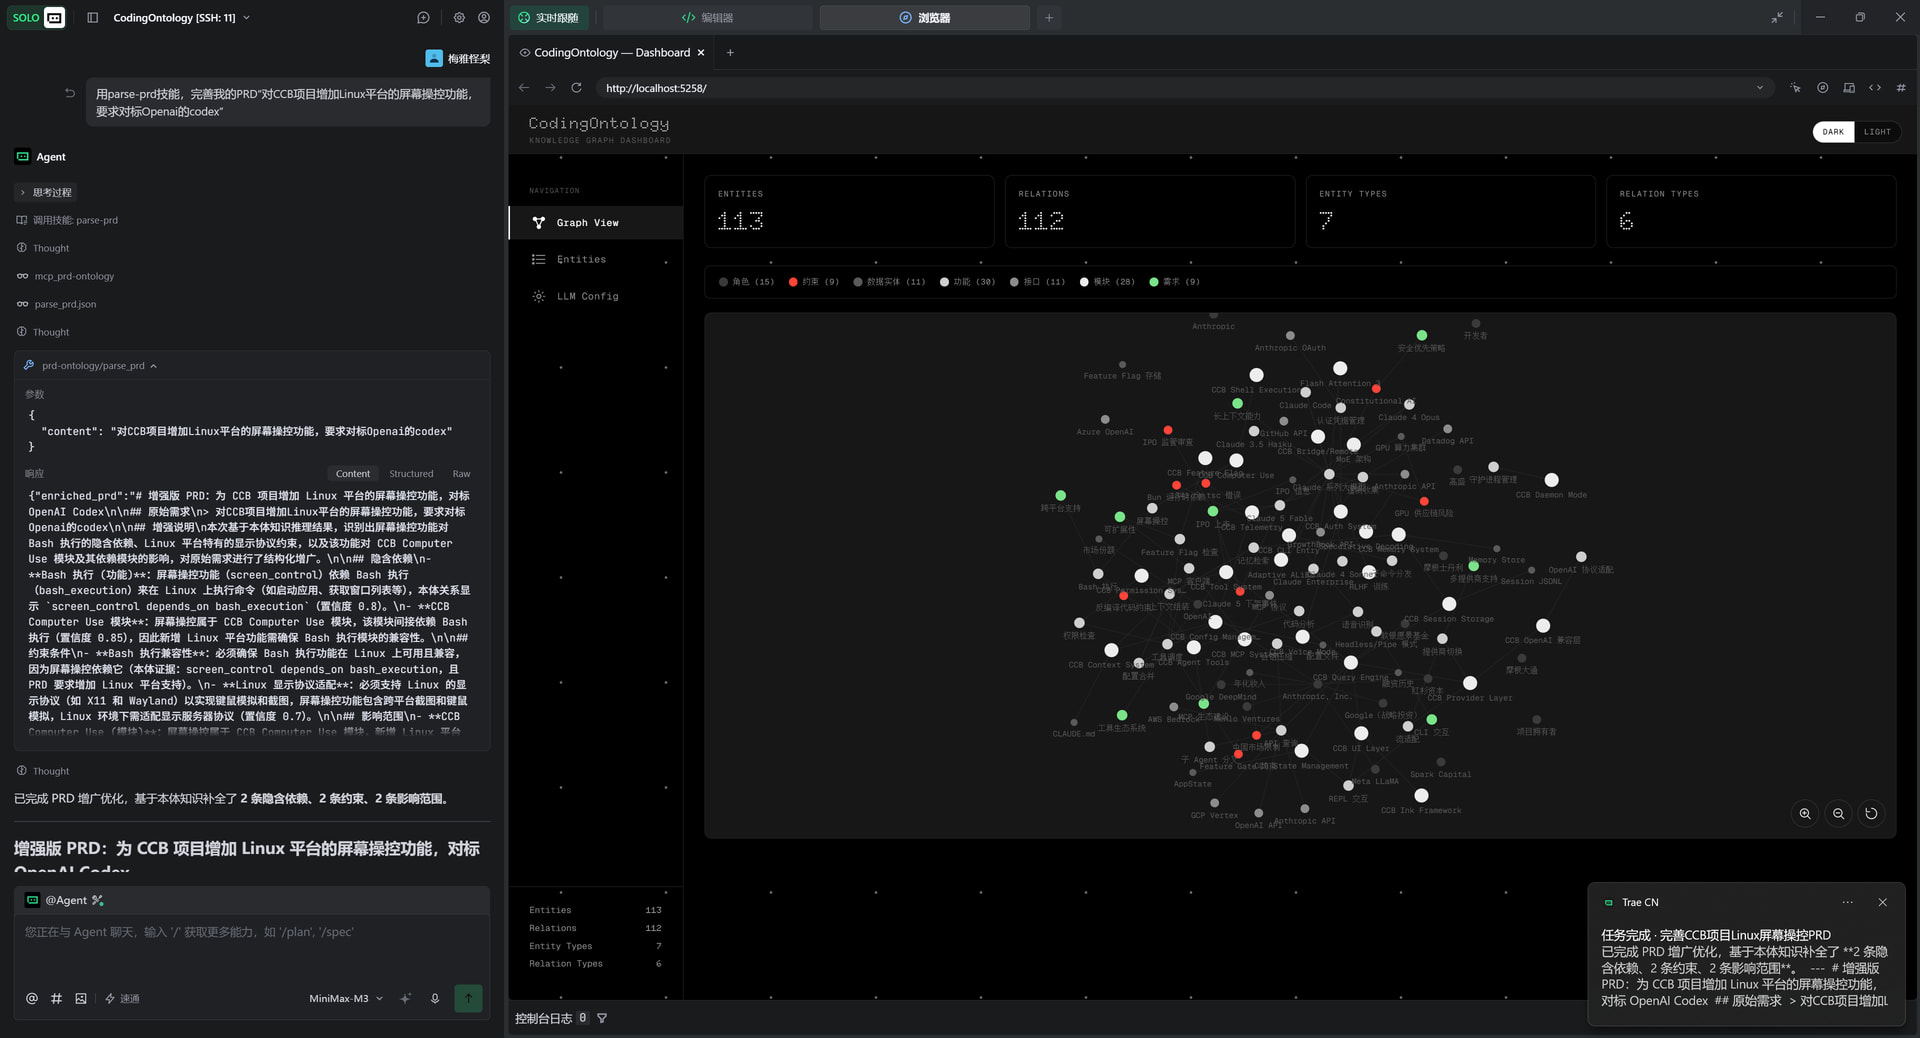
核心功能(PRD增强)debug:
-
解决本体数据更新中的小bug:
-
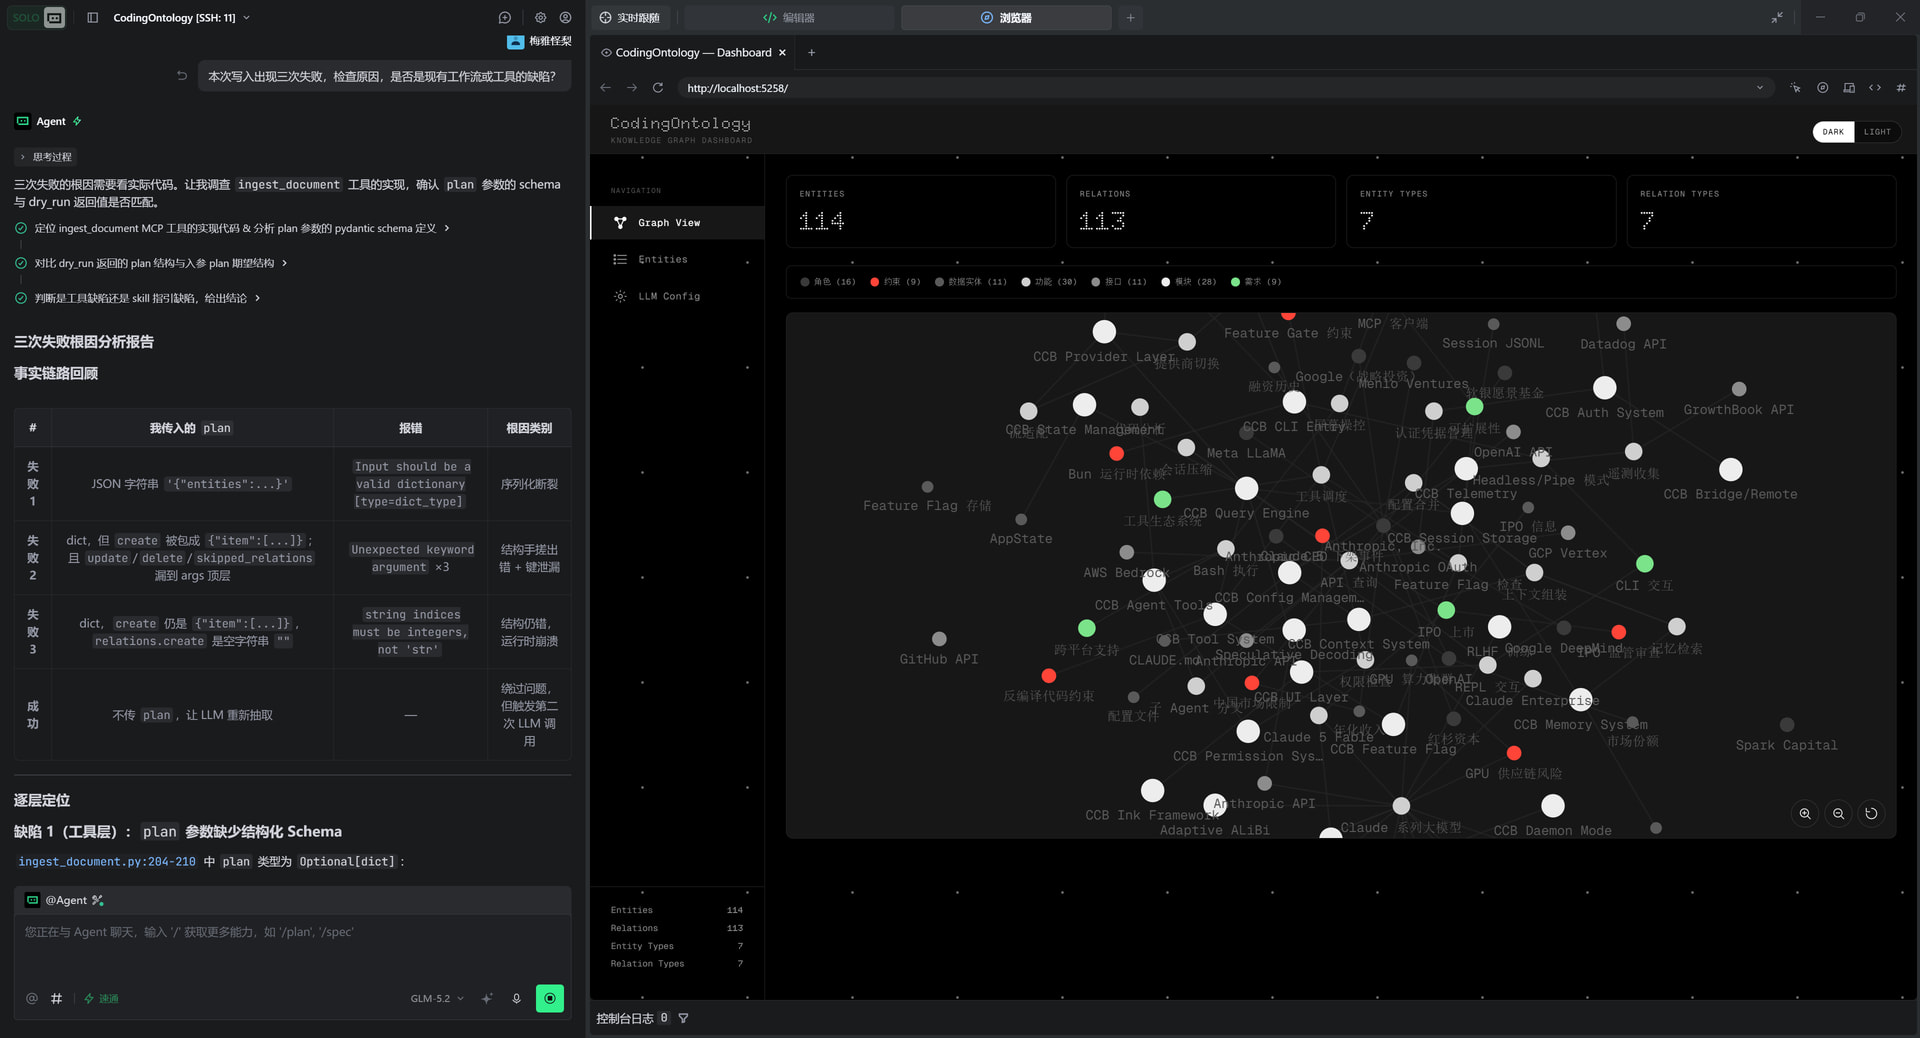
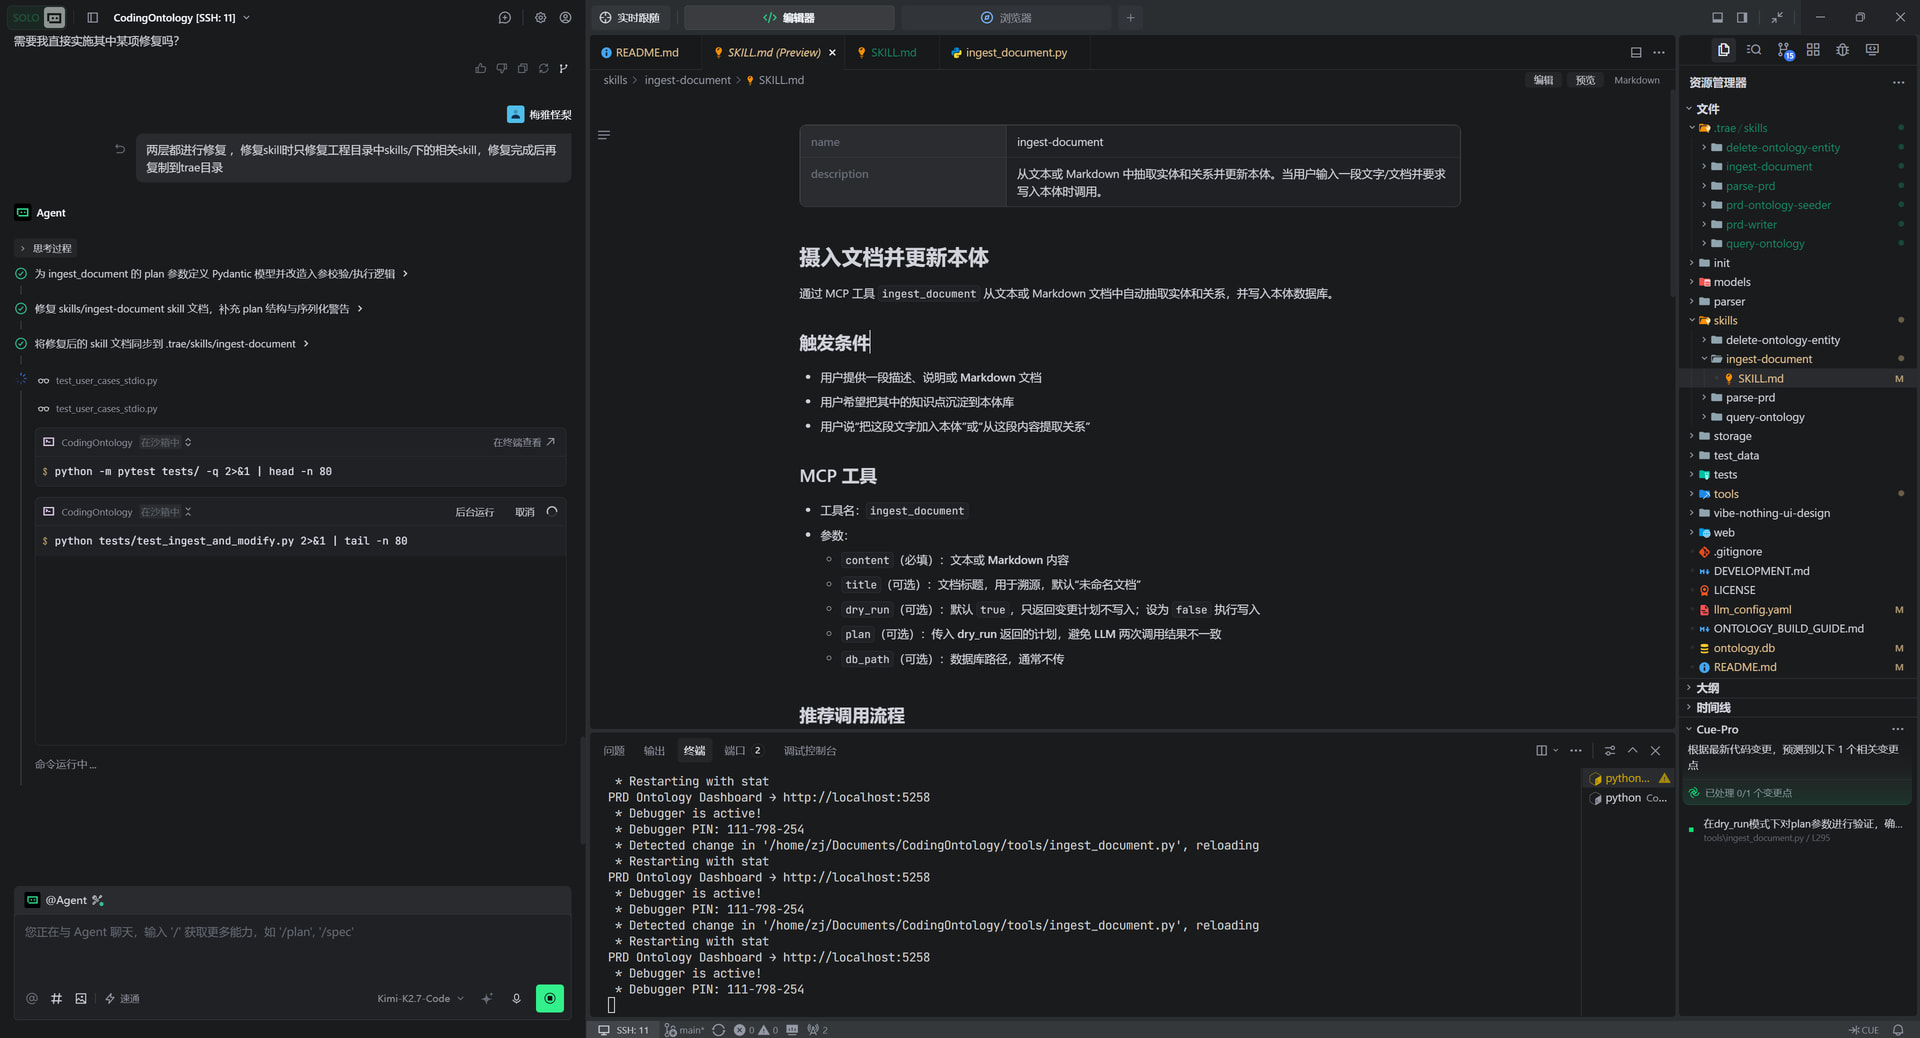
问题定位后,修复和优化工作流中的问题:
-
附关键任务对话的 Session ID(不少于 3 个),用于证明作品由 TRAE 开发完成。
-
.3534296379317915:616272eb7245ca59a200f3b3594ff414_6a563556eda2590c307c8676.6a56357beda2590c307c8679.6a56357a0247421ec7d696ca:Trae CN.T(2026/7/14 21:11:23)
-
.3534296379317915:c708528e191f799485f77f2b61a8f964_6a563556eda2590c307c8676.6a565380eda2590c307c8d22.6a56537f0247421ec7d696d9:Trae CN.T(2026/7/14 23:19:28)
-
.3534296379317915:047a2a57f0f30bf9b022afe0d712c60f_6a56edebbe131f133444916b.6a56f3f2be131f1334449355.6a56f3f1c6a68fa89c9bf3af:Trae CN.T(2026/7/15 10:44:02)
-
.3534296379317915:f1b210c1d14b5ccd762cd1a3f212605a_6a577f14eda2590c307c922c.6a5782b8eda2590c307c92bc.6a5782b7ff1e326f7385e8b7:Trae CN.T(2026/7/15 20:53:12)
5. 对应的报名审核通过的帖子链接