【学习工作】ZLink–AI 治理底座:企业级业务建模与应用搭建引擎
一、创意名称 + 创意介绍
创意名称: ZLink–AI 治理底座:企业级业务建模与应用搭建引擎
想解决什么问题:
当下 AI 代码生成、AI 搭应用的工具层出不穷,看似大幅降低了开发门槛,但本质仍停留在「用 AI 更快地写代码、画页面」的效率改良层面。
业务规则散落在生成的代码片段、页面配置与流程节点中,无法被结构化沉淀为可复用的业务资产;生成的应用越复杂,数据与逻辑一致性就越难保障;后续业务迭代依然依赖技术人员,无法真正实现业务自主。
ZLink 选择了另一条路径:以「业务对象」为统一元数据载体,让 AI 直接理解业务语义、生成完整业务模型,一次定义即可自动派生出全链路应用能力,真正实现业务知识的可沉淀、可复用、可迭代。
为什么会想到做这个(重点):
这是这个项目最想讲清楚的事。
今年 AI coding 工具的爆发,TRAE、Codex、Claud code 让"一句话生成一个页面""半天搭出一个后台"变成现实。于是行业里开始出现一种声音:低代码已死,AI 写代码就够了。 连我自己团队里都有人问:既然 AI 几分钟能写出 CRUD,为什么还要花精力做一个低代码平台?
我做完这个项目,给出的答案是:AI 写代码和低代码,根本不是同一个问题域,谈不上谁替代谁。 它们一个解决"代码生成",一个解决"业务事实的结构化沉淀与运行治理"。
具体来说,AI coding 解决不了四件事:
-
业务事实不是代码。 一个采购订单有哪些字段、订单状态机怎么流转、哪些角色能看到金额字段、单据转换时子表怎么拆——这些是业务事实,不是写代码的问题。AI 可以替你把这套事实翻译成代码,但事实本身仍然散落在 PRD、Excel、口头约定里。下次业务改了,你又得让 AI 重新翻译一遍,没有沉淀,没有版本,没有治理。
-
运行时治理是契约,不是实现。 多租户隔离、数据范围权限、操作审计、字段级可见性、幂等、防重复提交——这些是企业的硬约束,是契约。AI 生成的代码可以"看起来实现了",但只要没人盯,AI 不会主动在每个接口都加上
tenant_id过滤,不会主动给可重试 POST 加幂等键,更不会在每个批量操作里检查权限边界。我们在这个项目里就专门修过一批这样的坑:导出接口漏了租户过滤、关联表逻辑删除撞了唯一约束、订阅规则通知绕过了权限——这些都不是 AI 不会写,而是它没有"必须写"的约束。低代码平台的价值,就是把这种约束焊死在运行时里。 -
业务专家无法参与代码维护。 真正懂业务的人往往不会读代码。如果业务规则全部沉淀在代码里,哪怕 AI 帮你写得很漂亮,业务一旦变更,还是得回到开发手里排队。低代码平台把业务规则变成配置,业务专家可以看懂、可以参与维护、可以追溯每一次变更。这是组织协作的效率,不是代码生成的效率。
-
长期演进需要可控可回滚。 业务系统的生命周期是按年算的。一年里业务会改无数次,每一次变更都需要审计、可回滚、可灰度。配置变更天然适合做版本管理和灰度发布,代码变更要做到这点成本高得多。
所以我的判断是:AI coding 越强,低代码反而越该活下来——但活法变了。 低代码不再是"代替开发者写代码"的工具,而是"承载 AI 生成结果、并保证它在企业里安全运行的治理底座"。AI 负责把自然语言翻译成业务配置,低代码负责把业务配置安全地跑起来。这正是这个项目在做的事——平台本身大量代码是用 TRAE 写的,同时平台里又内嵌了一个 AI 助手,让业务方用对话的方式生成业务对象、配置列表、设计流程。
大概是什么产品:
一个面向中大型企业的AI原生的元数据驱动业务配置平台。它本身是一个完整的 Web 系统(Spring Boot + Vue),全部由trae自助搭建完成,核心是把"业务对象建模—列表/表单设计—业务动作编排—单据转换—通知触达—权限治理—审计追溯"这条链路全部配置化、可运行、可演进。同时内嵌 AI 助手,支持自然语言生成业务配置和智能数据查询。
二、目标用户及痛点
面向哪些用户:
-
中大型企业的 IT/数字化团队:需要快速交付多个业务系统,但又不愿每个项目都从零开始写代码。
-
业务分析师/产品经理:懂业务但不会写代码,希望直接参与业务规则的定义和维护。
-
SaaS 多租户运营方:需要把同一套业务能力按功能包授权给不同租户,并保证数据隔离。
在什么场景下使用:
-
业务部门提出一个新单据需求(如"我们要上线一个供应商准入流程"),IT 团队当天就能配置出业务对象、表单、列表、审批按钮、单据转换和通知规则,而不是排期两周开发。
-
业务规则变更(如"采购订单金额超过 10 万要走二级审批"),业务分析师直接改配置,不需要走开发排期。
-
跨租户复用:把"采购管理"打包成功能包,授权给新租户即可上线,菜单/业务对象/按钮权限一并生效。
当前痛点:
-
传统开发:每个业务系统都是一次性代码,业务规则散落在代码、注释、PRD 里,没人能说清全貌。
-
纯 AI coding:能快速出原型,但运行时治理(租户隔离、权限、审计、状态机)全靠人盯,企业级上线心惊胆战。
-
传统低代码:可视化拖拽看似友好,但配置能力浅、扩展性差,遇到复杂业务流程(如单据转换、分组通知、断点调试)就卡壳,最后还是得回到代码。
三、与其他平台的核心差异
市面上不缺低代码/无代码平台。我们把这个项目最常被拿来对比的几类产品梳理了一下,核心差异不是"功能多寡",而是定位层级不同。
与飞书妙搭的差异
飞书妙搭是 2026 年最热的 AI 原生系统搭建工具,我们对它的定位高度认同——它确实把"业务人员自助搭轻量系统"这件事做到了极致。 但妙搭和我们解决的不是同一个问题:
| 维度 | 飞书妙搭 | Zlink(本项目) |
|---|---|---|
| 定位 | 部门级轻量系统、业务人员自助搭建 | 中大型企业核心业务系统、IT 团队主导 |
| 数据基座 | 多维表格 + Serverless PostgreSQL(飞书托管) | 企业自有 MySQL(支持分库分表预留) |
| 生态绑定 | 飞书生态深度绑定,外部用户访问需付费版 | 可私有化部署,不绑定任何生态 |
| 业务流程 | ECA 自动化流(触发-条件-动作) | Pipeline 引擎(DAG 拓扑 + 6 类步骤执行器 + 门控条件) |
| 单据转换 | 多维表格"引用/查找引用" | 独立单据转换引擎(合并/拆分/7 种字段映射/主子表跨实体) |
| 多租户 | 飞书租户内权限隔离 | 真正的多租户 SaaS(租户隔离 + 功能包授权 + 跨租户复用) |
| 通知渠道 | 飞书消息为主 | 7 种渠道(邮件/短信/钉钉/企微/飞书/公众号/站内)+ 三种推送模式 |
| 可观测性 | 应用运营看板、监控告警 | TraceContext 全链路追踪 + Pipeline 断点调试 + SSE 实时事件流 |
| 部署方式 | SaaS 托管,平台锁定 | 可私有化部署,代码在客户手里 |
一句话总结差异:妙搭解决的是"业务人员能不能自己搭一个系统",我们解决的是"企业核心业务系统能不能不重复造轮子、还能安全上线"。两者是互补关系而非替代关系——妙搭适合部门内 30 人以内的小工具,我们适合跨部门、跨租户、需要审计和治理的核心业务系统。
与传统低代码平台(简道云 / 明道云 / 宜搭 / 轻流)的差异
这一类平台共同特点是表单驱动、流程驱动、SaaS 托管、面向业务人员。它们在简单场景下很高效,但在三个能力上普遍偏弱:
-
复杂业务编排能力浅:大多是线性流程或简单分支,遇到 DAG 拓扑、并行执行、条件跳过、上下文快照这类需求就卡壳。本项目把 Pipeline 做成了完整的执行引擎,还支持断点调试和 dry-run——这是传统低代码平台基本没有的能力。
-
单据转换能力缺失:采购订单转入库单、销售订单转出库单——这是企业核心场景,但传统低代码平台基本都靠"写代码"或"堆流程"硬扛。本项目有独立的单据转换引擎,支持合并/拆分/7 种字段映射策略(直接/固定/系统变量/聚合/公式/查找/自动编号),主子表可跨实体映射。
-
企业级运行治理弱:多租户隔离、数据范围权限、字段级可见性、操作审计、敏感字段脱敏——这些能力传统低代码平台大多有"基础版",但做到企业级硬约束的不多。本项目把这些做成了运行时契约,所有接口默认带租户过滤、所有批量操作默认带权限校验、所有可重试 POST 默认带幂等键。
与纯 AI coding 方案的差异
这是前面已经论述过的部分:AI coding 解决代码生成,不解决业务事实沉淀和运行时治理。本项目的差异在于把 AI 当作配置翻译层,把低代码当作运行治理层,两者协同而非替代。AI 写出的代码可能漏掉一个 tenant_id 过滤,但本平台的运行时不会漏——这就是治理底座的意义。
本项目的差异化定位
综合来看,本项目的差异化定位可以概括成三句话:
-
企业级而非部门级:解决核心业务系统的安全运行,不是部门内部小工具。
-
治理底座而非搭建工具:把业务规则沉淀为可治理的配置,不是替业务人员搭页面。
-
AI 协同而非 AI 替代:AI 翻译配置、低代码保障运行,两者分工明确。
四、价值与意义
效率提升:
平台把企业业务系统里最重复的 80% 工作(建模、表单、列表、CRUD、权限、通知、导出、单据转换)变成可配置能力,交付周期从"周"压缩到"天"。配合内嵌 AI 助手,“对话即配置"进一步把配置成本降到"分钟级”。一个完整业务对象的建模 + 列表 + 表单 + 业务动作,从人工 1-2 天降到 15 分钟。
商业价值:
-
多租户 + 功能包模型天然支持 SaaS 化:一套平台、N 个租户、按功能包授权,降低边际交付成本。
-
业务规则配置化沉淀,构成组织资产:人员流动不影响业务系统可维护性。
-
AI + 低代码协同范式可复用:这套"AI 翻译配置、低代码保障运行"的范式不限于企业系统,可迁移到任何需要"安全运行治理"的领域。
社会价值:
让懂业务但不写代码的人真正拥有"造工具"的能力。在 AI 时代,编程门槛的降低不应止步于"开发者写代码更快",而应该让业务专家直接成为系统建设者。这是 AI 普惠更本质的方向。
技术示范价值:
诚然,从创建性角度上来讲,我并不认为本项目就有较大的突破,但是本项目是用trae工具从0-1完全自主搭建的,我个人仅作为规划产品方法以及代码质量审查,因为本项目具有较大的技术示范价值,让人们意识到,AI不仅仅能搭建小的工具,即便面对复杂的企业级项目,也完全可以胜任
四、核心功能模块
平台已落地的核心能力(非 PPT,均已在仓库中实现并有测试覆盖):
-
业务对象元数据建模:实体、字段、关系、子表,全部元数据驱动,运行时动态渲染。
-
列表设计 + 表单设计:字段布局、筛选条件、按钮配置、子表设计,可视化配置。
-
业务动作 + Pipeline 引擎:基于 DAG 拓扑排序的步骤编排,支持 CREATE / UPDATE / DELETE / QUERY / NOTIFY / WEBHOOK 六类步骤,支持门控条件、跳过节点、上下文快照。
-
单据转换引擎:合并/拆分/字段映射(直接/固定/系统变量/聚合/公式/查找/自动编号),主子表跨实体映射,独立的子服务拆分(Engine / MappingParser / MainTableProcessor / ChildTableProcessor / FieldMapper)。
-
通知模块:7 种渠道(邮件/短信/钉钉/企业微信/飞书/公众号/站内),三种推送模式(逐人/群发/分组),抄送、附件、模板渲染、订阅规则触发,渠道配置变更即时失效缓存。
-
动态列表导出:租户隔离 + 数据范围权限 + 字段级权限 + 敏感字段脱敏 + 异步任务 + 多布局(平铺/多 Sheet/合并)+ 频率限制 + 用户配置,支持百万级行数预估与强制异步。
-
Pipeline 断点调试:dry-run 模式跳过实际副作用、SSE 实时推送节点事件、断点暂停与恢复、变量在线修改、上下文快照恢复——把"线上业务流程"变成可调试的代码。
-
多租户 + 功能包权限:租户隔离、功能包聚合授权(菜单 + 业务对象 + 按钮)、字段级可见性、动作级权限、数据范围过滤,URL 级 + @PreAuthorize 双重防护。
-
内嵌 AI 助手:Page Builder 智能体(自然语言生成业务配置)、SRM 领域智能体(采购分析、交付跟踪、寻源建议、价格分析、合同审查、供应商准入)、智能数据查询(自然语言查业务数据并渲染图表)。
-
完整审计与可观测:TraceContext + PerformanceLogger 全链路追踪、@OperLog 操作日志、执行历史与节点轨迹、SSE 调试事件流。
五、技术架构与设计哲学
技术栈: Spring Boot 3 + MyBatis-Plus + Vue 3 + Element Plus + Pinia + Vite,单仓库前后端分离。
架构原则:
-
依赖方向是硬约束:controller → service → service/impl → mapper,禁止反向依赖、禁止循环依赖、禁止 shared/common 成为业务耦合中转站。
-
大文件触发停工:Java 业务类软触发 300 行、硬触发 600 行;Vue 文件软触发 250 行、硬触发 500 行。超线必须拆分,不允许用注释分区掩盖。
-
API 是契约:错误状态码语义化(400/403/404/409/429),禁止用 200 OK 包装业务失败,禁止返回栈信息和 SQL。
-
安全默认拒绝:所有外部输入不可信,Security 默认
.anyRequest().authenticated(),仅显式放行登录/静态/健康检查。 -
数据模型表达业务事实:所有表用雪花 ID,强制带 tenant_id / version / create_by / create_time / deleted 等治理字段,禁止用大 JSON 字段逃避业务建模。
关键工程实践:
-
单元测试是完成边界:新增 Service/Controller 必须同步写测试,修 Bug 必须写回归测试,
mvn test可独立执行不依赖外部环境。当前测试用例覆盖 Pipeline 调试、单据转换、通知模块、导出权限、租户隔离等核心场景。 -
知识库与代码同步:
.trae/knowledge/下维护 architecture / module-index / api-catalog / db-schema / change-log / known-issues 六份文档,任何代码变更必须同步更新,保证 AI 在后续开发时能基于事实而非猜测工作。
六、AI + 低代码的协同范式(这是本项目的核心论点)
我在这个项目里反复验证了一件事:AI coding 和低代码不是竞争关系,而是上下游协同。
AI 的位置:语义到配置的翻译层
-
业务方说"我要一个采购订单,包含供应商、明细、金额,金额超 10 万走二级审批"——AI 助手把这句话翻译成业务对象 + 字段 + 表单 + 业务动作配置,落库即生效。
-
业务方说"看一下上个月供应商 A 的到货情况"——AI 助手把这句话翻译成查询条件 + 实体过滤 + 租户隔离,直接渲染图表。
-
开发者说"加一个 webhook 步骤,订单完成后回调 ERP"——AI 把这句话翻译成 Pipeline 配置 + 步骤执行器接入点。
低代码的位置:配置到运行的安全层
-
配置落库后,运行时天然带租户隔离、权限校验、审计日志、状态机守卫——AI 不需要每次都记得加这些。
-
配置变更有版本、可追溯、可回滚——AI 生成错了也能快速回退。
-
业务专家看得懂配置,可以二次修订——AI 翻译得不对,业务方能直接介入。
这套范式最关键的意义:
它把 AI 的"高效"和低代码的"可控"完美结合起来了。AI 负责"快",低代码负责"对"。在企业级场景里,"对"比"快"重要得多——一个漏了租户过滤的导出接口,可能让一家公司吃合规官司;一个绕过权限的批量删除,可能让客户数据全部丢失。这些风险,AI 不会主动替你想到,但低代码平台会替你兜底。
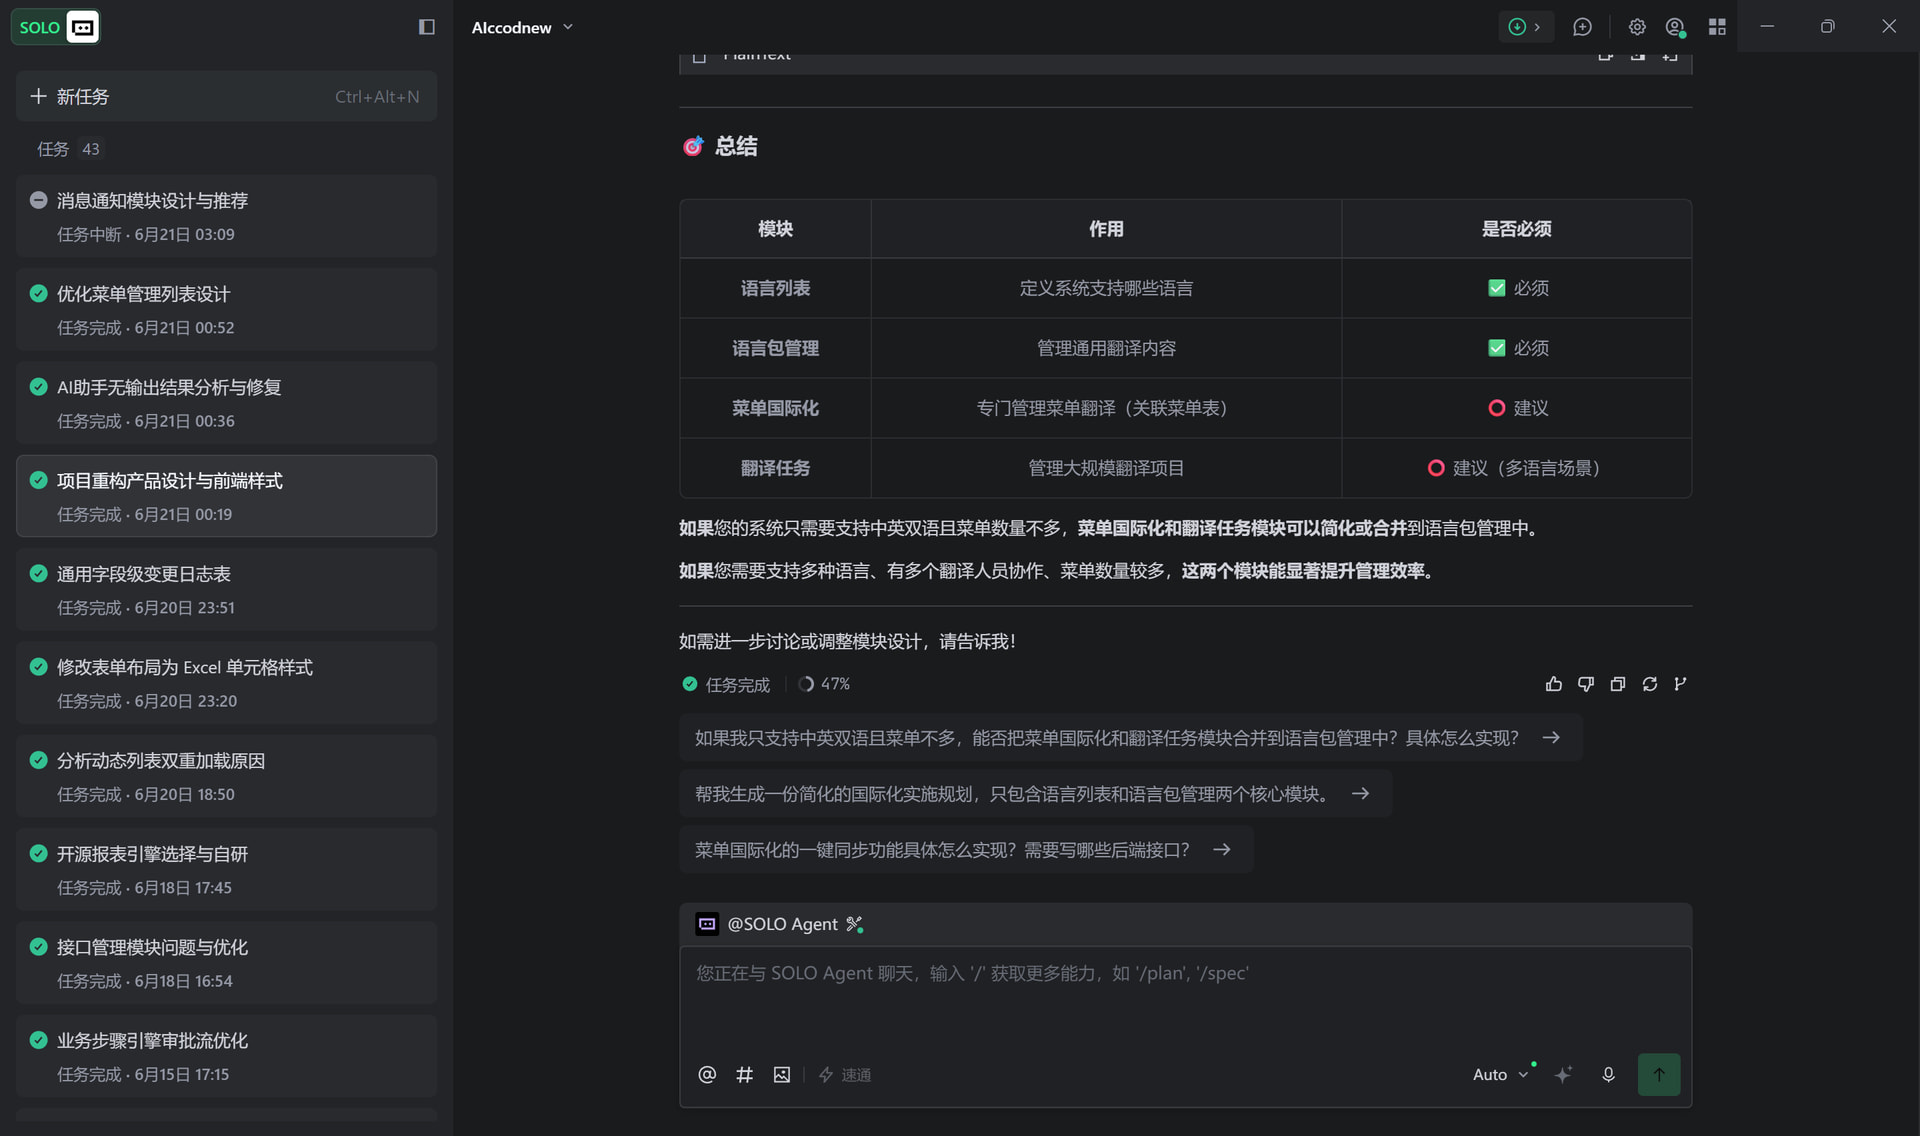
七、TRAE 实践过程
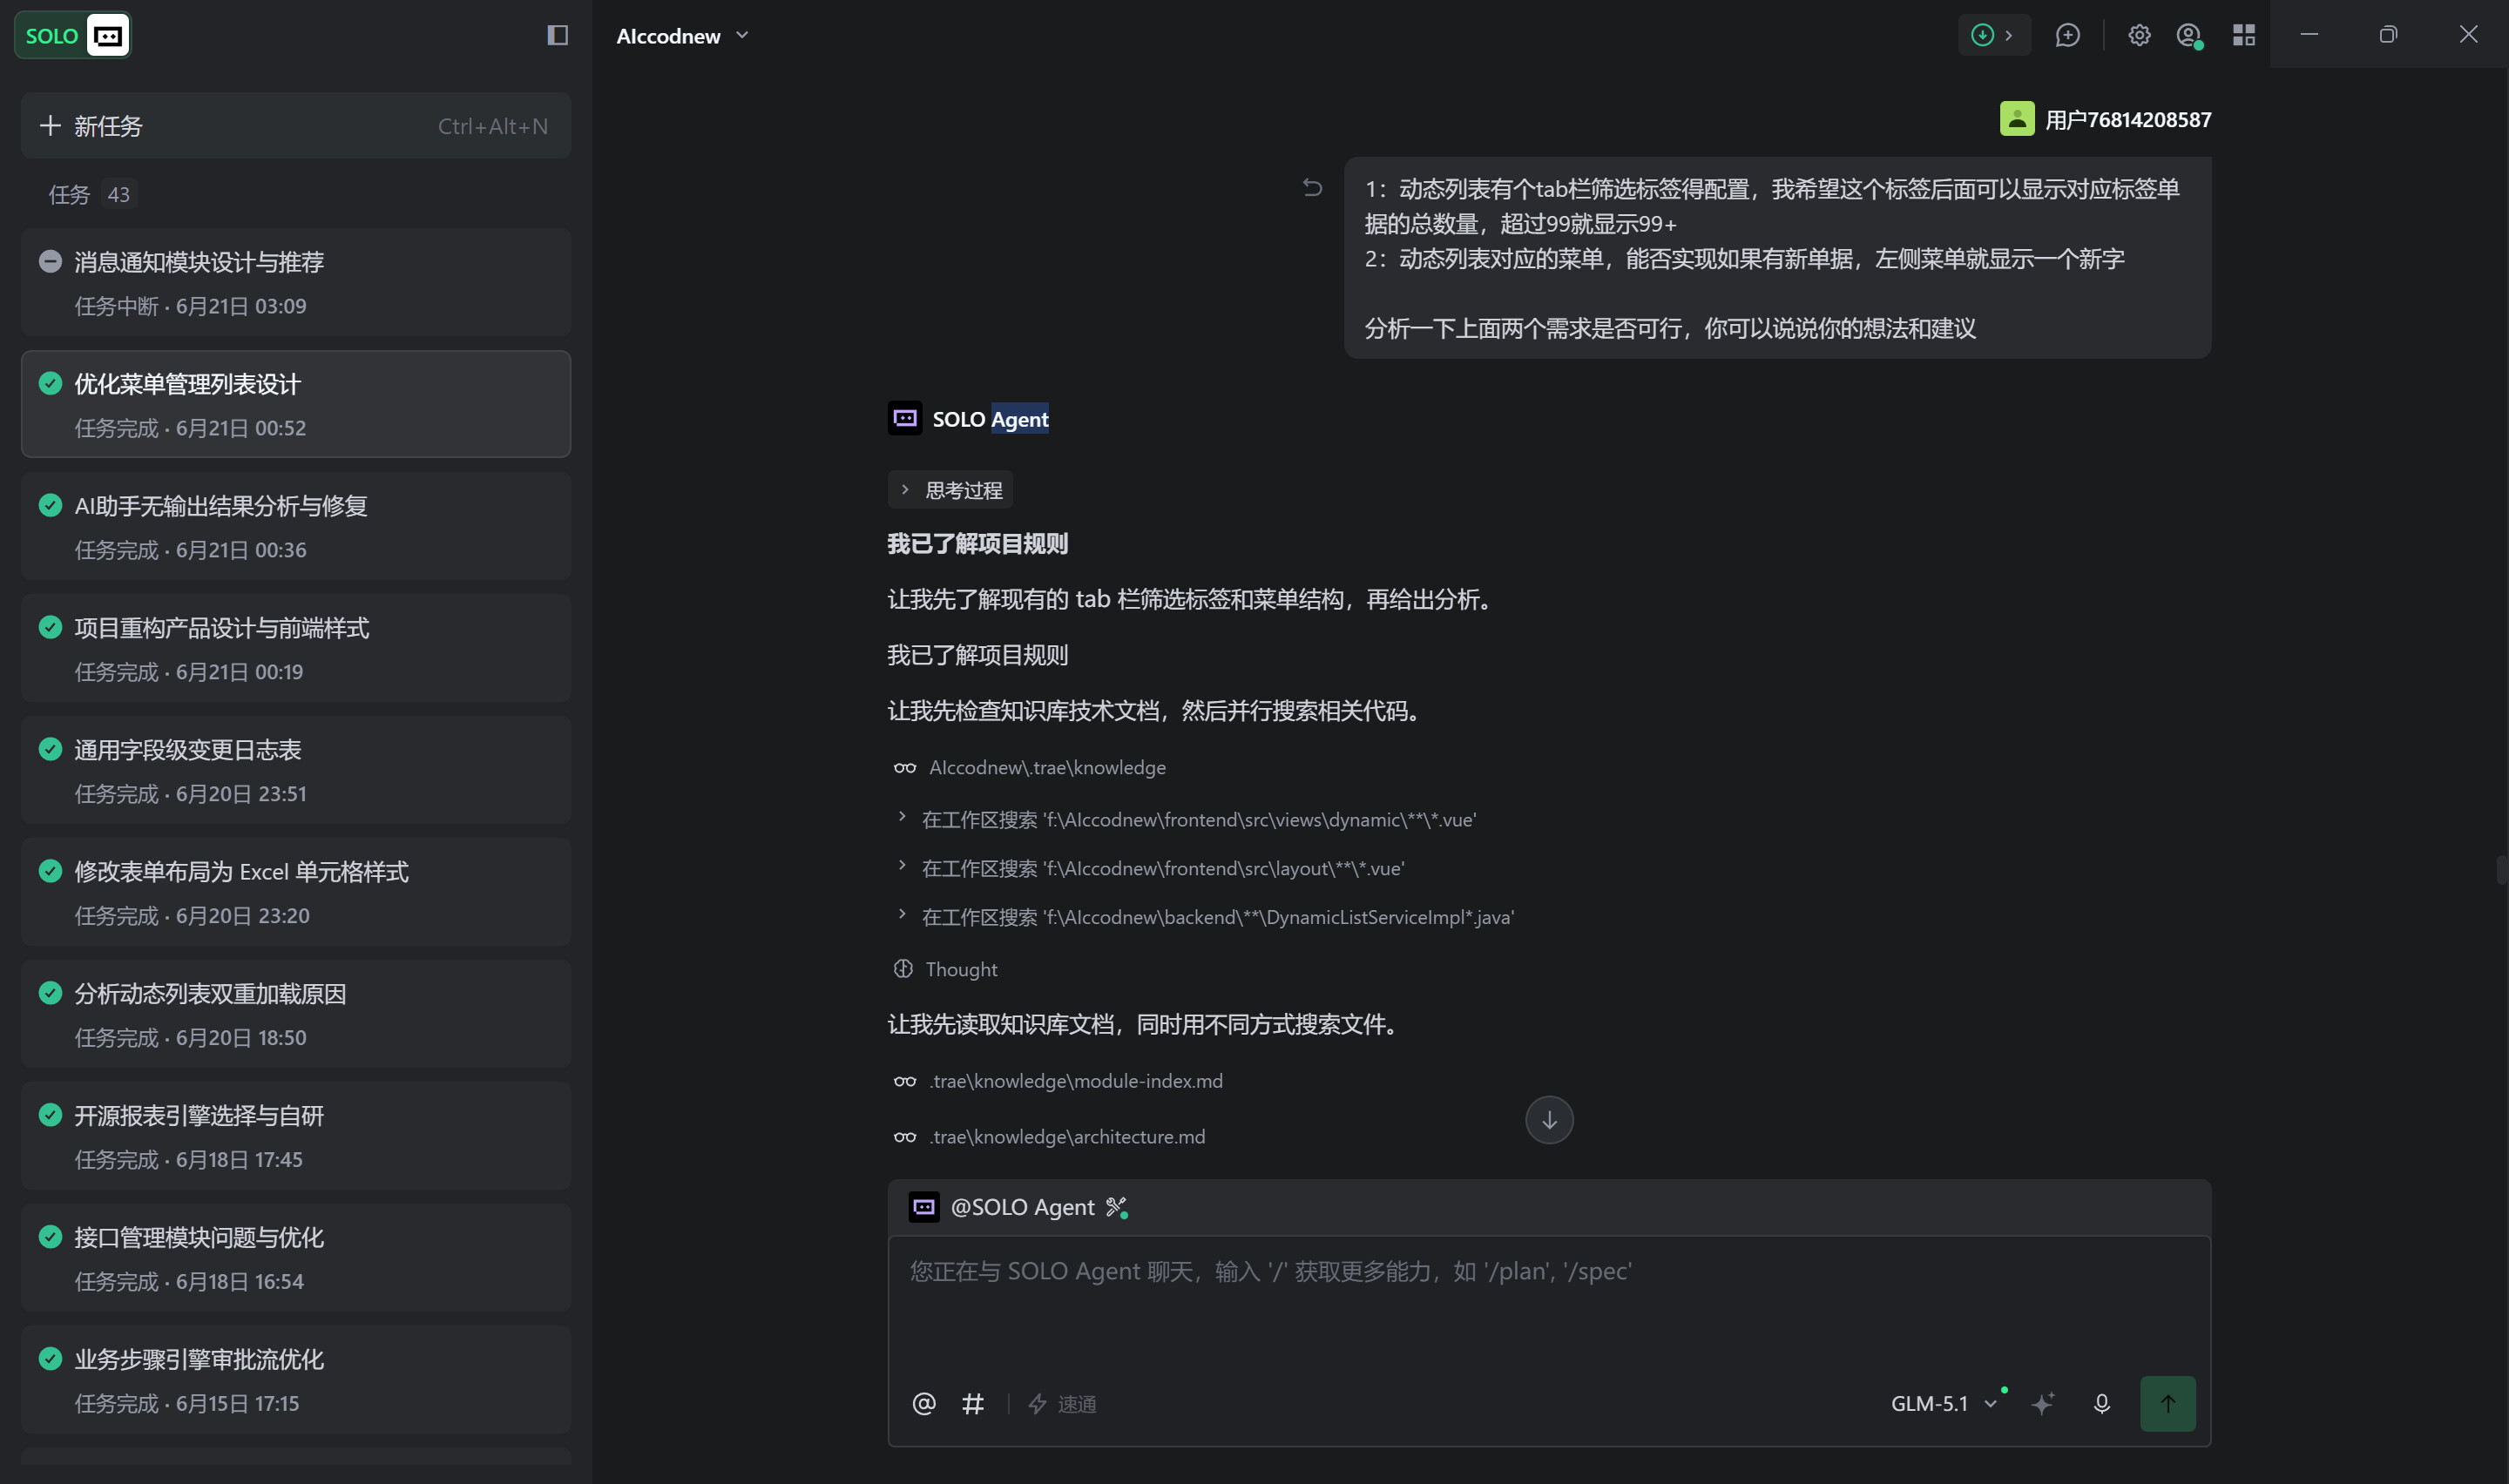
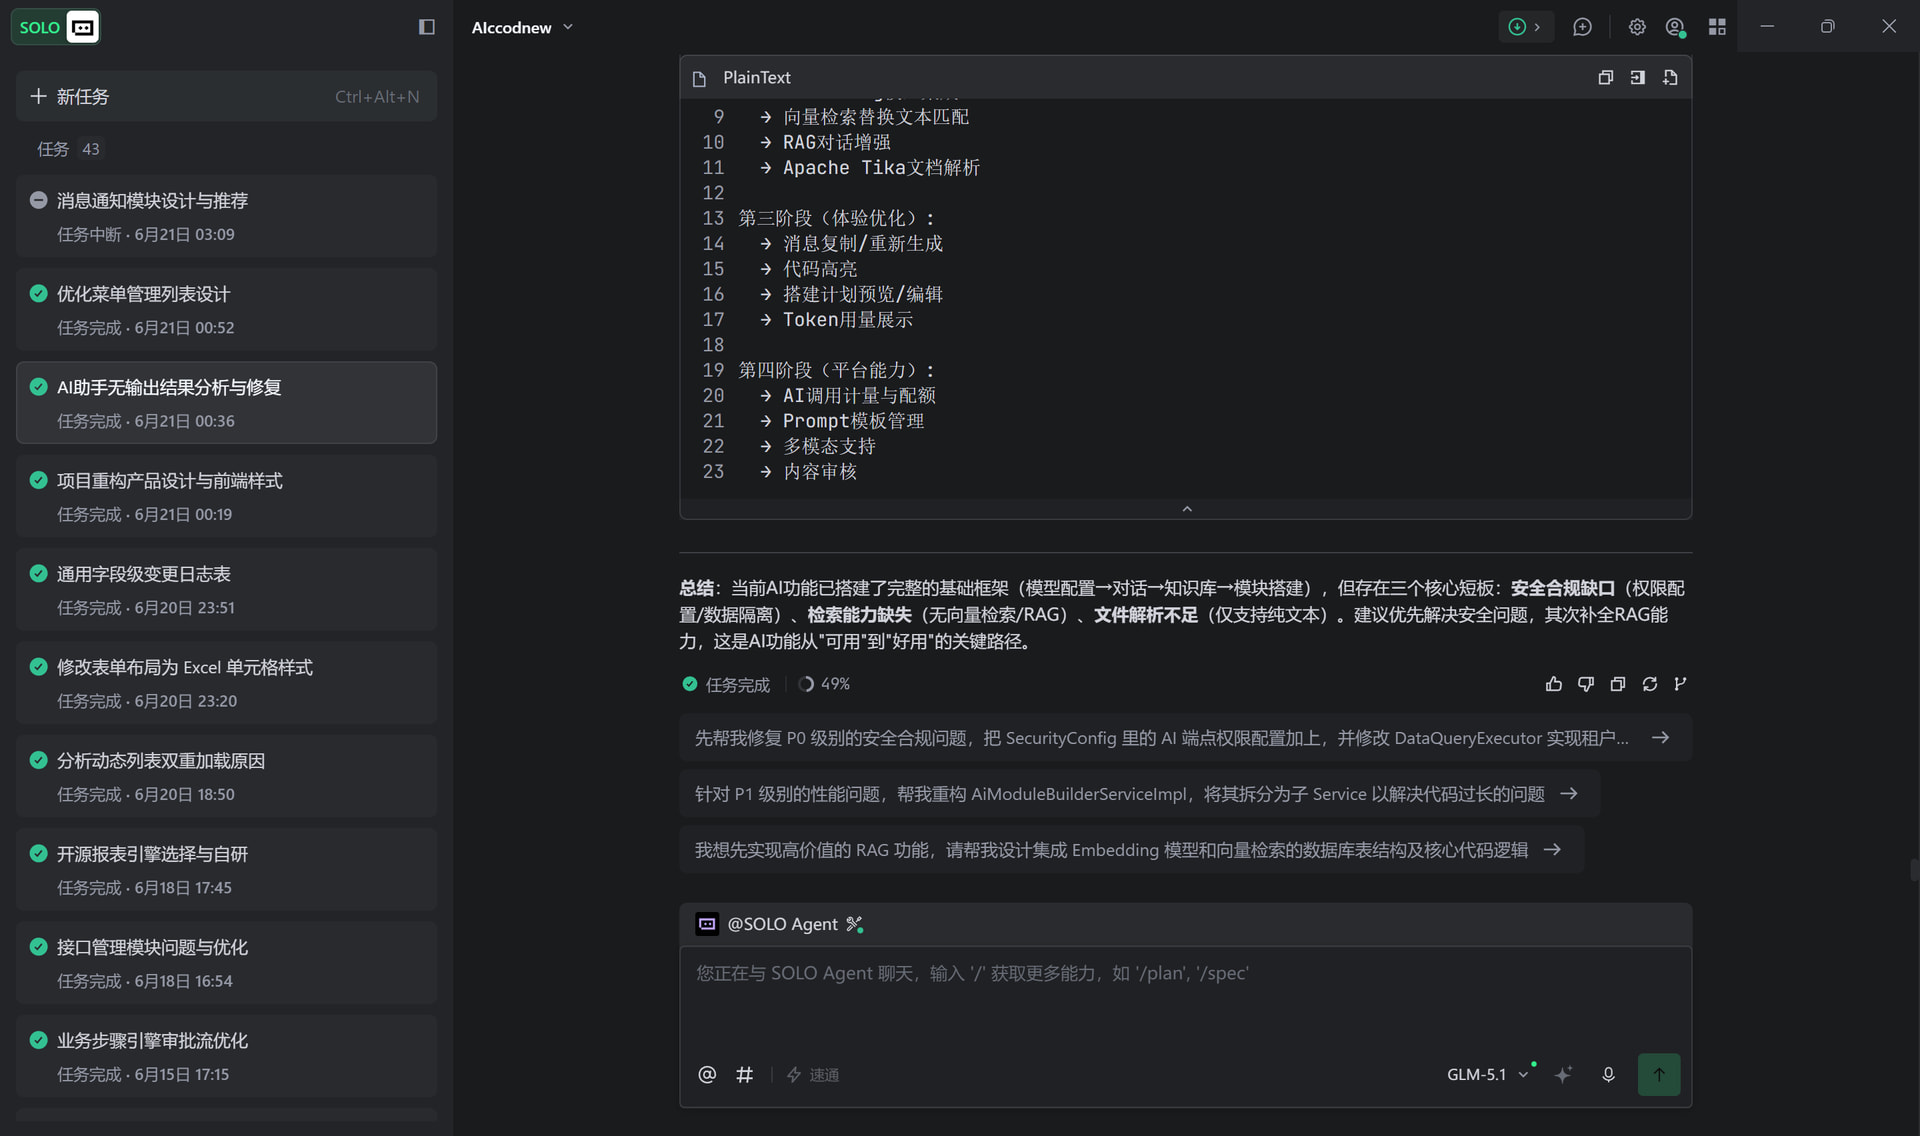
开发方式: 全程使用 TRAE IDE,结合项目规则文件(.trae/rules/)+ 知识库文档(.trae/knowledge/)+ 智能体协作(后端、前端、数据建模、需求分析、代码审查、测试智能体)完成开发。
典型工作流:
-
需求分析智能体把业务需求拆解为规格文档(变更目标、业务范围、非目标范围、角色权限、核心流程、状态模型、数据模型、API 契约、测试方式)。
-
后端/前端/数据建模智能体按规格分头实现,强制遵守项目规则(依赖方向、文件大小、安全配置、API 契约)。
-
代码审查智能体扫描反向依赖、循环依赖、大文件、权限缺口、N+1 查询、安全漏洞。
-
测试智能体编写单元测试和集成测试,验证 happy path + 异常路径 + 权限边界。
-
知识库智能体同步更新架构文档和模块索引,保证下一轮 AI 开发基于事实工作。
关键证明材料(发帖时附):
.244524712991225:6fdd2edc4b214c543fbc10e2f2761568_6a2406fdeeacde99fa71f298.6a36bfa604faeb77eaaa2777.6a36bfa4aa98be99c4213be8:Trae CN.T(2026/6/21 00:28:22)
.244524712991225:93769d2ab5a8dd870cdfce4998affe8a_6a2ba17bcf2b6530e756e753.6a36c03204faeb77eaaa27fd.6a36c02daa98be99c4213be9:Trae CN.T(2026/6/21 00:30:42)
.244524712991225:136308b992eab25418cc858b1127e6ed_6a2f9cef0011d96d9afa4393.6a36bd6b04faeb77eaaa271c.6a36bd6aaa98be99c4213be7:Trae CN.T(2026/6/21 00:18:51)
九、附:创意产物 HTML
报名帖: 【学习工作】ZLink--AI 原生的企业级业务建模与应用搭建引擎
系统访问地址:http://app.fulute.net:31097/
租户代码:100002(目前仅开通一个演示租户,因为后续可能用到生产环境,因此权限仅能开放一部分,AI助手功能(平台内部的AI模块搭建助手)暂时未做租户隔离,因此暂不在该租户开放AI助手权限,后续视迭代情况来决定是否开放)
账号:admin
密码:Admin@123
大家可以在菜单管理的列表和表单设计模块对页面进行搭建;
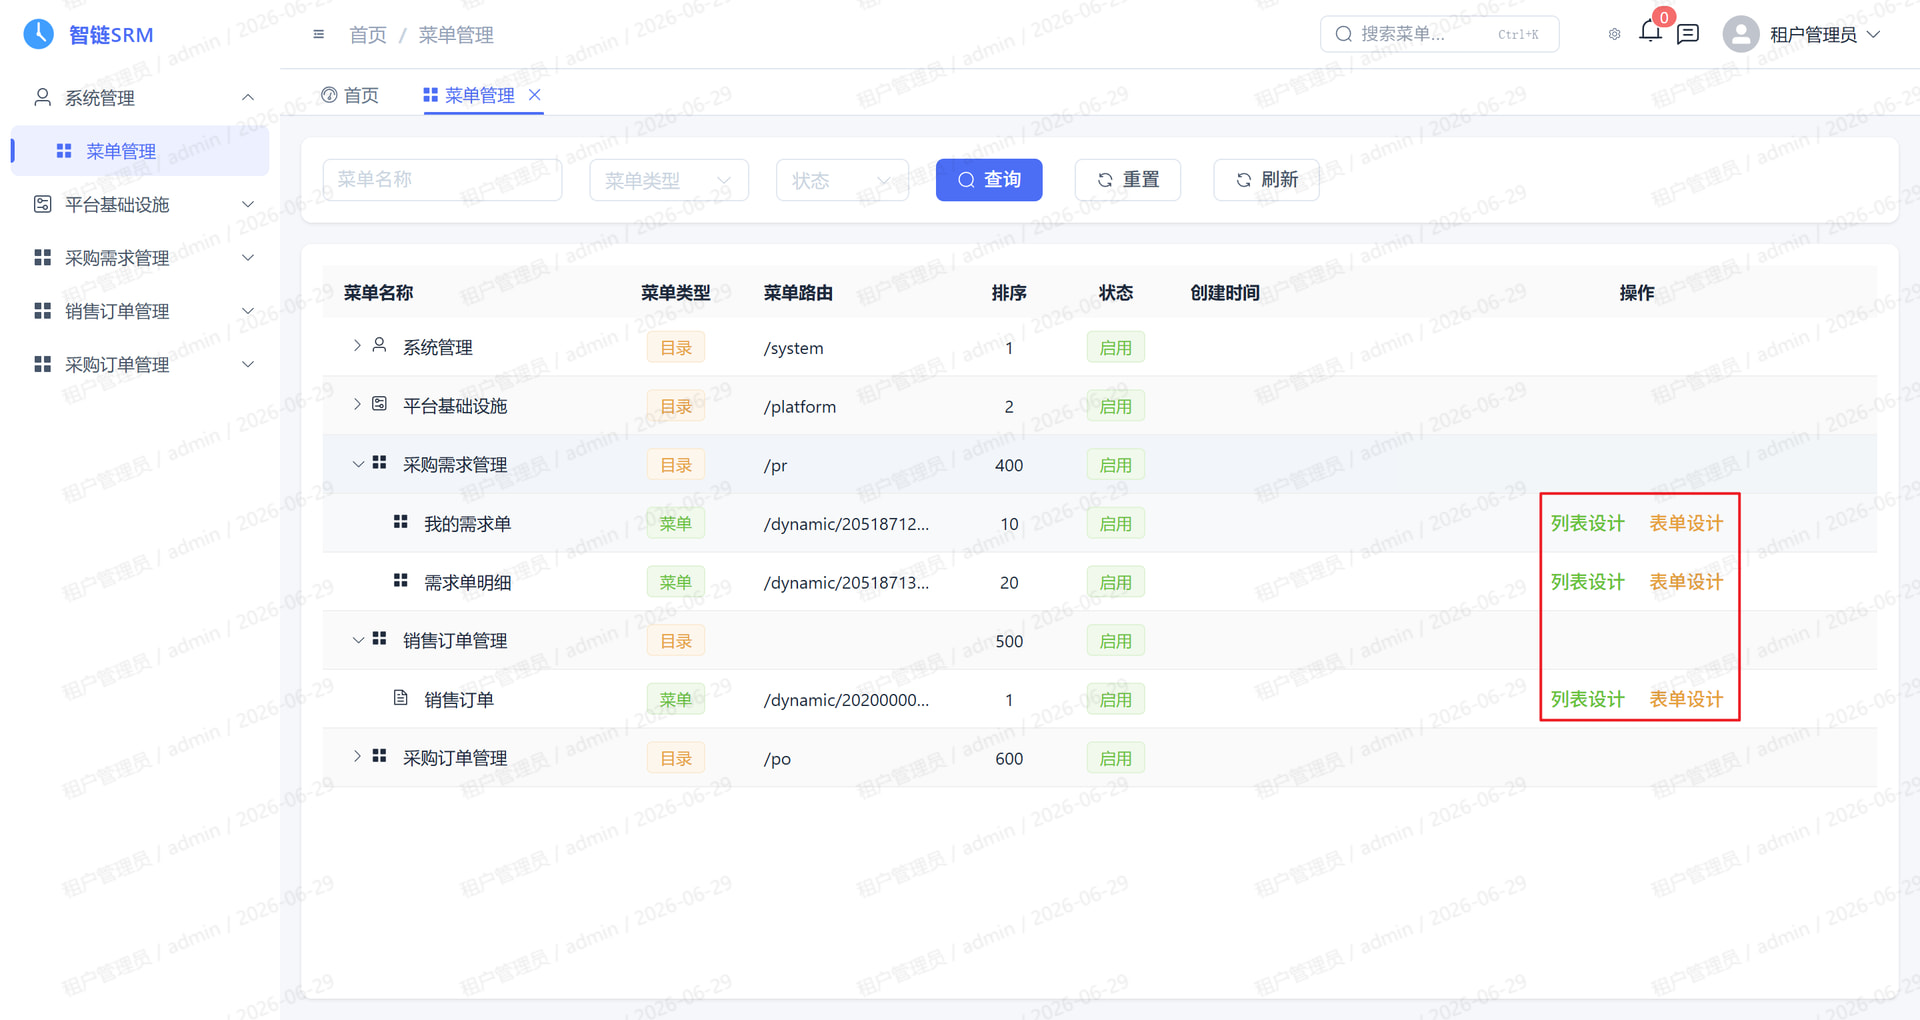
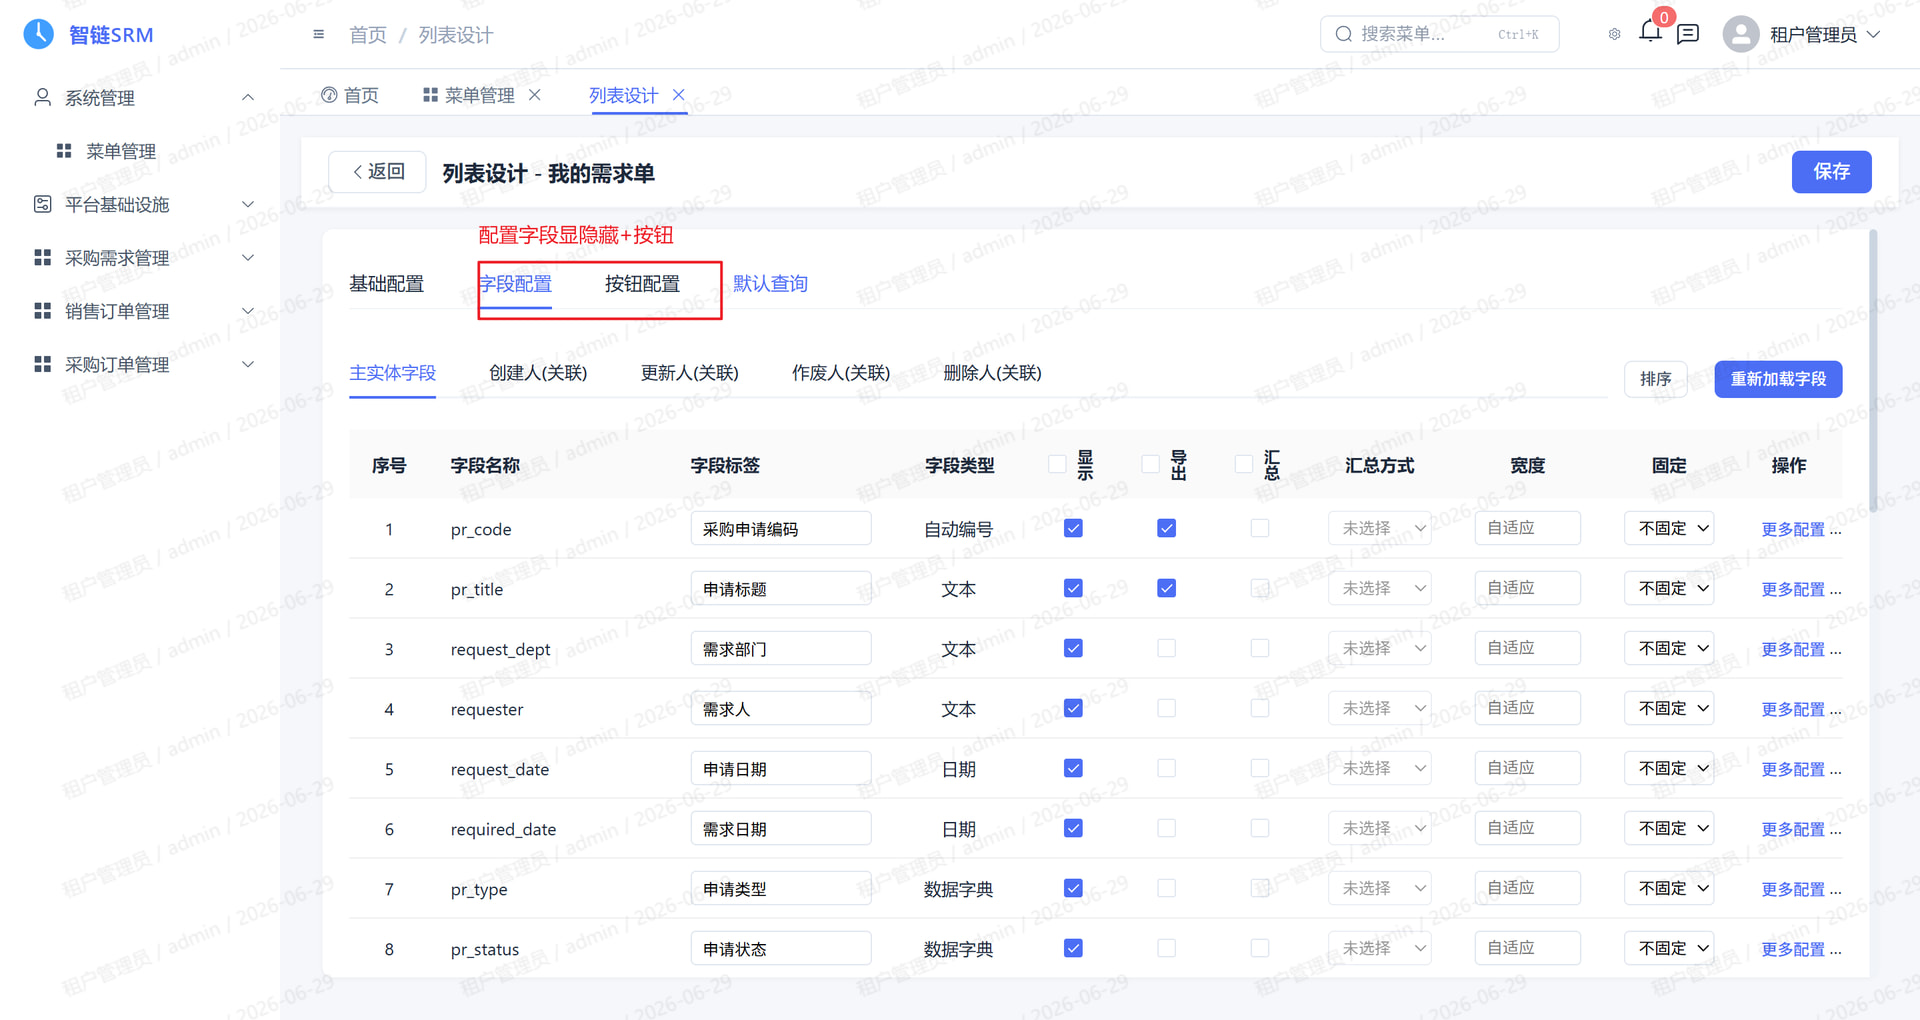
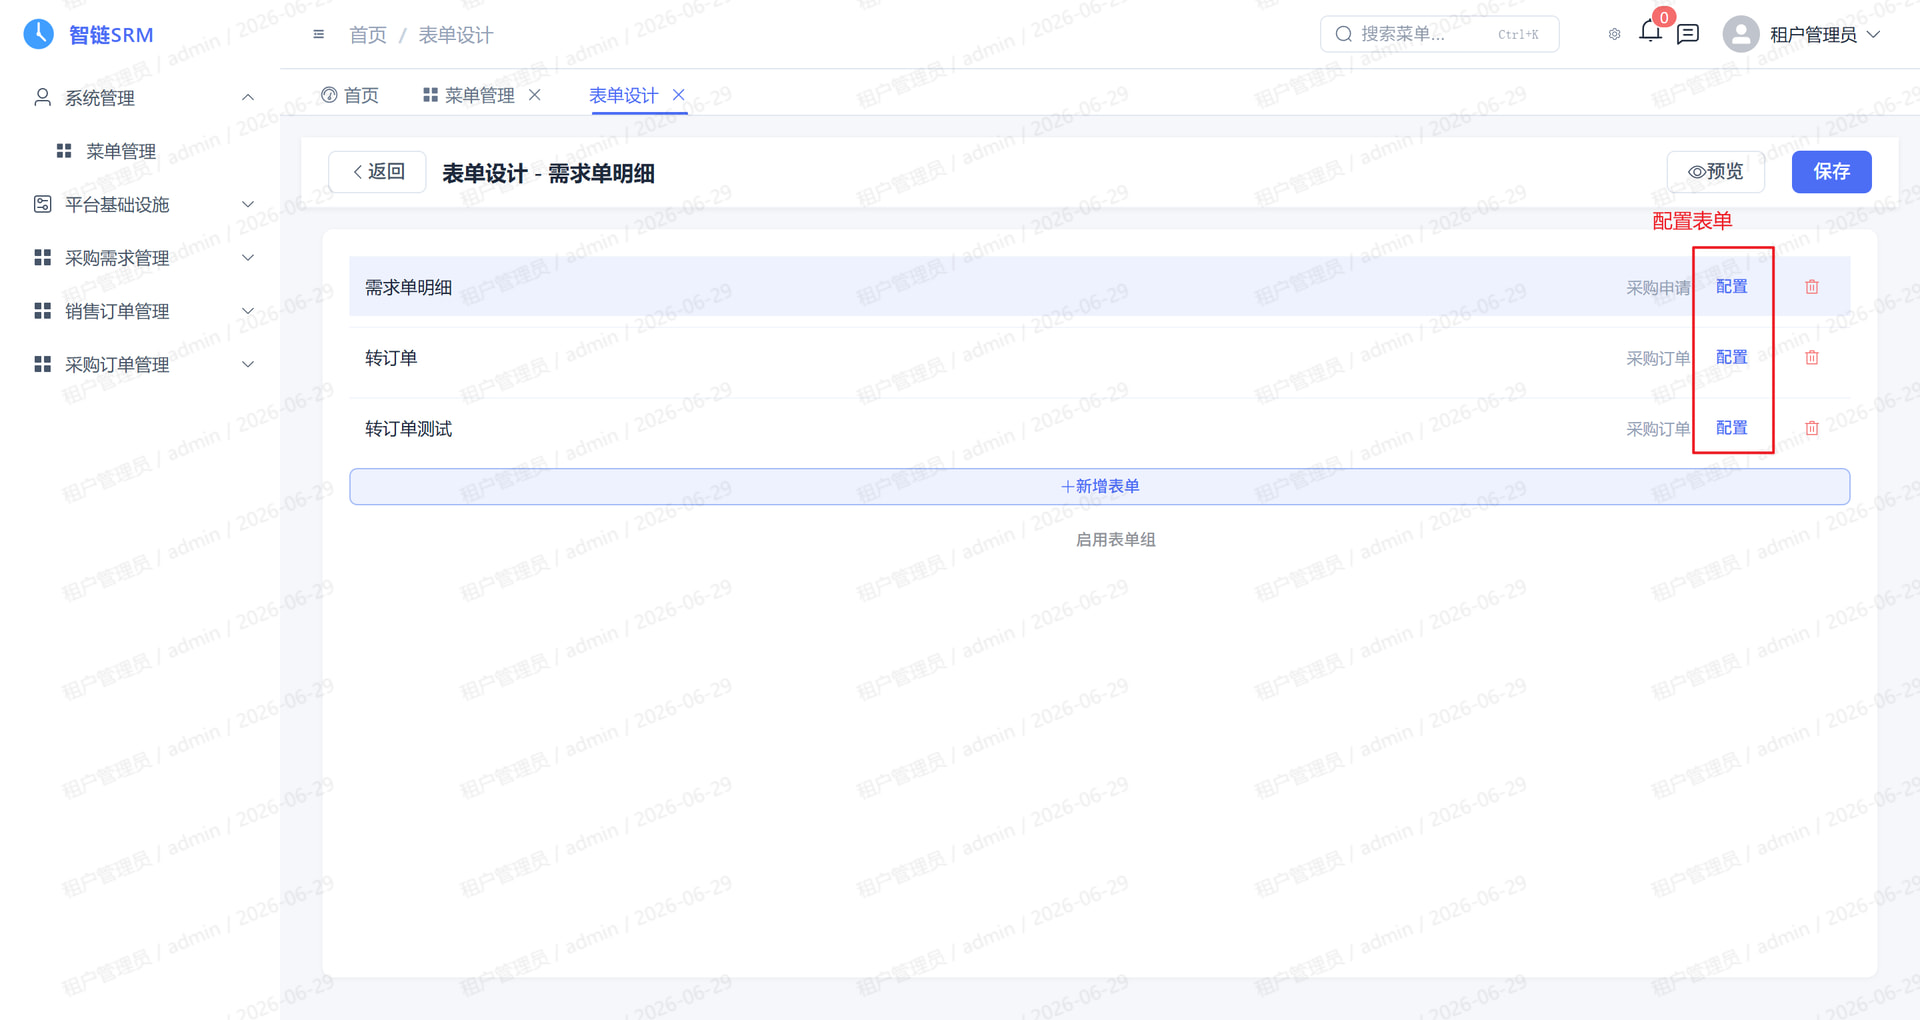
可以在业务对象-设计-业务动作模块配置按钮的执行逻辑;
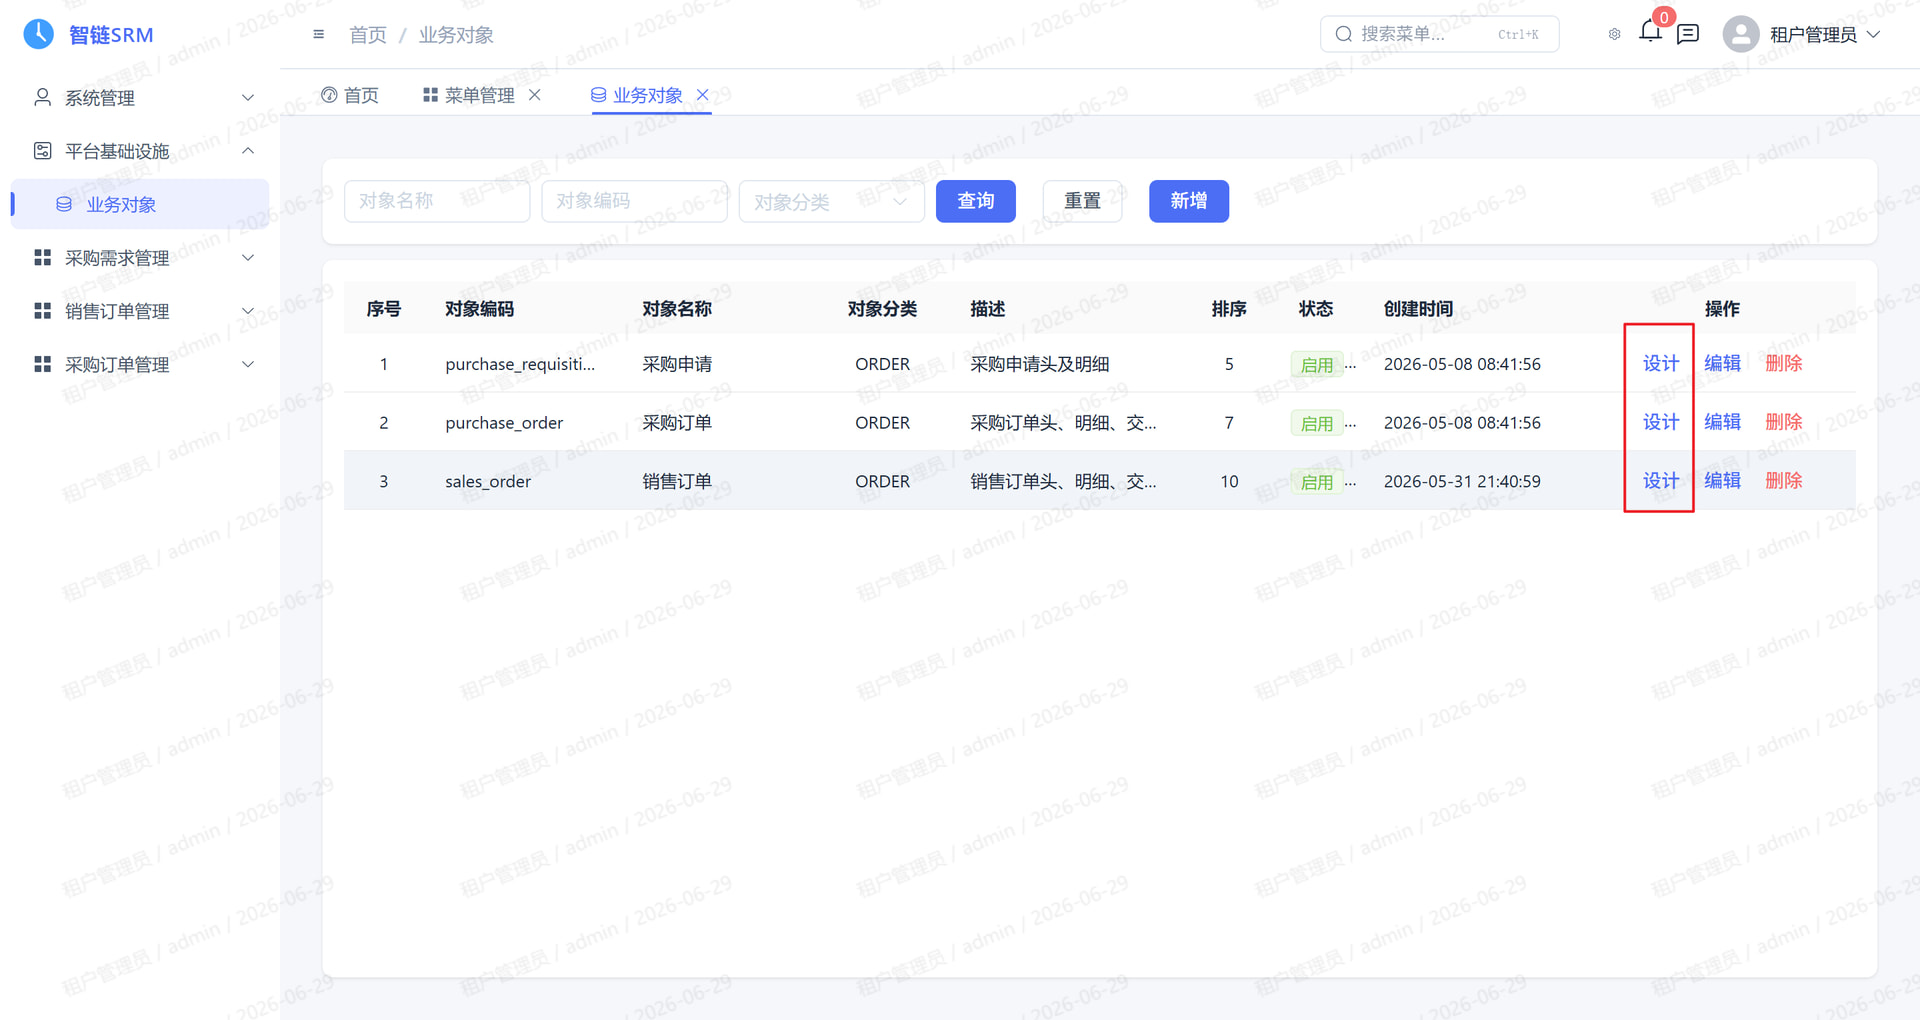

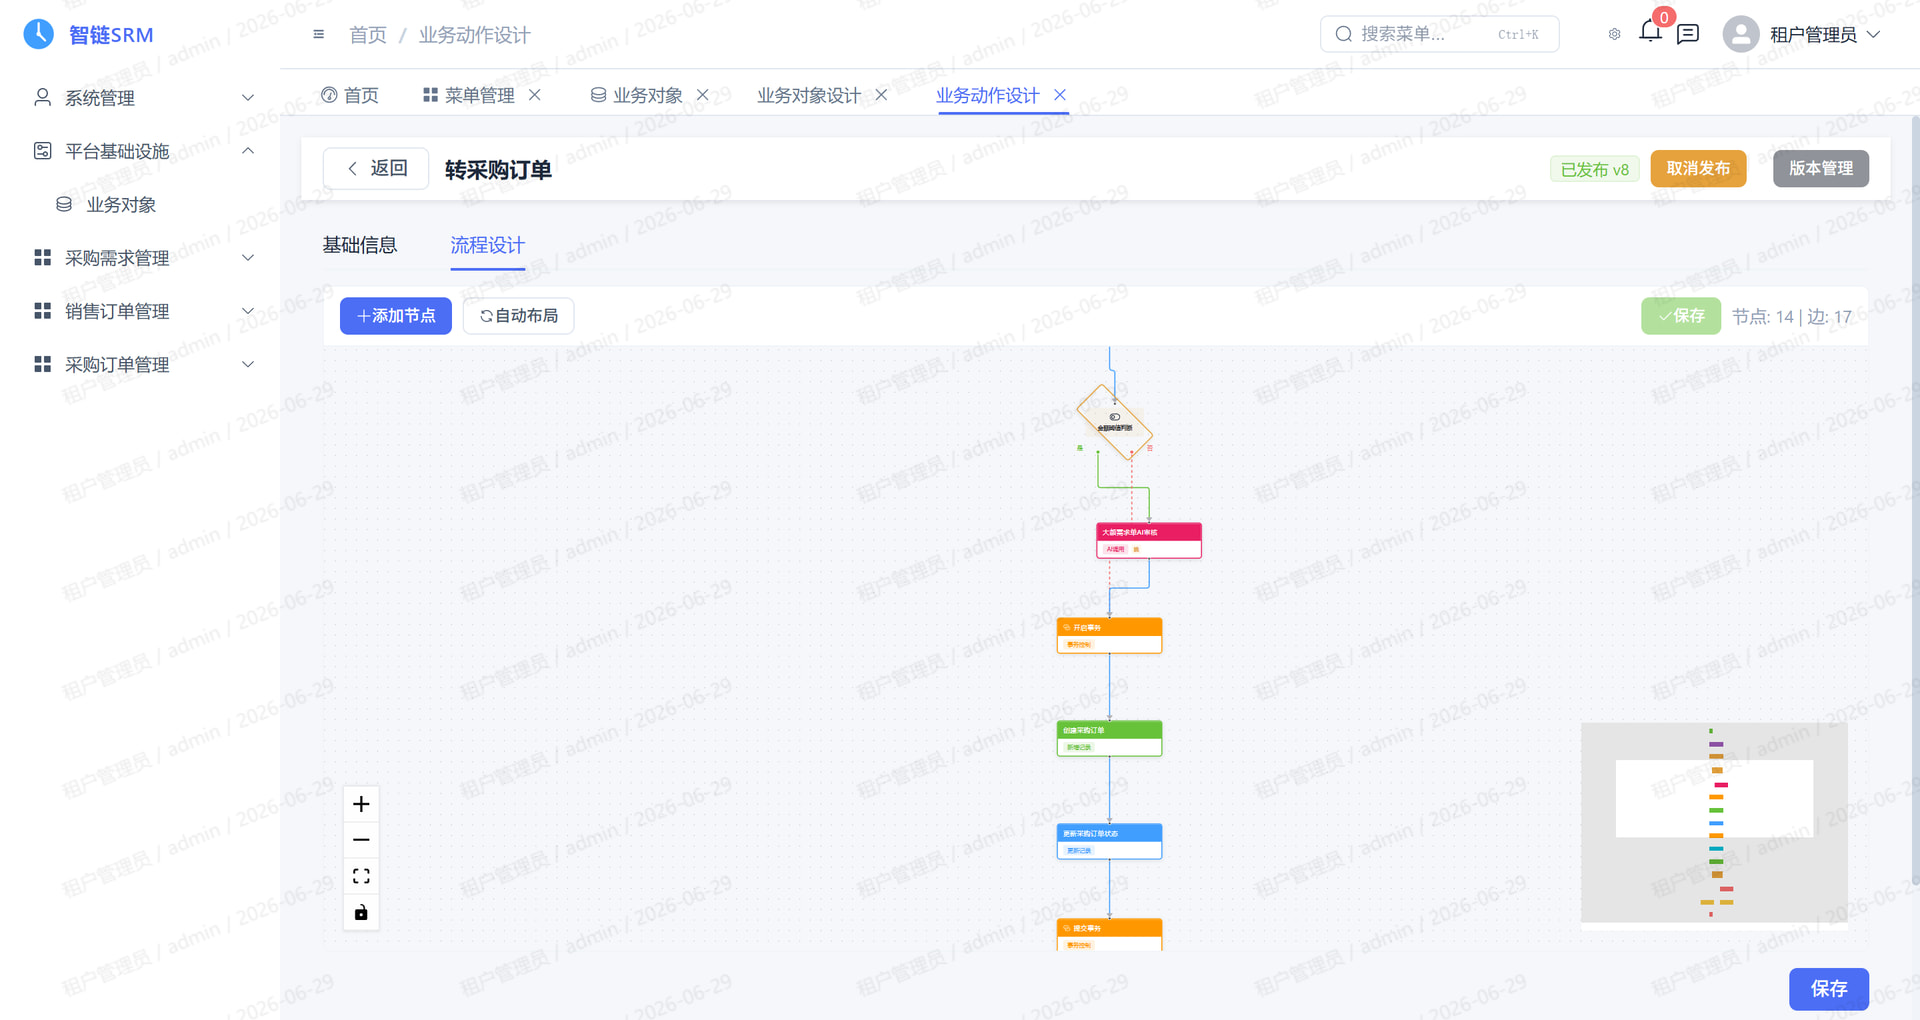
如果有什么BUG和建议,也欢迎大家提出