一、Demo 简介
是什么: AGI-Memory 不是又一个"AI 记忆库",是对"AI 该怎么记录信息"这件事的一次重新设计。现有的记忆方案,不管是简单的对话历史堆叠,还是加了向量检索的 RAG,本质上都是同一种记录逻辑——发生了什么,就原样记下来,检索的时候靠相似度去找。AGI-Memory 认为这套逻辑从根上就不对:信息从来不是同质的,一句"这次的报错是因为环境变量没配对"和一句"以后提交代码前必须跑一遍测试",性质完全不一样,不该用同一套方式记录、同一套方式检索。AGI-Memory 把"记录"这个动作拆成四种完全不同的记法——Memory(记一次具体经历)、Knowledge(记一条脱离情境也成立的事实)、Skill(记一套可复用的流程)、Rule(记一条行为边界)——每一种记法背后是不同的判断标准、不同的生命周期、不同的检索逻辑。
面向谁: 用 AI 编程助手做重度开发的人,尤其是已经受够了"AI 什么都往记忆库里塞、结果检索出来全是噪音"这种体验的开发者。
主要功能:
-
四层分类记录架构:不是把所有信息塞进同一个记忆库,而是先判断"这段信息本质上是什么",再决定该怎么记、记进哪一层,层与层之间用
derived_from关系记录彼此的推导关系,可以逐层回溯"这条知识是从哪句话、哪次判断得来的"。 -
两步式 MCP 治理流程:判断"该怎么记"这件事,交给正在对话的宿主模型来做——它已经读完了完整上下文,比后台一套通用规则更清楚这句话该记成什么。后端不重新理解一遍对话,只负责校验判断结果、检测跟已有记录有没有冲突、决定要不要真的写进去。
-
写入即治理,不是写完再治理:新记录写入前,先跟已有记录做语义相似度比对,识别是重复、矛盾、还是对已有知识的细化或推翻——记录这个动作本身就包含了"这条信息该不该被信"的判断,不是先囤积、后清理。
-
知识可以被替换,但从不无痕消失:一条记录被新的判断取代时,走的是标记 + 保留替换理由,永远能查到"这条记录曾经是什么样、后来为什么变了"——记录是有历史的,不是一个只会增长或者被清空的容器。
-
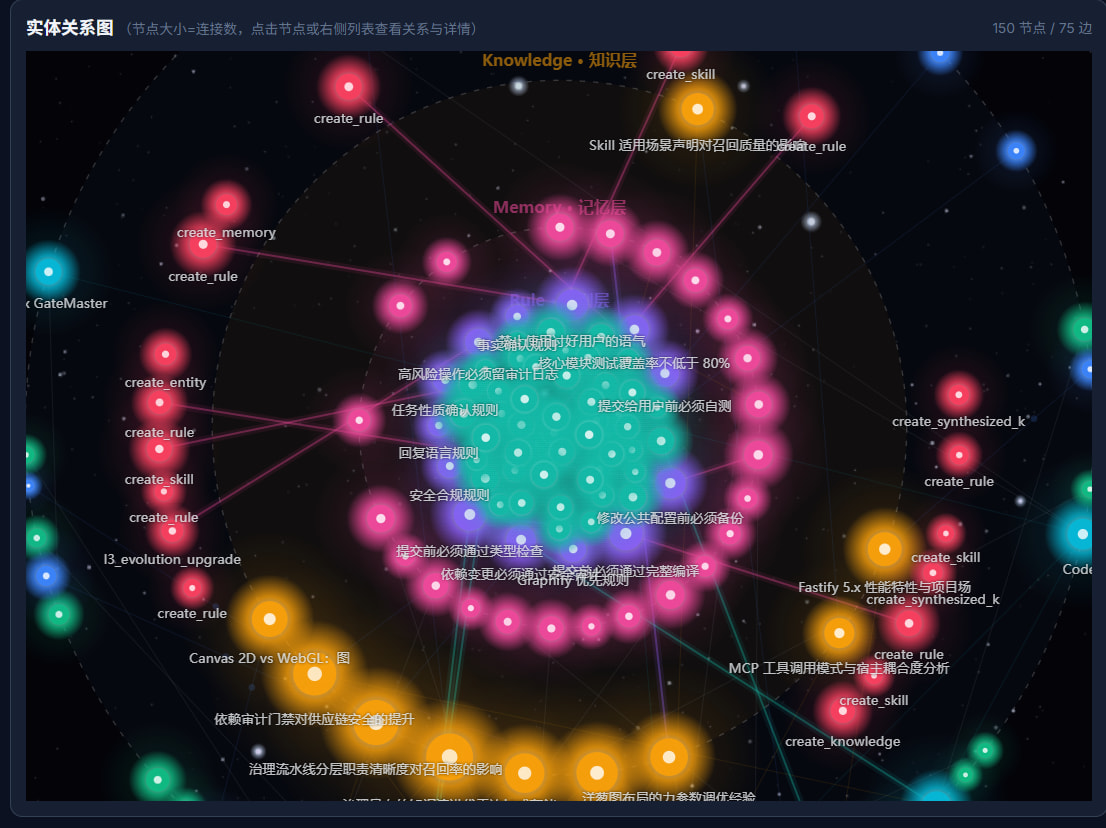
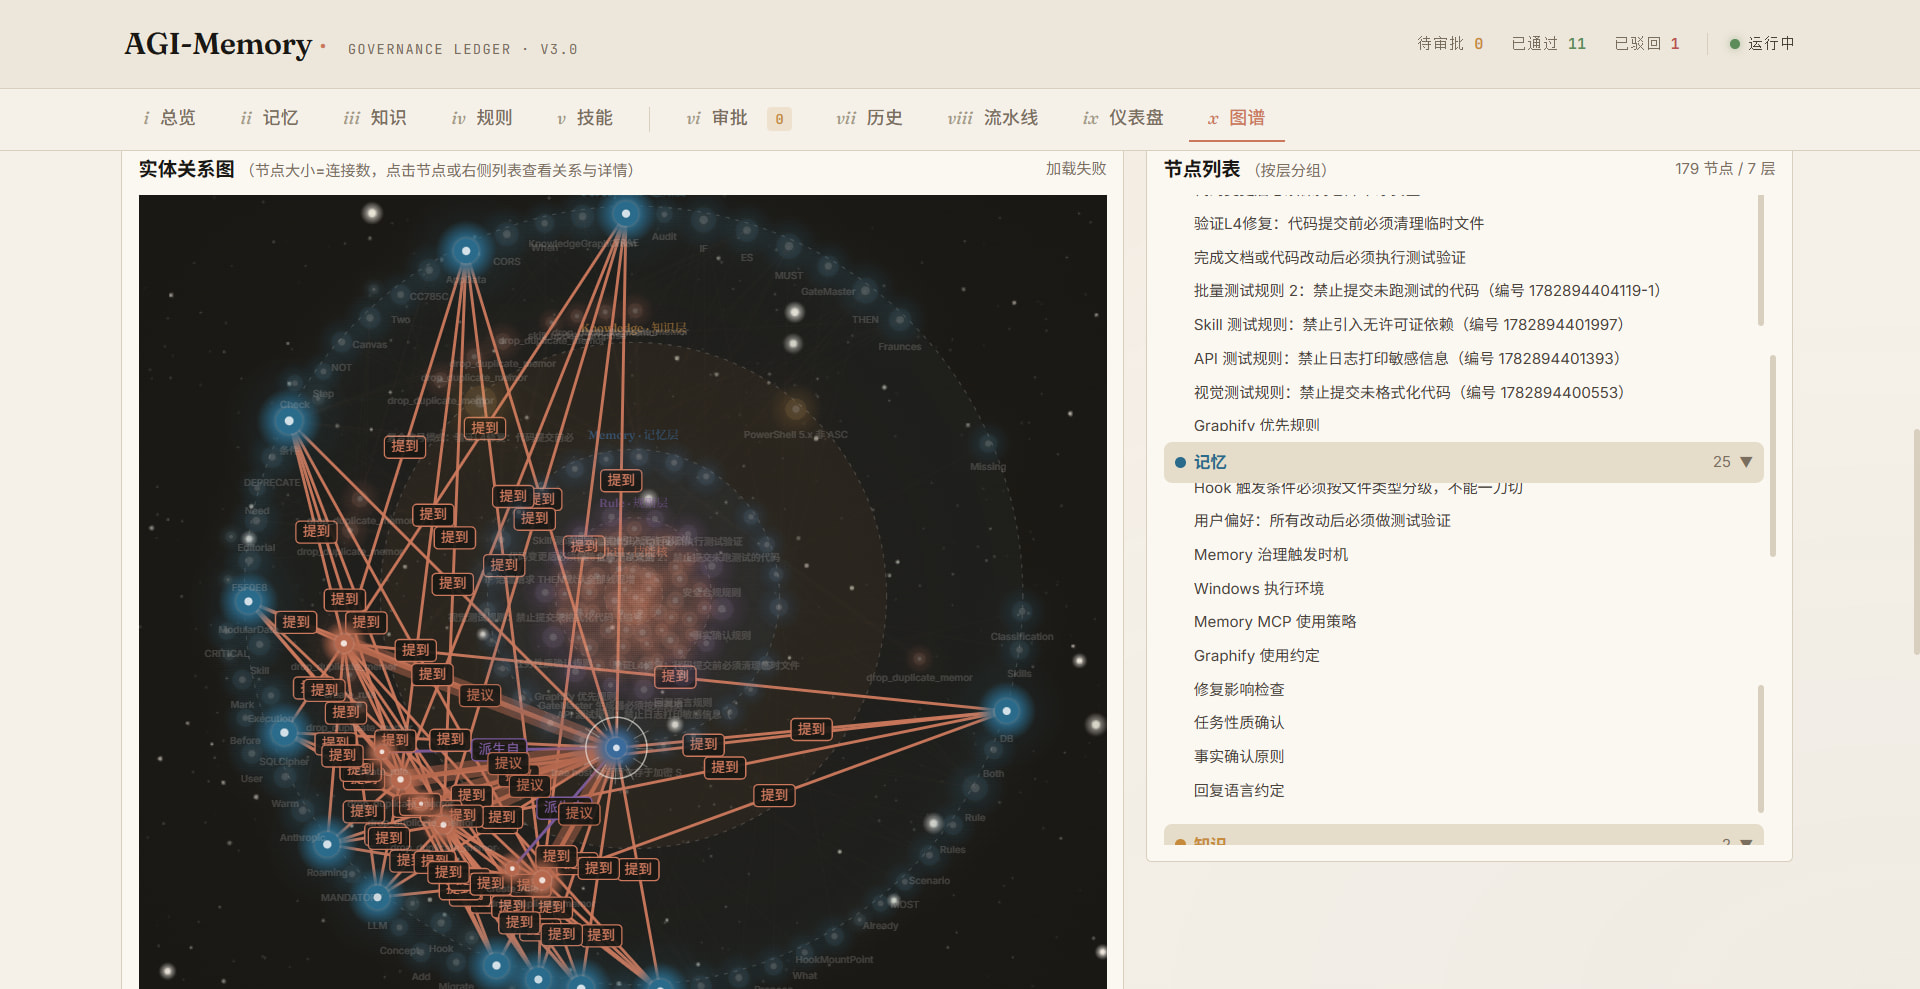
同心圆洋葱可视化控制台:Canvas 2D + D3.js 力导向渲染,把"这条记录是怎么被记下来的、跟哪些其他记录有关系"直接摆在眼前——因为记录方式变了,你需要一种新的方式去看懂这些记录之间的关系,不能再靠一张扁平的列表。
-
如图所示,主要是类知识图谱的方式帮助大家直接理解和判断,这样得出的memory,knowledge,skill,rule是否符合自己的预期,以及为什么不符合自己的预期。
二、Demo 创作思路
灵感来源:
做这个项目之前,先观察了一个现象:几乎所有 AI 记忆方案,不管技术实现多花哨,底层逻辑都停留在"日志"这个隐喻上——AI 说了什么、用户说了什么,原样存下来,需要的时候搜出来最相关的几条。这套逻辑在信息量小的时候没问题,但信息量一旦上去,会暴露一个根本性的错误:日志不分主次,记录应该分主次。一条"这次调试花了两小时"的经历,和一条"以后提交前必须跑测试"的规则,如果被同一套逻辑记录、同一套逻辑检索,前者迟早会把后者淹没在噪音里——不是因为存得太多,是因为从一开始就不该用同一种方式记这两件事。
这个判断直接决定了 AGI-Memory 的方向:不是去优化"怎么存、怎么搜",是重新定义"记录"这个动作本身该怎么做。
这个项目想改变的,是记录的方式,不是记录的数量或者速度:
传统记忆系统解决的是"记不记得住",AGI-Memory 想解决的是"记录本身对不对"。具体拆成三个从没被同一套系统统一考虑过的判断维度:
-
这段信息该被记成什么——这是记忆科学要回答的问题,人类记忆本身就分程序性记忆(怎么做一件事)、情景记忆(一次具体经历)、语义记忆(脱离情境的知识),AGI-Memory 第一次把这套分类真正落地成记录时的判断标准,而不是把所有信息都当成同一种"记忆"囫囵吞下去
-
新记录跟旧记录冲突了,该信谁——这是真值维护系统(Truth Maintenance System)这个 AI 领域几十年前就在研究的经典问题,AGI-Memory 把"记录"和"这条记录还成不成立"绑在一起,而不是记完就不再过问
-
有些"记录"根本不是记忆,是边界——“以后不能这么做"这句话,本质上不是在描述一件事,是在设定一条行为约束,这类信息如果被当成普通记忆存下来,只是一条"建议”,起不到真正的约束作用,需要用完全不同的方式记录、完全不同的方式生效
为什么做这个方向:
现在大家都在讨论怎么让 AI 记得更多、搜得更准,但很少有人问一个更基础的问题——AI 到底该用什么方式去记录一件事,这件事本身有没有被认真设计过。大部分方案默认"记录"就是"存储加检索",这是一个从来没被质疑过的假设。AGI-Memory 想验证的是:如果把"记录"这个动作本身重新设计——分清楚记的是什么、该用什么标准判断该不该记、记完之后这条记录还要不要为自己的成立与否负责——AI 的记忆系统会不会因此发生质变,而不只是量变。这是一件从头开始就没有太多现成答案可以照抄的事,做到现在,越来越确信这个方向本身是对的,值得继续做下去。
三、Demo 体验地址
-
在线 Demo: AGI-Memory 控制台
 评委体验提示: 打开后 URL 会自动附带
?demo=1参数,进入纯前端展示模式,您可直接体验使用 Mock 数据驱动的同心圆力导向图可视化与节点交互。若需接入您的真实后端,请去掉 URL 中的?demo=1即可走真实/internal/*接口。
四、TRAE 实践过程
在开发 AGI-Memory 极其复杂的四层架构与治理图谱渲染时,Trae IDE 是我梳理逻辑、编写前后端架构的核心工作台。以下是开发期间的关键 Session 记录:
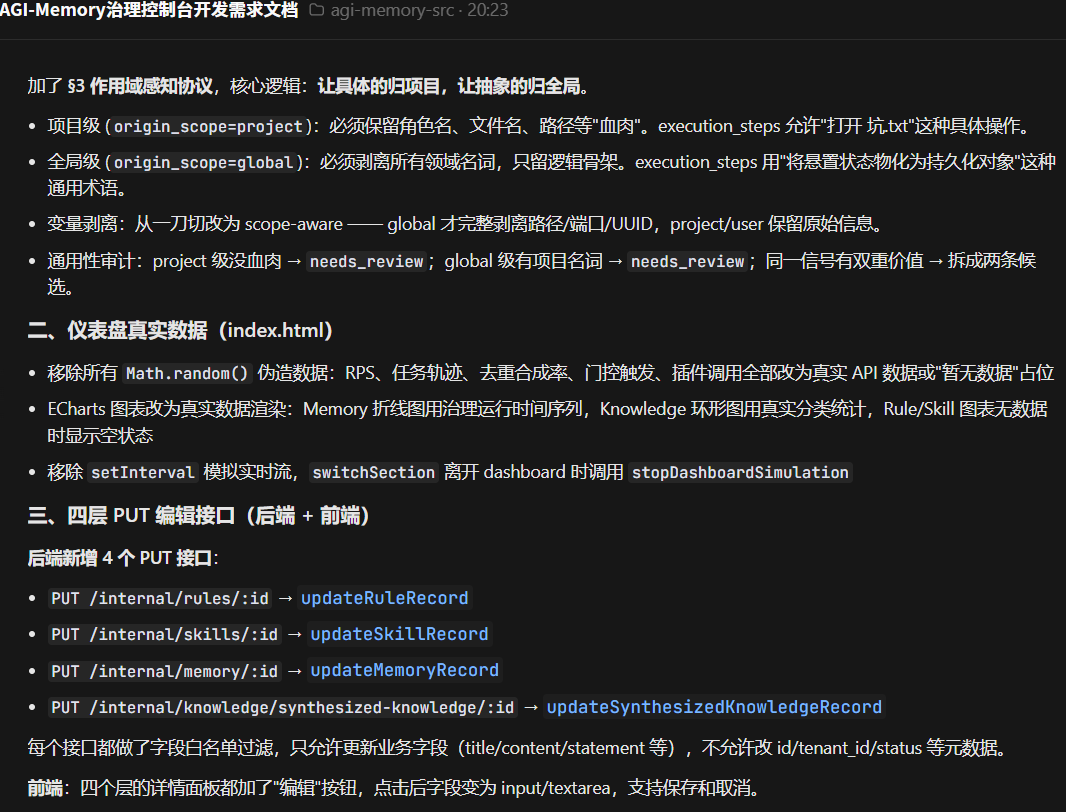
1. AGI-Memory 系统初期构思与核心需求文档(PRD)撰写
Trae 交互摘要: “AGI-Memory治理控制台开发需求文档” Session ID 溯源:
sessionId:4408385340969831:7a3be3cd15049a59f7e59e2078461680_6a33c28204f976c904ff0636.6a3a5a6f379f15f2a873b1ed.6a3a5a6f379f15f2a873b1eb:TRAE Work CN.0.1.21.no_sid.no_ppe.T(2026/6/23 18:05:35)
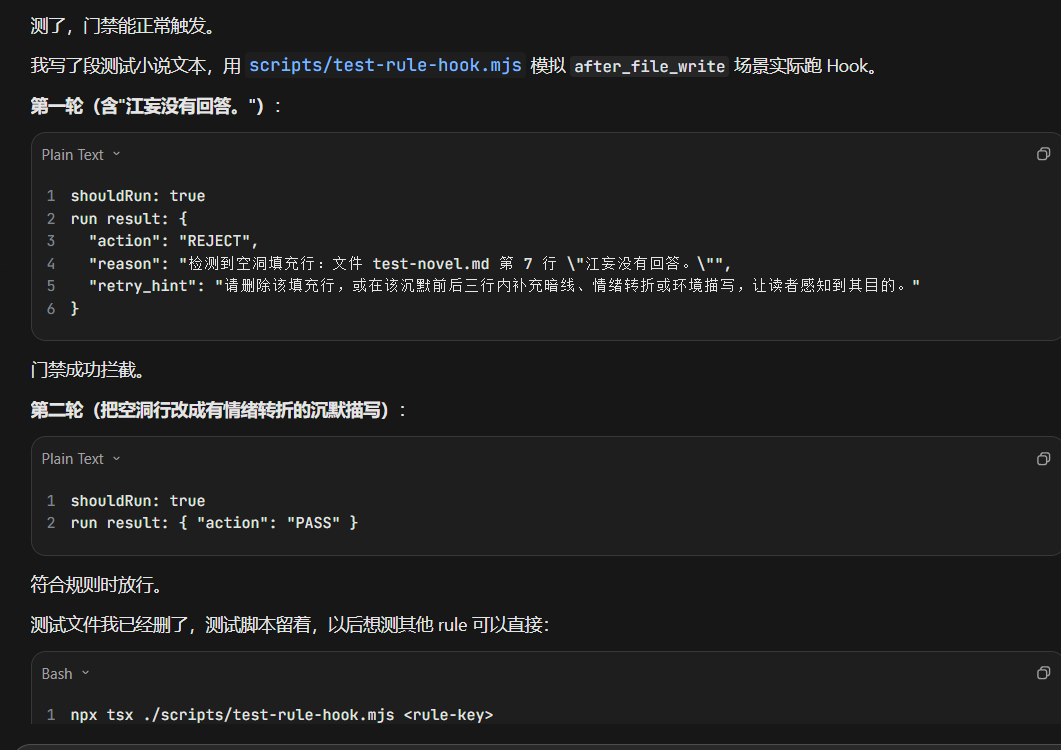
2. Gatekeeper 门禁逻辑联调,成功实现网关硬拦截触发测试
Trae 交互摘要: “测了,门禁能正常触发。” Session ID 溯源:
sessionId:4408385340969831:332edc8f88fb88130a6834fb1ee10761_6a33c28204f976c904ff0636.6a3b8597379f15f2a873ddf9.6a3b8596379f15f2a873ddf7:TRAE Work CN.0.1.21.no_sid.no_ppe.T(2026/6/24 15:21:59)
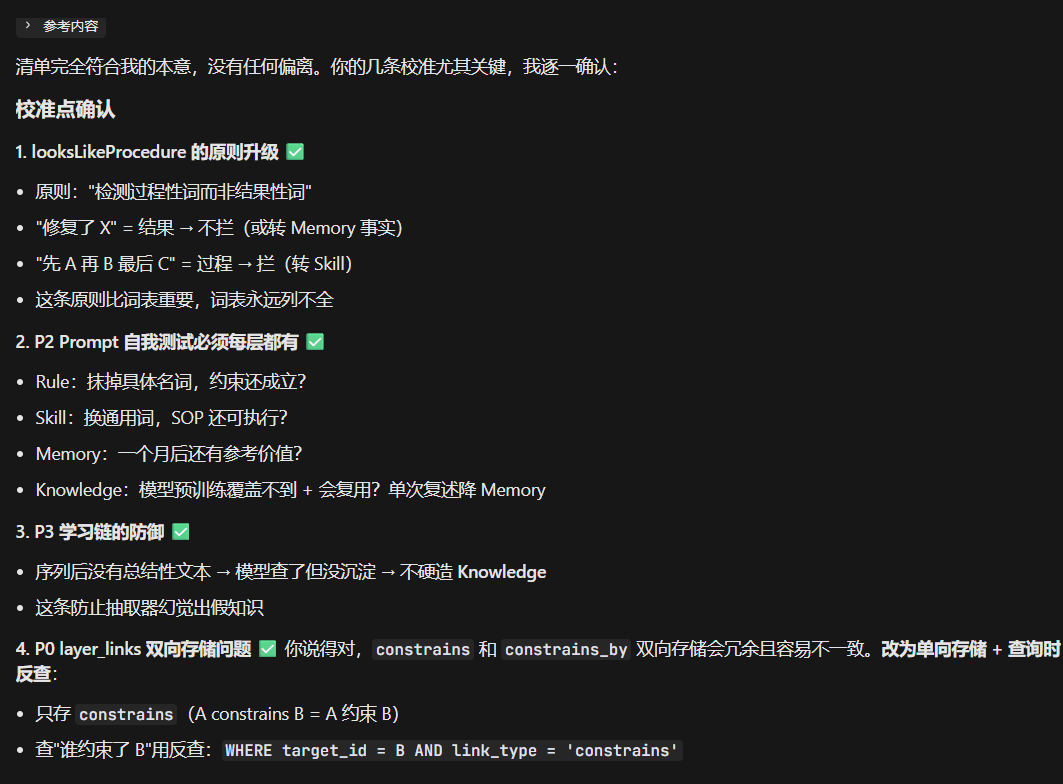
3. 认知架构极度复杂的底层校准,与 AI 确认权重衰减、LLM 元认知等关键假设
Trae 交互摘要: “清单完全符合我的本意,没有任何偏离。你的几条校准尤其关键,我逐一确认” Session ID 溯源:
sessionId:4408385340969831:b91a76bfb445bd846c00148f2797b57d_6a33c28204f976c904ff0636.6a437d6dc4e2ebe2d05e505b.6a437d6dc4e2ebe2d05e5059:TRAE Work CN.0.1.23.no_sid.no_ppe.T(2026/6/30 16:25:17)
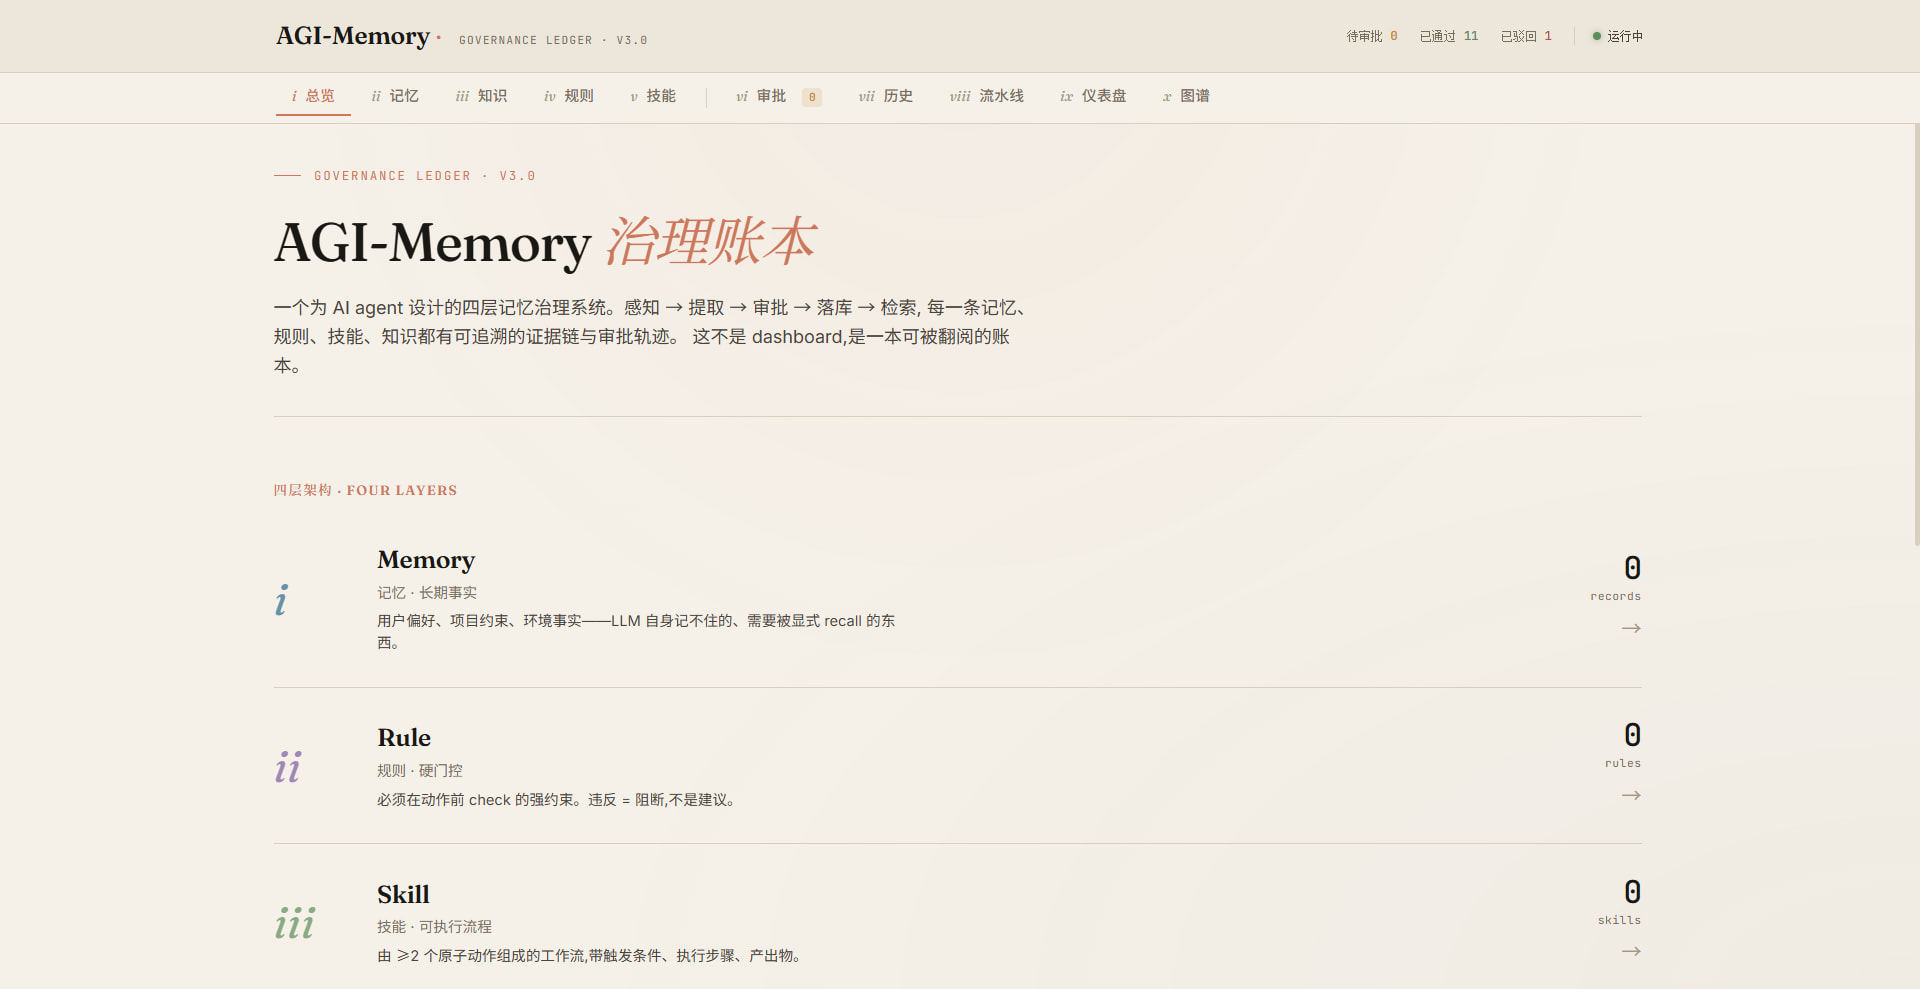
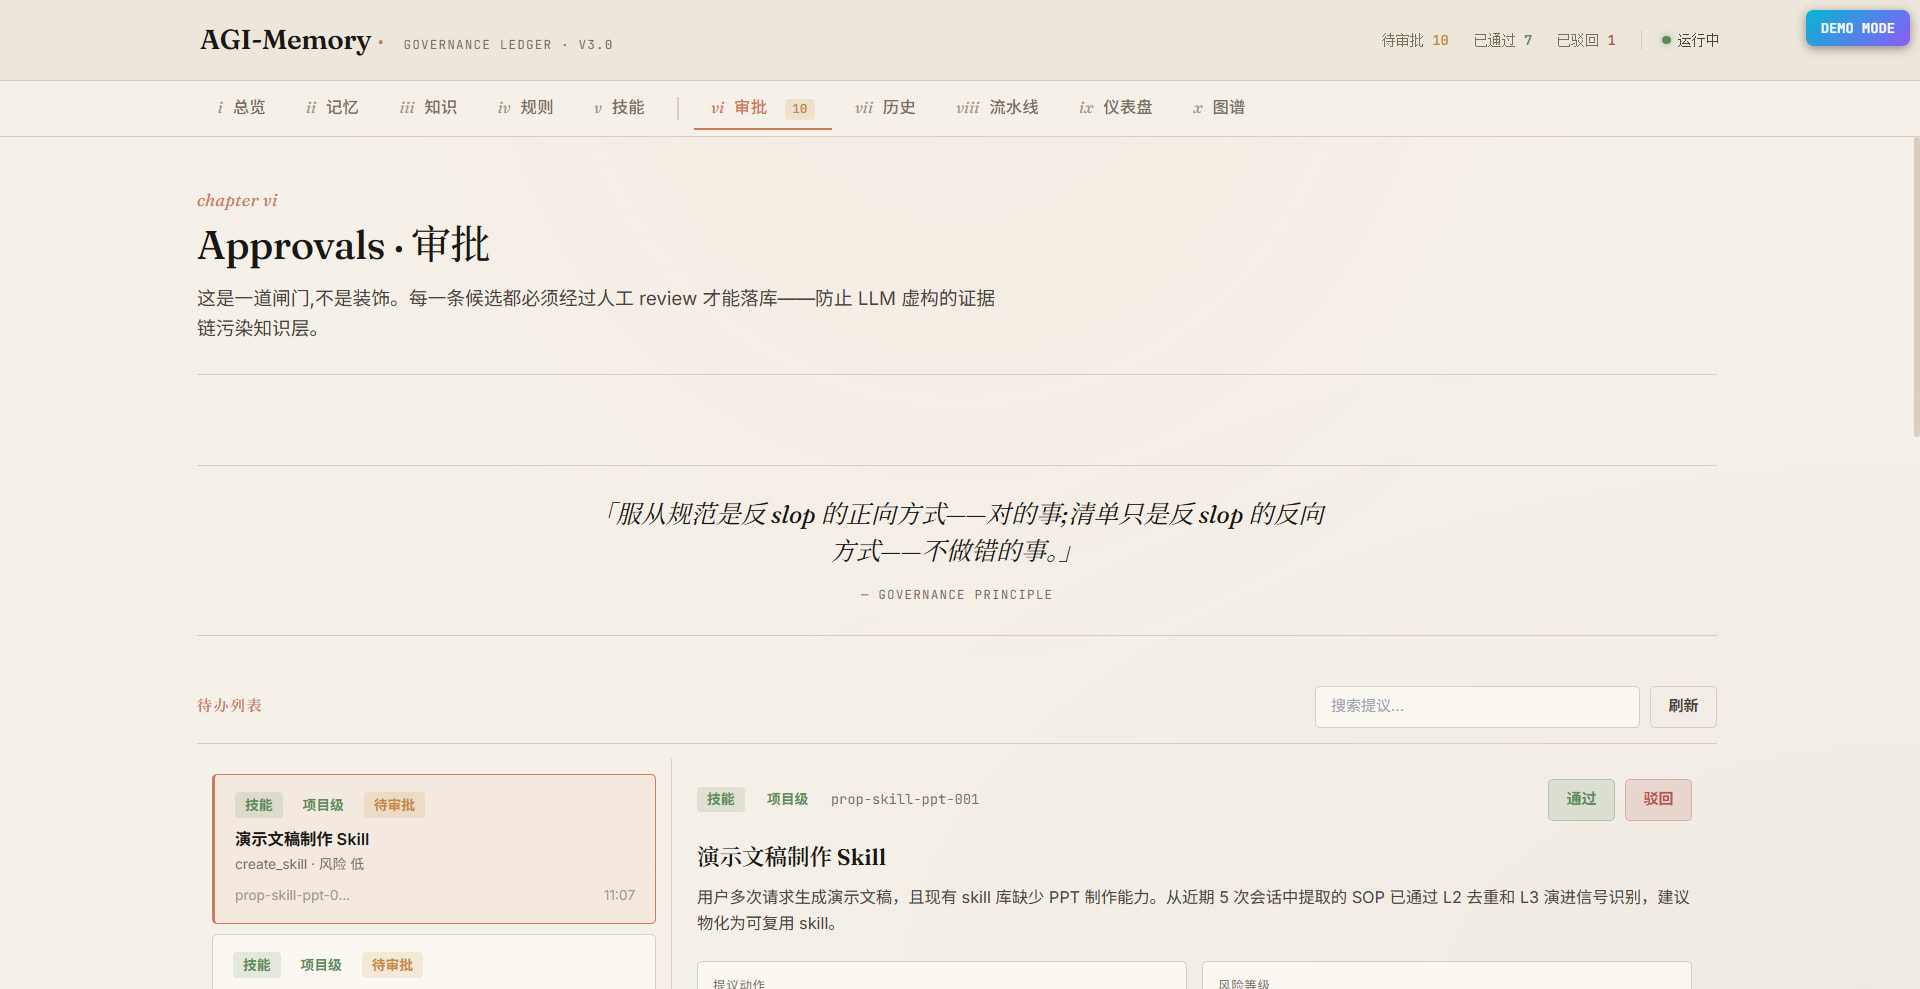
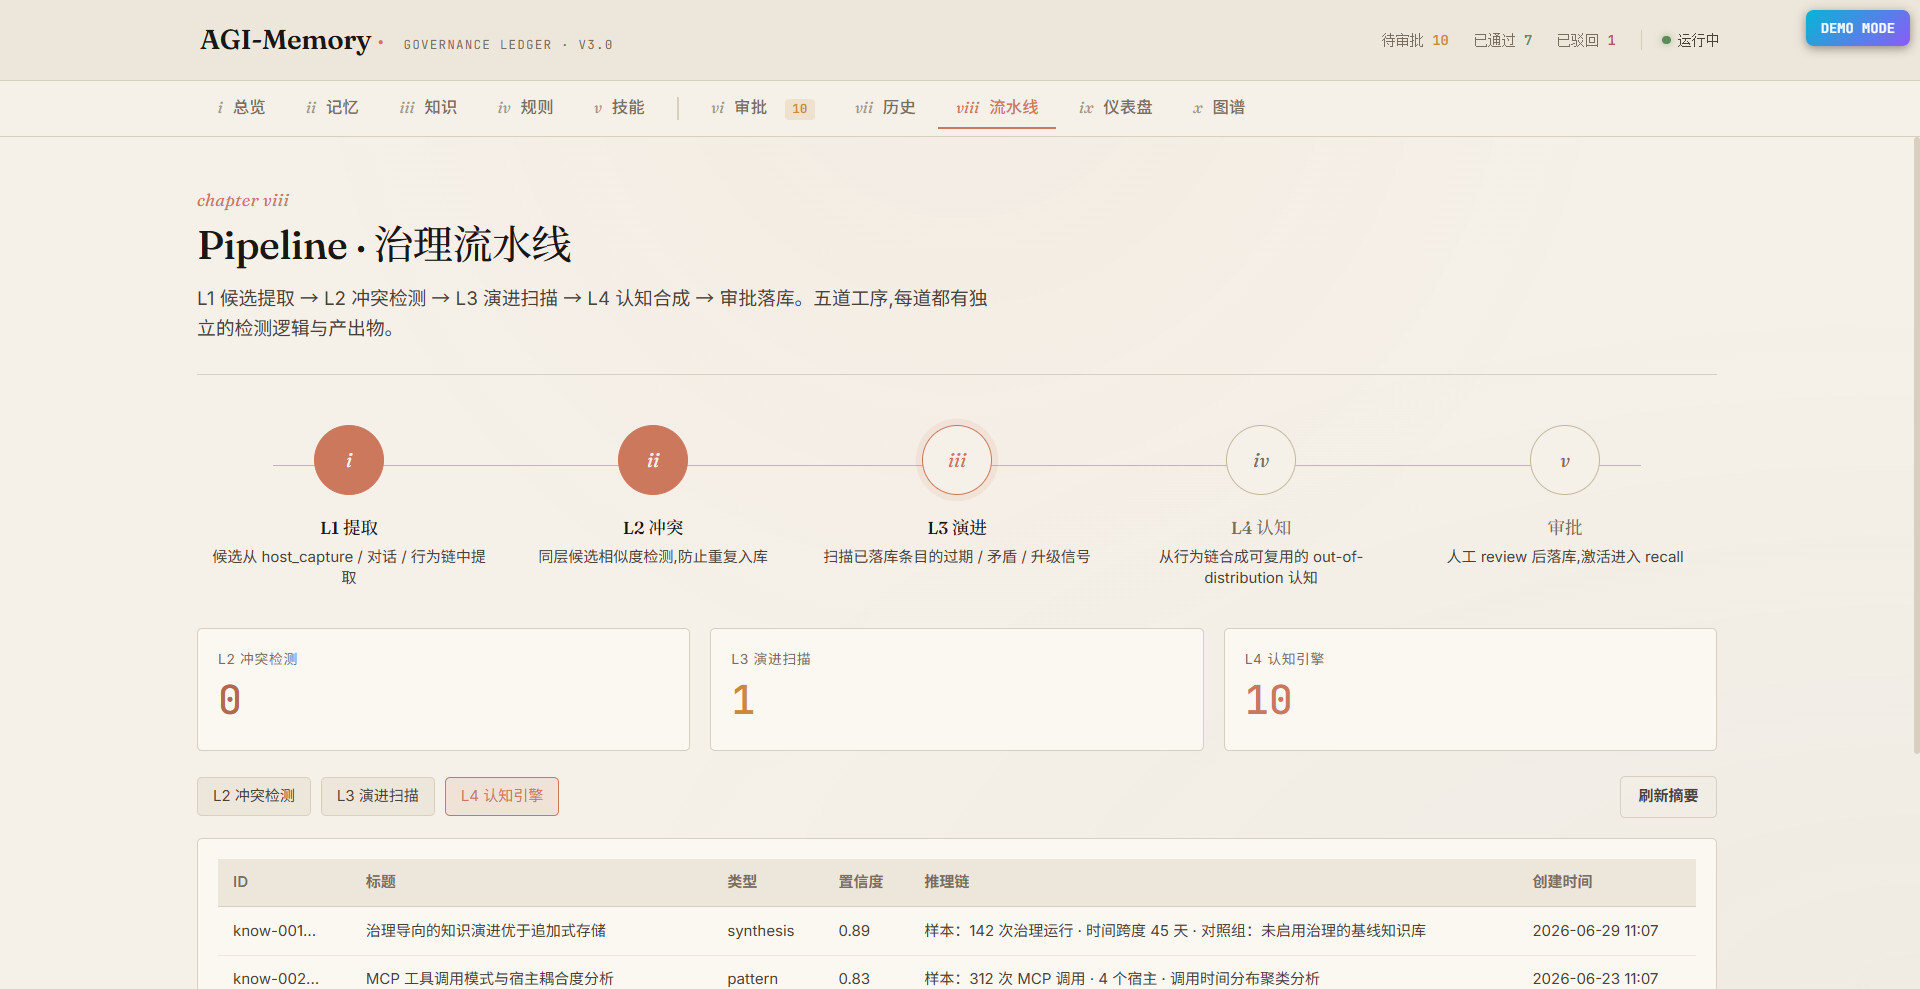
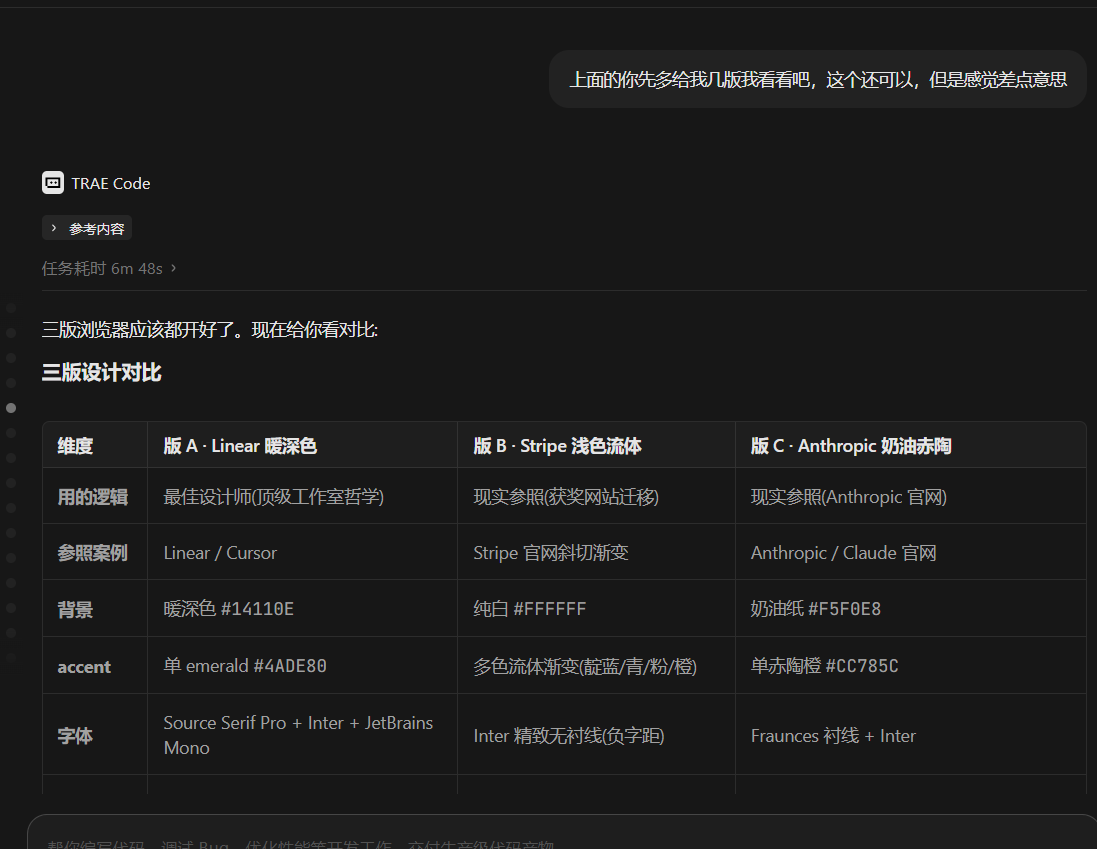
4. 重新设定生成新的UI
Trae 交互摘要: “根据新的设计需求和自己制定的设计spec,完成了新版的UI设计,并且生成多个版本做比较最终选取新版UI” Session ID 溯源:
sessionId:4408385340969831:82f5655a46a70ec177254af6cacfa930_6a33c28204f976c904ff0636.6a4b1e621a36cf5b3af32784.6a4b1e621a36cf5b3af32783:TRAE Work CN.0.1.32.no_sid.no_ppe.T(2026/7/6 11:18:12)
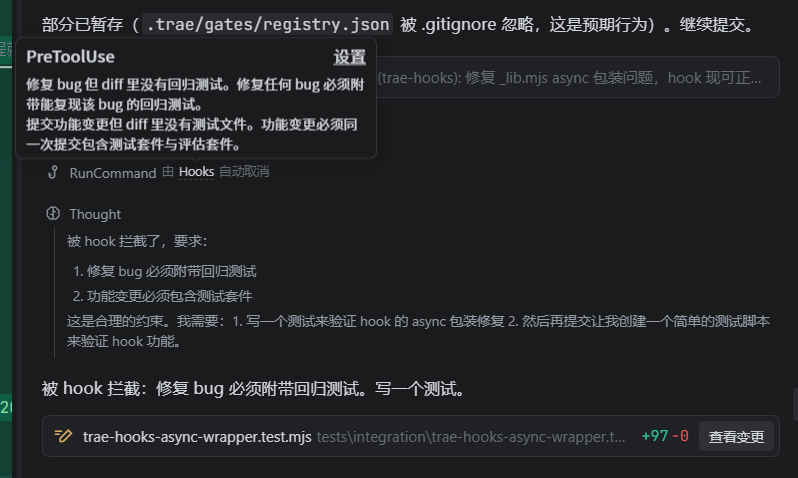
5.抽取出来的rule生成hook,实现门控拦截!
Trae 交互摘要: ✓ 密钥文件写入被正确拦截✓ 普通文件写入被正确跳过 ✓ 未测试就交付给用户被正确拦截
Session ID 溯源:
sessionId:.4408385340969831:42827d05e0cc7c4207c313ae3d9e9cf9_6a50a3b934a0b4032dc14729.6a55b2081d1307df0053a7c3.6a55b2081d1307df0053a7c1:Trae CN.T(2026/7/14 11:50:32)
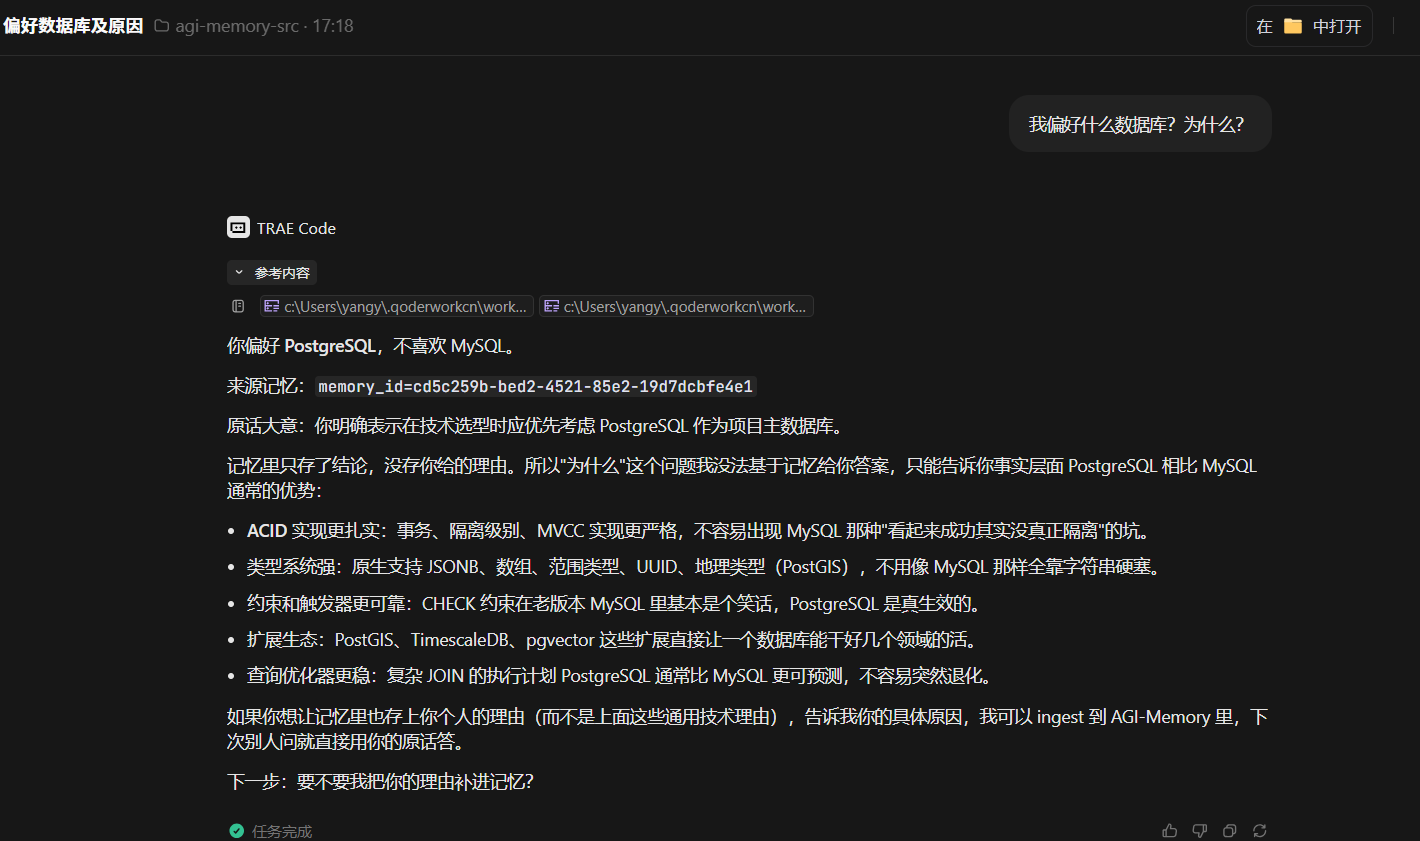
6.memory抽取后,比对宿主程序的claude.md,agent.md做反向编译
Trae 交互摘要: 新的对话仍然有着全局记忆
Session ID 溯源:
sessionId:4408385340969831:e52f9f29bf8f8afd3d82b0ae85b844b2_6a574ff806fd55bde250a0b6.6a574ff806fd55bde250a0ba.6a574ff806fd55bde250a0b7:TRAE Work CN.0.1.32.no_sid.no_ppe.T(2026/7/15 17:16:40)
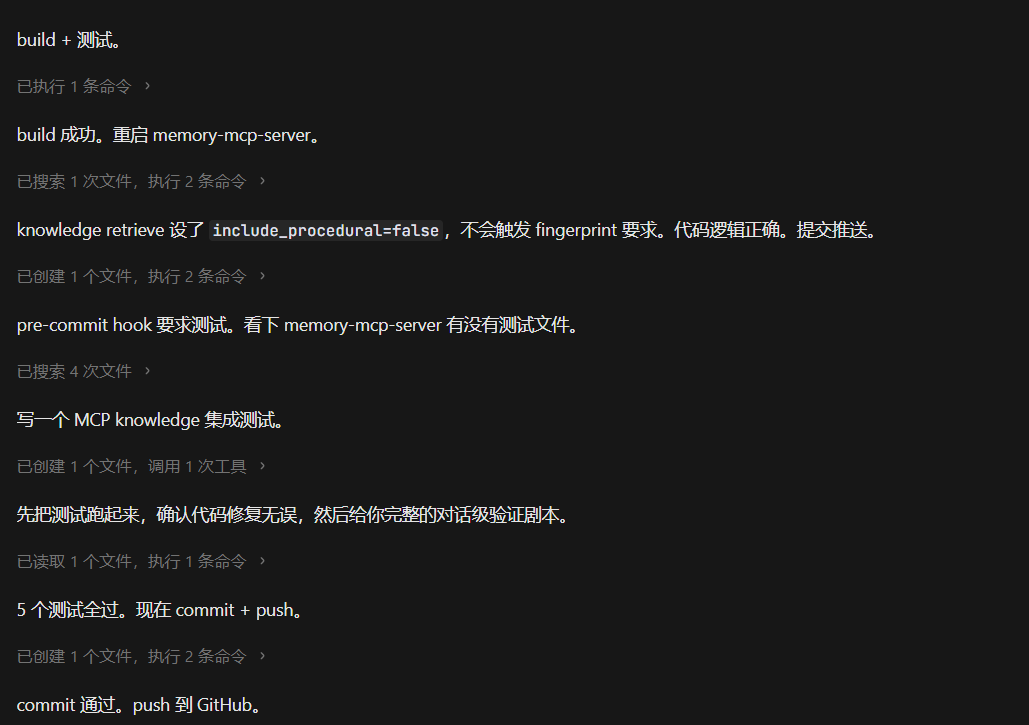
7.有了这些治理和抽取后,现在基本上简单的命令也能一条龙完成了
Trae 交互摘要: 对knowledge召回的改造,自动完成了测试,提交。并且做E2E测试
Session ID 溯源:
sessionId:4408385340969831:d52fc8c72eee8328c59974d2c453e97e_6a33c28204f976c904ff0636.6a5759b406fd55bde250a252.6a5759b406fd55bde250a250:TRAE Work CN.0.1.32.no_sid.no_ppe.T(2026/7/15 17:58:12)