我用全新 TRAE 在3小时内完成了「arXiv 论文每日速览」的开发与交付——
一个每天自动抓取 arXiv 新论文、生成中文摘要与相关度评分的 Web 工具,现在每天为我
节省约 50 分钟的文献筛选时间。作为一名凝聚态物理方向的博士生,追论文是我每天的
刚需,这篇帖子完整记录了从需求输入到最终交付的全过程,包括 Agent 模式拆解、多
Agent 并行开发、IDE 模式调试修复,以及踩过的坑和给官方的 3 条建议,全程截图为证。
一、任务背景
我每天人工浏览 arXiv 新论文约 1 小时,其中大量时间花在与我方向无关的论文上,
仍难免遗漏关键工作。我的预期交付很明确:输入领域的分类或关键词,工具自动抓取近
24 小时新论文,为每篇生成中文一句话摘要、与研究方向的相关度评分(1—5 星)
和推荐理由,支持网页浏览与一键导出 Markdown 日报。
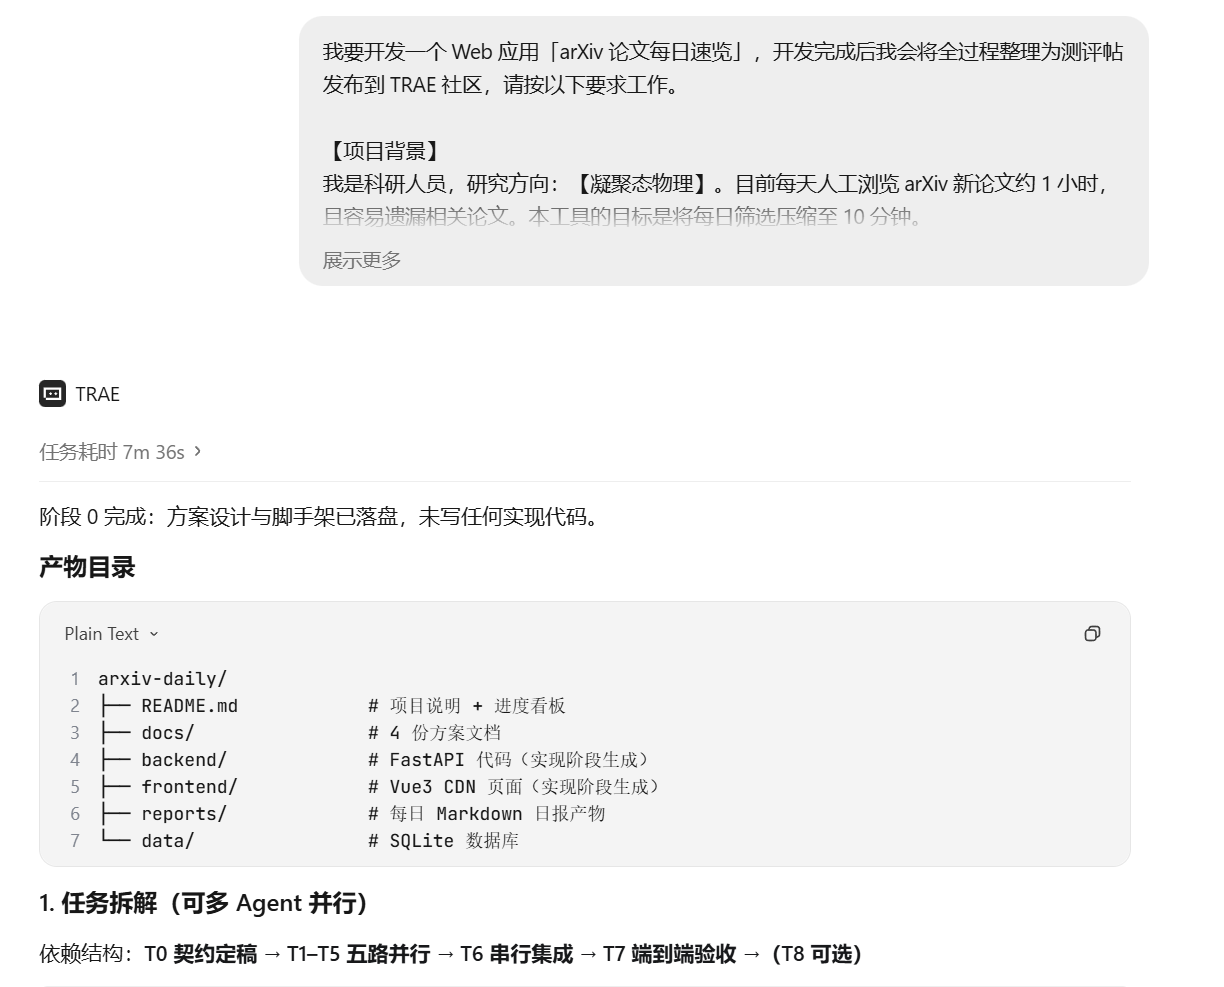
2.1 Agent 模式:把需求变成可执行计划
我以结构化文档的形式输入需求,并明确要求 Agent先拆解、后实现。
Agent 输出的拆解清单包含3个子任务,标注了依赖关系,并给出了 FastAPI +
SQLite 的技术选型及理由。
这里我做了一个关键判断:Agent 最初建议Agent 的原始方案采取同步抓取的方式,
我基于 arXiv API 有限流要求改为请求间隔 ≥3s。事后证明这个调整避免了后阶段的抓取失败。
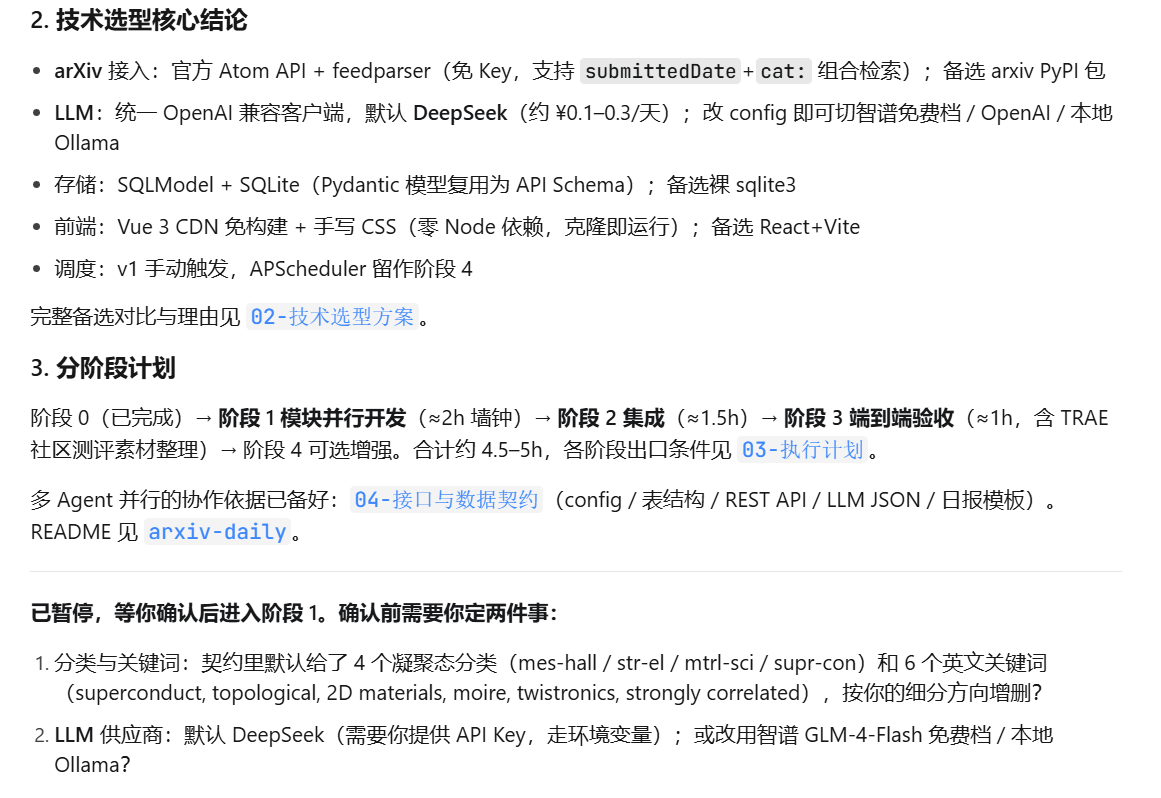
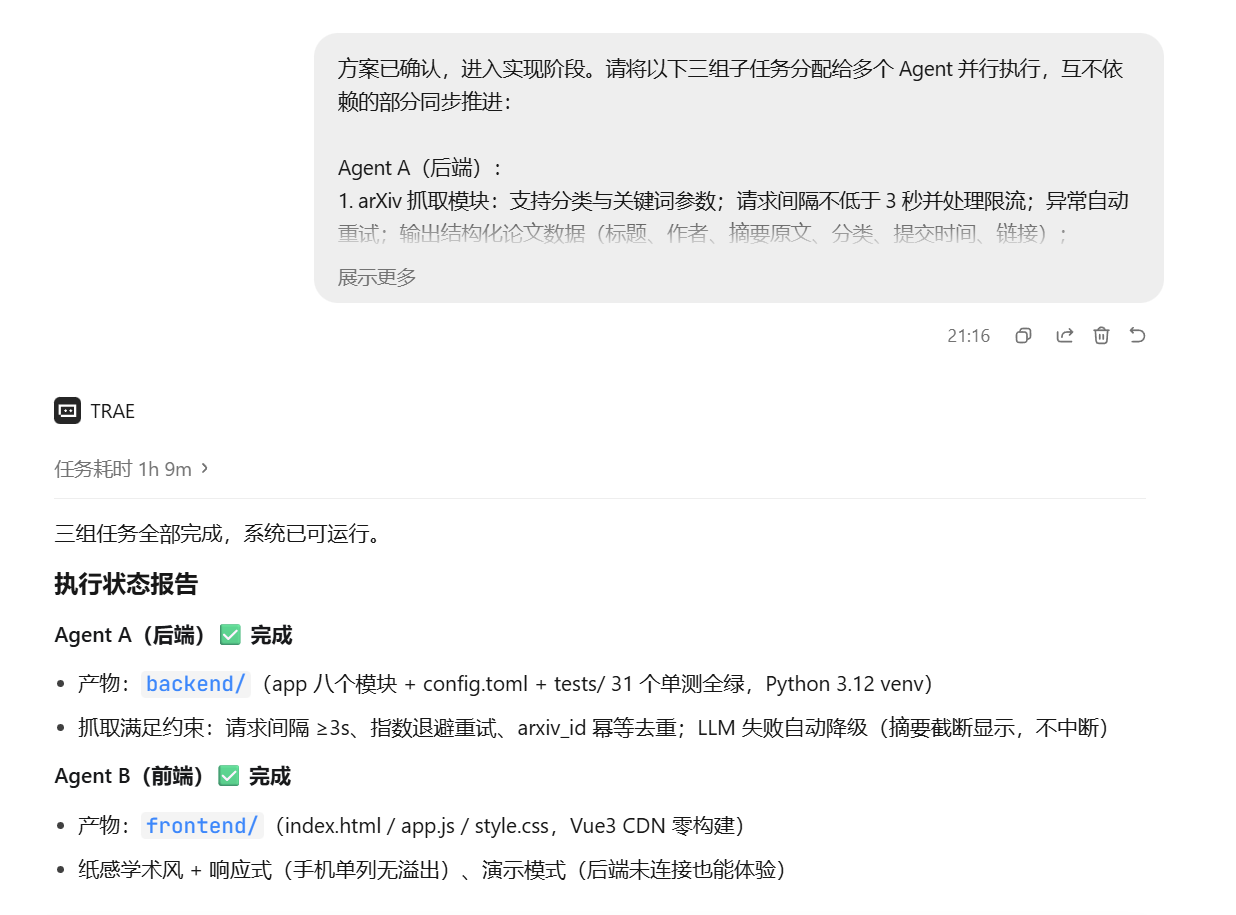
小结:让 Agent 先出方案、人做决策再动手,这才是这个工作流里最省时间的一步。
2.2 多 Agent 并行:后端、前端、联调三线推进
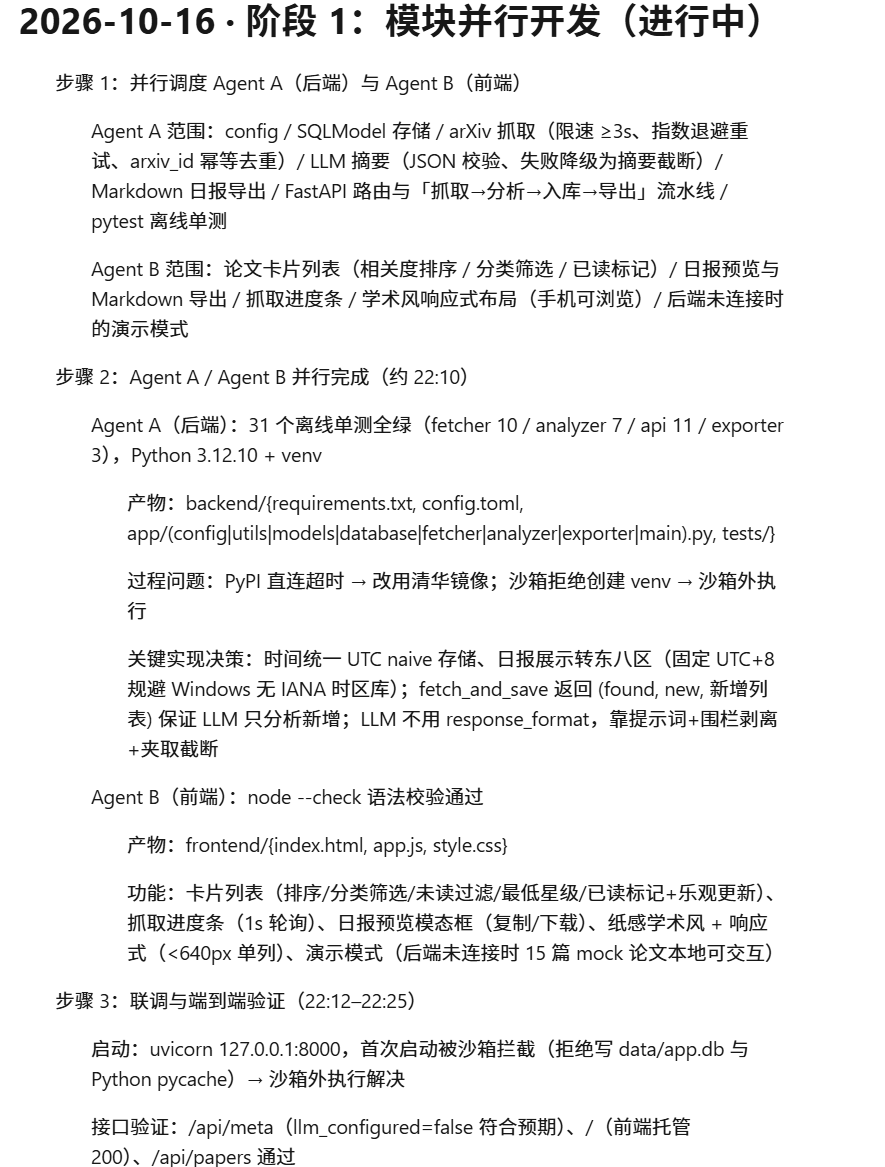
方案确认后,我将任务分配给三个 Agent 并行执行:Agent A 负责抓取与 LLM 摘要
模块,Agent B 负责前端界面与导出功能,Agent C 待前两者完成后联调验证。
并行推进期间,我在面板上能同时看到三条线的进度与状态报告。
实际体验:后端与前端几乎同时完成,整体比串行方式预估快10分钟。过程中 Agent A 曾就需要我决策关于LLM API Key的问题暂停向我请求决策,我选择了智谱 GLM-4-Flash,理由是有免费档,只需注册就可获取 Key。

2.3 切换 IDE 模式:两个真实 Bug 的定位与修复
并行开发完成后联调,我发现两个缺陷:
- 相关度评分相同的论文排序不稳定,每次刷新顺序变化;
- 已读标记刷新后丢失。
我切到 IDE 模式手动处理:第一步在浏览器复现问题并查看控制台,定位到
如排序未使用稳定键、已读状态未持久化到后端;第二步做最小化修改内容,
不碰无关模块;第三步按验证步骤手动回归。

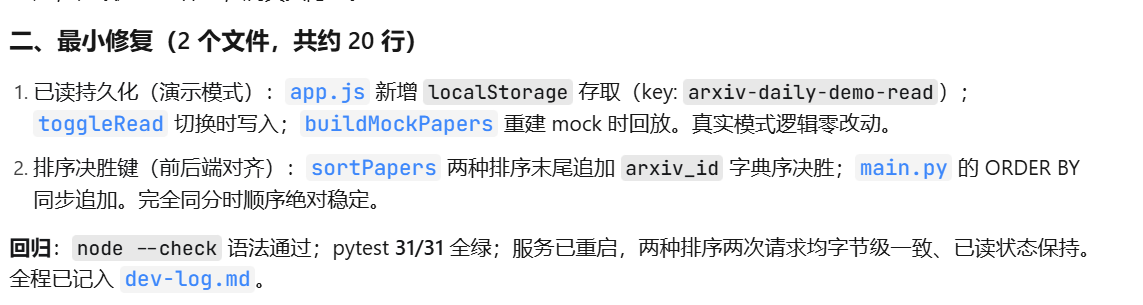
这一环节让我确认了分工边界:Agent 适合推进与生成,涉及精确逻辑的调试验证,
IDE 模式的可控性目前仍不可替代。
2.4 一次提示词迭代:让相关度评分真正可用
初版评分提示词跑出的结果中,50% 的论文集中在 4 星,几乎没有筛选价值。
我按以下思路重写:先明确 1—5 星的锚定定义,再要求模型先列相关点、后评分。
用同一批论文对新旧两版提示词各跑一次,评分分布对比如下:
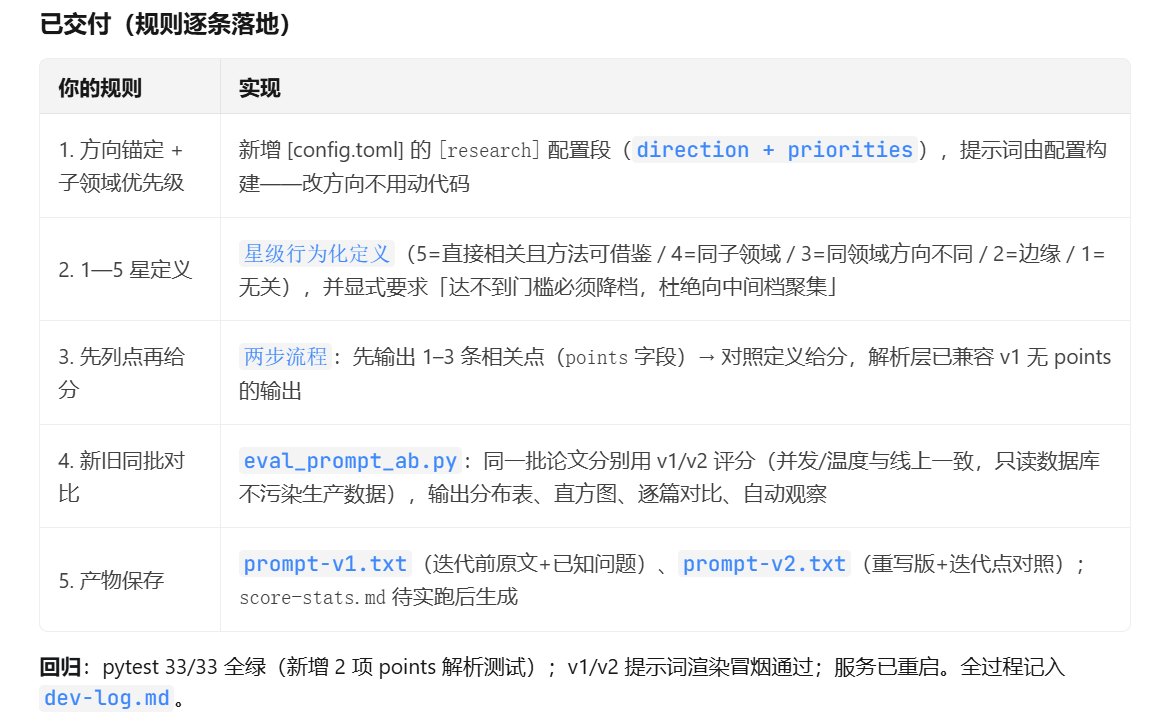
两版提示词的完整文本与统计已放在产物目录,需要的同学可以参考。
三、最终产物
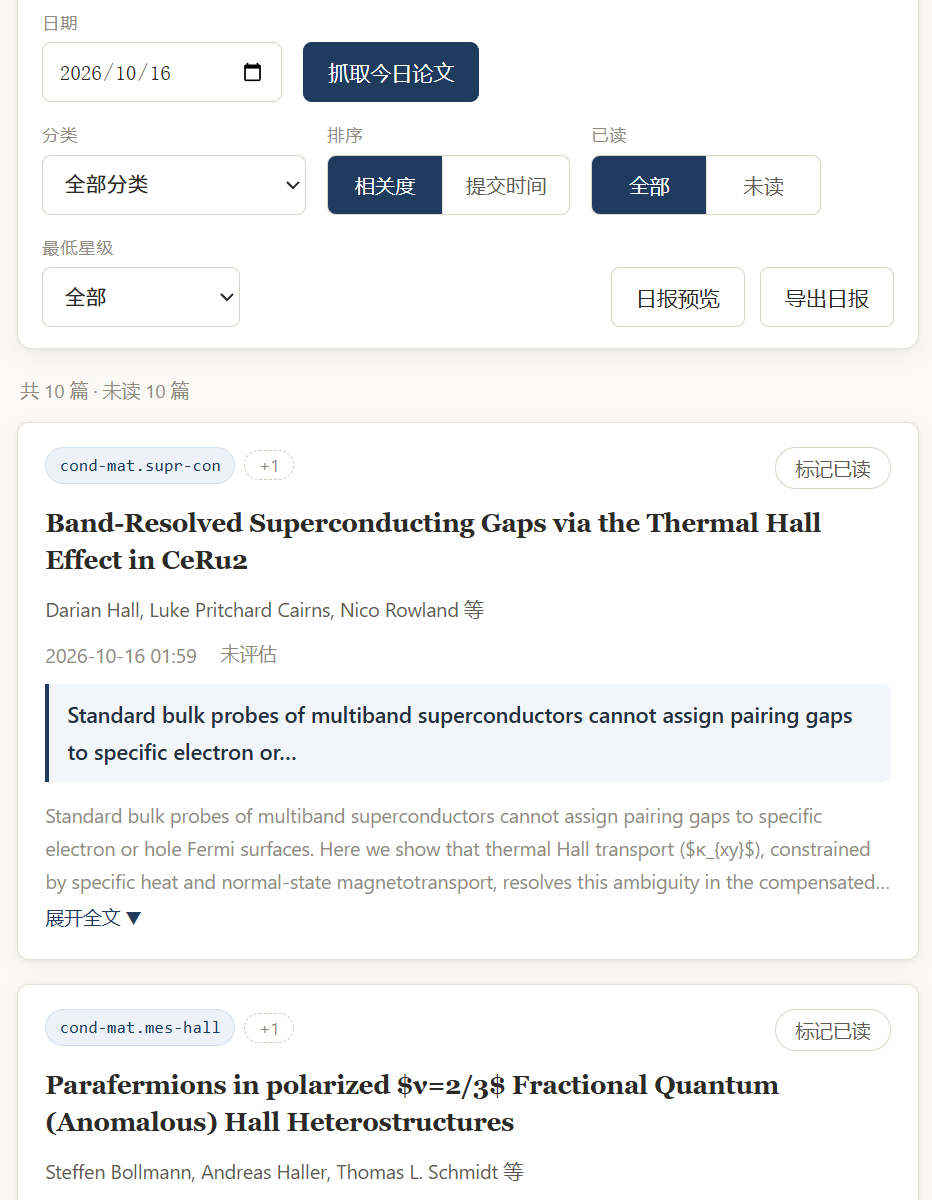
桌面端界面(支持按相关度排序、分类筛选、已读标记):
四、真实评价
节省时间的环节:前端界面从搭建到可用仅花3小时,按我以往经验人工开发
预估需半天;整体从需求到交付3小时,且全程无需在多个工具间切换。
仍需人工处理的环节:IDE 模式调具体问题】时,Agent 的第一次定位方向
有偏差,最终由我手动确认根因并修改;提示词调优共迭代2轮,每轮都需要
人工判断评分分布是否合理。
尚未解决的问题:如arXiv API 偶发限流导致个别论文摘要降级为截断显示。
