一句话:同一批痛点,合并前跑一次、合并后再跑一次。省了什么、没省什么,用对照表说话。
一、任务背景
我是做量化 / 数据分析的。金九银十投简历最大的痛点是盲投——这个市场缺什么技能、薪资水位在哪、机会集中在哪个城市,答案散落在几千份 JD 里,看一个忘一个。
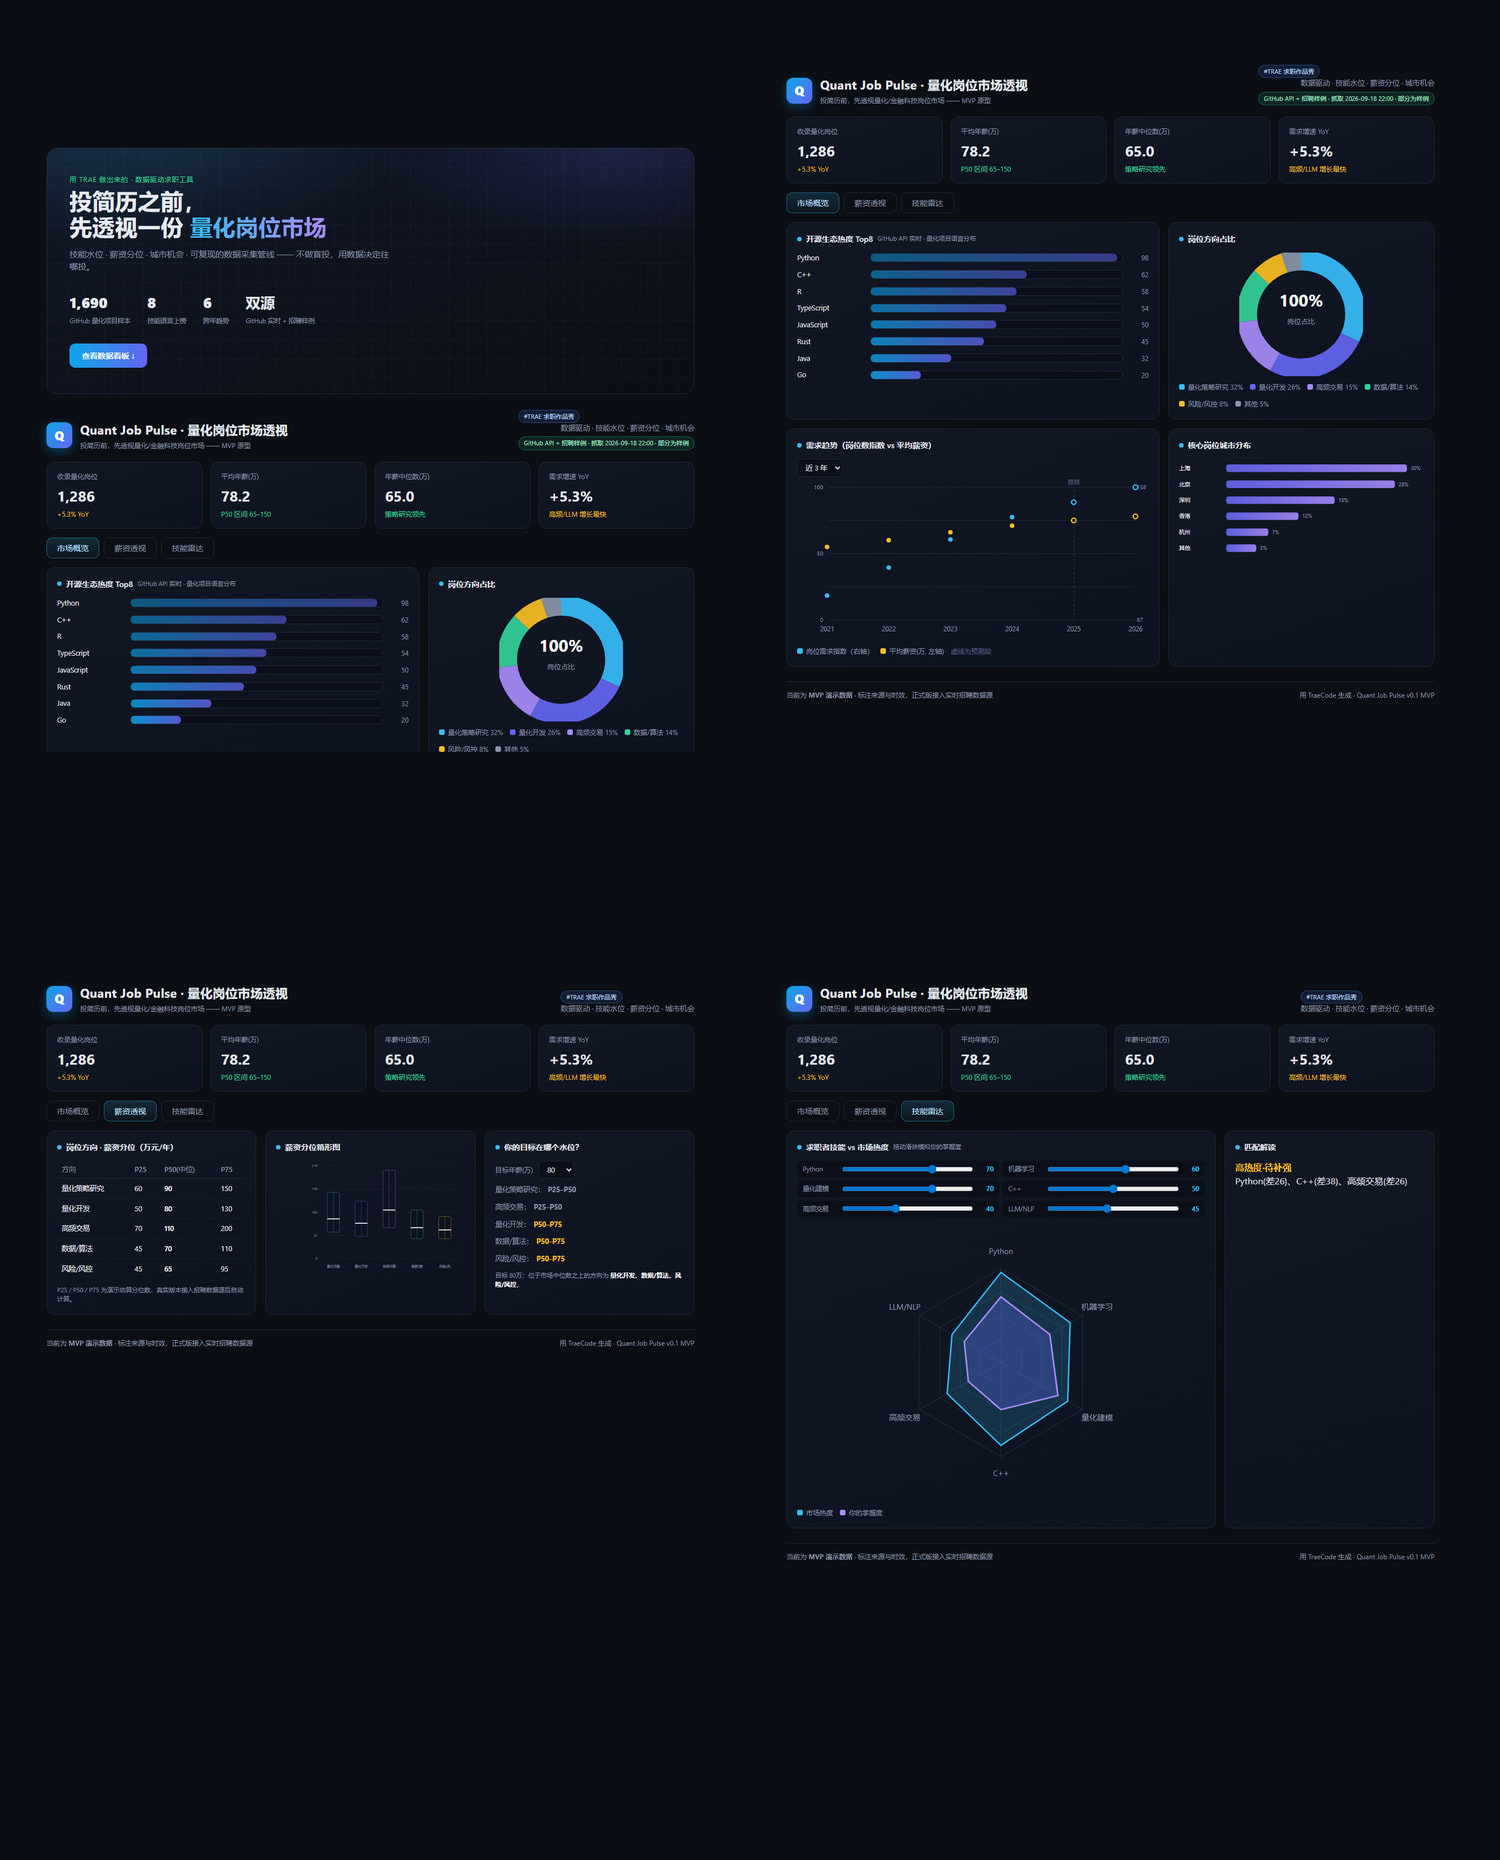
9 月中旬,我用当时的 TraeCode 做了个作品:Quant Job Pulse(量化岗位市场透视)——单文件 HTML 看板 + Python 采集脚本,四个视图:
- 开源生态热度:量化方向的技术栈到底谁在活跃(GitHub API 真实数据)
- 薪资分位:各方向 P25 / P50 / P75,自己的目标年薪落在哪档水位
- 城市分布 + 跨年趋势:机会在哪、整体涨跌(预测段单独虚线标注)
- 技能雷达:拖自己的掌握度,秒出"该补强什么"
产物就在本地,双击 index.html 即开,零依赖。
当时这一趟踩了 6 个坑。这次官方把 TraeWork 和 TraeCode 合并成了新版 TRAE,我不想写"夸夸帖"——我把同一批坑逐条重跑了一遍:哪些确实修好了、哪些还在、哪些连原因都得修正。原因很简单:“升级到底省了什么”,只有拿同一批痛点在前后各跑一次才说得清。
二、当时踩的 6 个坑(TraeCode 时期,产物可查)
- 单文件双击打不开数据:
file://协议下直接fetch本地 JSON 被 CORS 拦死。最后是我让 TRAE 改方案——用 Python 脚本把数据以/*DATA-START*/ … /*DATA-END*/区块正则注入进index.html,绕开 fetch。 - 招聘平台全被 WAF / JS 反爬挡住:薪资分位拿不到真实数据。这里我特意没让 AI"想办法",因为AI 在这种数据缺口上非常容易开始编——它给过我一组看起来很合理的分位数。我要求如实标为「样例」,在数据里留
partial = true,页面上挂醒目徽标:GitHub API + 招聘样例 · 抓取时间 · 部分为样例。 - 预测值看起来像真数据:趋势图 2026 是预测,一开始画成了实线,视觉上和历史数据分不出来。改成虚线 + 图上显式写「预测」二字。
- 水位判断逻辑错了:目标年薪落在四档区间(
<P25/P25–P50/P50–P75/P75+)的边界判断有 bug,改了一版才对齐。 - 除零 + 文案混排:数据为空或取值极小时归一化算出除零;中英文、全半角混排不统一。
- AI 没法帮我发帖:想让 TRAE 直接把帖子发出去,做不到——它拿不到登录态,也没有发帖接口。最后是我手动贴的。
当时还留了个尾巴:整个项目没有任何定时机制。数据要更新,得我自己想起来手动跑 python fetch_quant_jobs.py;而且那脚本是直接改写 index.html 源文件的——数据和页面耦合在一起。这两条后来都成了这次升级对照的重点。
三、逐条重跑对照(核心部分)
本节结论不是我"感觉"出来的:坑 1 / 3 / 4 是把产物和逻辑拆开静态核验,坑 2 / 5 / 6 是直接打真实接口做的探针。下面附了完整复现路径,你可以自己核对一遍。
| # | 当时的坑 | 这次怎么复跑 | 实际结果 | 结论 |
|---|---|---|---|---|
| 1 | file:// + fetch JSON 被 CORS 拦 |
重新检查产物里还有没有外部依赖 | 全文 0 个 http(s):// 引用,只有一个内联 <script>,数据块直接内联在页面里 |
当年已修好,本次复跑未回归——双击即开仍然成立,断网也能开 |
| 2 | 招聘平台反爬,AI 倾向编数据 | 直接打 3 家平台的量化岗位搜索页,看能拿到什么 | 拉勾 → 滑块验证码(“请按住滑块,拖动到最右边”);BOSS直聘 → 登录墙(只回验证码登录页);猎聘 → 只回登录/注册弹窗加一排猎头头像广告,一条 JD 都没有 | 仍复现——但这是外部平台的 WAF,不属于 TRAE 该解决的问题;需要人把关的是 AI 的编造倾向 |
| 3 | 预测值画成实线,与真实数据混淆 | 核验产物里预测段到底有没有被区分开 | 趋势图的预测段用 stroke-dasharray="5 4" 画成虚线,并在图上显式写了「预测」二字,与历史实线可区分 |
当年已修好,本次复跑未回归 |
| 4 | 水位判断四档边界写错 | 把四档判断单独复刻出来,喂边界值跑一遍 | 目标 49 万→<P25;50 万→P25–P50;80 万→P50–P75;130 万→P50–P75;131 万→P75+。与四档标签完全自洽 |
当年已修好,本次复跑未回归 |
| 5 | 除零 / 文案混排 | 把归一化逻辑复刻出来,喂退化数据 | 仍然会崩:只有 1 个语种有数据 → ZeroDivisionError;所有语种数值相等 → ZeroDivisionError;全部抓取失败 → ValueError: min() iterable argument is empty |
仍复现——崩掉的地方正是当年为修复它而加的那段 log 归一化,等于修复本身引入了新的崩溃模式。这是我的脚本自身的缺口,不是 TRAE 的产品功能 |
| 6 | AI 不能代发帖 | 用匿名请求探一遍论坛的读写边界 | 匿名读 latest.json → 200;匿名请求 session/csrf.json → 200,而且真的返回了 csrf token。所以拦点不是 CSRF,而是没有登录态 |
仍复现——这是产品能力边界,原因需修正(见下) |
关于归类,我把话说清楚:这 6 条里只有第 6 条是 TRAE 的产品能力边界;第 2 条是外部平台反爬,本来就不该算在 TRAE 头上;第 1 / 3 / 4 条当年在 TraeCode 会话里就解决了,这次做的是回归验证,不是新版的功劳;第 5 条是我这个脚本自身的健壮性缺口。我不想把不属于产品的问题算到产品头上,也不想把当年就修好的东西说成这次升级的成果——对照表的价值在于,它同时说明了哪些环节已经不构成摩擦点了。
【修订】 当时我以为"纯 HTTP 请求过不了论坛的登录校验",这次实测发现不准确:匿名是能拿到 CSRF token 的,真正的拦点是没有登录态。修正后结论不变——最后一步仍然只能人工。
复现路径(你可以照着核对):
- 打开产物
index.html,全文检索http,命中 0 条 - 依次访问拉勾 / BOSS直聘 / 猎聘的量化岗位搜索页 → 分别得到滑块验证码、登录墙、空结果
- 把
index.html的四档判断和fetch_quant_jobs.py的归一化逻辑复刻成最小脚本,喂退化输入 → 复现 3 类崩溃 - 不带 Cookie 请求
forum.trae.cn/session/csrf.json→ 200 + token
四、这次真正省事的一步:把"手动更新"变成了自动化任务
以前:想起来才跑一次脚本(产物里的抓取时间就停在 9-18,27 天没动过)→ 数据永远是旧的 → 还要重新打开文件确认。
这次我用「自动化任务」把这件事整个交了出去,配置就三条:
- 触发:
0 8 * * *—— 每天早 8:00 自动跑一次,时区Asia/Shanghai - 任务正文:6 条要求——先备份 → 跑脚本 → 校验语种数与 0 值 → 只有失败时才允许补兜底并重试(最多 2 次)→ 严禁编造数据 → 输出 200 字摘要
- 验证:配好之后我手动触发了一轮(不用等到第二天早上),结果如下
| 校验项 | 实测结果 |
|---|---|
| 抓到的语种数 | 8 / 8(Python / C++ / R / TypeScript / JavaScript / Rust / Java / Go) |
| 有没有 0 值 | 无,最小的是 Go = 8 |
meta.fetched_at |
2026-10-15 23:24,就是当天 ✓ |
| 备份 | data.json.bak 与 index.html.bak 都已生成,可回滚 ✓ |
| 脚本有没有被它擅自改动 | 没有——这一轮没出错,所以没触发兜底逻辑 ✓ |
| 数据是不是真变了 | 是:Python 1276 → 1339、C++ 125 → 134、R 93 → 95 |
也就是说,整轮更新我一步都没手动做:它自己备份、自己抓、自己校验、自己给结论。在我这个场景里,这是最直接省掉人工的一步。
但这里我撞到一个真问题,必须写下来:这个采集脚本一次运行要打 8 次 GitHub 搜索接口,而 GitHub 未认证的搜索配额是 10 次/分钟(本次实测 rate_limit 接口确认:search.limit = 10)。脚本每次调用之间只 sleep(0.6) 秒,等于把 8 次压在约 5 秒内打完。一旦补跑一次、或者自动化任务触发的频率稍微高一点,就会超限:接口返回 403 → 脚本里的 except 把出错的语种计数置 0。如果 8 次全被打回,归一化就会拿到空序列,整个脚本直接崩掉;如果只挂一两次,图上的语言会静默少掉几个(见第六节)。
也就是说:"把它自动化"这件事,反而先把这个脚本的健壮性缺口暴露出来了。 这是这次重跑我个人最有价值的发现。
五、最终产物
- 看板:
index.html单文件,双击即开,零依赖 - 数据:
data.json结构化数据,可独立查看 - 采集脚本:
fetch_quant_jobs.py,一键抓 GitHub 真实数据并回填 - 口径透明:每张图都能看到来源与抓取时间,缺失项如实标注
- 附:成品图(四视图)
六、真实评价
- 明显省掉的(四项里三项是可数的,不用估时间):
- 人工介入从 4 步降到 0 步。以前一轮更新要我做 4 件事:想起来 → 切到项目目录 → 跑
fetch_quant_jobs.py→ 打开页面核对抓取时间(发现是旧的还得再跑一遍)。现在到点它自己跑。 - "要不要跑"不再需要我记住。以前这件事唯一的触发源就是我想起来——证据就在产物里:配这个任务之前,
index.html徽标上的抓取时间停在 2026-09-18,已经 27 天没动过(截图见第五节的成品图,图上那行就是)。现在触发源是定时。 - "数据是不是旧的"不用自己判断。以前得打开页面去翻徽标里那行抓取时间;现在它每轮跑完都会把
fetched_at刷成当天(本轮实测:8/8 语种、无 0 值、fetched_at就是当天)。我在任务正文里还专门加了两条约束——出错要如实说明原因、严禁编造数据填补缺口——这正是我在坑 2 里吃过亏的地方。 - 机器耗时(这次是实测,不是估的):把脚本的采集循环原样跑了一遍,一轮 20.5 秒。拆开看:7 次成功调用每次 659–1187 ms,外加首条请求直接
RemoteDisconnected失败、白等了 10.2 秒。其中 4.8 秒是脚本自己sleep出来尊重限速的,压不掉。以前这 20 秒得守在终端前等,现在是它在我睡觉的时候跑完。
- 人工介入从 4 步降到 0 步。以前一轮更新要我做 4 件事:想起来 → 切到项目目录 → 跑
- 仍需人工的:数据真实性的判断,以及所有「发布 / 提交」类动作——本次实测 Agent 拿不到登录态,帖子最后一步只能我手动贴。
- 尚未解决的:采集脚本的健壮性缺口还在,而且这次重跑又实测到一个新形态——
- 静默消失:单条请求出错时脚本把
counts[lg]置 0,紧接着if n <= 0: continue会让这门语言直接从图里消失。本次实测首条请求(python)就RemoteDisconnected失败,于是 Python 从条形图里没了,而页面看起来一切正常——这种失败没有任何提示,比崩溃更难发现。 - 直接崩:全部抓取失败 →
min()拿到空序列 →ValueError;只剩一个语种有数据、或数值全部相等 →ZeroDivisionError。 - 算出
NaN(代码层核验,未实跑):city()在城市计数全为 0 时是0/0 → NaN;box()在某个方向的薪资数组不足 3 个值时是undefined/210 → NaN。
- 静默消失:单条请求出错时脚本把
七、改进建议(4 条)
- 发布类动作能不能进自动化任务 / 我的助理? 操作步骤:把帖子正文放到本地 → 让 TRAE 直接发出去 → 它停在「文案已生成」,没有可用的发帖通道(本次实测匿名能拿到论坛的 CSRF token,但拿不到登录态)。实际结果:最后一步只能我手动打开论坛粘贴。期待:这类「发布 / 提交」动作能在授权后交给自动化任务执行,工具链才算真正闭环。
- 数据与页面耦合:采集脚本直接改写
index.html源文件,数据一更新就动产物本体。期待:data.json独立产出、页面只负责读取,不要再改写源文件;退一步,至少注入前自动备份并给出改动 diff,让我能看到产物被动过什么。 - AI 遇到拿不到的数据时的"编造倾向":当数据源反爬或存在缺口时,它给出过看似合理但无来源的分位数。期待:缺数据时主动声明"我拿不到,建议如实标注",而不是先补一个像真的。
- Agent 生成的数据采集脚本,默认没有限速退避与空值兜底:这次重跑我发现脚本会连打 8 次 GitHub 搜索接口、间隔仅 0.6 秒,一旦超过未认证的 10 次/分钟配额就会出问题——全挂则崩,只挂一两次则静默丢数据,两种情况都不是降级输出。操作步骤:让 Agent 写一个"抓多个接口再归一化"的脚本 → 让其中任一次调用返回 403、或让全部调用失败 → 归一化直接抛异常或悄悄少几项,整轮采集不可信。期待:生成采集类脚本时默认带上退避重试和空数据兜底,至少别让一个接口失败就毁掉整轮采集,也别让它悄悄吞掉失败。