【完整实战案例】给 AI 写的 CI 门禁补测试:全新 TRAE 19 分钟交付 16 个用例,我的独立验收零打回
测试产物:
=======================================================前后对比
一、任务背景:一个昨天才进 main、却没有任何测试的 CI 门禁
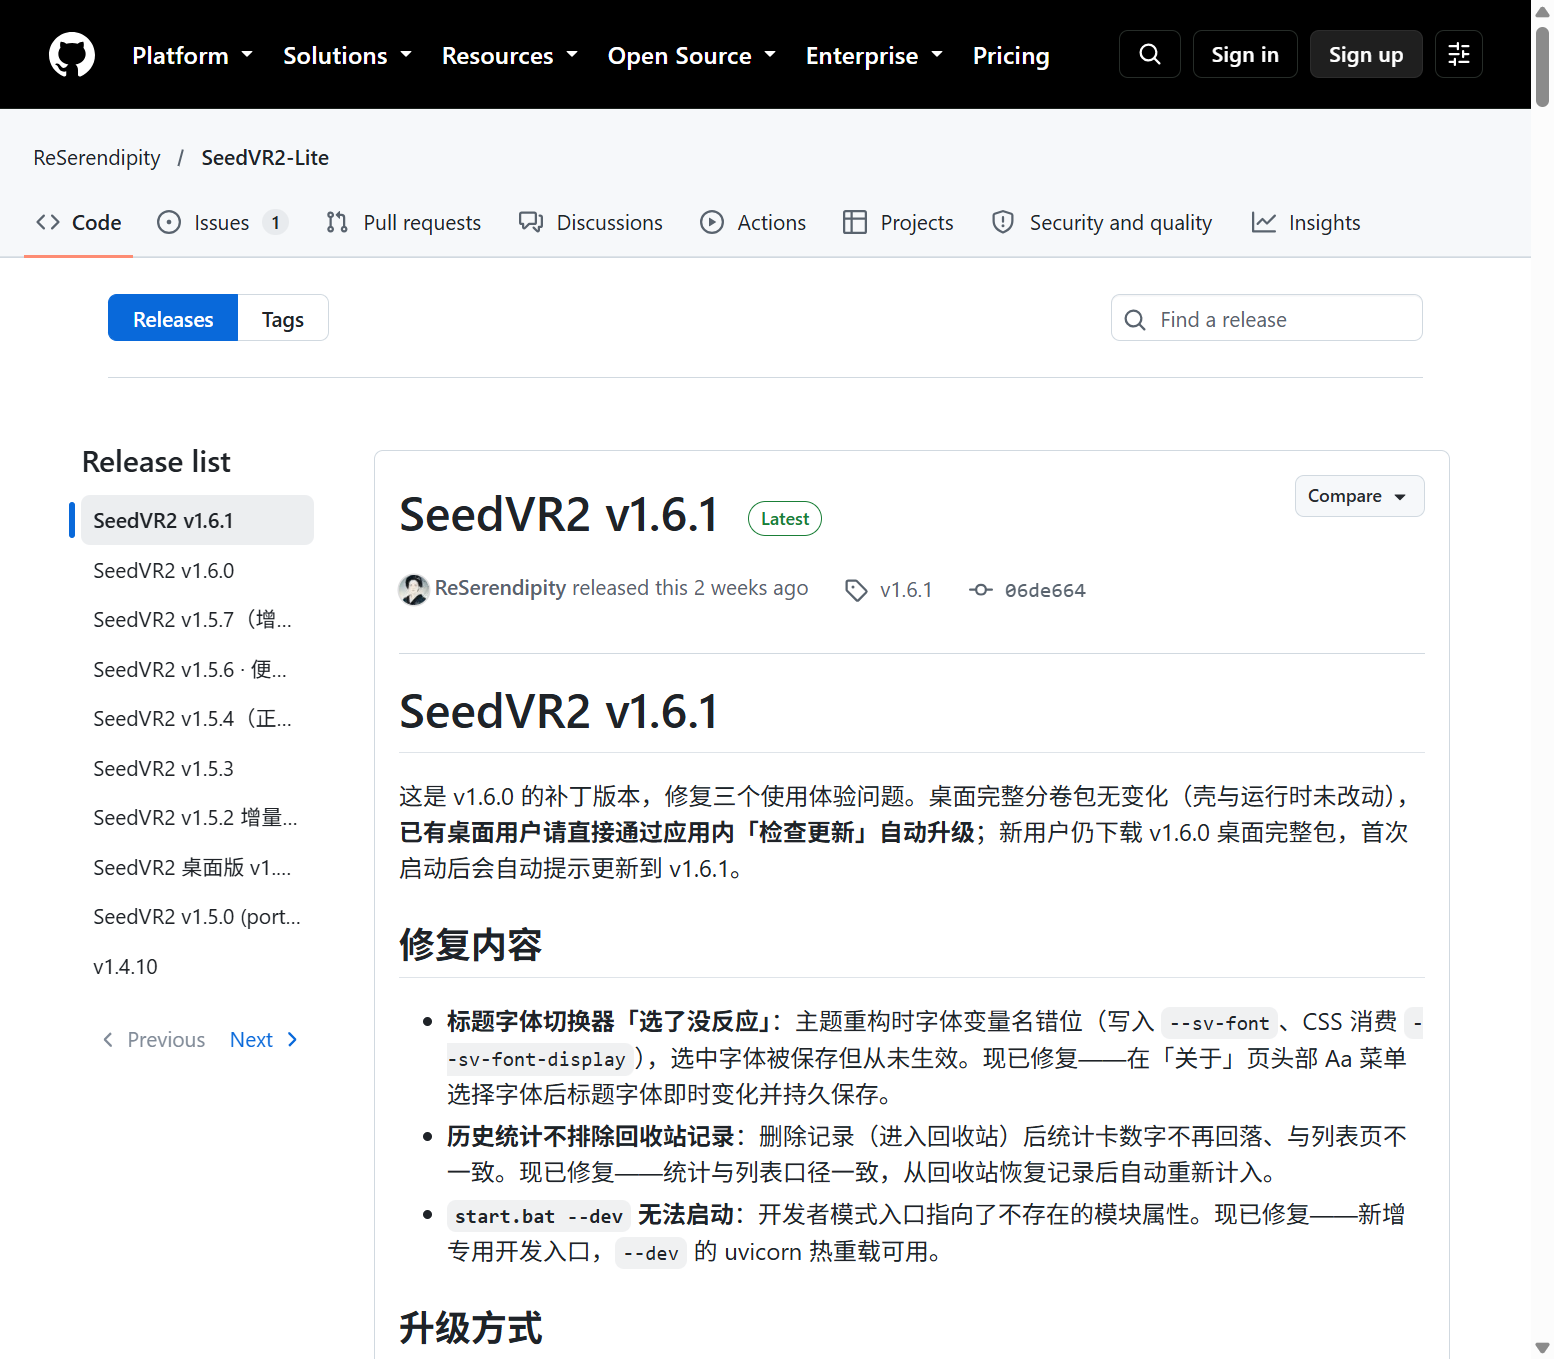
我在业余时间维护一个桌面端 AI 项目 SeedVR2-Lite:把官方需要 ComfyUI + 十几 GB 模型 + 复杂工作流才能跑的 SeedVR2 视频/图像超分,做成带 Tauri 桌面壳、一键安装、面向不懂代码用户的修复工具,配套 GitHub Pages 在线演示和增量更新通道。项目的最新正式版是 10 月 2 日发布的 v1.6.1。
项目里有一个 requirements-container-lock.txt——Docker 镜像实际安装的 111 个钉版依赖清单。它是 uv.lock 的导出件,但 Dependabot 会就地修改导出件、却从不重跑 uv lock。这个机制在 10 月 12 日接连发作两次(urllib3 单包升级、78 个依赖的批量升级),导致 uv.lock 与镜像实装版本各说各话,最后靠手动回退导出件才让 docker-publish 转绿,一次构建红大约 35 分钟。
10 月 14 日,项目里合入了 PR #162 解决这件事,除了止血同步,核心是加了一道锁一致性闸:
.github/workflows/lock-consistency.yml(74 行):CI 里用钉死的 uv 0.13.0 重新导出 uv.lock,与提交件比对;scripts/check_lock_consistency.py(131 行):比对"name==version 钉版集合"的 Python 脚本。
这道闸当天就在 main 的 CI 上跑绿了。但它有个微妙的问题:闸本身没有任何测试。
这个 131 行的脚本要处理的全是脏活:PEP 503 包名归一化(pydantic_core 和 pydantic-core 必须是同一个包)、Windows runner 上 CRLF/LF 行尾、uv 导出头两行要跳过、多行 --hash 续行的归属、hash 覆盖率差异只能报 INFO 不能判失败(因为 torch 的 CUDA 本地版本有手工补的哈希)……任何一个理解错,闸要么误报扰民,要么沉默放过真正的漂移。
10 月 15 日凌晨我写完测评活动的发帖计划,决定不拿旧功能凑数,就用这个真实缺口当任务:在全新 TRAE 里建一个新任务,让它为这道闸补一份行为测试。仓库 tests 目录里有 test_check_upstream_sync.py、test_check_numz_release.py 这样的同类先例(importlib 按路径装载 scripts 脚本、CPU-only、不联网),我要求新测试沿用同一风格。
二、推进过程:先立规矩,再放 Agent 干活
2.1 我做的第一件事不是打开 TRAE,而是写验收标准
让 AI 写测试最容易翻车的地方是:它能交出一份"看起来很完整"的测试,但断言的是实现细节而不是行为规格,或者干脆和源码互相抄写(tautology),覆盖率漂亮、防护力为零。
所以发任务前我先写死了指令卡(全文存在我的工作记录里),关键约束有六条:
- 只许新增
tests/test_check_lock_consistency.py这一个文件;不许改被测脚本、conftest 和其他任何文件。测试要是实锤了脚本有 bug,停下来报告,不许自行改源码——改了源码让测试变绿,等于既当运动员又当裁判; - 用例必须覆盖六类风险点:PEP 503 名等价、CRLF/LF 归一化、header 跳过、hash 续行归属、差异四分类(版本漂移 / 仅一侧存在 / hash 覆盖差异)、退出码契约(一致=0、漂移=1,且 FAIL 要点名漂移包);
- 夹具全部用
tmp_path现造文本,不读真实锁文件、不联网; - 环境障碍自己决策(我提前知道 tests/conftest.py 经 app 层顶层 import torch,新机器上收集就会失败),但要在汇报里说明决策与耗时;
- 验收命令是
pytest tests/test_check_lock_consistency.py -v全绿,且git status只出现新文件; - 提交必须用 GitHub noreply 身份(从 git log 自己读标准邮箱),只本地 commit,不许 push、不许开 PR。
写得这么细不是为了省事,恰恰相反——约束越明确,AI 的自主空间才越安全。"帮我给这个脚本补点测试"这种指令,产品体验上是放飞,工程上是赌博。

2.2 Agent 模式:19 分钟的真实过程,包含两次决策和一次翻车
发送任务后,TRAE Agent(模型 Seed-Evolving Max,完全访问权限,未绑定项目文件夹)开始跑。整个任务耗时 18 分 57 秒,我在旁边只做观察,中途没有给任何补充指令。从它的思考过程时间线看,关键节点是这样的:
第一阶段是侦察,不是写码。 它先读被测脚本、tests 目录里的两个先例、conftest,然后顺着 import 链摸 app.integrated_app.app_server → engines → seedvr2_engine,确认"跑任何测试都得先让 torch 这条链 import 通过",并指出 .venv 是个只有 fastapi/pytest 的精简环境。
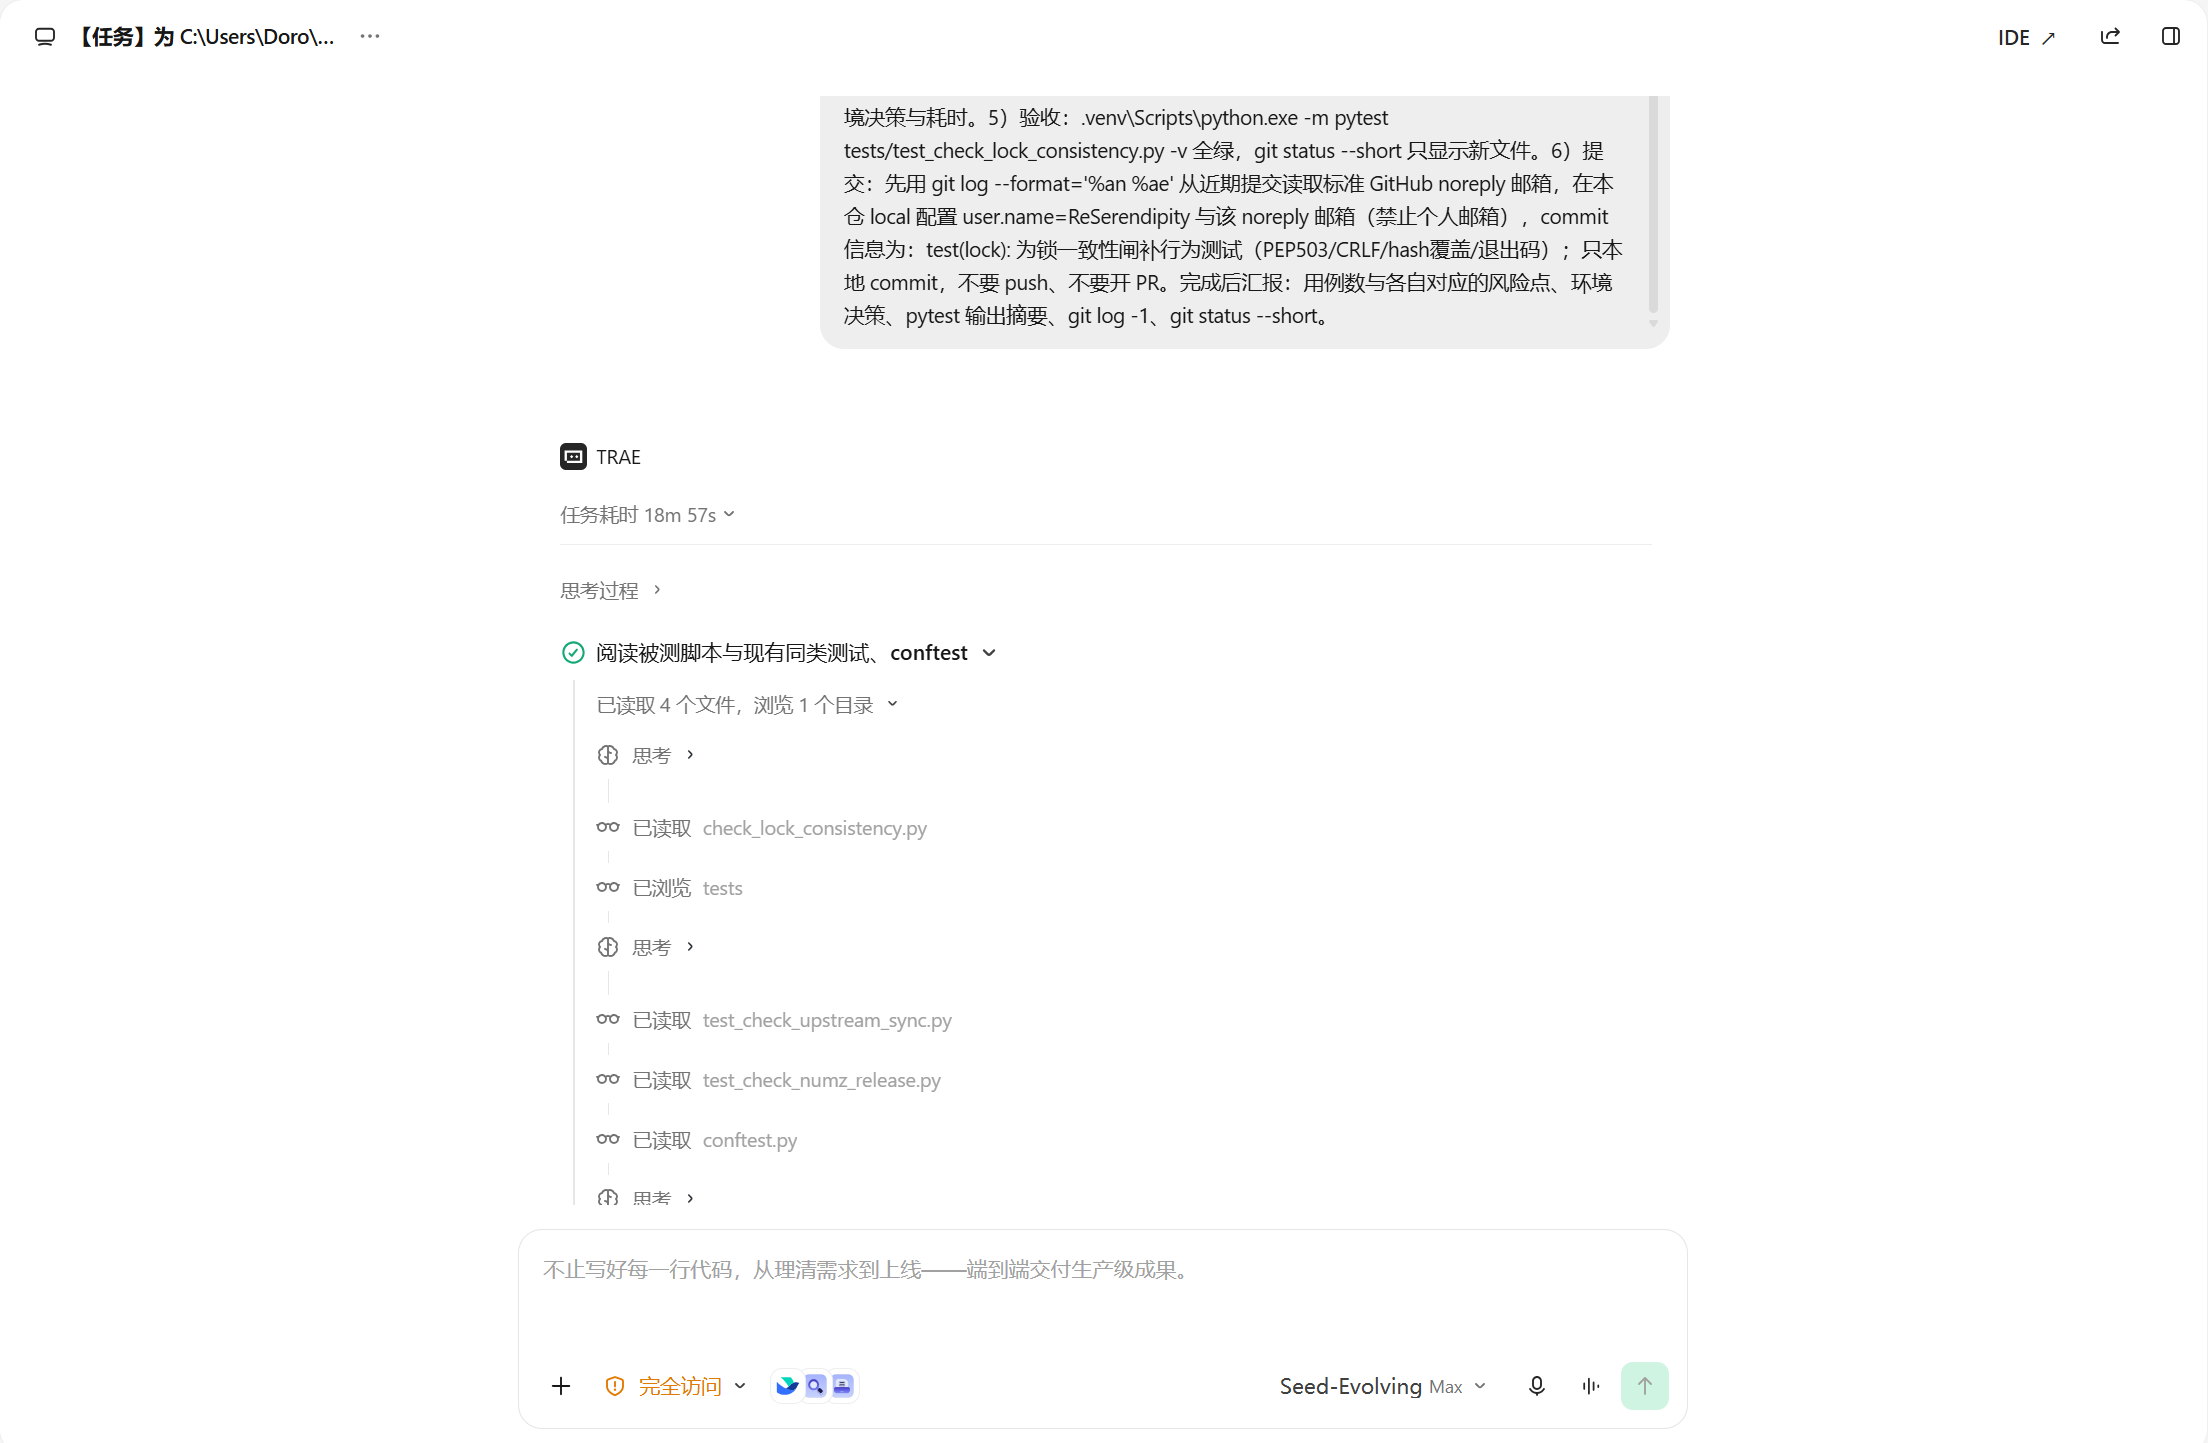
第二阶段是环境方案的真实权衡,这一段最让我意外。 它没有直接 pip install torch(CUDA 版轮子两三个 GB),而是先在仓库外的临时目录用 stub 模块做探测:伪造一个 torch,发现 config 模块立刻能通过;继续探 engines 深链,发现还连着 omegaconf、pipeline mixins 等一串包。逐个目标实测后,它得出了缺包清单(torch/torchvision/numpy/pillow/cv2/einops/omegaconf),然后主动改判方案:stub 堆下去会污染测试可信度,装 CPU 真包才是最小代价。
最终执行:tuna PyPI 装 10 个小轮约 10 秒;阿里云 pytorch-wheels 镜像用 --no-deps 装 torch 2.13.0+cpu(116.3 MB)+ torchvision 0.28.0+cpu(3.9 MB)约 32 秒。环境总耗时约 42 秒,没有改动任何仓库文件(.venv 本来就在 gitignore 里)。装包工具用的是 uv,torch 版本还特意对齐了仓库锁定的 2.13.0,没有随手装最新版。
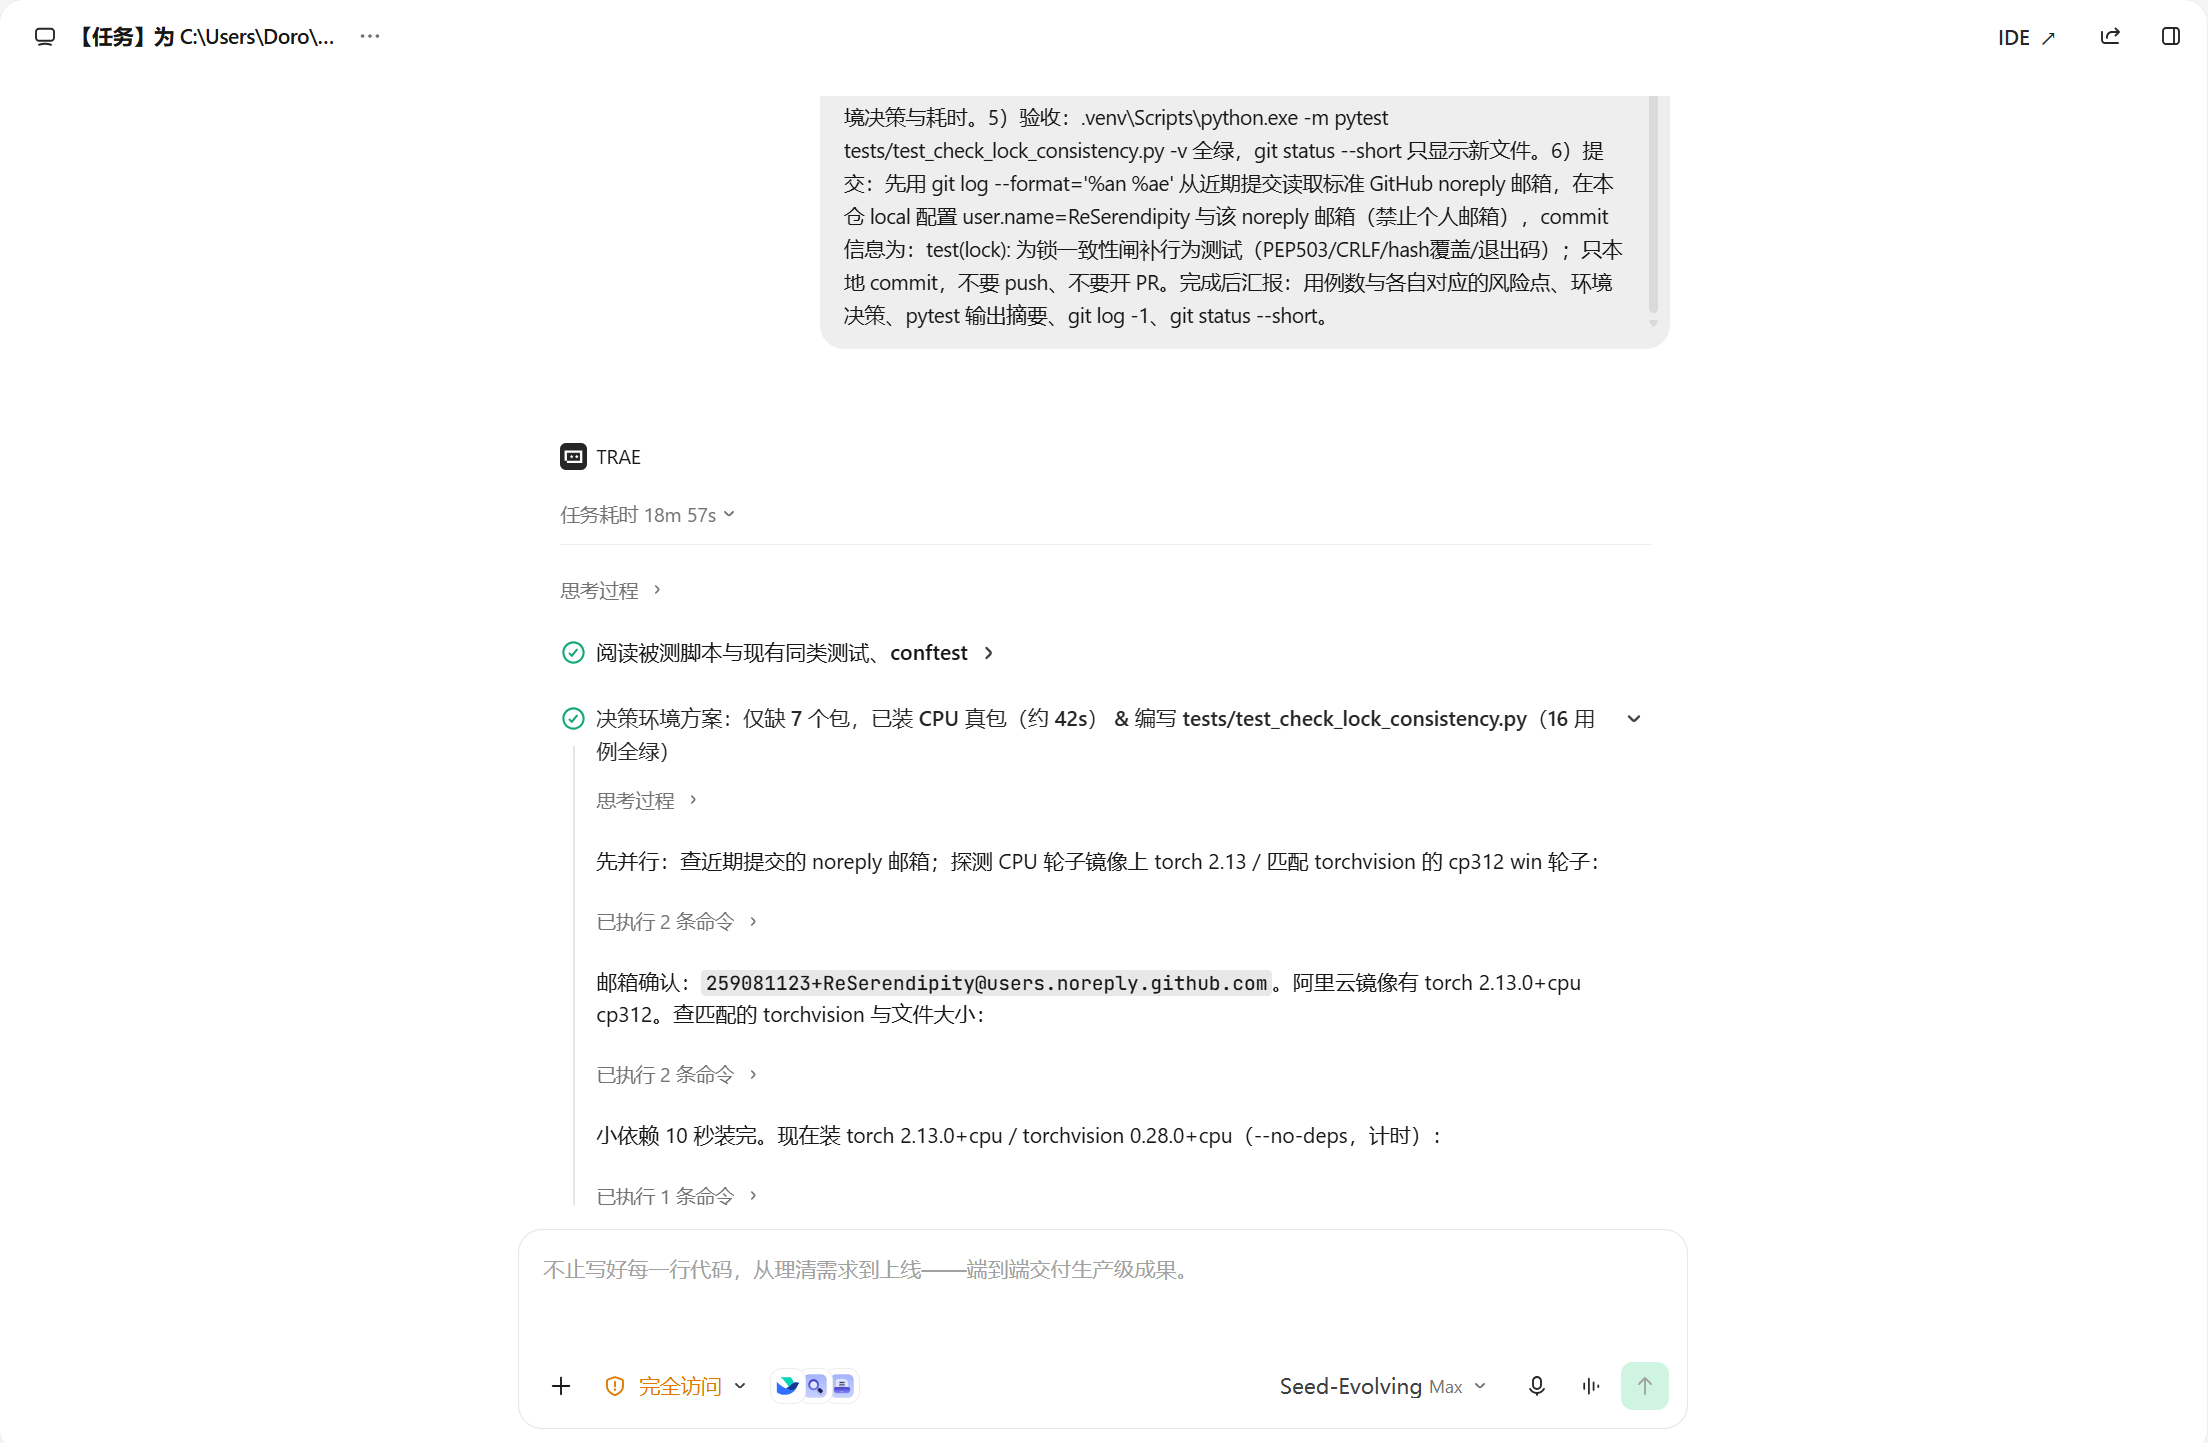
第三阶段写码和自测,这里出了一次真实的小车祸。 它生成了 248 行测试文件后,第一次跑收集就失败——首版里有一处引号笔误。它自己从报错定位、自己修掉,没有问我。这种级别的小错其实正是 AI 生成代码最常见的形态:不是不会,而是手滑;能不能自己抓到并闭环,比"一次写对率"更影响实际使用体验。
2.3 交付物:9 个测试函数、16 个收集项,每条用例都对应一个风险点
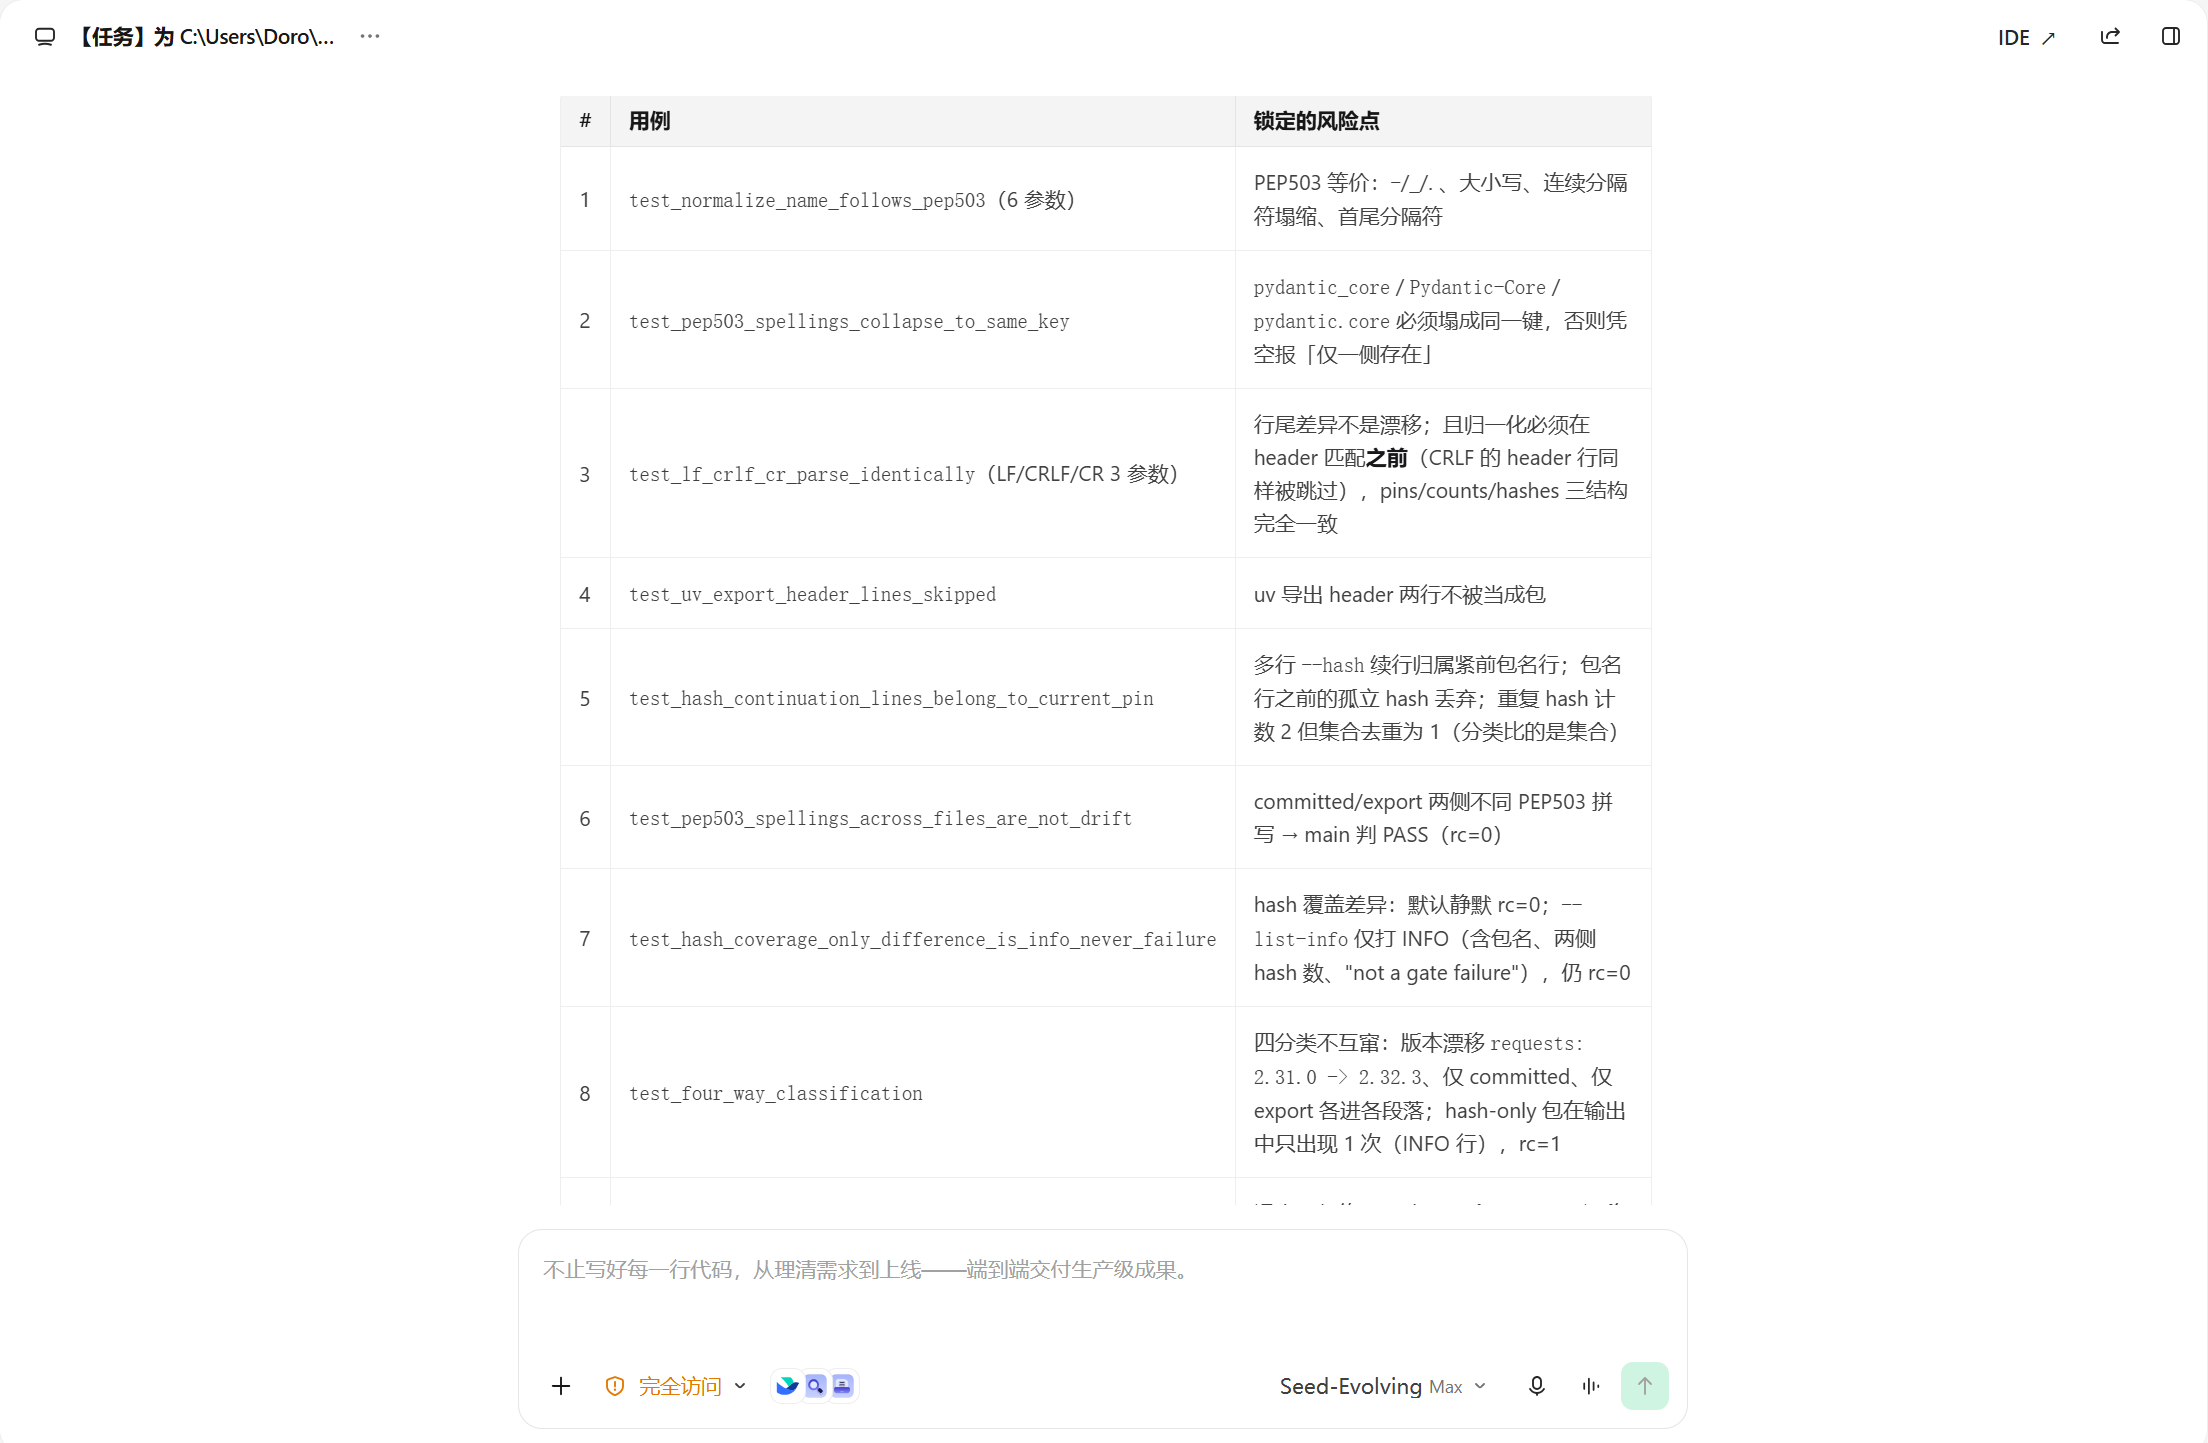
它最终交付的测试文件 248 行,pytest 收集 16 项。汇报里附了一张"用例 ↔ 风险点"对应表,比如:
test_normalize_name_follows_pep503参数化 6 组拼写(连字符/下划线/点/大小写/连续分隔符塌缩/首尾分隔符),外带一个跨文件专项:committed 写Pydantic_Core、export 写pydantic.core,必须判一致;test_lf_crlf_cr_parse_identically三种行尾参数化,而且断言归一化必须发生在 header 匹配之前(CRLF 的 uv 头行同样要被跳过),pins/counts/hashes 三个结构同时比对;test_hash_continuation_lines_belong_to_current_pin放了一个包名行之前的孤立 hash 行,要求必须丢弃;还有重复 hash 计数为 2、集合去重为 1 的区分;test_four_way_classification一个用例里同时造三类差异,并断言 hash 覆盖差异只出现在 INFO 行、在整个输出里只出现一次(不能混进 FAIL 段落);test_main_exit_codes_and_fail_names_drifted_package验证退出码 0/1 契约,并断言 FAIL 输出必须包含click: 8.1.7 -> 8.1.8这种点名信息——CI 日志里没有包名的失败是无法定位的。
跑完结果:16 passed, 1 warning in 0.17s,唯一 warning 是 fastapi/starlette 的 httpx 弃用提示,来自 conftest,与本次改动无关。
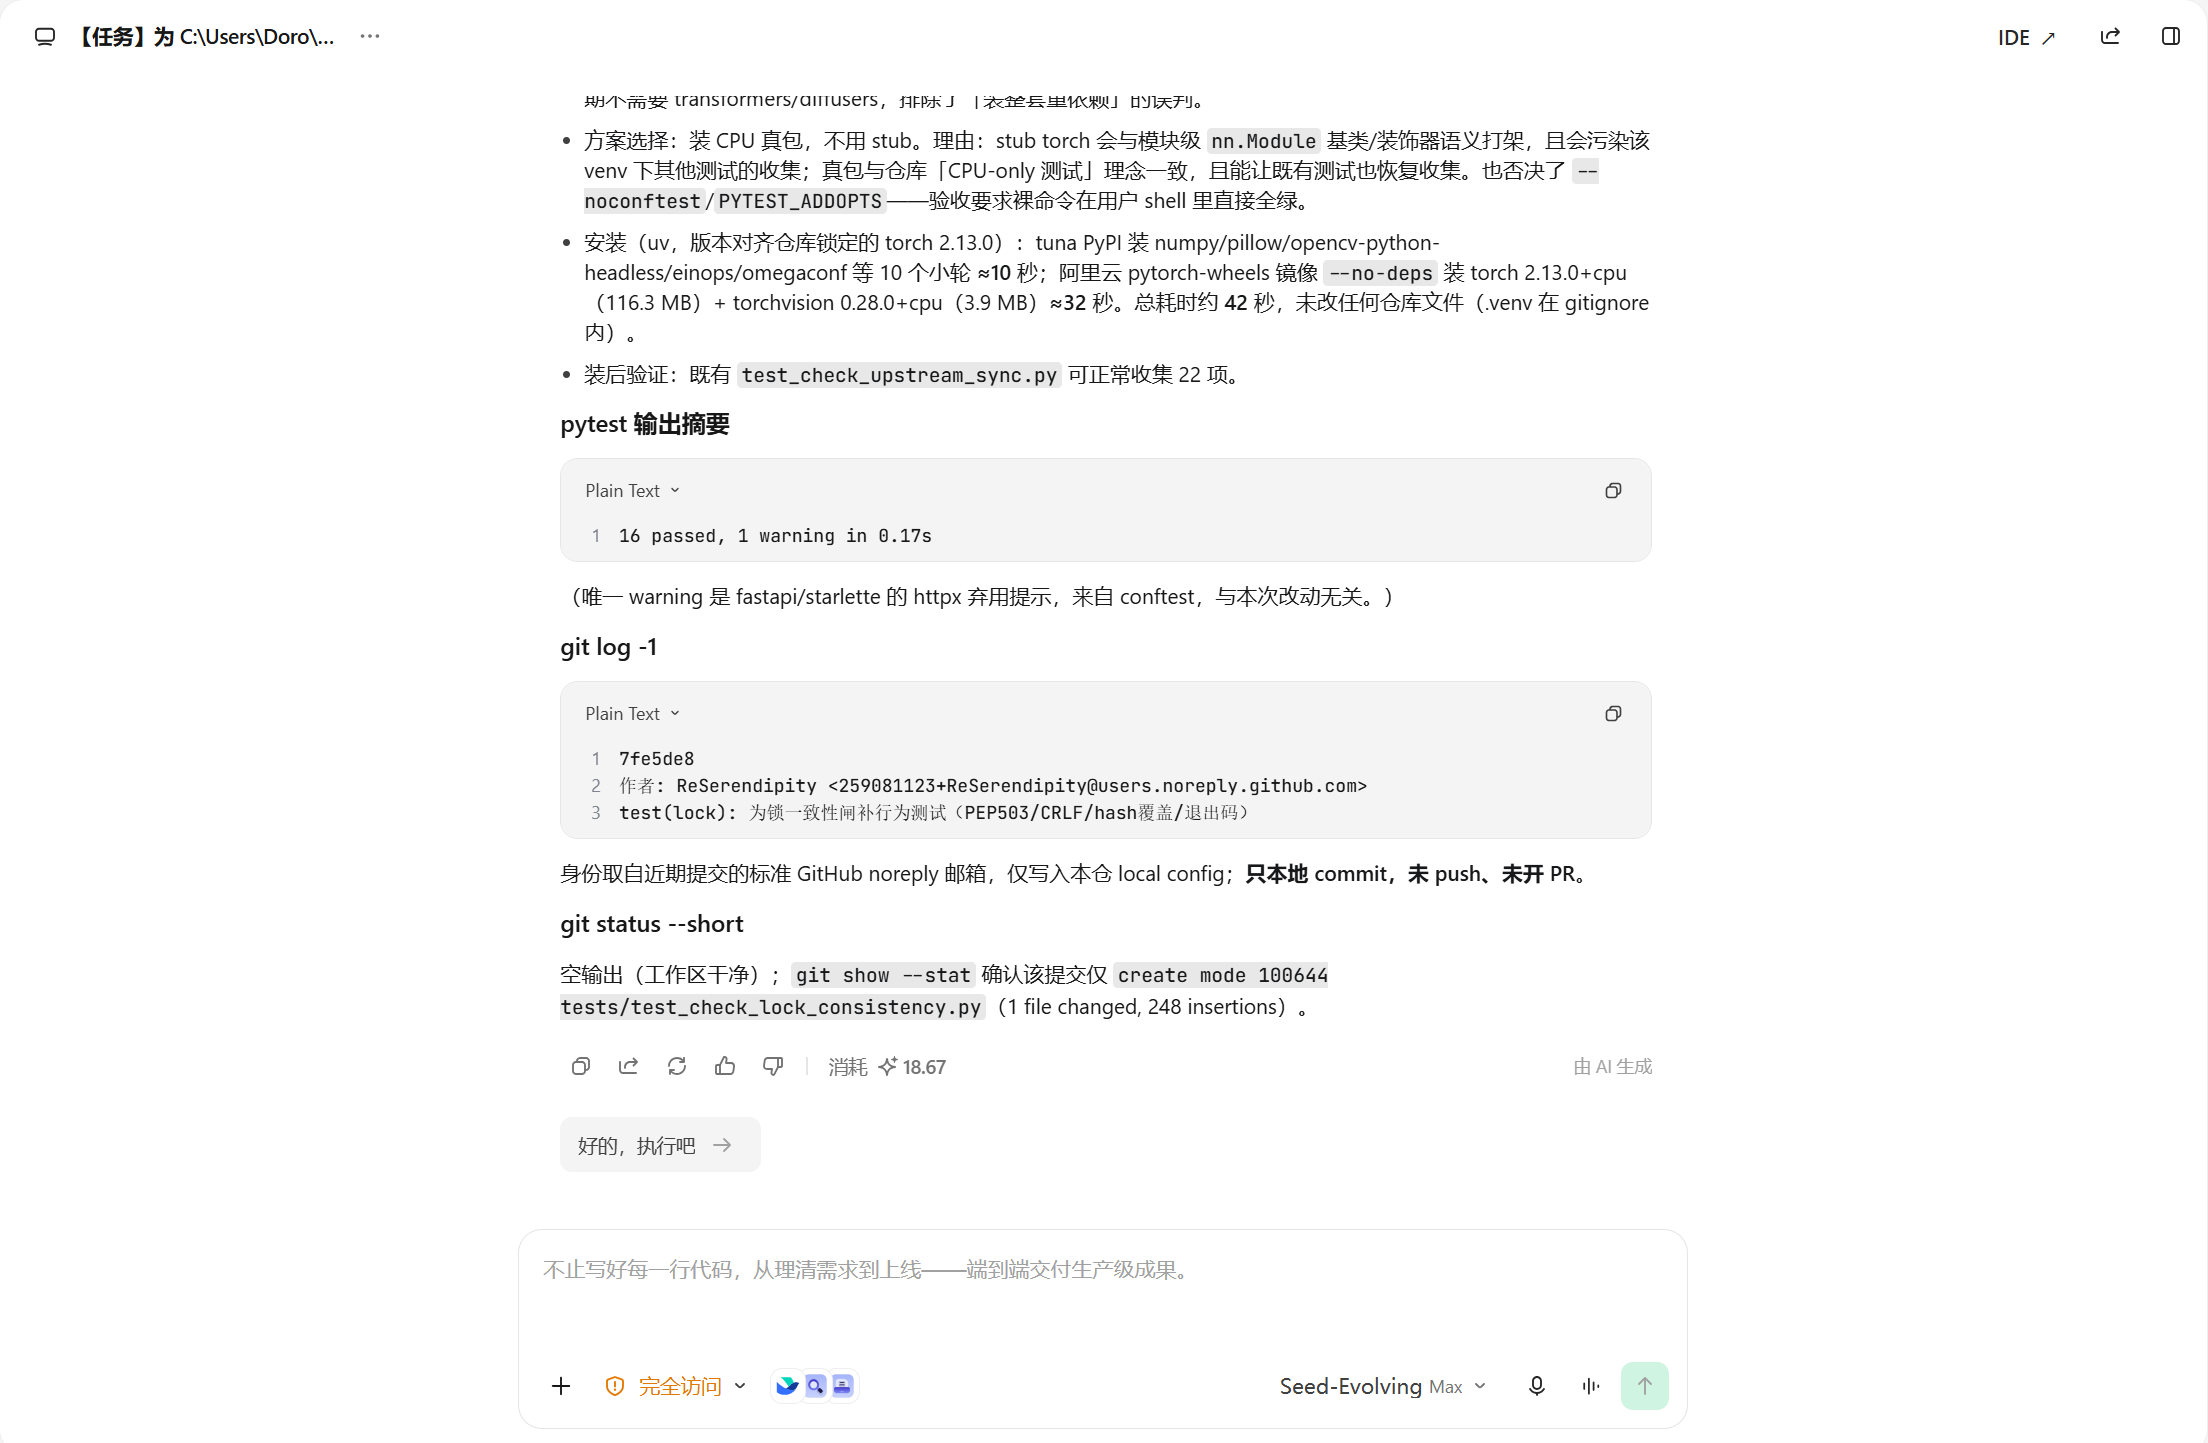
提交也按规矩完成:7fe5de8,作者与提交者都是 ReSerendipity <259081123+ReSerendipity@users.noreply.github.com>(它自己从近期提交里读出来的标准 noreply 邮箱,只写入仓库 local config),commit message 是 test(lock): 为锁一致性闸补行为测试(PEP503/CRLF/hash覆盖/退出码),只本地提交,没有 push,没有开 PR。
2.4 我不信它:B 门独立验收,零打回但不是走过场
Agent 说全绿不等于真的全绿。我在**另一个对话(就是负责发帖工程的这个会话)**做独立复核,全部重新亲自跑一遍:
- 独立重跑新测试:
16 passed in 0.16s(我复跑的数字,不是截图里的数字); - 跑先例测试确认无回归:
test_check_upstream_sync.py22 passed; git show --stat HEAD:只动了 1 个文件,+248/-0;git diff HEAD~1 -- scripts/check_lock_consistency.py tests/conftest.py:空输出,受保护文件零改动;git status --short:工作区干净;- 通读 248 行测试:确认没有 tautology——它断言的是"给定构造输入、应该有什么输出和退出码"的独立规格,不是把源码逻辑重抄一遍;
- 全量收集:main 基线 1791 项,本任务后 1807 项(差值正好 16)。
结论是一次通过、零打回。但我很清楚这不是因为它神,而是因为任务边界收得紧:文件只读访问、改动面只有一个新文件、验收是客观的退出码和断言。同样这个 Agent,让它自由重构一个跨模块功能,我绝不敢这样验收。
三、最终产物
- 代码:本地提交
7fe5de8(+248 行,16 个行为测试),仓库 GitHub - ReSerendipity/SeedVR2-Lite: SeedVR2 视频/图像超分辨率修复工具箱:Tauri 桌面版(一键安装+增量更新)与网页版/便携包,支持 3B/7B/7B-Sharp、FP8、GPU Block Swap 省显存、一键与批量修复、5 种语言界面,无需 ComfyUI | SeedVR2 video & image super-resolution toolkit: Tauri desktop (one-click install + incremental updates) + web/portable, 3B/7B/7B-Sharp & FP8, GPU Block Swap, one-click & batch restore, 5-language UI, no ComfyUI · GitHub ; - 可在线打开的产物:项目 Pages 演示站 SeedVR2-lite · 在线模拟演示 (纯前端仿真版修复工作台,顶部诚实标注"不含模型推理",可以拖图走一遍完整 UI 流程,能看到 3B 模型、FP16 精度、BlockSwap 块数这些真实参数位);
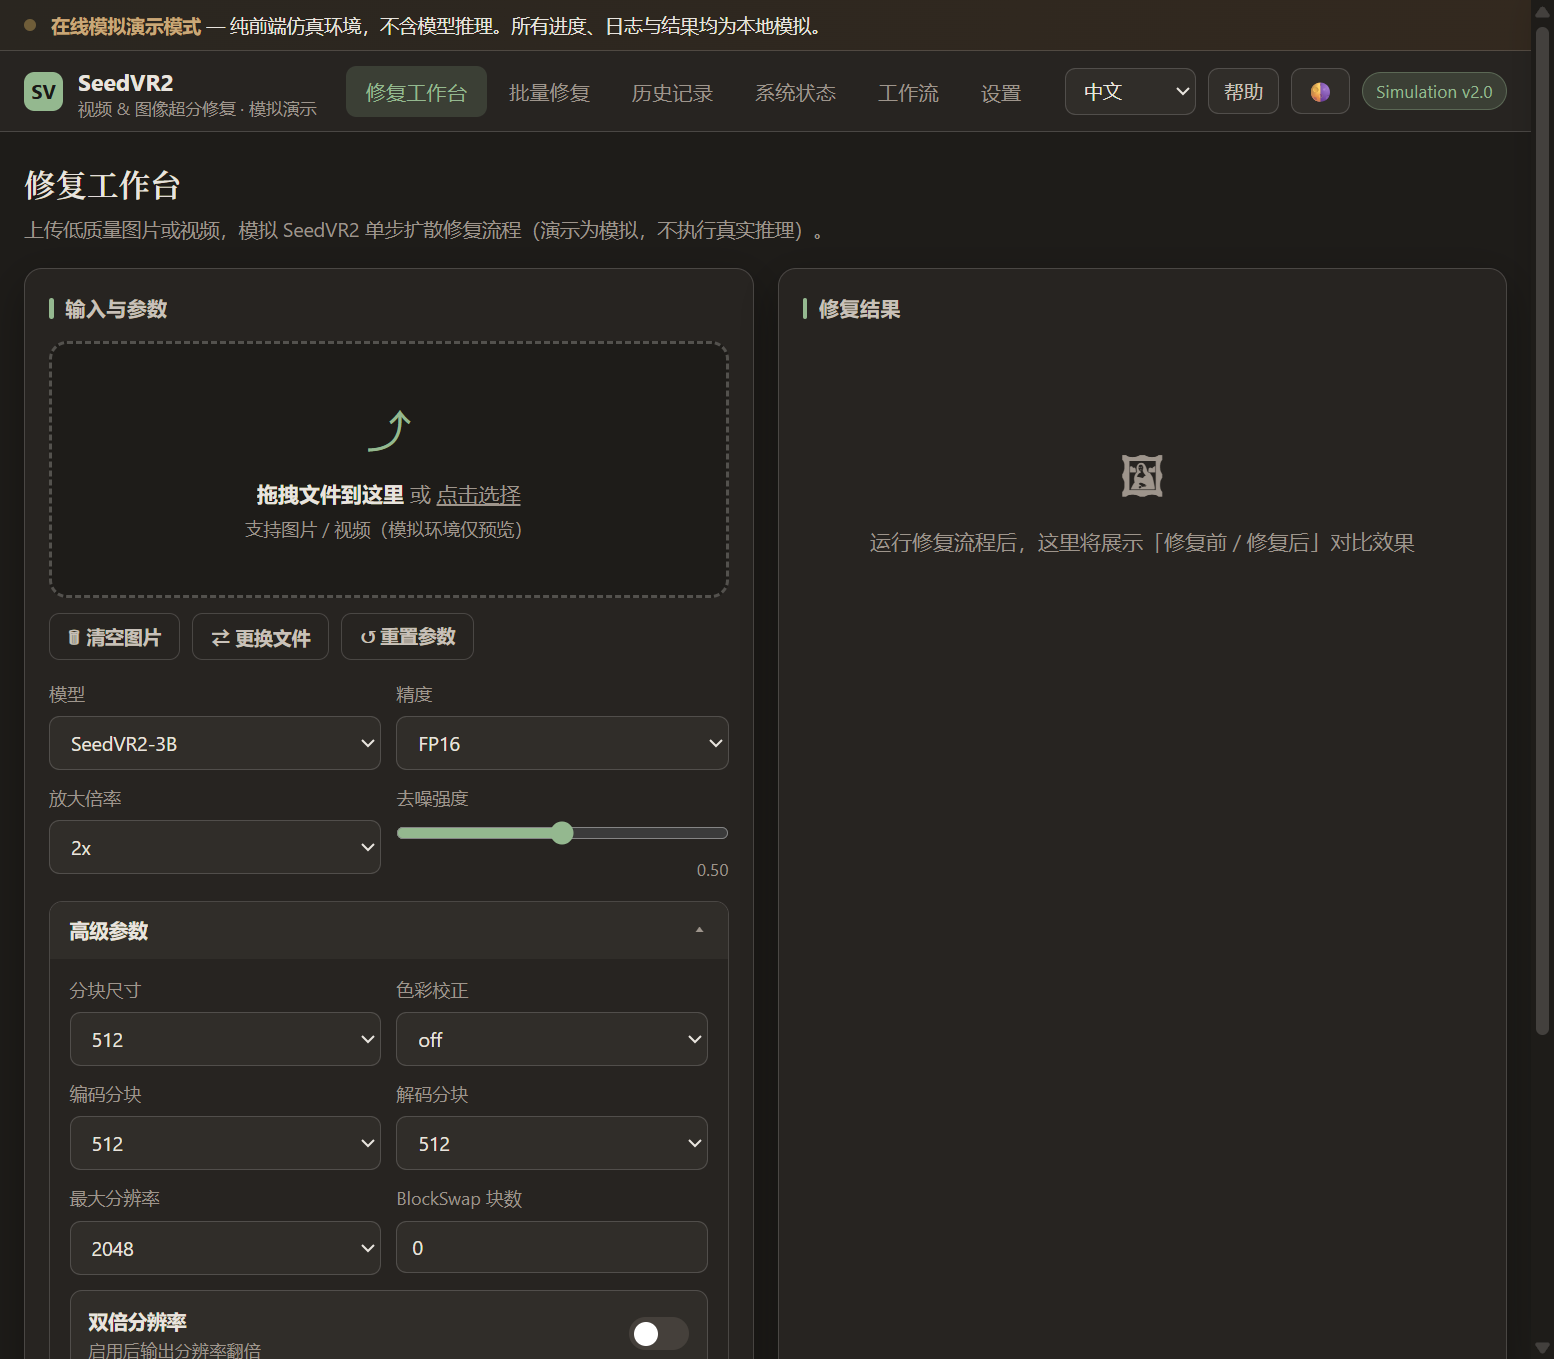
- 版本链可验证:GitHub Releases 从 v1.4.10 到 v1.6.1 共 10 个版本,包括 v1.5.6 免安装便携分卷包(内置便携 Python 与 3B FP8 模型)和 v1.6.1 增量更新;锁一致性闸在 PR #162 合并后已在真实 CI 跑绿;
- 测试体系:本任务后全量 1807 项可收集(Python 3.12,0.89 秒收集完成),新测试 16 项运行耗时 0.16 秒;
- 过程证据:任务指令卡、TRAE 过程截图 7 张(正文嵌入 5 张)、我的 B 门复核记录均已归档。
需要说明的局限:本机没有留存模型权重,这次没有做超分前后效果对比,我不拿旧截图冒充今天的成果——本文的"最终产物"严格限定在工程质量这条线上。
四、真实评价:省时间的、必须人来的、还没解决的
真正省时间的环节:
- 上下文零搬运。它自己读先例对齐了仓库的 importlib 装载惯例、中文 docstring 风格、tmp_path 夹具写法,我没有贴任何代码模板。这是"一个入口"合并后最实在的收益:Agent 模式读项目上下文、写文件、跑终端在同一界面闭环,不用我在聊天窗口和 IDE 之间复制粘贴;
- 环境诊断比我预想得克制。stub 探测→实测缺包→改判 CPU 真包→镜像选择→uv 钉版,整条决策链是工程师的做法,42 秒解决,没有走"装个大 CUDA 版试试"的弯路;
- 提交身份这种细节没踩雷。自己从 git log 取证 noreply 邮箱、只写 local config、不 push,全部符合我指令卡里的合规要求。
必须人来、我不敢交出去的环节:
- 验收标准必须人写。六类风险点是我对着脚本 docstring 和 PR 事故记录列的,AI 能帮你想全,但"什么算对"的裁判权不能下放;
- 不能自我验收。Agent 写的测试由 Agent 自己跑一遍绿,不构成质量结论。B 门复核(独立重跑、读代码防 tautology、核 git 事实)花了我约 20 分钟,和它干活的时间差不多——这个比例我觉得是健康的;
- 改动范围要物理隔离。"不许改源码、只许加文件、有问题停下报告"写进指令后,TRAE 平台侧还显示了文件冻结保护提示,双重保险下它确实没碰任何越界文件。
还没解决的问题(不吹不黑):
- 新任务的"项目归属感"不顺:我这次没绑定项目文件夹(选择文件夹控件在我的远程操控下没点成),Agent 全程靠消息里的绝对路径工作,终端默认目录也和项目脱节。它能完成,但这不该是用户常态。建议新任务在检测到绝对路径时主动询问"是否绑定此文件夹为工作区",或者把"选择文件夹"从可选弱入口提级;
- 19 分钟的过程无法一键导出:思考时间线、命令记录、环境决策散落在折叠面板里,我只能逐屏截图归档。对"留存 AI 协作过程"的合规和复盘需求,建议提供任务报告导出(Markdown,含时间线、命令、文件改动清单);
- 长任务中途无法纠偏:它跑的 19 分钟里我能看到步骤,但除了停止没有"在不打断的前提下插入一句提醒"的机制,关键决策(比如装包方案)即使我想追加约束也只能等它做完;
- 延续项目本身的老痛点:Agent 对多 GB 模型文件的下载没有断点续传编排,这种任务今天依然只能靠人工。
五、给官方的 3 条具体建议
- 把"环境决策"产品化:这次 Agent 自发做的 stub 探测 → 缺包清单 → CPU/CUDA 包抉择很有价值,但藏在思考过程里。建议在后台命令岛里提供"测试环境最小化建议"(检测 conftest 重依赖链、提示 CPU wheel 镜像),把优秀行为变成默认能力;
- 任务报告一键导出:含时间线、执行命令、文件 diff、测试结果的 Markdown/HTML 报告,对测评、复盘、团队交接都是刚需,比截图高效得多;
- 多 Agent/长任务的"中途插话":允许用户在不终止任务的情况下插入约束(如"装包只用 CPU 版"),Agent 在下个安全检查点采纳;并在任务面板上显示它当前正在写的文件和即将执行的命令。
六、写在最后
这次实验让我对"AI 写代码"有一个更具体的看法:Agent 的能力边界,往往等于验收标准的质量边界。一道没有测试的 CI 闸,和一个没有 B 门的 Agent,本质上是同一种风险——你没法确认它是真的对,还是只是看起来对。全新 TRAE 给了一个相当顺手的执行端,但把它关进"明确任务卡 + 最小改动面 + 客观验收 + 独立复核"的笼子里,才是它真正产出生产级结果的原因。
如果你也在让 AI 给项目补测试,欢迎聊聊:你的验收标准是怎么定的?有没有被"全绿但没用"的测试坑过?评论区见。
ReSerendipity/SeedVR2-Lite: SeedVR2 视频/图像超分辨率修复工具箱:Tauri 桌面版(一键安装+增量更新)与网页版/便携包,支持 3B/7B/7B-Sharp、FP8、GPU Block Swap 省显存、一键与批量修复、5 种语言界面,无需 ComfyUI | SeedVR2 video & image super-resolution toolkit: Tauri desktop (one-click install + incremental updates) + web/portable, 3B/7B/7B-Sharp & FP8, GPU Block Swap, one-click & batch restore, 5-language UI, no ComfyUI