【Skill 创作】Knowledge Graph Creator:一句话生成项目知识图谱,代码关系一目了然
1. Skill 简介
名称:Knowledge Graph Creator(知识图谱生成器)
解决的问题:
接手一个新项目时,最痛苦的不是读代码本身,而是理解代码之间的关联关系——哪个 Controller 调了哪个 Service,哪些模块互相依赖,整个架构长什么样。
传统做法要么用手动画架构图(画完项目已经变了),要么翻大量文件脑补关系。这个 Skill 让 AI 自动完成这一切:说一句"帮我创建知识图谱",就能把整个项目的关系可视化出来。
适用人群:
-
新入职/接手新项目的开发者,快速理解项目架构
-
技术负责人做代码评审,一眼看清模块依赖
-
写技术文档时自动生成架构关系图
-
任何想快速理解代码结构的人
效果:自动扫描项目所有文件 → 分析 import/extends 等关系 → 输出交互式 D3.js HTML 图谱,双击就能在浏览器里缩放、搜索、点击查看详情。
2. 使用场景
展示效果:
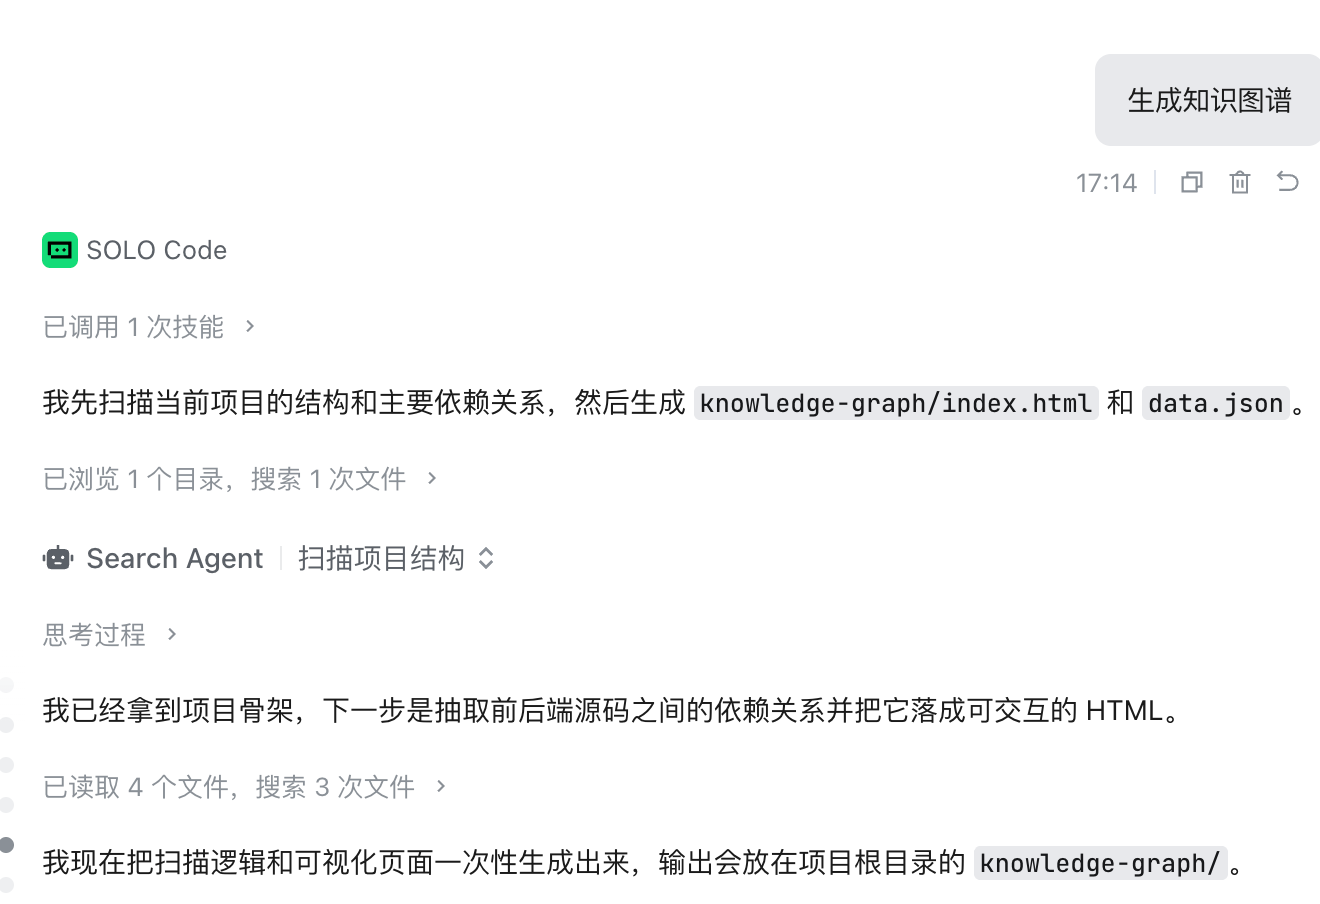
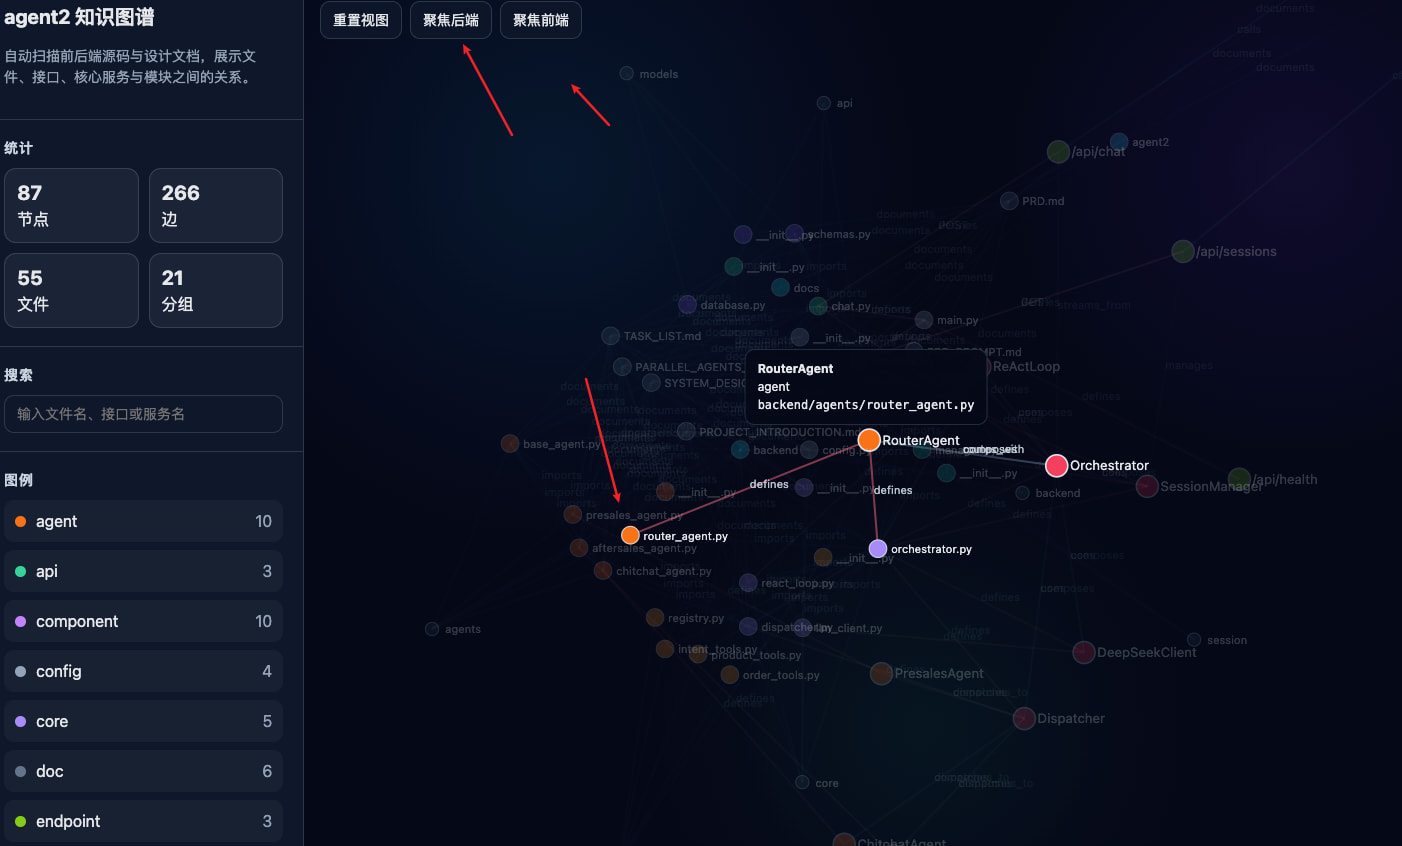
真实场景:
最近接手一个 Spring Boot 项目,十几个模块、几百个文件。想搞清楚 Controller 到底调了哪些 Service、Entity 被哪些地方引用了——直接在 SOLO 里说"帮我创建知识图谱",几秒钟就生成了一张交互式关系图,比翻代码快太多了。
省掉了什么:
-
不用手动梳理每个文件的 import 和依赖
-
不用边翻代码边画思维导图
-
不用等架构文档更新(项目一改图就过时)
3. 创作过程
第一版:确定核心能力
这个 Skill 的核心问题只有一个:AI 能不能替用户完成"扫代码→分析关系→可视化"的全流程?
首先是"扫什么"——我列了一张支持的文件类型清单,从 Python、JavaScript、Java 到 Go、Rust、Markdown 文档,覆盖了后端、前端、配置、文档四类文件。
然后是"怎么分析"——处理思路是分级的:
小项目(< 50 个文件) → 逐文件读取,完整分析

大项目(≥ 50 个文件) → 只用 ripgrep 扫描 import 行,不读全文件
这避免了大项目扫描过久的问题。
第二版:确定输出格式
输出必须是一份自包含的 HTML——用户双击就能在浏览器打开,不需要装任何依赖。
技术选型很明确:D3.js v7 的力导向图(force-directed graph)。它不是静态图片,而是一张可以缩放、拖拽、搜索、点击的交互图。
第三版:确定交互功能
列出了 10 项交互功能,按重要性排序:
-
力导向布局(节点自动排布,同类聚集)
-
缩放拖拽
-
节点拖拽固定
-
邻居高亮(最重要——悬停一个节点,只看它的关联关系)
-
搜索定位
-
详情信息面板
-
图例
-
边关系标签
-
侧边栏节点列表
-
统计信息
第四版:确定色彩系统
16 种节点分组各有独立颜色,形成视觉映射:
controller → 青色 #22d3ee

service → 翠绿 #34d399

entity → 紫色 #a78bfa

config → 琥珀 #fbbf24

util/helper → 粉红 #fb7185

...(共 16 种)
暗色主题,背景 #1a1b26,符合开发者审美。
创作中的关键决策
为什么用 D3.js 而不是 ECharts 或其他库?
D3.js 的力导向图在节点交互上更灵活——拖拽、邻居高亮、动态更新这些功能实现起来更自然。而且 D3.js 的 force simulation 引擎在节点布局质量上是最成熟的。
为什么 SKILL.md 里不写死 HTML 模板内容?
因为每个项目的图谱都不同——节点数、分组、关系类型都不一样。所以 SKILL.md 给出的是完整的生成流程和规范,让 AI 根据实际扫描结果动态生成 HTML。这样同一个 Skill 在不同项目上都能用。
为什么文件分析策略要有分级?
一开始对所有项目都逐文件读取,在一个有 200+ 文件的 Go 项目上跑了 3 分钟才出来。后来改成小文件逐读、大文件只读 import 行,速度提升了几十倍。
4. 使用步骤
安装:
-
下载 SKILL.md:https://github.com/mrg123/knowledge-graph-creator
-
TRAE 中导入:设置 → 规则与技能 → 技能 → 创建 → 导入文件
触发方式:在 TRAE SOLO 中直接用自然语言提问:
“帮我创建这个项目的知识图谱”
“分析架构关系,输出 HTML 图”
“看看 Controller 和 Service 之间怎么关联的”
AI 会自动执行:
- 扫描项目文件树 → 2. 分析 import/extends 关系 → 3. 生成知识图谱目录 → 4. 打开浏览器预览
5. 效果展示
(以下为实际生成的知识图谱截图)
生成的文件结构:
my-project/

├── knowledge-graph/

│ ├── index.html ← 双击就能打开

│ └── data.json ← 原始图数据,可复查
图谱包含的交互功能:
| 功能 | 说明 |
|------|------|
| 力导向布局 | 节点像物理弹簧一样自动排布 |
| 邻居高亮 | 鼠标悬停一个节点,只看它的关联关系 |
| 搜索定位 | 输入模块名,自动居中 |
| 详情面板 | 点击节点,显示路径、类型、描述 |
| 图例 | 按颜色分组,一眼看出模块分类 |
| 缩放拖拽 | 滚轮缩放,空白区拖拽 |
运行效果示例(描述):
-
一个 Spring Boot 项目:Controller(青色)指向 Service(翠绿),Service 指向 Entity(紫色)和 Repository(橙色),Config(琥珀)被多处引用
-
一个前端项目:Component(粉紫)互相组合,Page(玫瑰)引用 Component,Store(黄色)被 Pages 引用
-
一个 Python 项目:模块间通过 import 形成网状结构,utils(粉红)被大量引用
6. Skill 链接
GitHub 仓库(开源,MIT 许可):
下载后按上述安装步骤导入 TRAE 即可使用。
7. 总结与思考
最满意的地方:
-
一次扫描,处处可用——Skill 不在文件里写死图谱数据,而是给出完整的生成流程和规范,AI 根据每个项目动态生成
-
交互式输出——不是静态图片,而是可以搜索、点击、拖拽的网页
-
自动跳过噪声——隐藏目录、node_modules、build 目录自动排除,只关注你真正关心的项目代码
后续优化方向:
-
支持更丰富的边类型(HTTP 路由映射、消息队列订阅关系)
-
支持增量更新(项目改了只重新分析变化的部分)
-
支持导出为 PNG/SVG 图片
希望得到的建议:
-
还应该支持哪些类型的文件/语言?
-
节点太多时,有没有更好的聚合/分层策略?
-
你觉得"知识图谱"这个场景在 TRAE 中还有哪些应用方式?
有时候最基础的洞察反而是最容易被忽略的:代码之间的关系和代码本身一样重要。一个能把关系可视化的 Skill,也许比一段高效的代码更有价值。