请明确注意,它虽然混在开源排名中,这是一个自定义协议的模型,不允许评测研究之外用途,因此将它作为本地生成商业图片标准值得商榷
除 GPT 外,其它被测模型基于 int8 量化版
ComfyUI - 0.37.0
5090显卡
python 3.13 cuda 13.3
QwenImage-2512
首先是前辈Qwen-Image-2512,
长期、事实上的开源一哥,20B的偏大模型,int8量化。开启了全量50步效果,运行时间1:30
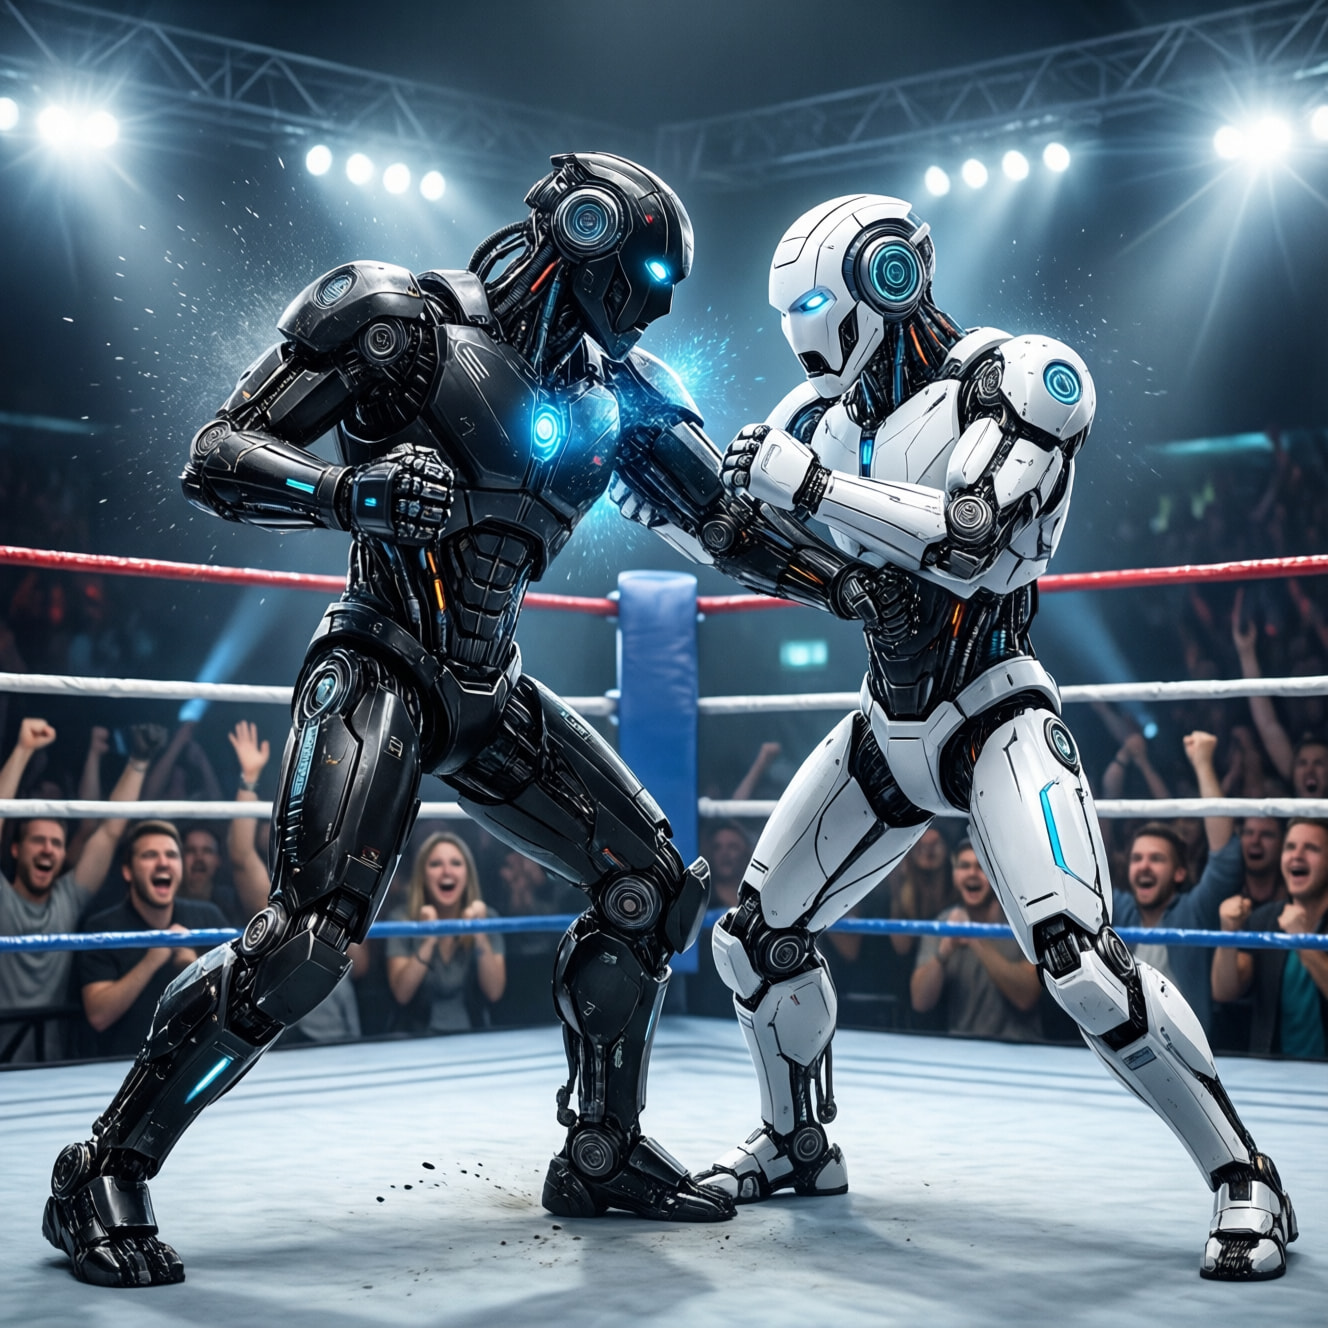
QwenImage-2512 + 4步法
它被相当多的免费生图网站使用,但是通常会开启4步lora以节约资源,
开启后时间降低到了【0:04】只有4秒,但这会影响质量,仅在能用的及格线
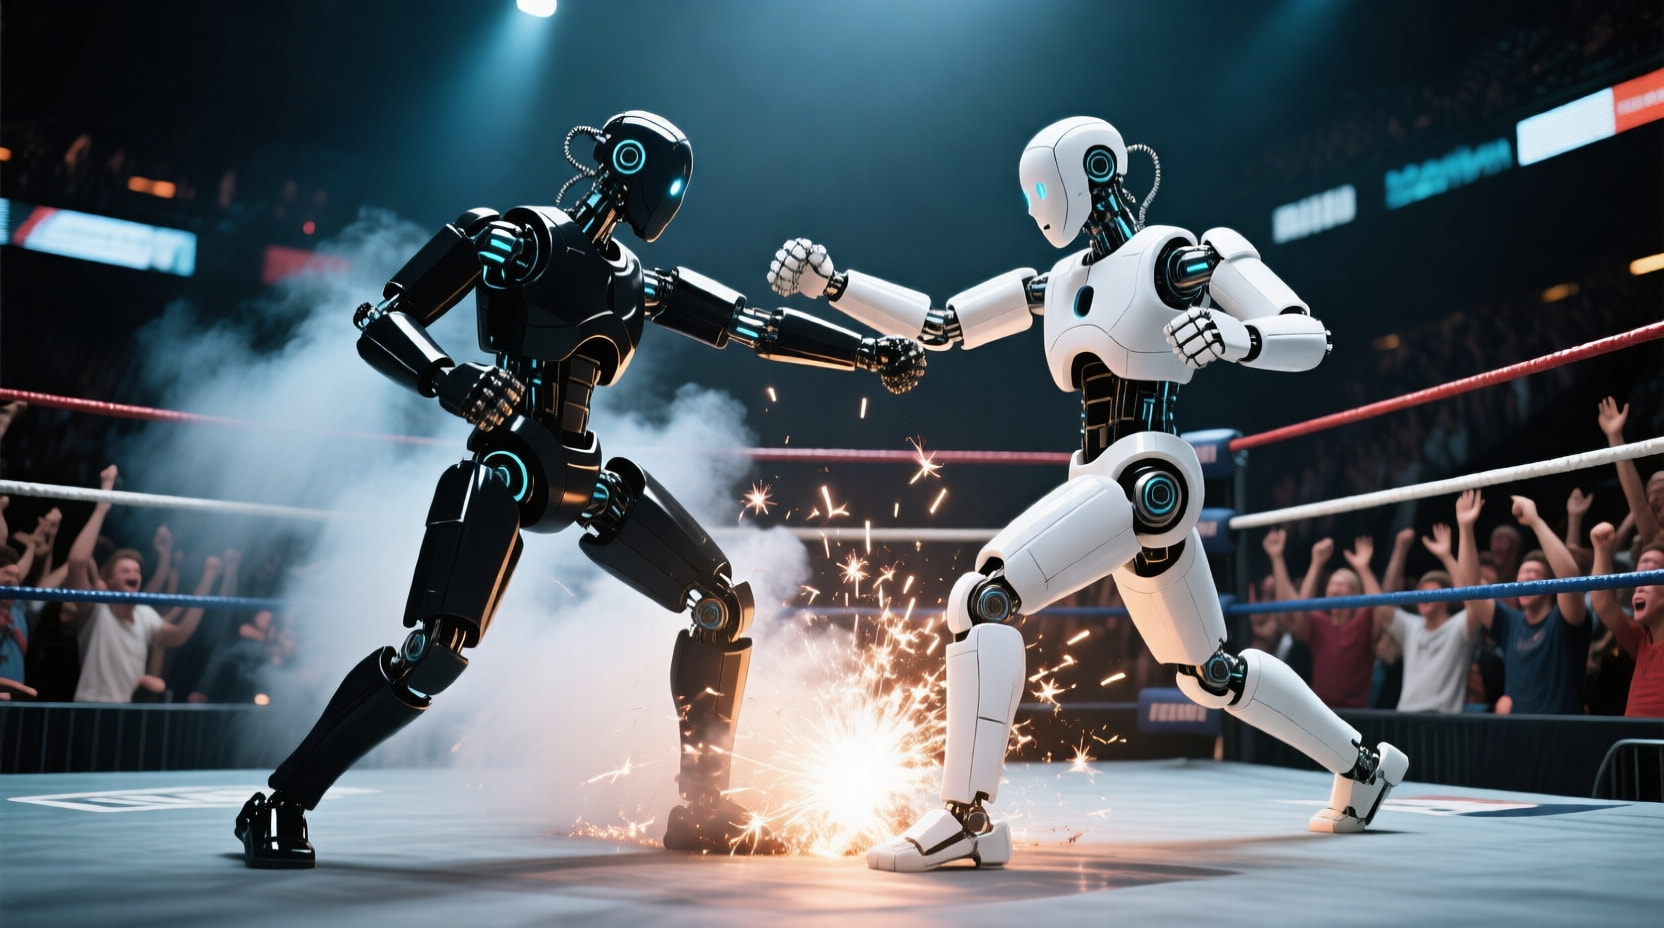
QwenImage-v2.1
本次挑战选手QwenImage-v2.1是仅有7B的中量级选手(在生图领域谈轻量需要3B以下)
官方推荐25~40步,不含加速lora
生图时间实测在9~15秒之间。
效果如下
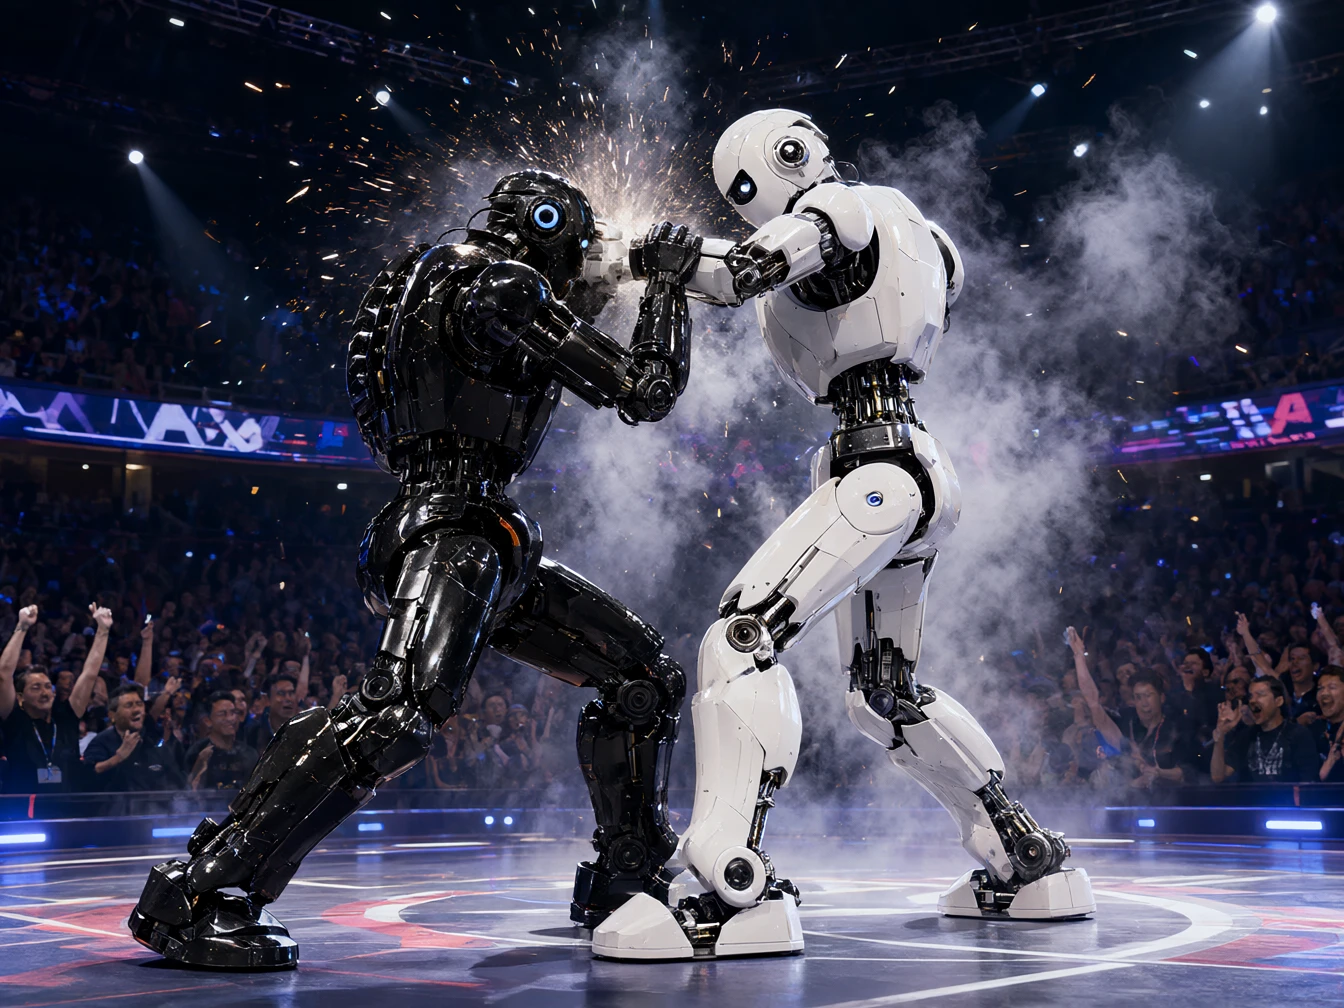
GPT-Image-2.0
下面是提到生图不得不谈,长期蝉联卫冕冠军 GPT-Image-2.0
王者身份实至名归,
通过第三方中转测试,生成时间(2分钟,非high模式)认为无实际参考意义
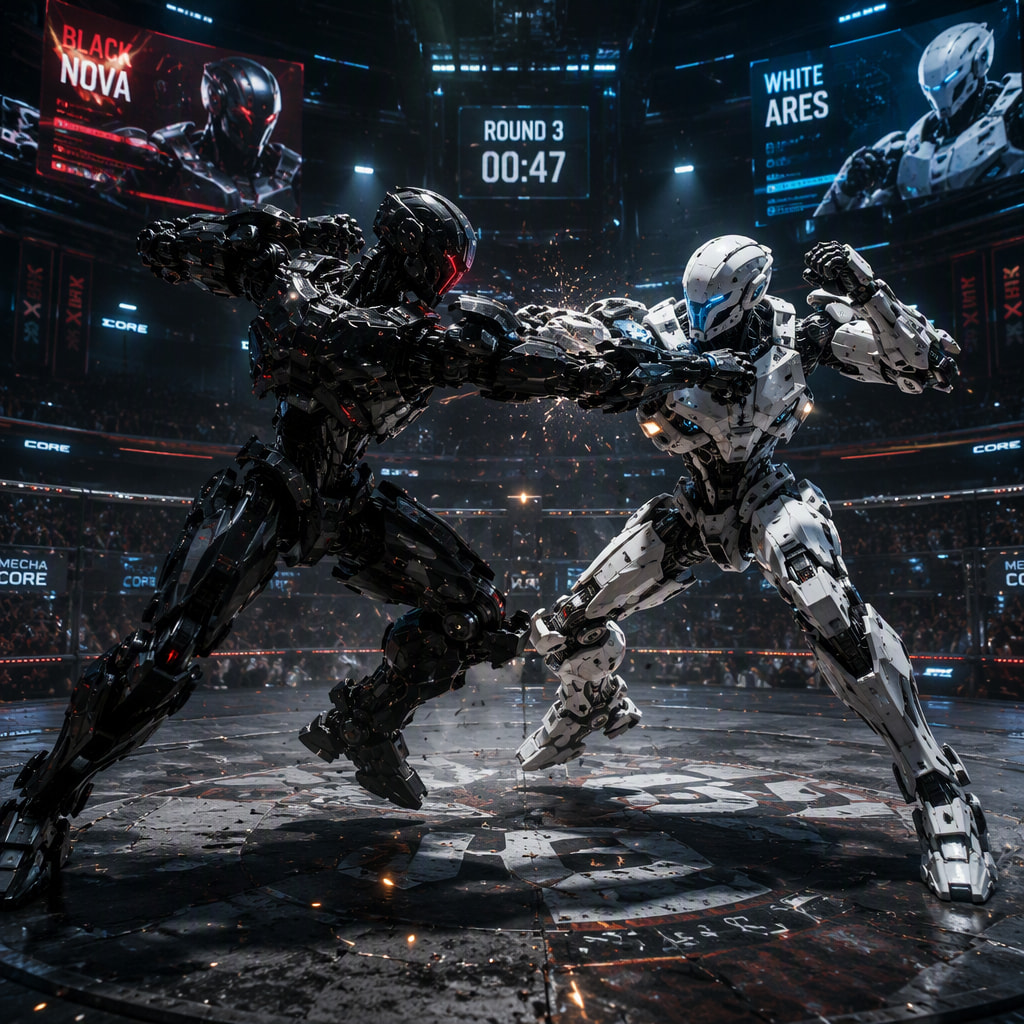
存在其它不可忽视的优势
显存优势
它的模型体积7B,编码器体积8B
这表示4bit量化下,8GB显存的非专业家用机【挤一挤能用】
它的显存甜点有2个,16GB设备跑8bit量化的做法是官方推荐的
而24GB设备(实际只需要19GB)能确保视觉模型(vl)和扩散模型都常驻显存而明显提升生图效率
继续显存提升意义有限
透明背景
QwenImage-v2.1的支持透明背景 / 支持【半透明】是杀手级的优势
上例公平起见,仅在对比同提示词文生图,没有专门强调半透明特性。
中文能力
在生图之外,它的中文编码能力能对GPT系列造成反超,不易出现文本模糊的糟糕情况
以官方数据,基于新版的 Qwen-vl 编码器,可达到 92% 的精确程度,历史最高。
结论
QwenImage-v2.1的模型,以7B的体量相当厉害
有这个实力超过它的前辈,在长时间内成为实际意义上的开源老大哥
客观来说,结合个人判断以及第三方实测数据,
对主商用模型打不过,对GPT-Image-2.0(而非2.5)有代差,
需要接受这一点,满血QwenImage-3.0-pro也打不过GTP-Image-2.0。
高质量场合仍然需要强力的商用模型撑场面。