关于「临时上传代码库文件计算嵌入向量」的反驳
对 TRAE 官方说明的技术质证 —— 基于客户端本体的实测证据
审计对象:TraeCode CN 3.3.102(TRAE IDE)· TraeWork CN 0.1.67(原 TRAE SOLO)
环境:Windows / 单一实机 · 方法:数据目录取证 + 二进制静态分析 + 运行日志行为追踪(全程只读)
成文时间:2026-09-21
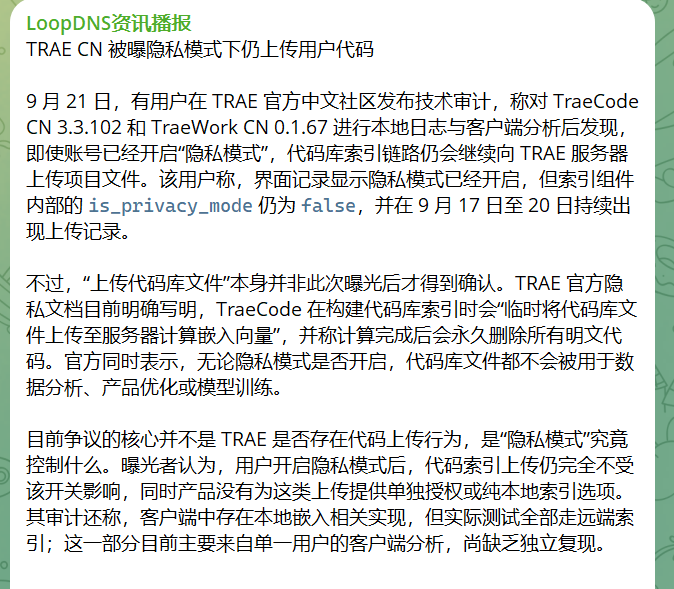
官方就"代码库索引是否需要上传"给出的说法,原文如下。本说明的每一处反驳,都只使用客户端本机可复现的证据, 不使用任何推测、不使用任何第三方转述,并明确区分"已证实"与"无法证实"。
TRAE 官方说明(被质证对象)
「为了实现代码库索引功能,当你将某个目录作为项目在 TRAE 中打开时,TRAE Work(原 TRAE SOLO)和 TRAE IDE 确实会临时将代码库文件上传至服务器计算嵌入向量。计算完成后所有明文代码将被永久删除。」
「无论隐私模式是否开启,TraeCode 绝不会将你的代码库文件用于数据分析、产品优化或模型训练……代码库文件将始终保存在你的本地设备上。」
结论:这段话里只有"会上传"是真的;"为了实现代码库索引功能"是目的倒置,"永久删除"客户端无从验证。
官方把整件事框定为「因为要索引,所以必须上传」。但在这套软件的本地二进制里,"索引"被明确实现成了两条并列的分支: 一条全本地、一条全远端。走哪条,由服务器下发的一个配置项决定—— 实测结果是 100% 走远端,本地分支一次都没有执行过。
这不是"做不到本地",而是"被配置成不做本地"。把这种策略选择表述成技术必然, 是本说明要反驳的核心。
〇、先把"能验证 / 不能验证"的边界划清楚
公开讨论这类问题最容易失焦,所以先把三句话拆开,逐句给出可验证性和实测结论。
| 官方表述 | 可验证性 | 本机实测结论 |
|---|---|---|
| ①「为了实现代码库索引功能……会临时将代码库文件上传」 | 客户端可验证 | 因果关系不成立。本地嵌入分支在二进制里完整存在、客户端启动参数默认点名的就是本地嵌入( local_embedding:true),但本机实测该分支执行 0 次,远端分支 288 次(Trae CN 73 + TraeWork 215)。详见第一节。 |
| ②「临时将代码库文件上传」 | 客户端可验证 | 成立——但"临时"的代价被严重轻描淡写。实测单次索引中,上传耗时占整个初始化耗时的 91%~98.6%;55 个文件的一次索引,光上传就跑了 3026 秒(约 50 分钟)。详见第三节。 |
| ③「计算完成后所有明文代码将被永久删除」 | 客户端不可验证 | 这是纯服务端行为,客户端日志、缓存、协议里没有任何与此相关的痕迹可查。 作为一句承诺可以存在,但不能作为技术事实被引用,更不能用来消解前两句的问题。 |
| ④「无论隐私模式是否开启,绝不会……用于分析/训练」 | 部分可验证 | 服务端用途无法验证;但可以验证的是隐私开关并没有生效在索引链路上—— 服务端把 appPrivacyMode 置为 on 之后,CKG 自己维护的 is_privacy_mode 至今仍为 false,上传在"开启隐私模式"之后照常继续。详见第四节。 |
本说明的举证原则:凡标注"实测"的结论,均给出来源文件与原始行;凡属推断的,明确标注"推断"; 凡客户端无法验证的(服务端行为),一律标注"不可验证",不写成结论。
一、反驳点一:上传不是索引的必要条件,是服务端把它选成了默认路径
这是整份反驳里最硬的一条,因为它不依赖任何主观判断——双分支的代码定义、客户端的启动参数、日志里的执行计数, 三者互相独立、指向同一结论。
1.1 二进制内部:索引被实现成了两条并列的分支
在 CKG 内核 libckg.dll(39,761,808 字节)中,内嵌了一段可完整解析的流水线定义(JSON 原文, 偏移 0x1490adb)。起点是 operation_router → file_counter, 然后进入一个叫 local_remote_embedding_selector(“本地/远端嵌入选择器”)的节点。 这个节点显式配置了两条互斥分支:
{
 "id": "default-remote-dsl",
 "nodes": {
  "local_remote_embedding_selector:0": {
   "type": "local_remote_embedding_selector",
   "configurations": {
    "local_branch":  "collect_files:1",                       // ← 全本地分支
    "remote_branch": "collect_files_and_remote_embedding:0",  // ← 全远端分支
    "in_edge": "file_counter"
   },
   "successors": {
    "to_local":  "collect_files:1",
    "to_remote": "collect_files_and_remote_embedding:0"
   }
  }
 }
}
两条分支各自的后续,是完全独立的:
operation_router→file_counter→local_remote_embedding_selector
to_local→collect_files→local_chunk_and_embedding→idle本机执行 0 次
to_remote→collect_files_and_remote_embedding→上传至服务器→idle本机执行 100%
本地分支的完整定义(同一 JSON):local_chunk_and_embedding 的 type=local_chunk_and_embedding、embedding_model=codekg_bge_m3、 split_method=v3、next_step=idle。 它是一条走到 idle 正常结束的完整流水线,途中没有任何网络节点——不是残留代码,是与远端分支等价的一等公民。
1.2 客户端生产代码:默认要求的就是本地嵌入,不是上传
更关键的是,发起索引的一方(桌面客户端)主动要求的是本地嵌入。 在 resources\app\out\main.js(偏移约 1,257,653)中,客户端构造给 CKG 的配置对象是:
const b = {
    port: String(e.defaultCkgFreePort),
    version_code: 2,
    storage_path: r,
    local_embedding: !0,                    // ← true,明确要求本地嵌入
    embedding_storage_type: "sqlite_vec",   // ← 本地向量库类型
    app_id: "6eefa01c-1036-4c7e-9ca5-d891f63bfcd8",
    limit_cpu: 1,
    source_product: "native_ide"
};
if (this.F.isRemote) { /* 拼成命令行参数 */ }
else { p.CKG_CONFIG_JSON = JSON.stringify(b); }   // ← 桌面本地模式走这里
同目录 modules\ckg\start.bat 里的正式启动命令,同样带 -local_embedding -embedding_storage_type=sqlite_vec。 也就是说:客户端说的是"给我在本地算",而实际发生的是"全部送到服务器算"。 这两者之间的矛盾,需要一个解释——而官方说明没有提供。
1.3 运行日志:本地分支签名全部为 0,远端分支 288 次
把两个应用的全部 codekg.log.* 逐条统计,得到的是一个非常干净的 0 : N 对照:
| 日志签名 | 归属分支 | Trae CN | TraeWork |
|---|---|---|---|
[CollectFilesStep] |
本地 | 0 | 0 |
[LocalChunkAndEmbeddingStep] |
本地 | 0 | 0 |
ckg_local_index_step |
本地 | 0 | 0 |
to_local_index |
本地 | 0 | 0 |
BatchLocalIndexEmbeddingTask |
本地 | 0 | 0 |
no_local_embedding_storage |
本地 | 0 | 0 |
[CollectFilesAndRemoteEmbeddingStep] |
远端 | 73 | 215 |
[DocumentUpdateStep] |
远端 | 56 | 1200 |
uploadKnowledgebaseFiles(上传文件实体) |
远端 | 408 | 33,285 |
1.4 裁决依据:一个服务器下发的"空名单"
那么选择器凭什么决定走哪条?答案写在它自己的日志格式里(libckg.dll 偏移 0x1474aef):
[LocalRemoteEmbeddingSelector] git uri: %s, iLRWL: %v, iAWL: %v
                                    ↑ inLargeRepoWhiteList        ↑ inAnyWhiteList
而它对照的两个名单,来自服务器下发的 GetCKGRAGConfig 回显(两个应用完全一致):
| 服务端配置项 | 下发值 | 含义 |
|---|---|---|
RAGRepoWhiteList |
(空列表) | 允许走本地索引的仓库白名单 —— 空的 |
RAGRepoNotOnlyWhiteList |
true | "不只白名单内的仓库"也参与 —— 与空名单叠加,使白名单彻底失效 |
RAGRemoteIndexThreshold |
-1 | 远端索引阈值被设为 -1(不设下限) |
RemoteNonGitFileCountLimit |
3000 | 非 Git 仓库单次采集上限(实测多次恰好卡在 3000) |
UploadFileIDsBatchSize |
1000 | 哈希清单批大小 |
UploadKnowledgebaseFilesBatchSize |
5 | 文件实体批大小 |
于是本机的真值分布是这样的——没有任何一次例外:
Trae CN    iLRWL: false × 25     iAWL: false × 12
TraeWork   iLRWL: false × 68     iAWL: false × 34
                          ↑ 100% 为 false
一个小结:这条链路本可以在本地跑完,是服务器下发的一个空名单把它推到了云端。
官方说「为了实现代码库索引功能……会上传」。但代码本身证明的是: 索引功能不需要上传——上传是选择器的另一个分支。 真实的关系是「上传是这条链路被配置成的默认路径,索引是它的产物」, 而不是「因为要索引,所以必须上传」。这个因果方向被颠倒了。
1.5 一个必须一并提出的疑点:客户端要本地模型,包里却没有本地模型
为了不把话说满,这里也要如实说明一个不利事实:本机不存在任何 CKG 嵌入模型文件。 modules\ckg\ 全目录只有 libckg.dll(39.76 MB)和三个 gcc 运行库, 合计约 42.4 MB;全盘搜索 *.onnx / *.gguf / *.ggml / *.safetensors 零命中 (仅有 VSCode 自带的语言检测小模型、对话分词器、RTC 资源包,均已逐项排除,与 CKG 无关)。 一个 bge-m3 量级的嵌入模型,INT8 量化后约 560 MB、FP32 约 2.2 GB,不可能藏在 42 MB 里。
因此本说明的措辞严格限定为:
「本地分支的代码路径完整存在,且客户端默认要求走本地; 但本机从未触发过该分支,因此也从未下载过本地模型,无法证明它在这个版本里端到端可用。」
但反过来,这恰恰构成新的疑问:客户端生产代码主动传 local_embedding:true, 而安装包既不提供本地模型、运行期也从不下载——这个参数在当前分发形态下根本无法生效。 如果官方要主张"只能上云",那么需要解释的就是:为什么客户端要发一个自己并不打算兑现的参数?
二、反驳点二:被上传的对象和"代码库"没有关系
官方说的是"上传代码库文件"。但实测显示,决定"传不传"的不是内容是不是代码, 而是"这个目录有没有被作为项目打开" + “服务端白名单里有没有它”。 这两条判据都不看内容的语义,所以出现下面的情况是必然的。
2.1 一个 168 万文件的局放数据集,被当成"代码库"索引并上传
被上传的目录清单里,有一个非常典型的例子:f:\allDataset\PD\all。 这是工程上用于局放(局部放电)识别的数据集目录,实测包含 1,681,216 个文件,顶层结构如下:
f:\allDataset\PD\all\
├── 4a\  4b\  4c\                  (原始采集数据分卷)
├── 放电标签csv\   放电标签prpd\   放电标签图片\
├── 无放电标签csv\  无放电标签prpd\
├── temp50\ temp100\ temp200a\ temp200b\ temp200c\   (解压中间产物)
├── _ungzip_tmp\
├── run_ungzip.bat   ungzip_fullprpd.py   verify_channels.py   verify_report.txt
└── .idea\  .trae\  .workbuddy\  __pycache__\
里面是 .fullprpd 原始波形、.csv 标签、图片——没有任何"代码库"语义。 对这样的目录做"代码库索引",在功能上没有任何意义。但日志显示,它被完整地走了一遍上传流程:
[CollectFilesAndRemoteEmbeddingStep] project f:\allDataset\PD\all
    initialize finished, build time: 3118.2421564 s,
    upload files time: 3026.1917772 s,
    total files: 55, total uploaded files: 55, total failed files: 0
类似地,声纹样本目录 f:\allDataset\姑苏换流变防火墙声纹样本sound(含"频谱图片"子目录) 也出现在远端项目清单里并被上传。
这里要给出一个诚实的限定:PD 数据集目录中,本次被 CKG 采集成"需上传"的是 55 个文件(其余因扩展名/二进制判定被跳过;且当时该目录正处于数据构建过程中), 并非 168 万个文件全部外传。我们不去夸大这个数字。
但这个案例恰恰说明了问题所在:它的筛选逻辑是"按内容类型挑能索引的文件",而不是"这是不是代码库"。 所以只要一个目录被当成项目打开,无论里面装的是代码、数据集还是样本, 符合类型的部分都会被送上云端——这正是"代码库索引"这个说法最名不副实的地方。
2.2 判定依据仍然是"目录级"的,不是"内容级"的
结合 1.4 节可以看得很清楚:RAGRepoWhiteList 是仓库(目录)粒度的白名单, 空名单意味着所有被打开为项目的目录一律走远端。 这里既没有"内容敏感度"的判定,也没有"用户是否同意"的判定。 "代码库索引"这个命名,会让人以为只有代码会被处理;实际的行为是项目目录级的整体采集与上传。
三、反驳点三:上传在工程上是净损失,且代价不可控
这是你原本提的第二条理由——“文件大了,等他传完,花都谢了”。 它其实可以升级成一条硬性技术论据:把耗时数据摆出来,"必要性"的说法就自己站不住了。
3.1 实测:索引流程的时间,几乎全部花在上传上
日志里每一行 initialize finished 同时给出两个数: build time(整个初始化耗时)和 upload files time(其中用在"上传文件"上的耗时)。 把所有可用样本拉出来对比:
| 项目 | 文件数 | 上传耗时 | 总初始化耗时 | 上传占比 |
|---|---|---|---|---|
f:\allDataset\PD\all |
55 | 3026.19 s | 3118.24 s | 97.1% |
f:\allDataset\PD\all |
54 | 1166.70 s | 1235.94 s | 94.4% |
e:\Work\Java\demo_web - 2026年9月11日 |
161 | 82.99 s | 84.19 s | 98.6% |
e:\Work\Java\demo_web - 2026年9月11日 |
152 | 51.24 s | 52.48 s | 97.6% |
e:\Work\disCharge\liuyi\二维数组直接识别 |
3000 | 88.19 s | 90.82 s | 97.1% |
e:\Work\disCharge\liuyi\二维数组直接识别 |
3000 | 41.50 s | 44.49 s | 93.3% |
e:\Work\Java\demo_web - 2026年8月31日… |
127 | 20.62 s | 22.23 s | 92.8% |
数据来源:%APPDATA%\Trae CN\ModularData\ckg_server\codekg.log.* 与 %APPDATA%\TRAE SOLO CN\ModularData\ckg_server\codekg.log.*, 过滤 [CollectFilesAndRemoteEmbeddingStep] project … initialize finished 行,按原文去重。
所谓"本地建索引"这件事,在时间上基本就是"把文件传上去"。
表里的上传占比稳定落在 92%~98.6%。也就是说, 用户等待"代码库索引构建完成"的那段时间里,几乎没有本地计算在发生,全部是在等上行带宽。 在这种事实下,把上传说成"为了实现索引功能"的必要步骤,等于承认: 这套设计把一件本可离线完成的事,做成了一件必须排队等网络的事。
3.2 更致命的是波动:同一份输入,耗时差 5~18 倍
把同一项目、几乎相同文件数的多次运行放在一起,差异是这样的:
| 项目(文件数) | 上传耗时(多次运行) | 最大倍数 |
|---|---|---|
demo_web - 2026年9月11日(169 → 161 个文件) |
4.67 s · 6.58 s · 82.99 s |
17.8× |
二维数组直接识别(均为 3000 个文件) |
16.44 s · 19.43 s · 41.36 s · 88.19 s |
5.4× |
文件数几乎没变,耗时却差出一个数量级——本地计算不可能产生这种波动,只有网络会。 这一条同时证明了两件事:其一,瓶颈确实在网络而不是本地算力;其二, 用户对"什么时候能用上索引"完全没有预期管理能力—— 同样的项目,今天 5 秒,明天可能 80 秒,后天遇到服务端 embedding_failed 还要重来。
3.3 还有失败重试与排队,成本被进一步放大
日志里大量出现服务端返回失败并要求重传的记录,例如:
[BatchUploadKnowledgebaseFilesTask] some files failed:
    map[348222c23d82e94c70d07753893491af34092adf:embedding_failed:
    rpc error: code = ErrInternal desc = We're sorry, something went wrong. Please…]
这意味着链路上还叠加了:服务端向量化失败 → 客户端重传; 以及 UploadKnowledgebaseFilesRateLimit: 3、 UploadKnowledgebaseFilesLimiterWindowSize: 50 之类的服务端限流。 本地的 CPU 就在那里空着,而任务在等服务端配额。
3.4 把三条并起来看
- 有本地实现(第一节:分支完整、客户端默认请求本地);
- 被配置成不用(第一节:空白名单使之永不生效);
- 代价还更大(本节:92%~98.6% 的时间在上传、波动 5~18 倍、有失败重试与限流)。
一个"更慢、更不稳定、还依赖外部服务"的实现,被说成是"为了实现功能"的唯一(或默认)路径, 在工程逻辑上是说不通的。
四、反驳点四:可验证性与告知义务不一致
4.1 "永久删除"是一句无法被检验的承诺
客户端侧可查的一切——CKG 日志、本地缓存目录、协议结构、网络请求记录——都没有任何 与"明文代码在服务端被删除"相关的痕迹。这句话在技术上既无法证实、也无法证伪。 这不代表它一定是假的,但它不能作为消解前三个问题的理由: "我会删掉"和"你不该被我传"是两件事。
4.2 隐私模式的开关,没有传导到索引链路上
这是可以验证的,而且结论很直接:
| 观测项 | 实测值 |
|---|---|
UI 层隐私模式状态(服务端 2026-09-17 09:59 写入,标记 {"type":"server"}) |
appPrivacyMode:<uid> = on 已开启 |
CKG 自己维护的 local_env.json → is_privacy_mode |
false(两个应用均如此,实时读取) |
| 开启隐私模式之后,是否还在上传 | 持续上传(09-17 晚 / 09-18 / 09-19 / 09-20 均有记录) |
日志中 privacy 关键词命中次数 |
0(两个应用的 CKG 日志中,索引链路从未打印过隐私状态) |
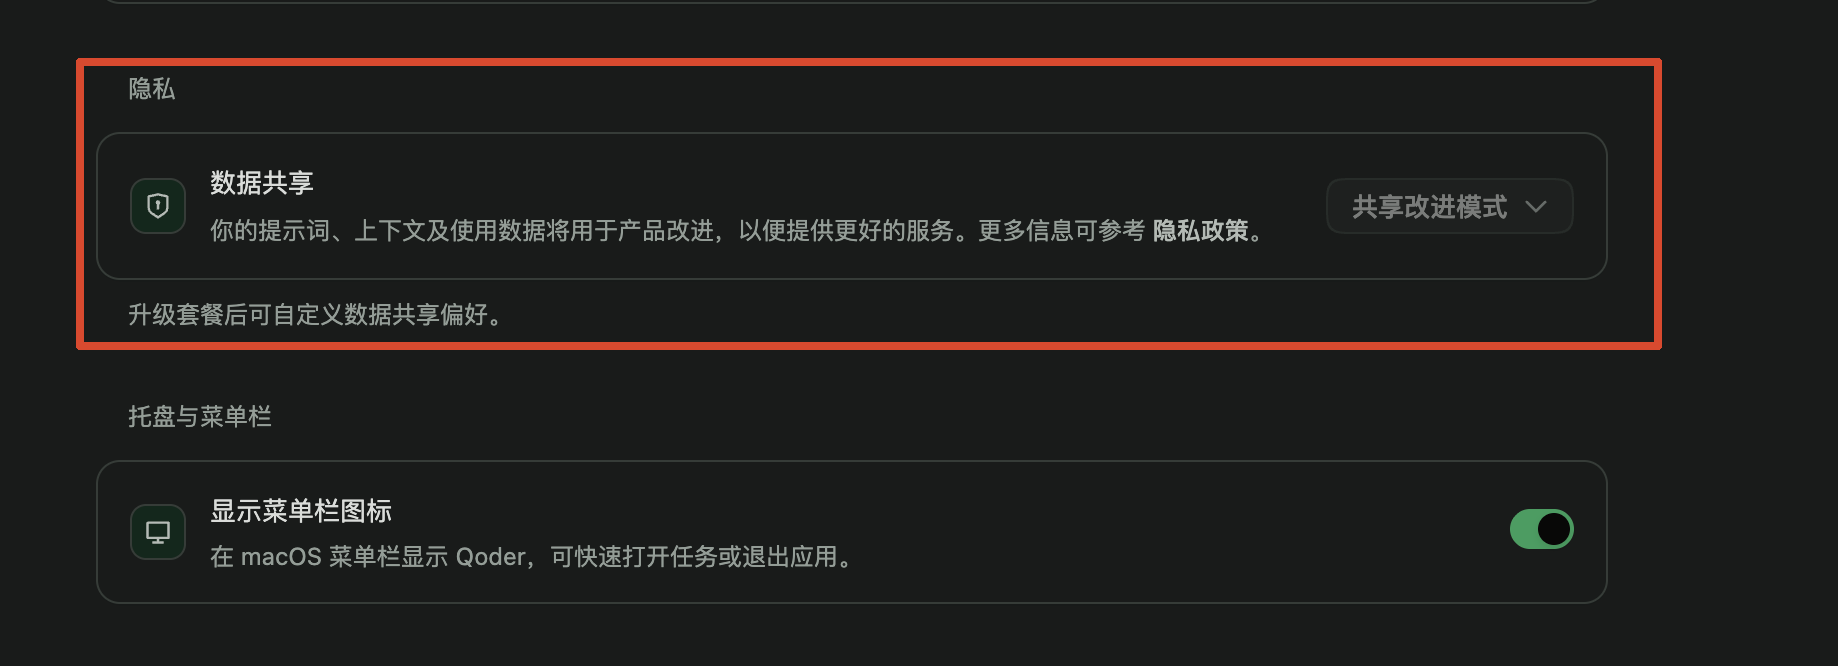
也就是说:用户在界面上打开的"隐私模式",并没有作用在代码索引上传这条链路上。 这与官方"隐私模式生效、且无论如何都不会上传用于分析"的表述之间, 存在一个客户端侧可以直接观察到的落差。
4.3 一个对照:堆快照上传时,它是会问的
同一个安装包里,另有一条"采集进程内存快照并上传"的通道。它的界面文案是这样的:
「进程(PID:{0})内存占用过高,我们将采集堆快照并上传到分析服务器,如果你需要取消,请点击取消按钮。」
它会告知、并提供取消入口。而代码库索引的文件上传, 在界面上没有任何提示,也没有任何"这一次不要传"的选项—— 唯一的开关是"要不要用这个 AI 功能"。 同一个产品对两类数据外传采取了两种完全不同的告知标准, 这本身就说明:哪些该告知、哪些不方便告知,设计者是清楚的。
五、我们不否认的部分(以及对可能反驳的事前回应)
一份只有指控的质证是没有说服力的。下面这些是对我们不利、但我们必须承认的事实, 以及官方可能的回应和我们的事前答复。
认我们承认的事实
- "确实会上传"是真的。本机两个应用合计观测到 20,328 次内容上传请求 (
uploadKnowledgebaseFiles:Trae CN 408 次、TraeWork 33,285 次),指向trae-api-cn.mchost.guru/api/ide/v1/knowledgebase/uploadKnowledgebaseFiles。 这一点官方没有隐瞒。 - 上传的是文件实体,不是哈希。这一点我们有量化判据(见下),因此也不接受"只传了元数据"的说辞。
- 云端索引本身不是违法行为。我们质疑的不是"能不能做",而是 描述是否准确、选择权是否存在、代价是否被如实告知。
辨可能出现的五种回应,与我们的答复
回应一:「本地分支只是预留代码,并不代表实际可用」
如果是这样,那么需要解释的是:为什么客户端生产代码要默认下发 local_embedding:true 并配 embedding_storage_type:"sqlite_vec"? 为什么官方文档里的启动命令也带这两个开关? 一个"不可用"的路径,不会在产品代码里被默认请求。 退一步说,即使它真的不可用,那也应当明确告知"本产品不提供本地索引", 而不是用"为了实现索引功能"来暗示上传不可避免。
回应二:「上传是为了索引质量更好/支持多端使用」
这是产品目标,不是技术必要性。而且"向量化"和"多端同步"是两件不同的事: 前者是计算,后者是存储与分发。用后者为前者的必要性辩护,属于偷换论题。 更重要的是,即使接受这个目标,也应当提供"仅本地索引"的选项让用户自己取舍。
回应三:「隐私模式已经保护了用户」
实测否定:is_privacy_mode 在隐私模式开启后仍为 false, 且上传持续发生(见 4.2)。请公布隐私开关与索引链路的对应关系, 并解释为什么两套状态不同步。
回应四:「上传的是分块和向量,不是原始文件」
这与量化判据冲突。四条独立证据:
| 判据 | 数据 | 它说明了什么 |
|---|---|---|
| 批大小不对称 | 哈希清单 uploadFileIDs 批 = 1000; 文件实体 uploadKnowledgebaseFiles 批 = 5 |
两者是不同的东西,后者一批只敢拿 5 个 |
| 耗时不对称 | 1000 个哈希 ID ≈ 374 ms; 1 个文件实体 ≈ 2520 ms; 55 个文件 ≈ 3026 s | 只有传输文件内容才会呈现这种量级 |
| 服务端行为 | 服务端对上传物按文件返回 embedding_failed |
服务端是在对上传内容做向量化,不是在读哈希 |
| 协议结构 | 二进制内含 UserFileContent / user_file_content 字节字段 |
协议里就为"文件内容"留了位置 |
需要说明:本机未抓取到明文请求体(其自研网络库 ahanet 不记录 body), 因此"传内容"这一结论是由上述量化判据与协议结构共同支持的强推断, 而非直接抓包。我们把这一点标注清楚。
回应五:「用户可以选择关闭索引」
关闭索引 = 关闭 AI 对代码库的理解能力,等于放弃这个产品的核心价值。 用"关掉功能"来替代"提供纯本地选项",本质上是把功能胁迫包装成选择权。 而且,官方目前没有提供"保持索引但不上传"的开关—— 这正是第一节所证明的、技术上完全可行的那个选项。
六、结论与诉求
三个结论
- 因果被颠倒了。"为了实现代码库索引功能……会上传"暗示上传是技术必然。 但客户端二进制里存在完整的、不经过网络的本地嵌入分支,且客户端生产代码默认请求的就是它; 本机 100% 走远端的原因,是服务端下发的
RAGRepoWhiteList为空。 正确的表述应当是:“索引有两种实现,本产品的服务端策略选择了需要上传的那一种”。 - 代价被轻描淡写了。“临时上传"在实测中是索引流程耗时的主要成分(92%~98.6%), 并且随网络波动 5~18 倍,还有失败重传与服务端限流。 对一个 55 文件的数据集目录,单次上传耗时达到 3026 秒。 这不是"临时”,这是把可用性押在了上行带宽上。
- 承诺不可验证,且开关未生效。"永久删除"在客户端无任何可验证痕迹; 而可验证的是——界面上的隐私模式开启后,CKG 的
is_privacy_mode仍为false,上传照常继续。
基于以上,我们提出四点诉求
- 修正表述。请把"为了实现代码库索引功能……会临时上传"改为如实描述: 索引存在本地与远端两种实现,当前默认策略为远端上传; 并明确"上传是策略选择,而非技术必需"。
- 提供真正可用的纯本地索引选项。既然本地分支已在代码中存在、客户端也已在默认请求它, 那么补齐本地模型(随包提供或首次启用时下载)、并使该分支实际生效,是工程上已被证明可行的事。 若因某些原因无法提供,请公开说明具体原因,而不是以功能需要为由回避。
- 把告知与授权做在索引上传之前。做到与堆快照上传同等的标准: 明确告知、提供取消入口;并支持"按目录"粒度的授权—— 允许用户把数据集、样本库、素材库这类目录排除在索引之外, 而不是只能在"用功能"和"不传"之间二选一。
- 公开"永久删除"的可验证机制,并修正隐私开关的行为。 说明明文在服务端的留存周期、删除方式、以及用户如何自证; 同时修复"界面已开启隐私模式、CKG 内部仍为 false"的状态不同步问题。
附录 A:证据来源与复现方式
本说明的全部数据均可在同一台机器上复现,路径如下。
| 证据类别 | 位置 / 方法 |
|---|---|
| 索引分支定义(本地/远端) | libckg.dll 偏移 0x1490adb,内嵌 JSON(流水线 DSL,可直接解析) |
| 选择器日志格式 | libckg.dll 偏移 0x1474aef: [LocalRemoteEmbeddingSelector] git uri: %s, iLRWL: %v, iAWL: %v |
| 客户端启动参数 | <安装目录>\resources\app\out\main.js 偏移约 1,257,653 (local_embedding:!0);modules\ckg\start.bat |
| 服务端配置回显 | CKG 日志中 GetCKGRAGConfig 输出(RAGRepoWhiteList 等) |
| 执行计数 / 上传耗时 | %APPDATA%\Trae CN\ModularData\ckg_server\codekg.log.*%APPDATA%\TRAE SOLO CN\ModularData\ckg_server\codekg.log.*过滤 [CollectFilesAndRemoteEmbeddingStep]、[LocalRemoteEmbeddingSelector]、 uploadKnowledgebaseFiles |
| 本地模型缺失 | modules\ckg\ 目录清单;全盘搜 *.onnx / *.gguf / *.ggml / *.safetensors (零命中,已排除 VSCode 语言检测模型、对话分词器、RTC 资源包) |
| 隐私开关状态 | local_env.json 的 is_privacy_mode;UI 层 appPrivacyMode 存储 |
| 堆快照告知文案 | 应用内本地化文案:「进程(PID:{0})内存占用过高,我们将采集堆快照并上传到分析服务器,如果你需要取消,请点击取消按钮。」 |
附录 B:本文刻意没有使用的论据(以及原因)
为了让反驳站得住,下面这些"看起来更有冲击力"的说法被主动排除了:
| 被排除的说法 | 排除原因 |
|---|---|
| “上传了 168 万个数据集文件” | 不实。该目录被采集并上传的是 55 个文件(见 2.1 的限定说明)。 夸大数字只会给对方一个现成的反击口。 |
| “它把明文代码永久保存/贩卖” | 无法证明。“永久删除"无法证实,但同样无法证伪。本文只主张"不可验证”, 不主张"没有删除"。 |
| “本地模型明明能用却故意不用” | 本机确实不存在任何 CKG 嵌入模型(42.4 MB 的目录装不下 bge-m3)。 因此只能说"代码路径存在、客户端默认请求、却从未触发且从未下载模型", 不能说"本地明明是能用的"。 |
| “抓到了明文请求体” | 其自研网络库 ahanet 不记录 body,本机未抓到明文载荷。 "传的是内容"是由批大小、耗时量级、服务端 embedding_failed、 协议含 user_file_content 字段四条判据共同支持的强推断,本文如实标注为推断。 |
“阻断 trae-api-cn.mchost.guru 就能解决” |
不成立。该域名同时承载对话、补全、Cue、Hub 等多个服务(见 product.json), 屏蔽它会连带废掉 AI 功能本身,不能作为论据。 |