我是谁
大家好,我是RPA求职者,25届毕业生,现在在杭州,做技术开发工程师。在广州做 RPA 负责人期间,带团队做了 Amazon、Temu、Walmart、紫鸟代理 4 大平台的上架和采集,也做过领星 ERP 的财务、仓库报表自动化。这些经历写进简历时,基本都变成了“负责开发 RPA 程序”一句话,再之前在盛趣做过 Python 爬虫工程师(主要学习Python)。最近在准备看看RPA市场,方向还是 Python 爬虫、RPA 开发、自动化这一类。
改简历的时候我发现一个问题:自己明明做了不少事,但写出来都是“负责开发 RPA 程序,自动化获取数据”“参与亚马逊多平台商品上架”。面试官扫一眼就过去了,根本不会追问。尤其是 RPA 和爬虫项目,技术细节很多,但业务结果很容易写散。
所以我用 TRAE 做了个「简历项目亮点提炼器」。
它干的事不复杂:把一段项目经历粘进去,先拆成 Situation、Task、Action、Result,然后标出哪块缺东西。通常 Result 最空。这时候它不会替你编数字,而是生成几个追问,比如:
-
覆盖了多少店铺、站点、SKU?
-
原来人工要多久?现在缩短到多久?
-
成功率从多少提升到多少?
-
失败重试做了几次?超时从 30s 提到 90s 后,失败率降了多少?
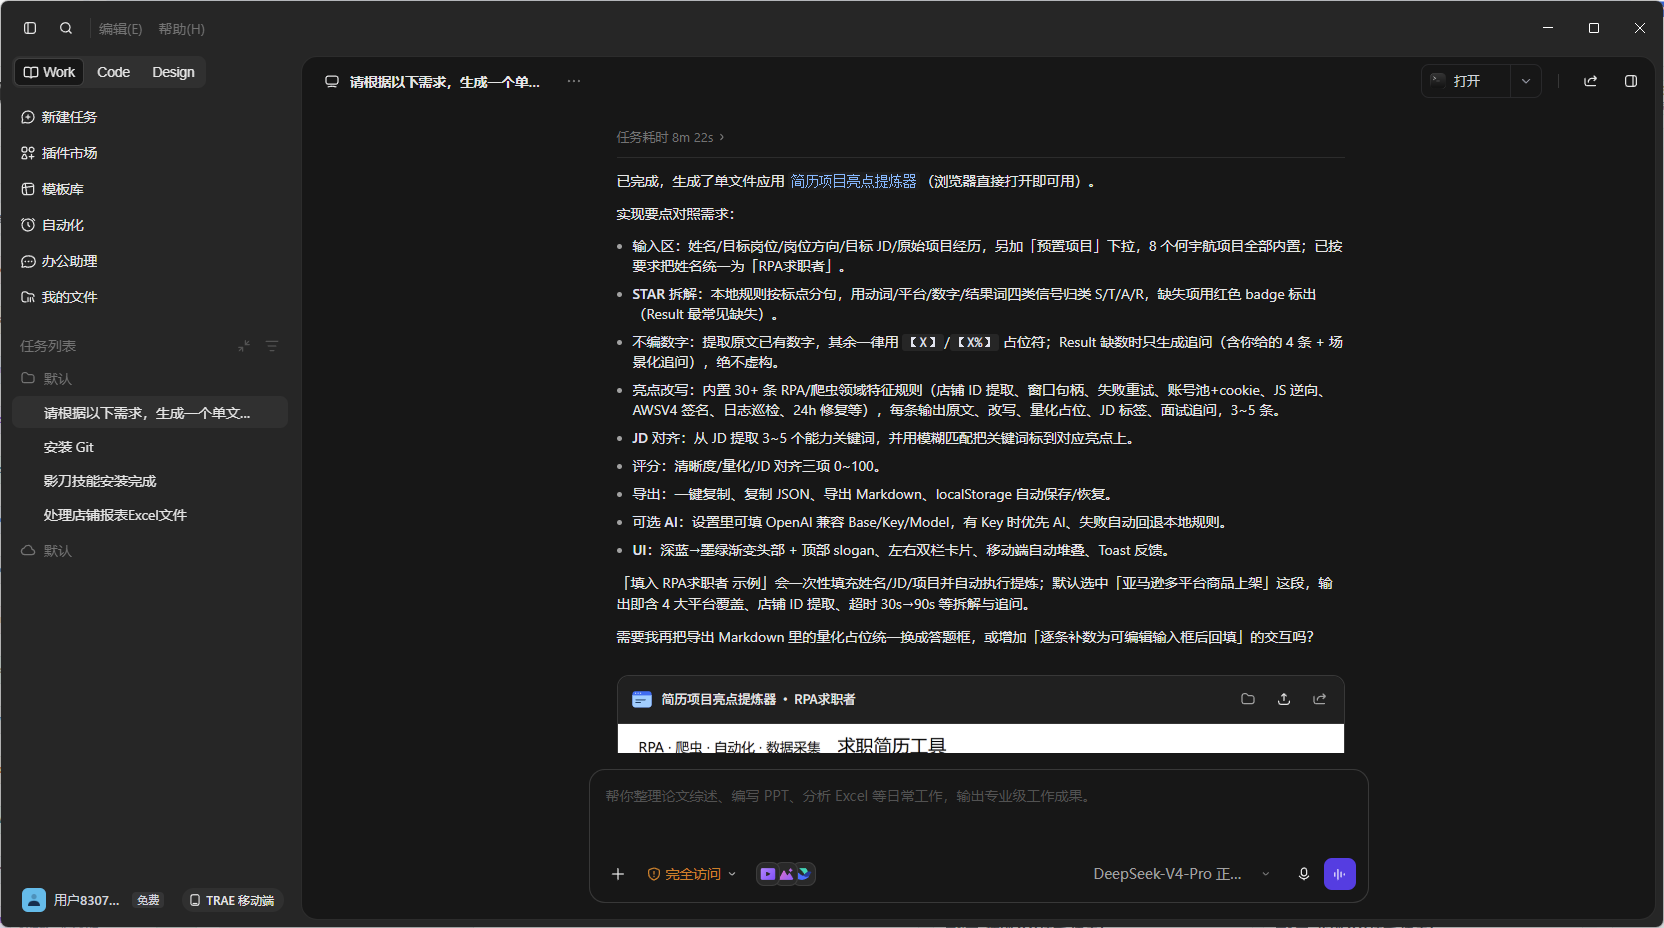
你填完这些数字,它再帮你改写成 3~5 条简历亮点。每条亮点旁边还会标:这条能对上目标 JD 的哪个词,以及面试官可能会追问什么。
我拿自己简历里“亚马逊多平台商品上架”那段测试过。原文是“负责对亚马逊英国、德国、美国,Temu 等多个站点处理上架”。提炼后会变成带平台、带机制、带追问点的表述,比如覆盖 Amazon/Temu/Walmart/紫鸟代理 4 大平台,店铺 ID 提取、窗口句柄管理、失败重试这些都会被拎出来。数字还是得自己补,但至少知道该补什么。
我是怎么用 TRAE 做出来的
用 TRAE 做的时候,第一版我让它直接帮我改写,结果出来全是“提升了系统性能”“优化了业务流程”这种话,看着像那么回事,面试一问就露馅。第二版我把提示词改了:先拆 STAR,再找缺失项,只生成追问,不生成数字。用户填完数字,再组装表达。这样出来的东西至少能用。
关键提示词大概是这样:
把下面这段项目经历拆成 STAR,标出缺失项。不要改写,只提问。
根据追问回答,把原始经历改写成 2~3 条简历亮点,每条不超过两行,不要编数字。
后来我又加了两个东西:一个是 JD 对齐,粘目标岗位 JD,它提取几个关键词,标在每条亮点旁边;另一个是面试追问预测,每条亮点旁边列 1~2 个面试官可能问的问题。这块最费劲,因为要让模型别乱编,只能基于原文问。
【截图 1:第一版直接改写,输出空话】
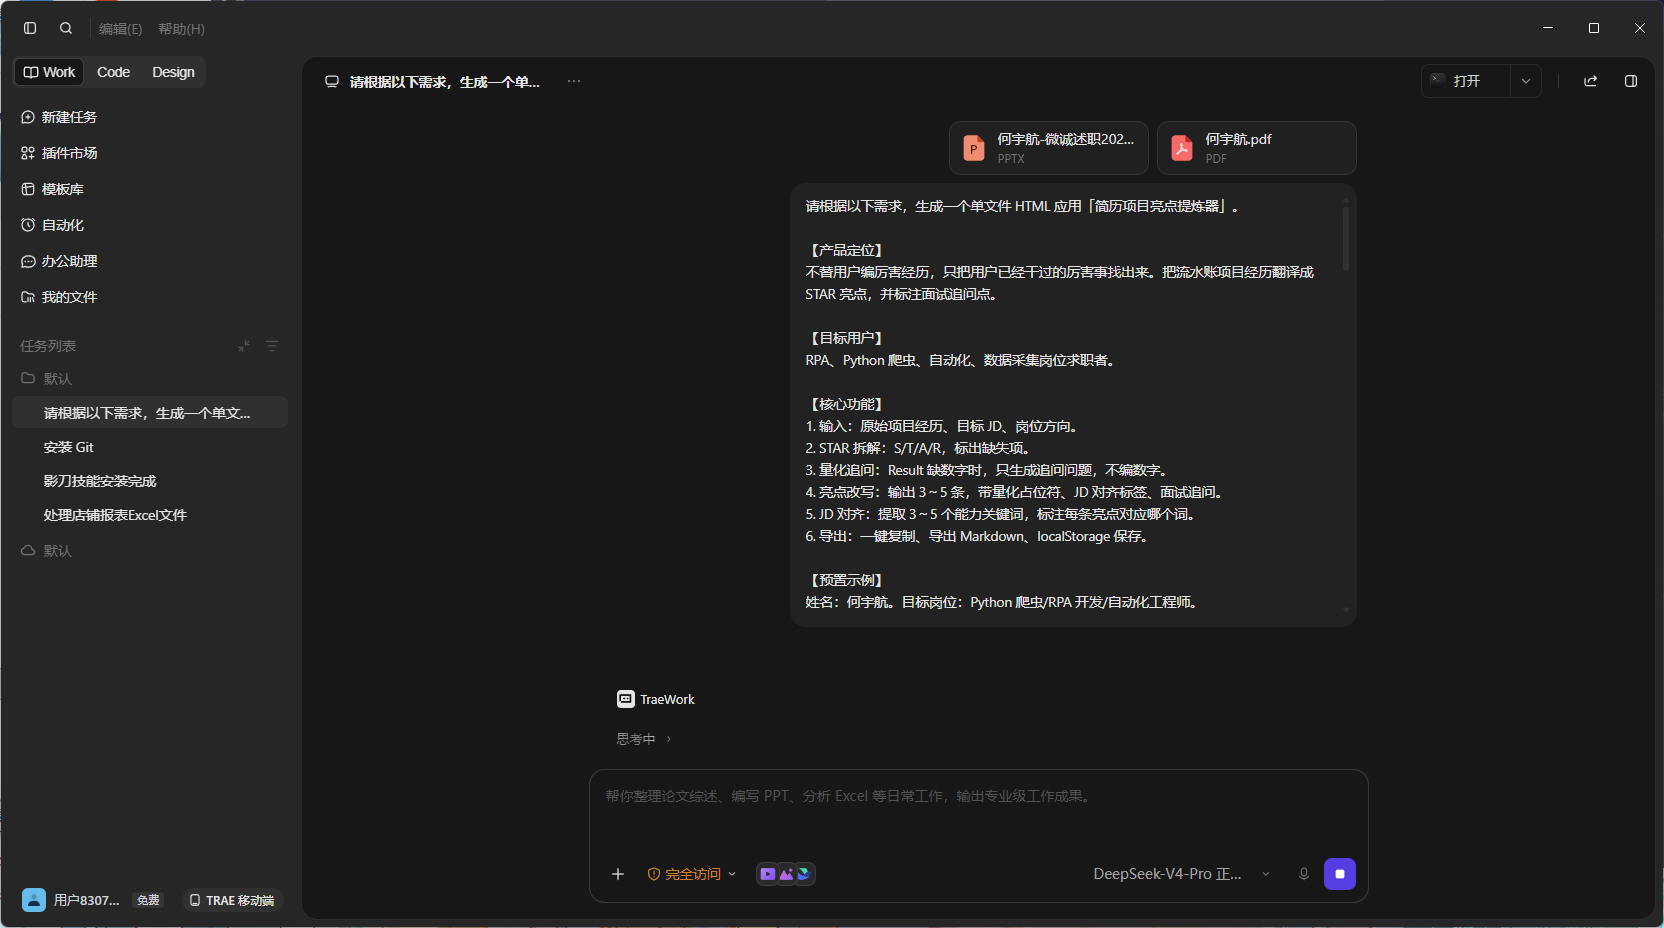
【截图 2:JD 对齐 + 面试追问预测】
成果展示:
【GitHub:在线体验链接】
目前是单文件 HTML,浏览器打开就能用,不用装东西。代码还在整理,后面放 GitHub。欢迎拿自己的项目经历试试,尤其是 RPA、爬虫这种技术点多但结果难写的。