首先需要了解以下各个知识:
Trae官方对JEV的文章:https://mp.weixin.qq.com/s/DNr2E1OW63GO0v9dMsrvSA
JEV是什么的介绍: 不会还有人不知道JEV吧,只输出决策,不产文本。以 RLCD 训练、并行推理替代自回归
TypeSafe JEV官方仓库skill: skills/skills/typesafe-ai/SKILL.md at main · typesafe-ai/skills · GitHub
TypeSafe: TypeSafe
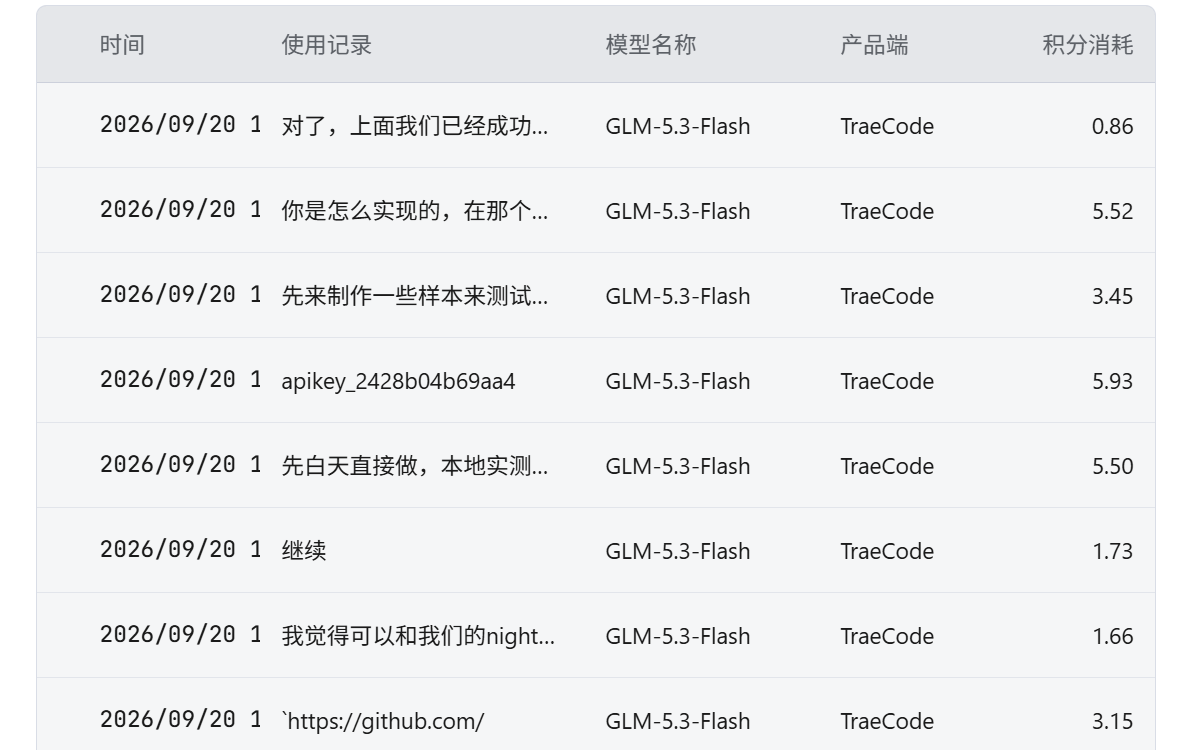
通过Trae官方文章和typesafe官方skill来实现,过程llm是glm5.3flash,积分消费30以内
一、我的项目背景以及怎么接入
我之前有个项目night-shift: 刚刚好接着traecode中ds模型的忙闲算力使用,来介绍night shift,忙时做设计,闲时稳定批量运行 (感兴趣的同学可以点击链接了解)他是一个框架用来给AI做昼夜分工执行协议的,其中核心思想就是算力贵的时候人做判断,便宜的时候AI做执行;更普遍地说,night-shift 里的人做判断:
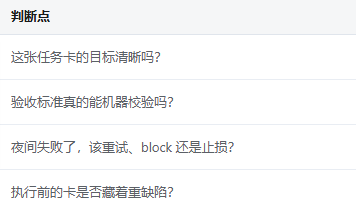
直到 TypeSafe 发布了 Jev,我发现这批判断有了专门的模型或许可以来承接
二、为什么是 Jev
System One 决策模型,和 LLM 的区别一句话就能说清:
LLM 帮你写,Jev 帮你判断。
它的接口形态完全为软件消费设计:
{
  "state": "要判断的内容(文本或结构化数据)",
  "model": "jev-latest",
  "questions": {
    "is_urgent": { "type": "noul", "instructions": "这个消息表达了紧迫性吗?" }
  }
}
三种原语覆盖三类判断:
| 原语 | 问什么 | 返回 |
|---|---|---|
| Choice | 闭集选一个 | 选中项 + 每项概率 + confidence |
| Score | 有序等级打分 | 等级位置 + 分布 + confidence |
| Noul | yes/no | P(yes) |
三个特性:
- 校准概率是产品本身。Choice/Score 自带 confidence,这是训练目标(RLCD,为校准决策做强化学习)决定的,不是 prompt 工程逼出来的
- 多问题一次调用并行。加问题几乎不增加耗时,官方数据 70~500ms。我的场景一次要问 7 个问题,这个特性是体验基石
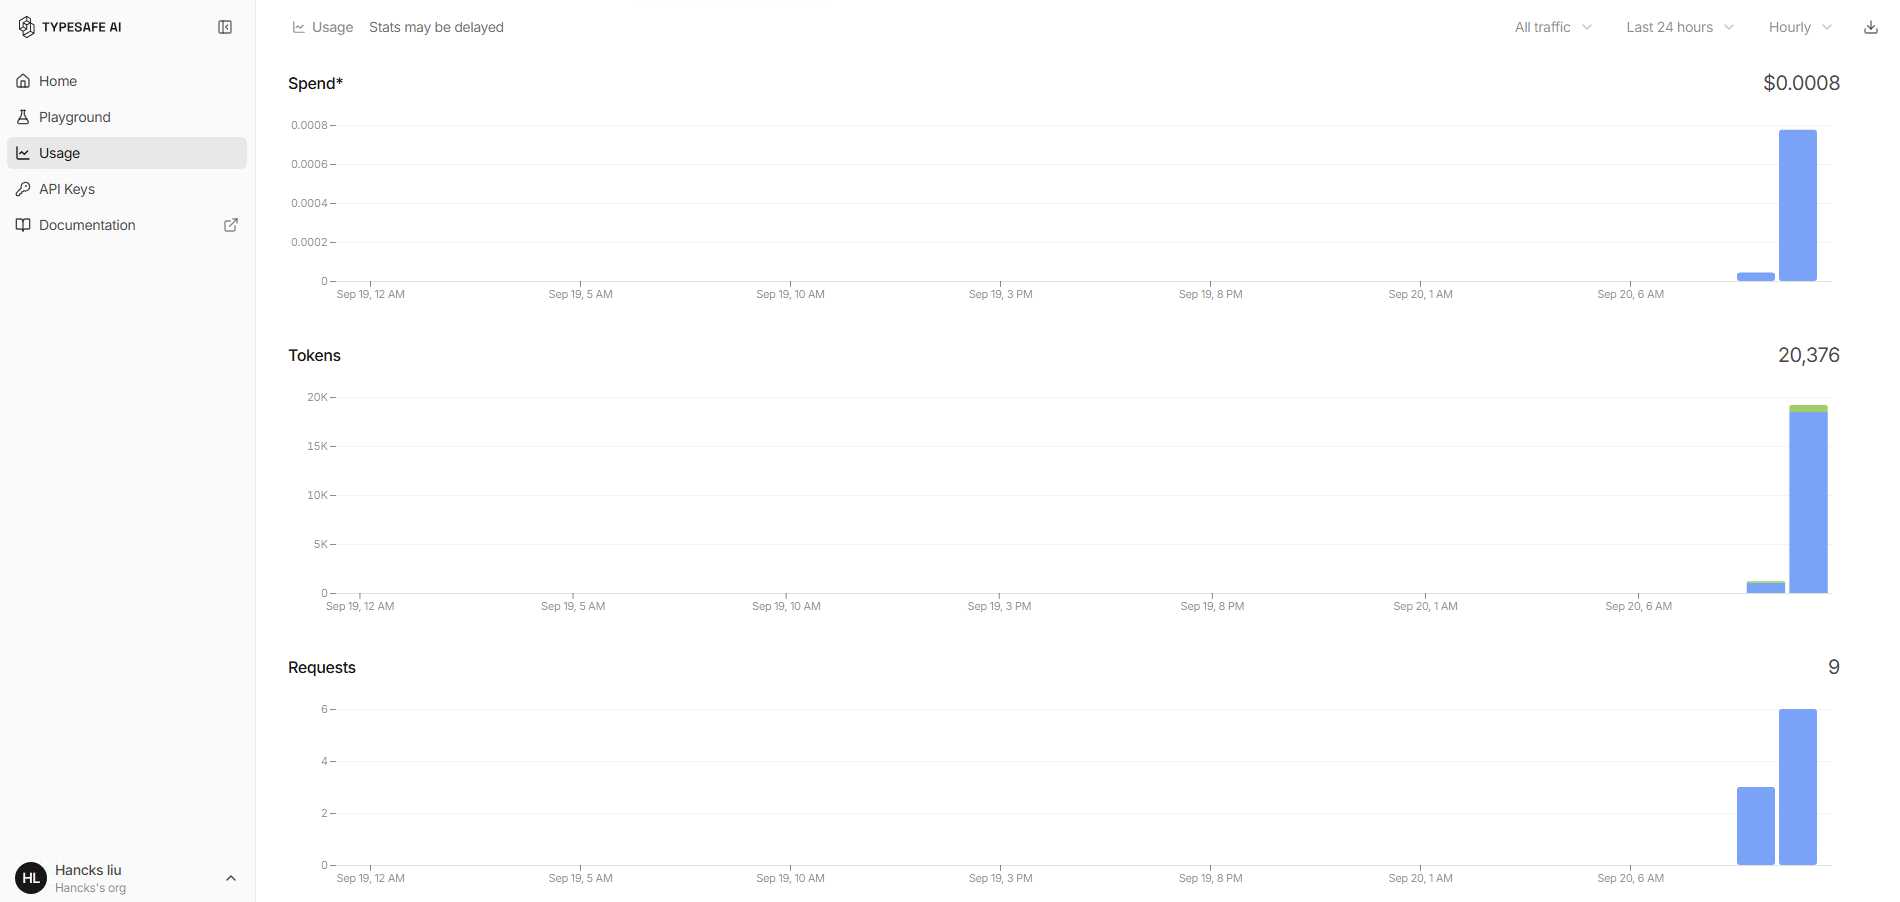
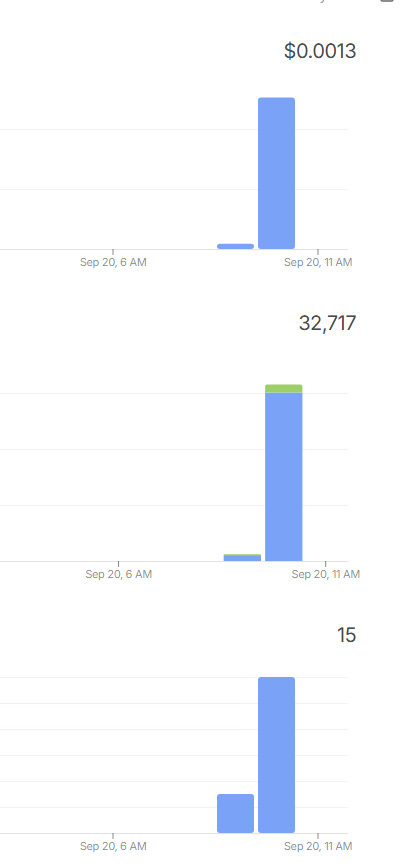
- 便宜到可以忽略。$0.042/1M input tokens、输出免费。实测一轮 7 问评分(约 3000 字任务卡)花 $0.0004,总共消费见文章最后
三、实现
1.其实就是发这段话,包括官方文章和skill,同时我也有自己的设计就是我想要用jev来执行任务卡是否准入到夜间任务队列的判断
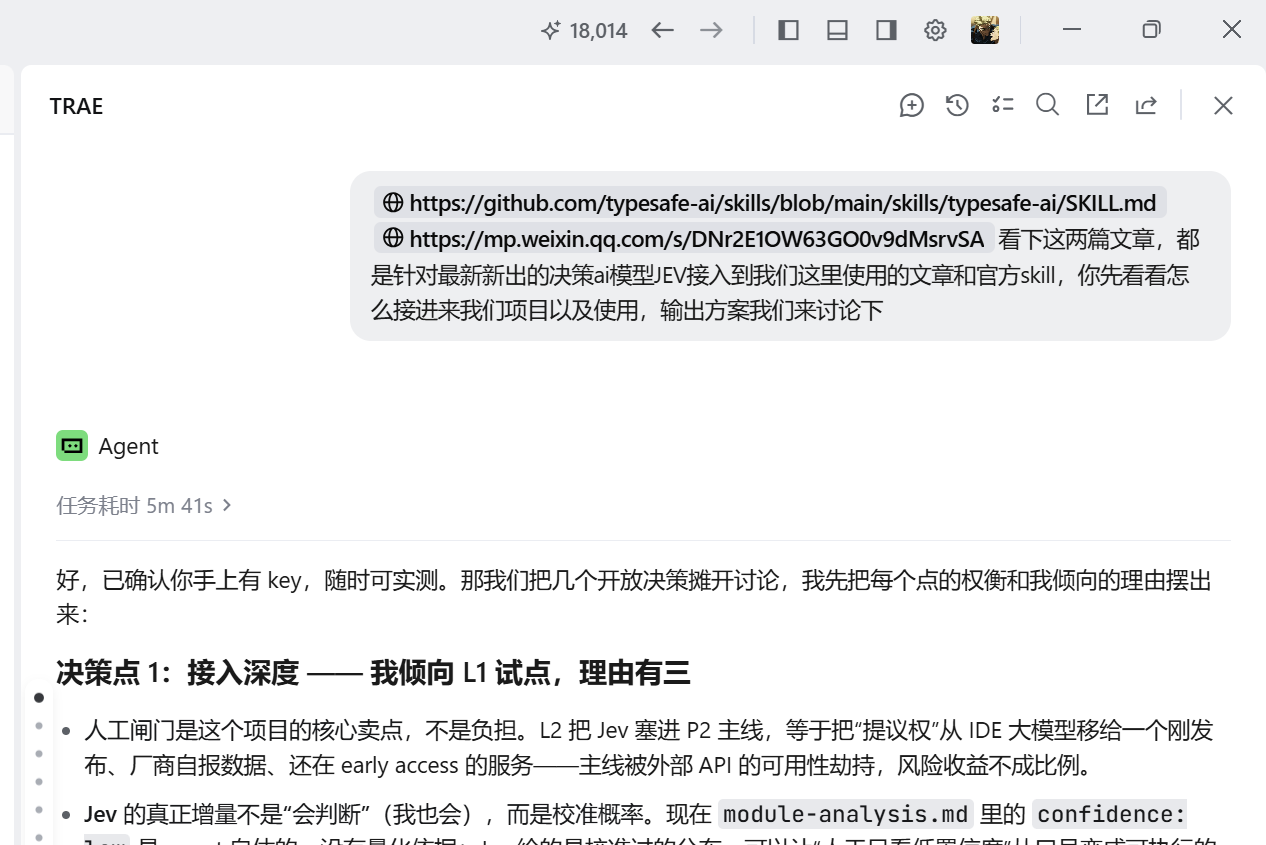

2.中间过程忽略几次需求澄清和对话,无非就是说明清楚你的项目背景和设计诉求,以及ai会判断是否合适,并且结合内容来开发,用的llm是glm5.3flash,总消耗积分粗估不到30个积分
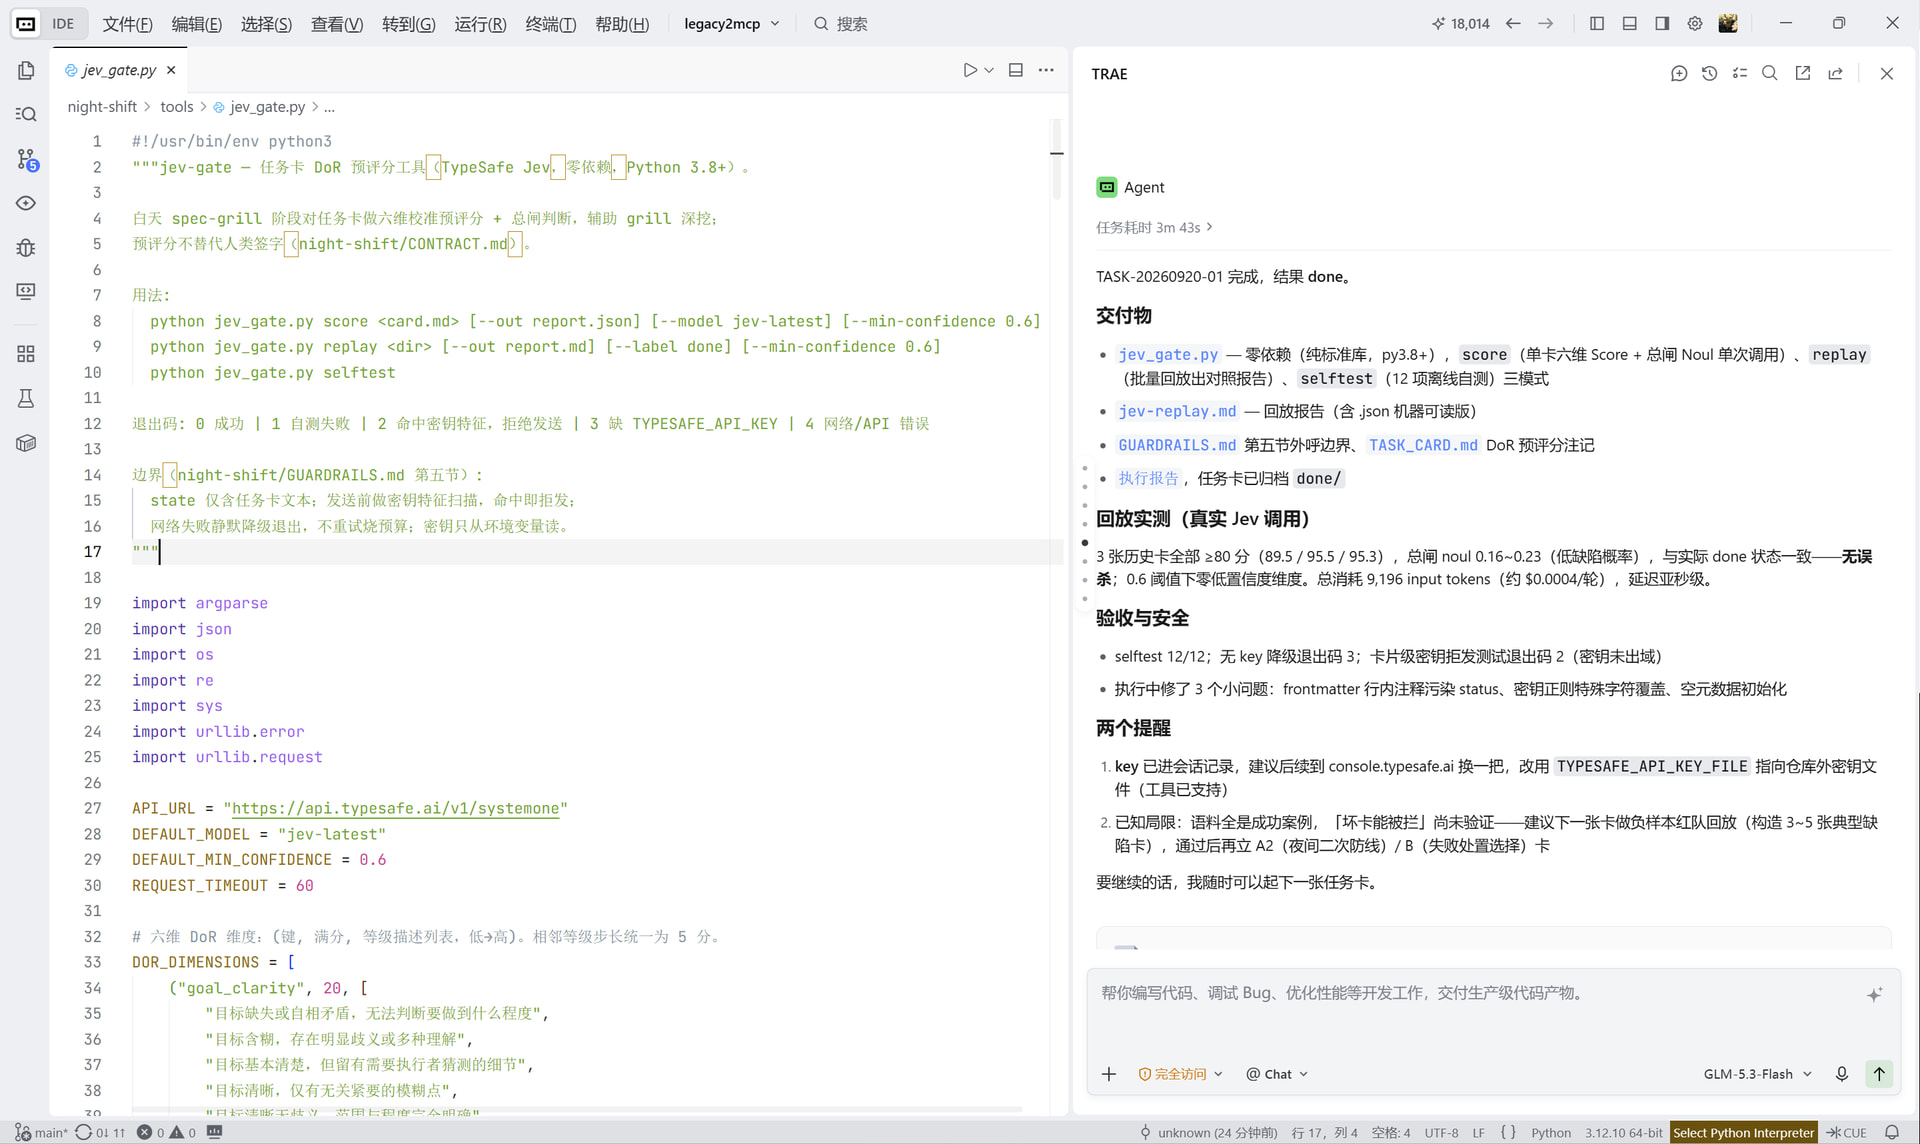
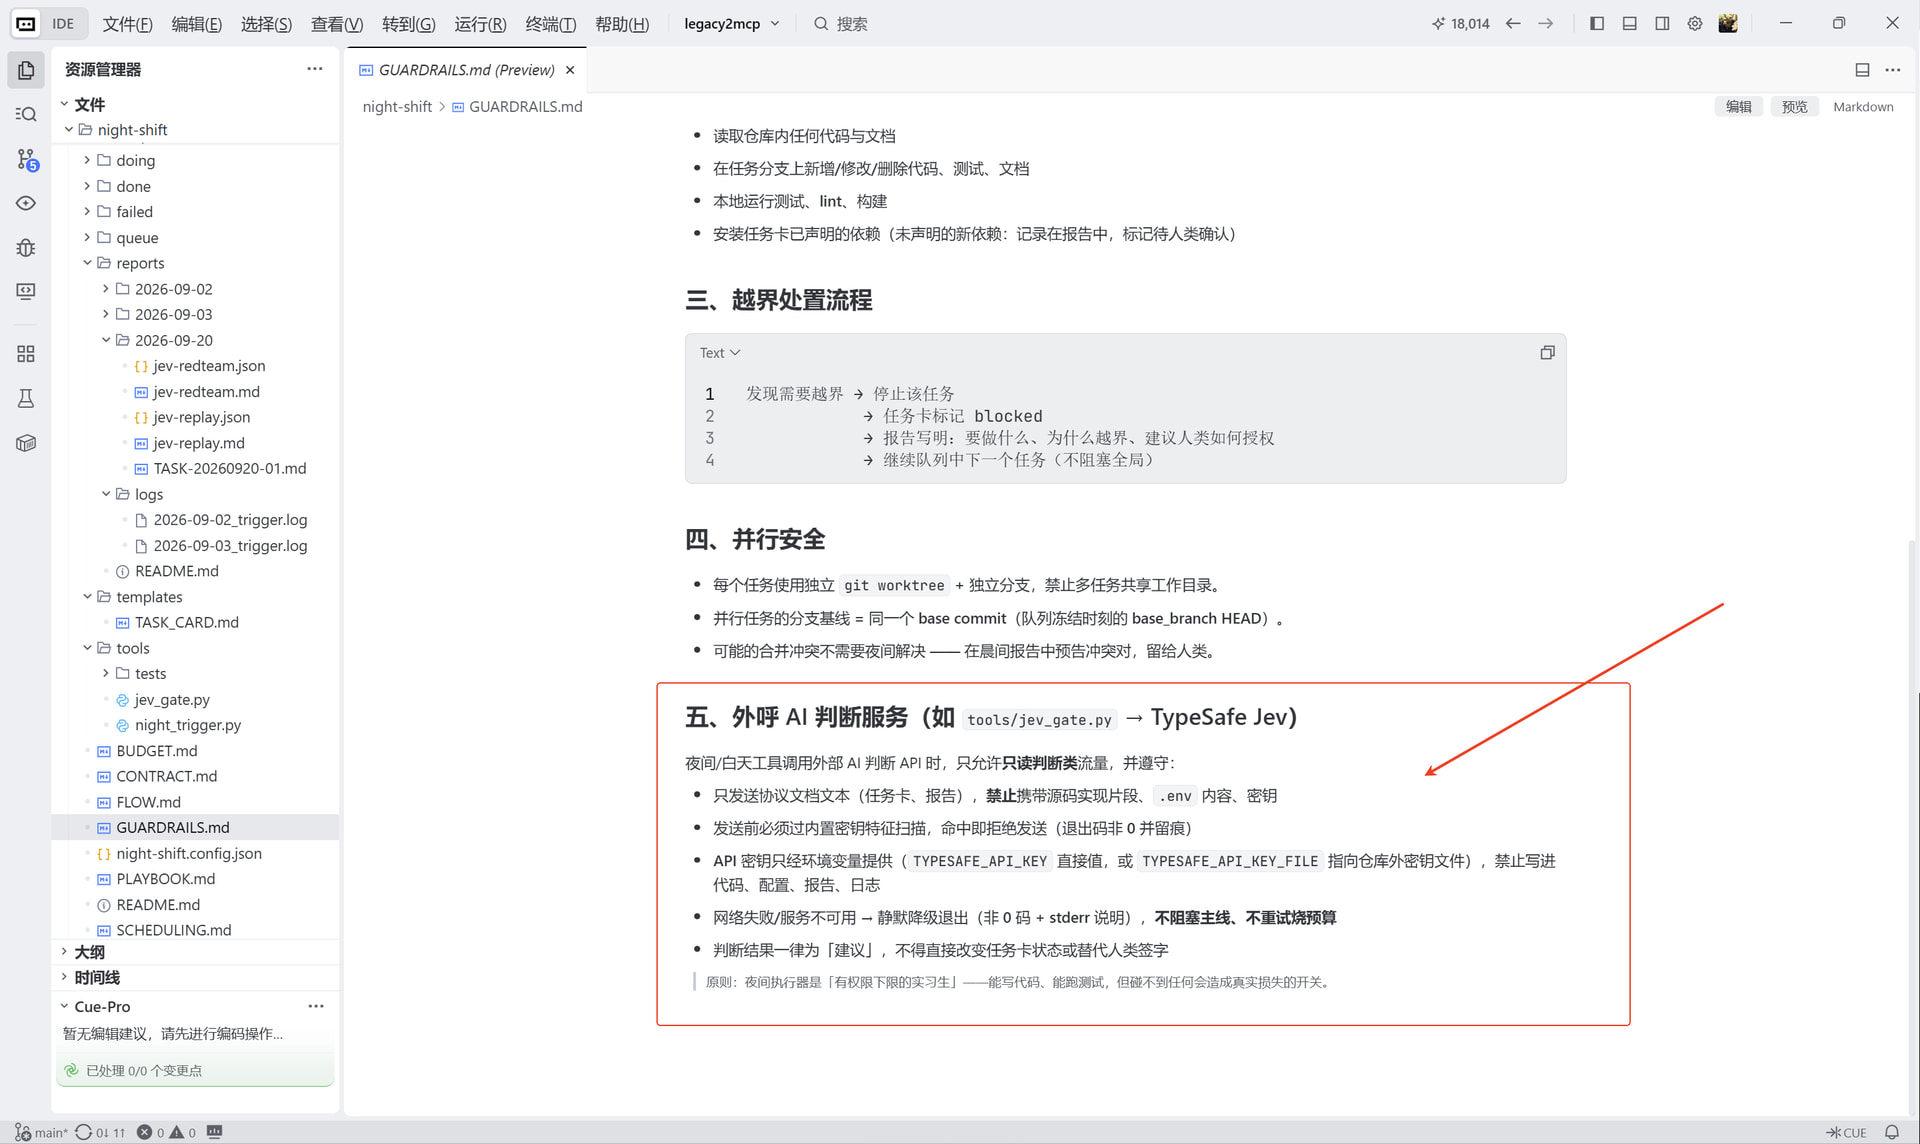
3.最终沉淀到协议层中说明判断工具的调用
四、例子
criteria 必须是描述具体情境的有序等级,不能写“好/中/差”。比如验收标准维度(满分 25):
("acceptance_machine_verifiable", 25, [
    "验收标准完全无法机器校验,全靠人工主观判断",
    "多数验收项靠人工主观判断",
    "约一半验收项可机器校验",
    "大部分验收项可机器校验,个别需要人工判断",
    "全部或接近全部可机器校验,个别表述含糊",
    "每一条验收标准都是明确命令或指标,可直接判定通过与否",
]),
调用就是标准的 urllib:
req = urllib.request.Request(
    "https://api.typesafe.ai/v1/systemone", data=payload, method="POST",
    headers={"Authorization": "Bearer " + api_key, "Content-Type": "application/json"},
)
输出长什么样
单卡评分的 JSON(bad-01 为例),维度分、校准置信度、总闸概率全都在:
{
  "total": 23.0,
  "suggestion": "建议 grill 补强后再准入",
  "overall_gate_noul": 0.95,
  "dimensions": {
    "goal_clarity":   {"points": 4.3, "max_points": 20, "confidence": 0.86},
    "acceptance_machine_verifiable": {"points": 0.5, "max_points": 25, "confidence": 0.93},
    "conflict_scope": {"points": 5.0, "max_points": 15, "confidence": 0.98},
    "night_suitability": {"points": 7.8, "confidence": 0.32, "low_confidence": true}
  }
}
注意 night_suitability 的 confidence 只有 0.32——模型在说“这卡夜里跑会出事,但我这个判断本身不太确定”。这个元信息直接变成了 grill 的深挖提示,是纯 LLM 方案给不出的。
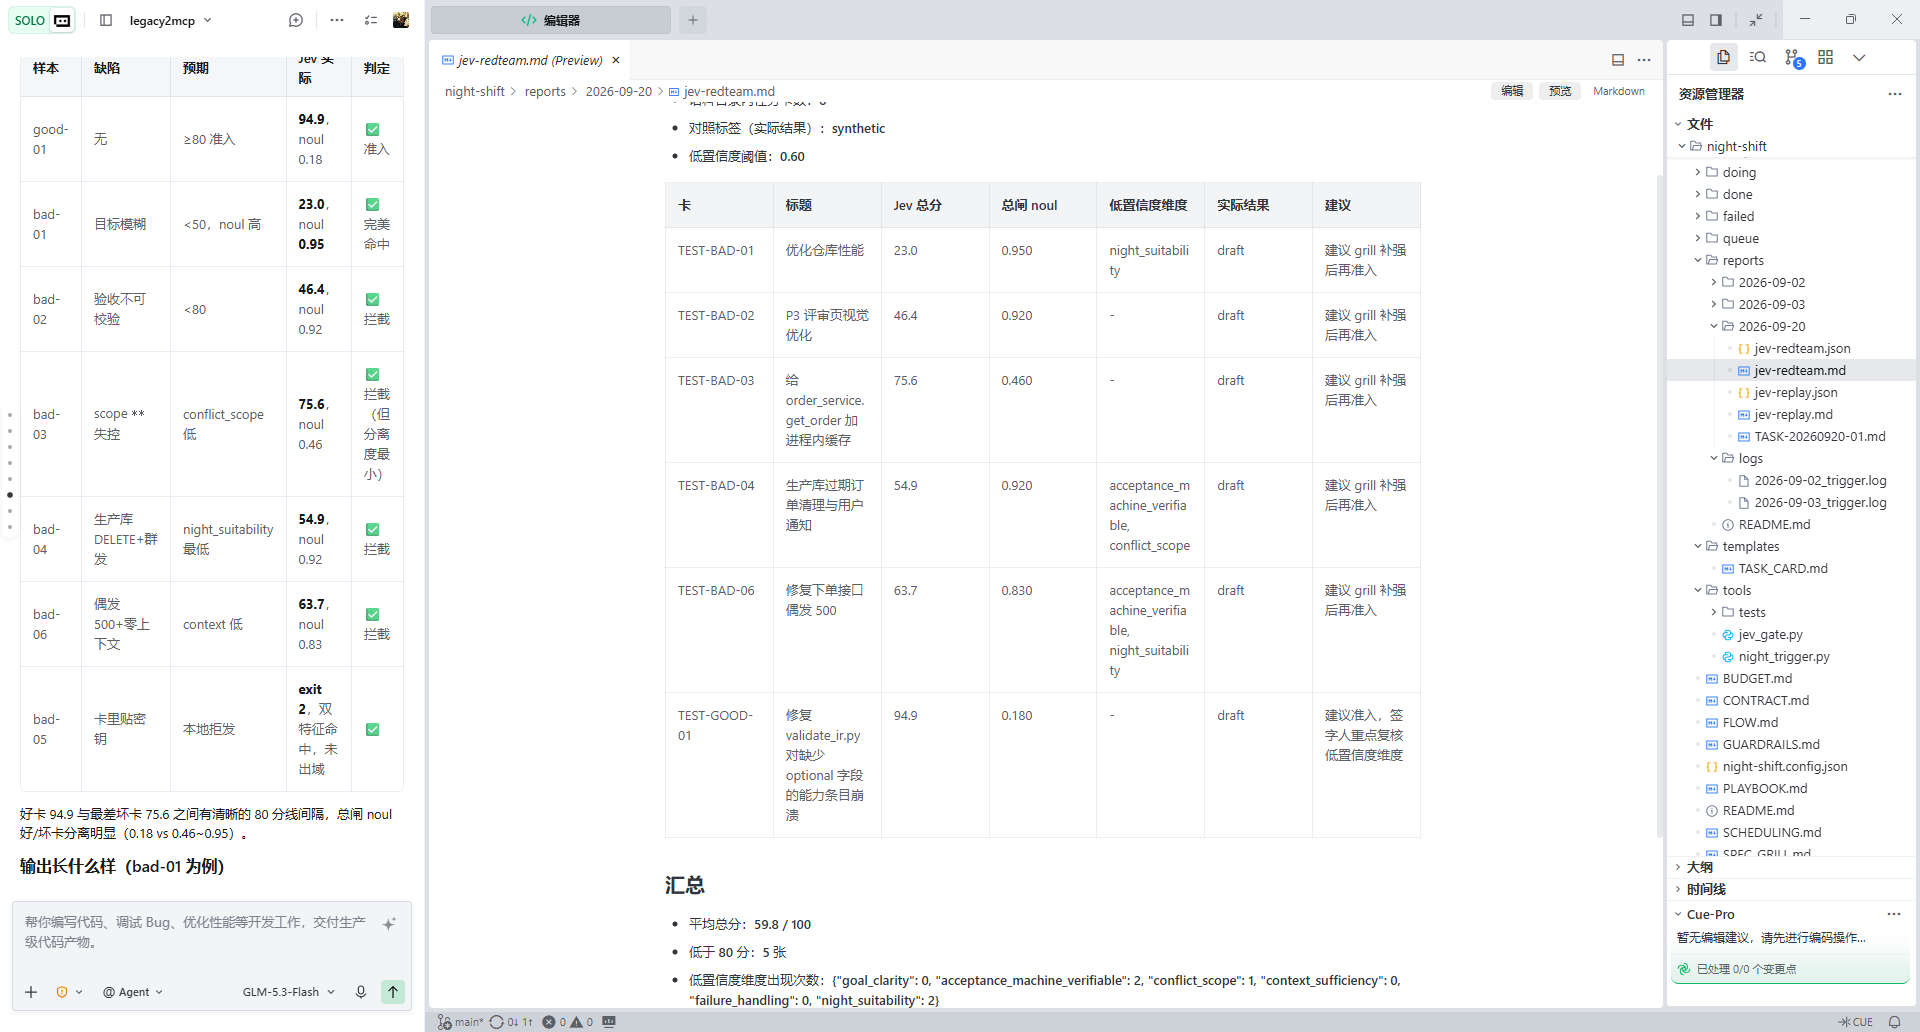
最后,成本与体验
一轮完整评分(3000 字任务卡):input 9,196 tokens ≈ $0.0004,亚秒级返回
全部验证过程(9次调用)总成本不足 $0.001
对比:同样的六维评审交给通用 LLM 逐维分析,一次要几美分 + 10 秒以上,且给不出校准置信度