我用 TraeCode 把一场华为杯数学建模竞赛拆成「六条智能体流水线」,数天打完并一次交付 27 页 LaTeX 论文
1. 我是谁,以及我遇到了什么问题
我是一名在读研究生,和队友备赛「华为杯」研究生数学建模竞赛中,选择了 2025 年 E 题《高速列车轴承智能故障诊断》训练。
这道题的麻烦在于它横跨三个专业方向,而且四问层层递进、缺一不可:
-
任务1:从 161 个轴承台架数据文件里,面向"迁移任务"筛选源域主集并做故障特征提取;
-
任务2:在源域上设计诊断模型并评价(诊断精度 + "正常类召回偏低"这种怪现象的归因识别);
-
任务3:把知识迁移到 16 个完全无标签的实际列车文件(A~P) 上,逐文件给出标签标定;
-
任务4:对迁移诊断做可解释性分析(事前 / 迁移过程 / 事后三层)。
最后还要提交完整可运行源代码和一篇正文不超过 20 页的 LaTeX 论文。
如果按老办法一个人硬扛,我得先补旋转机械、信号处理、迁移学习一大摞知识点;再手写 4 个子问题的数据读取、特征提取、模型训练、可视化、审计脚本;再手工画几十张图、手工排 LaTeX 卡页数。光想想就清楚"时间根本不够,且大量时间会耗在机械搬砖上"。
2. 我是怎么用 TraeCode 解决这件事的
我主要用的是 SOLO 模式:把整场比赛抽象成一个工作流,让 TraeCode 的多个智能体分工接力,我只在关键决策点做"架构师"拍板和 Code Review。
我把它拆成六个角色流水线:顶层规划师(题目解构)→ 建模编程一体执行手(模型探索)→ 科学可视化设计师(数据叙事)→ 数模论文写手(论证构建)→ 项目质量审计师(完整性审查)→ 主控器(总调度)。
第一步:让 TraeCode 先深度解构题目,而不是急着写代码
我把题面 PDF 和数据集描述丢给它,要求先产出一份可执行的问题解构,而不是直接动笔:
提示词:「@ 赛题 请逐条解构四个子问题的本质分别是什么:任务1 本质是构建’可迁移表示层’、任务2 是源域四分类+域不变性探针的双重目标、任务3 是无标签目标域的置信度交付、任务4 是三层可解释证据链。并为每个子问题建立假设树、给出建模方向指南。」
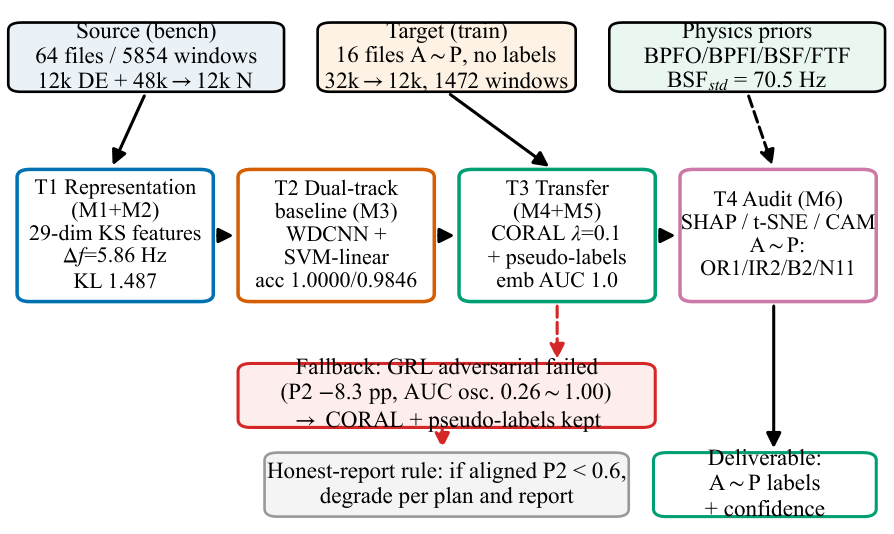
它产出《问题解构报告》《假设树与模型演进路径》《综合建模方案》,并提前画好全题技术路线图,让我先看到终点再走路径:
第二步:让建模智能体"先探索、再落地",结果以标准化表落盘
对每个子问题,我让它在独立工作区 + 独立脚本里做完一整套实验,而不是把所有代码堆在一起。每个子问题从 探索计划 开始,到产出标准化结果表(CSV)和 模型边界/风险校验报告结束,形成可复用的中间产物:
提示词:「子问题2 请先探索浅层(SVM/RF)与深度(WDCNN)双轨方案的适用性,再落地训练。把结果写成标准化 CSV(含文件级 GroupKFold 精度、窗口级精度、各类别召回),并单独回答:为什么正常类召回卡在 0.750 下不去?」
其中最有价值的一步,是让审计侧的"域判别探针"给出一个可靠的负结果——监督训练出的嵌入域判别 AUC = 1.0,说明"监督精度高不一定自带域不变性",从而把"显式对齐"从可选项变成必选项。这种"先证伪、再定方案"的逻辑,是靠工作流里的证据链支撑的,不是拍脑袋。
第三步:可视化设计师统一出图,图内中文标注、风格一致
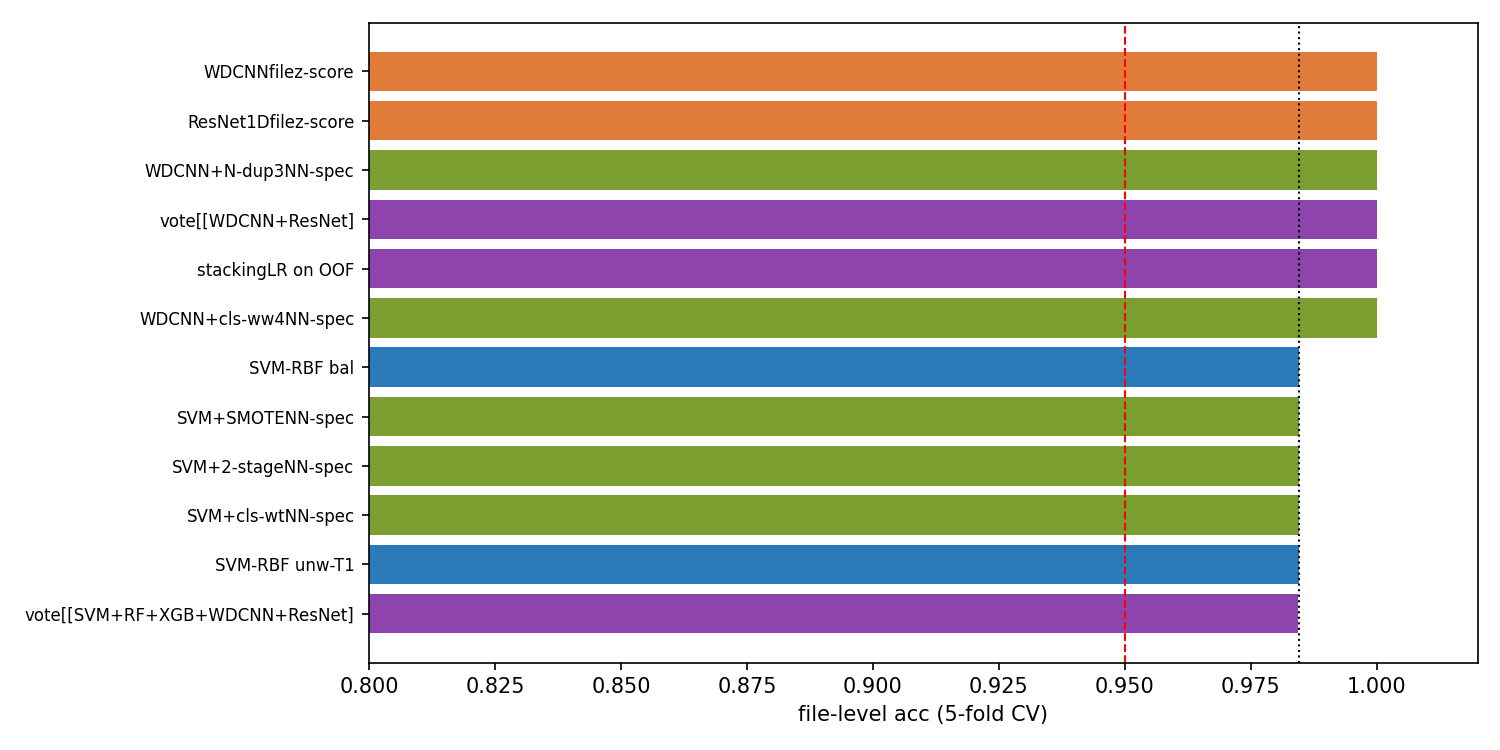
每张图先有"叙事框架",再按统一规范产出成图并登记图表资产,避免各子问题图表风格打架:
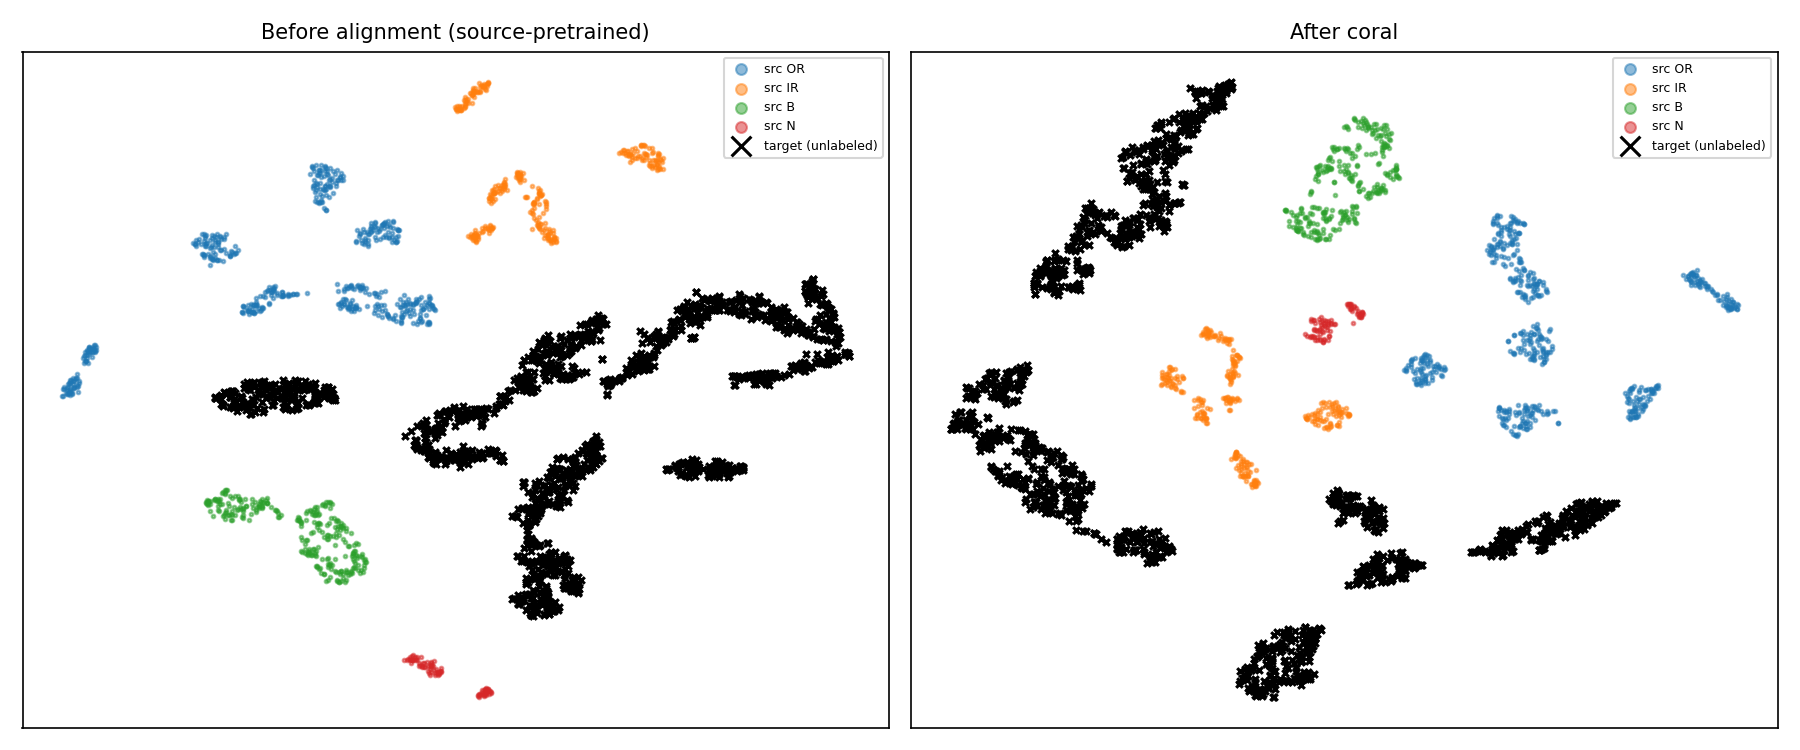
迁移对齐结论同样被可视化成"对齐前后"的几何证据(域中心距 1.515 → 0.892,下降 41%),直接应答任务3"迁移结果可视化"的硬性要求:
第四步:论文写手按大纲把四章写成 LaTeX,并用审计锁死页数与口径
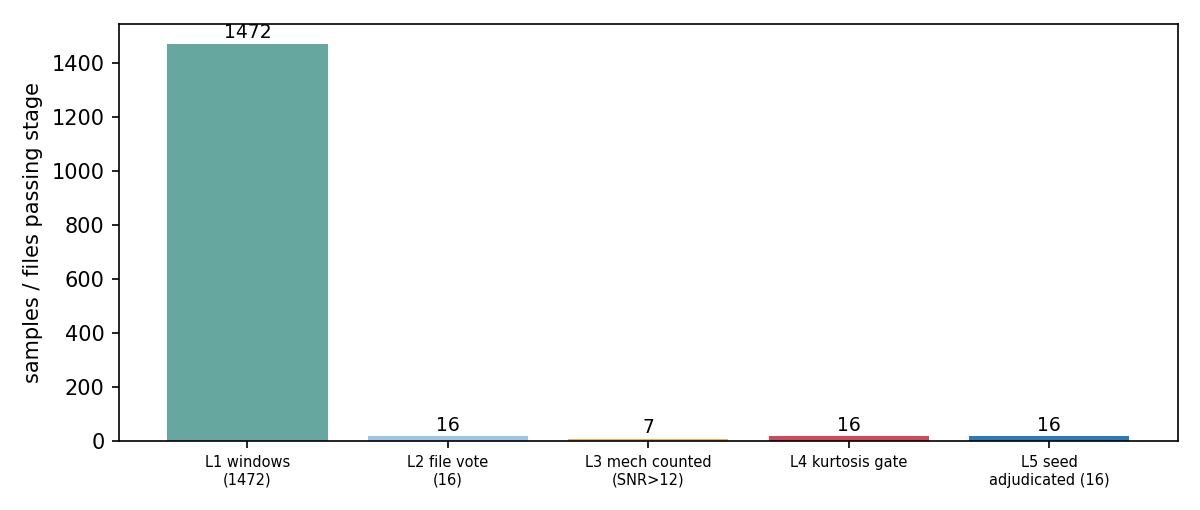
写手基于大纲把每章落到 LaTeX,把摘要里的锚点数值与图表编号逐一对齐,用字数/图表预算把正文卡进 20 页;审计智能体再按轮自审,专门揪"数值口径矛盾、图内标注不一致、因果断言无证据"这类问题:
第五步:质量审计闭环
每轮产出都交给审计智能体对照规则核查,我把它的《四轮自审报告》《终审回应报告》作为修改依据,而不是闷头改。
3. 成果展示
最终交付了一套可以正式提交、可复现、可审计的完整作品:
-
可复现代码:4 个子问题各一个独立 Python 脚本 + 统一配置,跑一遍即得全部标准化结果表(CSV);
-
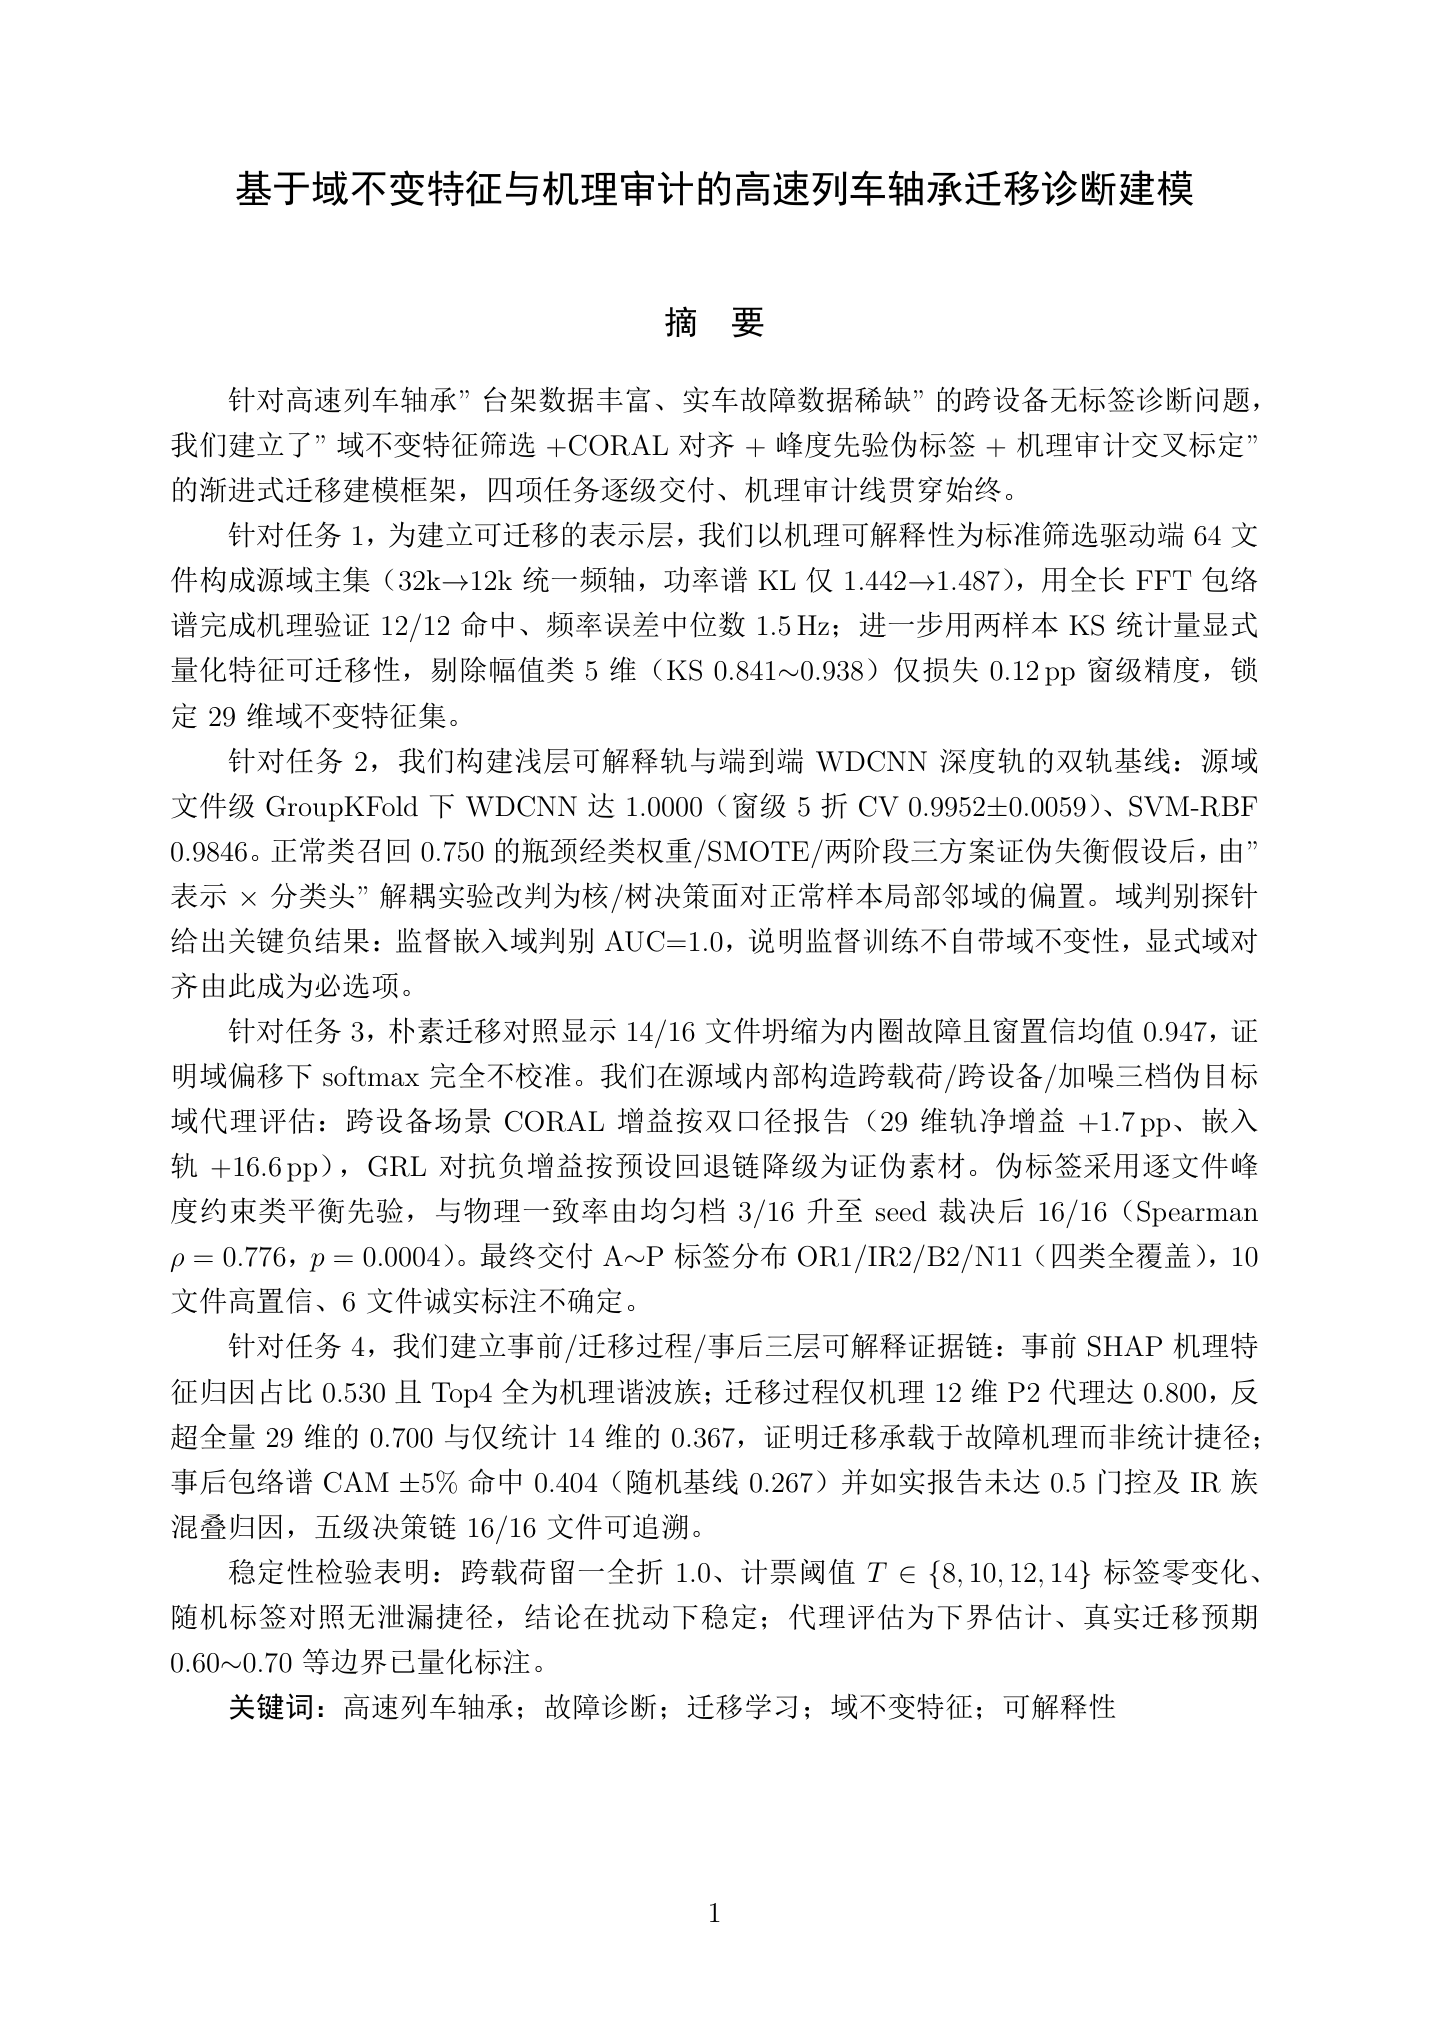
27 页正文 LaTeX 论文(含技术路线图和 18 张机理图、6 张表),摘要如下,直接体现题目要求的四问递进:
-
16 个无标签目标域文件的迁移标定:OR1 / IR2 / B2 / N11(四类全覆盖),其中 10 个文件给高置信标签、6 个文件在证据不足时诚实标注为"不确定"而不是硬猜;
-
硬核量化结果:
-
源域 WDCNN 文件级精度 1.0000,SVM-RBF 0.9846;
-
朴素迁移 14/16 坍缩为内圈故障 → CORAL 显式对齐后 t-SNE 域中心距降 41%;
-
峰度约束类平衡伪标签与轴承物理先验一致率 16/16(Spearman ρ = 0.776, p = 0.0004);
-
可解释性三层证据链:SHAP 机理特征归因占比 0.530、包络谱 CAM ±5% 命中 0.404(随机基线 0.267)并如实报告未达 0.5 门控。
-
交付物给谁用:提交华为杯竞赛评阅;方法框架可平移到任何"数据解释 + 迁移学习 + 需要可解释交付"的科研/工程场景。
4. 效率对比
-
以前怎么做:先花一周补信号处理/迁移学习知识点 → 每个子问题手工写全套脚本、反复试错 → 手工画几十张风格不一的图 → 手工排 LaTeX 卡 20 页、临近提交大返工。整个周期常要连续熬夜,且风险极高。
-
现在怎么做:把「解构→建模→编码→可视化→写作→审计」串成流水线并行接力,每个子问题独立落地、结果以标准化表交叉引用,页数和口径由审计轮直接定位修正。我只需要在关键选择上拍板(例如对齐方法从谱系里选 CORAL、放弃振荡的 GRL),以及做 Code Review。
一个直观变化:传统单人做完这类四连问+论文通常意味着"编码与写作各占一半还互相返工";这次编码、可视化、写作是被多个智能体分流并行推进的,且每一步都有可复跑的实验和审计记录,把"返工成本"转移到了"流程内自审",而不是提交前才暴露。
5. 经验和技巧总结
-
把大任务拆成可独立交付的子任务,各自独立工作区:每个子问题一个脚本 + 一组标准化 CSV 结果,才能在四问之间互相交叉引用,也方便最后统一审计。
-
尽早把领域上下文喂进去:题面 PDF、符号规范、图表配色/中文标注规范提前作为样板提供,比每个子问题都从零解释省得多。
-
关键动作自己当"架构师":让 AI 负责逐步论证和落地,但方法选型(用 CORAL 弃 GRL)、可信度门槛由我决定;触发不可信结果时走"证伪 → 回退"而不是硬撑,符合科研该有的诚实边界。
我的真实场景是"研究生数学建模竞赛",但它背后其实是每个开发/科研/数据分析者都熟悉的一条主线:把模糊的复杂任务,交给能编排多个智能体的 TraeCode,让它替你把重复的机械劳动跑完,把精力留给真正需要判断的地方。