我是0代码的普通爱好者,日常使用自己的openclaw需要时常更新和调试。长期折磨我的是这三类问题:
- 调试即翻车:无论是自己手动调试 OpenClaw,还是让openclaw调试自己,一个不留神就容易把自己环境"搞死",回滚成本很高。
- 更新后遗症:早期 OpenClaw 版本迭代频繁,几乎每次更新都会带来一批新的配置问题或插件冲突。
- 上下文成本高:OpenClaw 的上下文 Token 消耗太大,光是来回试错、排查 bug,调试成本就居高不下。
在这之前,我处理这些问题基本靠手动翻文档、翻配置、试来试去,既慢又容易踩雷。
二、我是怎么用 TraeCode 解决的
我主要用的是 SOLO 模式,把 /.openclaw 目录整体交给 TraeCode 托管。日常的配置修改和 debug 排障,都交给它去完成,整个过程顺畅了很多。
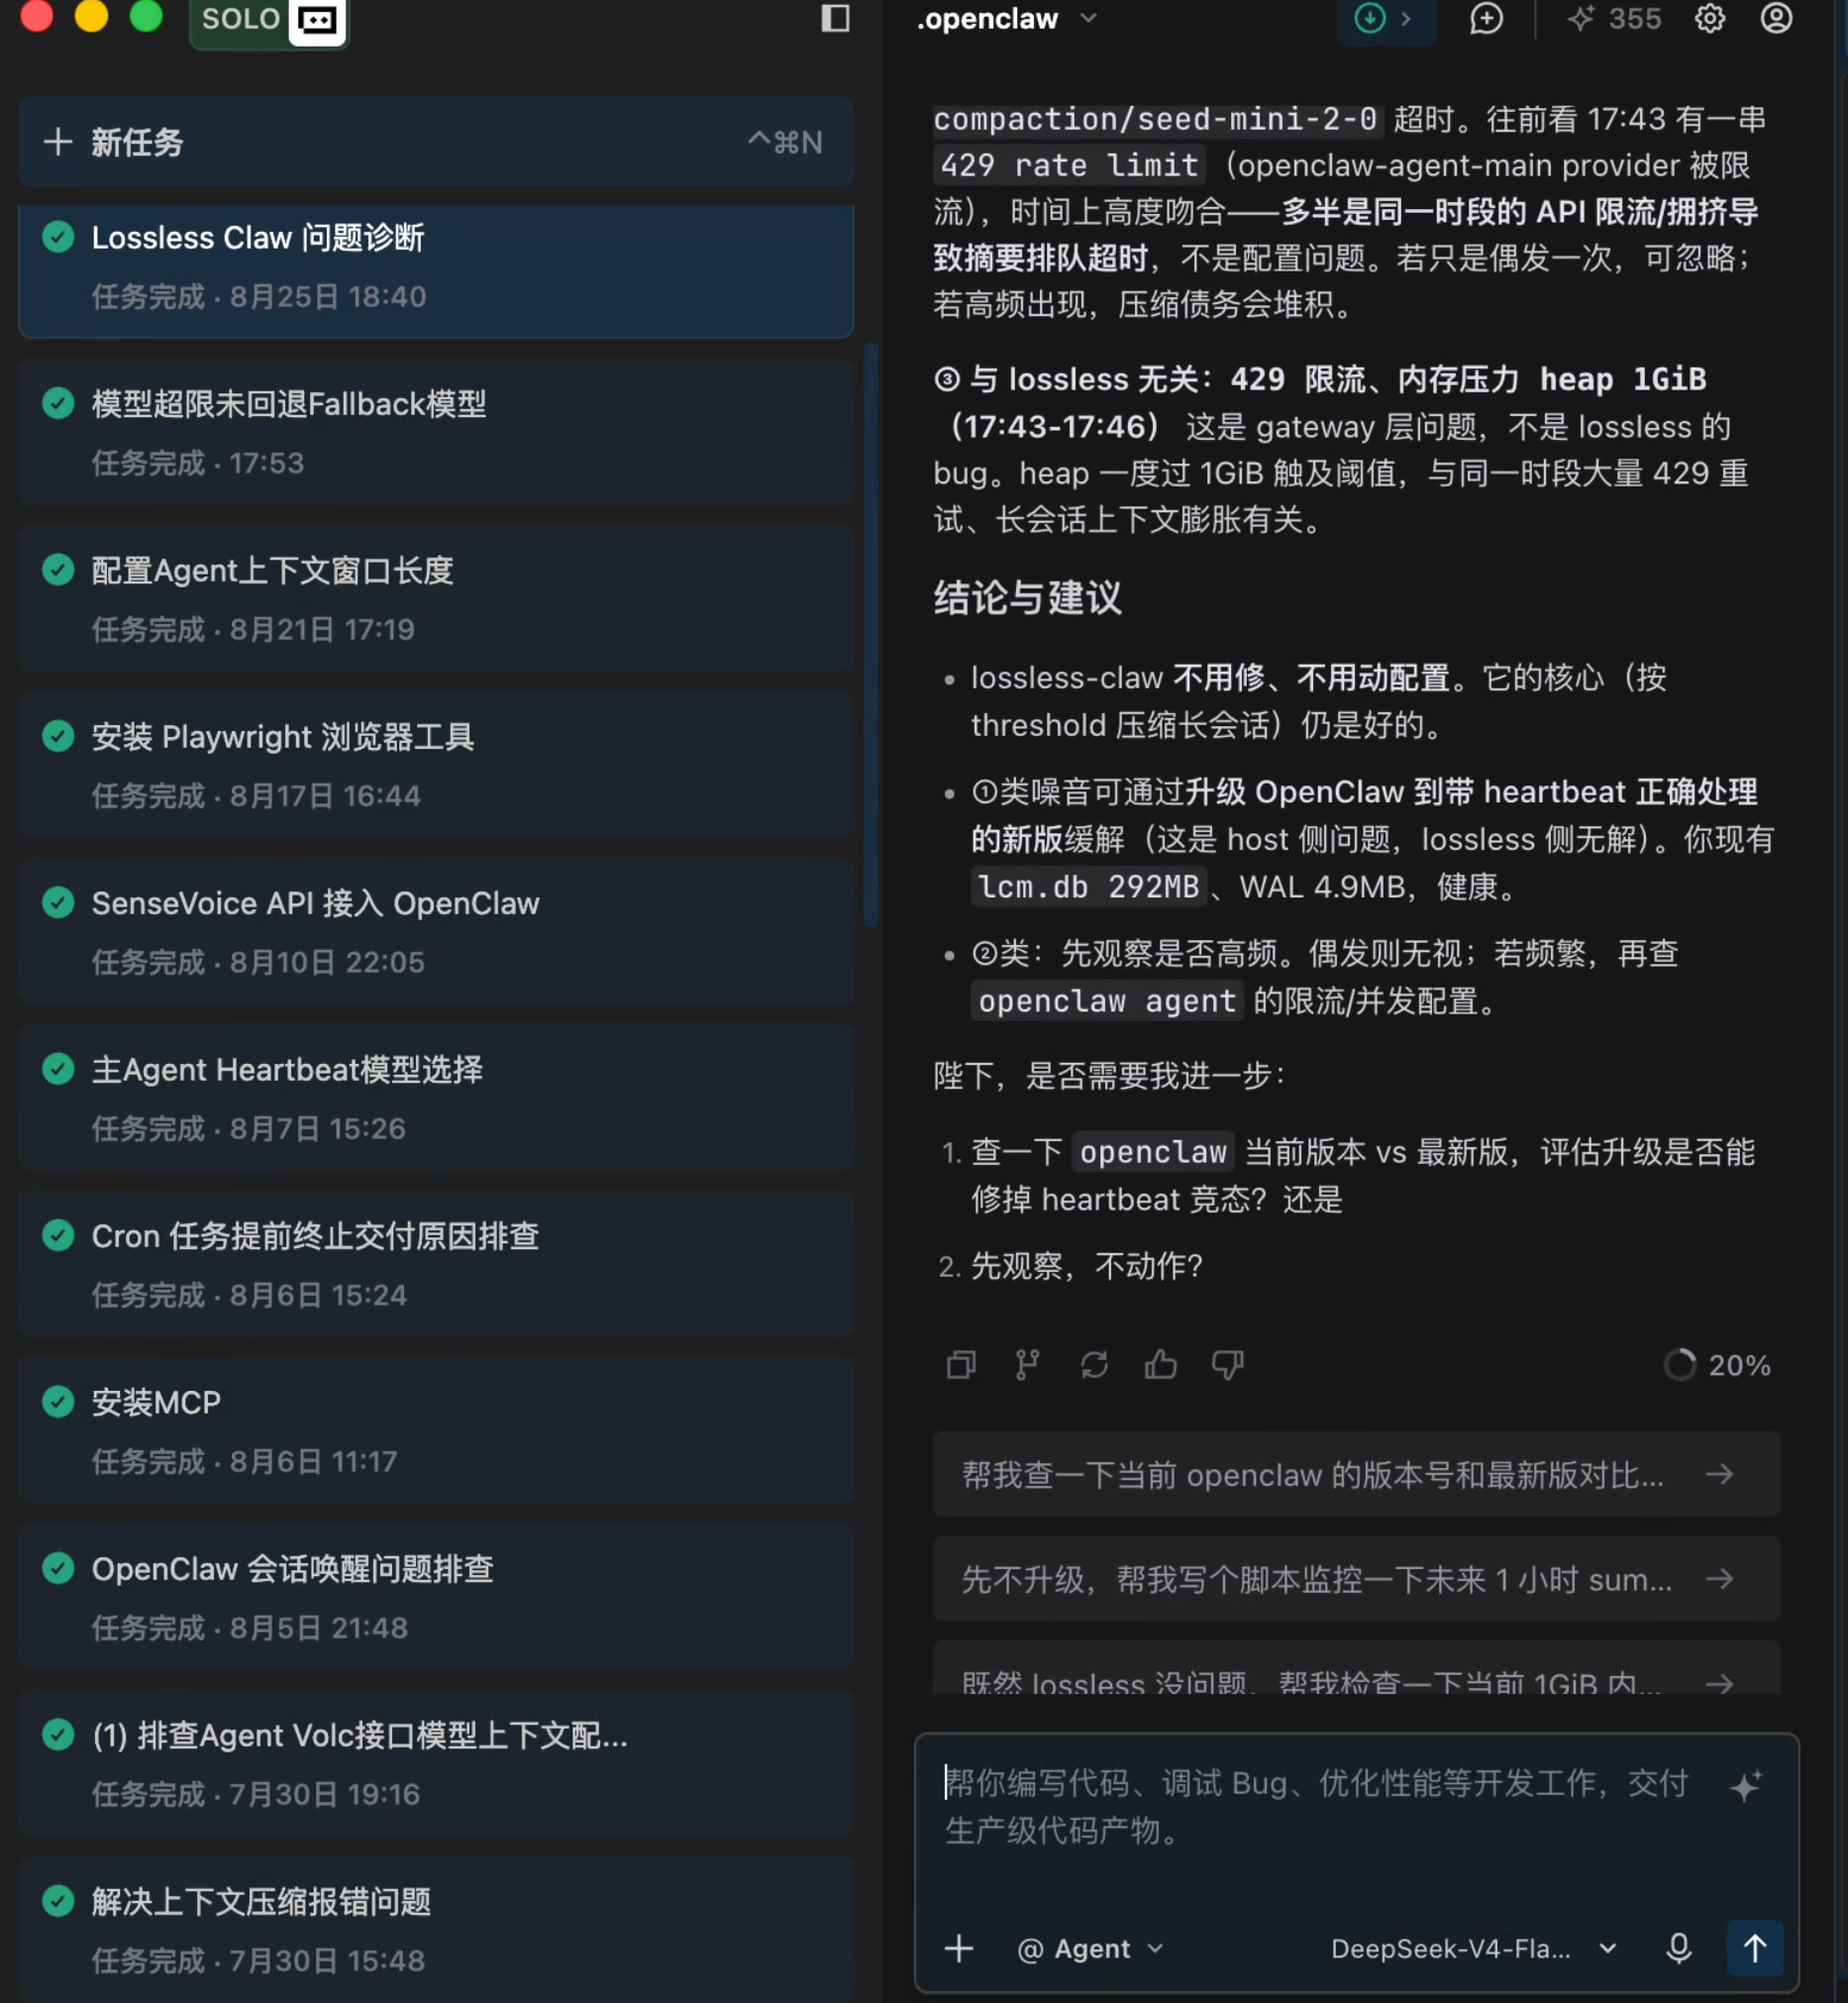
整个解决过程分三步:
第一步:让 TraeCode 先建立对项目的索引 我基于 /.openclaw 的项目自身配置,加上 https://docs.openclaw.ai/ 的官方文档目录,让 TraeCode 建立了一套可检索的索引。
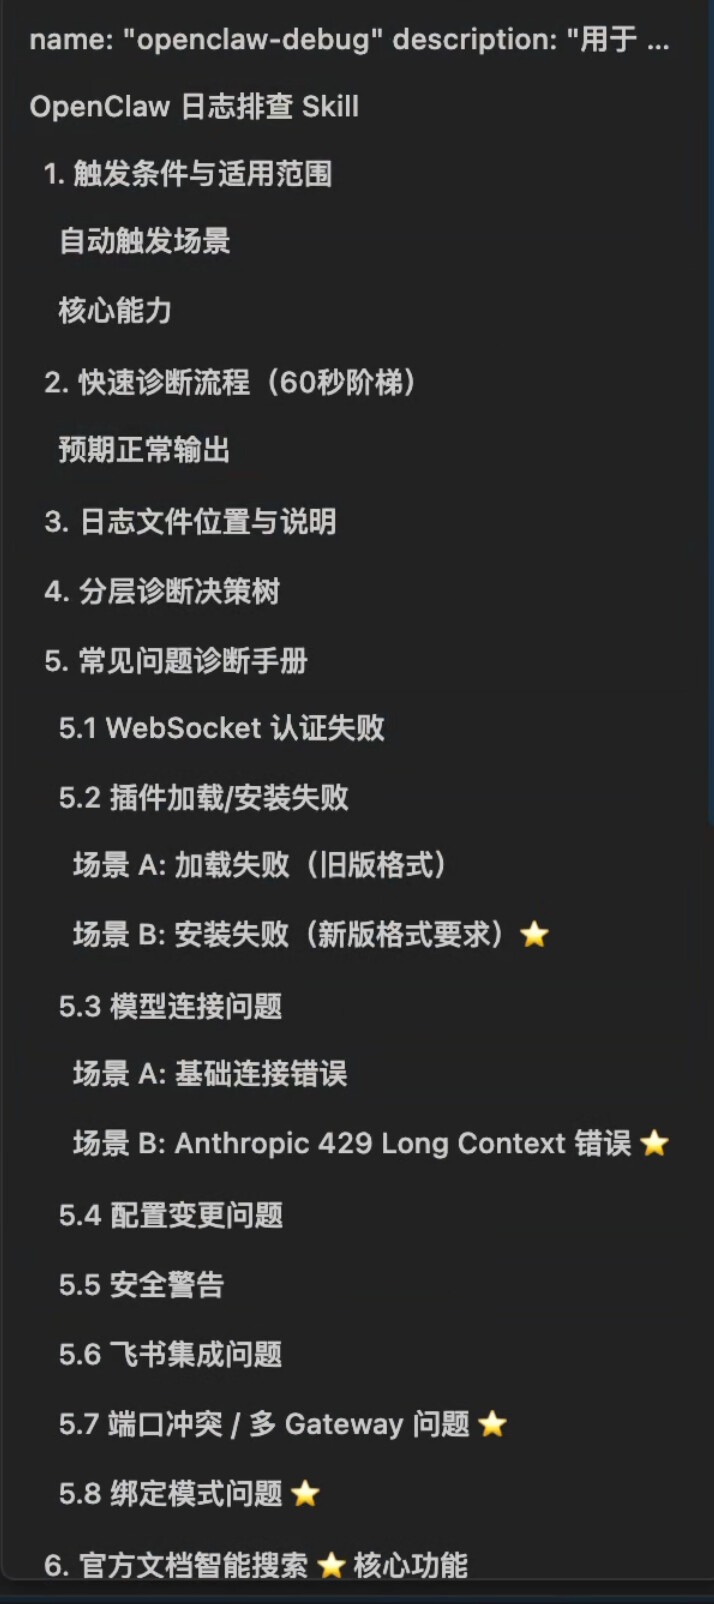
第二步:让它按固定路径排查 bug 真正遇到 debug 需求时,TraeCode 会先搜官方文档 → 再比对本地配置 → 再结合 GitHub 上的 issue,来判断这个 bug 到底是"更新导致的原有配置不当",还是"官方已存在、待解决的 issue"。这个流程帮我判定问题根源,省下了大量日常浪费的时间。
这套 debug 能力本身,也是我用 SOLO 模式自建的 skill,并且会随着日常使用遇到的新情况持续更新。
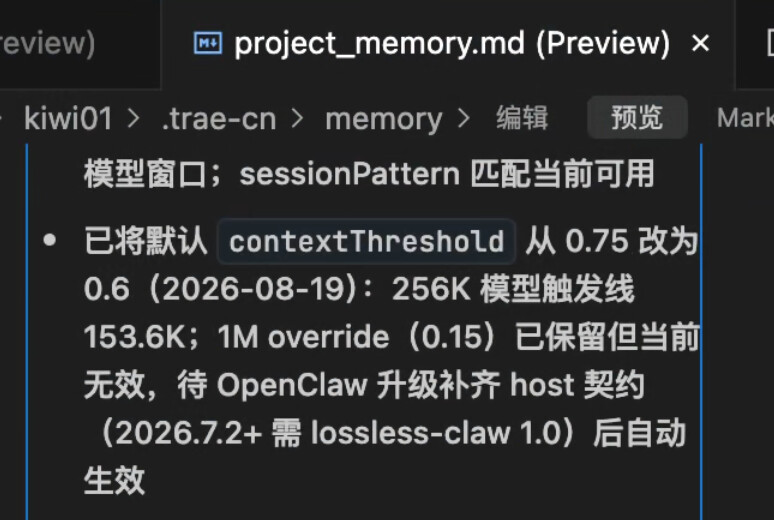
第三步:用项目记忆兜住"临时修复容易忘"的问题 针对那些确认是官方待修复、但短期又改不到的 bug,我会做临时应对措施。可这类临时方案一多就很容易遗漏。我的做法是:让 TraeCode 把临时配置的原因写进项目记忆。这样后续每次做配置或功能调整时,TraeCode 会主动读取项目记忆,并提醒是否需要移除这些临时配置。
举个实际例子:我遇到 lossless 插件无法针对单个模型配置压缩长度 的问题,后来确认后续版本已经修复,但我暂时不想升级 beta 版。就让 TraeCode 在项目记忆里记下这条临时配置及原因,等以后条件成熟再统一处理。
三、成果展示
- 明确交付:以上.
- 解决什么问题、给谁用:这套方法让我脱离"每次 debug 都要从头试错"的循环,自己日常维护 OpenClaw 时直接复用,也方便后续接手的人快速理解为什么会有这些临时配置。
- 是否投入日常使用:已在日常运维中持续投入使用,并随新问题不断演进。
四、效率对比
- 以前:碰到 bug,先手动翻文档、翻配置、翻 GitHub issue,很多时候靠猜和试错,一次 debug 往往折腾大半天,还容易把环境改坏。
- 现在:把问题丢给 TraeCode,按"文档 → 配置 → issue"的顺序自动比对定位,几分钟就能判断问题类型;再加上项目记忆自动记原因,临时修复方案也能被可靠追回,不再靠脑记。
一句话概括:从"手动试错、容易翻车"变成了"自动定位、有据可查、不怕遗忘"。
五、经验和技巧(3 条)
- 先把"上下文"给足,效率翻倍:在 debug 前,先让 TraeCode 基于项目配置 + 官方文档建立索引,比直接抛一个问题给它,定位问题的速度和准确度会明显好很多。
- 能自动化的尽量走 SOLO 模式:像建立索引、搜文档比对配置这类流程化的事,交给 SOLO 自动跑最省心;需要你自己判断和反复微调的场景,再切换手动控制。
- 一个不起眼的坑:注意区分文档归属:TraeCode 容易把 OpenClaw 的 agent 文档误当成自己的。建议在项目规则里写明 TraeCode 自身的目录文件边界,避免和 OpenClaw 的 skill / tools 文档混淆,否则很容易索引错地方。
