一、我是谁,以及我遇到了什么问题
我是一个1.4W人的腾讯频道主,——这是个玩家交流频道,总共 1.4 万+ 成员,日常就是大家聊游戏、发作品、求互访。
问题是这样的: 这个频道以前是"野生状态",人虽然多,但留不住人。新人进来没几天就沉默了,活跃用户全靠老面孔,运营动作全靠我手动在公告栏吼一嗓子,根本没章法。
我想搞个积分体系来盘活频道:
- 签到 +188,发帖 +188,评论 +66;
- 发电量可以抽实物奖、兑换游戏礼包、买广告位(自己的作品顶置子频道);
- 搞排名榜、段位系统(青铜→白银→黄金→王者),给用户成长感。
但我得自己写个频道机器人来落地这套体系。问题来了——我是物联网专业的,Python 能写点小脚本,但要搞定一个能支撑 1.4w 人、还要对接腾讯频道官方 WebSocket API、还要带管理后台、还要防并发扣积分出错的机器人,光靠我自己以前那点水平,真的没底。算一下:
- 机器人核心逻辑(签到/发帖/抽奖/兑换)
- 管理后台页面(用户管理、订单审核、广告投放、数据面板)
- 腾讯频道 WS 长连接 + 权限 intents 订阅
- 数据库设计(用户表 / 积分流水表 / 订单表 / 抽奖表…)
- 跨机器人数据迁移(原来的第三方机器人里还有一堆老用户数据)
我一个人从零手写,保守估计至少 2 周,还一堆 bug 上线了才发现。我一个学生,真没这么多时间。
二、我是怎么用 TraeCode 解决这件事的
我主要是 IDE 模式(讨论 + 决策)+ Solo 模式(分模块交付)结合,大架构我自己把控,具体实现细节全部甩给 TraeCode。
第一步:先定骨架 —— 聊透技术选型和架构
我没有一上来就让它"写个机器人"。第一步是纯讨论:
我问 TraeCode(大致原话):
“我要做腾讯频道机器人,1.4 万人用,用户规模不小。给我出个架构:数据库选啥、API 怎么组织、后台页面用什么形式、积分扣减怎么防并发超扣?”
聊了几轮后定下来:
- 技术栈:Python + aiohttp + SQLite(1.4 万人 SQLite 完全扛得住,不用上 MySQL 增加部署复杂度,这是 TraeCode 主动建议的,说到「你一个学生部署一个 SQLite 最省心,等真到了 10w+ 再迁」);
- 积分防超扣:所有加减积分的操作统一走
power_ledger流水表 + 事务 + SQL 原子更新UPDATE users SET balance = balance - ? WHERE id = ? AND balance >= ?,影响行数=0 就回滚——这个我以前根本想不到,我以前写过的扣积分逻辑就是先查再减,并发一高肯定超扣; - QQ 频道权限:intents 必须同时订阅
1<<30(私域频道消息)+1<<9(公域频道 @消息),之前很多开发者只配一个导致收不到消息; - 后台形态:
admin.html单文件 SPA 页面 +api_server.py做后端接口——不用前后端分离,不用装 Node,不用 npm build,双击 html 就能用,最适合我这种懒人。
第二步:模块化切分,一块一块交任务给 Solo
定完架构,我就拆模块了。我没有把"写整个机器人"当一个任务扔给 Solo,那样它容易写飘。我是一块一块地派单,写完一块立刻跑验证:
派单 1:数据库设计(database.py)
「给这个积分运营系统设计 20+ 张表:users、power_ledger、checkins、orders、lottery_records、announcements、daily_activity_records、analytics_reports、external_migration_records、migration_user_submissions… 索引要给齐,users 要有段位、经验、签到连续天数、是否测试号字段;流水表要留可逆类型;外键不用、用 SQLite。」
TraeCode 写完后,它自己写了 _test_migration.py 测试所有表的增删改查和事务一致性,我只需要点开看测试全绿就行。
派单 2:业务服务层(services.py)
这是最厚的一层,1800+ 行,包括:
UserService— 注册、查用户、get_or_create 防重复;CheckinService— 每日签到(带连续天数奖励)+ 防重复签到;LotteryService— 抽奖(概率权重、库存、每日限抽、每人限中 N 次)多奖品配置化;OrderService— 订单(待付款/进行中/已完成/失败/过期)+ 30 秒轮询订单超时取消;PostRewardService— 发帖 +188 / 评论 +66,带 15 秒 WS msg_id 级幂等去重 + 6 秒业务级内容去重双层拦截(防用户刷屏刷发电);MigrationService— 跨机器人迁移服务(这个是后面加的,单独派的单):待认领池 + 用户自提 + 审批流 + 昵称相似度匹配 + 批次回滚。
派单 3:机器人核心(bot.py)
- QQ 官方 WebSocket 长连接 + 断线自动重连(5 秒间隔重试,保证机器人不会"假死");
- 20+ 个用户命令:
菜单 / 签到 / 我的发电库 / 我的签到 / 我的流水 / 我的排名 / 发电量榜 / 活跃排名 / 抽奖 / 订单 / 服务 / 广告投稿 / 我的迁移 提交 ...; - 两个自动认领钩子:用户注册时查迁移待认领池、用户发消息时也查一次,不用等用户主动申请就能自动迁数据;
- 定时任务调度器(apscheduler):每天 9:00 定点宣传推送、每周一 10:00 置顶帖、每天 9:30 子频道自动推送排行榜。
派单 4:管理后台(api_server.py + admin.html)
- 100+ 个 API 接口(用户、订单、抽奖、广告、充值、迁移、数据分析…);
- 「
 一键重载」按钮:路由热重载,改完
api_server.py新接口不用重启 API 服务,点一下按钮就生效; - 管理后台 20+ 菜单:
 数据分析(日活/积分趋势/用户转化漏斗)
 频道用户 /
 创作者中心 /
 充值审核
 商品管理 /
 订单管理(带状态下拉改成进行中/完成/失败/取消)
 举报中心 /
 签到管理 /
 发帖评论
 抽奖管理 /
 等级管理(段位名+经验配置+用户排名预览)
 广告管理 /
 电量流水 / 外部数据迁移(三Tab:批次/待认领池/用户申请审批)
第三步:Bug 调试 + 修复 —— 从日志到定位不超过 3 分钟
最让我爽的是遇到报错不用自己翻半天堆栈。比如我用户发「我的积分」时,bot 返回了"小游出了点小问题"。我把 bot_auto.log 最后 20 行直接扔给 TraeCode:
AttributeError: 'Author' object has no attribute 'nickname'
  File "bot.py", line 1825, in _show_points
    user = await self._db(UserService.get_or_create_user, qq_id, message.author.nickname or message.author.username or "用户")
它 10 秒内就告诉我:QQ 官方新版 SDK 的 Author 对象用 username 不用 nickname,让我把所有 message.author.nickname 改成 getattr(message.author, 'nickname', None) or getattr(message.author, 'username', '') or '用户',一次性把 _show_points、_show_my_rank、_cmd_check_migration 三个地方都修掉,重跑一遍冒烟测试就过了。
三、成果展示
整个机器人和后台上线后,我一个人维护 1.4 万人的频道完全没问题。具体成果:
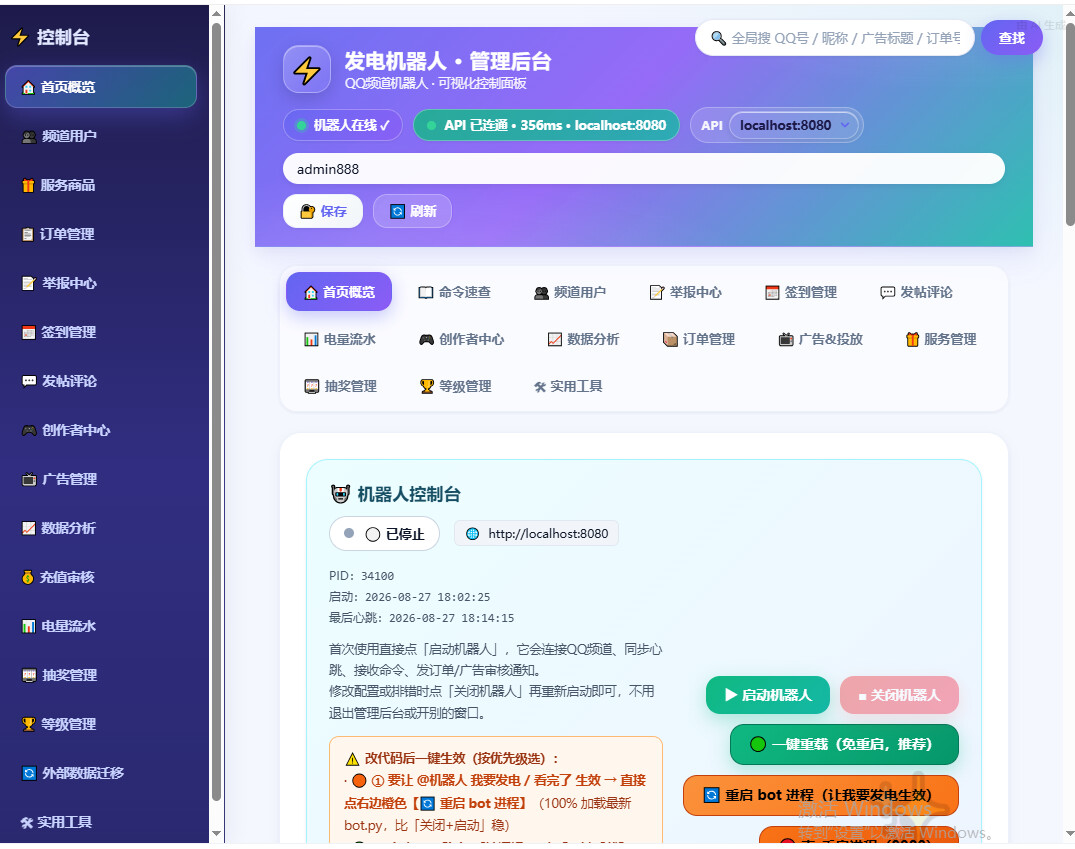
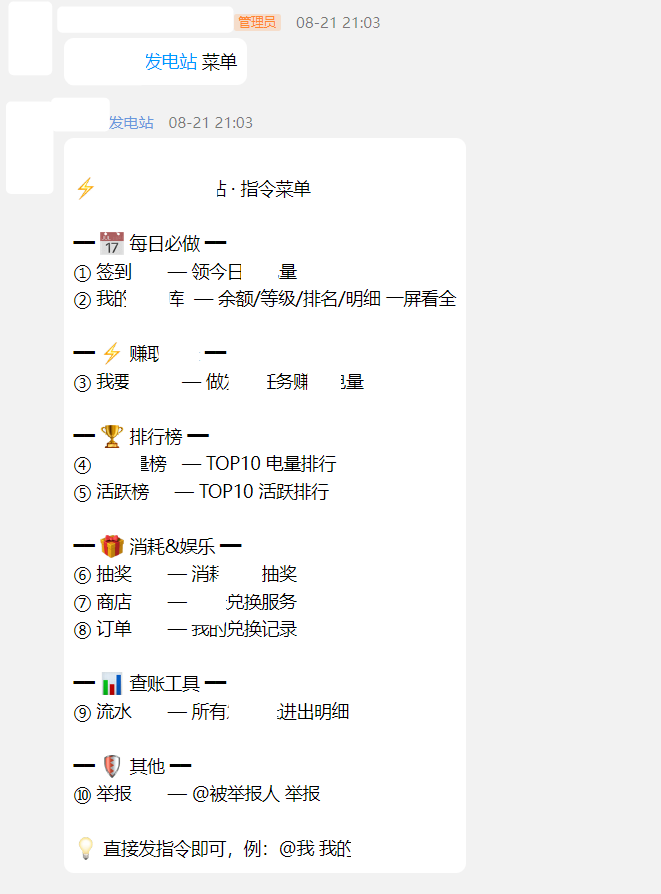
现在日常运营完全不用我守着:
- 用户签到/发帖/评论:bot 自动加发电量;
- 用户申请抽奖/兑换:系统自动处理,有异常后台会报;
- 用户迁移老数据:自己 @机器人 提交,后台点审批就行;
- 我每天只要打开管理后台看 5 分钟数据面板:今日 DAU、新增用户、订单异常、待审批数 —— 全在一张首页概览上,一目了然。
四、效率对比
这个对比对我来说真的是"肉眼可见":
| 维度 | 以前(不用 TraeCode) | 现在(用 TraeCode) |
|---|---|---|
| 架构设计 | 瞎想,不知道 1.4w 人 SQLite 能不能扛,不知道积分怎么防并发 | 和 TraeCode 聊 20 分钟定好技术栈 + 原子更新防超扣 + 双层幂等去重 |
| 代码量(估计) | 1500+ 行全部自己写,每个函数查文档、调试、重写,估计 2 周 | 自己写决策代码,TraeCode 写实现代码 4000+ 行(6 个核心文件),4 天交付 |
| Bug 排查 | 积分少扣了?翻日志 1 小时找不到原因 | 把报错行扔给 TraeCode,3 分钟定位 + 3 处同步修复,10 分钟解决 |
| 管理后台 | 本来想省了,直接操作数据库……太危险,放弃 | admin.html 20+ 菜单 + 100+ API,单文件 SPA,双击就用,运营效率至少 ×5 |
| 跨机器人迁移 | 对着 1 万张截图抄 CSV,人工核对昵称,3 天起步 + 必然错漏 | 待认领池 + 用户自提审批 + 批次回滚,半天写完,用户自己操作 80%,我只要点大额审批 |
| 总投入时间 | 保守估计 14 天,还一堆隐性 bug 上线才出 | 4 天全链路跑通(数据库 → 服务 → bot → API → 后台 → 冒烟测试),8 个迁移场景全部冒烟全绿 |
最关键的是:我以前根本不敢想一个人搞定 1.4 万人的频道机器人,觉得这至少得一个小团队。现在 TraeCode 帮我扛了 80% 的「体力活代码」,我只需要做我最擅长的事:想清楚运营要什么、定规则、卡阈值、拍板要不要改——这两件事加起来,我一个学生 + 一个 AI 就能顶上一个小团队的产出。
五、经验和技巧总结(3 条给新手的硬核经验)
技巧 1:大任务千万别"一锅端"给 Solo,要按架构分层派单
我如果直接说"给我写一个支持 1.4 万人的 QQ 频道运营机器人",它肯定会东写一块西写一块,最后产物大概率散架。正确派单顺序是:
- 先派「数据库设计」→ 验证所有表和约束;
- 再派「服务层」→ 业务逻辑全写 services 里,bot 和 api 只调用;
- 再派「bot.py」→ 套上 WS 连接 + 命令路由;
- 再派「API + 后台」→ 套上权限校验 + 页面;
- 最后单独派「冒烟测试」→ 自己写自己跑自己修。
一层验证过了再下一层,不返工。
技巧 2:让它写"防御性代码",比你自己想防坑靠谱
我自己设计积分扣减的时候只会"先查再减"。TraeCode 主动加了三层防御:
- SQL 原子更新:
balance = balance - ? WHERE balance >= ?,行数=0 就失败,并发再高也扣不穿; power_ledger流水表:每笔变动 type/sub_type/note 全记,可逆可查可回滚;- 事务包起来:扣积分 + 写订单 + 写流水是一个事务,半中间崩了也不会出现半状态。
你不用告诉它怎么防,你只要说"这是钱/积分,不能错",它就懂该加什么。
技巧 3:不要跳过"日志里拿报错 → 扔给 TraeCode 定位"这条捷径
以前报错我要自己看堆栈、追变量、搜文档,一个 AttributeError 可能查半小时。现在我把 bot 日志最后 20 行(包含 Traceback 的部分)整段复制给 TraeCode,它 10 秒内给我根因 + 修复位置 + 同步修复所有同类问题——这条捷径至少帮我省了 5 小时以上的调试时间。
最后想说一句话:以前一直觉得「开发一个能给 1.4 万人用的系统」这种事离我很远,得毕业进大厂跟着团队才能接触到。现在有了 TraeCode,我一个大二学生,在上课 +的间隙,4 天就把整套机器人 + 后台 + 迁移系统做出来了——真的,工具不是帮你替代思考,而是帮你把思考的结果落地得更快、更稳、更敢做更大的事。