【TraeCode的100种用法】我用 TraeCode 从零搭建智能 BI 平台,让业务人员用自然语言自助取数分析
案例类型:SOLO 模式 | 从 0 到 1 创建项目 | 数据分析 / 产品场景
版本:v1.0 | 数据产品负责人 2026-08-27
一、我是谁,以及我遇到了什么问题
我是公司数据分析负责人,负责内部数据平台的架构设计与落地。
日常工作里最典型的痛点:业务人员不会 SQL。运营、财务、市场团队每天都要取数分析,但完全依赖 BA帮忙写 SQL——一个简单的查询,平均要等 2-4 小时。除此之外还有:
- 口径不统一:同一个"获额人数",不同团队问出来的口径不一样,口径靠口口相传
- 元数据靠人记:字段含义、层级关系(比如"总计行没有二级分类"这类业务规则)没有沉淀,AI 生成 SQL 经常"猜错"
- 查询不可控:没有审计,谁查了什么、查了多少行,完全无记录
- 可视化要靠开发:取到数还要再找前端做图表,链路很长
我的目标:用 TraeCode 快速搭一套开箱即用的智能 BI 平台,让非技术人员用自然语言自助完成数据分析,同时给专业用户保留 SQL 工作台,做到安全可控、权限清晰、操作可追溯。
二、我是怎么用 TraeCode 解决这件事的
2.1 使用模式
整个过程主要使用 SOLO 模式(Agent 自主规划与执行),关键节点用 IDE 模式人工把关。核心思路:先用文字把 PRD 写清楚,再让 Agent 分模块落地。
2.2 第一步:写清规格,让 Agent 有章可循
我先在 TraeCode 里描述了平台全貌(5 大模块 + 多 Agent 架构 + DeepSeek 大模型),让它输出规格文档 spec.md / tasks.md / checklist.md,把"智能取数、智能分析、智能看板、数据口径管理、数据源管理"拆成 16 个可实现的任务,确认后再开工。这一步的关键是先对齐需求再写代码,避免 Agent 做偏。
2.3 第二步:技术栈与架构
- 前端:React 18 + Vite + Ant Design 5 + ECharts(PowerBI 黄黑主题)
- 后端:Python FastAPI
- 大模型:DeepSeek(deepseek-v4-flash),OpenAI 兼容接口
- 数据源:SQLite(三个 Excel 测试数据源自动转成单库多表,支持跨表 JOIN)
- 多 Agent 流水线:意图识别 → Schema 注入 → SQL 生成 → 安全校验 → 执行 → 可视化 → AI 解读
整个流程:用户输入一句中文问题,系统自动完成 NL→SQL→执行→图表→解读→可加入看板 全流程。
2.4 第三步:模块开发与截图
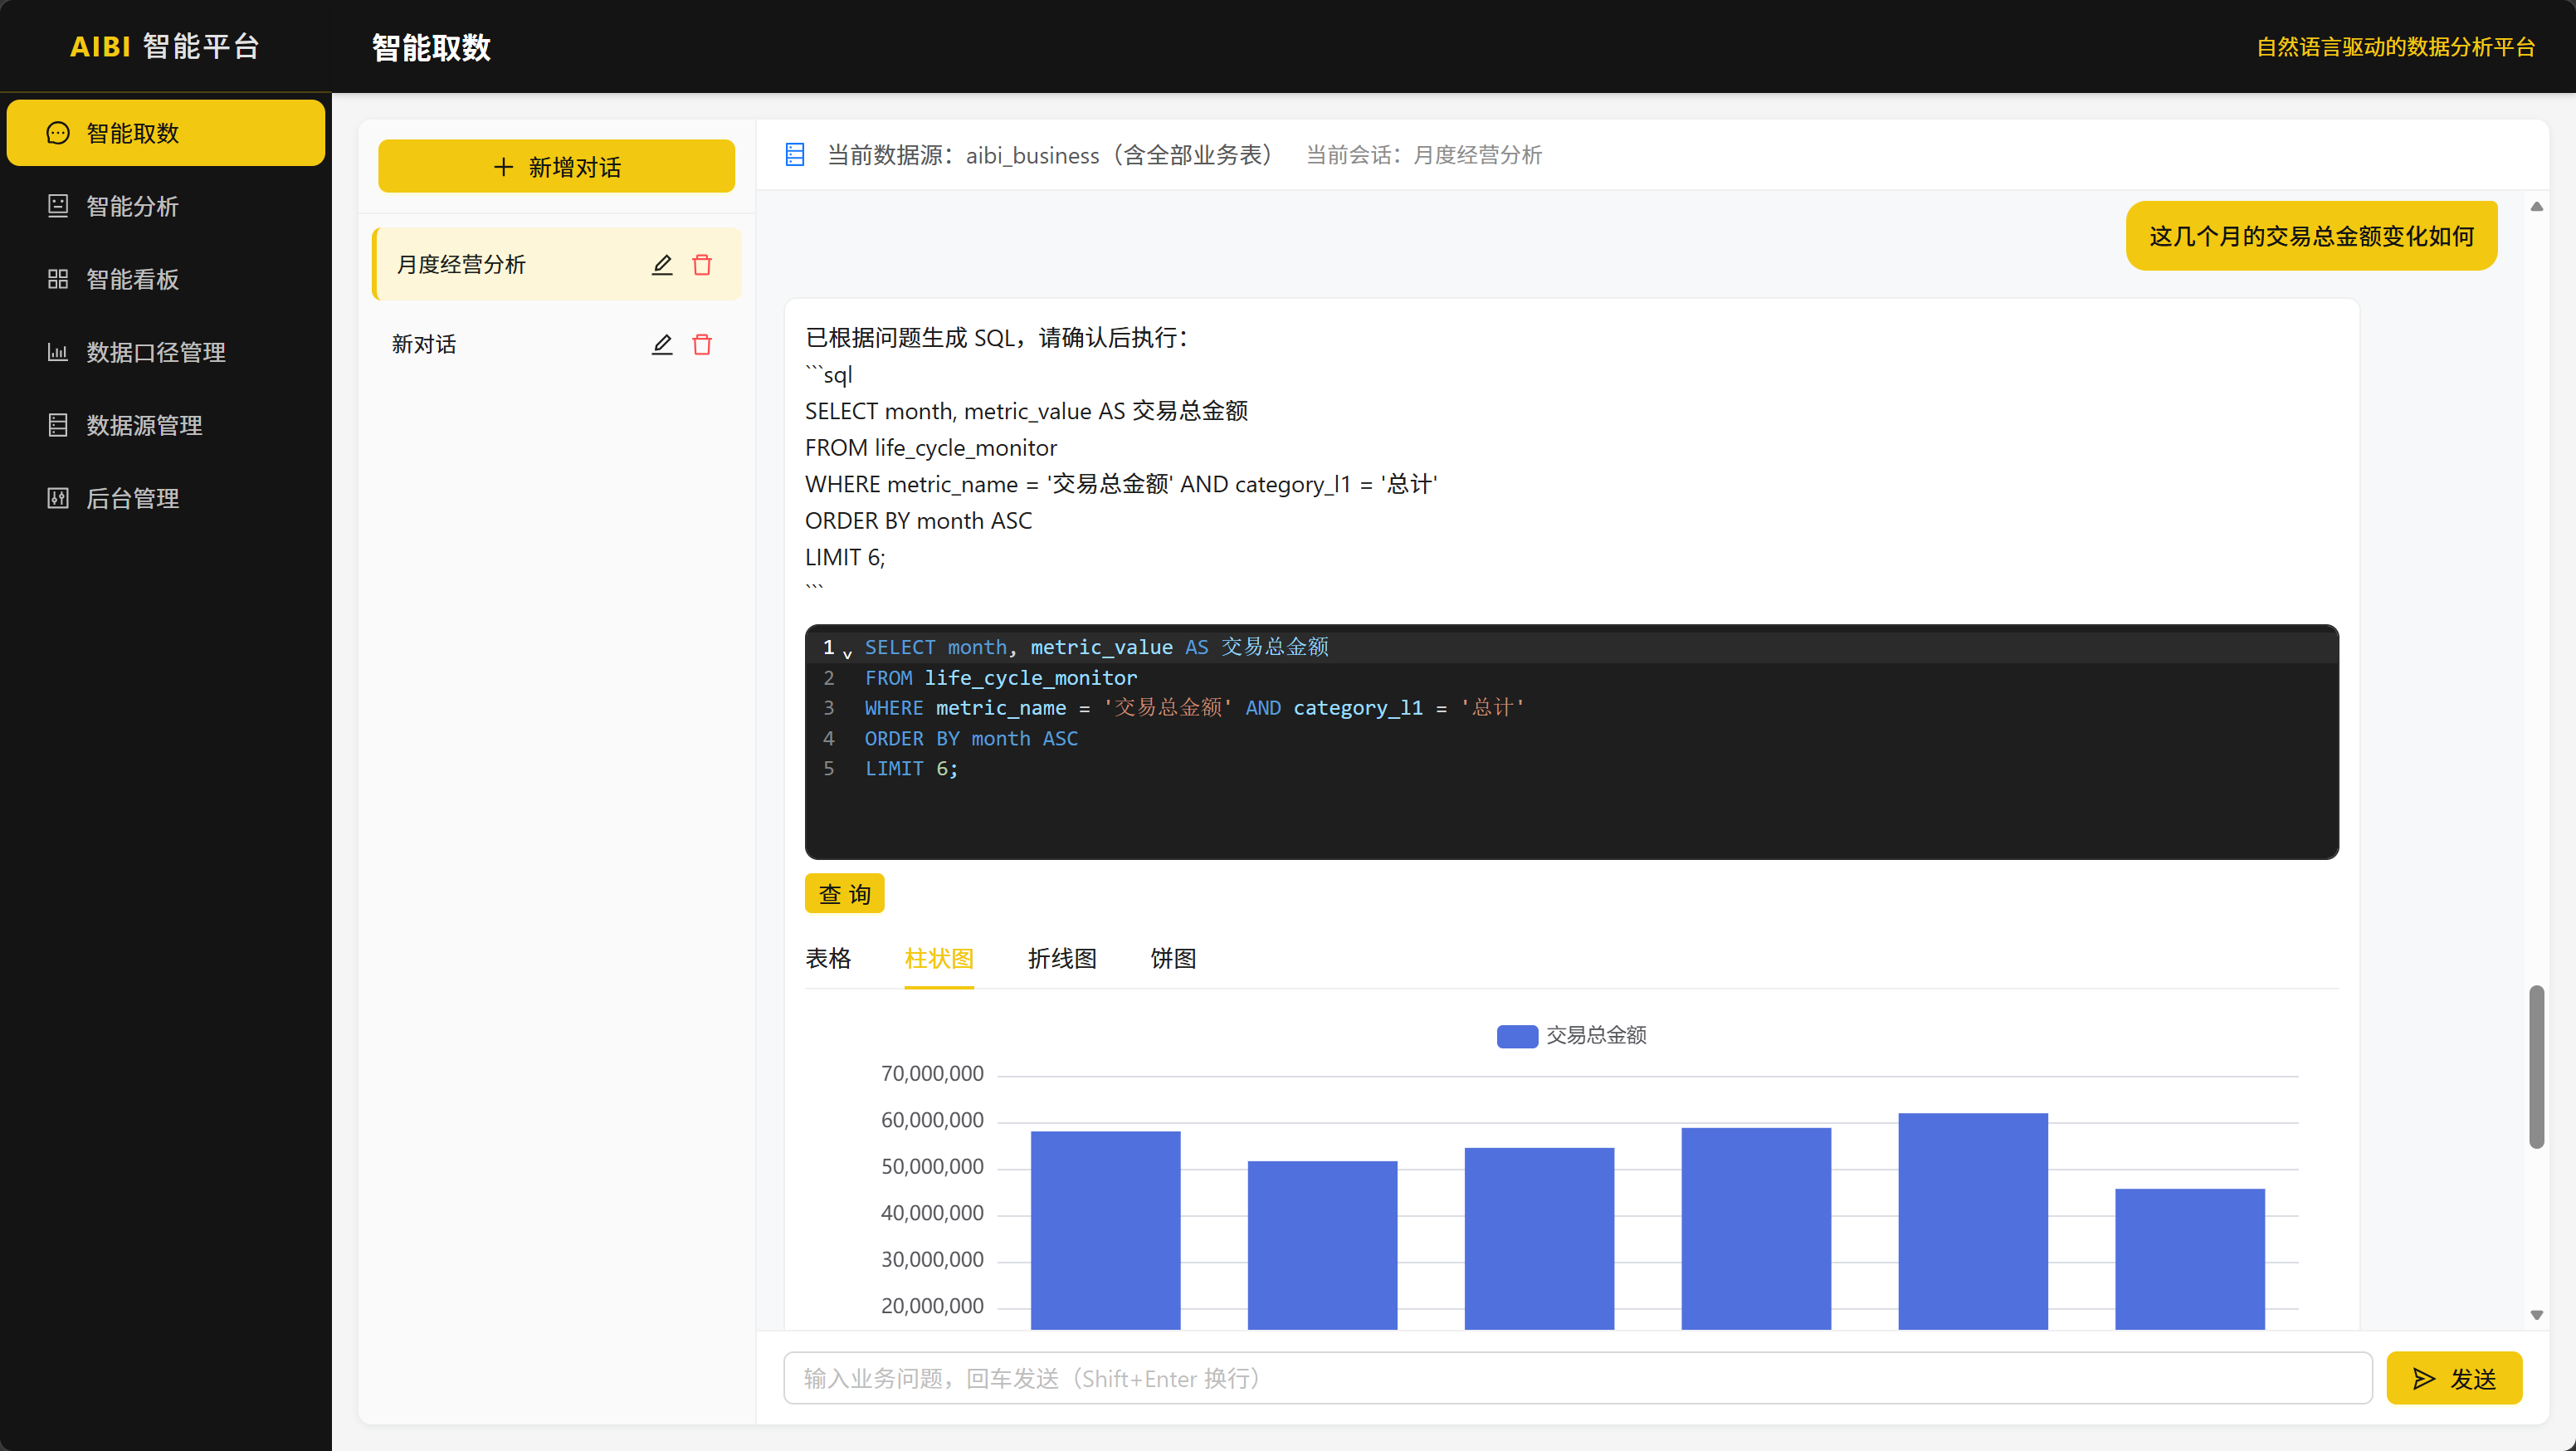
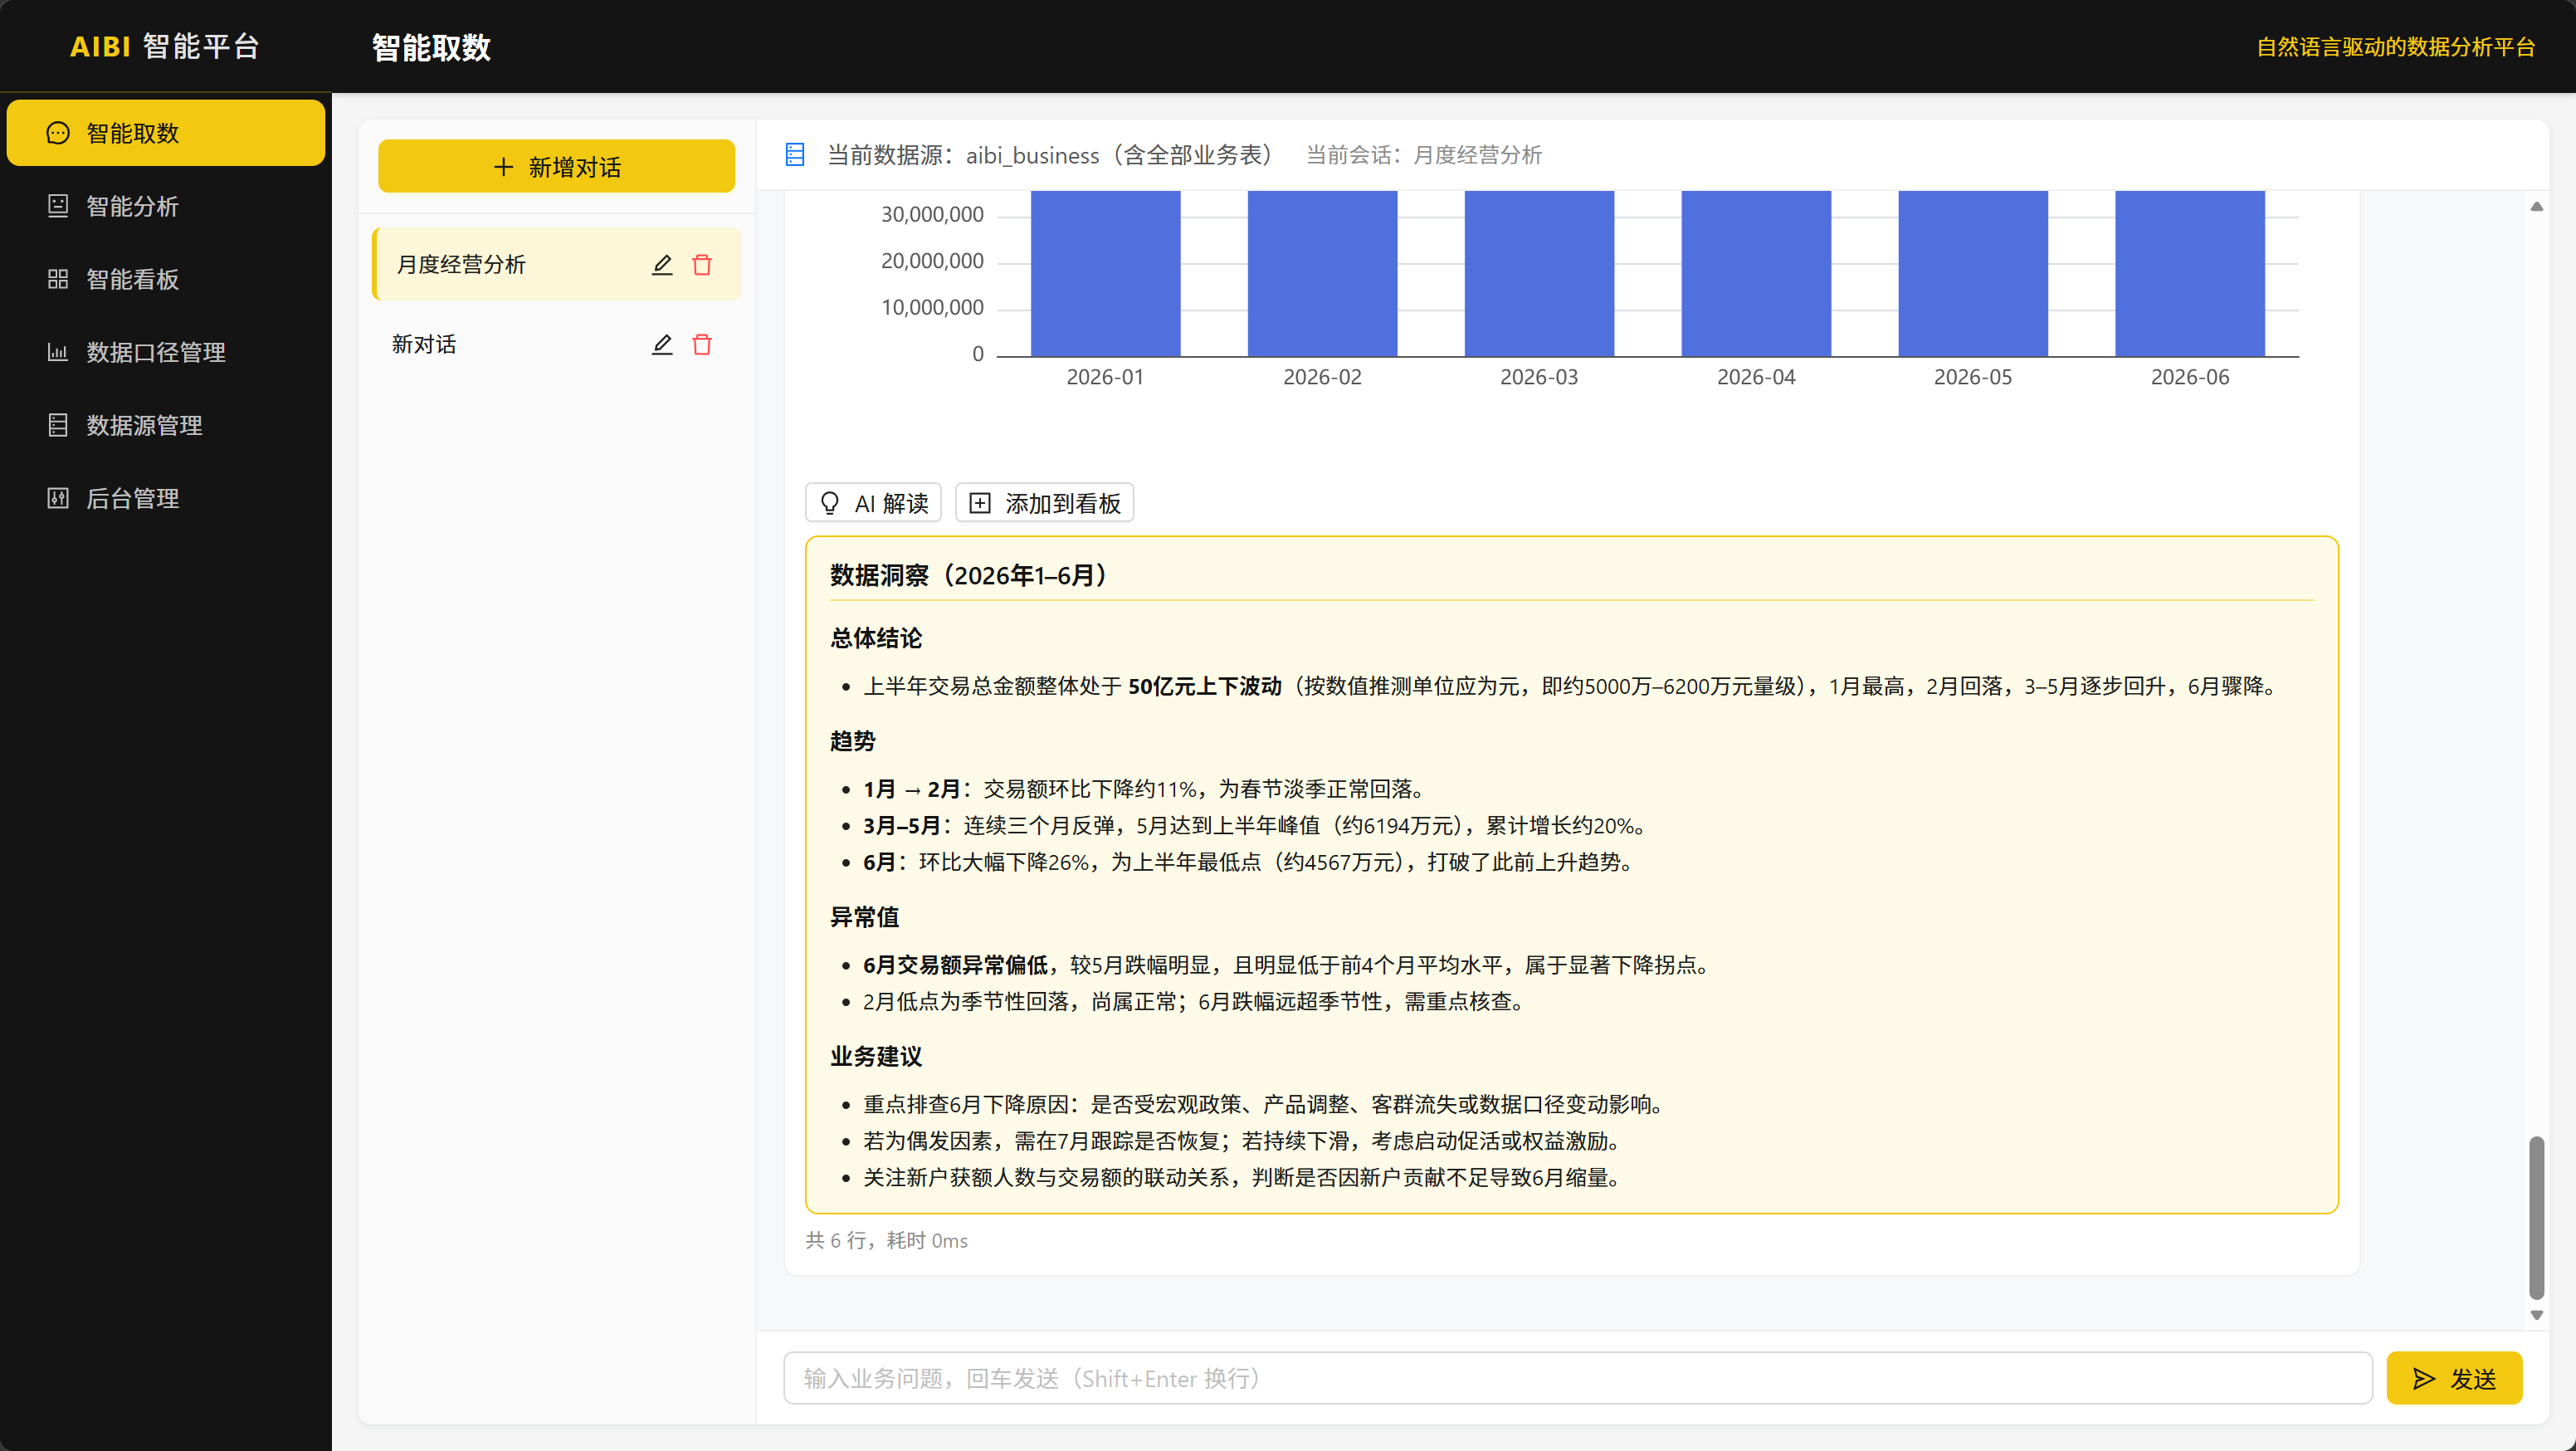
① 智能取数 —— 自然语言对话式取数(核心)
业务人员输入"这几个月的交易总金额变化如何",AI 自动生成 SQL,用户确认/修改后一键执行,结果支持表格、柱状图、折线图、饼图切换,还能让 AI 生成数据解读(Markdown 渲染),并一键添加到看板。
② 智能看板 —— 图表管理与大屏
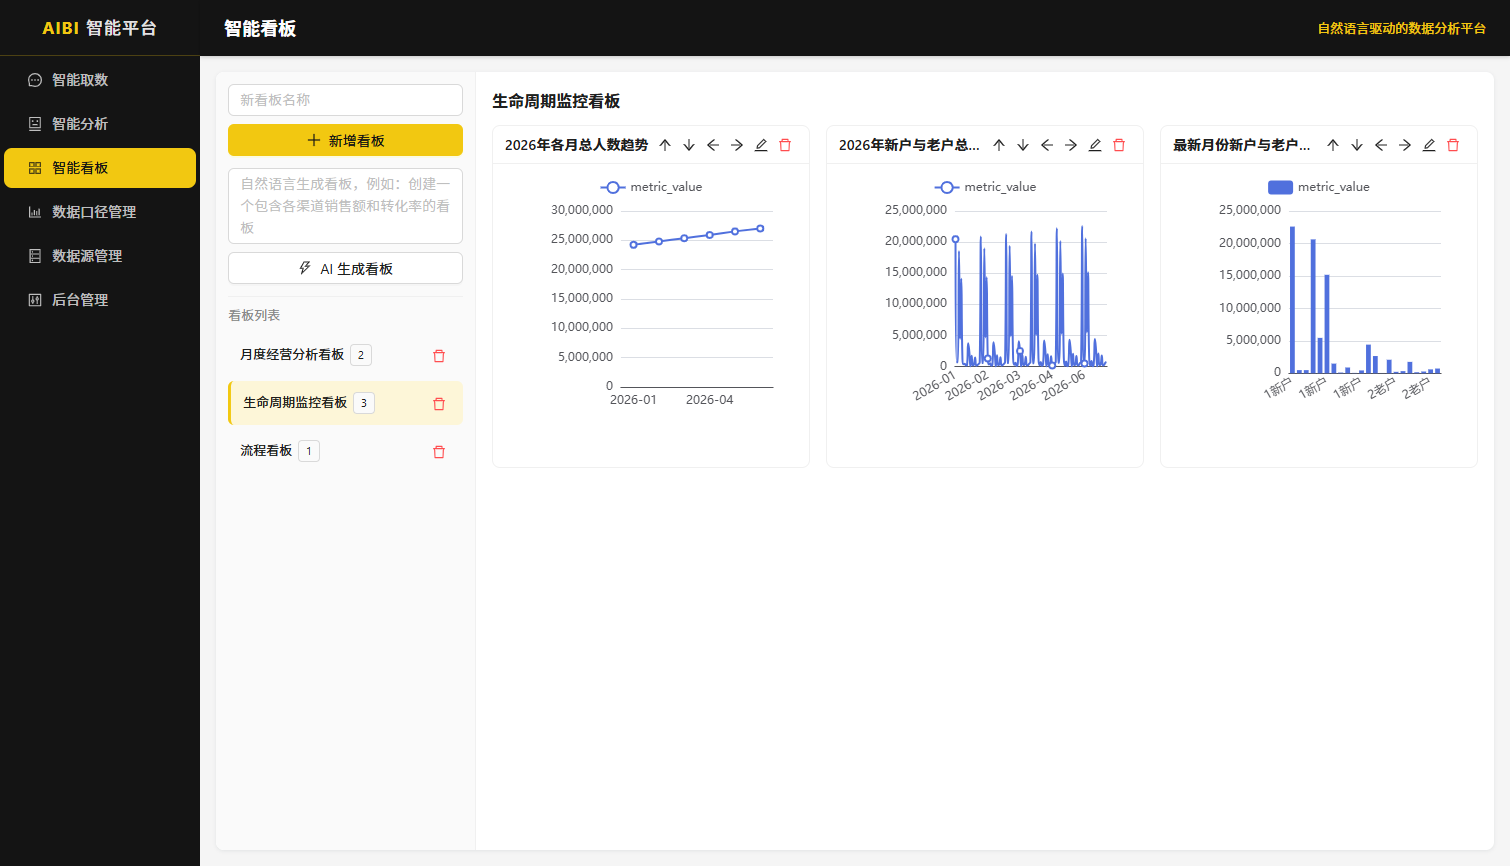
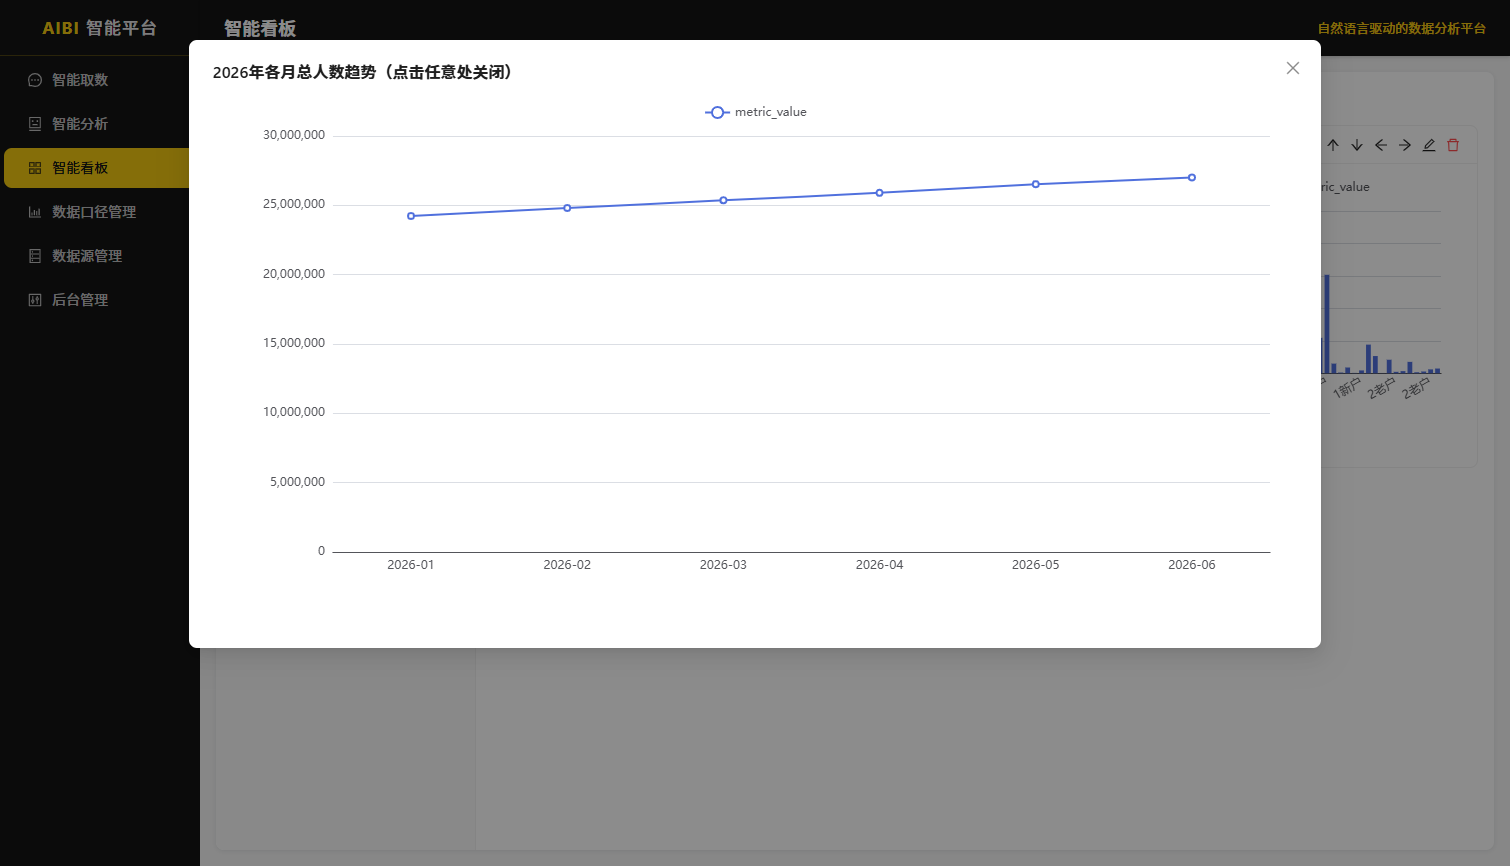
取数结果可一键加入看板,支持自定义布局、设置时间区间与自动刷新间隔、编辑图表 SQL 与可视化类型;点击图表可放大查看大图;还支持用一句话让 AI 直接生成整个看板。
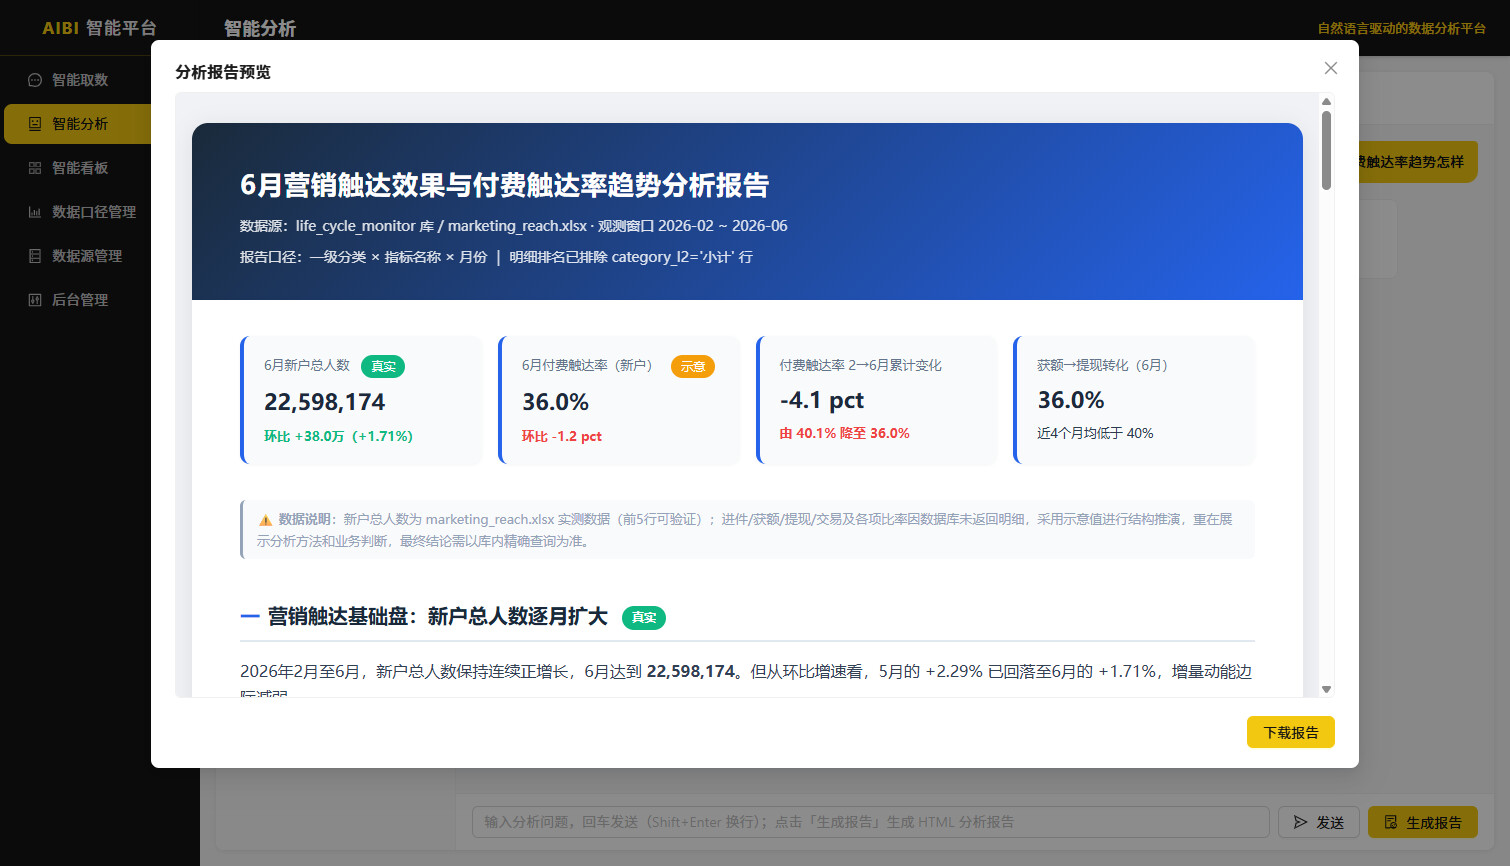
③ 智能分析 —— 上传文件 + 宽泛问题 → HTML 分析报告
支持多轮对话,用户上传 Excel/CSV 后提一个宽泛问题(如"这个月的业务情况如何?哪些方面表现好"),系统自动查询数据库或分析上传文件,生成完整的 HTML 分析报告,支持预览与下载。
④ 数据口径管理 —— 统一指标口径
把常用指标口径(名称/描述/SQL)沉淀为文档,作为智能取数的查询语料注入提示词,AI 生成 SQL 时优先按已定义口径取数,杜绝"同一个指标多个答案"。

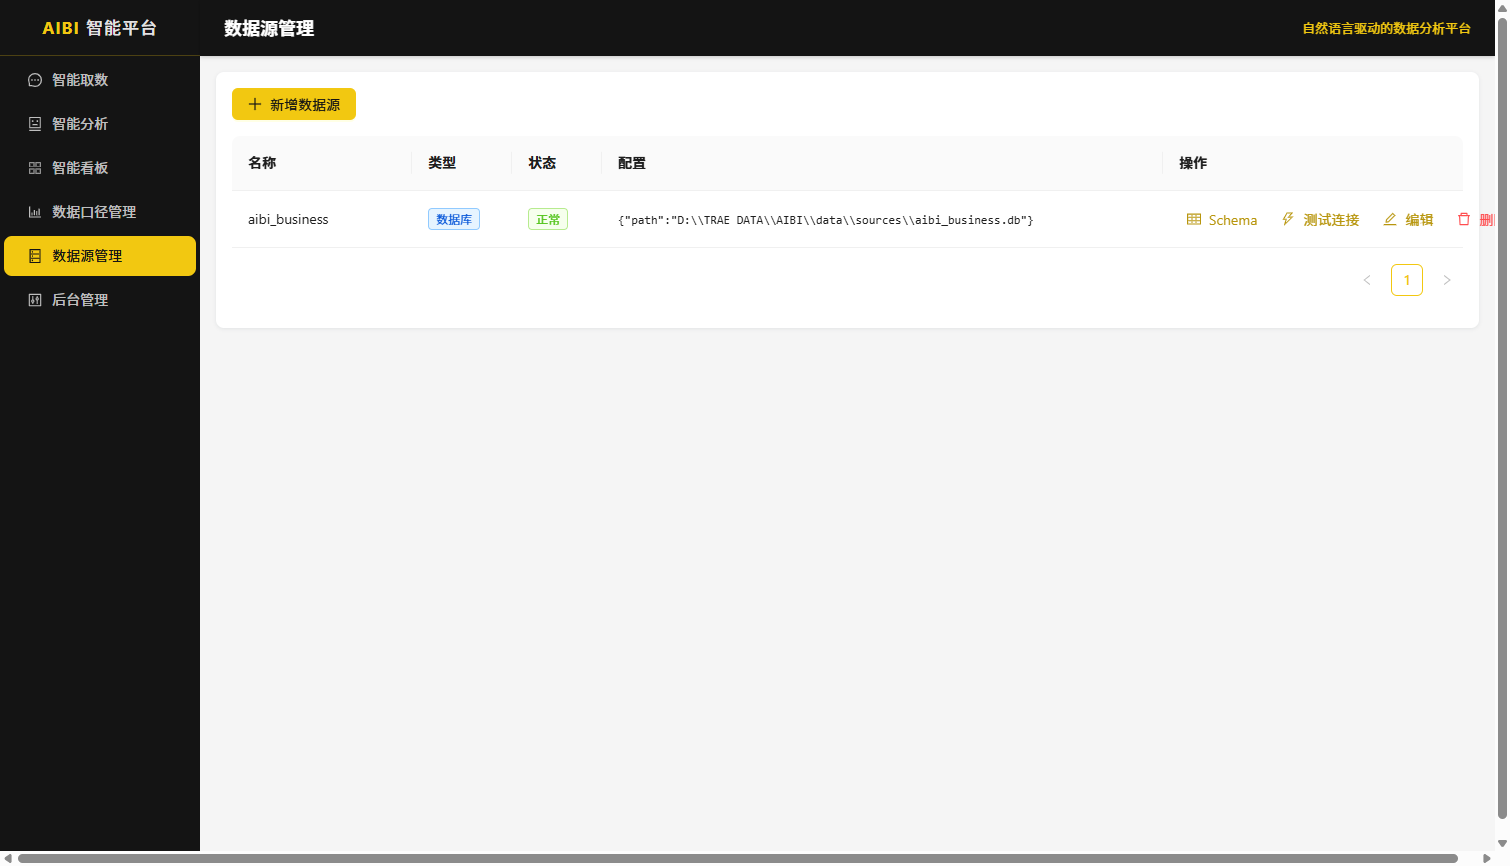
⑤ 数据源管理与 Schema 管理 —— 让 AI"懂"数据
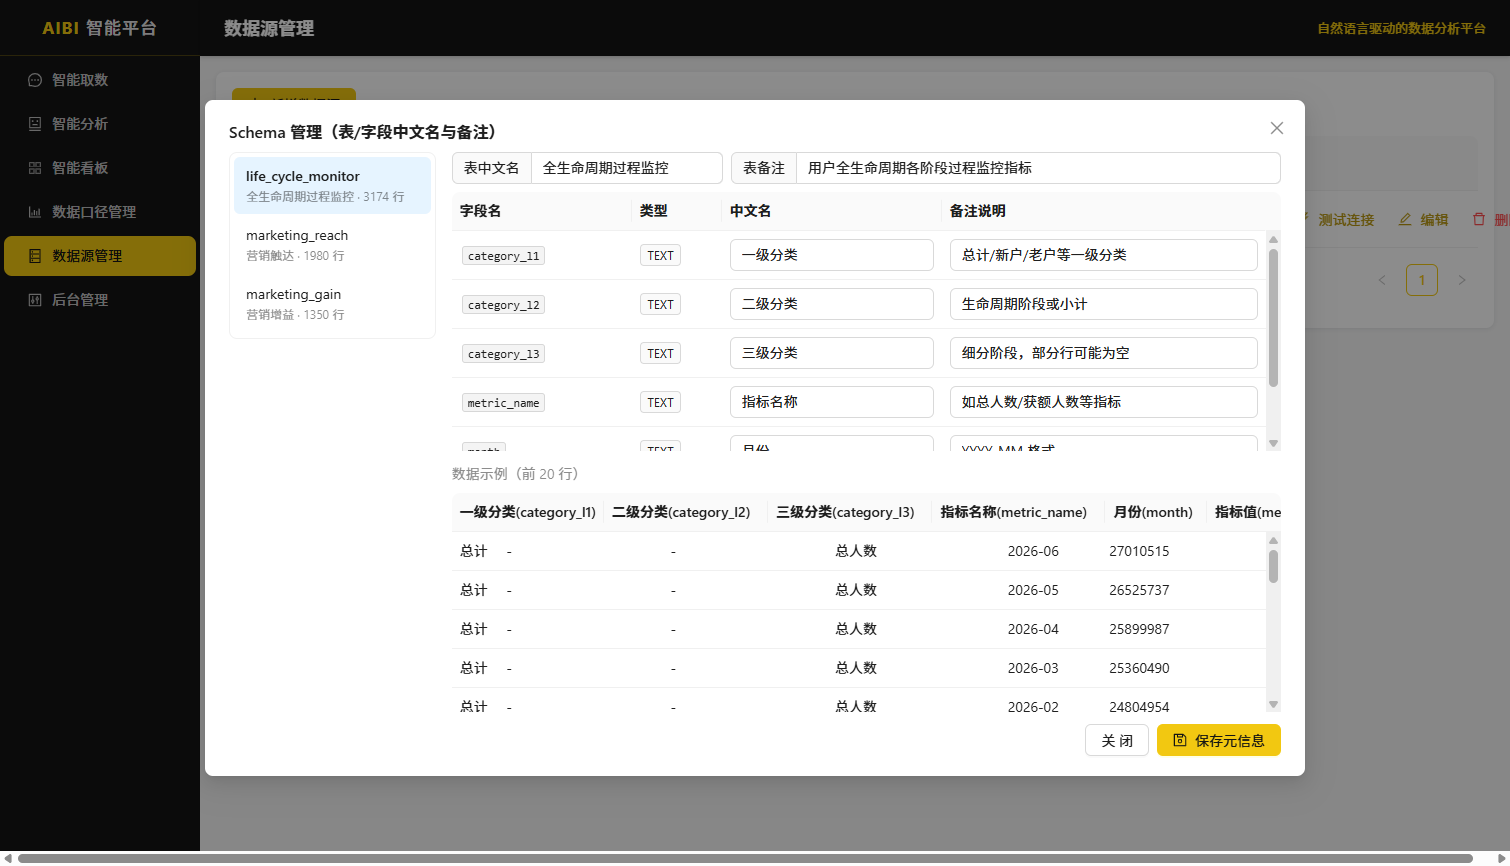
管理平台调用的数据源;并支持为每张表/每个字段维护中文名和业务备注(如"category_l1 = 一级分类,总计行无二级分类"),这些元数据会实时注入 NL→SQL 提示词——这是解决"AI 猜错列名/生成 0 行"的关键手段。
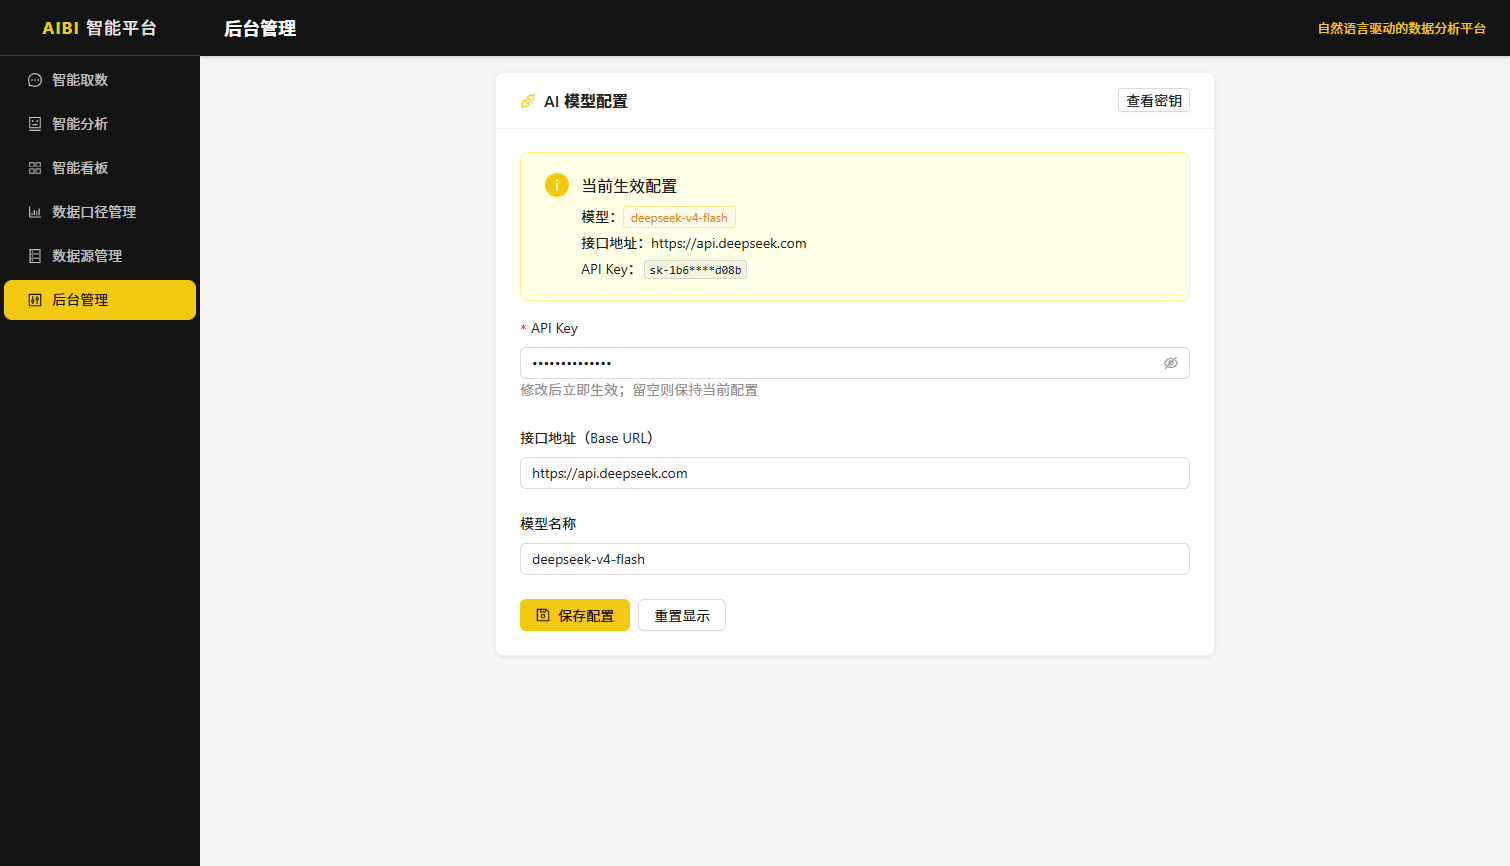
⑥ 后台管理 —— 模型 Key 集中配置
在页面里直接查看/修改当前生效的大模型配置(DeepSeek Key、接口地址、模型名),保存后立即生效,无需改代码重启。
2.5 第四步:安全与质量兜底
- SQL 安全引擎:仅允许只读查询,拒绝写操作/多语句,30s 超时 + 10000 行上限,全量审计日志
- 错误兜底:所有 API 异常统一弹窗提示,避免"点了没反应"
- 无 Key 降级:不配置大模型也能用手工 SQL 工作台
三、成果展示
最终交付了一套可运行的智能 BI 平台,前后端共 40+ 个源码文件、约 5000 行代码,六大模块全部可用:
| 模块 | 交付内容 |
|---|---|
| 智能取数 | NL→SQL→执行→可视化(表格/柱状/折线/饼图)→AI 解读→加入看板,多轮追问 |
| 智能分析 | 上传文件 + 宽泛问题,生成 HTML 分析报告(预览/下载) |
| 智能看板 | 自定义布局、时间区间/自动刷新、AI 一句话生成看板、图表点击放大 |
| 数据口径 | 指标口径 CRUD,作为 NL→SQL 查询语料 |
| 数据源管理 | 数据源 CRUD + 连接测试 + Schema 中文名/备注维护 + 数据示例 |
| 后台管理 | AI 模型 Key/地址/模型名页面化配置,立即生效 |
配套交付了 start.bat / stop.bat 一键启停脚本,日常运维零成本。
四、效率对比
| 以前 | 现在 | |
|---|---|---|
| 取数 | 提需求给 IT → 排期 → 2-4 小时出数 | 业务人员输入一句话,30 秒内出数 + 图表 |
| 口径 | 口口相传,同一指标多版本 | 口径文档沉淀,AI 按统一口径取数 |
| 元数据 | 字段含义靠问人 | Schema 管理维护,AI 自动读懂业务规则 |
| 可视化 | 再找开发做图表,又一轮排期 | 查询结果一键切换图表、一键上大屏 |
| 审计 | 无记录 | 全部查询操作留痕可追溯 |
五、经验和技巧总结
- 先写规格再动手:让 SOLO 先产出 spec/tasks/checklist,需求对齐后再实现,能少走很多弯路,也方便后续"接着干"。
- 把业务语义注入 Schema 文档:只给表名/字段名,AI 会"猜";把"总计行无二级分类、小计是汇总行要排除"这类规则写进 Schema 文档后,SQL 准确率明显提升,基本不再出现 0 行查询。
- 模型名要用 API 规范名:比如用户说的"v4 flash"实际模型名是
deepseek-v4-flash,写错会 400;把 Key/模型名做成页面可配置,比写死在代码里灵活得多。 - 错误提示要兜底:antd 的静态 message 在 App 上下文里不显示,会导致"点击查询没反应"的假象——统一用全局 message 实例接管所有 API 错误,体验立竿见影。
- SQL 展示用专业代码框:用 CodeMirror(VS Code 深色主题 + SQL 高亮)替代普通文本框,AI 生成的 SQL 可读性、可编辑性都好很多。
以上案例为真实落地项目(AIBI 智能数据分析平台),截图来自平台实际运行界面。欢迎交流~