本来想着比赛结果已经出来,自己没晋级就算了。
但今天看到群里有不少参赛者也在反馈评审过程相关的问题,我还是忍不住想把自己这边能够查到的一些情况客观整理出来。
我并不是想因为没有晋级就质疑比赛结果,更不是要求官方必须改变结果。
我主要想确认一件事:
我们提交到复赛的作品,是否真的按照赛前所说的方式,得到了足够完整的体验和评审?
因为从我目前能够看到的实际使用记录来看,有几个地方让我比较困惑。
1、复赛之前说一个作品会安排多位评委进行评审,但我的项目目前只能确认有 1 位评委实际激活试用
复赛阶段我看到的说明是,一个作品会安排多位评委进行评审,我印象中是 5 位评委,并且会认真体验作品后再进行综合评价。
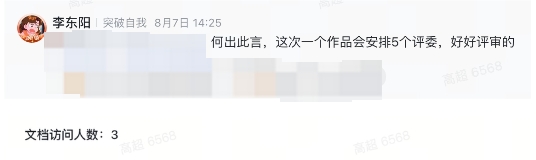
但从我项目后台能够看到的实际测试情况来看:
目前我只能确认有 1 位评委老师真正激活并使用过测试账号。
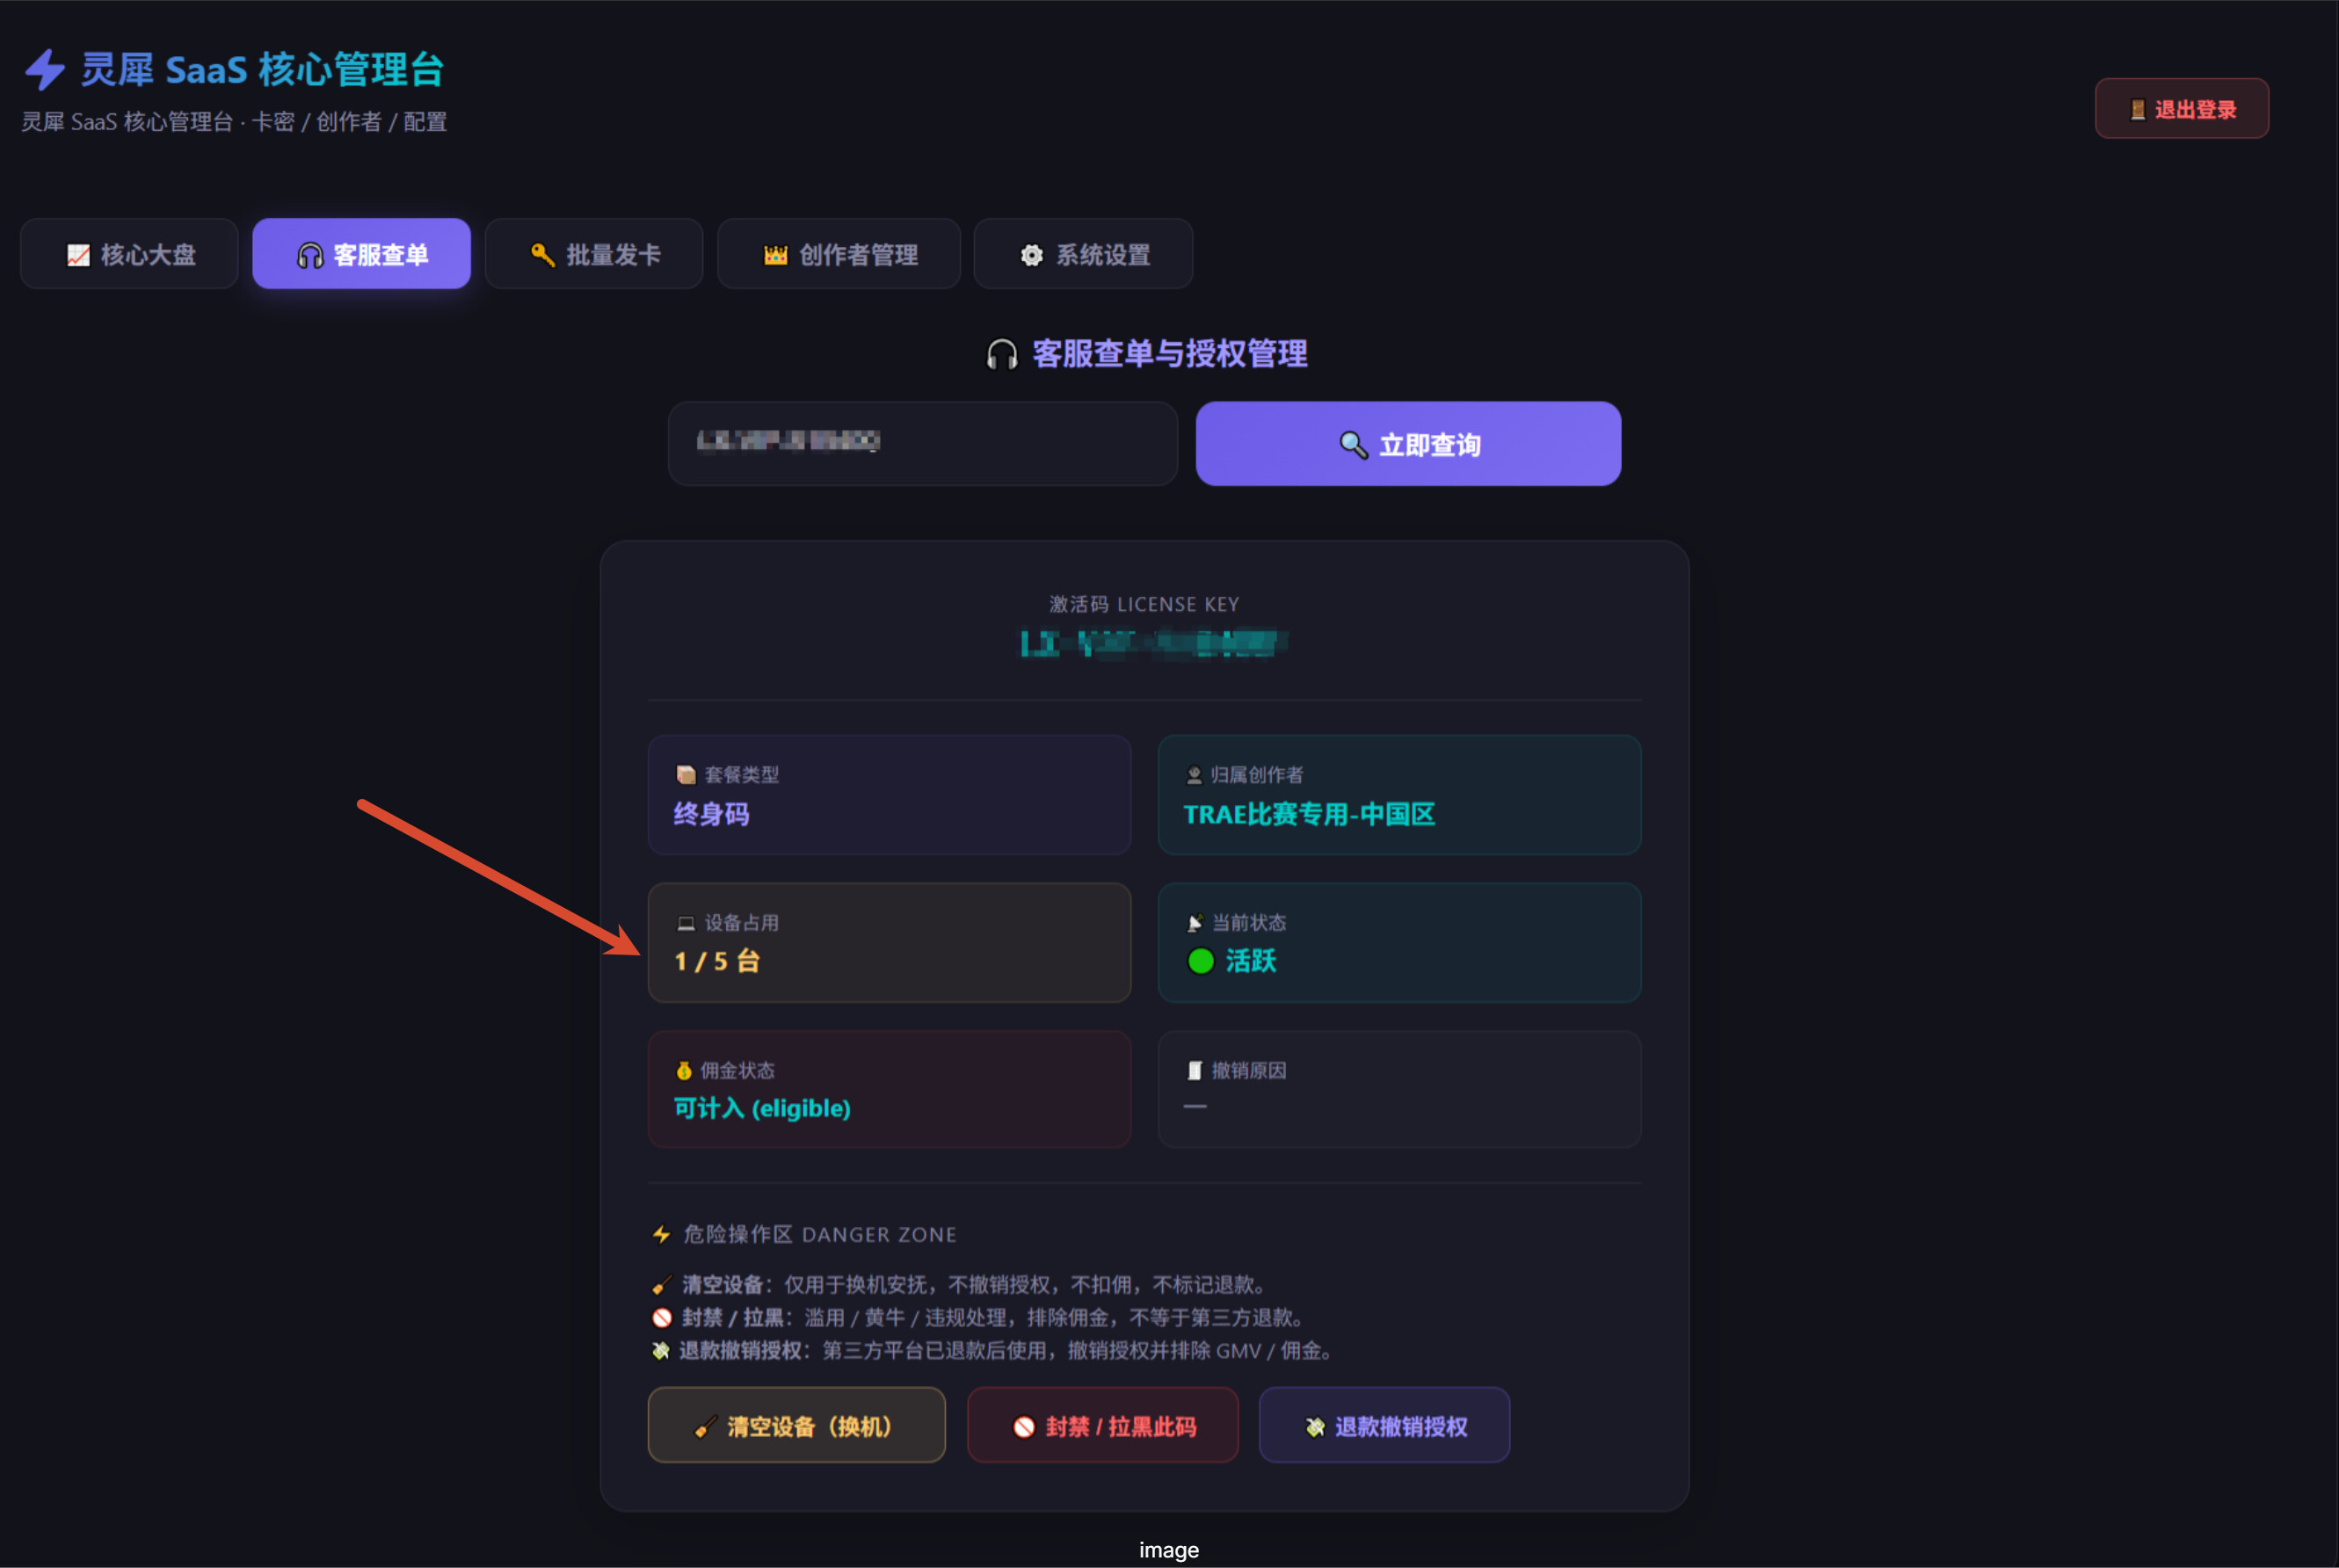
所以我比较想知道:
其他评委是否通过其他方式完成了评审?
例如只观看帖子、视频或其他材料,也会算作一次正式评审吗?
如果一个作品理论上有多位评委,那么实际产品体验部分的最低要求是什么?
这一点如果官方可以解释一下,我觉得不仅是我,很多参赛者应该都会比较关心。
2、项目中一个比较重要的“创作者分享”功能,看起来并没有被实际体验
我的项目有一个我认为比较重要的能力:
创作者可以把自己长期收藏整理的网址、收藏库,生成一个公开分享网页,再分享给其他人。
它不是单纯的“导出收藏”,而是把已经整理好的知识收藏转成一个可以直接浏览和传播的页面。
正常是点击图1的青色按钮以后,生成图2的页面:
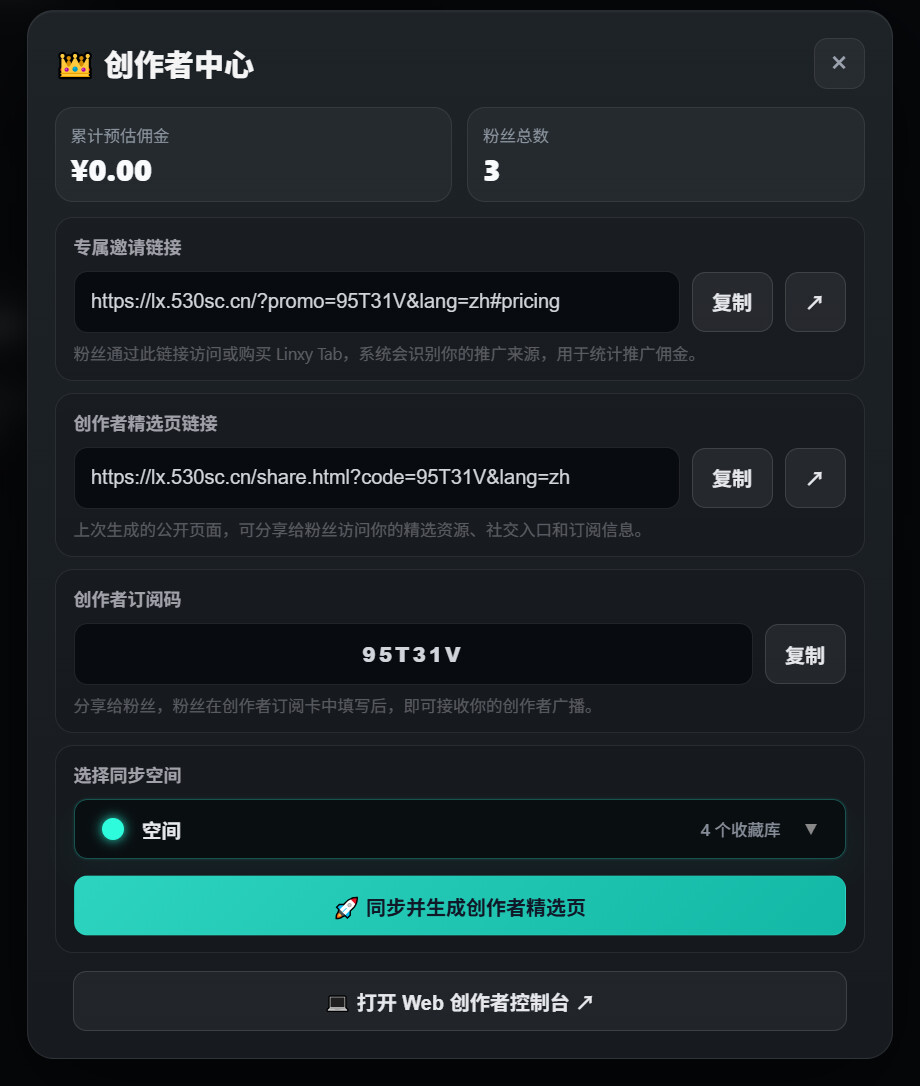
如果生成了分享页是下面这样的:
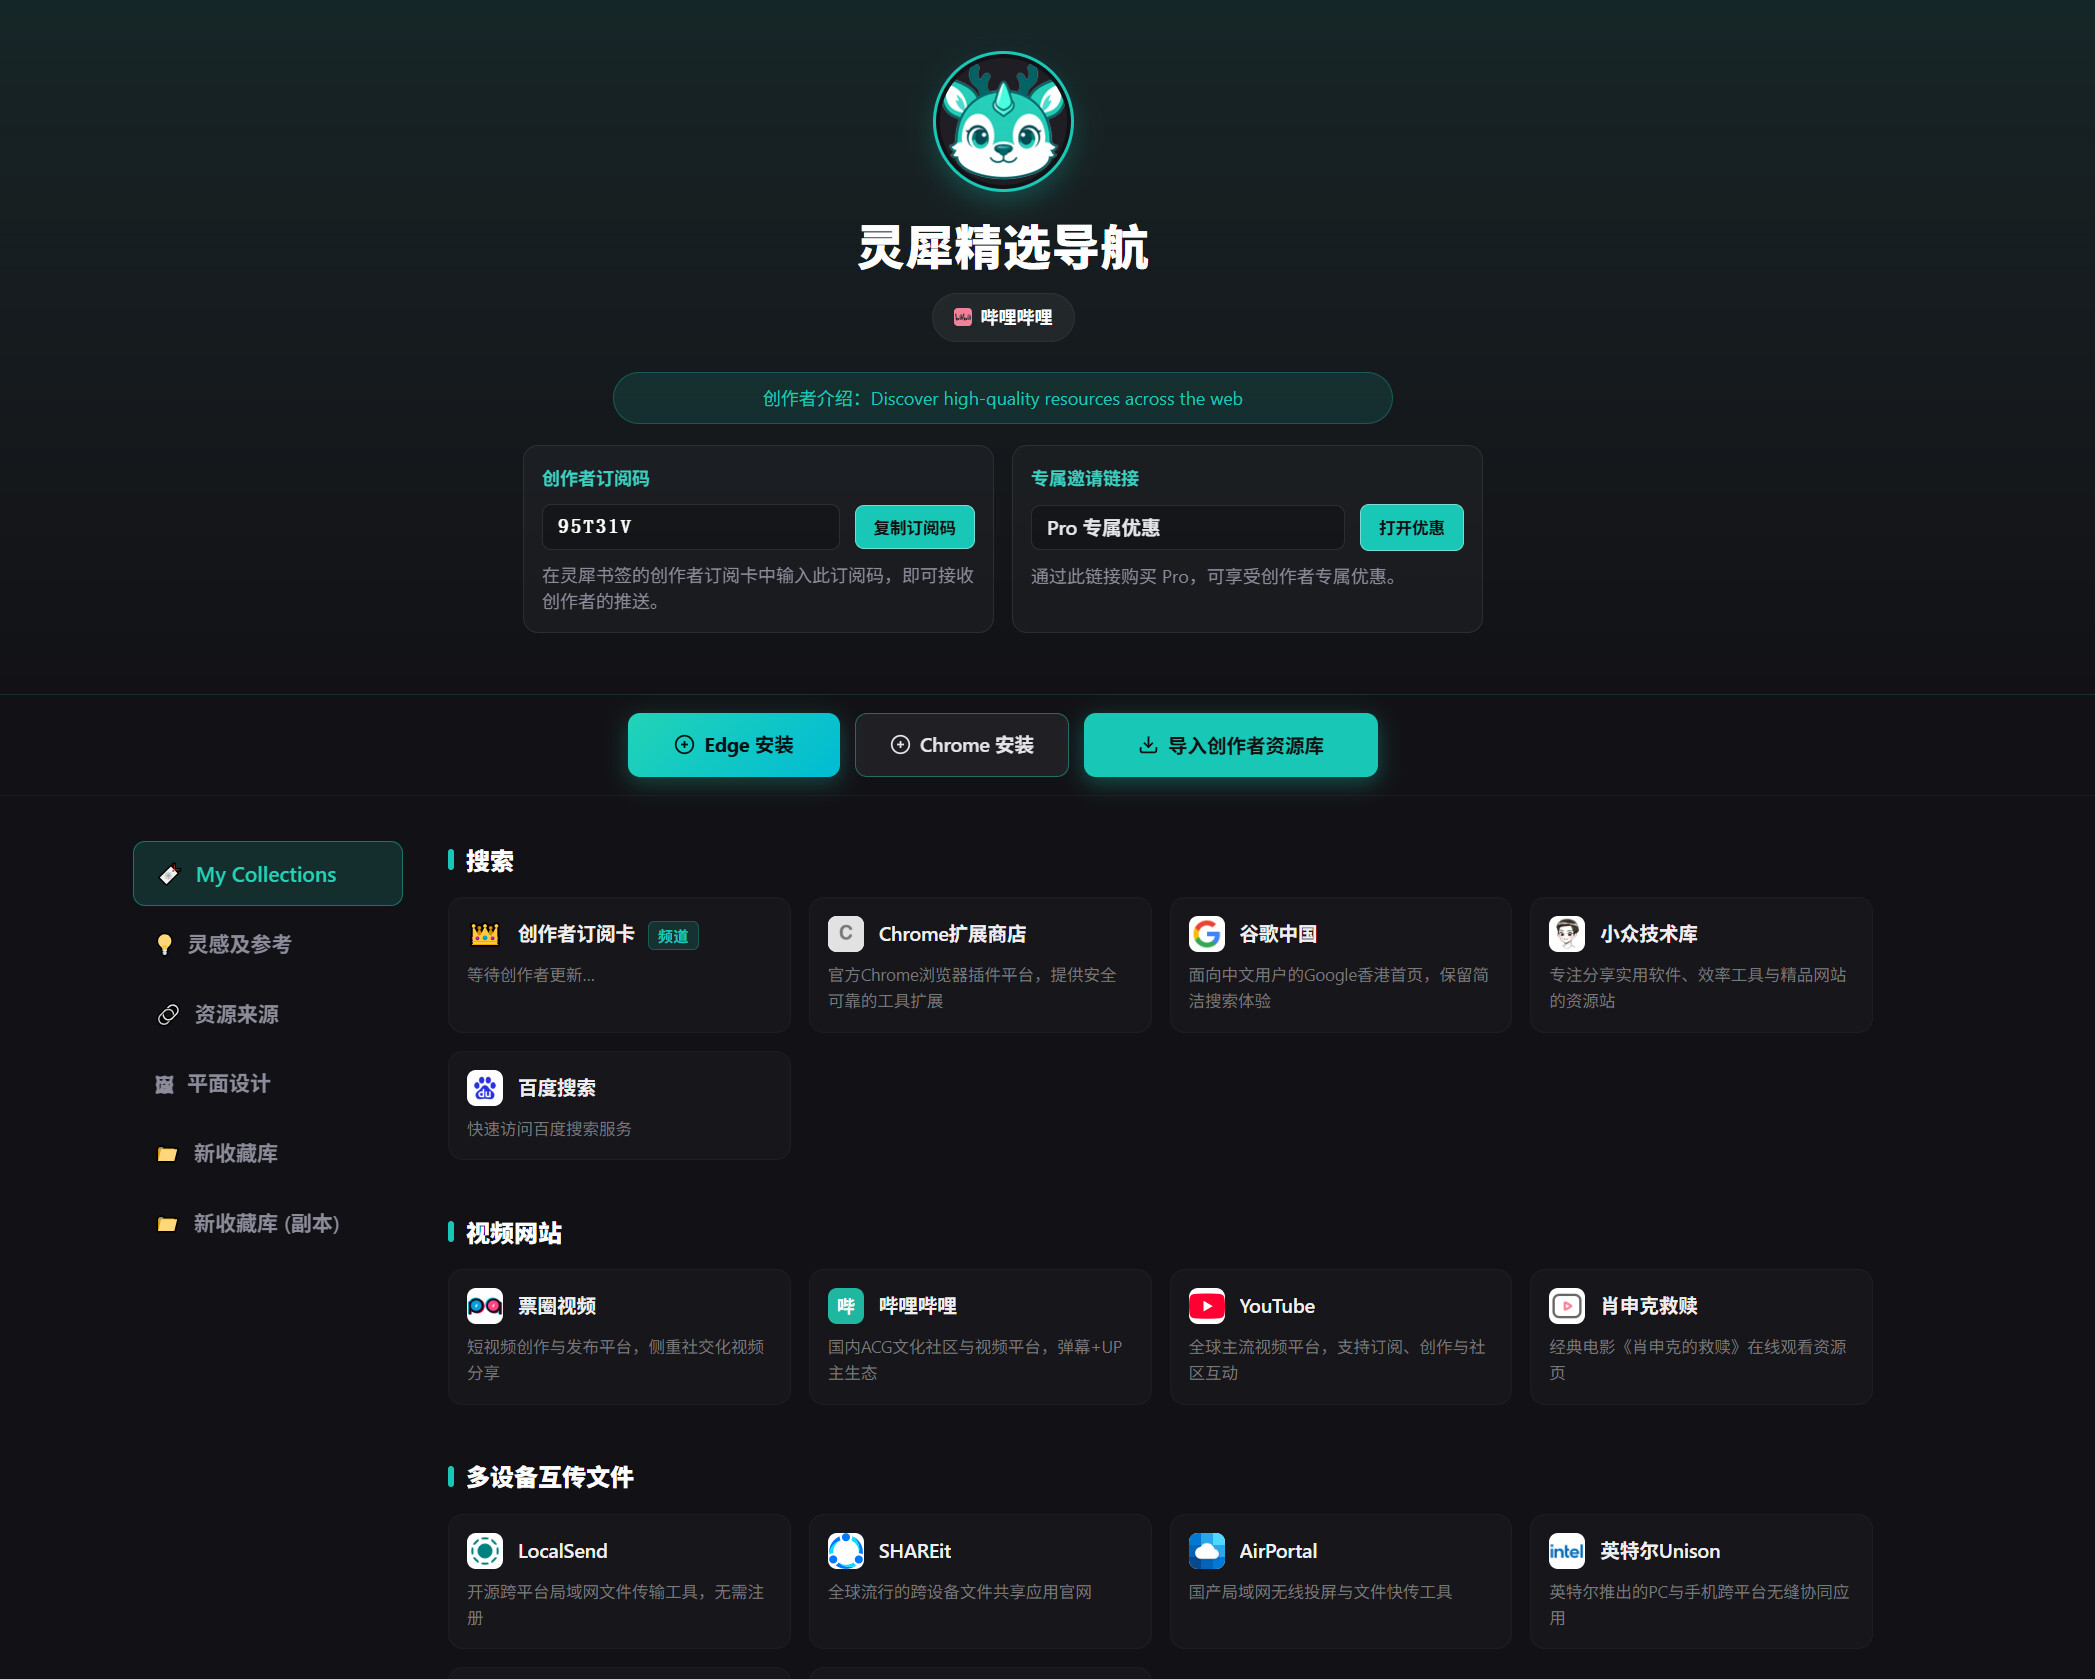
但我后来检查了专门提供给评委老师的测试账号。
这个测试账号的分享页面目前实际是这样的:
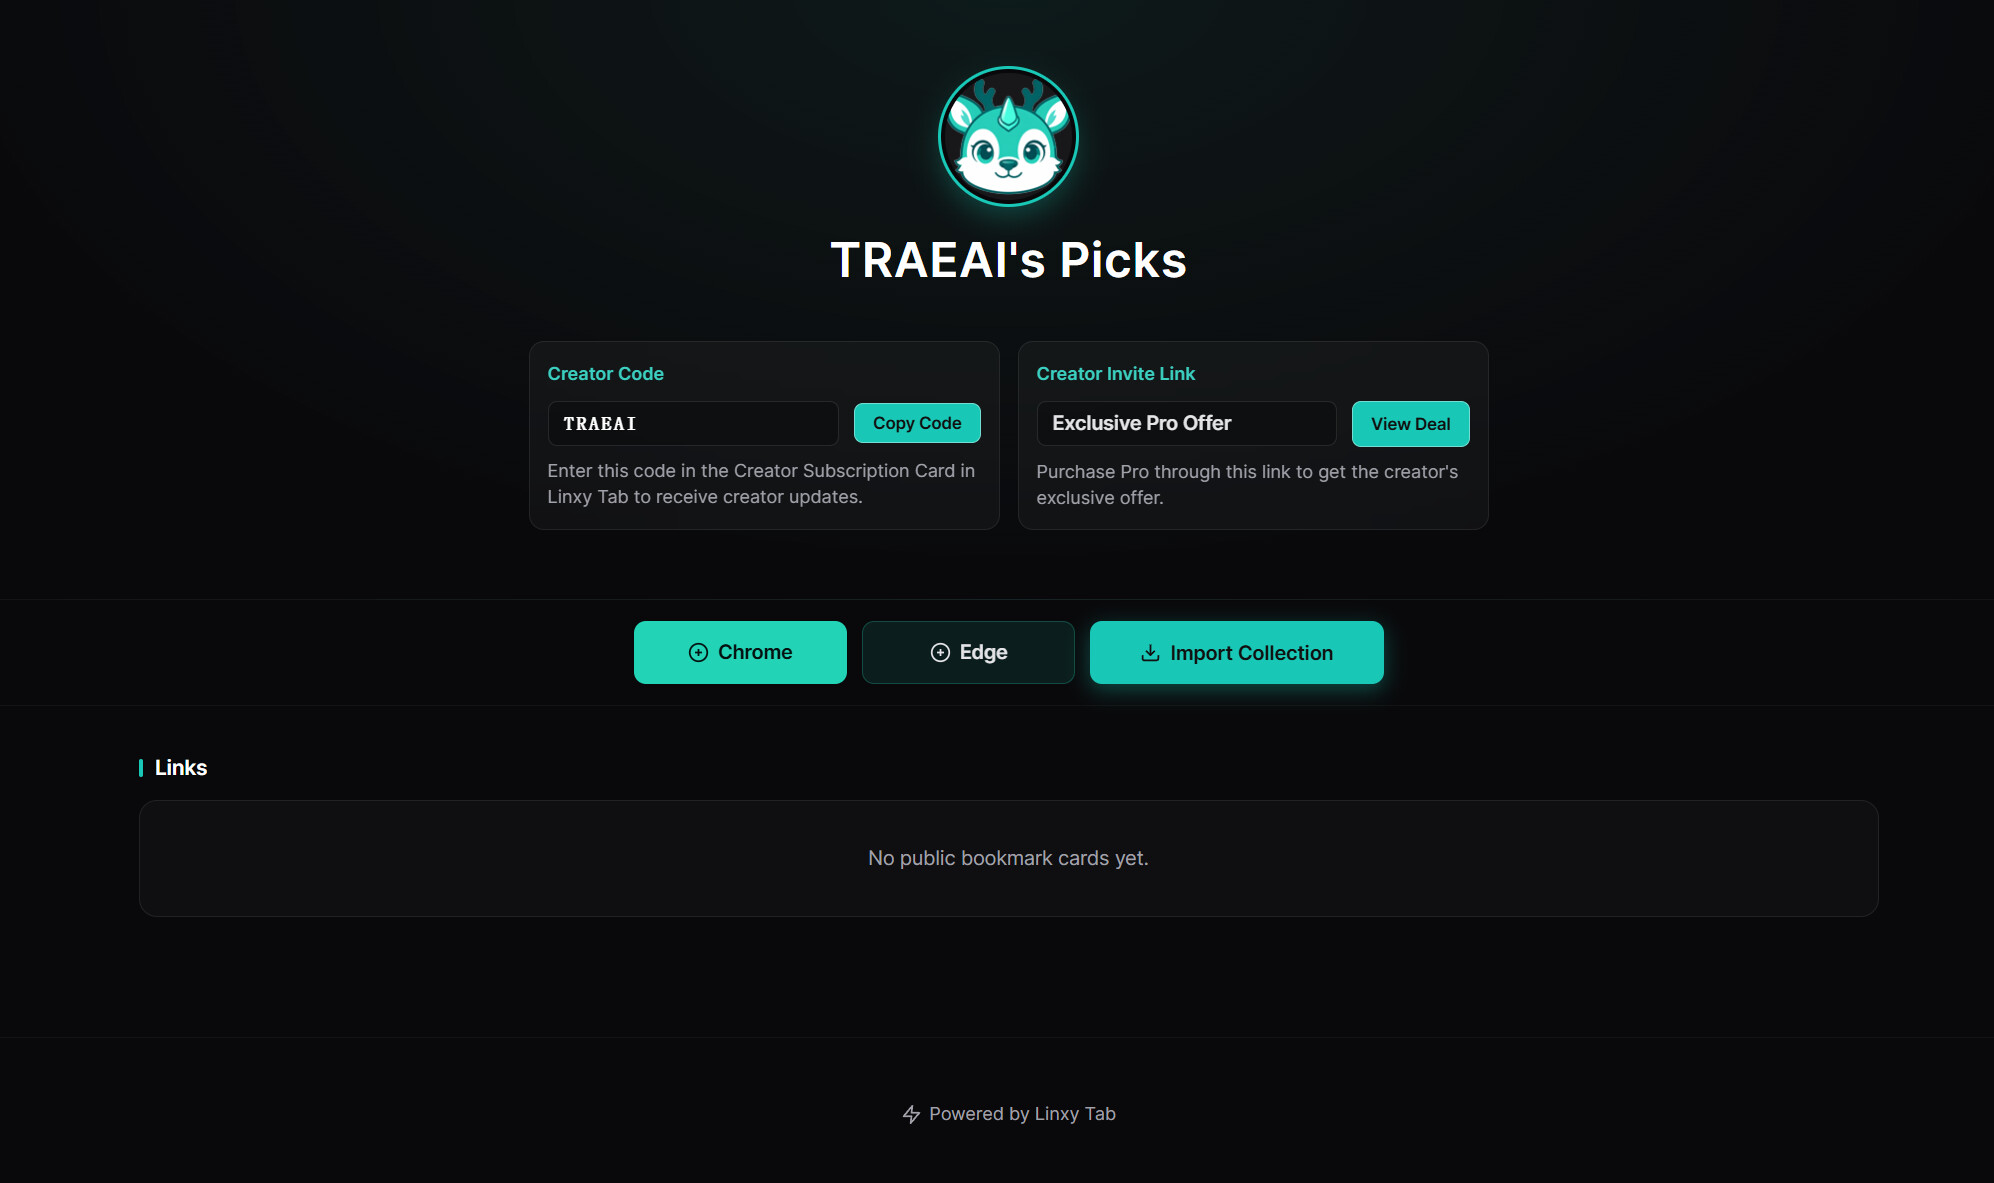
也就是说,至少从我目前能够观察到的账号状态判断,这个评委测试账号并没有真正生成过分享页。
如果评委实际完整测试了这个功能,正常情况下应该会产生相应的分享页面。
所以这也让我产生了疑问:
复赛评审到底会要求评委实际体验作品中的主要功能,还是主要依据参赛帖子和演示材料评分?
如果是后者,我觉得也可以,但可能需要在比赛规则里提前告诉参赛者。
因为很多参赛者为了复赛,会专门投入大量时间准备:
测试账号、测试数据、服务器、API Key、真实产品环境等。
大家默认这些准备是为了让评委真正进入产品体验,而不是最终基本没有被使用。
3、AI 功能的调用记录也让我很难确认是否进行了实际体验
目前我的项目里包含多项 AI 功能,例如:
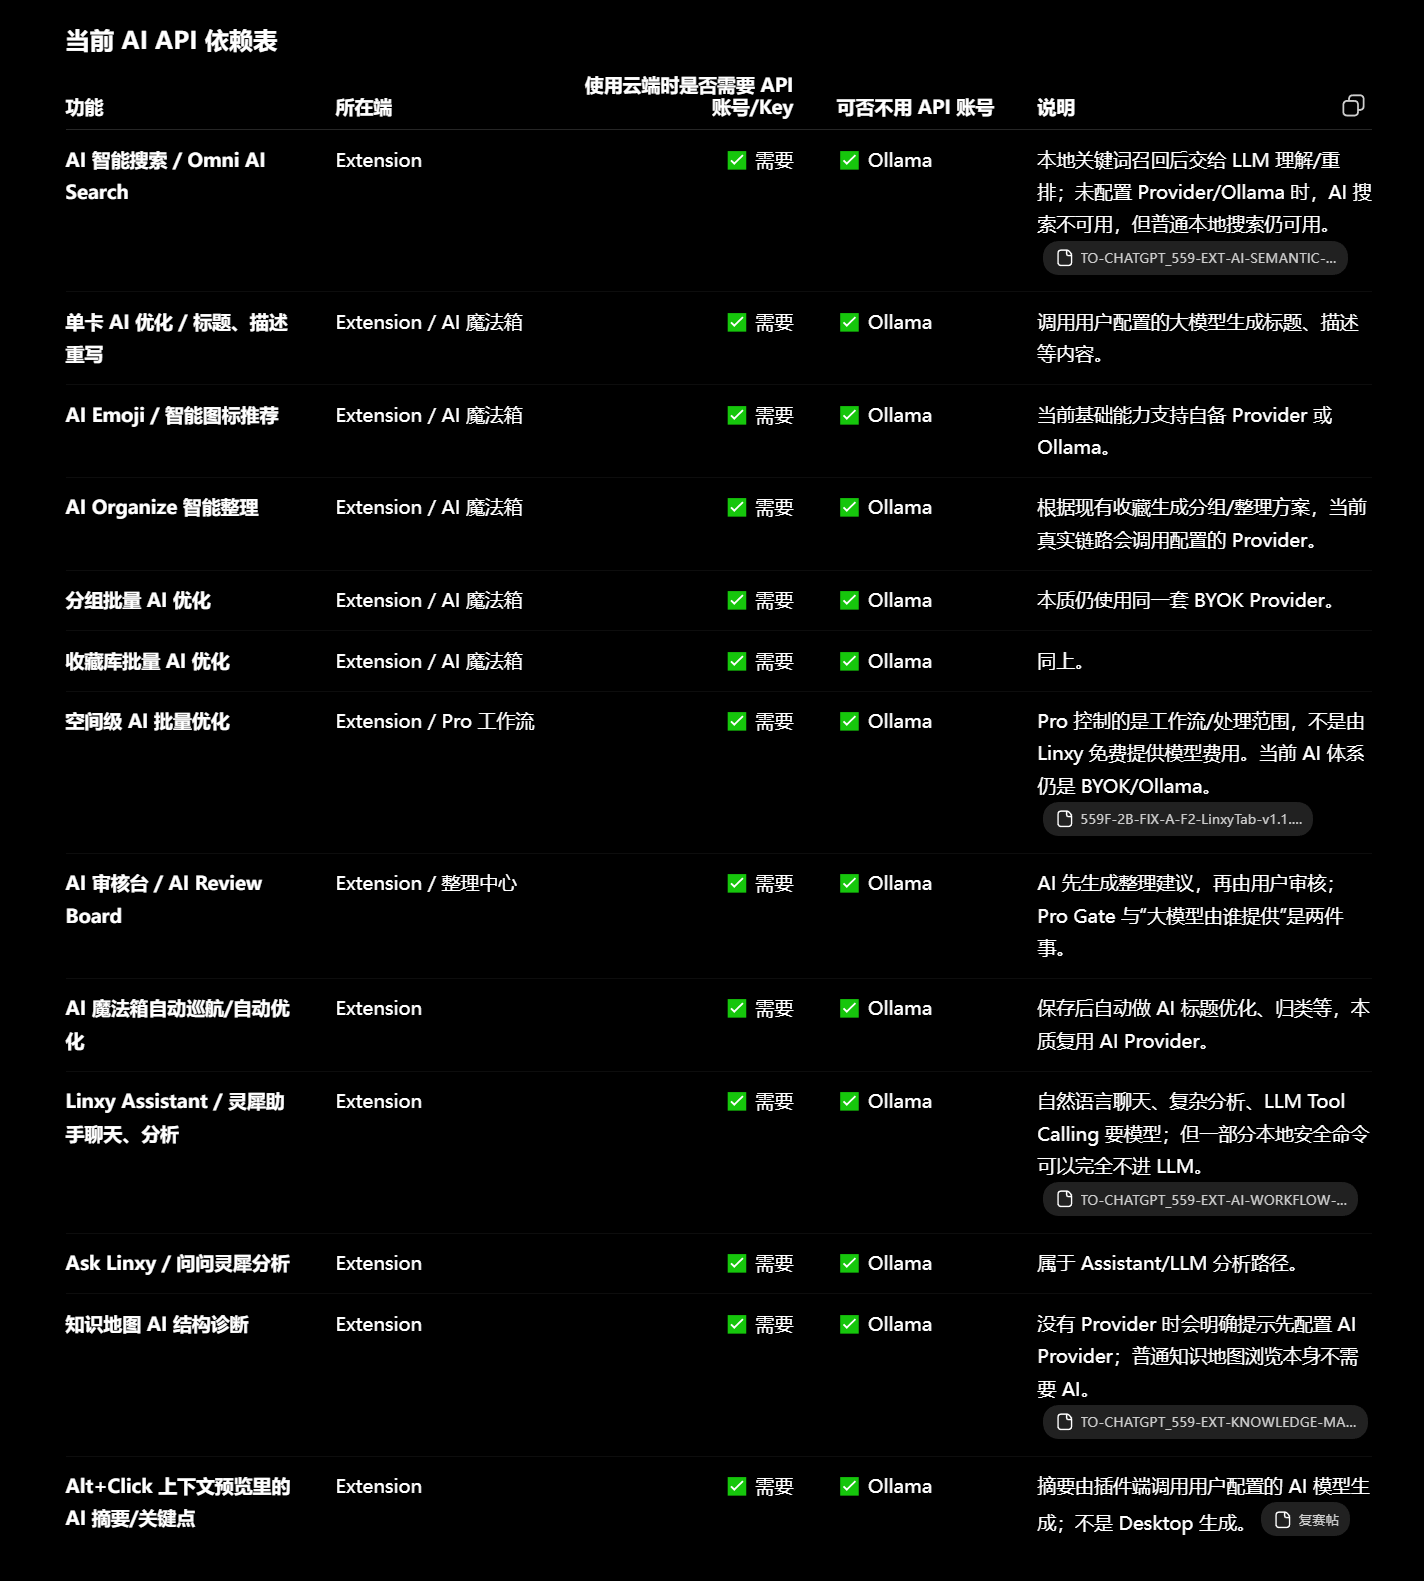
项目采用的是 API Provider / API Key 方式。
为了方便评委测试,我提前提供了可以直接使用的 API 账号。
而且系统有一个比较容易核验的特点:
只要在项目里填入 API 账号,系统就会自动进行一次测速。
例如这里:
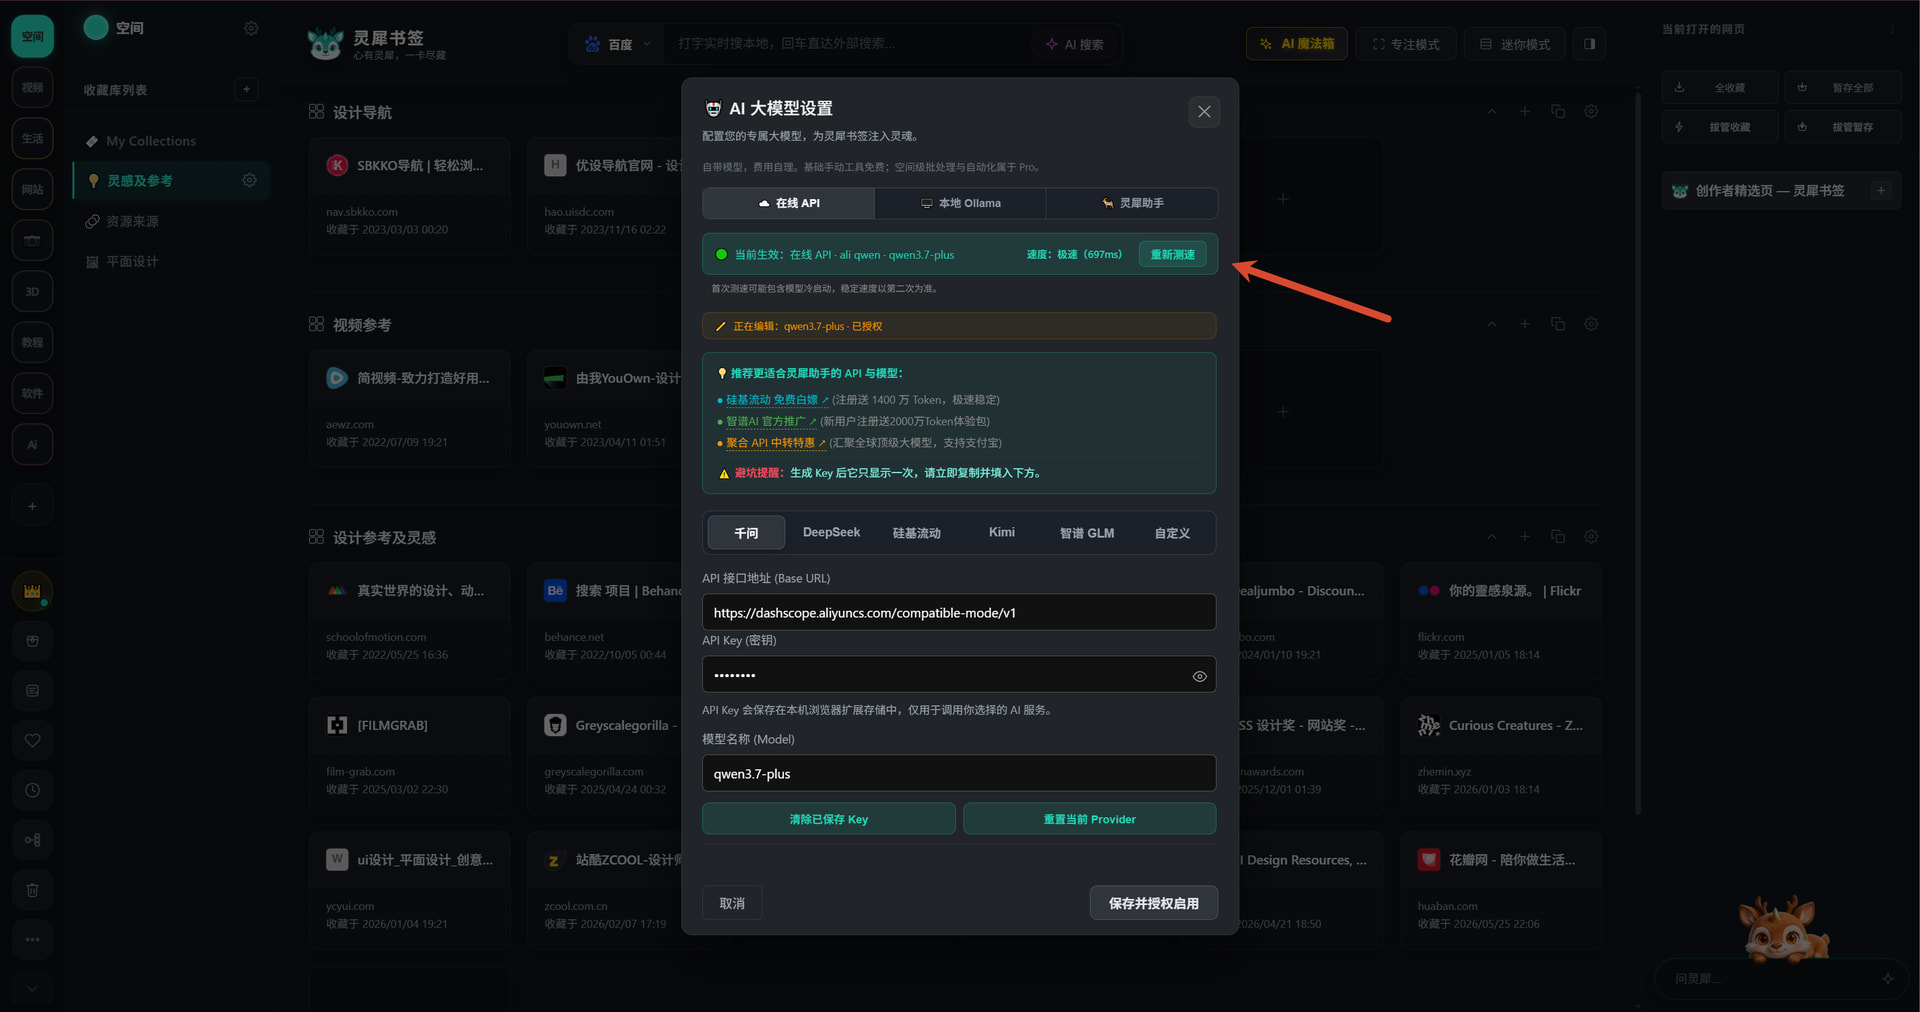
所以 API 后台的调用记录,大致可以帮助我判断:
是仅仅填写了 API Key,还是后续真正使用了 AI 功能。
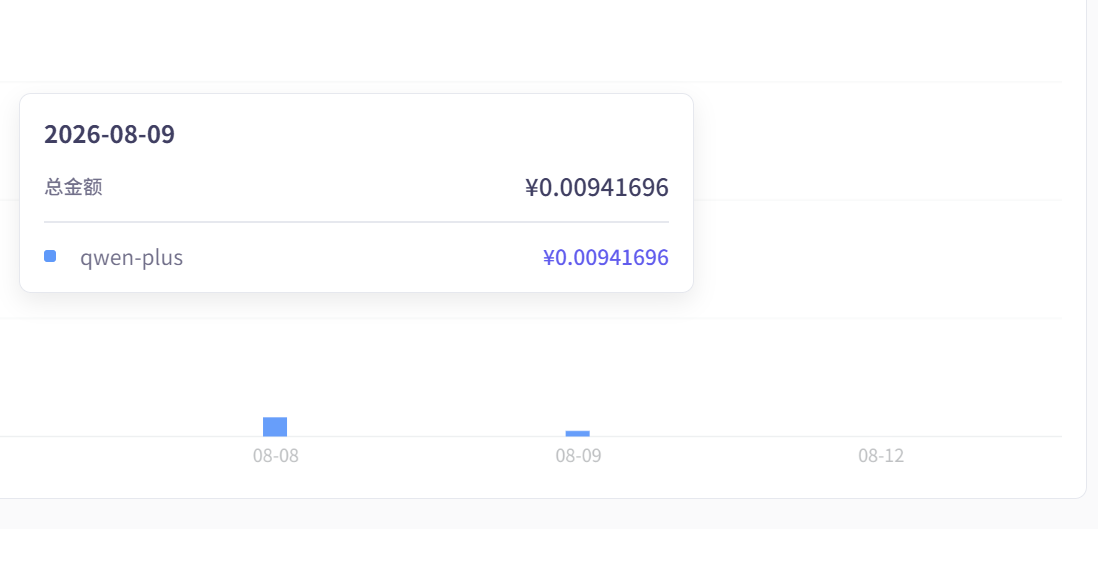
8 月 8 日
在提交之前,我自己先测试了提供给评委的 API 账号。
当时我:
- 测试了 API;
- 实际体验了 2 个 AI 功能;
- 并没有把全部 AI 功能都测一遍。
所以当天产生了一部分 API 用量。
8 月 9 日提交前
提交前我又最后进行了一次检查:
- 填入 API 账号后触发了一次自动测速;
- 又点击了一个 AI 功能进行了一次测试。
因此,这部分调用也是我本人产生的。
对应的 API 使用记录如下:
8 月 12 日
到 8 月 12 日的时候,我因为一直没有观察到评委测试记录,所以曾经在群里询问过一次:
我的项目是不是还没有评委开始测试?
比较巧的是,在我反馈之后不久,终于出现了一位评委老师激活测试账号的记录。
之后也确实有人填入了我提供的 API 账号。
但是从 API 调用记录来看:
只产生了一次填写 API 后系统自动触发的测速调用。
之后没有看到继续调用 AI 功能所应产生的明显 API 使用记录。
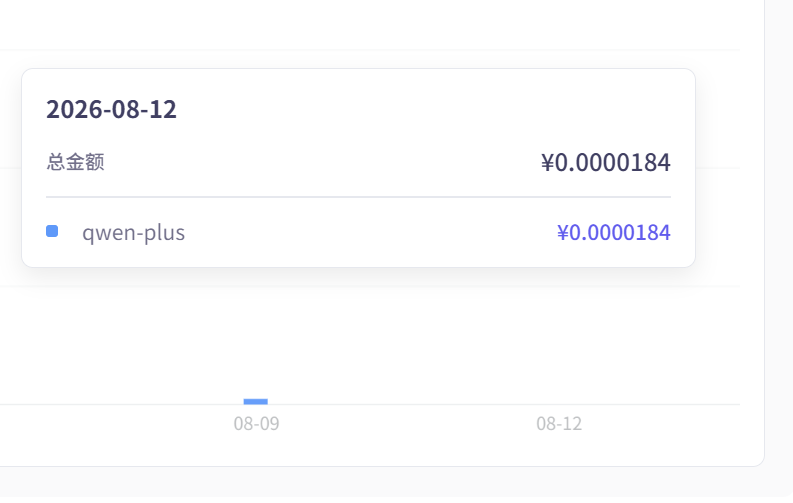
也就是说,至少从我能够核验到的记录看,这次行为更接近于:
填入 API Key
→ 系统自动测速一次
→ 没有继续实际调用 AI 功能
而不是对项目中的多项 AI 能力进行了实际体验。
当然,我无法看到评委的完整评审过程,所以我也不会直接断言“评委完全没有看作品”。
但综合:
- 测试账号激活情况;
- 分享页面实际生成状态;
- API 调用记录;
- 我能够观察到的产品使用痕迹;
我确实很难确认这个项目是否获得了此前所描述的那种比较充分的产品体验和多人评审。
我真正希望官方回应的其实是几个很简单的问题
我觉得比赛结果本身是一回事,评审过程是否清晰是另一回事。
我更希望官方能够帮参赛者说明:
- 复赛所谓“多位评委评审”,是每一位评委都需要实际体验产品,还是其中部分评委只看帖子、视频和其他材料即可完成评审?
- 如果作品已经提供完整测试账号,赛方是否对评委有最低实际体验要求,例如最低体验时长、核心功能检查清单,或者至少完成若干关键功能的实际测试?
- 如果某项核心功能实际上已经完整实现,但评委没有实际点击或体验,这项功能最终是按“未实现”评分、根据演示材料评分,还是不参与这一部分评价?
- 如果实际上只有 1 位评委进入产品进行真实体验,这种情况是否符合复赛原本设定的多人评审流程?如果符合,那么多人评审机制具体体现在哪里?
- 如果只有 1 位评委实际体验产品,赛方如何避免这位评委个人的兴趣、产品偏好、专业背景或对某类产品不熟悉,对最终结果产生过大的影响?是否存在第二位评委交叉评审或补充复核机制?
- 不同评委之间是否有统一的评分维度和评分尺度校准?例如 A 评委习惯打 90 分,B 评委习惯打 60 分,如果不同作品由不同评委评分,最终排名如何保证横向可比和公平?
- 赛方是否会保留每个作品的评委评分记录、评语、评审时间或其他基础评审轨迹,以便在出现明显争议时进行内部复核?
- 如果参赛者能够提供测试账号记录、API 调用记录、后台状态等相对客观的证据,表明核心功能并没有被实际体验,赛方是否有正式的申诉或内部复核渠道?
我并不是要求官方因为这些问题重新判我晋级。
比赛一定会有主观判断,而且每个评委对产品价值的理解也可能完全不同,这些我都能接受。
如果评委完整体验之后,认为我的项目做得不够好、不值得进决赛,我完全接受这个结果。
我真正介意的是:
如果参赛者花了大量时间准备完整产品、测试账号、服务器、API、测试数据和演示环境,但最后作品实际上没有得到足够的体验,那么这种情况下,最终分数到底有多大程度能够代表作品本身?
既然这次比赛有非常多认真投入的开发者,我还是希望官方能够对评审流程给一个更明确的解释。
这样即使最后结果不会改变,至少大家能够知道:
自己的作品究竟是“被认真体验之后没有晋级”,还是“在没有充分体验的情况下就完成了评审”。
这两种情况,对参赛者来说感受还是非常不一样的。

 虽然我也被……