一个 80后莞漂的AI成长突围,一支 70/80/00 后混编小队的1周打磨。
我们不承诺它完美,只承诺一件事:它说的每一句话,你都能查到出处。创造者寄语:AI 时代,与其焦虑被取代,不如主动拥抱 AI,让 TRAE 成为你的智多星。人人都可以创造。
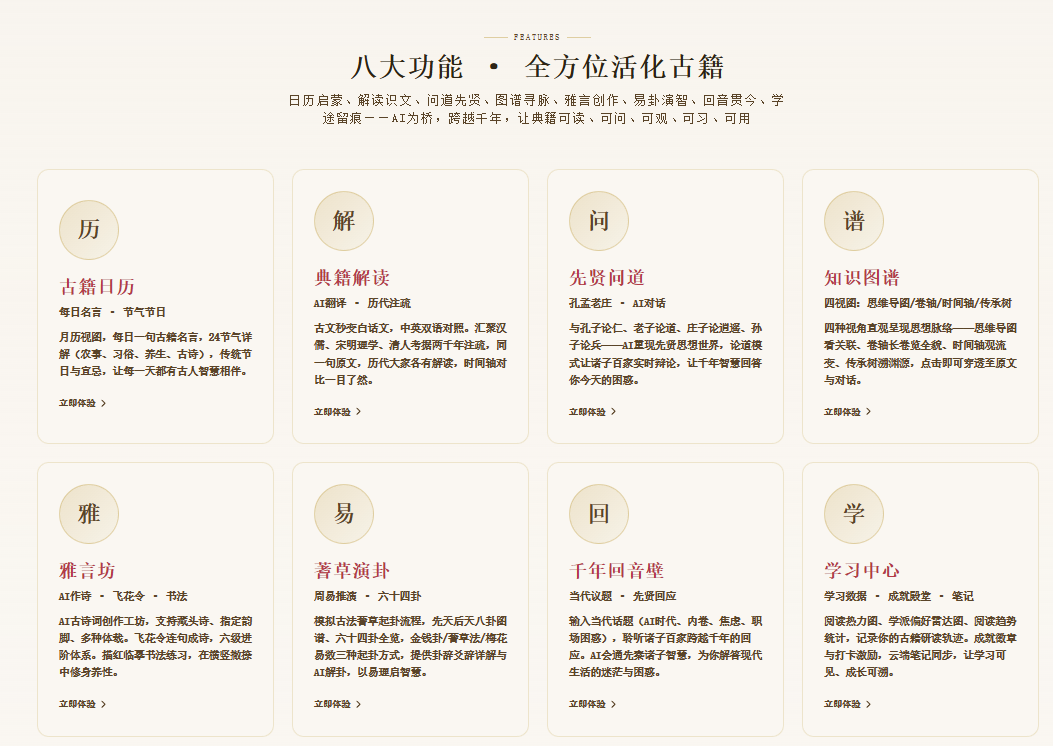
数据速览(全部可在代码与产品中核验):22 部典籍 · 145 章精读 | 11 位先贤数字人 | 20 位历代学者注疏 | 64 卦易理系统 | 202 节点思想图谱 | 82 道知识题 | 238 个单元测试 + 53 个端到端测试 | 三轨冗余部署
一、团队介绍:墨问队
队伍定位:用最朴素的敬畏心,做最有依据的古籍活化。
| 成员 | 年代 | 分工 | 一句话介绍 |
|---|---|---|---|
| 李喜庆(队长) | 80 后 | 产品策划、TRAE 开发、内容架构 | 湖南平江山村走出,在东莞打拼多年,非程序员出身 |
| 金建平 | 70 后 | 古籍内容审校、典藏资料把关 | 对一字一句有洁癖的传统读书人 |
| 朱志彪 | 00 后 | 交互体验、视觉走查、BUG修复 | 用最挑剔的眼睛替年轻用户把关 |
我叫李喜庆,80 后,来自湖南平江的一个小山村,在东莞打拼多年。AI 时代来临,我常感到焦虑——总觉得现在是年轻人的天下,长江后浪推前浪,怕自己这代人被时代悄悄抛下。
今年四月最后一天临下班,老板递来 BOM 转换的急活,节后就要上线,偏巧会写程序的同事请假了。正一筹莫展时,TRAE 的弹窗跳了出来——就这么着,我竟做出了人生第一个软件工具。同事原来手工一份要两小时,现在用工具一分钟完成。那一刻,心里某个地方亮了:原来,我也能被世界温柔接住。
有一天用TRAE写工具中,左下角弹出TRAE AI大赛消息,我比较忙,但后来想试试,我只敲了一句"我要参赛",它自动操控浏览器浏览帖子,自己思考分析竞争态势,帮我选了古籍活化赛道,瞬间戳中心事——爷爷那本泛黄的《论语》,在书架上躺了三十年,我从没翻完过。我想老祖宗的智慧,不该就这样沉睡。于是有了《智读古籍》,也遇见了我的队员:70 后金建平、00 后朱志彪,我们组成"墨问队",继续打磨这份心意。
二、产品简介
是什么
一句话:智读古籍是一款 AI 驱动的古籍阅读伴侣(Web 应用),让被文言文吓退的普通人,零门槛地把中华经典读对、读懂、用活。
它不是电子书阅读器,也不是聊天机器人套壳。它想解决的问题是:普通人想亲近经典,但文言文是墙、注疏在图书馆、AI 问答又会编——读不对,不如不读。
面向谁
- 想读经典却被文言文劝退的普通人
- 需要可信引注的学生与传统文化爱好者
- 想给孩子做传统文化启蒙的家长
完整功能地图
| 功能域 | 模块 | 说明 |
|---|---|---|
| 问道 | 问道七门 | 学子、齐家、观礼、入道、众生、逍遥、渭水七扇身份门,从对应先贤开启旅程 |
| 对话 | 先贤对话 | 11 位先贤数字人,独立人格 Prompt 约束,SSE 流式实时对话,每位 10 条预设快捷提问 |
| 解读 | 典籍精读 | 22 部典籍、145 章,原文 / 古注 / 今译 / 启示四层解读结构 |
| 解读 | 注疏时间轴 | 20 位历代学者,从先秦到当代跨越约 2500 年,同一句经典看不同时代怎么解 |
| 图谱 | 中华思想图谱 | 202 个节点覆盖人物-典籍-学派-事件,四视图联动,可跳转对话与解读 |
| 易卦 | 易经八卦 | 64 卦完整解卦,三种起卦方式,明确标注"传统文化研习,非占卜迷信" |
| 识读 | 古籍 OCR | 浏览器端本地推理(Tesseract.js),图片不上传服务器、不出设备 |
| 践行 | 雅言坊 | 白话心事转古诗,藏头 / 藏尾可选,作品明确标注"AI 拟作" |
| 践行 | 修学体系 | 毛笔书法描红、82 道知识题、飞花令·连句成诗、古籍日历、学习仪表盘与成就殿堂 |
| 回音壁 | 千年回音壁 | 输入当代困惑,听千年前的圣贤如何回应 |
| 论道 | 先贤论道 | 18 组预设辩题,看不同立场的先贤就同一议题交锋 |
用户使用路径
体验只需两步:点一扇时空之门穿越千年,与孔子、老子坐而论道;去雅言坊写下心事,AI 为你赋一首专属古诗。其余惊喜,菜单里自寻。
深度路径:首页每日一句 → 对话页与先贤深聊(每条回复标注出处性质)→ 典籍精读对照历代注疏 → 图谱顺藤摸瓜 → 践行模块学以致用 → 学习中心沉淀进度与成就。
产品截图
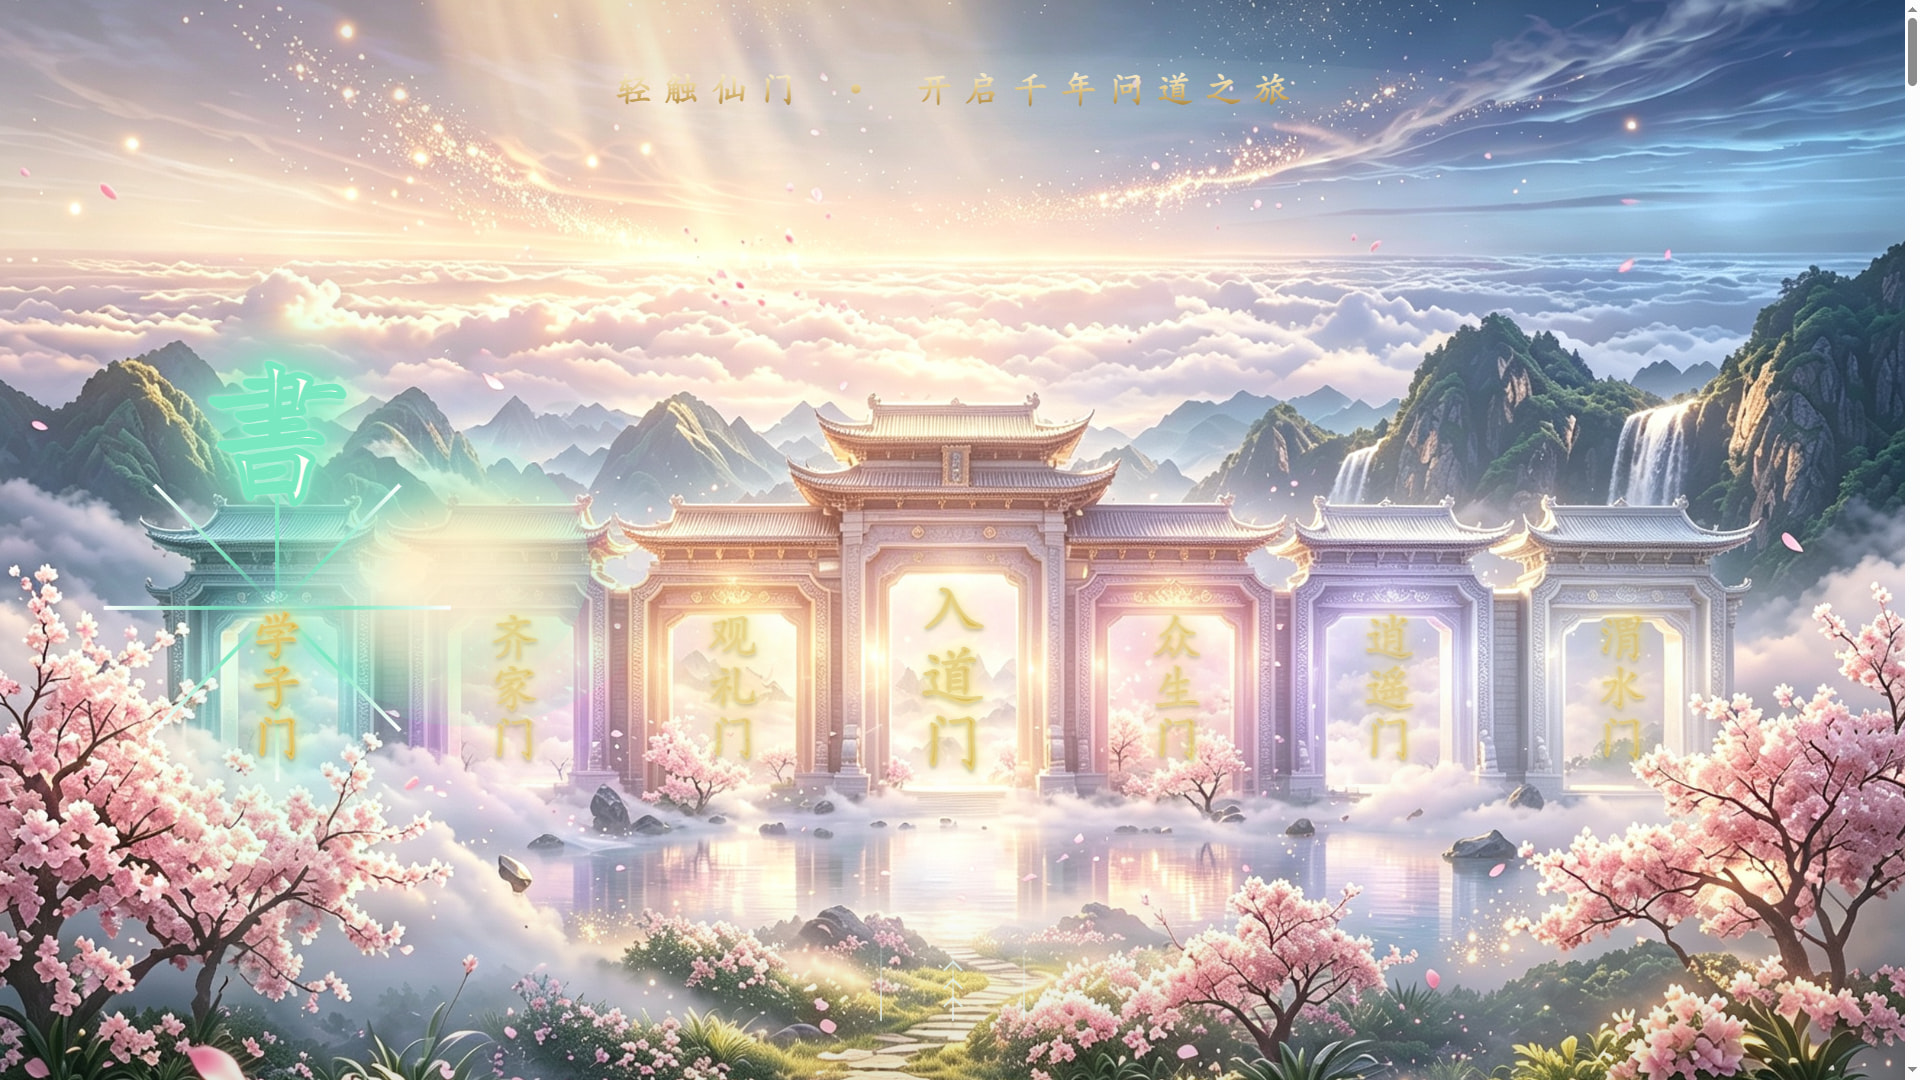
▲ 云海仙山之间七扇身份门,轻触仙门,开启千年问道之旅。
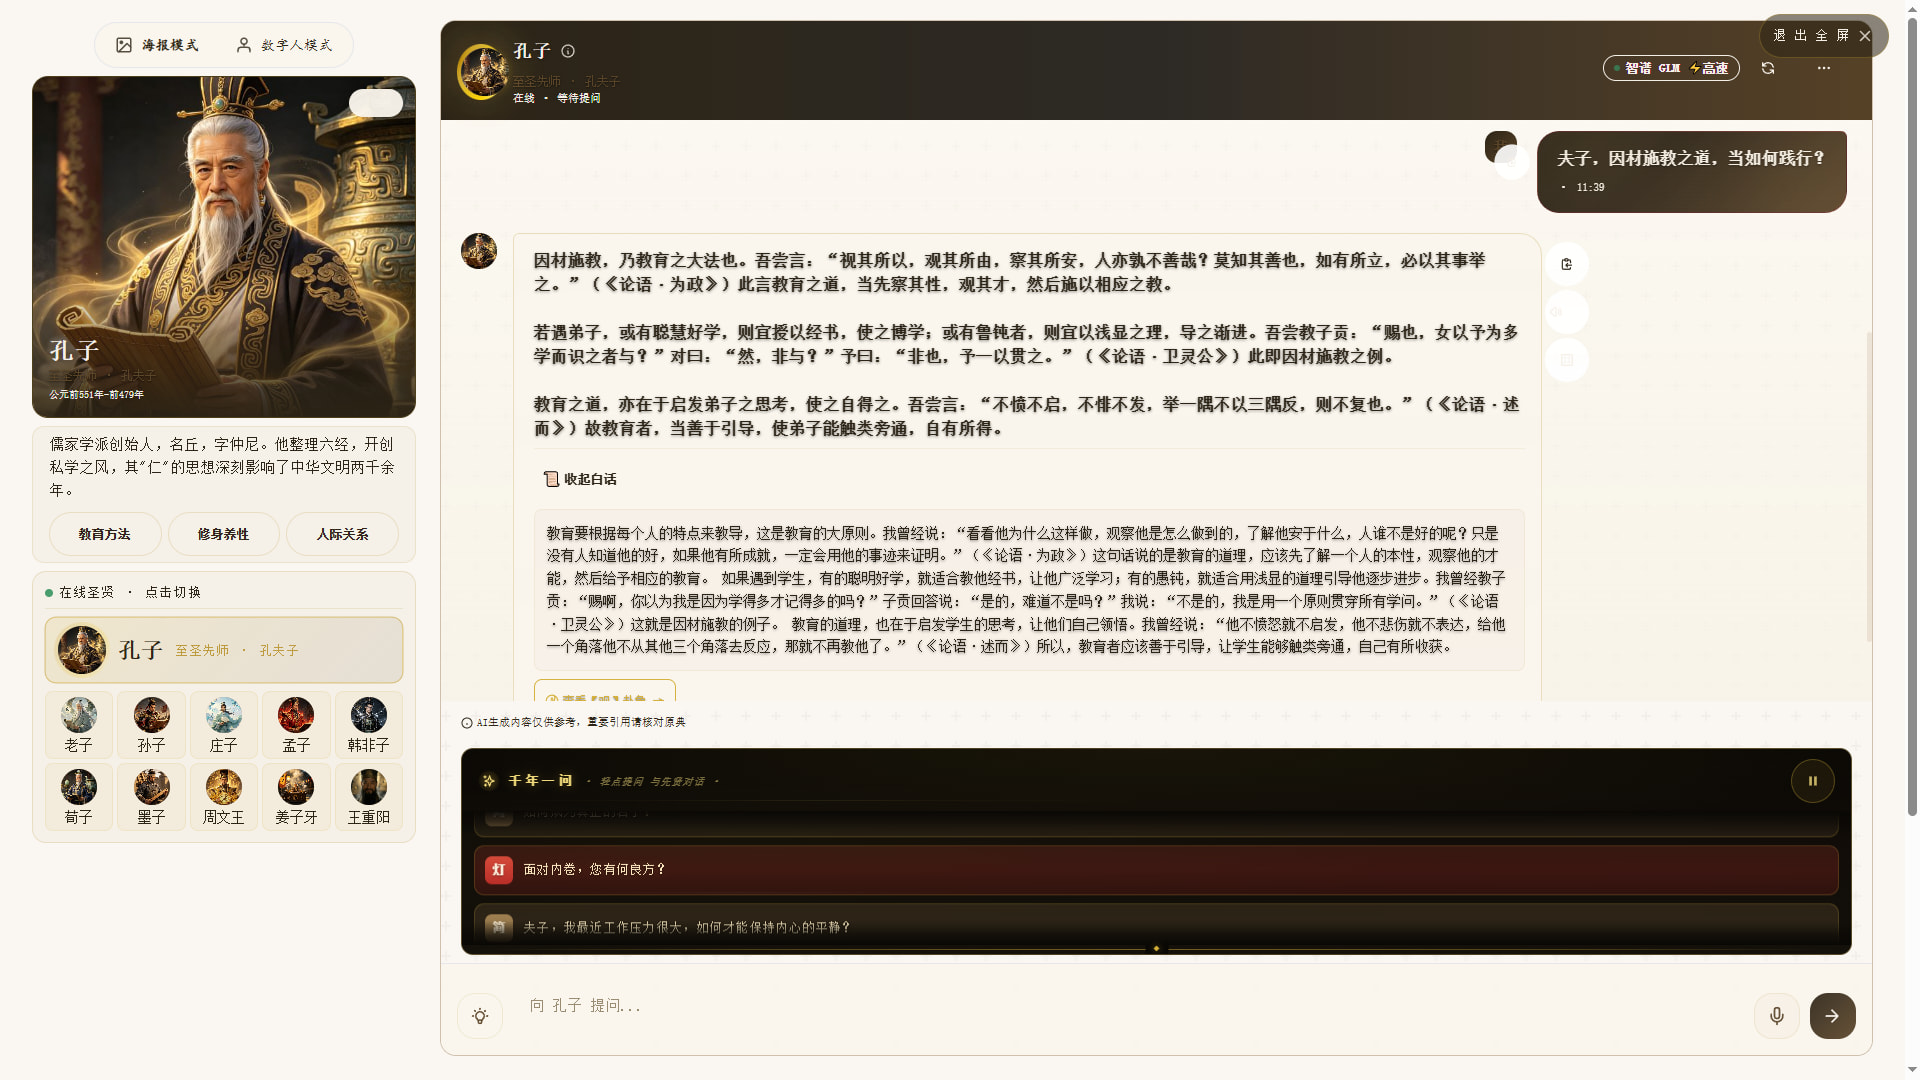
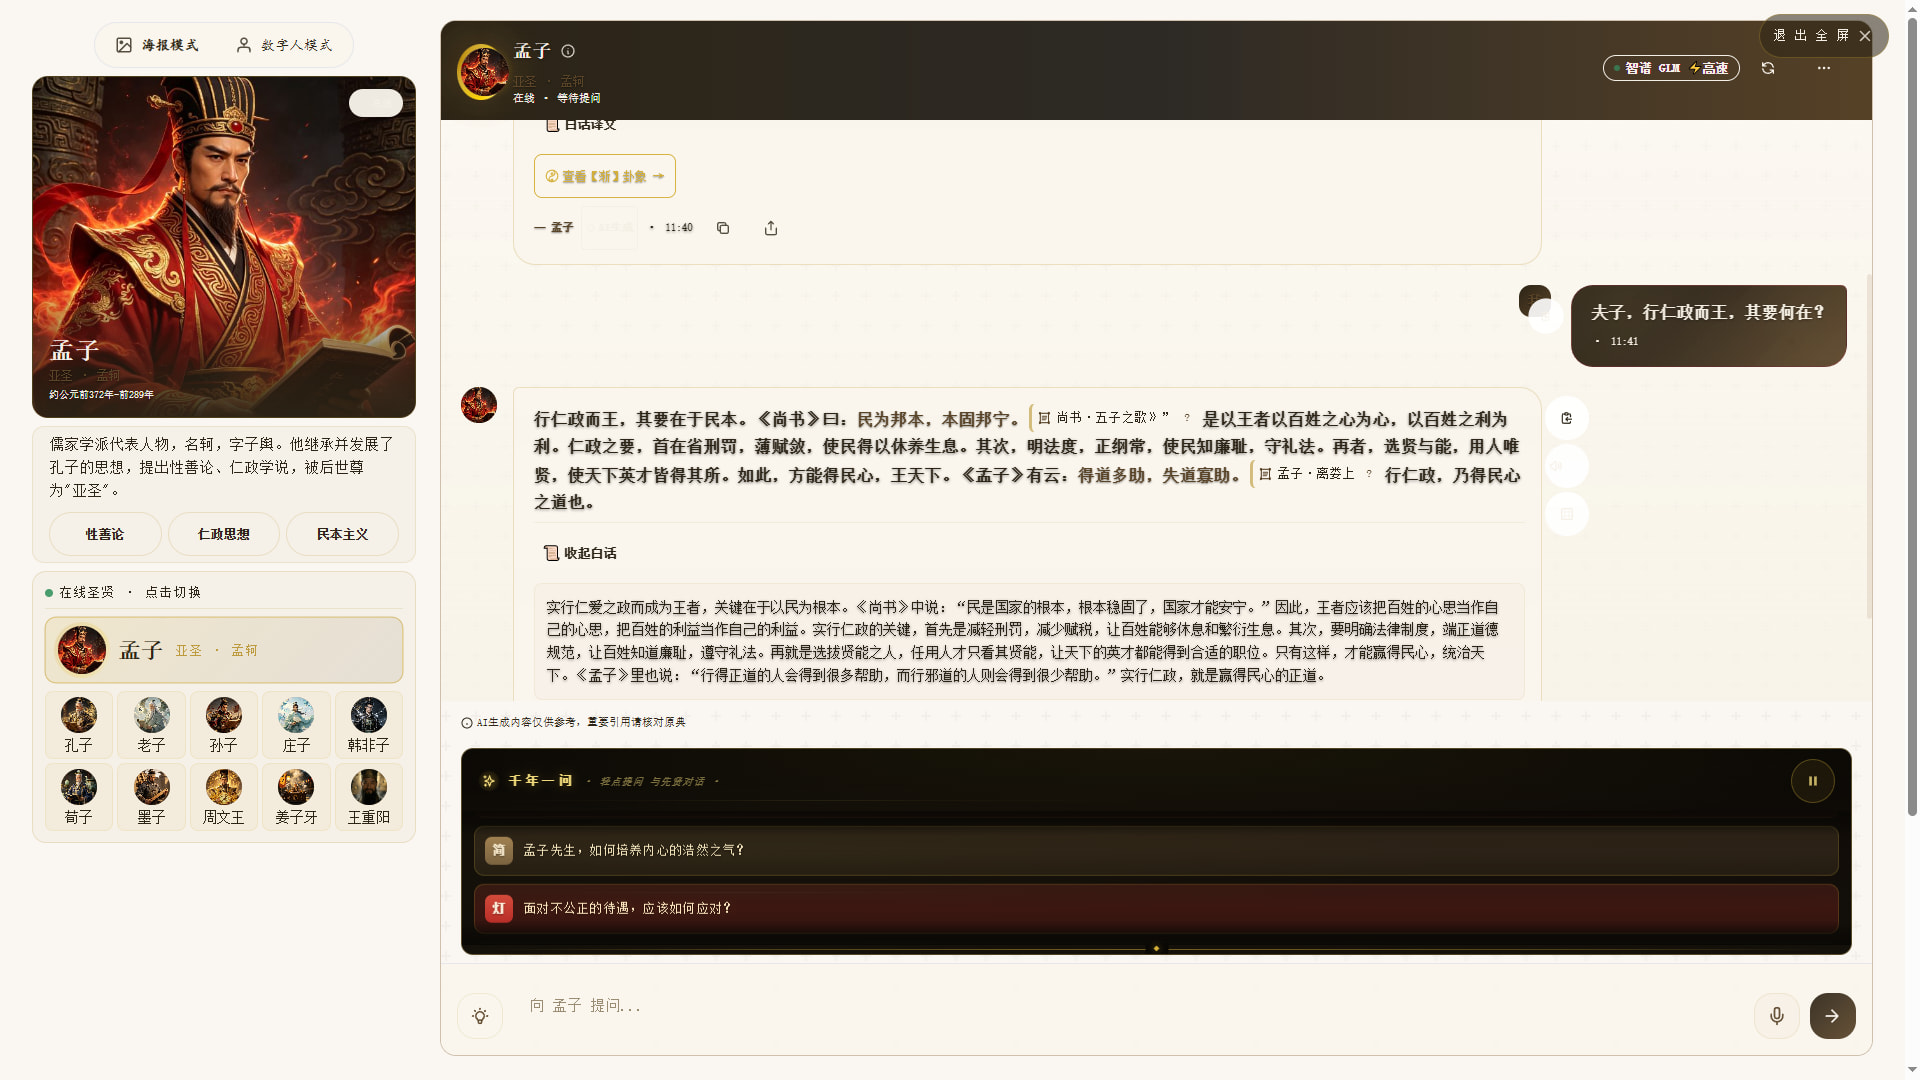
▲ AI 回复中的原文引用全部高亮并标注出处,金色 = 经典原文、蓝色 = 历代注疏、灰色 = AI 解读,核验失败的内容一律降级为"AI 解读"。
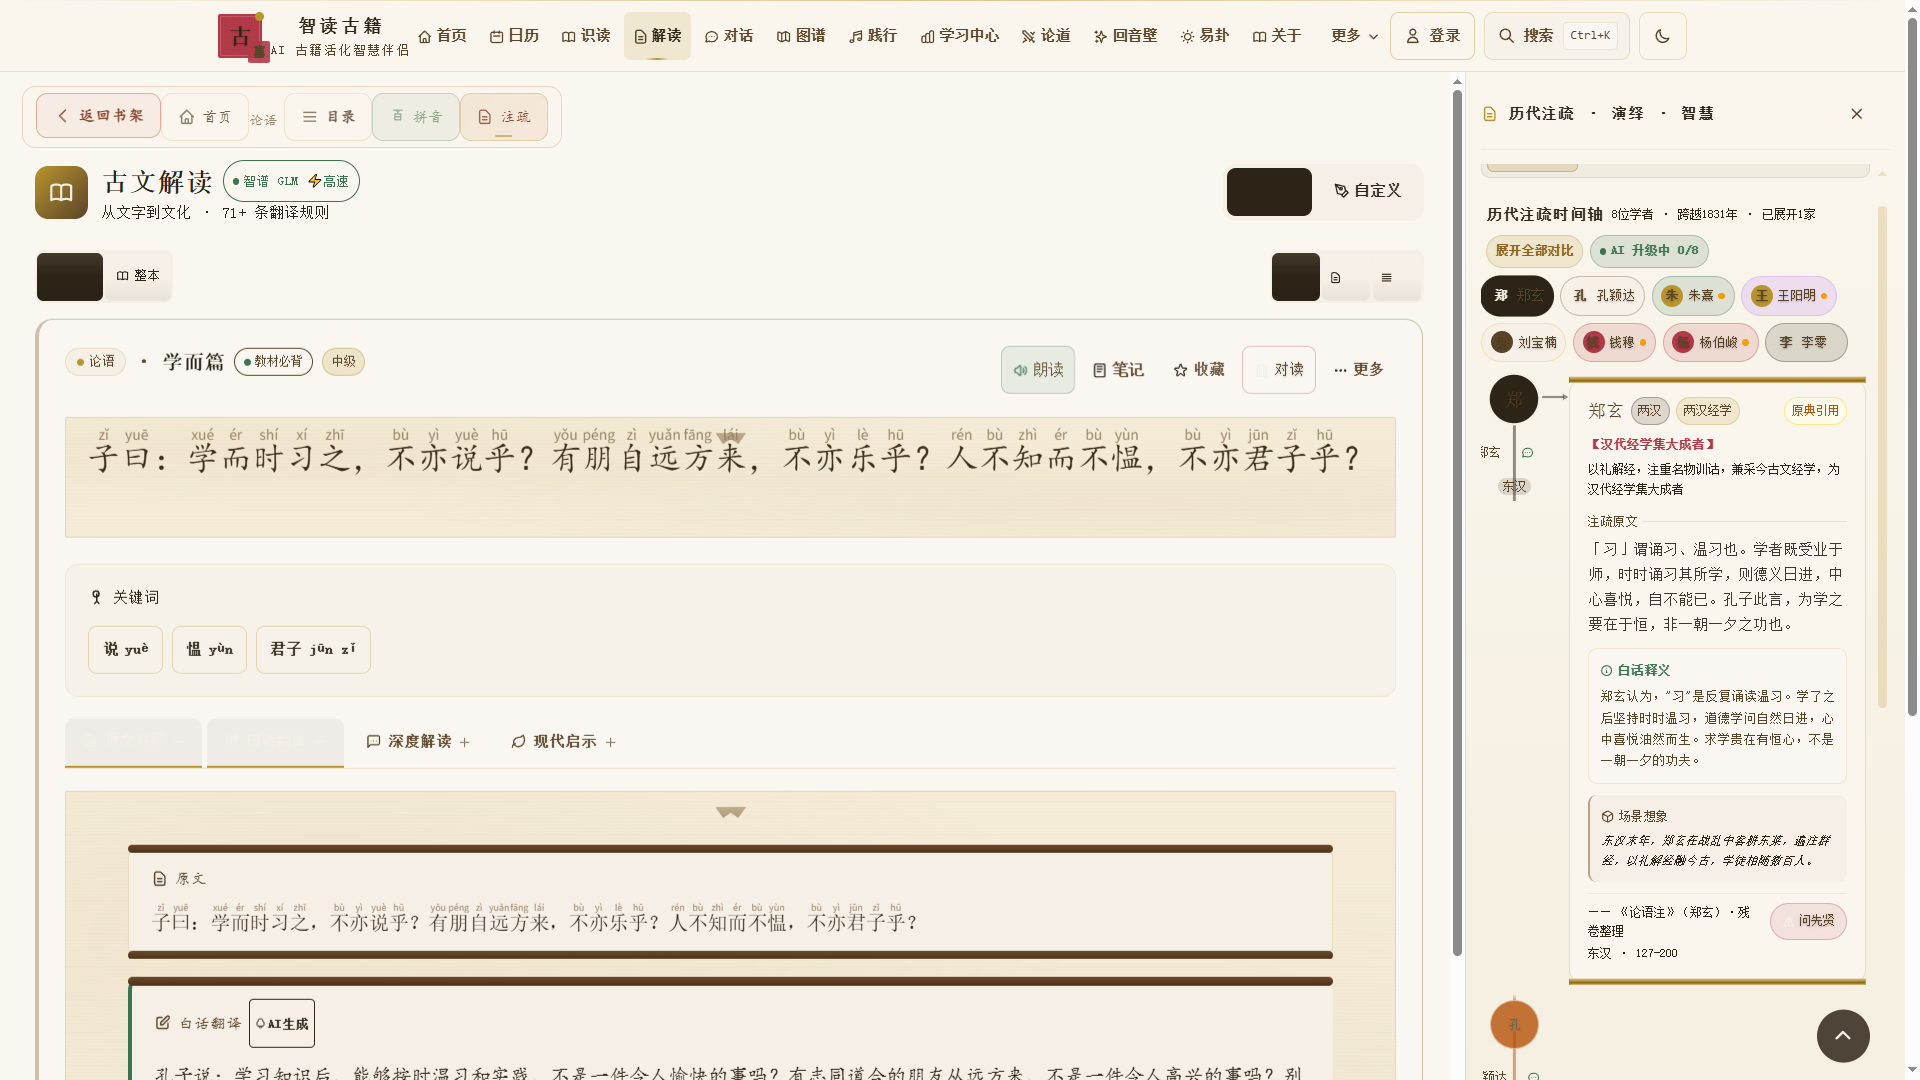
▲ 点开《论语》“学而时习之”,不光有原文和白话翻译,还能看到郑玄(东汉)等历代学者怎么注、怎么解。
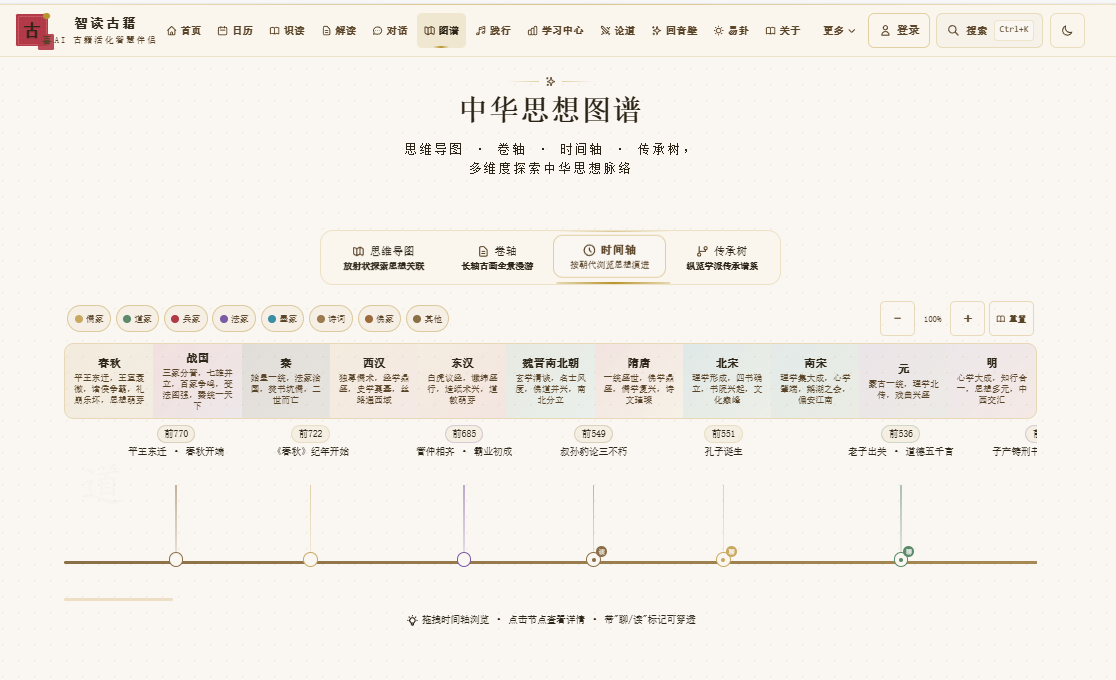
▲ 202 个节点覆盖人物-典籍-学派-事件,思维导图 / 卷轴 / 时间轴 / 传承树四视图联动,点击可跳转对话与解读。
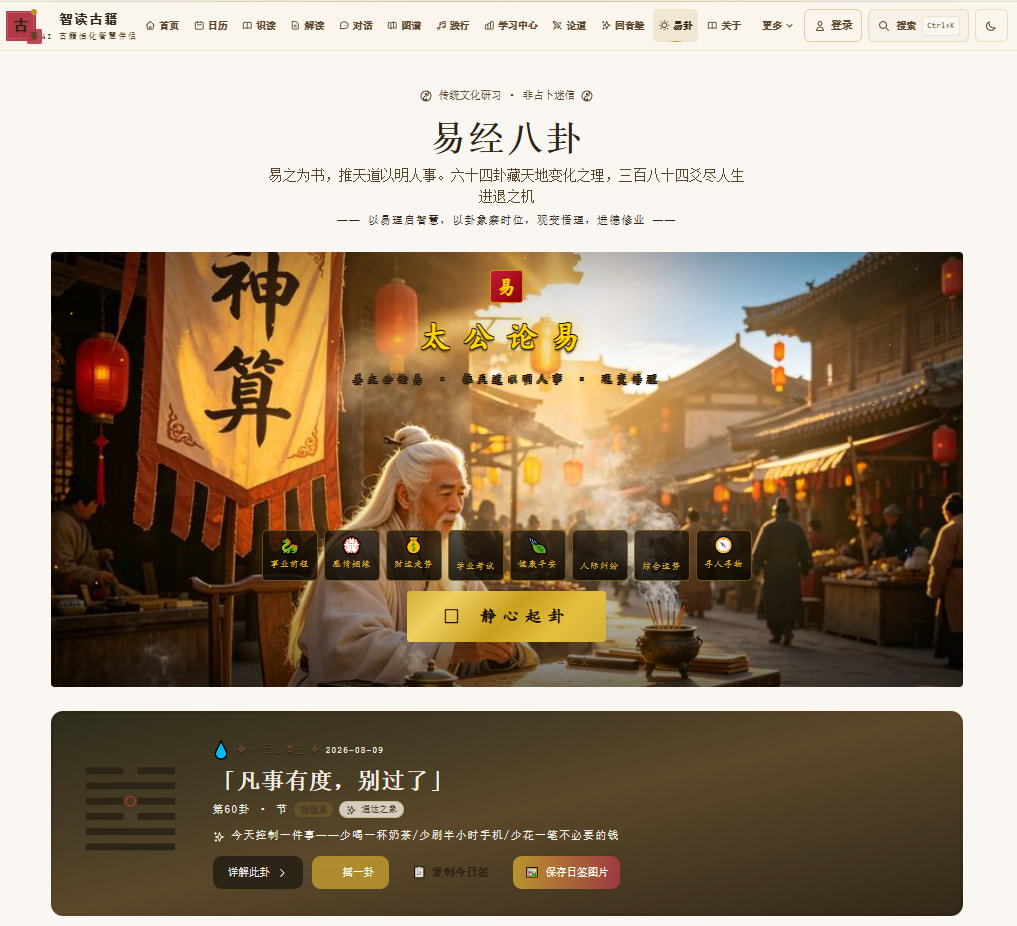
▲ 64 卦完整解卦,三种起卦方式,页面顶部明示"传统文化研习 · 非占卜迷信",给出易理启示与行动建议。
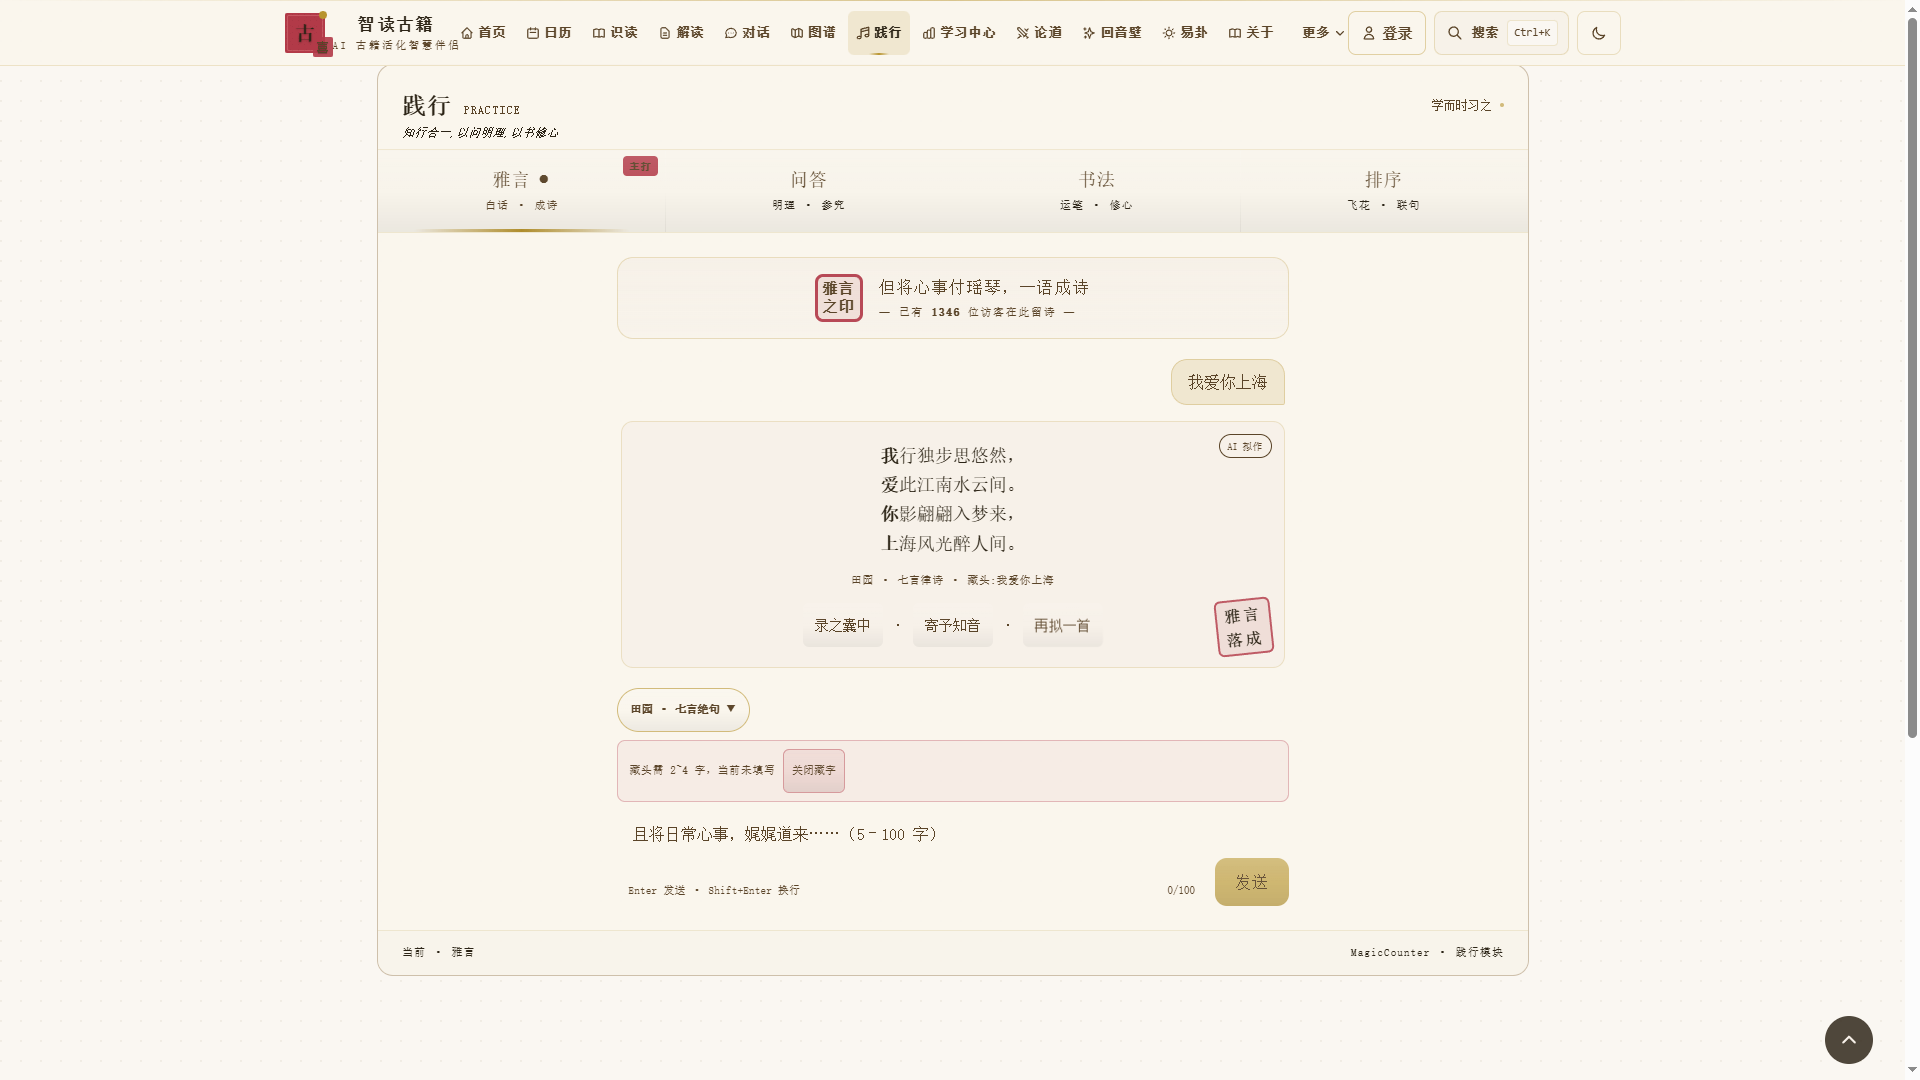
▲ 写下白话心事,AI 回以古诗。藏头 / 藏尾、诗风体裁可选,作品明确标注"AI 拟作"。
相比初赛 Demo 的升级
| 维度 | 初赛 Demo | 复赛成品 |
|---|---|---|
| 内容可信度 | AI 直接输出,无防伪 | 三态徽标引用核验系统,每句话标明出处性质 |
| 测试保障 | 0 个自动化测试 | 238 个单元测试 + 53 个端到端测试 |
| 可用性兜底 | 单点部署,API 挂则全站挂 | 三级降级(主备 AI → 本地规则引擎) |
| 部署形态 | 单一线上链接 | 国内入口 + 海外入口 + 单文件离线版(双击即用) |
| 数据安全 | 简单存储 | 登录云端持久化 + 匿名本地优先 + 按用户隔离存储 |
三、产品演示视频
无
四、产品创作历程
起点:被两本书击中
一本是爷爷的《论语》,三十年没翻完;一本是公司的文档处理任务,两小时变一分钟。前者让我愧疚,后者让我相信:AI 不该只是年轻人的工具,它也可以帮普通人把亏欠了几十年的文化传承补上。
初赛:把想法跑通
6 月 17 日项目初始化,6 月 18 日完成核心对话模块,6 月底黑金史诗 UI 与姜子牙易卦场景成型,初赛 Demo 上线。初赛结束后收到很多留言:如:电影级别的图片特别好看
转折:一个让我后背发凉的问题
有一次测试,AI 生成了一句"朱熹曰",说得有模有样,但我翻遍《四书章句集注》根本找不到这句话。
那天我坐在电脑前愣了很久。做这个产品的初衷是让人"读对"经典,如果 AI 把假的说成真的,那我不是在帮人,是在害人。
所以复赛这一个月,我们没有盲目堆新功能,主要在做一件事:让这个产品说的每一句话,都尽可能是可核验的。
复赛攻坚:四个关键决策
决策一:建三态徽标,把"谁说的"钉死
所有带引号的内容,由 quoteParser 统一解析,再经 citationVerifier 在本地语料库逐条核验。核验结果三态分流:精确命中标"经典原文"并给出出处;部分命中标"历代注疏"并注明学者朝代;核验失败一律降级为"AI 解读"。宁可错杀一千个真引用,也不放过一个假的。文化产品,诚信是底线。
决策二:补测试,外行改代码才敢下手
初赛时一个测试都没有,改一个地方,手动点十分钟验证。复赛补齐了 238 个单元测试(Vitest,覆盖引用解析、核验、检索、编排、安全等)和 53 个端到端测试(Playwright,覆盖冒烟、关键流程等 5 个场景)。现在每改一处,跑一遍就知道有没有改坏。
决策三:做三级降级,路演时 API 挂了也不怕
有一次半夜测试,大模型 API 突然超时,页面白了。我盯着那个空白页看了很久——要是评审的时候正好赶上 API 抽风,做得再好也白搭。
于是做了三级降级:主 AI 引擎异常自动切备用 AI(服务端多 Key 轮询 + 熔断 + 跨供应商降级链),都不可用则切本地规则引擎——65 条智慧语录、82 道题、64 卦基础卦辞全部预置本地,核心功能永远能用。
五、TRAE 实践过程
我们怎么用 TRAE 开发
整个项目从第一行代码到部署上线,全程在 TRAE 中完成。工作方式大致是:我用白话描述想要什么、感觉哪里不对,TRAE 负责实现;我负责三件事——做产品决策、读内容对错、磨审美细节。
- 写代码:我描述意图,TRAE 实现;
- 查 bug:控制台报错我看不懂,直接贴给 TRAE,它定位问题给方案;
- 写测试:238 个单元测试与 53 个端到端测试,大部分由 TRAE 起草,我来审核与调整;
- 架构讨论:三级降级、引用核验链、三轨部署,都是在与 TRAE 的对话中逐步成型的;
- 深夜陪改:凌晨两点测试跑不过,TRAE 不会不耐烦,陪我一遍一遍调。
但有几件事 TRAE 替不了:三态徽标的设计决策、什么功能该砍该留、AI 编的假引注(最初是我自己读出来不对的)、以及审美判断。产品做砸了,责任也是我的。
 Session 1 · 创意启动
时间:2026年6月17日 09:01:08
阶段:第一阶段 · 种子萌芽
核心工作:从0到1梳理需求、设计产品架构、搭建React+TypeScript+Vite项目骨架
关键产出:PROPOSAL.md(300多行产品提案)、项目基础结构
.3041719401614576:0974df2aea2e46f1527b980486f62b04_6a31ec88049b15b4a5b96de2.6a31f1d4049b15b4a5b96e48.6a31f1d4a758e1bf1625ff84:Trae CN.T(2026/6/17 09:01:08)
Session 2 · 核心功能成型
时间:2026年6月18日 08:01:43
阶段:第二阶段 · 核心成型
核心工作:古籍解读模块、知识图谱、先贤基础对话系统实现
关键产出:三大核心模块完成、5位先贤上线、初赛帖首次发布
.33435435925884:45d4d3769a2eeac14dd09c399834674a_6a33a22bbddb8dab27f82564.6a340857bddb8dab27f83a6d.6a340857d092906496aa75b7:Trae CN.T(2026/6/18 08:01:43)
Session 3 · 黑金殿堂UI革命
时间:2026年6月25日 17:41:50
阶段:第三阶段 · 体验升级
核心工作:v6-v7黑金史诗殿堂风格重构、电影级UI迭代、Ken Burns推拉效果、金色粒子特效
关键产出:黑金殿堂风格首页、电影级视觉体验
.2534795986613488:1580d1fa8f51c388d6395c43485d7d69_6a3cf78e464e29c285057296.6a3cf7de464e29c28505729b.6a3cf7def295ffce66ed35db:Trae CN.T(2026/6/25 17:41:50)
Session 4 · 姜子牙电影场景
时间:2026年6月26日 17:01:50
阶段:第三阶段 · 体验升级
核心工作:太公神算模块开发、姜子牙清晨古街问卦电影场景、8大场景解卦系统雏形
关键产出:姜子牙仙风道骨形象、清晨古街电影级场景
.3595870788926890:819698be7bf43a26ca71709927785b43_6a3c834c9ecbf22c44bf415b.6a3e3ffe32c04a3eb3df10e8.6a3e3ffedb2829f1b0962bb3:Trae CN.T(2026/6/26 17:01:50)
Session 5 · 专业解卦引擎
时间:2026年6月28日 17:30:29
阶段:第三阶段 · 体验升级
核心工作:8大场景分主题专业解卦系统、500-800字长文解卦、情感化文案设计
关键产出:64卦×8场景专业解卦、共情开场白、凶卦柔化处理
.2068628907765076:9ae0484f7dda7dba8a6c45e30112ccba_6a33a1c6277ab4597b4e2a20.6a40e9b55d9178b8e45e116e.6a40e9b5832b073ea25eca49:Trae CN.T(2026/6/28 17:30:29)
Session 6 · 全面修复验证部署落地使用 Session 太多 直接贴图
时间:2026年8月
阶段:第四阶段 · 落地
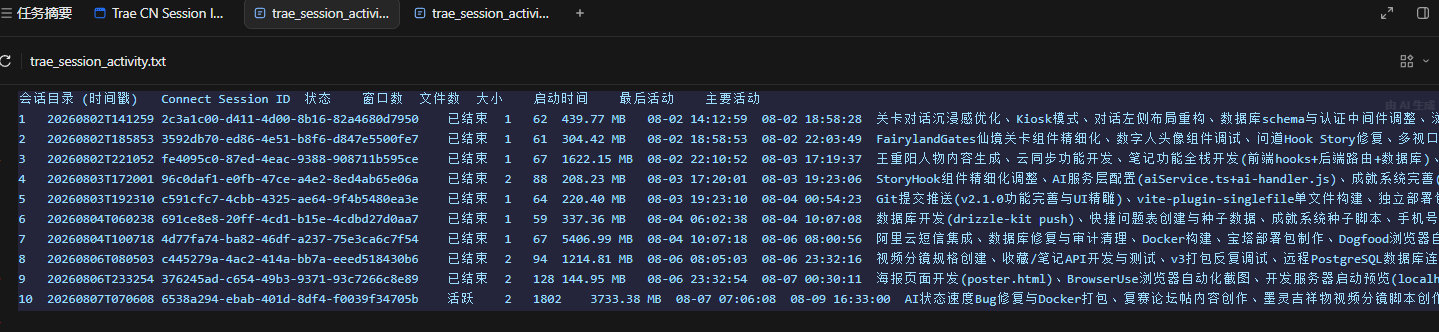
六、技术方案
总体架构
用户浏览器
  │
  ├─ 前端:React 18 + TypeScript + Vite 5 + Tailwind CSS + Three.js
  │    ├─ 引用核验链:quoteParser → citationVerifier → 本地语料库比对 → 三态徽标
  │    ├─ 知识检索:BM25 本地知识索引(800ms 超时保护)
  │    └─ 本地兜底:规则引擎 + 预置内容(语录/题库/卦辞)
  │
  ├─ 服务端代理:Hono(Node.js)
  │    ├─ /api/ai:多供应商 OpenAI 兼容接入,豆包(火山引擎)优先
  │    │    SSE 流式输出 · 多 Key 轮询 · 熔断 · 跨供应商降级链
  │    └─ PostgreSQL(Drizzle ORM):用户、进度、成就、笔记持久化
  │         匿名用户本地存储,登录后自动迁移上云,数据按用户隔离
  │
  └─ 部署:国内静态托管+云函数
AI 工程要点
- 多供应商冗余:服务端统一代理,主备切换对前端无感;
- 流式体验:SSE 逐字输出,长文解读不等待;
- 人格稳定:每位先贤独立 System Prompt 约束语料边界与语言风格;
- 合规设计:AI 内容全程显式标识,易卦模块明示"研习非占卜",API Key 不落前端。
七、社会价值
受众规模
想读经典的普通人以亿计,但真正能跨过文言文门槛的是少数。学生要考试,家长要启蒙,银发族想圆年轻时的读书梦——核心功能永久免费、无需注册即可使用、支持大字体与夜读模式、离线版双击即用,这些设计都是为最普通的人准备的,特别是文言基础薄弱的群体和老年读者。
社会效益
古籍数字化解决了"看得到"的问题,但看得到不等于读得懂,通用 AI 问答又解决不了"读不对"。智读古籍的选择是"活态化":用对话降低门槛,用注疏时间轴还原学术传承,用三态徽标守住内容诚信。如果这套"AI 内容显式标识 + 本地语料核验"的做法能被更多文化类产品参考,它的价值就不止一个应用本身。
可复制性
"先贤人格 Prompt 约束 + 本地结构化语料 + 引用核验链 + 三轨分发"的整套方案,与具体典籍内容解耦。同样的骨架可以迁移到中医药典籍、地方志、博物馆馆藏讲解、图书馆古籍服务等场景。赛后核心代码将开源,教育机构、公共图书馆、文博单位、公益组织可免费使用(保留署名、禁止商业化)。
八、迭代规划
- 近期(赛后 1-2 个月):补全更多典籍的注疏覆盖;先贤人格稳定性专项调优;OCR 识别增强;
- 中期:注疏学者扩编、图谱节点扩充至 500+;开放用户共创语录与笺注;
- 远期:与图书馆、文博机构合作落地"古籍伴侣"公益版;原生移动端评估;多语种译介探索。
结语
做智读古籍这几个月,我们最大的收获不是学会了写代码,而是明白了一件事:诚实比完美重要。
AI 时代,与其焦虑被取代,不如主动拥抱 AI,让 TRAE 成为你的智多星。这段路让我深深理解:人人都可以创造。
打开它,和先贤说说话——两千年的智慧,一直在等你。
为往圣继绝学,不是学者的专利,是每个普通人都可以做的事。
——李喜庆
墨问队
2026 年 8 月