你书架上有多少本方法论书籍?
是不是每一本买的时候都信心满满,觉得这次一定要把方法用起来。结果呢?书翻完了,笔记记了,过三个月连讲什么都想不起来了,我也是这样。
直到我开始想,如果能把这些书的精华,直接变成 AI 能理解的 Skill 呢?
不需要再翻笔记,不需要每次都跟 AI 解释背景,上传一本书,它就能变成一个随时可调用的方法库。
这就是我做的这个 Skill:book-to-skill,一个能帮你把手里的工具书秒变可复用 Skill 的元 Skill~~
1、Skill 简介
book-to-skill 是一个”元 Skill“,它能帮你把任何方法论书籍(PDF 或 TXT 格式)自动转换成结构化的、可复用的 Skill。通过我自己设计的 16 个问题框架,深度提取书籍中的方法步骤、核心原则、警告提示、案例示例和工具模板,让一本书的精华变成随时可调用的 AI 能力。适合经常阅读工具书、方法论著作,希望把书本知识转化为实际行动的同学们使用。
2、使用场景
为什么做它?
我经常读各种方法论书籍,GTD、原子习惯、深度工作、思考快与慢等等,读完觉得很有道理,但过段时间就忘了,更别说在需要的时候真正用起来。书架上的书越来越多,真正改变行为的却很少。
之前遇到的麻烦:
-
读完书想用某个方法,却想不起具体步骤
-
笔记记得零散,不成体系,查找困难
-
不同书的方法论之间没有关联,无法组合使用
-
AI 助手虽然读过这些书,但每次都要重新解释背景
做出来之后能省掉哪些动作:
-
不用手动整理读书笔记,Skill 自动提取核心框架
-
不用反复翻书找某个方法的具体步骤,Skill 里一目了然
-
不用每次都给 AI 解释“这本书讲的是什么”,Skill 自带上下文
-
一本书变成一个可复用的能力模块,随时调用
3、创作过程
第一步:明确需求
和 SOLO 讨论后,我们确定了核心目标:不是简单总结书的内容,而是提取书里“可操作的方法论”。这需要一套系统化的分析框架。
第二步:设计 16 个问题框架
这是整个 Skill 的核心。我参考了多本经典方法论书籍的结构,发现它们都有共同特点:
-
有明确的问题定位和目标受众
-
有可执行的步骤流程
-
有必须遵守的核心原则
-
有常见错误和避坑指南
-
有配套的工具和模板
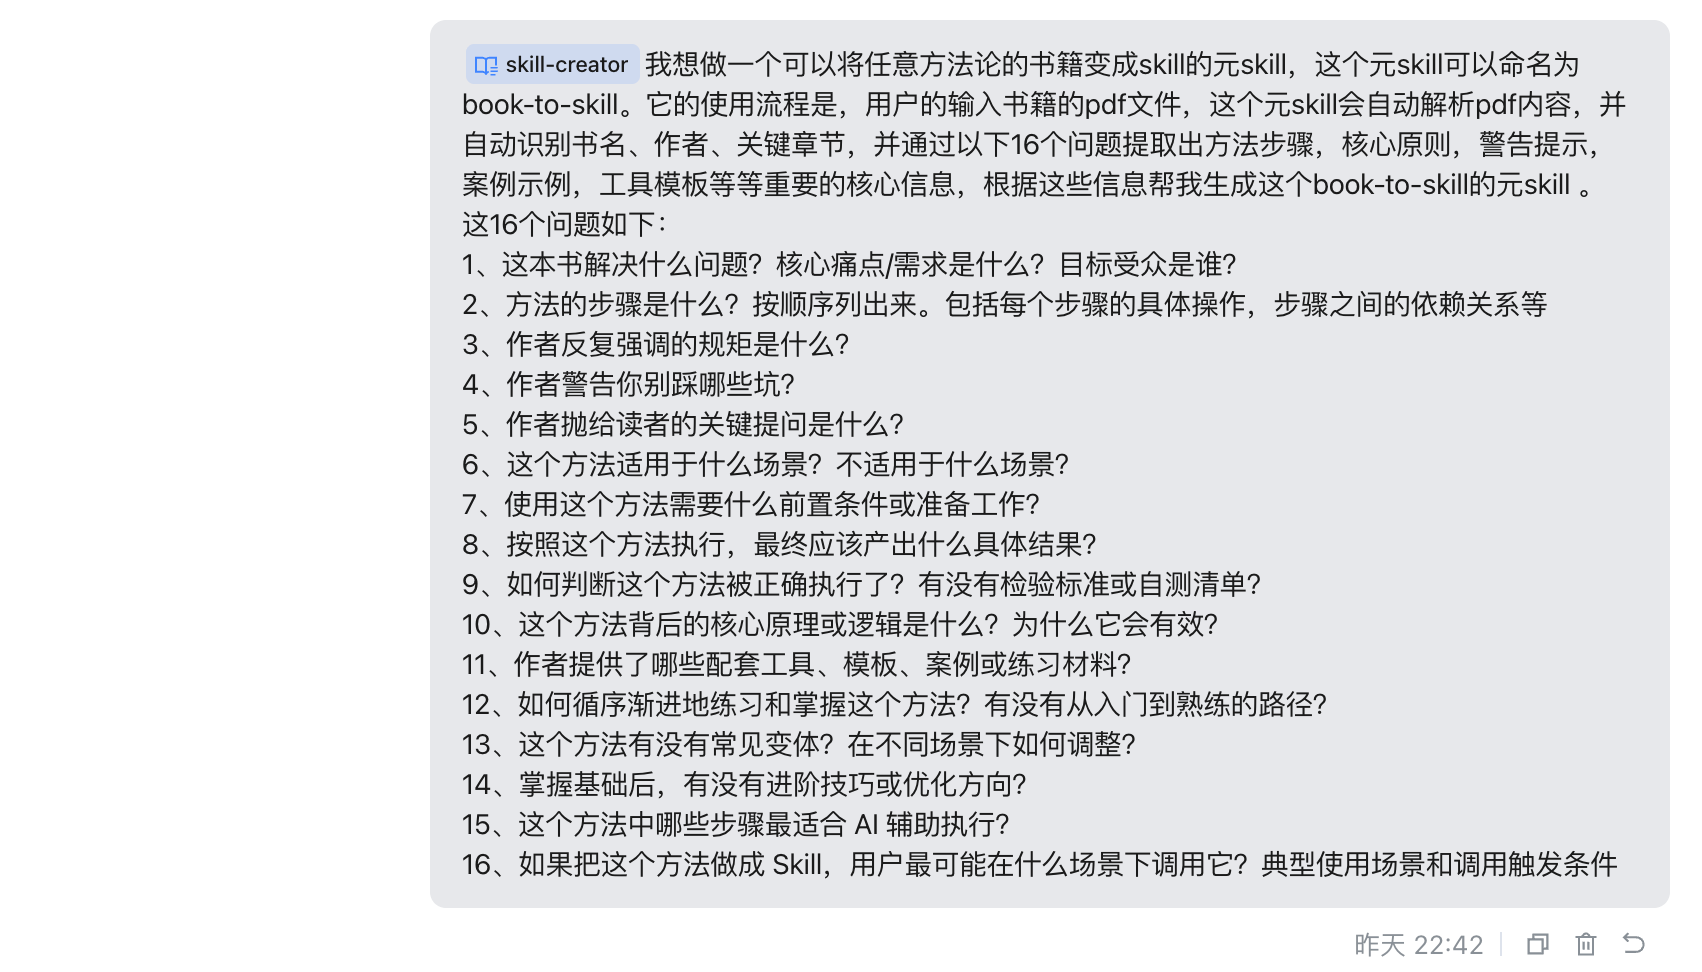
基于此,我设计了 16 个问题:
| 分组 | 问题 |
|---|---|
| 定位分析 (1-5) | 书籍定位、方法步骤、核心规矩、警告与坑、关键提问 |
| 使用指南 (6-9) | 适用场景、前置条件、预期产出、检验标准 |
| 深入理解 (10-14) | 核心原理、配套资源、学习路径、方法变体、进阶技巧 |
| AI 增强 (15-16) | AI 辅助点、Skill 化建议 |
第三步:实现内容提取
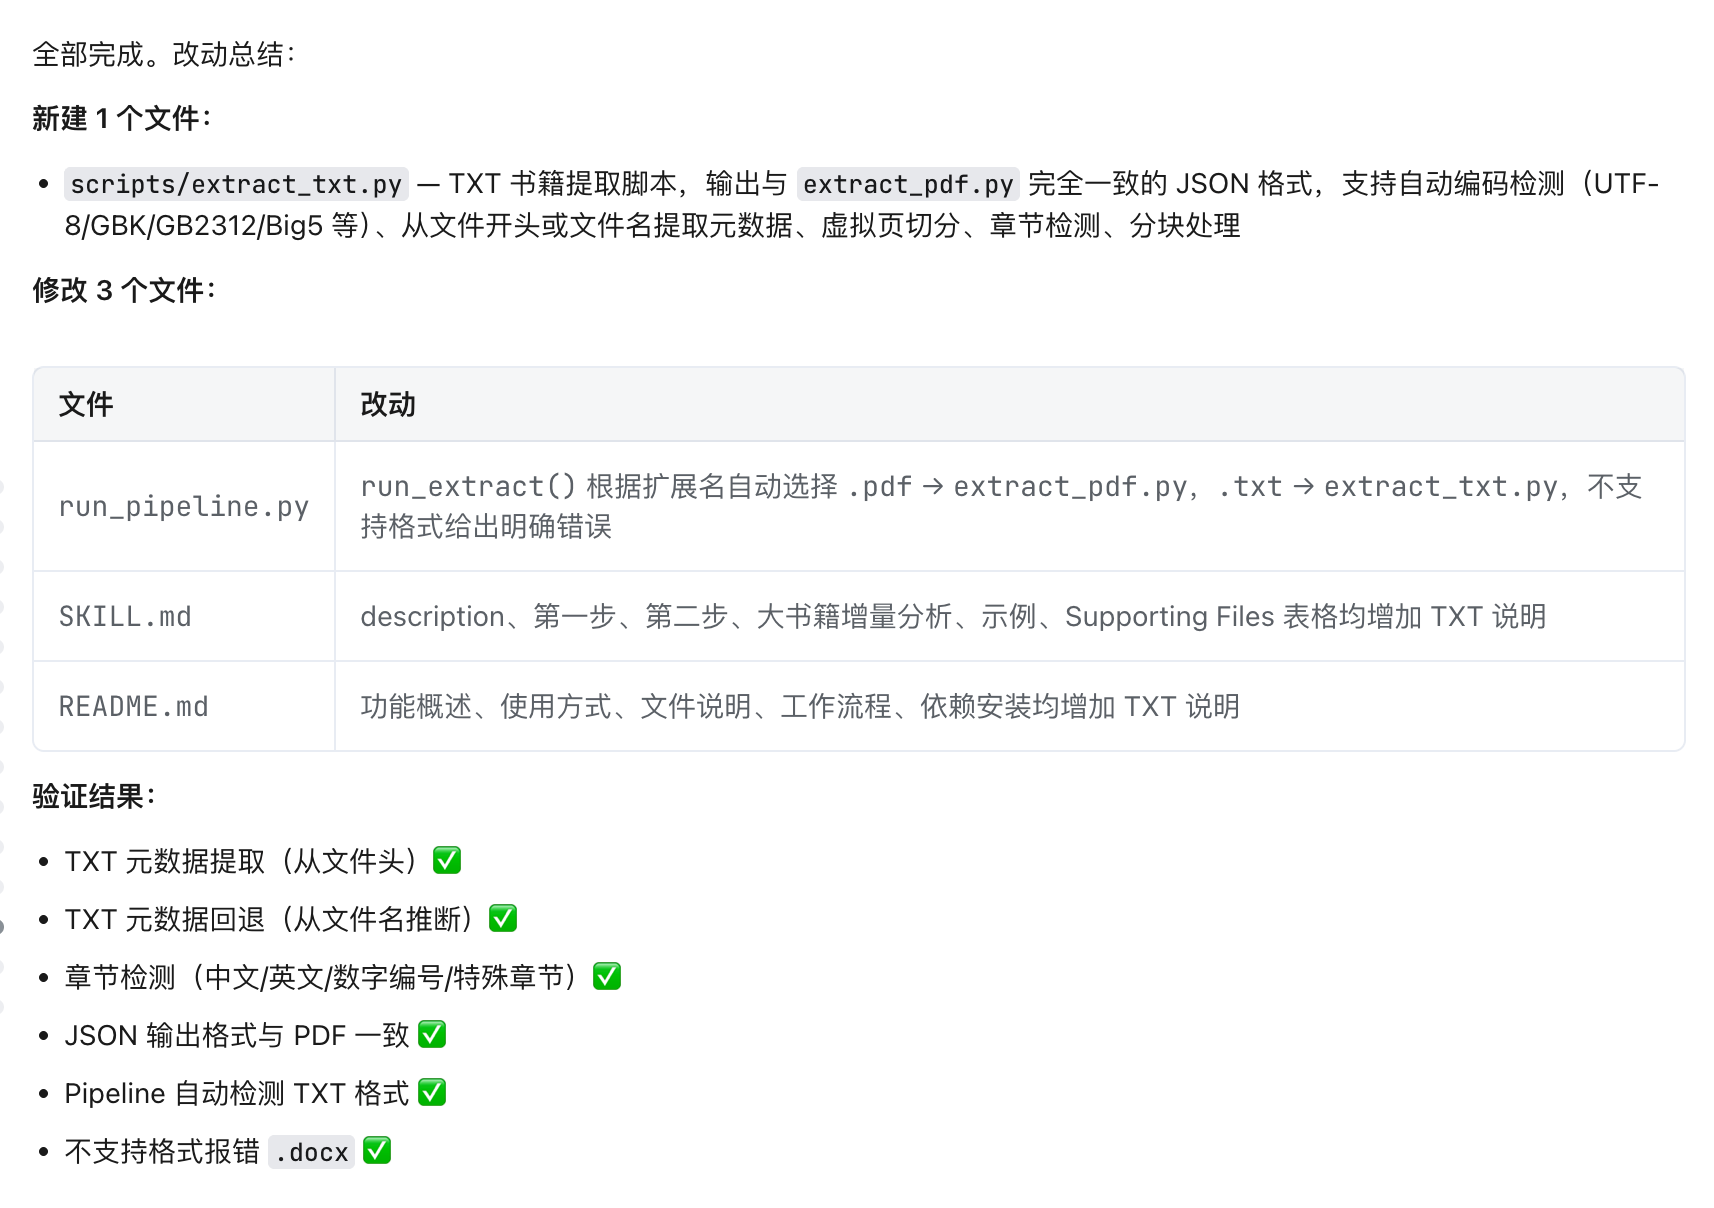
使用 Python 实现了 PDF 和 TXT 的内容提取:
-
PDF 提取:使用 PyPDF2 + pdfplumber,提取元数据、章节结构、完整文本
-
TXT 提取(这是在初版完成后追加的功能):自动检测编码(支持 UTF-8、GBK、GB2312、Big5),从文件头提取书名作者
-
大文件支持:超过 300 页自动分批处理
第四步:实现 Skill 生成
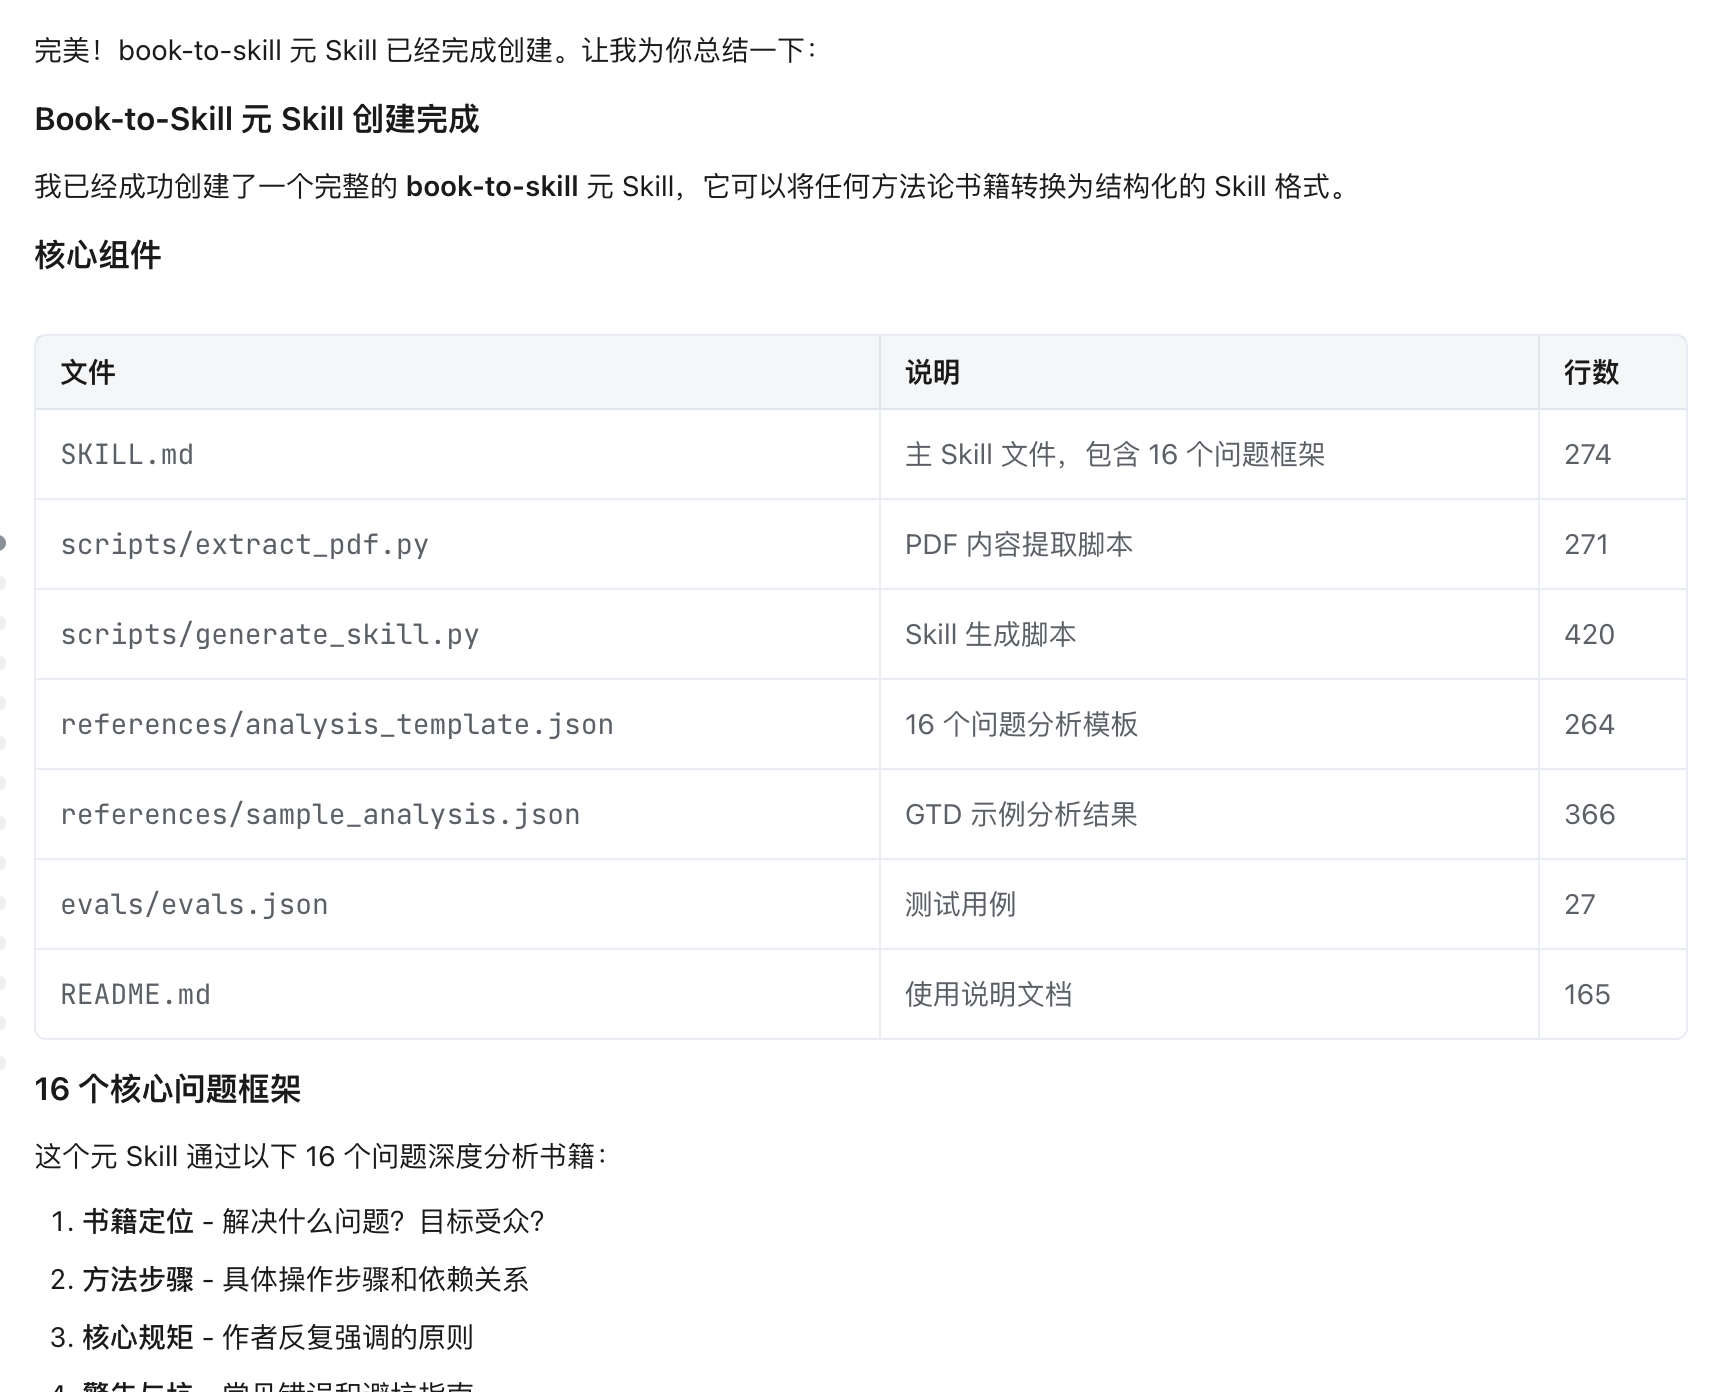
基于分析结果,自动生成标准 Skill 目录结构:
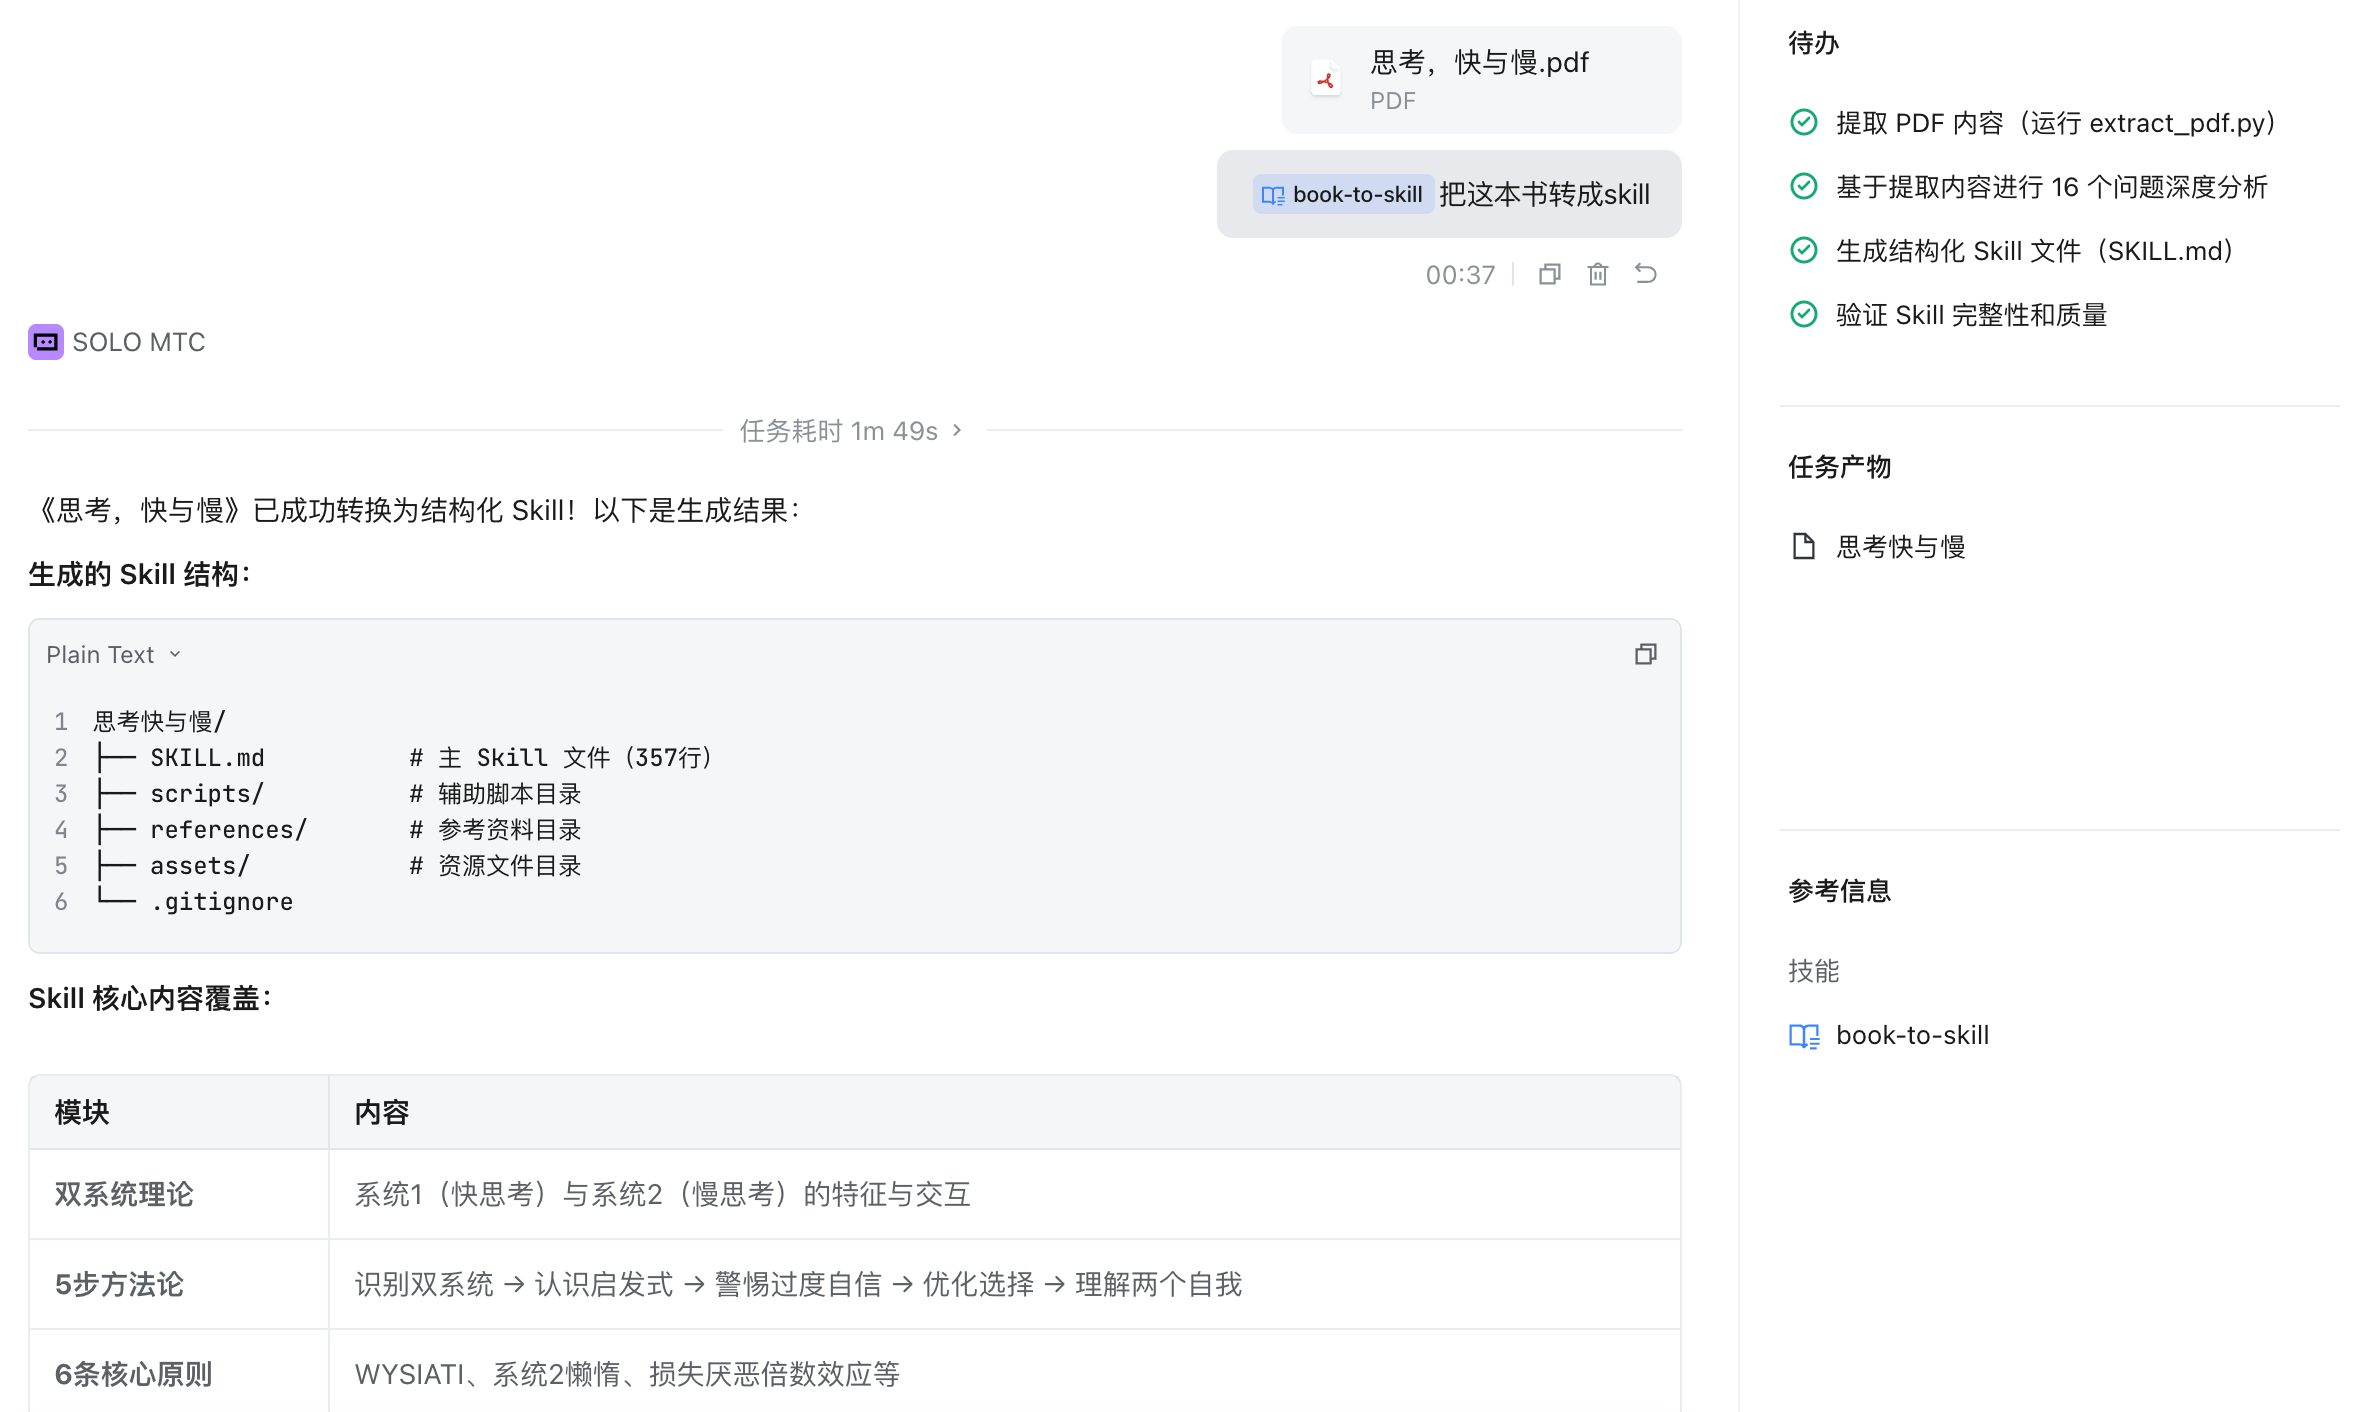
Plain Text
skill-name/
├── SKILL.md          # 主 Skill 文件
├── scripts/          # 辅助脚本
├── references/       # 参考资料
└── assets/           # 资源文件
第五步:添加书籍类型检测
因为不是所有书都适合转成 Skill,所以我添加了类型检测逻辑:
-
方法论/工具书 → 继续处理
-
小说/传记/散文/诗歌 → 提示用户,建议其他处理方式
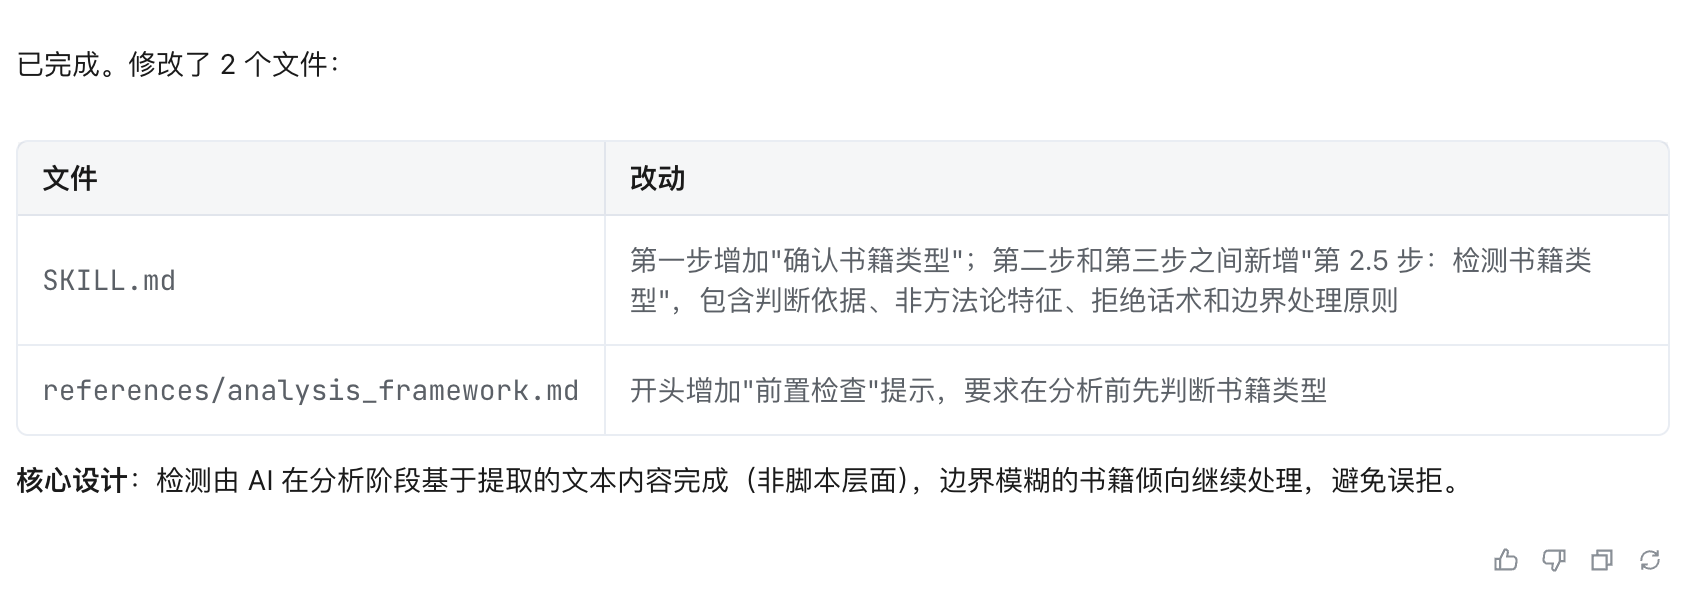
第六步:在反复测试的过程中,进行不断的迭代优化
-
添加了 GTD 书籍的完整分析示例作为参考
-
优化了 Skill 命名规范(小写+连字符)
-
添加了 evals 测试用例
-
规范 skill 生成的目录结构
-
等等….
4、使用步骤
自然语言触发,直接对 SOLO 说:
-
把这本书变成 skill
-
提取这本书的方法论
-
帮我总结这本书的方法框架
上传 PDF 或 TXT 文件后,SOLO 会自动调用 book-to-skill 完成转换。
5、效果展示
示例1:将《小狗钱钱》转换为 Skill
输入: 书籍的 PDF 文件
主要处理过程:
-
提取书名、作者、章节结构
-
提取书籍内容
-
通过 16 个核心问题深度分析
-
生成 Skill 文件
输出结果:
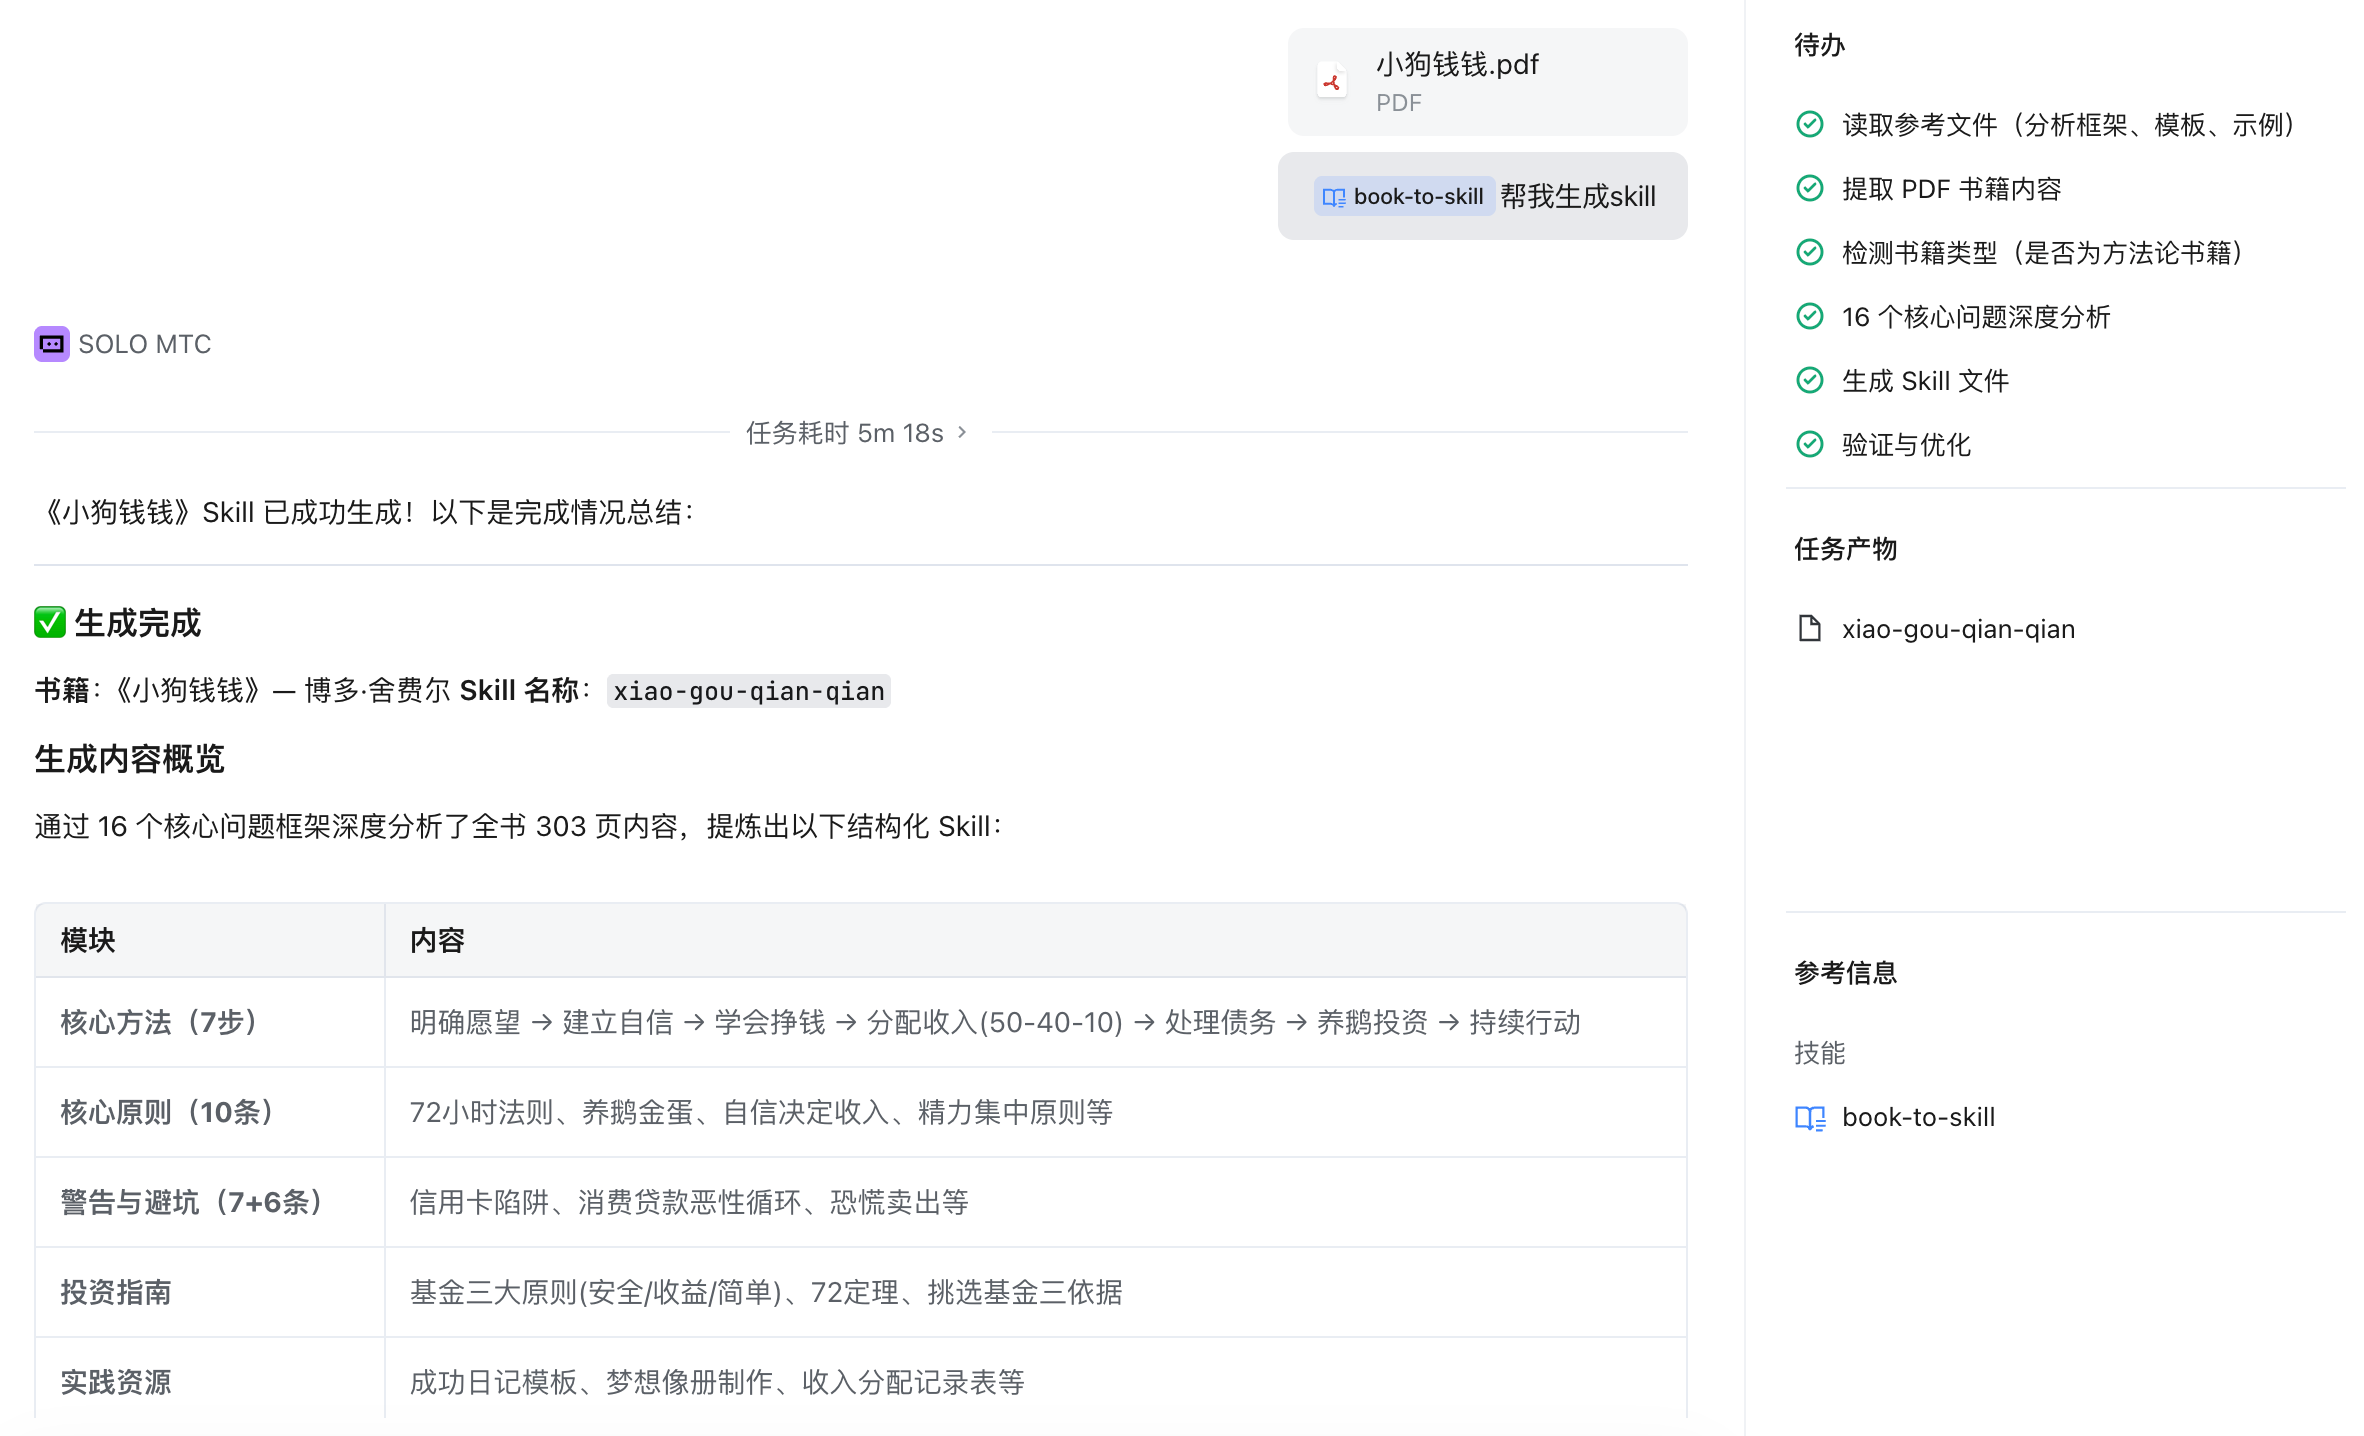
转换前后对比:
| 维度 | 转换前 | 转换后 |
|---|---|---|
| 查找方式 | 翻书、翻笔记 | 直接问 Skill |
| 内容结构 | 零散笔记 | 结构化框架 |
| 可复用性 | 每次重新解释 | 随时调用 |
| AI 理解 | 需要背景说明 | 自带上下文 |
生成的《小狗钱钱》 skill 使用结果:
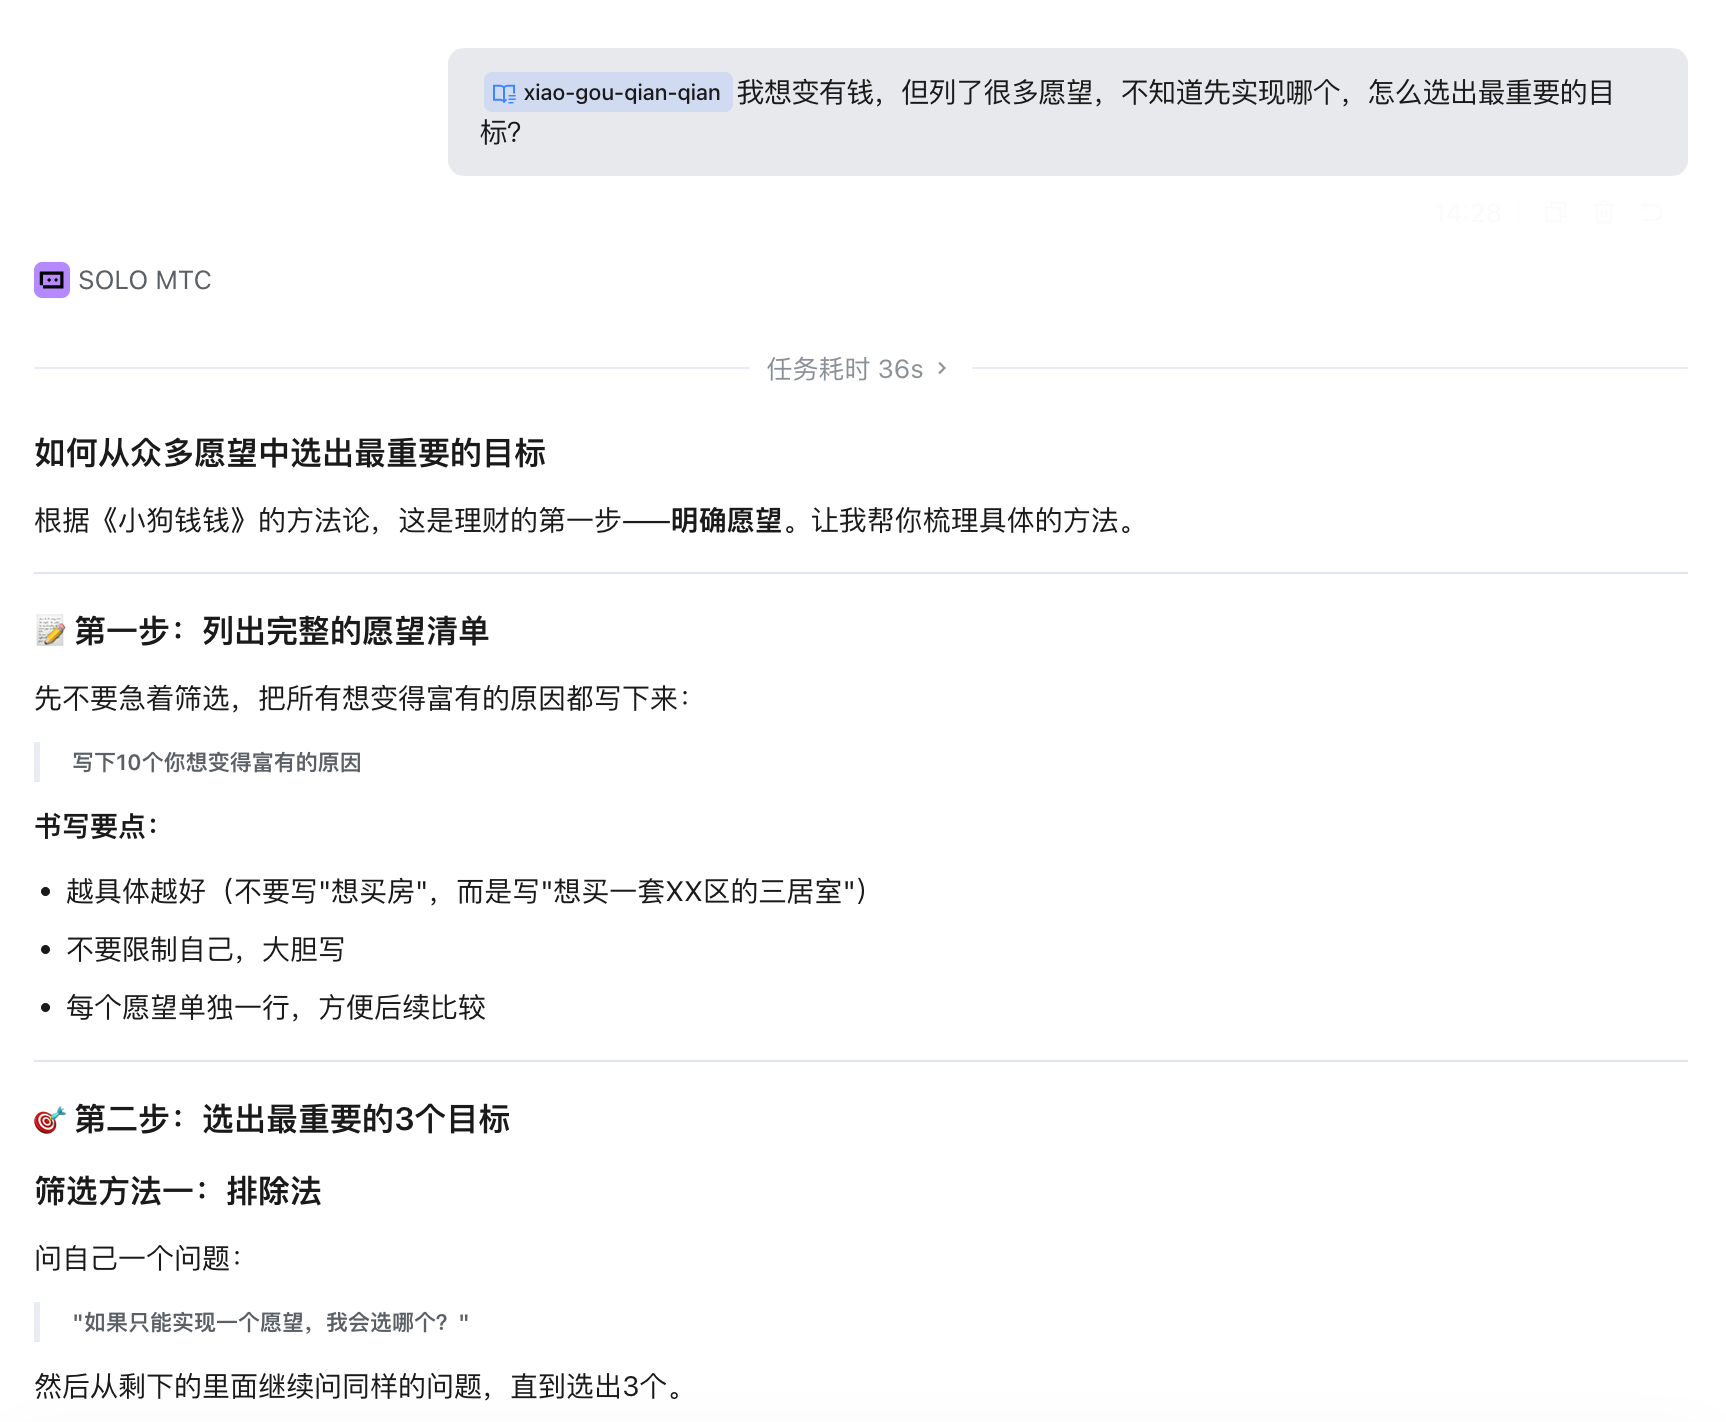
示例2:将《纳瓦尔宝典》转换为 Skill
输入: 书籍的 PDF 文件
输出结果:
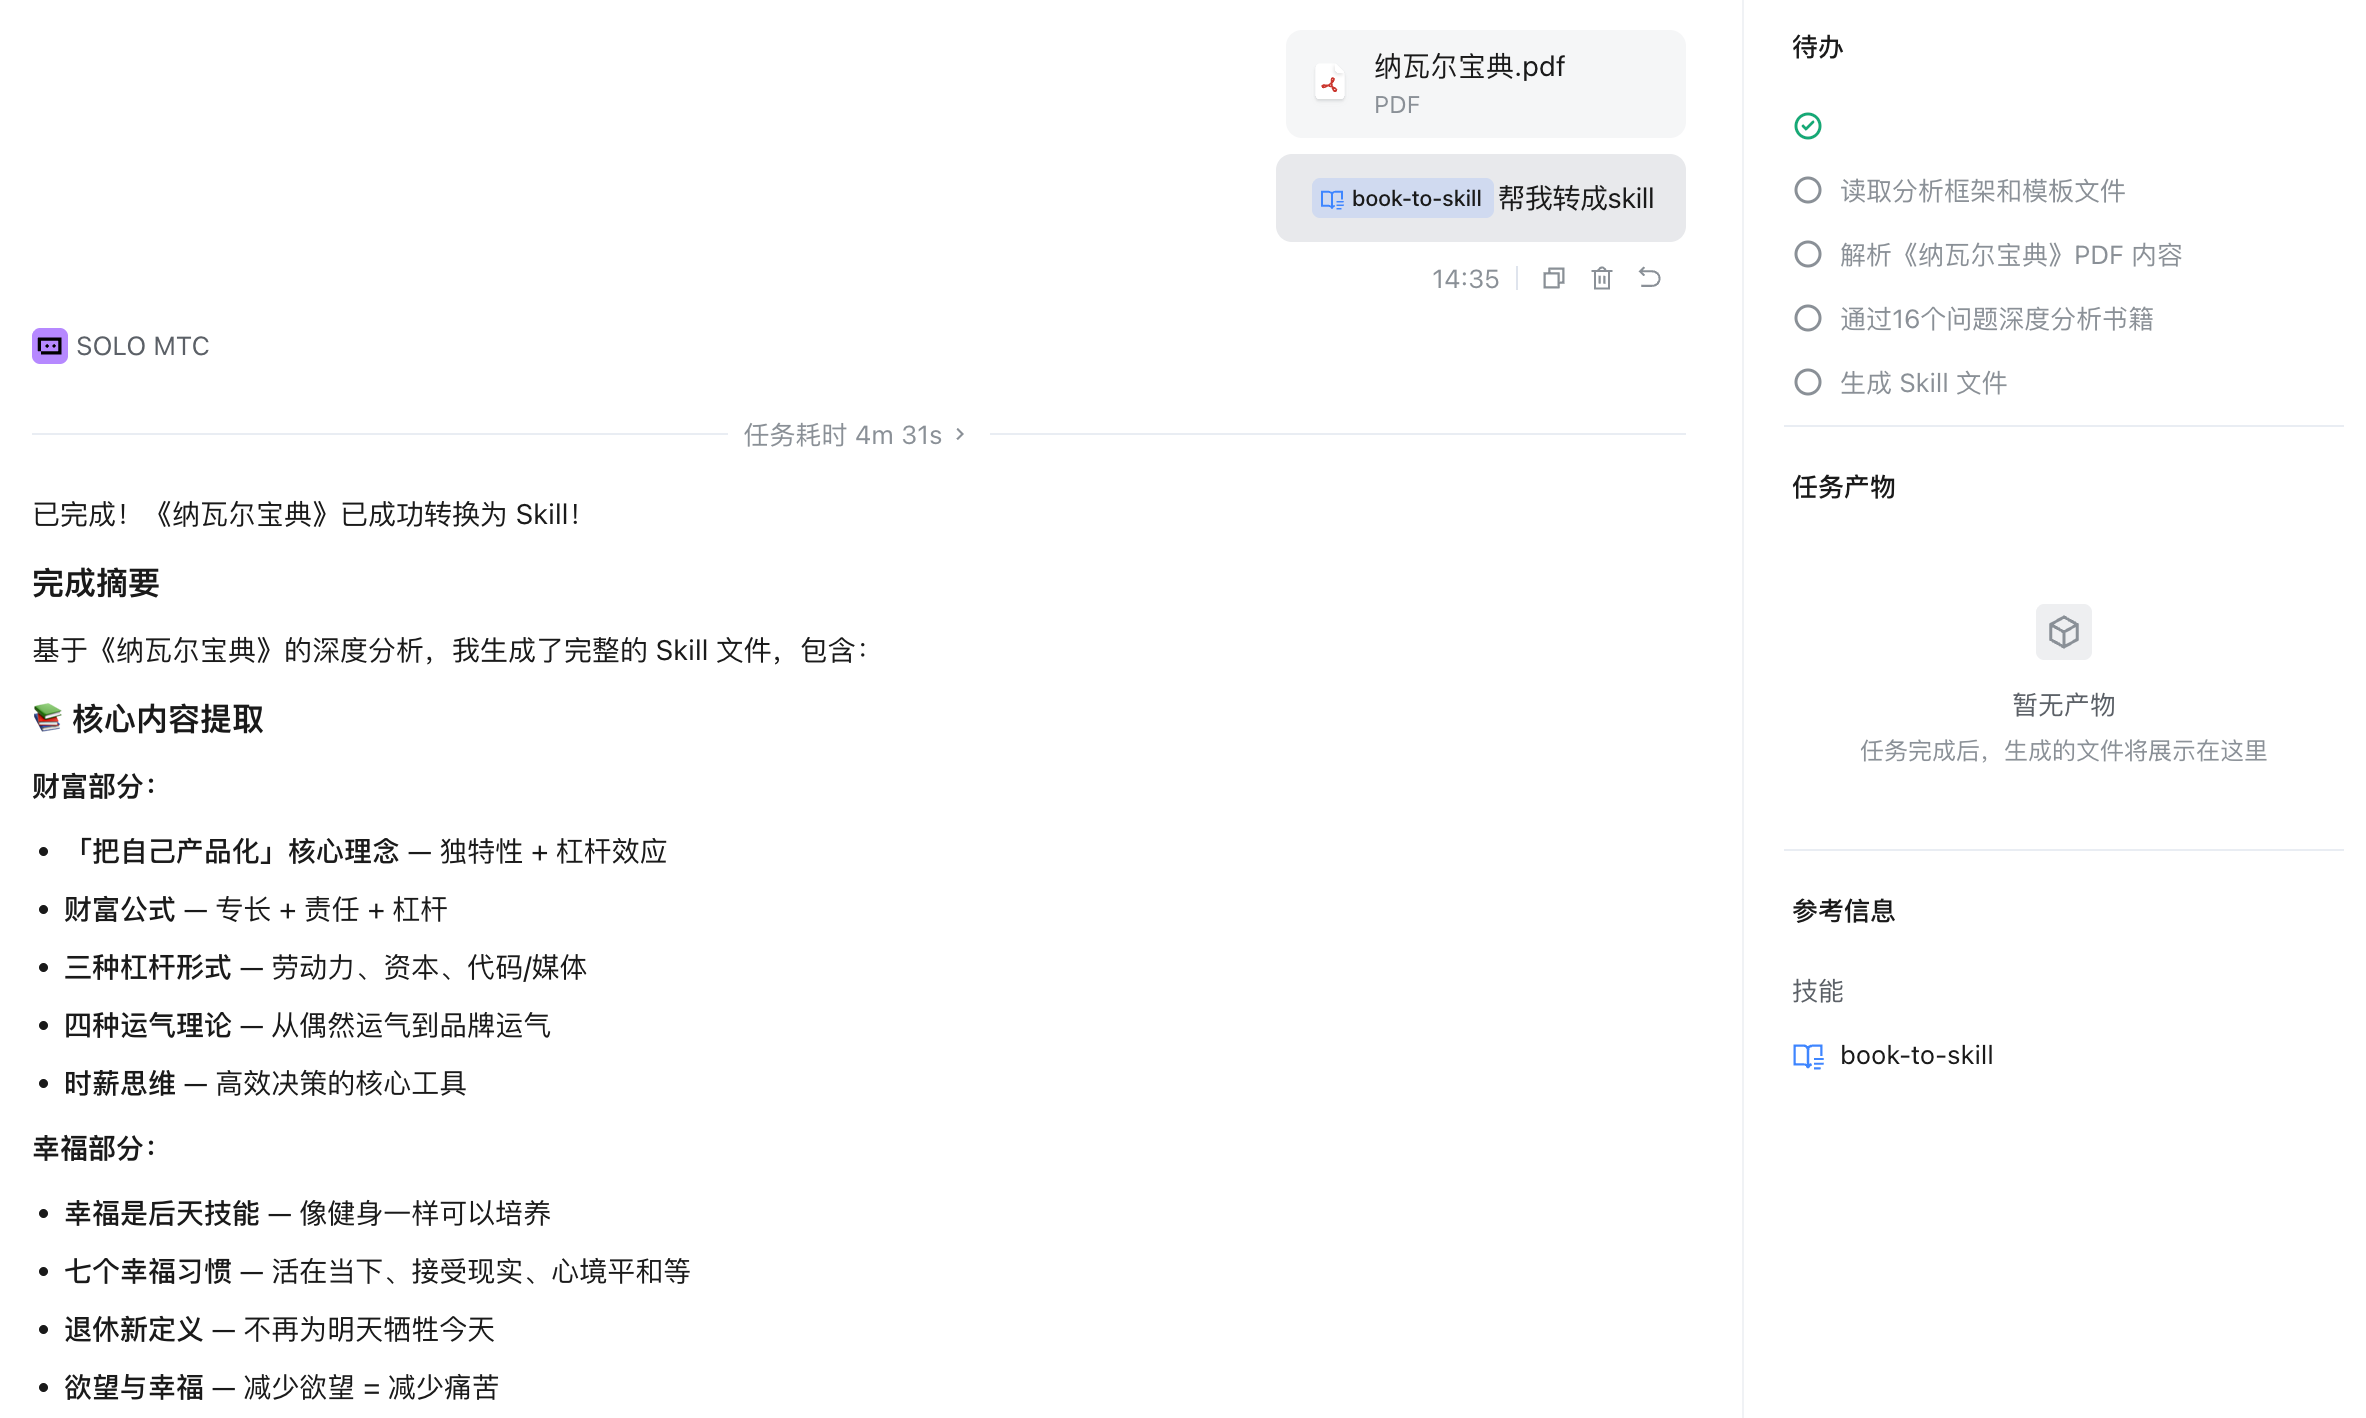
生成的《纳瓦尔宝典》 skill 使用结果:

示例3:将《思考快与慢》转换为 Skill
输入: 书籍的 PDF 文件
输出结果:
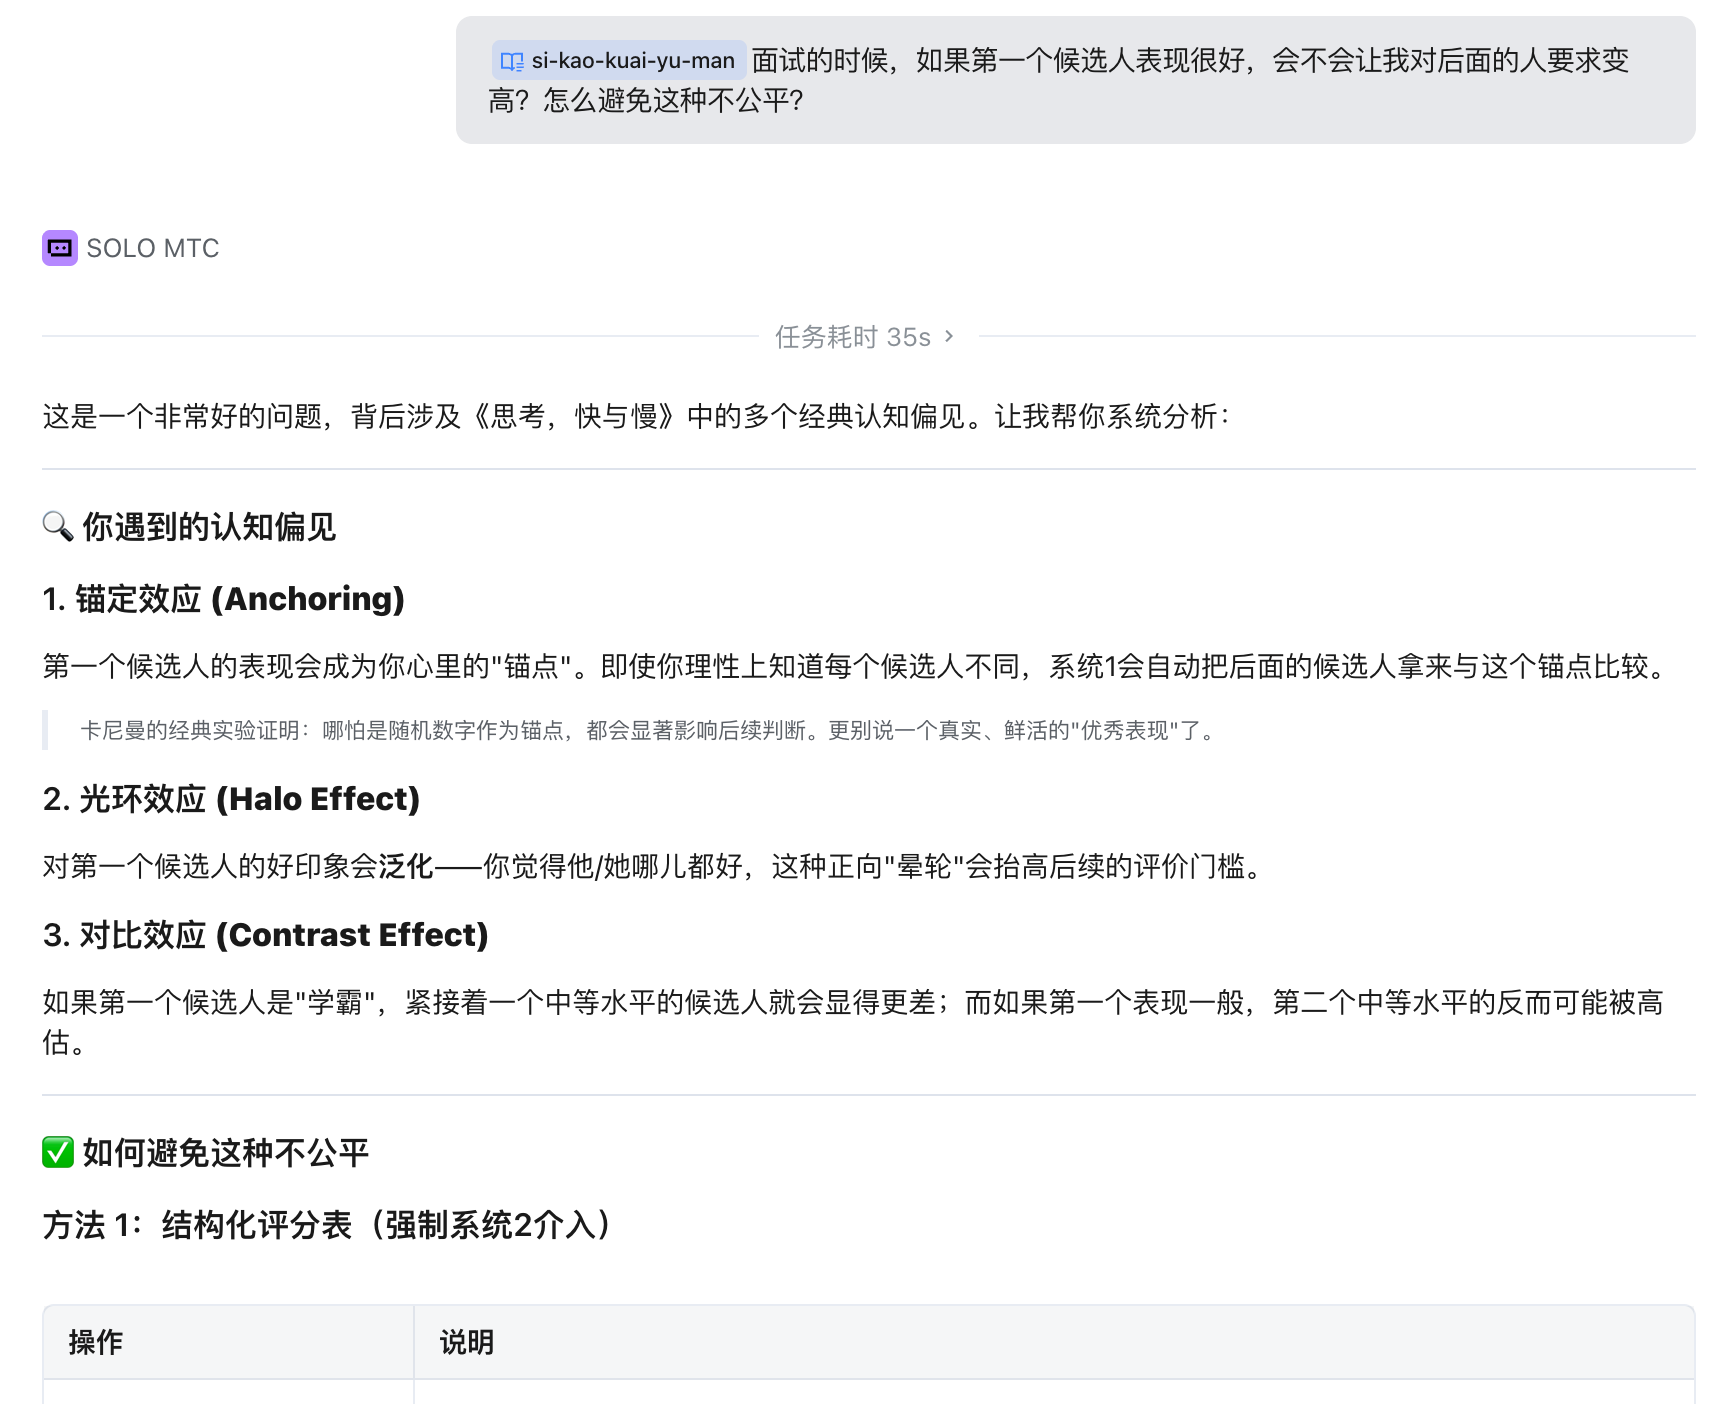
生成的《思考快与慢》 skill 使用结果:
6、Skill 链接
-
Skill 路径: myskills/book-to-skill at main · sarahxu0205/myskills · GitHub
-
核心文件: SKILL.md、README.md
-
脚本目录: scripts/(extract_pdf.py、extract_txt.py、generate_skill.py)
-
参考文档: references/(analysis_framework.md、analysis_template.json、sample_analysis.json)
7、总结与思考
我的收获:
-
效率提升:以前整理一本方法论书的笔记需要 2-3 小时,现在 5 分钟内完成核心框架提取
-
知识复用:书架上的方法论书籍正在变成一个个可调用的 Skill,真正实现读书致用
-
AI 协作新范式:发现元 Skill 这个概念很有价值,一个帮助创建其他 Skill 的 Skill
最满意的地方:
-
16 个问题框架的设计,它抓住了方法论书籍的共性,让提取结果既有深度又可操作
-
书籍类型检测,避免对不合适的书做无效处理
-
大文件支持,实用性强,不局限于小册子
后续优化方向:
-
支持更多格式(EPUB、MOBI、图片型PDF)
-
添加多本书籍的方法论融合(比如把 GTD + 原子习惯组合成新 Skill)
-
优化对中文书籍的章节识别
-
添加可视化流程图生成
希望得到的建议:
-
16 个问题框架是否有遗漏或冗余?
-
对于不同类型的方法论书籍(理论型 vs 实操型),是否需要差异化处理?
以上,感谢你的阅读。