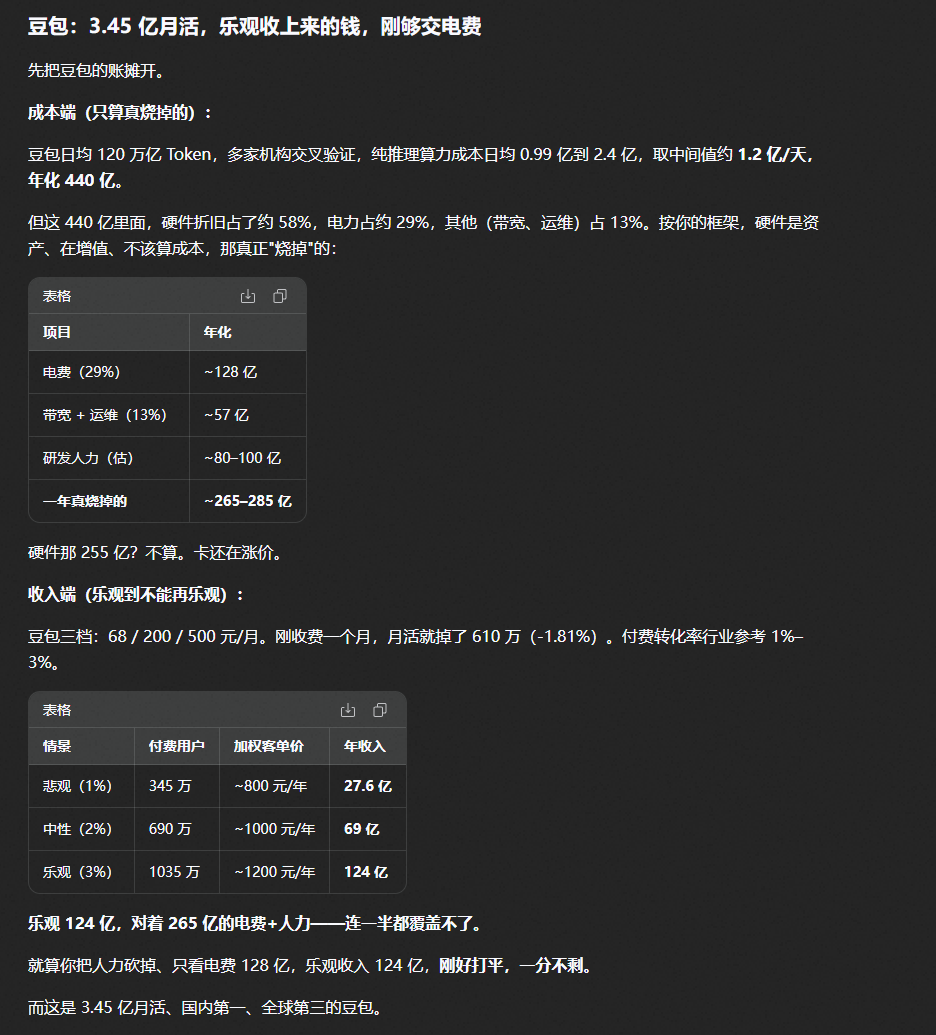
①付费用户,以前一次任务只扣除一次插队,哪怕你一个任务跑几个小时也只扣除一次,最低档100次的套餐可以完成很多事情了,短任务是差不多4000积分够你执行100次短任务,长任务从100次对话插队直接缩短到2-5次了
现在:4000积分≈100次短任务≈2-5次长任务
以前:100次插队=100次短任务=100次长任务
2-5次长任务 vs 100次长任务
②免费用户也是差不多道理,以前排队用差点的模型(或者一些低峰期)可以钻下空子 几乎没什么人排队,可以免费使用,现在送的那些积分短….像现在豆包思考模式也开始收费了一样,也必然的吧。
现在:送的几千积分跑长任务2-5次左右就没了,短任务跑一百次问题不大
以前:低质量模型,一天排到10-30次问题不大。高质量模型一天总会排到3-5次吧
前后落差太大了,所以大家才会发帖吐槽。慢慢总会习惯的 
不过这么一改,重度用户反而跑了,剩下的都是一些轻度用户了吧。
AI投资很大,甚至连字节嫡子豆包都顶不住了,何况二房的庶子,还有一堆庶子嗷嗷待哺呢。
但是这个算力硬件不是一次性成本支出,它是资产几乎不贬值,甚至是投资按近几年行情看它还再增值。
剩下的基本就是电费和人工成本了。
他们现在的定价,本质上是一个财务部门思维的产品决策:成本多少,定价多少,毛利多少,倒挂了就调。这套逻辑在卖矿泉水的时候没问题,但在一个全行业都没找到盈利模式、硬件还在增值、用户基数才是唯一资产的阶段,用这套逻辑,就是在用算盘打股票的账。
整个行业都在亏。OpenAI 亏,Anthropic 亏,豆包限流,Cursor 靠融资活着。在这个阶段,谁先把用户基数做成不可逆的资产,谁就是下一个赢家。 而不是谁先把电费收回来。
字节不缺那 3.5 亿。字节缺的是想明白:Trae 的 KPI 不应该是"订阅收入",应该是"有多少开发者的工作流里离不开它"。
既然怎么都赚不到钱,不如免费梭哈!
把用户基数当资产养着。
160 万开发者的心智、代码习惯、工作流锁定,这些东西在 AI 编程赛道里才是真正的护城河。Cursor 现在估值多少?靠的就是开发者基数。你为了省 1.5 亿电费,把基数砸了,这是拿金条换废铁。
完全免费不行,不是因为钱,是因为算力池是共享的。
豆包 3.45 亿月活都被挤到限流了。Trae 的推理卡和豆包、TikTok 推荐、内部业务跑在同一个池子里。如果 Trae 完全免费、完全不设门槛,会发生什么?
-
有人写脚本无限循环跑 Agent,占着卡不放;
-
有人拿它当免费算力挖矿、跑无关任务;
-
高峰期真正需要用的开发者反而排不上。
豆包那个"当前使用人数较多"的弹窗,trae的排队机制,就是完全免费(或接近免费)的代价。
—— 以上结论来自豆包
所以各位铁子,今天把所有积分都梭哈!过几天再来看结果!
3 个赞
主要是他长任务由于上下文压缩严重还全是错误,得再多开几次长任务修复上一次长任务留下来的错误,一次循环反复套娃。只能说烂完了
4 个赞
2000积分,使用glm5.2,我就跑了俩长任务,还有400多,这软件更新后,消耗也太快了
3 个赞
还有老铁截图一次任务干掉了2800积分的哈哈,反正大概就这么算的,你看下TraeWork版应该还有2500积分,用完得了大概率可能会调整政策,因为这么算下去,就这一两天 两三天,付费用户和免费用户积分都归0了,那还怎么玩。长任务用TraeWork跑感觉更稳妥一些,小修小改用trae换个账号登录打开同一个工作空间进行修改。
3 个赞
现在价格基本和WorkBuddy对齐了,但是人家WorkBuddy有免费的Hy3模型兜底。trae这送的积分估计一两天付费用户和免费用户全归零。到时候大家都没得玩了。
4 个赞
今天没有用TRAE,早上用deepseek-v4-flash登codex,解决一个长问题,用了0.53亿TOKENS,花了2.1元
3 个赞
如果是是deepseek-v4-flash模型的话,用trae只有0.05x倍率 几乎免费。或者用WorkBuddy的hy3免费平替deepseek-v4,但是codex能力应该比前两个好
2 个赞
trae中deepseek-v4-flash不是正式版,0.05X倍不一定省钱,按现在扣法,0.05X一个长问题,0.5亿TOKENS,TRAE扣掉的积分价值应该会大于2元。
codex命中缓存很高才省钱
2 个赞
deepseek-v4-flash正式版昨天发布的,网上测试文中已超GML-5.2
2 个赞
应该还是字节的战略偏移了,我等码农撑不起这片天,豆包成红牌了吧。
2 个赞
请教下
这个倍率怎么理解的 用官方的也有倍率的说法?
我以为只有包月/中转站才有
2 个赞
这里的倍率应该是比如你原本同样的任务用glm5.2需要100积分,这是基准线,就是1倍,那么另一个模型K3是2.3X,就表示同样的任务要消耗230积分。
2 个赞
逗包
13
因为不同模型参数不一样,部署成本就不一样。成本不一样结算的时候就只能用不同倍率了。总的来说例如K3总参数达到2.8W亿了,成本远远大于deepseek-v4-flash。
2 个赞
逗包
14
我问豆包,它自己都算了一遍,付费用户总量在“非常乐观“场景下也就达到保本电费水平(这数据我没有核实仅供参考),虽然不赚钱但是各大厂商又不得不去做,AI方面算是未来国家级别的战略方向,哪怕一分钱不赚,你也得在牌桌上。除非NVDA和各大内存厂商产能跟上,显卡等硬件价格下跌到正常水平,国内外厂商手里的显卡再翻个两倍三倍的,平摊到大家手上的算力就多了,token就便宜了,到时候我们国内电力优势和廉价牛马人力优势就体现出来了。。。
但目前看来应该不可能,物以稀为贵。NVIDIA就是算力的"央行",目前显卡现在几乎等同于货币了,这不是"产能不足",是刻意为之。
老黄说:“尽管我们非常希望供应能够更加充足,但未来几个季度供应将非常紧张。”
翻译成人话就是:”我们知道你们买不到,但我们也不打算多产“
2 个赞
明白,对我来说,大模型聪明能干活就可能,不去管有多少参数,不一定要用最顶级的模型(就算K3是最顶级吧,说白不喜欢K模型,一直用GLM),deepseek-v4-flash正式版能达到GLM-5.2,觉得就可以拿来用。一直觉得参数高,不一定是最聪明
逗包
16
deepseek-v4-flash这个价格算上命中缓存,确实超便宜呀,网上各种测试正式版是达到了GLM5.2水,这么小的参数无敌了。deepseek-v4-pro正式版也快出来了,照这个场景看媲美k3甚至超越都不在话下了。那到时候直接用deepseek官方的更划算
1 个赞
逗包
18
这头像也是 豆包生成的,它眼中放荡不羁爱自由的自己
2 个赞