我是 AIGC 创作团队负责人,团队 4 个人,同时在做内容创作和 AI 应用开发。我们每天需要盯紧 AI 行业动态——新模型发布、开源项目更新、行业政策变化、竞品动向——但团队群里的信息流完全是「野生状态」:谁看到一篇好文章就随手转发,没分类、没解读、没沉淀,重要消息经常被刷过去,想回头找又找不到。
我试过几种方案:用 RSS 阅读器订阅,但只解决了「收集」问题,还是得人工筛选和写摘要;用市面上的 AI 资讯产品,要么信息源不能自己选,要么推送格式不适合团队群,要么月费不便宜。我真正想要的是一个「AI 读报员」——每天自动抓取我指定的信息源,用大模型做深度分析,然后推送到飞书群,团队打开就能看到结构化的资讯简报。
市面上的成品都不完全满足,我决定自己用 TraeWork 撸一个。
────────────────────────────
【我用了 TraeWork 解决了这件事】
模式: Work ☐ Code ☐ Design
全程纯 Work 模式,没用 Code 模式,所有代码都是对话生成的。TraeWork 在这个项目里扮演了三个角色:架构师、程序员、运维工程师。
——第一步:需求拆解与架构设计——
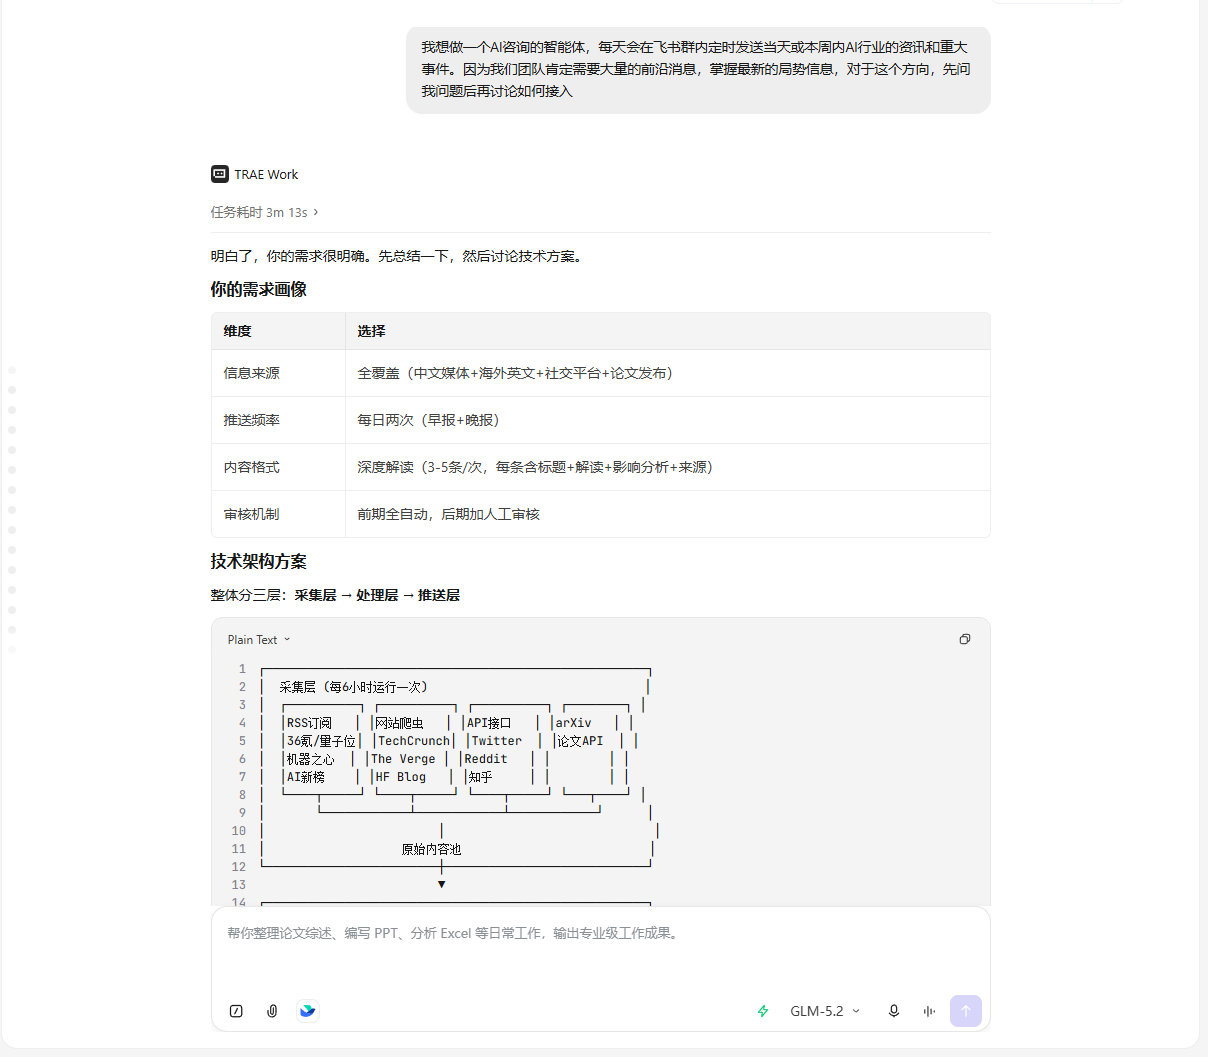
我在对话里描述了完整需求:定时抓取国内外 AI 资讯,用大模型做深度分析,推送到飞书群。TraeWork 帮我把需求拆成了三层架构,通俗来讲就是三步流水线:
采集层(「信息采集员」):同时去 7 个网站抓最新文章。我列了想要的信息源(量子位、36氪、InfoQ、机器之心、TechCrunch AI、OpenAI Blog、HuggingFace),它帮我确认了每个网站的 RSS 订阅地址。关键是设计了「并行抓取 + 严格超时」——7 个源同时抓,哪个源 10 秒没响应就放弃,不会因为一个网站卡住导致整个任务挂掉。
处理层(「分析师」):把抓到的文章标题和摘要喂给 DeepSeek 大模型,让它输出结构化分析——核心内容、深度解读、对内容创作的影响、对应用开发的影响、影响指数,每条资讯 5 个板块。我们团队既做内容又做应用开发,所以分析要双线覆盖。
推送层(「快递员」):把分析结果排版成飞书卡片消息,推送到团队群。用飞书的自定义机器人 Webhook,支持 Markdown 排版,带签名校验防止伪造。
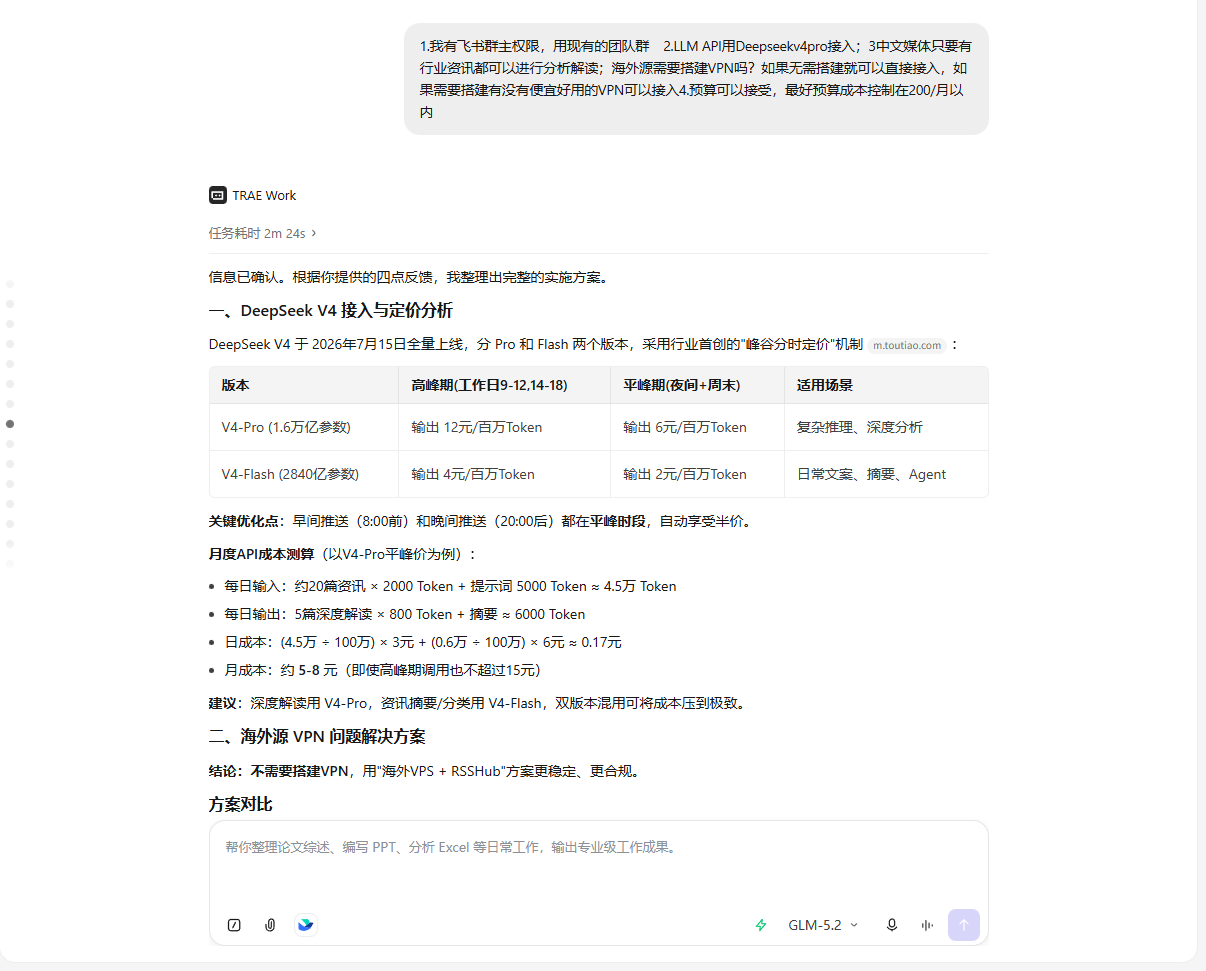
技术选型上,TraeWork 建议用腾讯云 CloudBase 云函数部署。好处是:有免费额度、支持定时触发(到点自动跑)、Node.js 环境、不需要自己买服务器。大模型用 DeepSeek V4 Pro,性价比高,月成本控制在 200 元以内。
——第二步:代码生成——
整个云函数代码全部由 TraeWork 在对话中生成,我负责复制粘贴到 CloudBase 控制台。代码做了这几件事:
RSS 抓取与解析:说白了就是「去网站拉文章列表」。用 Node.js 自带的 http 模块发请求,拿到 XML 格式的 RSS 数据,然后手动解析出标题、链接、摘要、发布时间。不依赖任何第三方库,纯原生写法,兼容性最好。
关键词过滤与去重:不是所有文章都跟 AI 相关,所以要过滤。设了 70 多个关键词(AI、大模型、GPT、Claude、Agent、AIGC、算力等),标题和摘要里只要命中任意一个关键词就保留。同一个话题可能多个网站都报了,按标题前 30 个字去重,每次最多留 15-20 条。
DeepSeek API 调用:把过滤后的文章列表发给 DeepSeek,让它按固定格式输出 JSON 分析结果。这里有个细节——设置 max_tokens=4000 防止返回内容被截断,还做了「截断修复」:如果返回的 JSON 不完整(被截断了),自动找到最后一个完整的右大括号,补全缺失的闭合符号,尽量抢救数据。
飞书卡片构建与签名:把分析结果拼成飞书卡片格式的 JSON,包括标题、分隔线、各板块内容、快讯列表。签名是为了防止别人伪造你的机器人发消息——用时间戳加密钥算一个 HMAC-SHA256 签名,飞书收到消息时会验证签名是否正确。
定时触发器配置:在 CloudBase 控制台配两个定时任务,早报 10:00、晚报 20:00,到点自动执行云函数。
——第三步:部署与排障(最折腾的部分)——
代码写完只是一半,部署上线踩了一连串的坑。这个阶段 TraeWork 的排障能力让我最意外——每次报错,我直接把 CloudBase 控制台的完整日志复制贴给它,它从日志里精准定位问题,给出修复代码。
具体踩坑过程见下面的经验部分,这里先说结果:经过大约 5 天的迭代(不是全职,断断续续),机器人稳定运行,每天 10:00 和 20:00 准时推送飞书群。
────────────────────────────
【我做出了什么】
一个完全自动化的 AI 资讯机器人,每天两个时段自动推送飞书群卡片消息。
核心功能:
— 7 个信息源同时抓取:量子位、36氪、InfoQ、机器之心、TechCrunch AI、OpenAI Blog、HuggingFace,每个源 10 秒超时,互不拖累
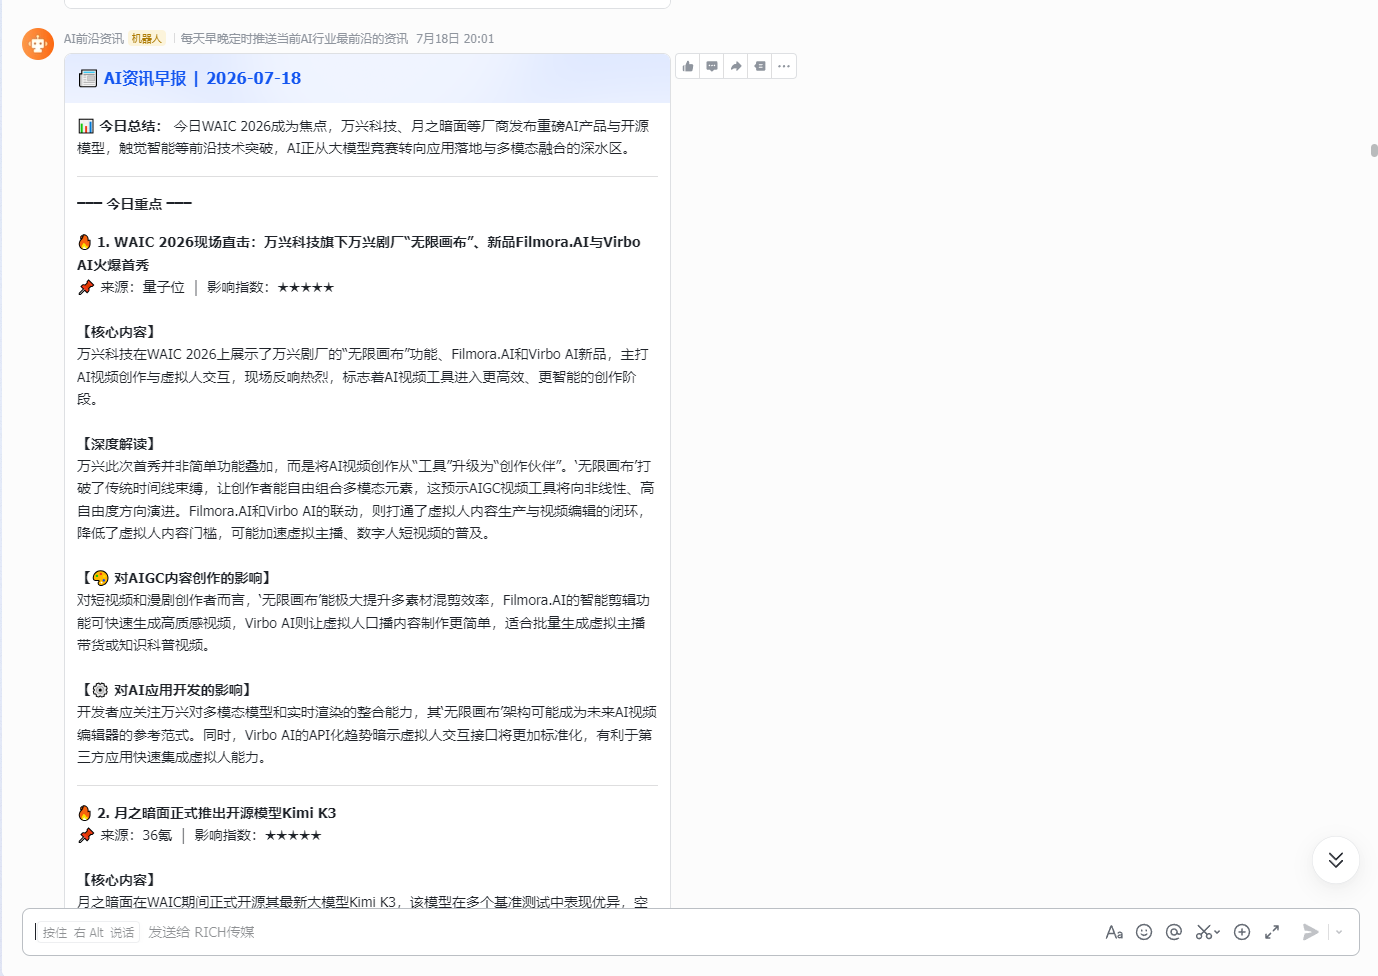
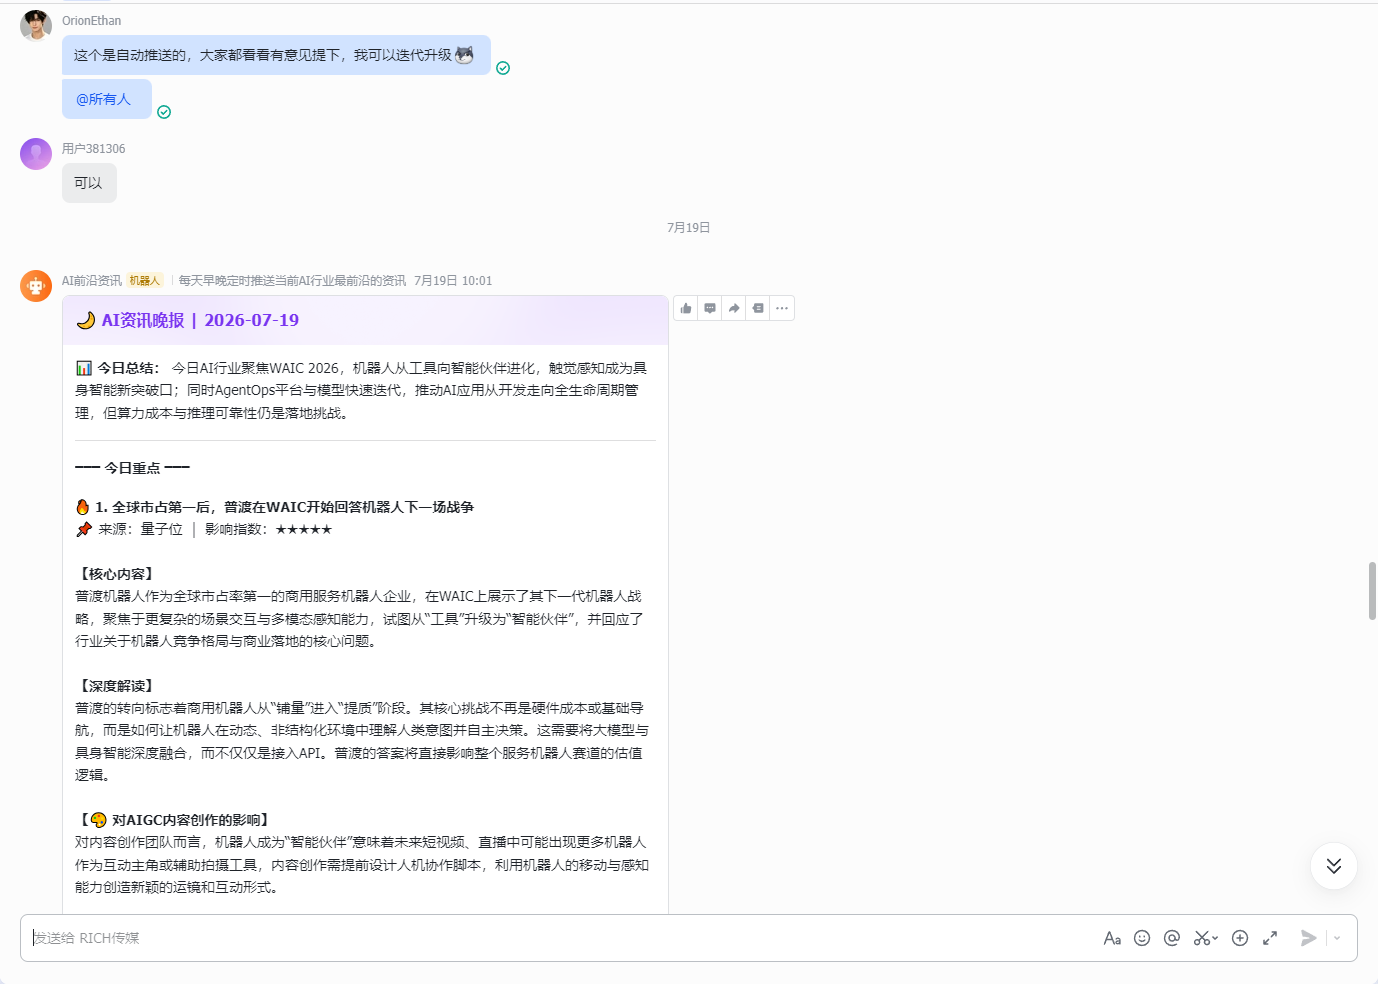
— DeepSeek 大模型深度分析,每条资讯输出 5 个板块:核心内容(80-150 字)、深度解读(100-200 字)、对内容创作的影响(60-100 字)、对应用开发的影响(60-100 字)、影响指数(星级评分)
— 飞书卡片推送,带签名校验,Markdown 排版,分「今日重点」和「快讯速览」两个区域
— 智能过滤(70+ AI 关键词),自动去重,每次推送 3-5 条重点 + 4 条快讯
— 双时段定时推送:早报 10:00、晚报 20:00
成本控制:DeepSeek API 每月 200 元以内(选在低谷时段调用更便宜),CloudBase 云函数免费额度覆盖,不花一分钱服务器钱。
后续还衍生出了第二个机器人「机会雷达」——同样的架构,换了信息源(36氪、虎嗅、V2EX 职场、少数派、知乎日报、华尔街见闻、鸟哥笔记)和分析框架(职业发展影响 + 普通人赚钱机会 + 口播视频拍摄建议),一个对话就生成了新版本代码,直接部署上线。两个机器人并行运行,一个盯技术,一个盯商业机会。
────────────────────────────
【效果展示】
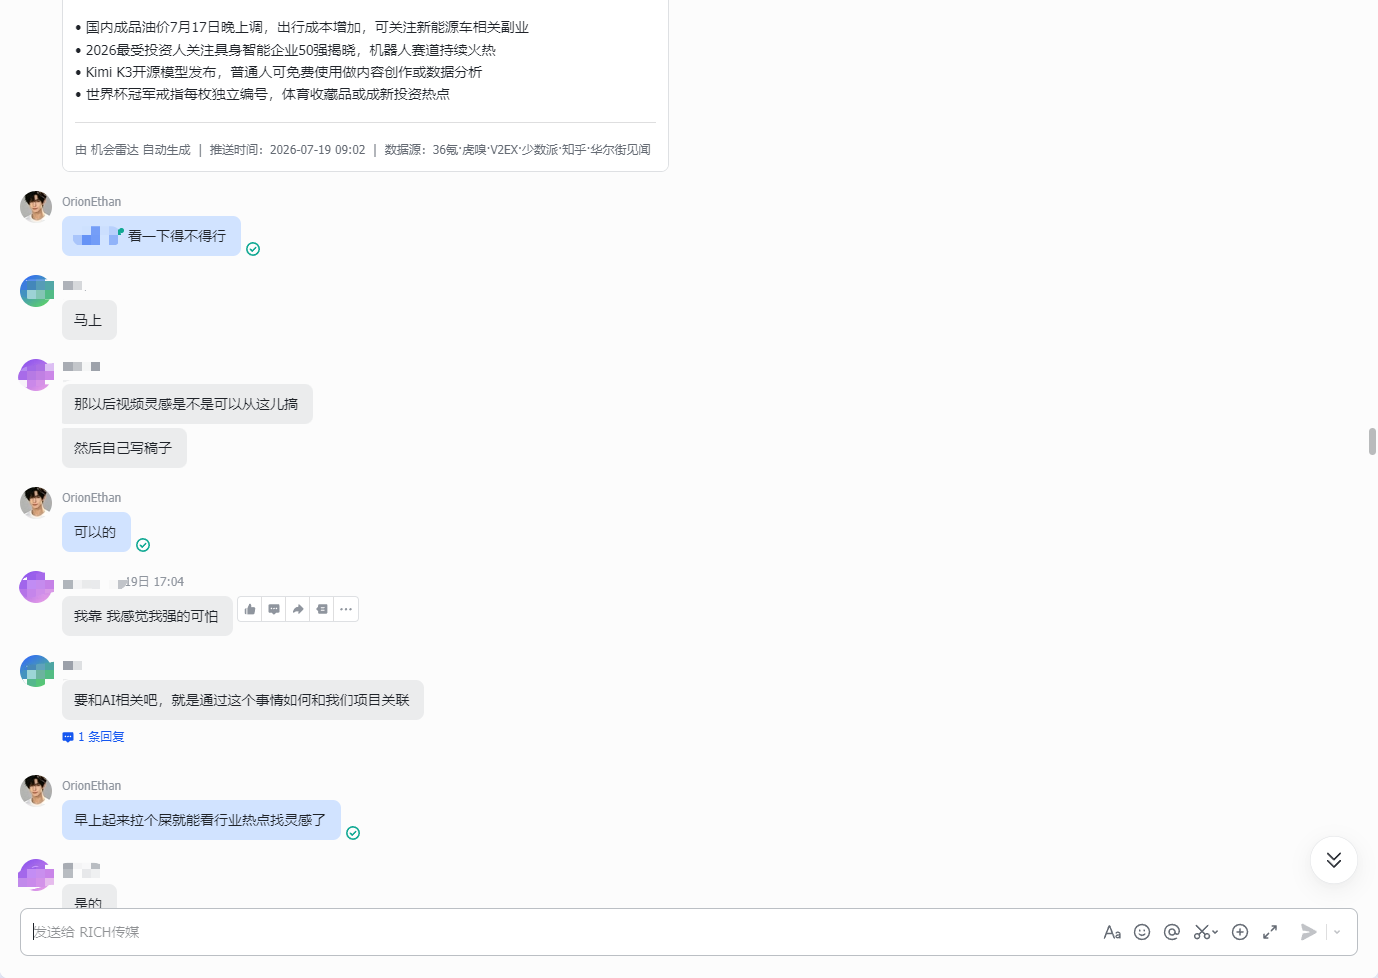
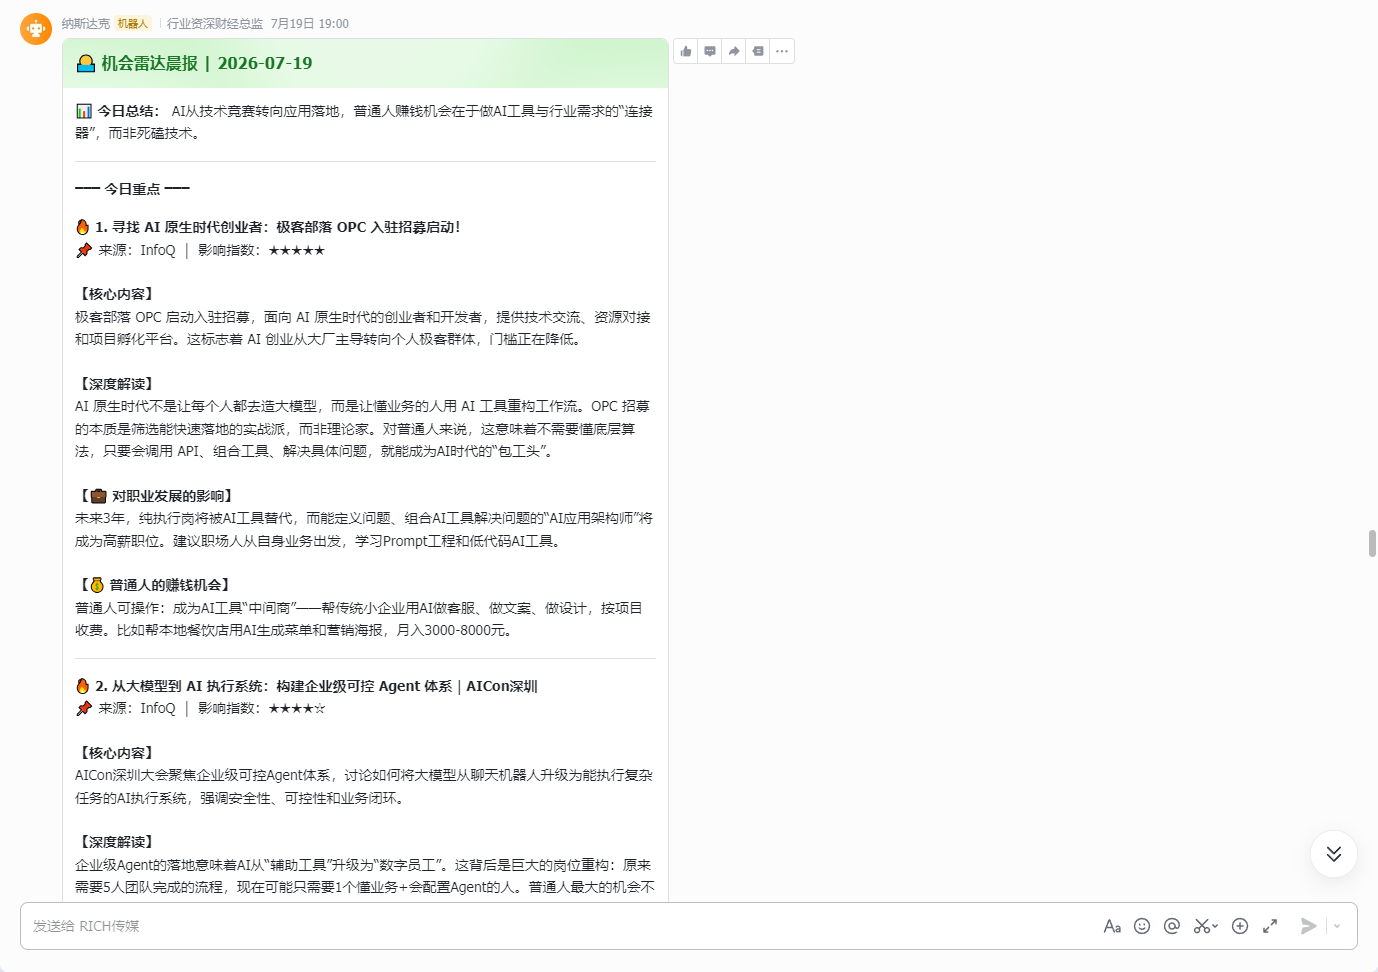
────────────────────────────
【经验 & 技巧总结】
技巧一:让 TraeWork 当「运维工程师」,贴日志比描述问题更高效
部署过程中我踩了至少 6 个坑,每个坑都是把 CloudBase 的错误日志整段贴给 TraeWork,它从日志里直接定位问题。这里详细展开每个坑的排查过程:
坑 1:命令行部署一直报权限错误
一开始我用 CloudBase 的命令行工具部署代码,结果它扫描到我电脑的 Application Data 系统目录时报了 EPERM 权限错误,反复重试都不行。把错误日志贴给 TraeWork,它判断是命令行工具扫描路径的权限问题,建议别折腾 CLI 了,直接用控制台网页端上传 ZIP 包。照做后一次成功。
坑 2:函数显示执行成功,但飞书群没收到消息
测试运行返回成功,但飞书群始终没消息。把日志贴给 TraeWork,它发现代码最后一行写了 process.exit()——这行代码的意思是「立刻结束进程」。但飞书推送是一个异步请求,还没发完,进程就被强制结束了。删掉 process.exit(),再补一行兼容 SCF 入口的代码,问题解决。
坑 3:RSS 源频繁超时,有效信息越来越少
最初 7 个 RSS 源里有 4 个用的是 rsshub.app 这个公共服务,但它太不稳定了,几乎每次都超时,导致实际能抓到的数据只剩 2-3 个源。TraeWork 给了两个方案:一是换成各网站的官方 RSS 地址(更稳定),二是用并行抓取替代串行——7 个源同时抓,谁先回来谁先处理,每个源最多等 10 秒,超时就放弃,不影响其他源。改造后数据获取成功率从 30% 提升到 90% 以上。
坑 4:代码直接报语法错误,根本跑不起来
代码里用了 ES6 的新语法(spread 操作符 … 和 async/await),但 CloudBase 的 Node.js 环境比较老,直接报 SyntaxError: Unexpected token ‘*’。TraeWork 帮我把整个代码「翻译」成了老语法版本:async/await 改成 Promise.then 的链式写法,箭头函数改成普通 function,spread 操作符改成 for 循环逐个 push。这版一次通过。
坑 5:飞书一直返回 19021 签名错误
飞书机器人一直返回 19021(签名校验失败),消息发不出去。我先口头跟 TraeWork 说「签名不对」,它给了好几个排查方向——检查密钥、检查时间戳格式等——但都不准。后来我把完整的请求和响应日志贴上去,它一眼就看出来了:生成签名的函数里,createHmac 初始化时已经把密钥传进去了,后面又多调了一次 .update(密钥),等于把密钥处理了两遍。删掉多余的 .update 调用,签名立即通过。这个坑让我深刻体会到:贴日志比口头描述精准十倍。
坑 6:某天推送突然失败,DeepSeek 返回 400
用了几天一直正常,某天突然推送失败。日志显示 DeepSeek API 返回 400 错误,提示信息是「支持的模型名是 deepseek-v4-pro 或 deepseek-v4-flash,但你传的是 deepseek-chat」。原来 DeepSeek 更新了模型命名,旧名称被废弃了。把代码里的模型名改成 deepseek-v4-pro,恢复正常。
总结一句:报错先贴日志,不描述。日志里有错误码、有堆栈、有上下文,TraeWork 能直接从中提取关键信息,比你口头描述准确十倍。
技巧二:CloudBase 环境兼容性,提前让 TraeWork 用「安全语法」
CloudBase 的 Node.js 环境比较老,很多新语法不支持。async/await、箭头函数、spread 操作符(…)这些现在写代码很常用的语法,放上去就报错。我的经验是:一开始就告诉 TraeWork「目标运行环境是 CloudBase,比较老,请用 var 声明变量、function 关键字定义函数、Promise.then 做异步,不要用 async/await 和箭头函数」。这样生成的代码一次通过率极高,省得后面反复改语法。
还有两个小坑:String.padStart()(给数字补零用的,比如把 5 变成 05)在老版本 Node 里可能不支持,用 (‘0’+x).slice(-2) 替代就行;new URL()(解析网址用的)也可能不存在,用 require(‘url’).parse() 替代。这些都是 TraeWork 在排障过程中教我的。后来我学乖了,把这些整理成了一份「CloudBase 安全语法清单」,每次新项目开始就先贴给 TraeWork,让它一开始就用兼容语法,少走弯路。
技巧三:同一套架构,换数据源就能复制出新产品
做好 AI 资讯机器人后,我想再做一个职场/赚钱资讯的机器人。我没有从头开始对话,而是直接告诉 TraeWork「基于刚才那个机器人的架构,换一套信息源和分析框架,生成新版本」。它直接复用了整个代码结构,只改了三个地方:
— 信息源:从 AI 媒体换成职场/财经媒体(36氪、虎嗅、V2EX 职场、少数派、知乎日报、华尔街见闻、鸟哥笔记)
— 关键词:从 AI 关键词换成 70 多个职场/赚钱关键词(就业、跳槽、副业、变现、跨境电商等)
— 分析框架:从「对内容创作/应用开发的影响」换成「对职业发展的影响 + 普通人的赚钱机会 + 口播视频拍摄建议」
十分钟就输出了新版本代码,直接部署上线。这意味着一旦你用 TraeWork 跑通了一套架构,后面做同类项目就是「换料不换锅」——锅还是那口锅,换个菜码就行,效率指数级提升。
────────────────────────────
TraeWork 在这个项目里不只是写代码的工具,更像是我的技术合伙人——从架构设计到代码生成再到排障运维,全程参与。最关键的是,它让我这种非专业后端开发的人,也能独立完成一个涉及 RSS 抓取、大模型 API、云函数部署、飞书集成的完整项目。一个人 + 一个 AI,干出了一个开发团队的活。
TraeWork的100种用法 #AI办公