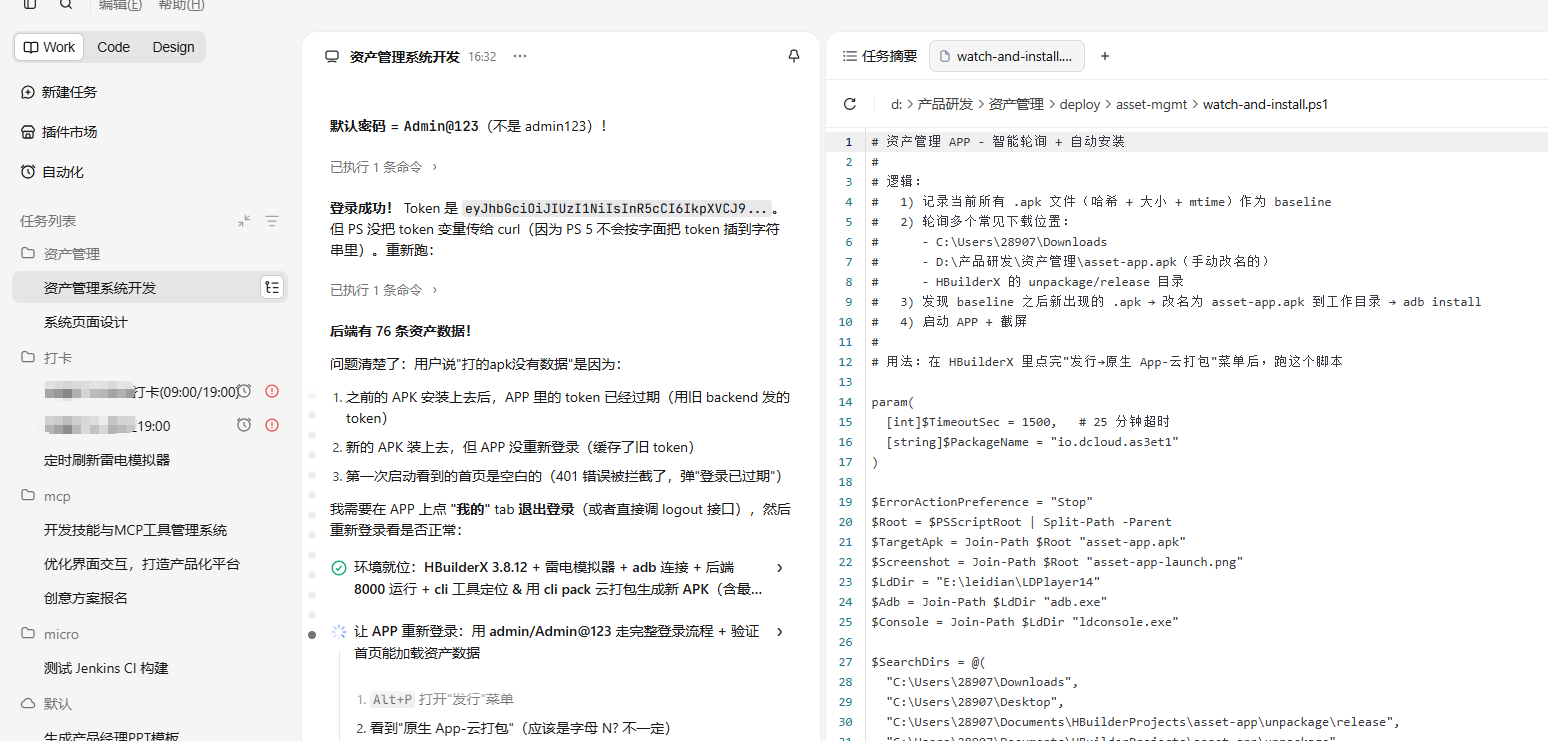
我与 Trae Work:一个人搞定技能、系统、App、Electron 与定时打卡的实战心得
从一个高频使用者的视角,记录我用 Trae Work 独立完成多个产品方向的全过程。
一、为什么我会成为 Trae Work 的高度使用者
最早接触 Trae Work,是被它「一个工作区,多种形态产物」的定位吸引。日常开发中,我常常需要在 IDE、写文档、做原型、跑脚本之间来回切换,而 Trae Work 把这些动作收敛到了同一个对话入口里——既能写代码、也能写技能、还能编排自动化任务。
更关键的是,它内置的 Skill 体系 让我可以把常用的工作流沉淀下来。下一次遇到类似场景,不再从零开始描述,而是直接调用技能,让 AI 沿着既定流程跑。这种「把方法论固化为工具」的感觉,是我持续使用它的核心原因。
下面是我用 Trae Work 独立完成的几个代表性方向,每一个都跑通了从 0 到 1 的闭环。
二、用 Skill 把「思路」沉淀为「工具」
1. 从重复 prompt 到可复用技能
最初使用 Trae 时,每写一个 PRD 都要重复一遍「按产品经理视角、列功能清单、给验收标准」这类提示词。后来发现 Trae Work 提供的 Skill 机制 才是真正的杠杆点——把一个成熟的 prompt 模板沉淀为技能后,后续每次调用都自动加载上下文。
2. 我的 Skill 沉淀清单
经过几个月的迭代,我在 Trae Work 中沉淀了多类技能:
-
咨询分析类:用于撰写市场分析、品牌调研、竞品研究的结构化报告。
-
设计原型类:把 HTML/CSS/JS 高保真原型封装为可复用的设计工作流。
-
文档写作类:覆盖 PRD、研究报告、技术方案等长文场景。
-
数据处理类:针对 Excel/CSV 做分析、清洗与可视化输出。
3. 沉淀带来的复利效应
最大的收益不是省了几次 prompt,而是 知识资产的积累。团队里其他人也能调用我写好的技能,方法论变成了可分发的工具,这是 Trae Work 在我工作流中扮演的「元能力」角色。
三、用 Trae Work 搭建一套个人系统
我说的「系统」,是指围绕日常开发与协作搭建的一整套工作流,包括:
-
任务管理:把想法、待办、Bug、灵感统一收口。
-
文档沉淀:技术方案、复盘、踩坑记录集中管理。
-
代码片段库:常用配置、组件、脚本的复用。
-
自动化任务:定时跑数据备份、报表生成、消息提醒。
在 Trae Work 中,这些并不是通过一个复杂的产品来承载,而是 由多个 Skill 加 Schedule 任务组合而成。比如:
-
写文档时调用
doc-writing-guide技能。 -
处理数据时调用
data-analysis技能。 -
每天定时跑的任务用
Schedule配置 cron。
这套「Skill + 定时任务 + 工作区」的组合,让我一个人就拥有了一个轻量级的操作系统。
四、独立完成的 App:从 Web 到 Electron
1. 一个完整 App 的全流程
我用 Trae Work 独立开发过多个 App,覆盖 Web、桌面端(Electron) 两条主要路线。完整流程大致是:
-
需求阶段:调用 PRD 技能,产出《产品需求文档》。
-
设计阶段:调用 HTML 原型技能,生成可点击的交互 Demo。
-
开发阶段:用 Vue + Vite 起前端,用 Node.js/Express 起后端。
-
打包阶段:用 Electron 打包为桌面端,配置
electron-builder出 Windows 安装包。 -
发布阶段:自动生成更新说明,发布到指定渠道。
整个过程我没有切换到外部 IDE 之外的地方,关键的脚手架、配置、组件代码,都能通过对话让 Trae Work 直接生成。
2. Electron 桌面应用的几个关键点
桌面端比 Web 端复杂的地方主要在:
-
主进程与渲染进程分离:需要明确
main.js/preload.js/renderer的职责划分。 -
原生能力调用:文件读写、托盘、自动启动等,需要用 IPC 桥接。
-
打包配置:
electron-builder的nsis配置、图标、签名、增量更新。
这些细节单独做并不难,难的是 第一次做时如何快速跑通。Trae Work 的价值在于,我可以边做边问,每遇到一个报错就把日志贴进去,让它帮我定位问题、给出补丁。这种「对话式排错」的体验,比翻 Stack Overflow 高效得多。
3. 个人 App 案例
其中一个比较实用的,是一个 本地化的桌面小工具:
-
用途:把日常零散的 Markdown 笔记整理成结构化文档。
-
技术栈:Electron + Vue3 + Vite。
-
关键能力:本地文件索引、标签分类、全文搜索、自动备份。
-
产出:Windows 可安装版本,双击即用。
从立项到出第一版可运行安装包,只用了不到一周,其中大部分时间花在产品细节打磨上,而不是写代码本身。
五、定时打卡:从想法到自动跑通
定时打卡是我用 Trae Work 解决的另一个典型场景。
1. 场景描述
我希望每天上午定时向飞书群发送一条打卡提醒,统计昨天的工作产出,包括:
-
完成了哪些任务。
-
代码提交了几次。
-
文档更新了几篇。
2. 实现方式
我没有去写一个完整的服务,而是直接用 Trae Work 的 Schedule(定时任务) 能力:
-
cron 表达式:
0 9 * * 1-5(工作日早上 9 点)。 -
任务内容:调用相关 Skill,读取昨日的 Git 提交记录、文档变更、任务状态。
-
输出形式:渲染为结构化文本,推送到飞书群。
整个流程在 Trae Work 的对话里就能完成配置和调试,不需要额外搭一台服务器。
3. 几个关键经验
-
时间窗口要明确:cron 是 5 字段表达式,「每月第三个周五」这类复杂规则不支持,要降级为最近的可行方案。
-
任务消息要写完整:定时任务在另一个会话里执行,看不到历史上下文,所以
message字段要把来源、目标、输出格式、边界条件全部写清楚。 -
沉默偏好要写明:如果不希望被打扰,就明确写「保存到文件即可,不要单独通知」,让执行者按意图行事。
这套定时跑下来,我再也不用手动整理日报,早上 9 点打开飞书就能看到昨天的产出统计。
六、几点深度使用心得
用得越久,越能感受到 Trae Work 的几个底层设计哲学:
1. 对话即工作流
不要把 Trae 当作一个「聊天机器人」,而要把它当作 一个可以编程的工作流引擎。每一段对话其实都是在描述一段逻辑:输入是什么、要经过哪些处理、最终产出什么。把对话写得像一份需求文档,得到的产物质量会高很多。
2. 技能是核心资产
我现在的习惯是:每解决一个重复性场景,就考虑能不能抽成一个 Skill。一旦沉淀下来,下次遇到类似问题就能直接调用,节省的不是几分钟,而是 思考的负担。
3. 工作区是协作单元
Trae Work 的工作区天然适合作为 知识沉淀的容器。把项目相关的 Skill、文档、脚本、模板都放在同一个工作区里,团队成员进来就能直接复用,比单独写一份《新人入门手册》有效得多。
4. 善用定时任务做「无人值守」
很多重复性的小事,比如每日数据备份、周报统计、环境巡检,都可以交给 Schedule 任务在后台跑。把人的精力从机械劳动中解放出来,去做真正需要判断的工作。
七、写在最后
Trae Work 对我而言,不只是一个 AI 对话工具,而是一个 「个人操作系统」级别的协作伙伴。它让我一个人在技能开发、应用搭建、系统建设、自动化任务之间无缝切换,而不需要在多套工具之间来回折腾。
如果你也正在寻找一种方式,把 AI 真正融入到自己的工作流里——而不是停留在「偶尔问个问题」的层面——我建议从一个具体的小场景切入,先用起来,再沉淀成 Skill,最后用定时任务串成自动化。这条路径走下来,你对 AI 工具的认知会发生质的变化。
工具的真正价值,不在于它能做什么,而在于你能用它做出什么。
作者:一个把 Trae Work 当作第二开发环境的独立开发者