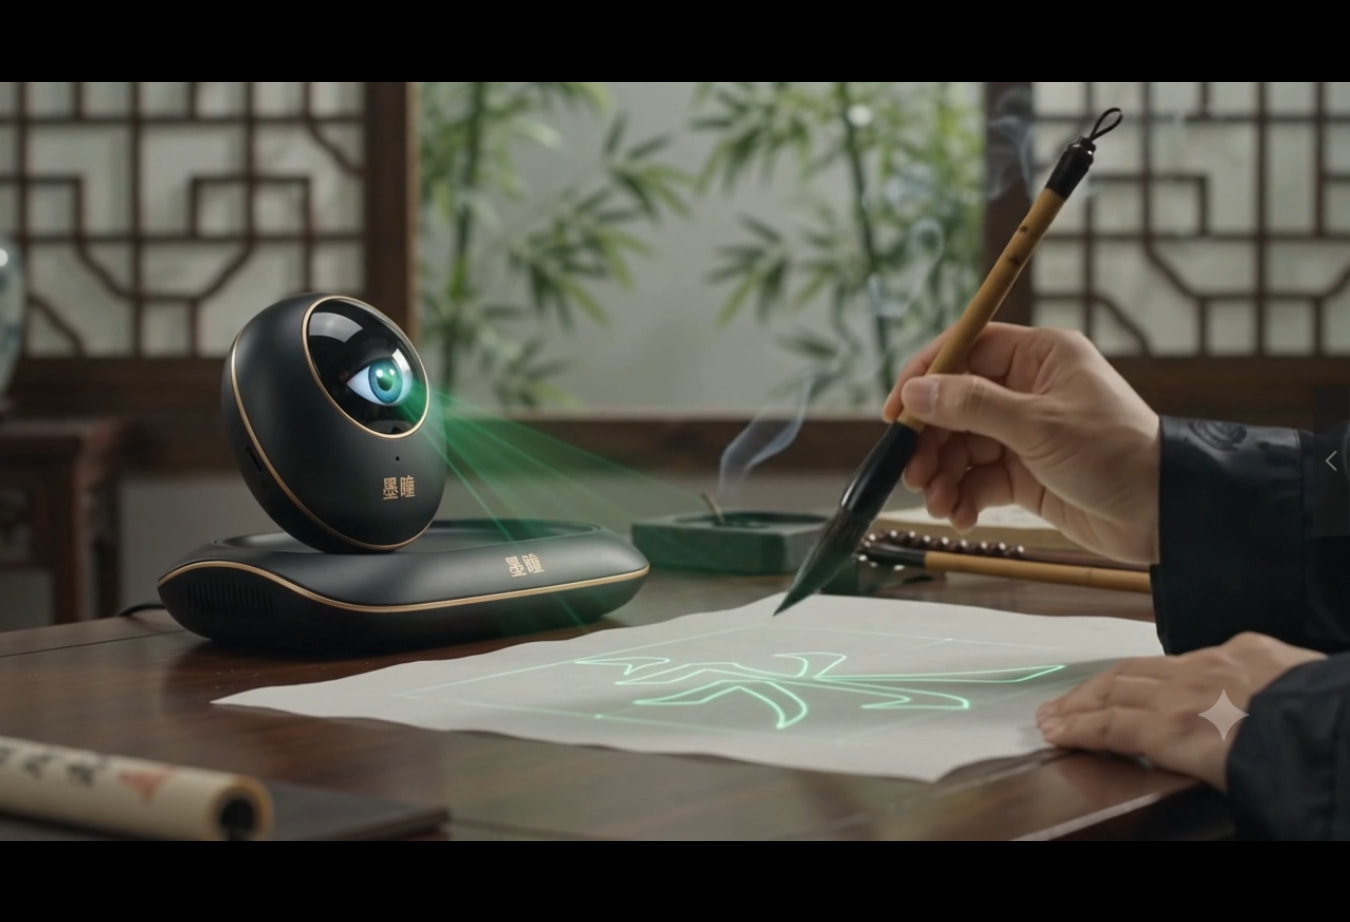
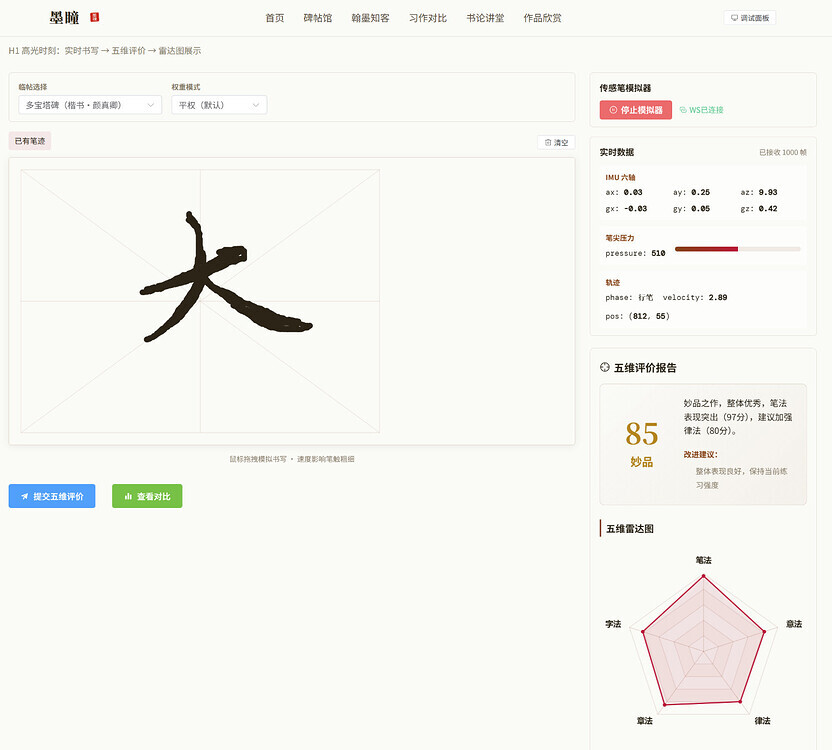
大家好!我是“墨瞳”项目的作者,零代码经验的产品研发。墨瞳项目的Demo不是一个网页演示,而是真实的代码实现,所有接口都已完成,网站建好,交互真实,LLM接入就绪,只待智能硬件接入后系统调教。
从动念头报名到卡点提交Demo帖,总共不到5天时间,期间项目里程碑推进丝滑顺利,模块之间的调试没有出现过大的问题。回顾用 TRAE Work 开发这款 AI 书法学习伙伴的过程,我最大的感触不是 AI 写代码有多快,而是如果能调教好 AI 的“记忆”,开发效率能直接起飞。
相信大家在用 AI 开发长周期项目时,都遇到过这些痛点:
- 开启新会话就像“断片”了,得重新喂一遍 PRD 和架构。
- 之前修过的 Bug、确认过的命名规范,AI 转头就忘。
- 会话一长,AI 就开始胡言乱语。
为了解决这些问题,我在开发“墨瞳”的过程中,摸索出了一套 OpenClaw 三层记忆开发方法论。今天把这套“给 AI 装上长期记忆”的方案分享给大家。
1. 核心架构:OpenClaw 三层记忆系统
我通过在 .trae/rules 下编写协议,强制让 TRAE Work 遵循三层记忆逻辑:
| 层级 | 名称 | 载体 | 核心价值 |
|---|---|---|---|
| L1 | 工作记忆 | 会话上下文 | 处理当前任务,接近阈值时触发自动压缩。 |
| L2 | 中期情景记忆 | memory/daily/ |
自动归档每日 Session 日志,新会话可按需检索。 |
| L3 | 长期持久记忆 | MEMORY.md |
最核心! 沉淀架构决策、技术选型和踩坑记录,跨会话继承。 |
2. 自动化“知识蒸馏”:不让经验失传
我在 .trae/rules/memory_protocol.md 里定义了一个规则:当上下文占用达到 80% 时,必须执行结构化蒸馏。
AI 会自动从 6 个维度提取核心知识并写入 MEMORY.md:
- 需求约束:哪些是绝对不能改的底线。
- 已确认方案:比如我项目中前后端对齐的枚举值。
- 失败方案:尝试过但走不通的路(避免 AI 以后带你重蹈覆辙)。
- 踩坑清单:比如 Windows 环境下的特殊配置。
- 编码规范:项目特有的命名和目录结构。
- 待办事项:接下来的里程碑。
3. 实战案例:那个折磨我 3 次的 Windows 代理坑
分享一个具体的“长期记忆”应用。在开发过程中,我发现 Windows 注册表的 ProxyServer 值带 http:// 前缀会导致 Python 调用 LLM 时 DNS 解析失败。
这个坑我排查了很久,最后我让 AI 把解决过程存入了 L3 长期记忆。结果在后续开发后端引擎时,AI 自动检查了环境并加了 trust_env=False 的防御代码。这种“被 AI 保护”的感觉,真的只有试过才知道。
4. 技能萃取:从“写代码”到“造工具”
当同一个任务(比如写一个 ECharts 雷达图组件)成功完成两次后,我会引导 AI 执行“技能萃取”,生成一个通用的 .trae/skills/charts-helper.md。下次再有类似需求,一句话加载技能即可。
—
结语
把 AI 当成一个“会遗忘”的临时工,还是一个“能持续进化”的合伙人,关键就在于这套记忆系统的搭建。
如果大家对这套 .trae/rules 协议文件 或者 三层记忆的具体配置 感兴趣,欢迎在评论区留言,我整理一下分享出来!
也欢迎大家体验我的 Demo [墨瞳 - 亦师亦友的智能书法学习伙伴],给点意见!
—
相关链接:
- Demo 体验帖:[墨瞳-亦师亦友的智能书法伴侣]
- 项目技术栈:Vue3 + FastAPI + OpenCV + 智谱 GLM-VL
—