【标签】 学习工作;社会公益
【标题】 学习工作赛道 + 浮生行紀:歷史人物生命敘事可視分析平臺—以陸隴其為例
【正文】
0. 先和大家打个招呼吧 
-
你是谁: 我是一名985高校教师,文史哲研究者;
-
你是怎么用 TRAE 把 Demo 做出来的: 我一直想做個網站,把历史人物个体的生命叙事用可视化的形式呈现出来,因为历史上有太多人的其实有丰富的生命,但是一直被现代学术体制遗忘。尤其是有的人在身后竟然拥有多种年谱,把一個清代人物的四本年譜並排著看,同一年發生的事,四本書寫得不一樣,一眼就能看出差異。然后但這個想法卡了好久。
用 TRAE 就像跟一個懂技術的朋友聊天。我說人話:「我想讓人輸入一個問題,網站自動去古文裡找答案,再用大白話回答,還要告訴你這段話出自哪本書哪一頁。」它就幫我把後台、前台全部寫好了。我只管說「要什麼效果」,它管「怎麼做」。
最意外的瞬間是:我擔心了一整週的核心功能,一個下午就跑起來了。最大的坎是問答系統太慢,問一個問題要等 50 秒。TRAE 幫我一步步排查,發現是每次都上網檢查更新導致的,改了一個設置就降到 3 秒。
9 個頁面,158 次提交,從零到上線。沒有 TRAE,這個想法永遠只會停在我腦子裡。
1. Demo 簡介
一句話定位
浮生行紀是一個基於 RAG + 可視化技術的數字人文網站,以清代理學名臣陸隴其(1630–1693)的四部年譜為核心文本,將傳統古籍尤其是年譜等材料的閱讀轉化為多維度的交互式探索體驗。
面向誰
-
高校研究者 — 明清思想史、文獻學方向的師生,需要快速比較多版本年譜差異
-
數字人文愛好者 — 對文本可視化、知識圖譜、GIS 歷史地圖感興趣的技術人文跨界者
-
傳統文化愛好者 — 希望以非線性方式了解歷史人物生平的普通讀者
核心功能
功能一:四譜對勘 — 同一年份,四種書寫
將四部成書於不同年代(1697/1718/1725/1745)的陸隴其年譜逐年份並列展示,自動標注差異類型(增補/省略/改寫/語序調整),並支持句子級語義對齊。用戶可直觀感受到「同一事件在不同時代被如何重新書寫」。

圖 1:四譜對勘頁面 — 四部年譜按年份並列,自動標注版本差異
功能二:智能問答 — 對年譜自由提問
基於 Agentic RAG 架構,整合 大模型 + BGE 中文語義嵌入 + 本地關鍵詞索引。用戶可用自然語言提問(如「陸隴其何時中進士?」),系統自動從年譜原文中檢索相關段落並生成結構化回答,同時標注原文出處。
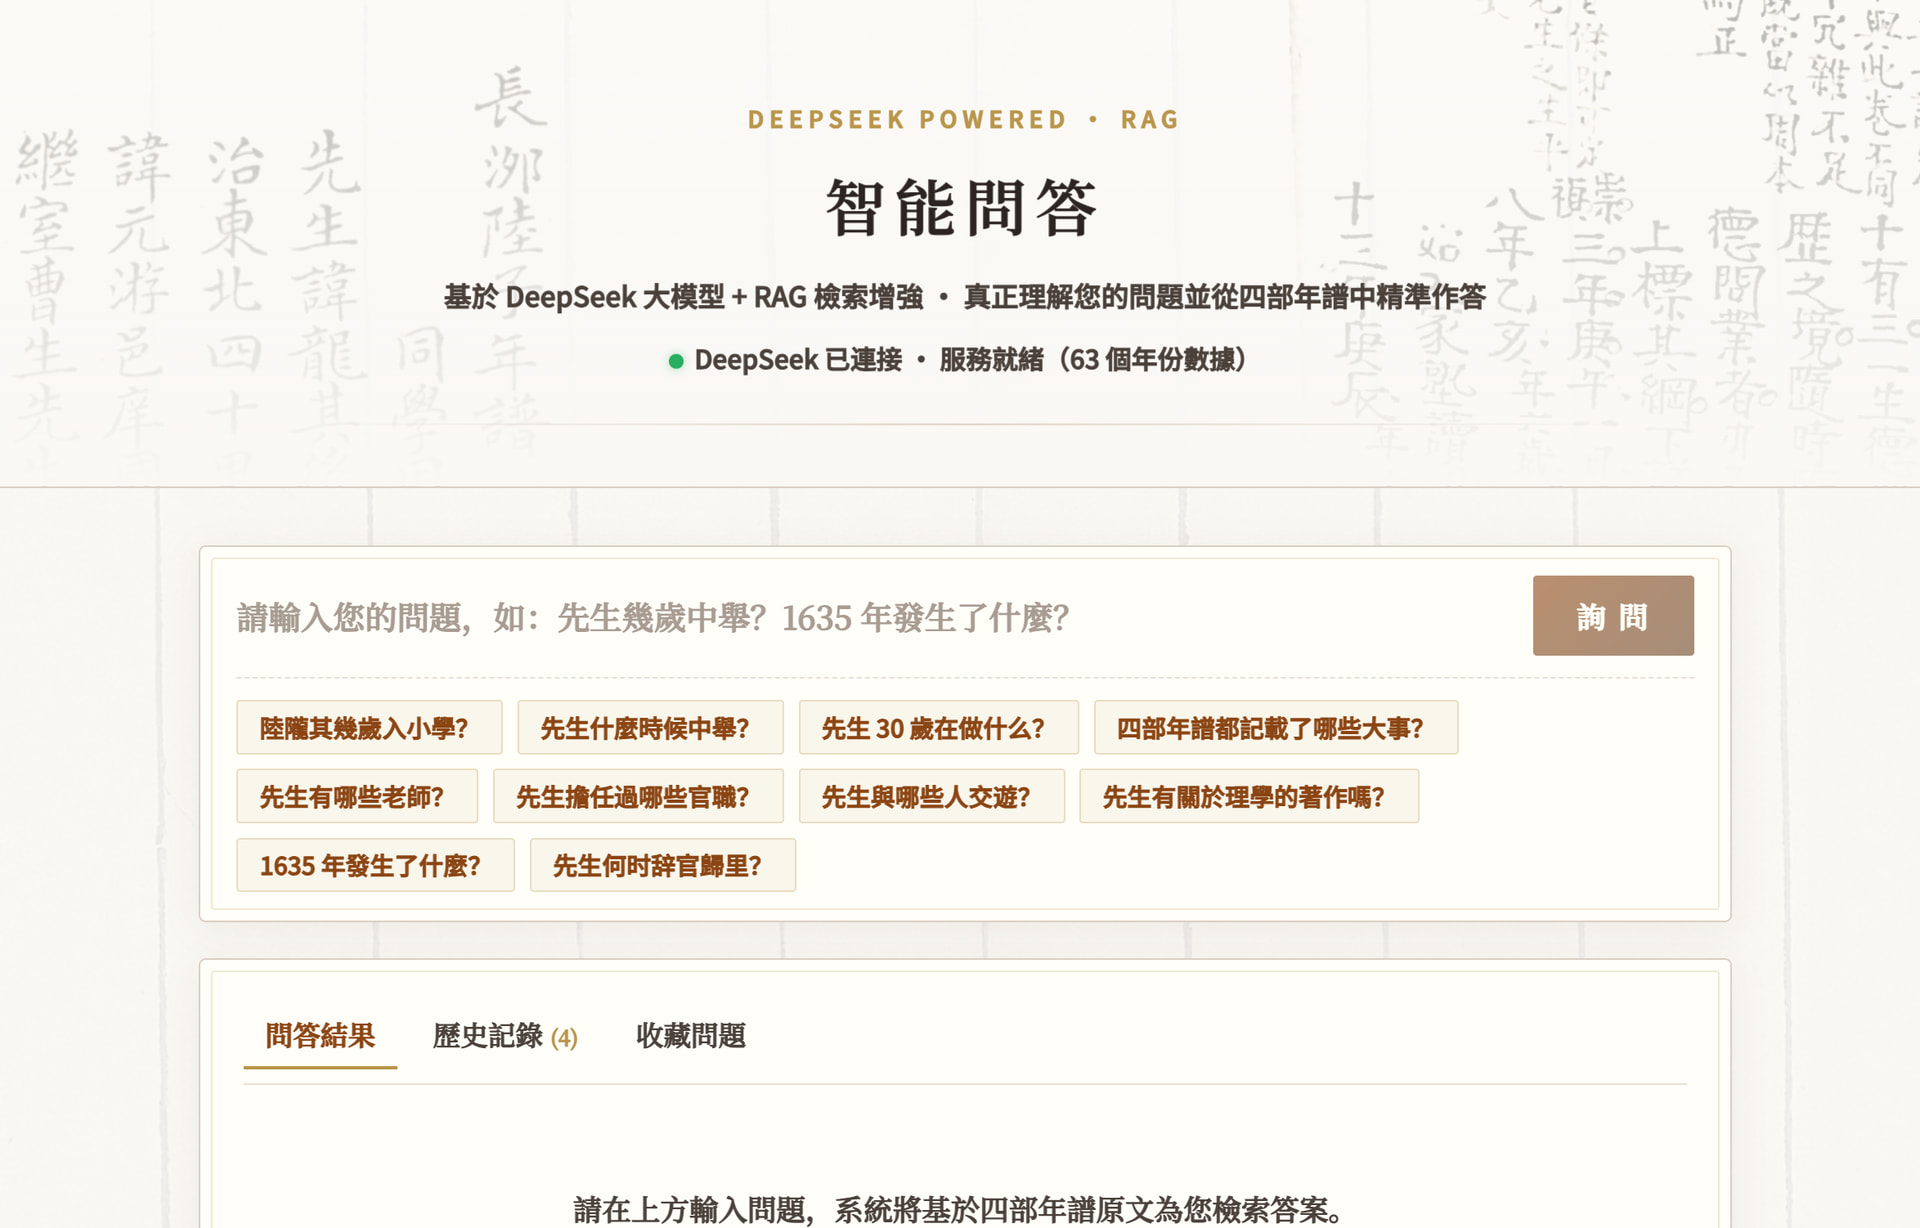
圖 2:智能問答頁面 — 自然語言提問,附原文引用
功能三:主題分析 + 語義空間 — 從數據中發現模式
將 45 個年份的事件按 12 類主題分類統計,支持四版本對比/差異視圖切換。更進一步,使用 BGE 嵌入模型將全部段落映射到二維語義空間,以散點圖呈現四部年譜在「意義層面」的聚散關係。

圖 3:主題分析 — 徑向圖下鑽
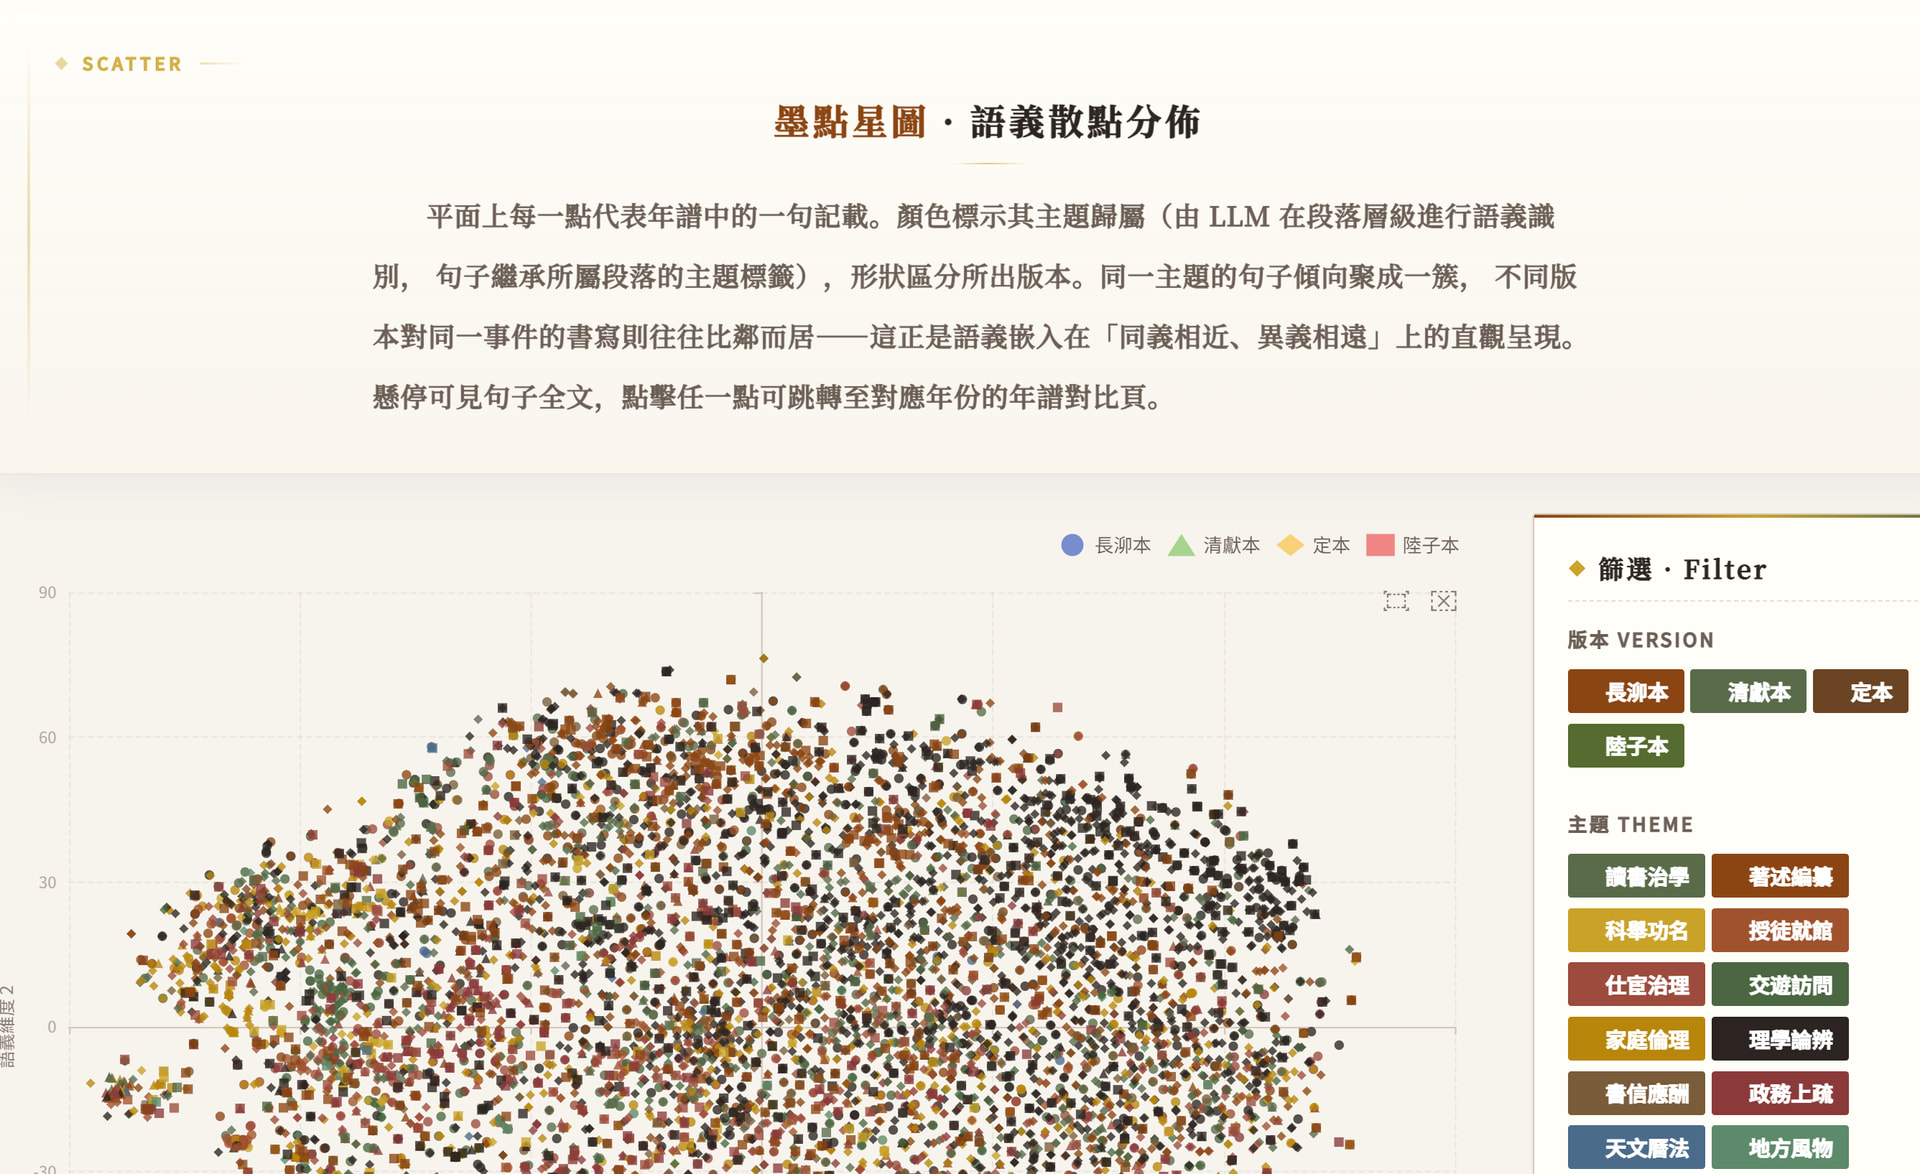
圖 4:語義空間 — 段落聚類散
2. Demo 創作思路
靈感來源
在攻讀歷史文獻學時,我反覆遇到一個困擾:同一個歷史人物的多部年譜,內容高度重疊但細節處處差異。陸隴其作為「清代第一位從祀孔廟的儒者」,身後留下了四部年譜——最早一部成書於他去世僅四年後(1697),最晚一部相隔近五十年(1745)。半個世紀裡,記憶在流轉中被不斷改寫:有人增補細節,有人刪除忌諱,有人自稱「定本」,有人爭奪「原本」。
這些差異本身就構成了一部「記憶的角力史」。但傳統閱讀方式下,要逐字逐句比較四個版本,工作量巨大且容易遺漏。我想:能否用 AI 和可視化技術,讓這種比較變得直觀、甚至有趣?

圖 5:人生敘事頁面 — 以章節式敘事引導讀者進入陸隴其的生命故事
想解決的問題
-
多版本比較的認知負荷 — 傳統方式需要四本書攤在桌上逐行對照,讀者容易疲勞且難以系統性發現差異模式
-
年譜閱讀的線性困境 — 年譜按年編排,讀者只能從頭讀到尾,無法按主題、地理、人物關係等維度切入
-
原始文本的檢索障礙 — 古漢語用詞與現代提問方式差距大,傳統關鍵詞搜索難以命中語義相關段落
-
研究結果的可視化匱乏 — 文史研究者往往止步於文字論述,缺少將發現可視化呈現的工具
為什麼做這個方向
數字人文是 AI 落地的一個獨特場景:它既需要嚴肅的文獻學功底,又需要前沿的 NLP 和可視化能力。選擇陸隴其年譜,有三個判斷:
-
文本量適中 — 四部年譜合計數萬字,既有足夠的數據密度支撐語義分析,又不至於大到無法全量索引
-
版本差異顯著 — 四部年譜跨度近五十年,編者立場各異,差異類型豐富(增補/省略/改寫/重排序),適合做對比可視化
-
學術價值真實 — 陸隴其在清代理學史上的地位長期被「扁平化」,這個項目能為重新理解他提供新的工具視角
3.体验地址
4.用 TRAE 完成 Demo 開發的完整流程
整個項目從零開始,全部在 TRAE IDE 中完成。158 次 Git 提交記錄了從數據準備到前端打磨的完整歷程。以下是關鍵階段:
PHASE 01 · 數據基建
年譜文本結構化與 Markdown 同步
將四部年譜原文逐年份整理為 Markdown 文件,建立 nianpumd 數據源。TRAE 幫助自動生成 Python 腳本,將 MD 轉換為結構化 JSON,同時構建年份索引、關鍵詞索引、弟子網絡、著作圖譜等基礎數據。
PHASE 02 · 後端 API
FastAPI + RAG 智能問答系統
用 TRAE 搭建 FastAPI 後端,整合 DeepSeek API 實現 Agentic RAG 流程:查詢改寫 → 語義檢索 → BM25 檢索 → RRF 融合 → 重排序 → 結果評估 → 生成回答。期間遇到 HuggingFace 網絡超時問題(每次查詢延遲 23 秒),TRAE 幫助定位到 sentence_transformers 的網絡檢查機制,設置 HF_HUB_OFFLINE 後響應降至 2 秒。
PHASE 03 · 前端頁面
9 個功能頁面 + 古籍視覺體系
從首頁到智問頁,逐一實現:首頁(打字機+粒子+花瓣動畫)、人生敘事(章節式滾動)、四譜對勘(並列差異標注)、主題分析(徑向圖+玫瑰圖)、語義空間(散點聚類)、逐年閱覽(時間軸+翻頁書)、行迹地圖(Leaflet+D3)、弟子分析(OpenLayers+vis-network+Chart.js)、著作圖譜(ECharts 關係圖)。TRAE 在每個頁面中協助生成 ECharts/D3 配置、CSS 動畫、響應式佈局。
PHASE 04 · Vue 3 遷移
漸進式遷移與動畫升級
將首頁從原生 JS 遷移到 Vue 3,利用 <Transition> 和 <TransitionGroup> 實現引言輪播淡入淡出、導航下拉縮放動畫、索引卡片 staggered 進場、路徑箭頭逐個畫出、特色卡片懸停聯動、打字機游標平滑淡出等六項視覺提升。
PHASE 05 · 部署上線
群暉 NAS 部署 + API 安全
編寫 PowerShell 部署腳本和 SSH 遠程啟動腳本,一鍵部署到群暉 NAS。設置 API Key 環境變量優先讀取機制,部署腳本排除敏感文件,FastAPI 中間件攔截 /config/、/backend/ 等敏感路徑(返回 403)。花生殼內網穿透實現外網訪問,部署版限制 API 調用 5 次。
TRAE 在開發中的核心角色
| 開發環節 | TRAE 做了什麼 | 效率提升 |
|---|---|---|
| 數據處理腳本 | 根據需求描述生成 Python 腳本:MD→JSON 轉換、索引構建、關鍵詞提取 | 從手寫數小時 → 對話式 10 分鐘 |
| RAG 後端 | 生成完整 FastAPI 路由、DeepSeek 調用封裝、語義檢索模組、重排序邏輯 | 複雜架構快速落地,專注調優 |
| 前端頁面 | 生成 ECharts/D3/Leaflet 配置、CSS 動畫、響應式佈局、Vue 3 組件 | 9 個頁面逐一推進,無需從零查文檔 |
| 性能調優 | 定位 HuggingFace 超時根因,分析 45 秒延遲鏈路,給出修復方案 | 23 秒 → 2 秒,省去手動 profile |
| 部署運維 | 生成部署腳本、安全中間件、API 限流邏輯 | 一鍵部署,安全配置自動化 |
| 視覺打磨 | 逐像素調整古籍視覺體系:版框、紀年帶、題簽柱、篆書印章、紙紋斑駁 | 設計意圖直接轉為代碼 |
典型開發對話示例
以下是實際開發中與 TRAE 的典型交互模式:
# 場景:四譜對勘頁面的差異標注邏輯 # 用戶:幫我實現四部年譜同年份的並列展示,要自動標注差異類型 # TRAE: # 1. 生成了差異檢測算法(增補/省略/改寫/語序) # 2. 生成了四列並列布局的 HTML + CSS # 3. 生成了差異類型的顏色標注系統 # 4. 生成了年份切換的交互邏輯 # 場景:性能調優 # 用戶:智問響應太慢了,要等 50 秒 # TRAE: # 1. 在各環節加入計時日誌 # 2. 定位到 search_relevant_text 語義: 45.6s # 3. 發現 HuggingFace 每次連網超時 23 秒 # 4. 設置 HF_HUB_OFFLINE=1,延遲降至 0.7s # 5. 總響應時間從 50s → 2.9s
4.1經驗總結與開發心得
1. AI 輔助開發的最佳實踐
在 158 次提交的開發過程中,我逐漸摸清了與 TRAE 協作的最佳模式:
-
先提需求,再要代碼 — 先讓 TRAE 理解「要做什麼」而非「怎麼做」,它給出的方案往往比直接要代碼更合理
-
分步迭代優於一次生成 — 9 個頁面逐一推進,每個頁面先出框架再填細節,避免一次性生成大量代碼後難以調試
-
用 Git 做安全網 — 每個功能完成後立即提交,出問題時 `git checkout` 秒回滾,比手動撤銷可靠得多
-
讓 TRAE 做調優 — 性能問題、視覺細節、安全加固這些「打磨」工作交給 TRAE,它擅長在現有代碼上做精確的手術
2. 數字人文項目的技術選型反思
-
RAG 優於純大模型 — 年譜是封閉語料,RAG 檢索原文再生成,比直接讓大模型「憑記憶」回答準確得多。加上原文出處標注,學術可信度大增
-
語義嵌入解決古漢語檢索 — 傳統關鍵詞搜索「陸隴其何時中進士」會漏掉「公登第」「廷試」等同義表述。BGE 中文嵌入模型把這些語義相近的段落都檢索到了
-
可視化要服務於發現 — 徑向圖、散點圖不只是好看,它們能幫研究者發現「四部年譜中哪一部在哪些主題上寫得特別多/少」這種用肉眼讀不出來的模式
3. 開發心得
核心體會
TRAE 最獨特的價值不在於「生成代碼」,而在於將意圖直接轉化為可運行的系統。傳統開發中,從「我想做一個四譜對勘頁面」到「頁面上線」之間有無數瑣碎的步驟:查 ECharts 文檔、寫 CSS 佈局、調 API 接口、處理響應式。TRAE 把這些步驟壓縮成了一輪對話。
這個項目讓我深刻體會到:AI 輔助開發的真正潛力,不在於替代程序員,而在於讓有領域知識的人能夠獨立完成一個完整的數字產品。沒有 TRAE,這個項目可能需要一個前端工程師 + 一個後端工程師 + 一個設計師的團隊协作數週。而用 TRAE,我一個人在業餘時間完成了全部開發。
最後,關於這個項目的定位——它不是一個「技術 Demo」,而是一個有學術靈魂的數字人文工具。技術服務於人文關懷:讓被簡化的生命重新被看見,讓被壓縮的記憶重新展開。這才是「浮生行紀」這個名字的含義——浮生若夢,行紀為證。
4.1 附开发关键步骤截图(不少于 3 张)
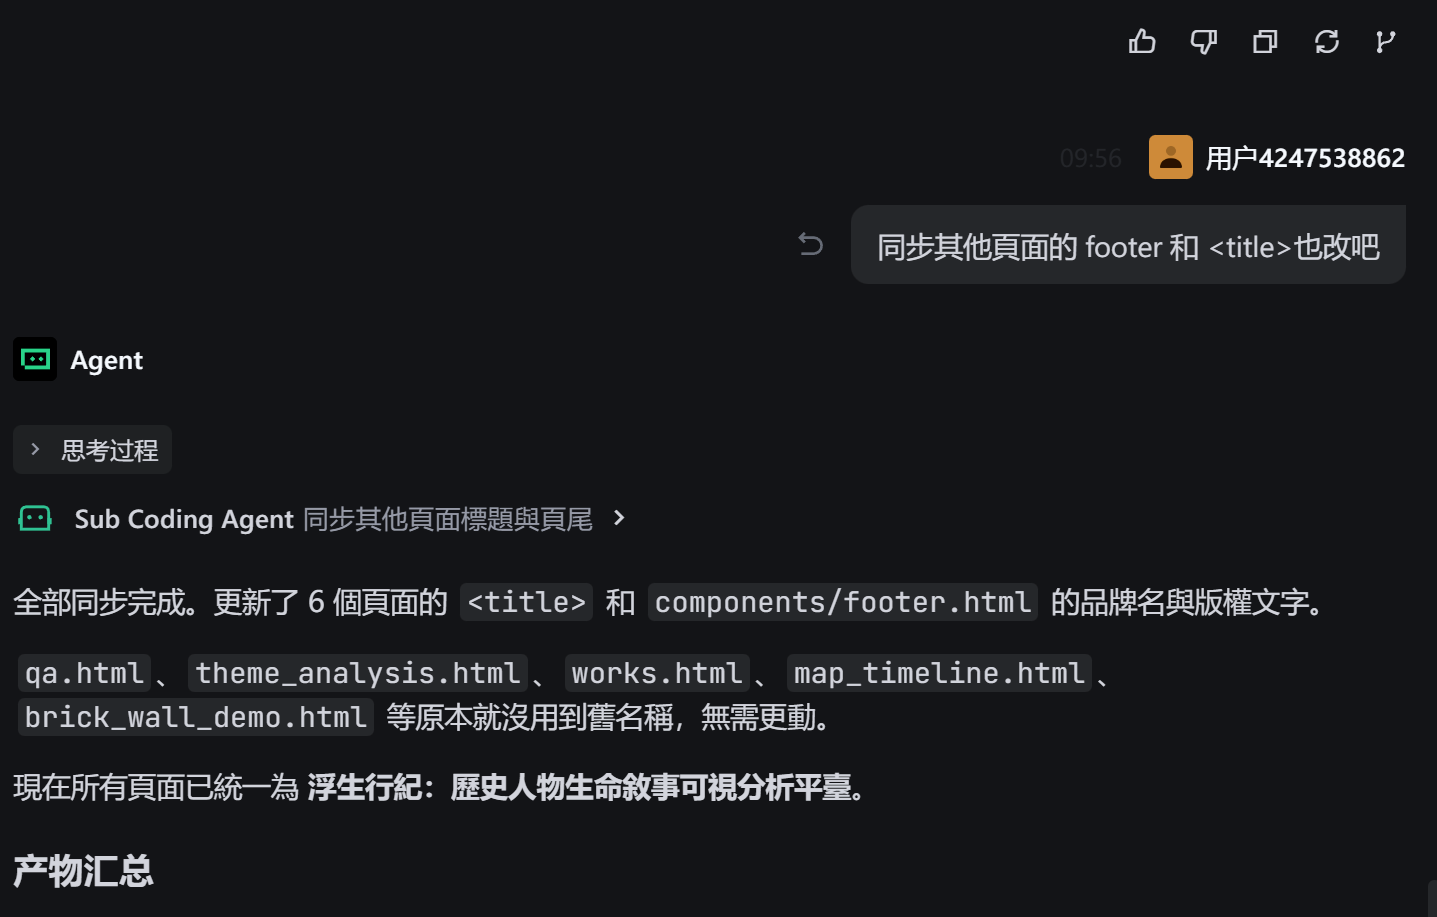
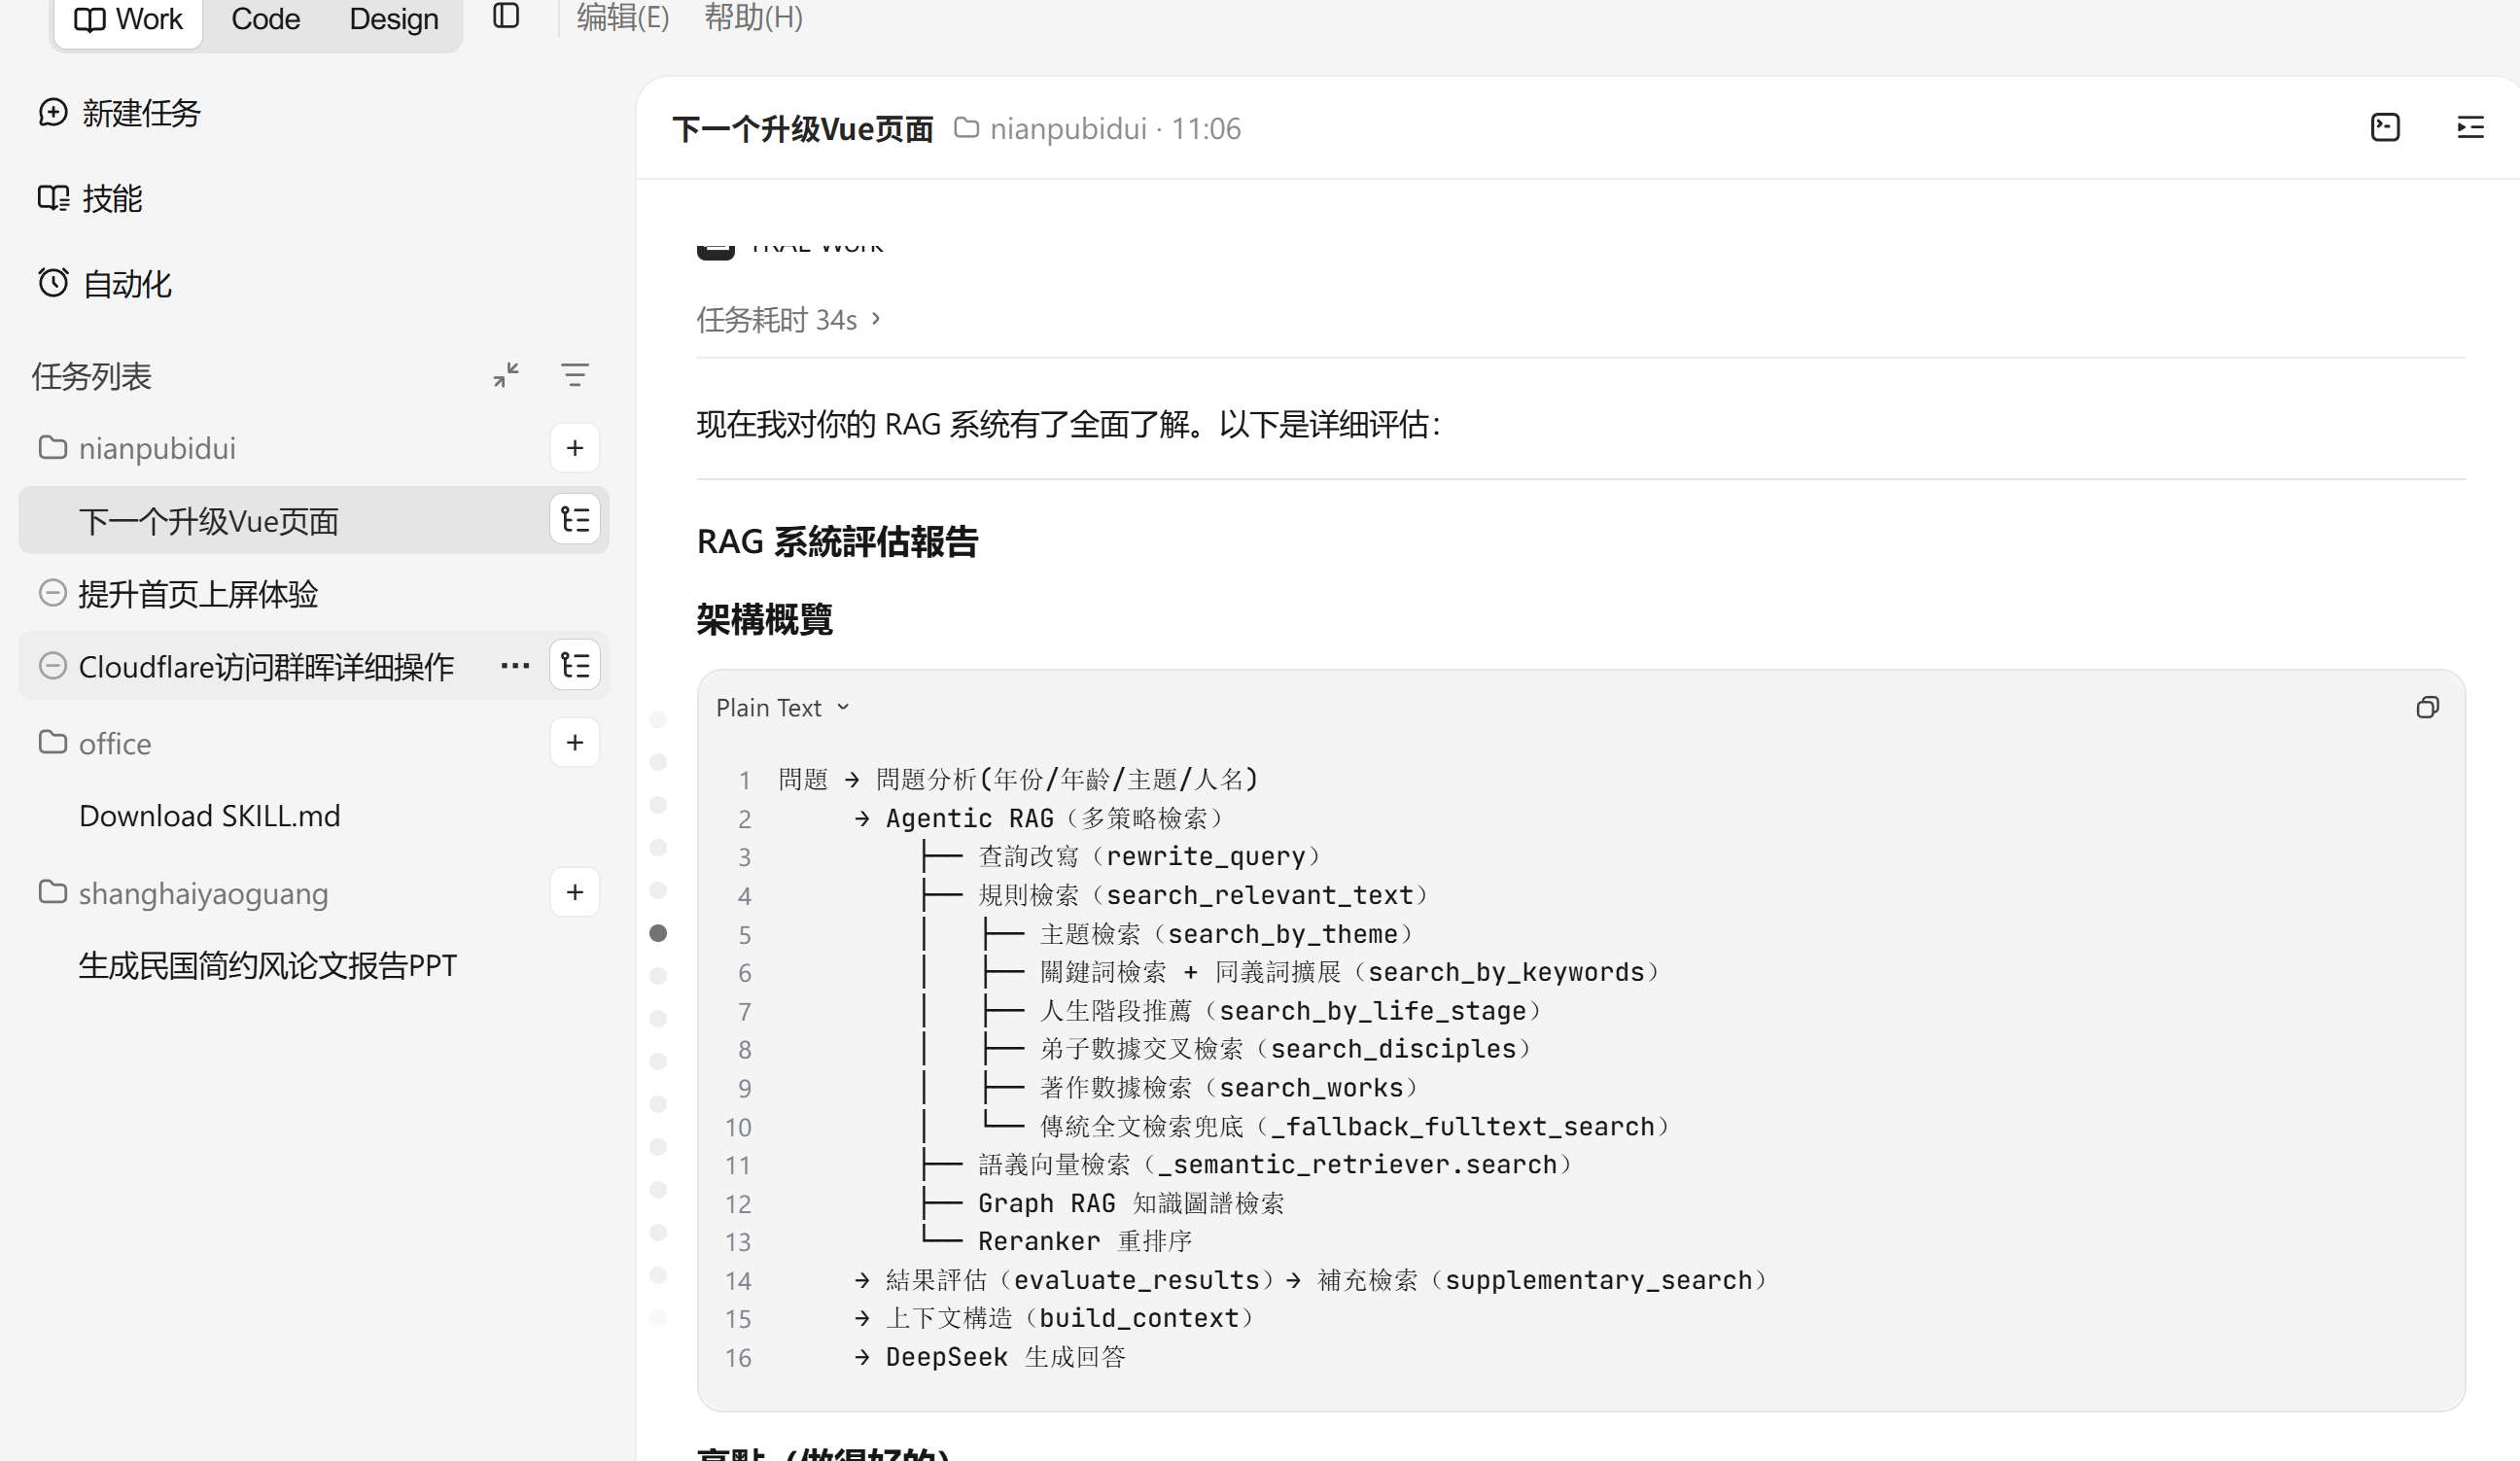
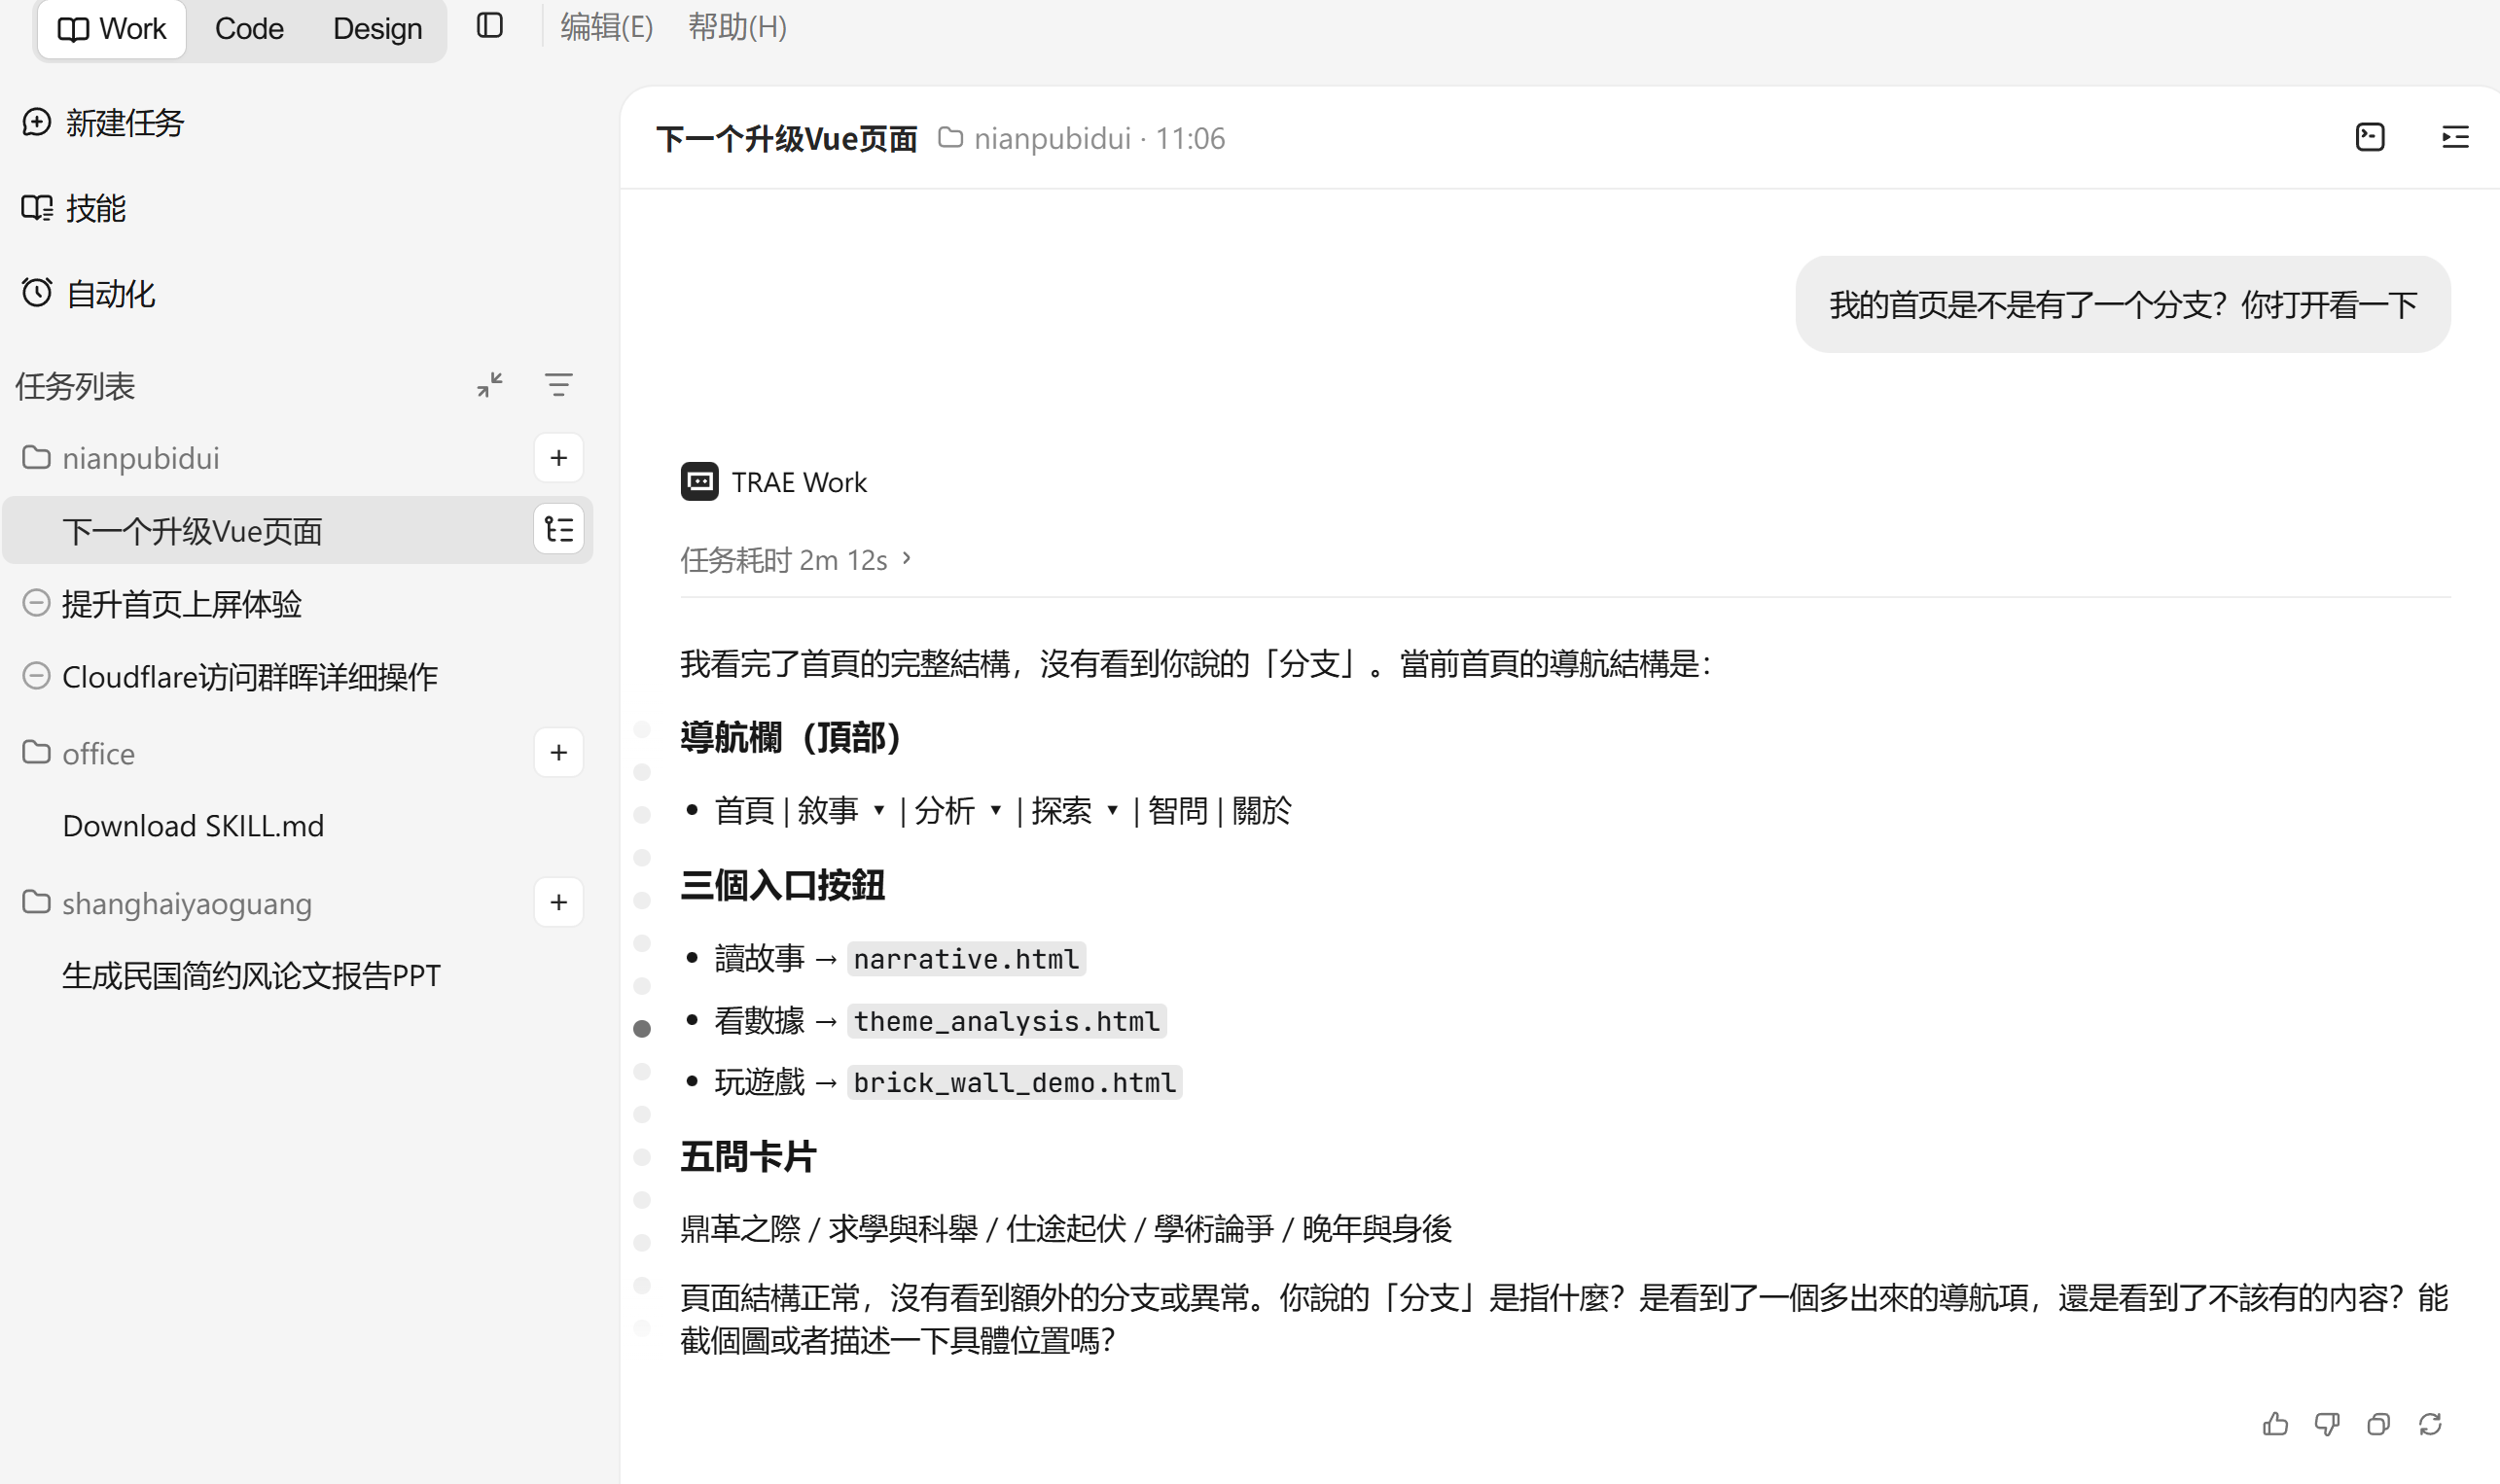
4.2 附关键任务对话的 Session ID(不少于 3 个),用于证明作品由 TRAE 开发完成。
.977916393166416:01cb12575131c0cd8dd4675a249e3fe1_6a4b32f5d7581944849dec16.6a4b3315d7581944849dec18.6a4b33141ec9fd7f234c034b:Trae CN.T(2026/7/6 12:46:13)
.977916393166416:fa63f4e09a5d179cb93cde7e2230f145_6a48ff1b4ac6d13a68ccc690.6a4a5e3679f2065f5c45bd02.6a4a5e363dbb813497c46f57:Trae CN.T(2026/7/5 21:37:58)
.977916393166416:154ae39771771448733c1234f7ae171a_6a3cabe71cd343ca17f58a51.6a44696a8783888e7e4ce0ab.6a44696a0be893990e052b47:Trae CN.T(2026/7/1 09:12:10)
5. 对应的报名审核通过的帖子链接
【学习工作】浮生行纪——历史人物生命叙事智能平台 - TRAE AI 创造力大赛 / 【大赛报名专区】 - TRAE 官方中文社区