生活娱乐 | Movie Narrator — 一句话生成电影解说视频
一、Demo 简介
Movie Narrator 是一个 AI 驱动的电影解说视频自动生成工具。输入一部电影名,AI 自动完成剧情研究、旁白剧本创作、语音合成、字幕生成、视频渲染全流程,输出一条完整的电影解说短视频。
整个项目从零开始,全程使用 TRAE Work 完成开发和迭代。
- 产品形态:Python CLI 工具 + Web UI(Gradio)
- 面向谁:短视频创作者、影视解说博主、内容生产团队
- 核心功能:
- 一句话生成全流程:输入电影名 → 自动生成 60 秒解说视频(旁白 + 字幕 + 画面 + BGM)
- 多 TTS 引擎支持:Edge TTS(免费)、OpenAI TTS、小米 MiMo TTS(含声音克隆和声音设计),可按需切换
- 多语言字幕:自动翻译生成中英双语字幕,支持原文/翻译/双语三种叠加模式
- 智能场景匹配:检测视频场景,用 Embedding 语义匹配旁白段落到最佳画面
- Web UI 可视化:浏览器操作全流程,实时查看进度,支持中途取消
产品截图:
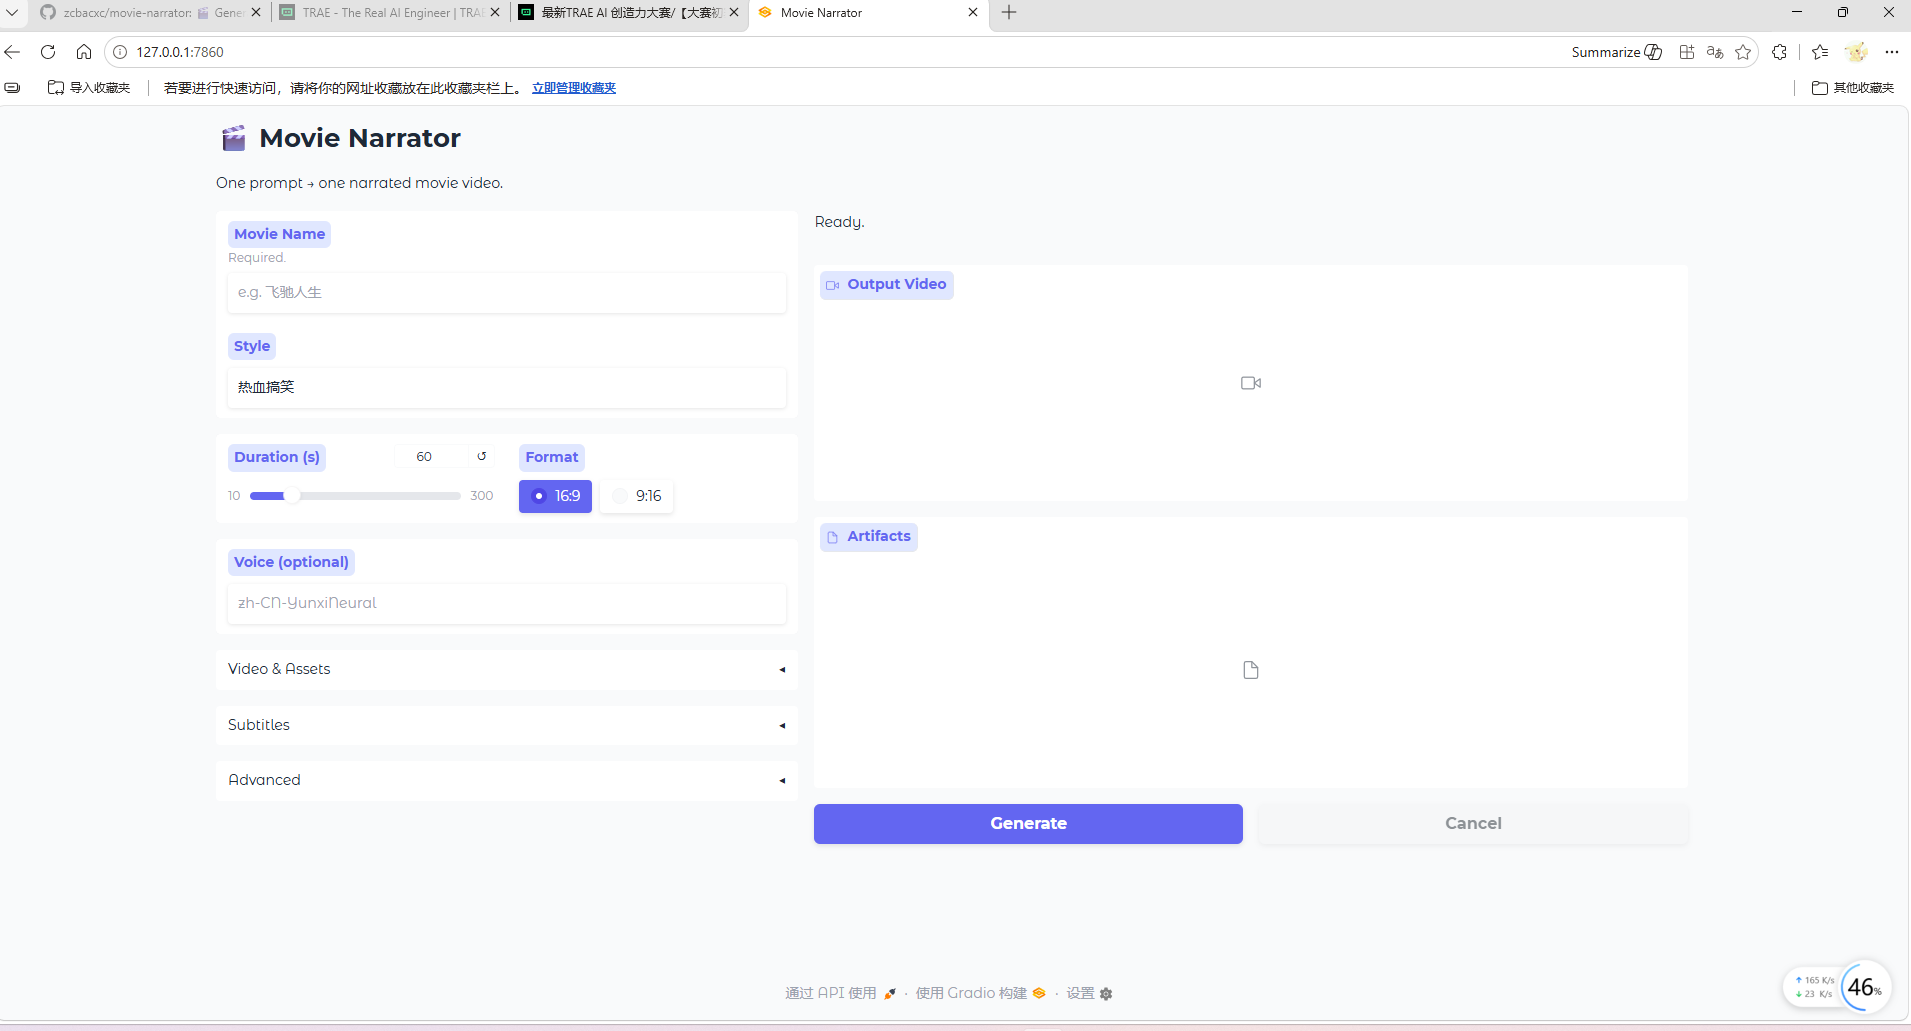
Web UI 界面 — 浏览器中完成全部操作
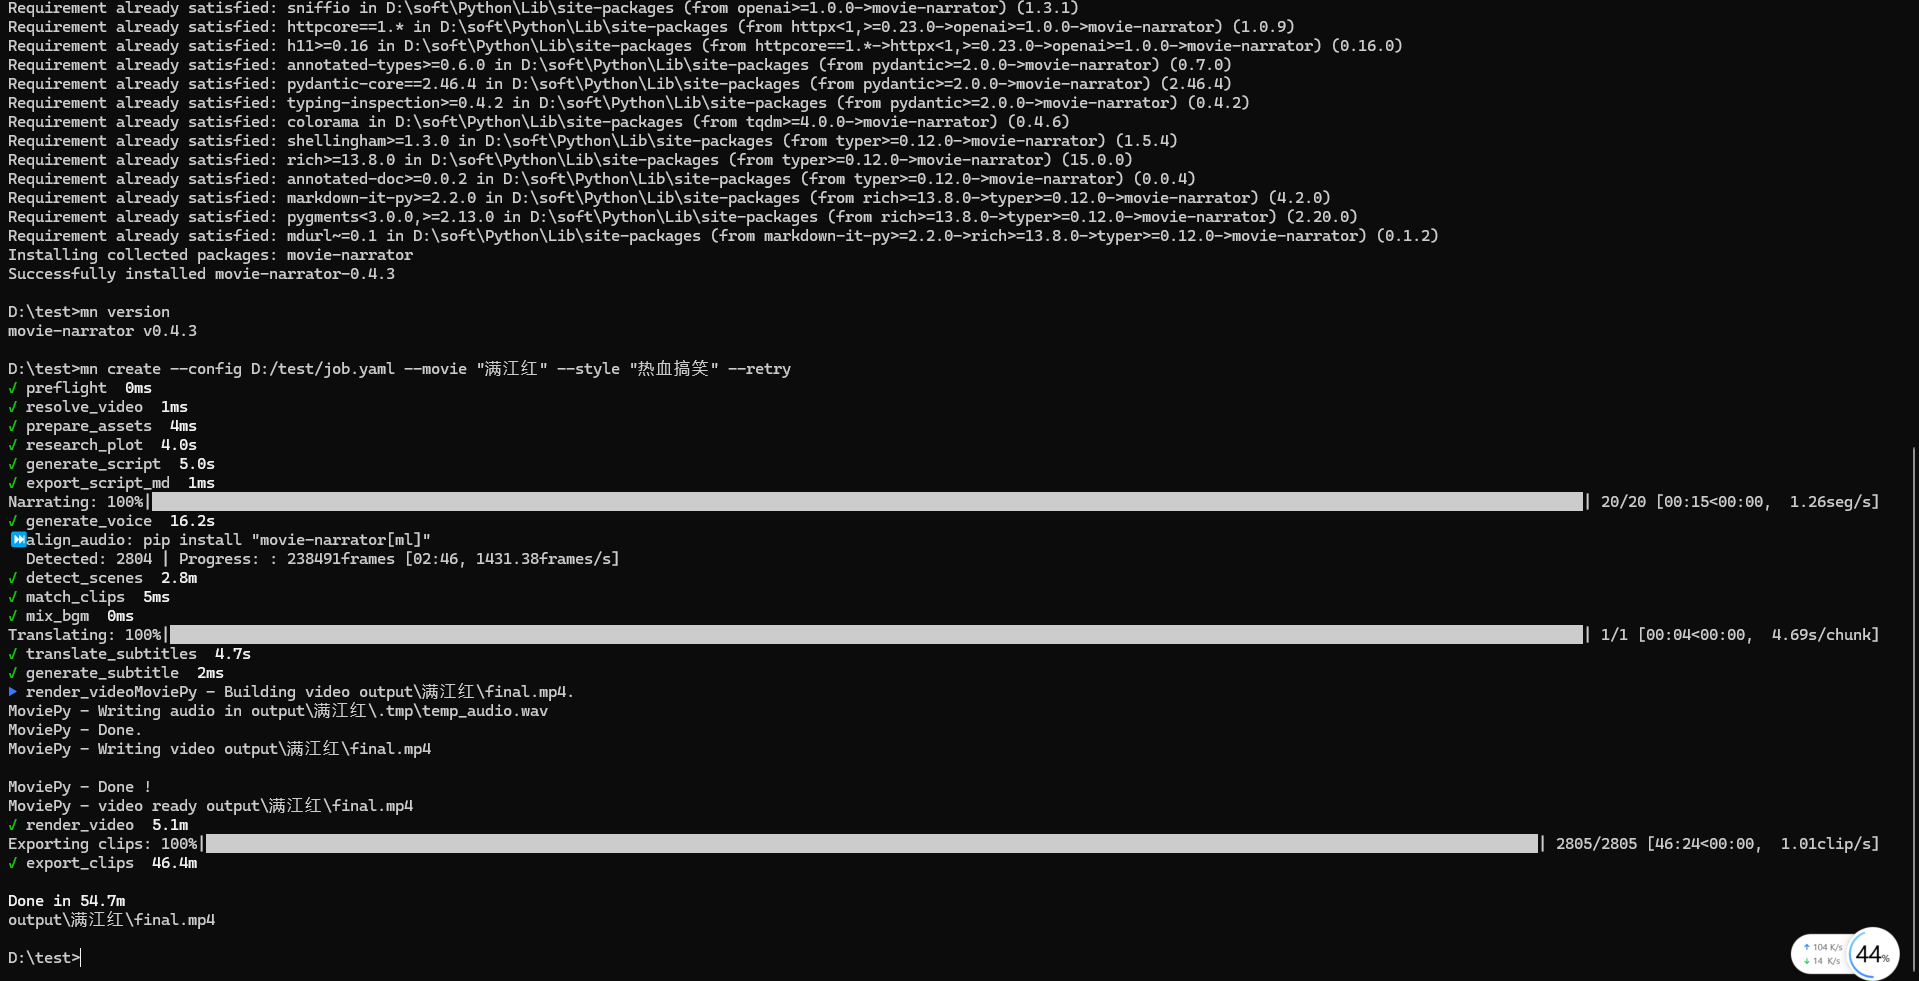
多语言字幕开发过程 — TRAE Work 自动实现翻译流水线
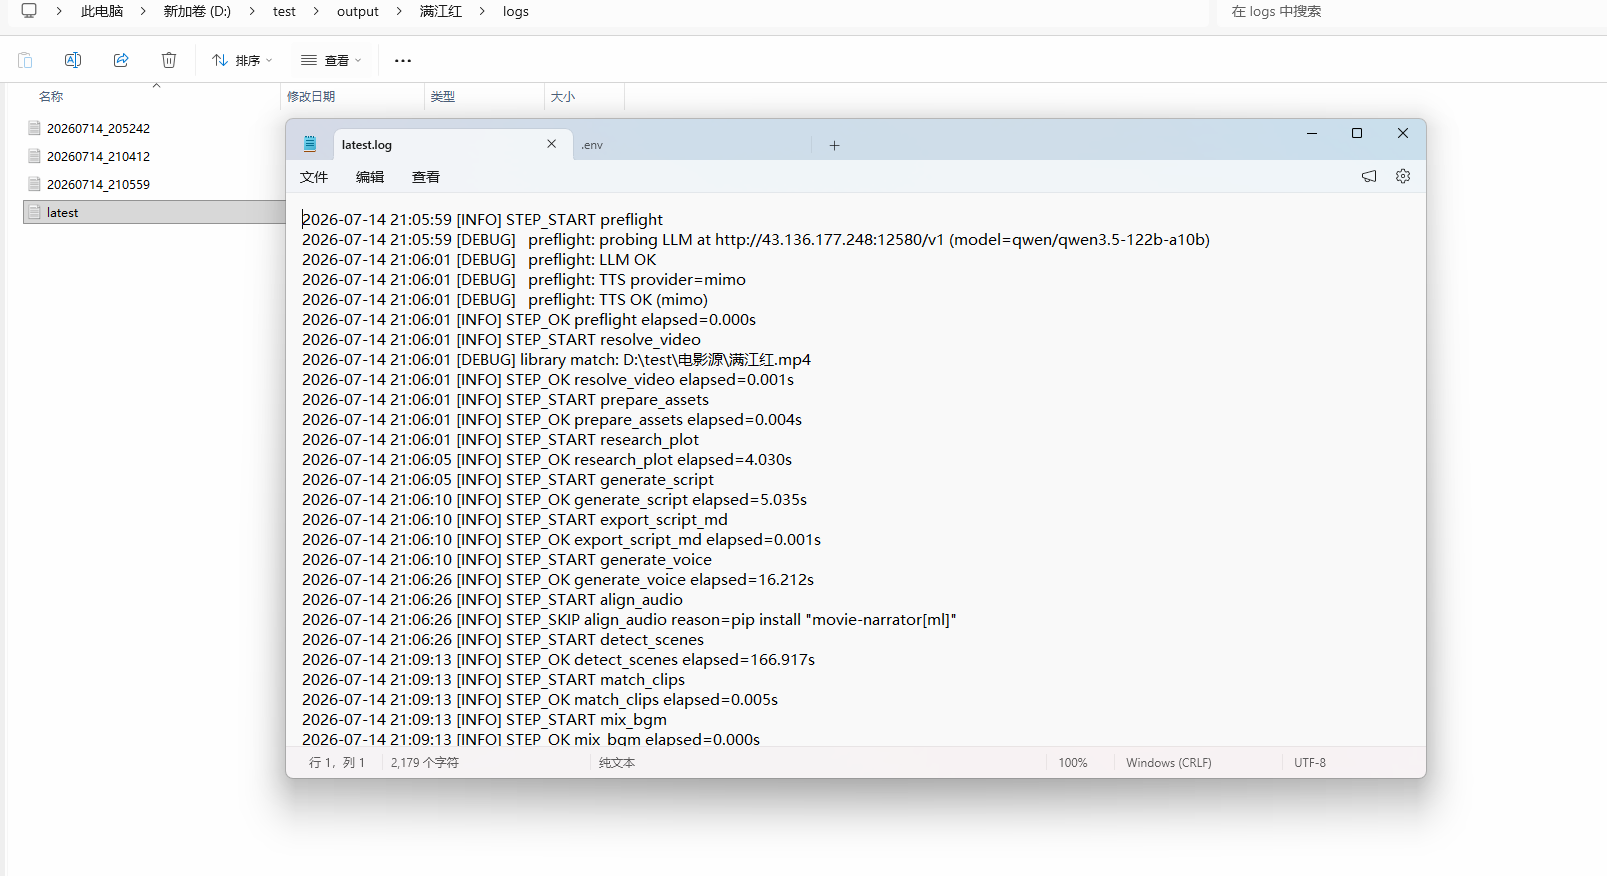
日志模块 — TRAE Work 从零构建结构化 Console 协议
二、Demo 创作思路
灵感来源:
做短视频运营的朋友抱怨:一条 60 秒的电影解说视频,要查资料、写文案、录音、配字幕、剪辑,至少 2 小时。我就在想——这些步骤能不能让 AI 全自动化?
想解决的问题:
影视解说视频的创作链路高度结构化(调研 → 文案 → 语音 → 字幕 → 剪辑),每一步都有明确的输入和输出,非常适合用 AI 流水线自动化。但市面上的工具要么只做其中一步(如纯 TTS),要么是封闭的 SaaS(不能自定义模型和声音)。
为什么做这个方向:
- 全链路自动化:不是只做 TTS 或只做字幕,而是一句话进去、一条视频出来
- 本地可控:支持 Ollama 本地模型,也支持远程 API,创作者完全掌控数据
- TTS 引擎可插拔:Edge TTS 免费、OpenAI TTS 标准化、MiMo TTS 支持声音克隆——三种引擎统一接口,一行配置切换
- 工程化质量:14 步流水线、soft/hard 步骤分类、preflight 预检、步骤级重试——不是玩具脚本,是可维护的工程项目
三、Demo 体验地址
方式一:GitHub 源码
完整源码、文档、CI/CD 流水线、CHANGELOG 均在仓库中,可 clone 后本地运行。
方式二:本地快速体验
pip install movie-narrator[full]
mn create --movie "满江红"
方式三:演示视频
四、TRAE 实践过程
整个项目从第一行代码到 v0.4.3,全部使用 TRAE Work 完成开发。以下是关键开发阶段的展示。
4.1 项目搭建 + 核心流水线构建
我向 TRAE Work 描述了产品愿景:“做一个 CLI 工具,输入电影名,自动生成解说视频”。TRAE 帮我完成了:
- 项目脚手架搭建(pyproject.toml、包结构、CLI 入口)
- 14 步流水线架构设计(resolve_video → prepare_assets → research_plot → … → render_video)
- LLM 对接(剧情研究 + 剧本生成)
- TTS 语音合成(Edge TTS 集成)
- MoviePy 视频渲染(字幕叠加 + 音频混合)
这是整个项目的地基,TRAE 一次性帮我生成了可运行的核心链路。
4.2 结构化日志系统构建
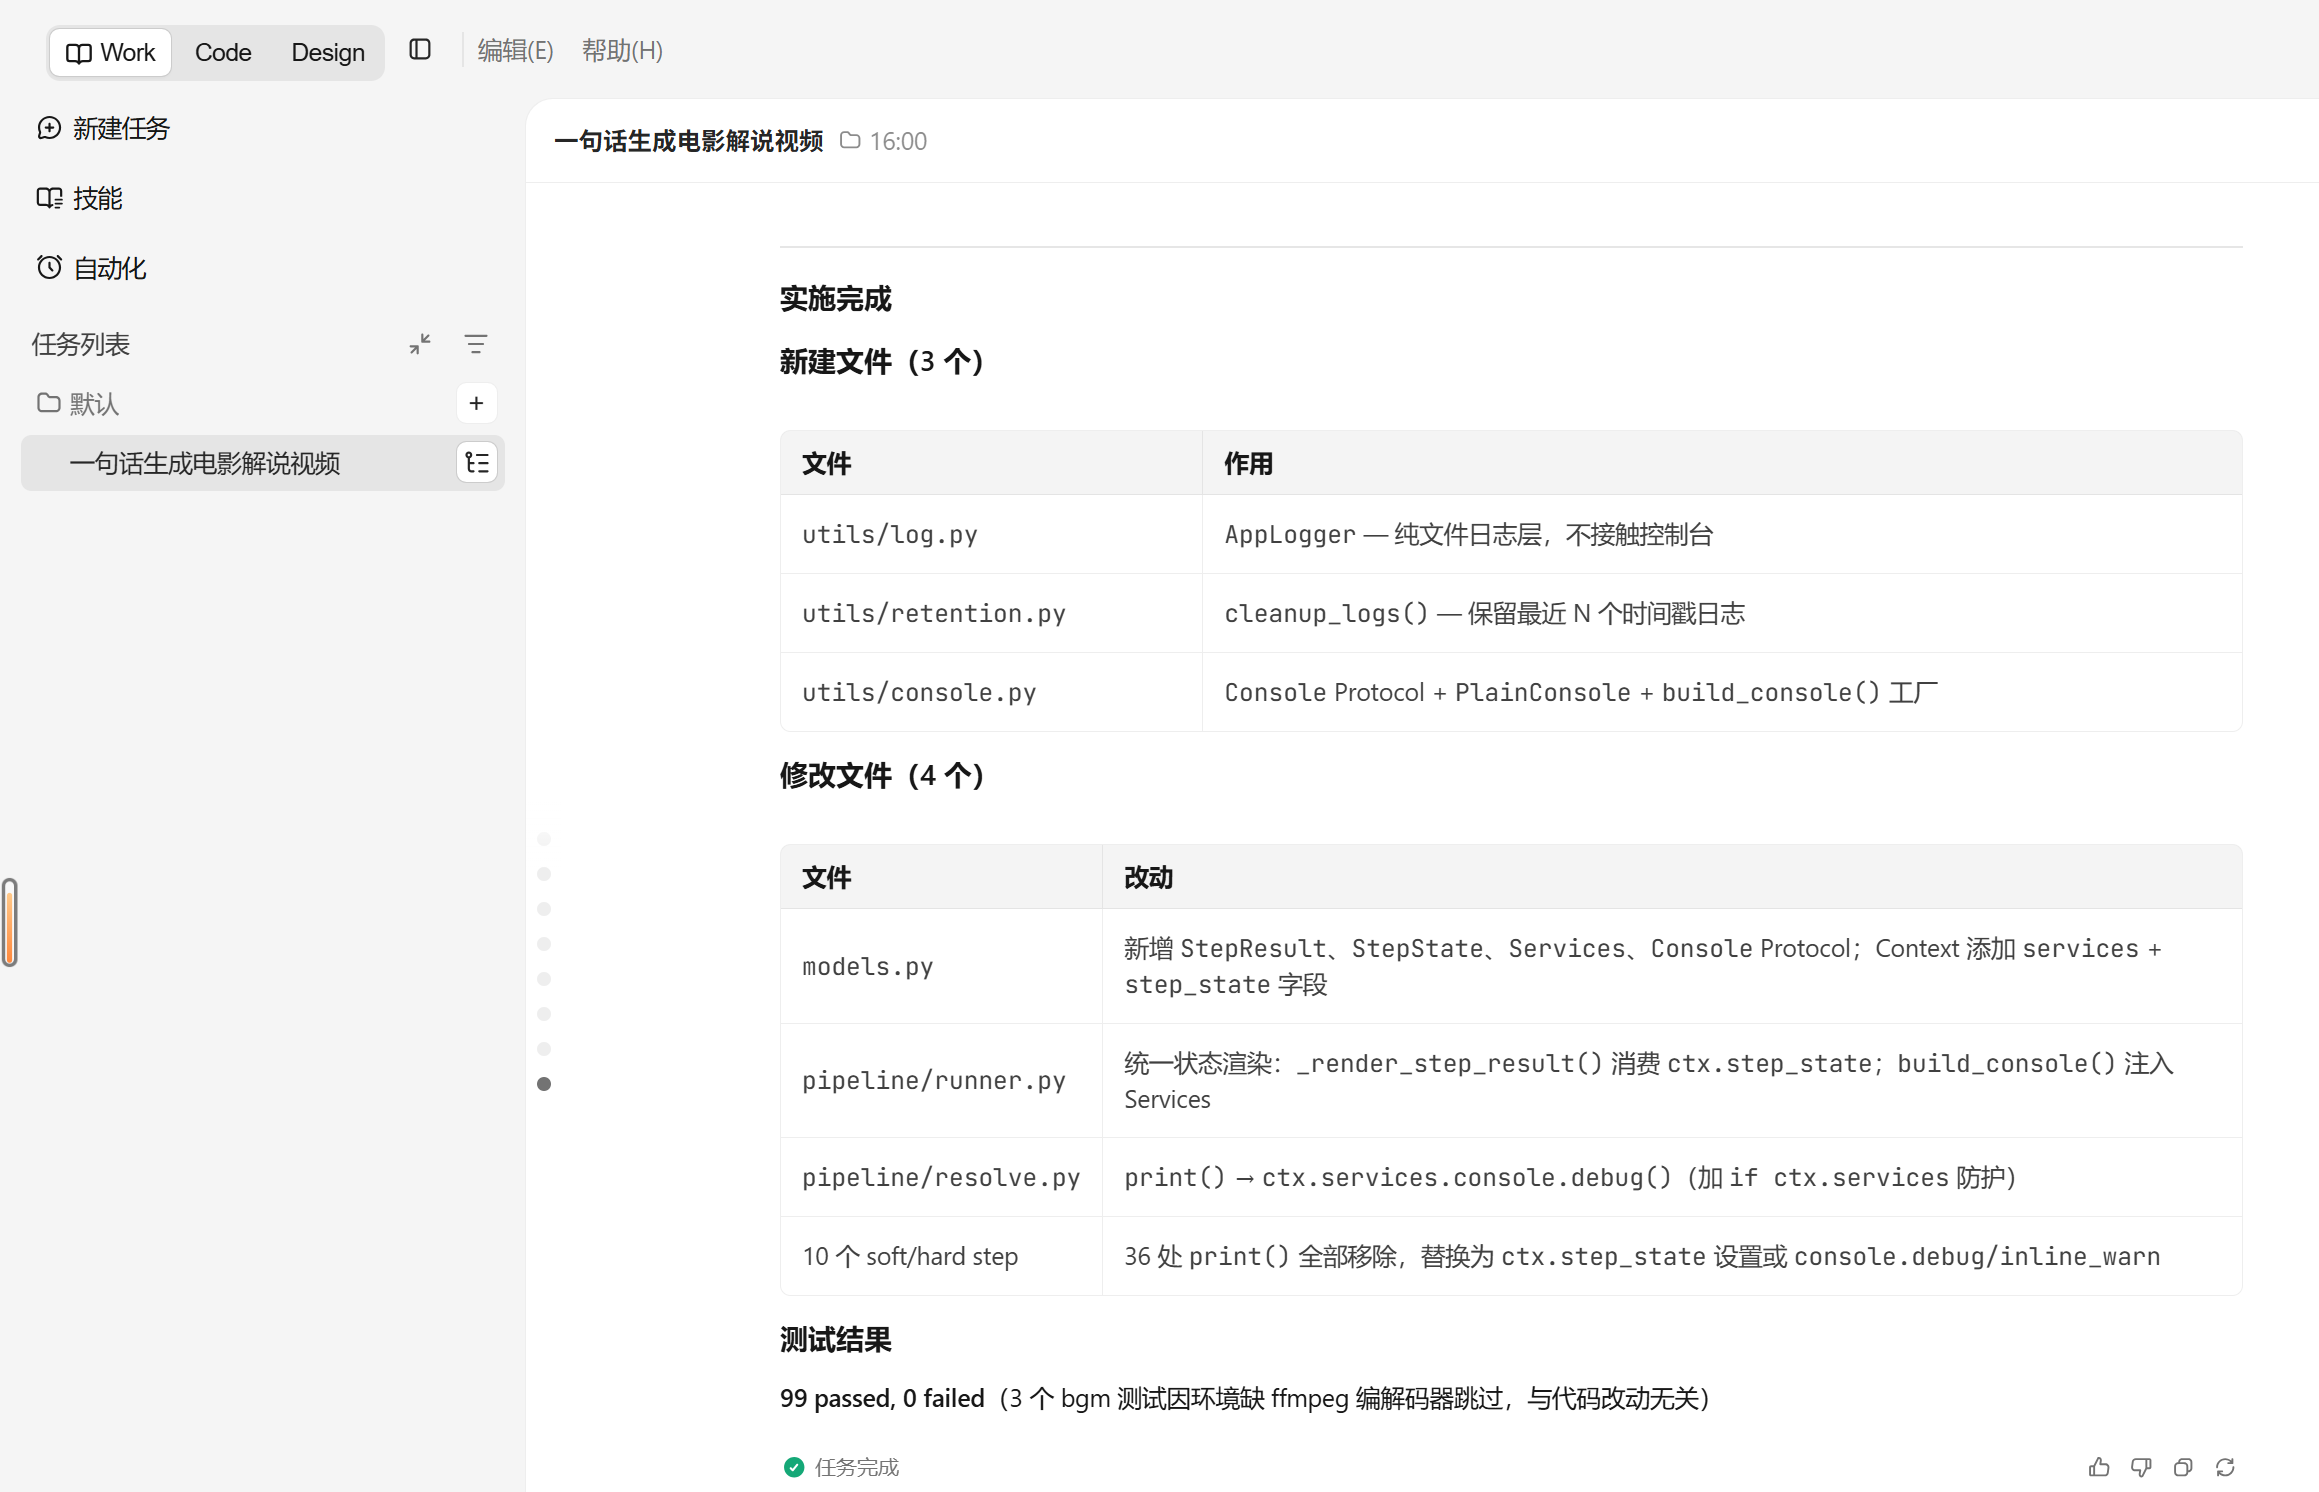
流水线跑起来后,我需要一套完整的日志系统来追踪每一步的执行状态。向 TRAE Work 描述需求后,它帮我从零构建了:
utils/log.py— AppLogger 纯文件日志层,双写时间戳日志 + latest.logutils/retention.py— 日志保留策略,自动清理旧日志utils/console.py— Console Protocol + PlainConsole + 工厂函数models.py— StepResult / StepState / Services 数据模型runner.py— 统一状态渲染,每步自动记录耗时和结果
最终 14 个 pipeline step 全部接入结构化日志,99 passed,0 failed。
4.3 多语言字幕功能开发
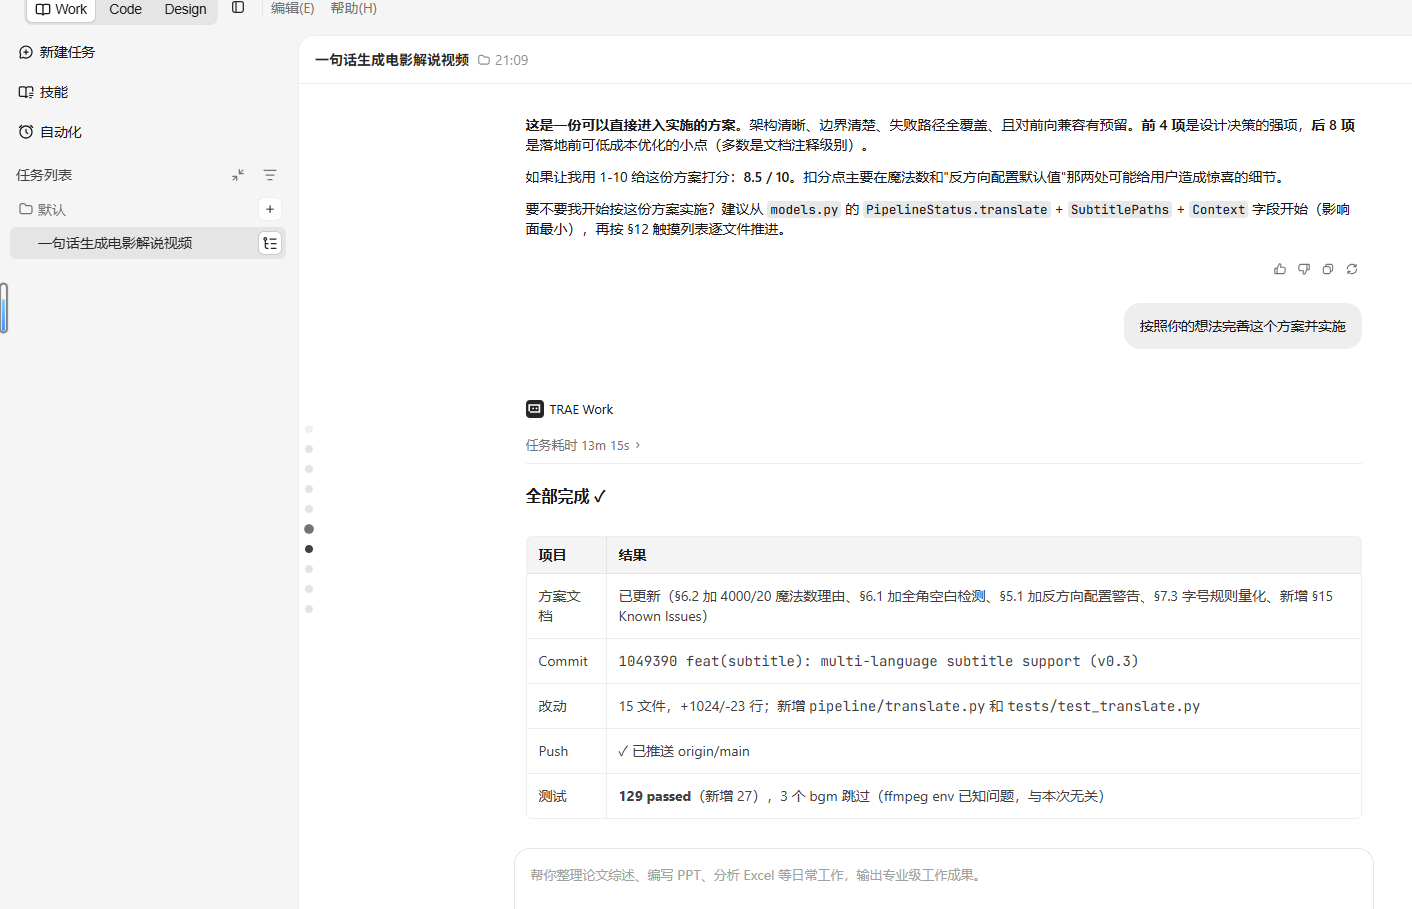
为了让解说视频面向国际观众,我需要加多语言字幕。我先写了一个方案文档,让 TRAE 评估(它打了 8.5/10 分,指出了 magic number 和反向配置默认值的问题),然后让它按改进建议从零开发:
- 新建
pipeline/translate.py— LLM 翻译 provider,chunk 级重试 + soft-degrade - 三文件字幕输出:
subtitle.srt(原文)+subtitle.<lang>.srt(翻译)+subtitle.bilingual.srt(双语) - 三种叠加模式:original / translated / bilingual
改动:15 files, +1024/-23 lines。测试:129 passed, 27 new。
4.4 Web UI 开发
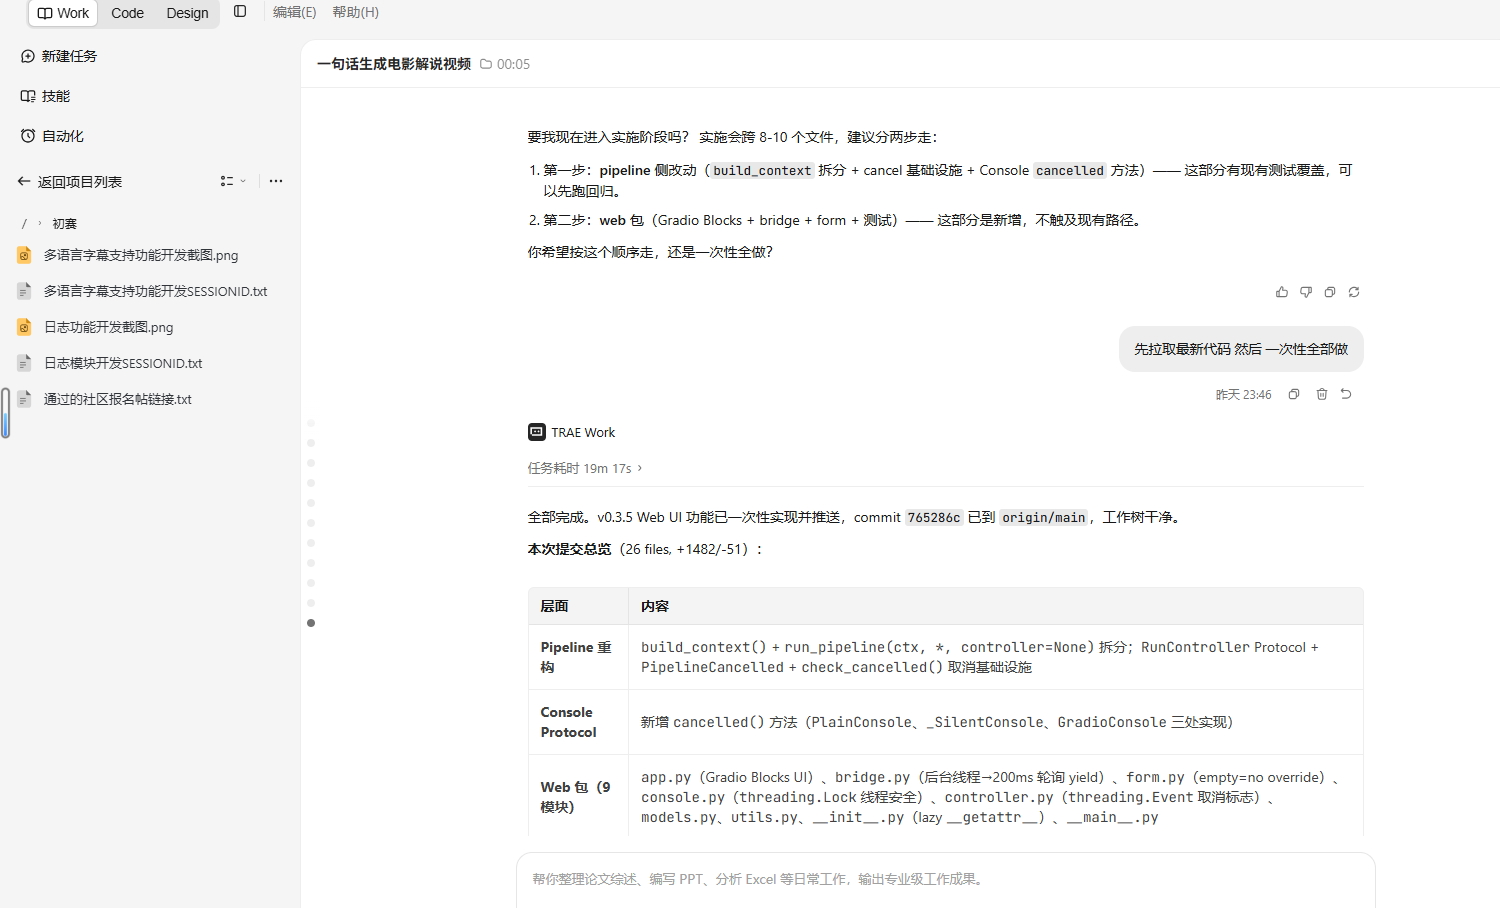
CLI 门槛高,我决定用 TRAE Work 开发一个 Web UI。TRAE 提出两步实施方案(先重构 pipeline 再加 Web 层),我选择一次性做。TRAE 在 19 分 17 秒内从零构建了完整的 Web 层:
- Pipeline 架构升级:
build_context()+run_pipeline(ctx)拆分,RunController 协作式取消 - Web 包(9 个模块):Gradio Blocks UI、后台线程桥接(200ms 轮询)、表单、线程安全 Console、取消控制器
- 全部测试通过,26 files, +1482/-51 lines
4.5 TTS 抽象层 + MiMo TTS 集成
为了让用户自由选择语音引擎,我用 TRAE Work 从零构建了 TTS 抽象层:
TTSProvider协议 +BaseTTSProvider(CI 静默回退)- 三种 Provider 实现:Edge TTS(免费)、OpenAI TTS、小米 MiMo TTS
- MiMo TTS 支持三种模式:命名音色、声音克隆(base64 音频)、声音设计(文本描述生成音色)
- SHA256 两级缓存,避免重复合成
4.6 Preflight 预检 + 步骤级重试
为了提升健壮性,我用 TRAE Work 开发了两个关键机制:
- Preflight 预检:流水线执行前探测 LLM 连通性(1-token 请求)和 TTS 凭证,失败立即报错附修复提示,避免静默降级到 Mock 内容
- 步骤级重试:
--retry标志启用交互式 [R]etry / [S]kip / [A]bort,重试时保留 ctx 状态(TTS 缓存自动复用),无需从头重跑
4.7 Python 3.13+ 兼容 + MoviePy 2.x 升级
用 TRAE Work 完成了依赖升级:
- MoviePy 1.x → 2.x API 迁移(6 处 API 重命名)
- Python 3.13 加入 CI 矩阵
[ml]extras(whisperx/sentence-transformers)在 Python 3.14 上自动跳过- 首次运行自动创建
~/.movie-narrator/.env配置文件
关键步骤截图
| 截图 | 对应开发任务 | Session ID |
|---|---|---|
| 日志功能开发截图 | 结构化日志系统从零构建 | 8443a1184bc399ba0c856217d1cfe128 |
| 多语言字幕支持功能开发截图 | 翻译流水线 + 双语字幕从零开发 | 5231e1c0ac4b1d8ac2c274439809f518 |
| Web UI 功能开发截图 | Gradio Web UI + Pipeline 架构升级 | f8c92dedd78815c1e7779fbbdac4d55a |
Session ID(共 3 个)
8443a1184bc399ba0c856217d1cfe128— 日志模块开发(TRAE Work CN 0.1.32, 2026/7/13 15:35)5231e1c0ac4b1d8ac2c274439809f518— Web UI 功能开发(TRAE Work CN 0.1.34, 2026/7/13 23:46)f8c92dedd78815c1e7779fbbdac4d55a— 多语言字幕支持功能开发(TRAE Work CN 0.1.34, 2026/7/13 20:44)
五、报名帖链接
六、技术架构
src/movie_narrator/
├── pipeline/          # 14 步流水线
│   ├── runner.py      # 编排器(preflight + retry + soft/hard)
│   ├── preflight.py   # 运行前 LLM/TTS 校验
│   ├── research.py    # 剧情研究(LLM)
│   ├── script.py      # 旁白剧本生成(LLM)
│   ├── tts.py         # 语音合成调度
│   ├── translate.py   # 多语言翻译(LLM)
│   ├── render.py      # MoviePy 2.x 视频渲染
│   └── errors.py      # StepAction / PipelineCancelled
├── tts/               # TTS 抽象层
│   ├── edge.py        # Edge TTS(免费)
│   ├── openai_provider.py  # OpenAI TTS
│   ├── mimo_provider.py    # MiMo TTS(声音克隆/设计)
│   └── factory.py     # Provider 工厂
├── web/               # Web UI(Gradio)
├── config.py          # 27 个配置字段 + 自动初始化
└── cli.py             # CLI 入口 + --retry 交互
流水线 14 步:
resolve_video → prepare_assets → research_plot → generate_script →
export_script_md → generate_voice → align_audio → detect_scenes →
match_clips → mix_bgm → translate_subtitles → generate_subtitle →
render_video → export_clips
七、开发心得
用 TRAE Work 从零开发这个项目最大的感受是:AI 不只是写代码,而是参与架构决策。
比如多语言字幕那一步,我先写了个方案文档,TRAE 读完打了 8.5 分,指出"magic number"和"反向配置默认值"两个问题,然后自己改进方案再实施。这不是简单的"你说我写",而是真正的技术协作。
再比如 Web UI 那一步,TRAE 提出分两步做(降低风险),我选择一次性做(图快),结果 19 分钟完成了 26 个文件的改动,测试全过。这种"AI 提建议、人做决策"的模式,比纯手动效率高了一个量级。
整个项目从第一行 pyproject.toml 到最终发布 v0.4.3,经历了 7 个主要开发阶段,每一步都是用 TRAE Work 完成的——从架构设计、代码编写、测试验证到文档同步,全流程 AI 驱动。