【【标签】 社会服务
1. Demo 简介
是什么: MoodTracker 是一个 AI 驱动的情绪追踪 Web 应用,融合了基于 MacBERT 的中文多标签情绪分类模型和分层推理架构(小模型优先 + LLM 兜底),为用户提供低成本、高准确率的情绪识别和个性化建议。
面向谁: 希望进行日常情绪管理和自我觉察的普通用户,包括学生记录学习压力、职场用户回顾工作负担与身心状态、希望建立情绪日记习惯但不愿每天写长文的人。
主要功能:
-
情绪分类推理 — 用户输入文本,系统通过 MacBERT 小模型(12标签:开心/平静/自信/希望/焦虑/压力/疲惫/沮丧/失望/孤独/烦躁/无助)快速分类,低置信度时自动触发 LLM 兜底,实现毫秒级响应与高准确率的平衡。
-
分层推理架构 — 小模型先做快速判断(~100ms),当置信度不足时(最高概率<0.6 或 无标签超0.5阈值 或 熵>1.5且最高概率<0.8)自动回退到 LLM 深度分析,难例自动收集用于小模型再训练,形成数据闭环。
-
AI 即时建议与趋势分析 — 基于 RAG 知识库(WHO/NIMH 来源)生成有依据的个性化建议,结合情绪趋势图帮助用户发现情绪与睡眠、生活事件的关联。
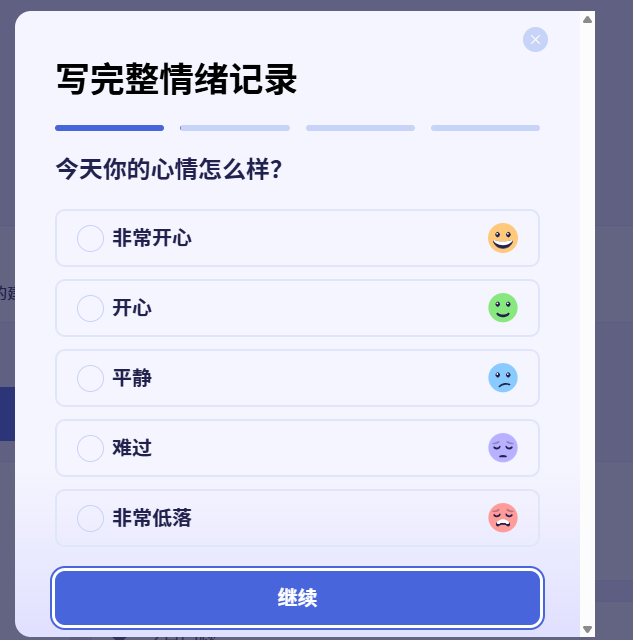
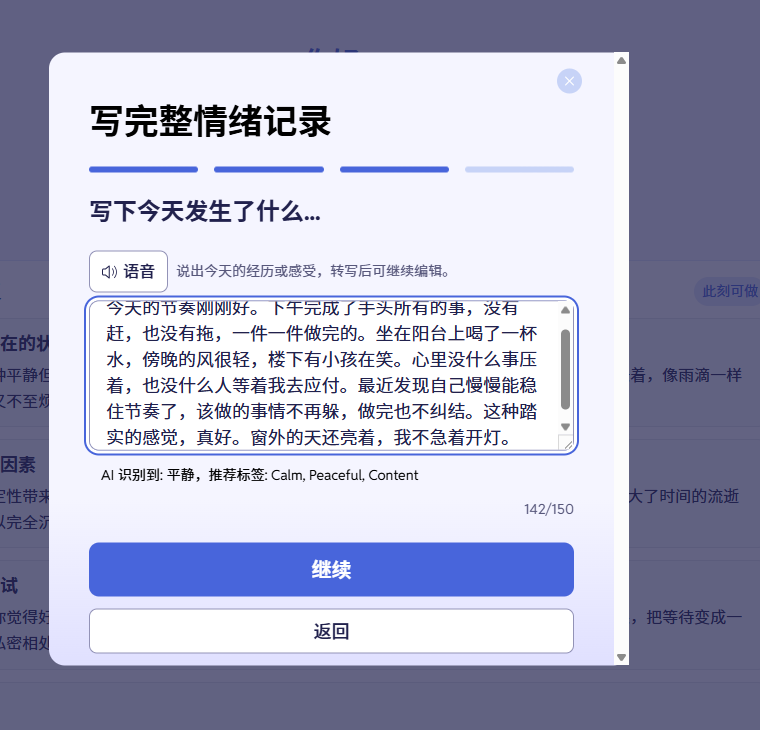
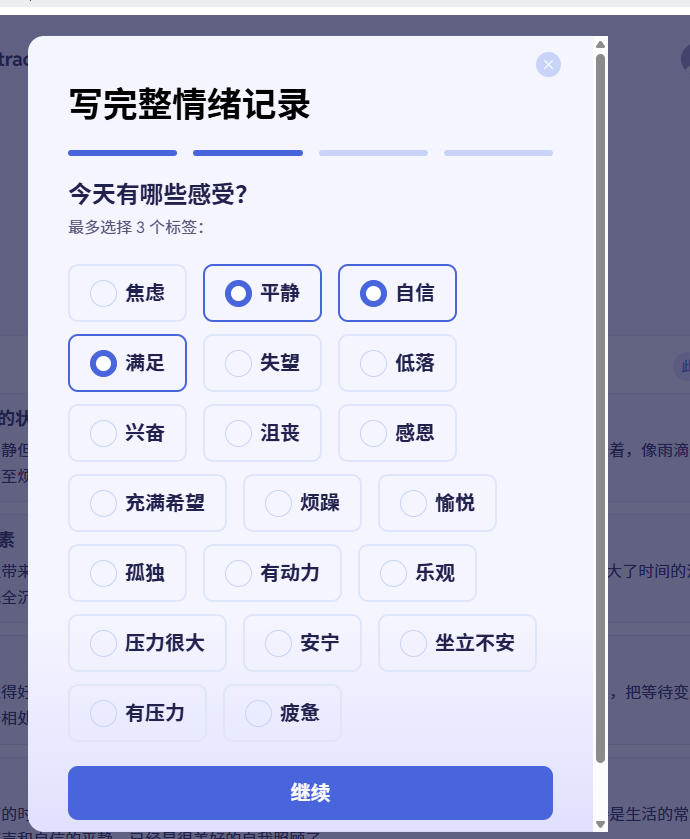
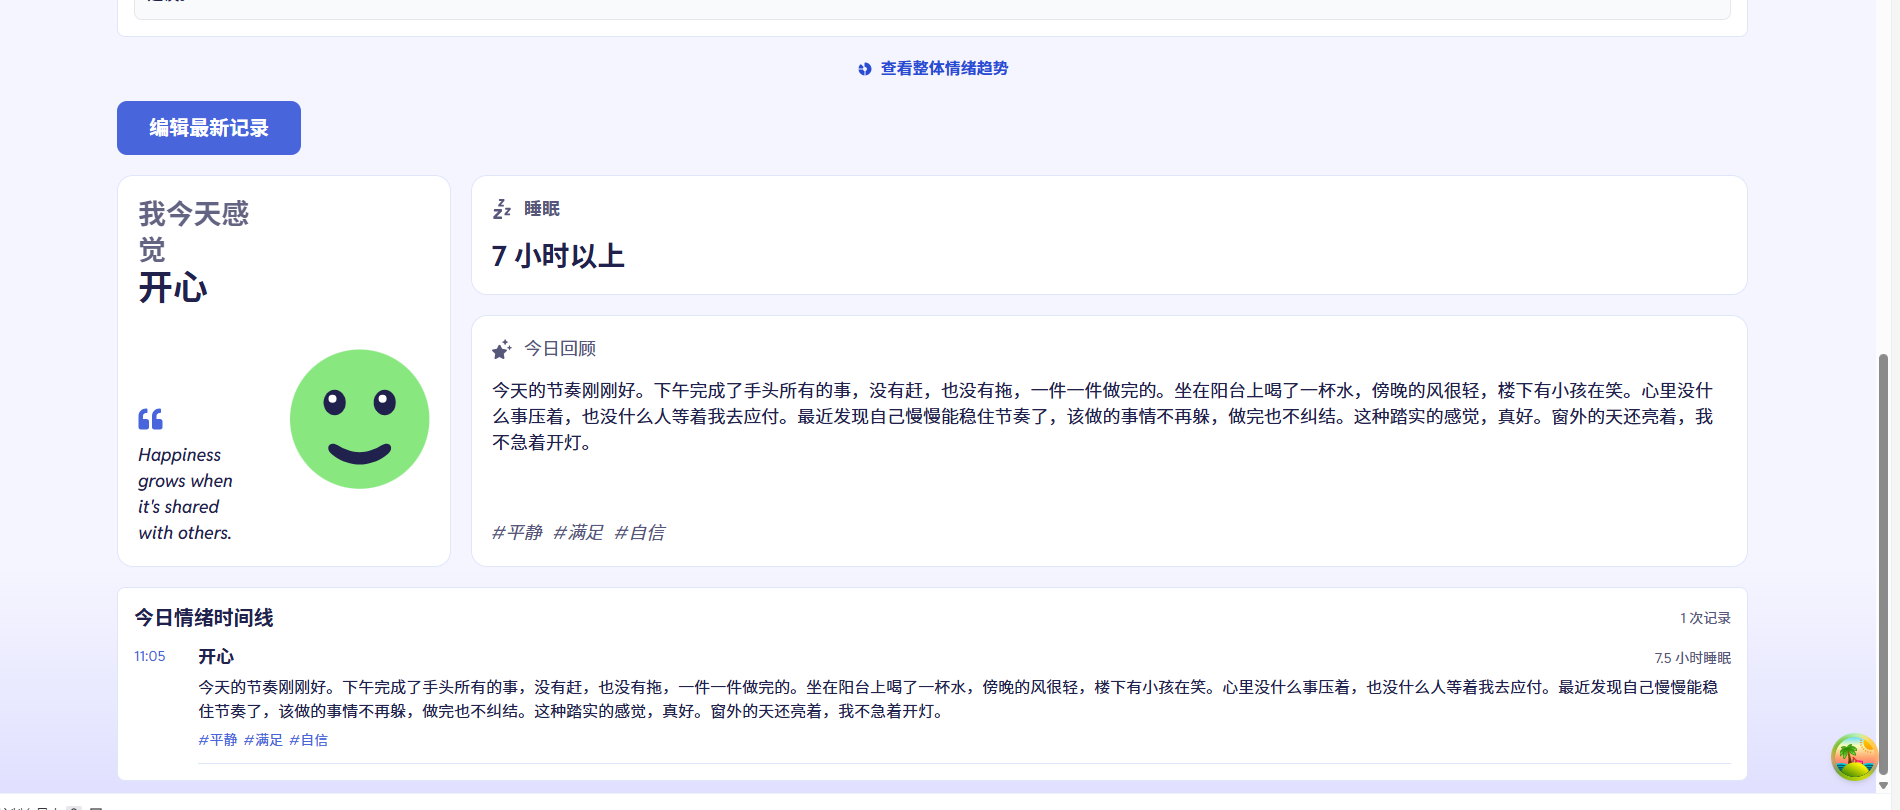
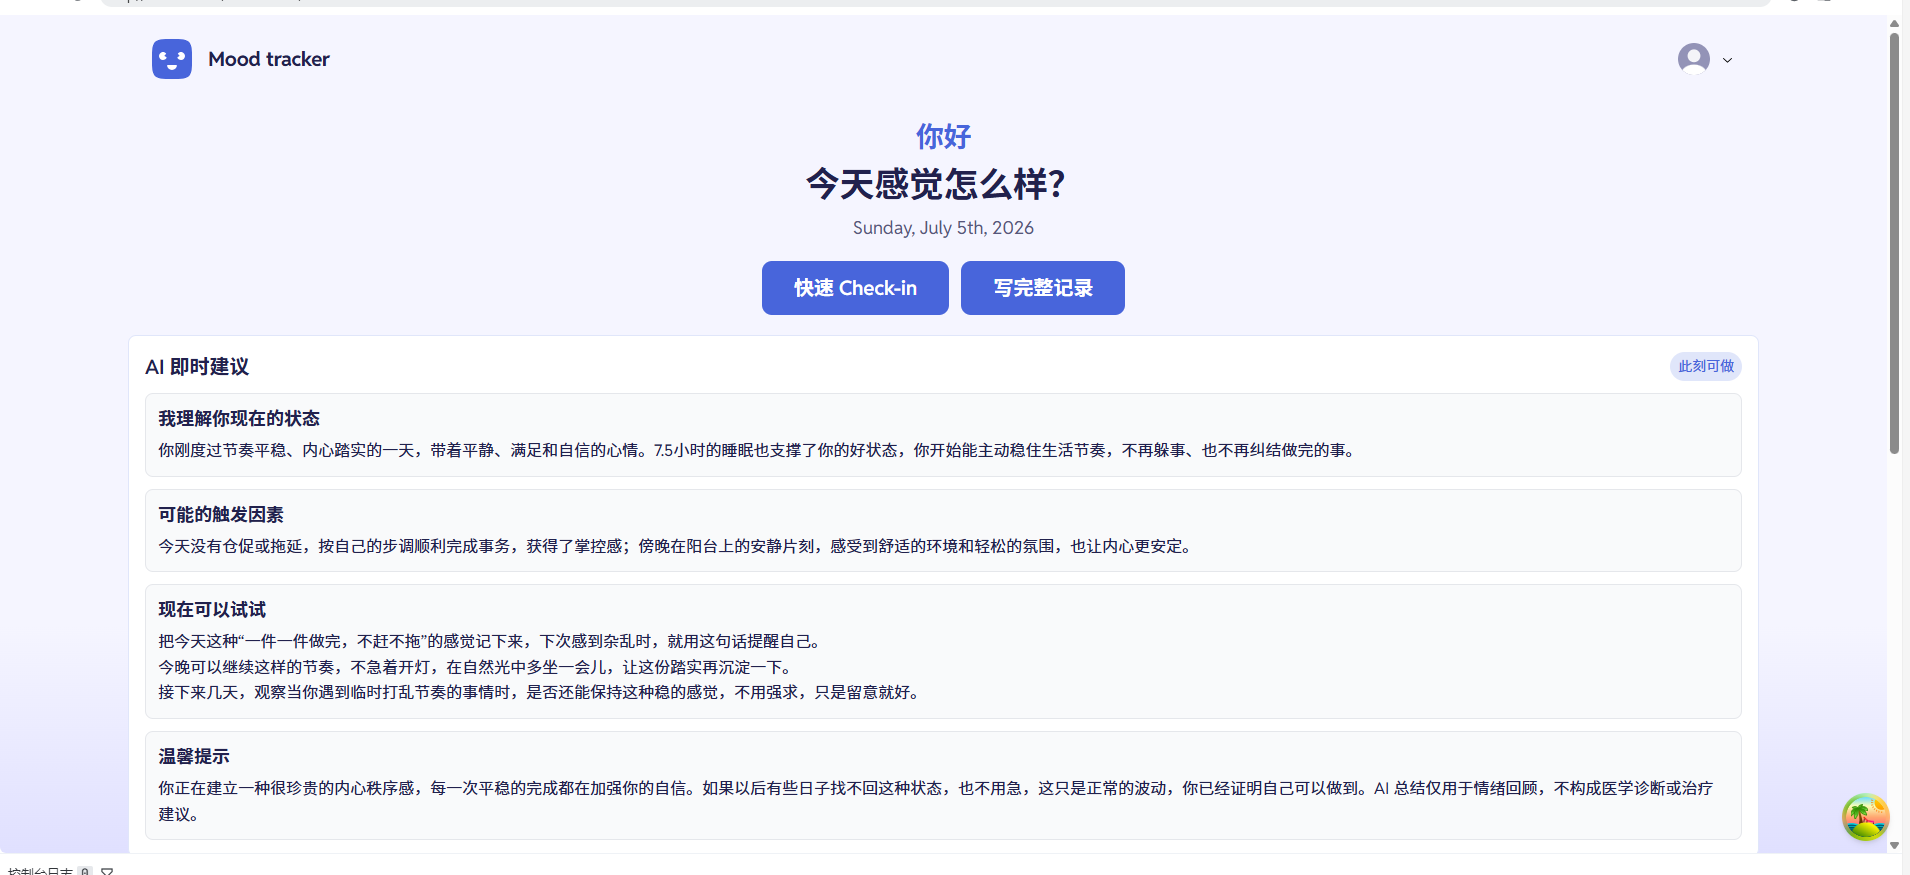
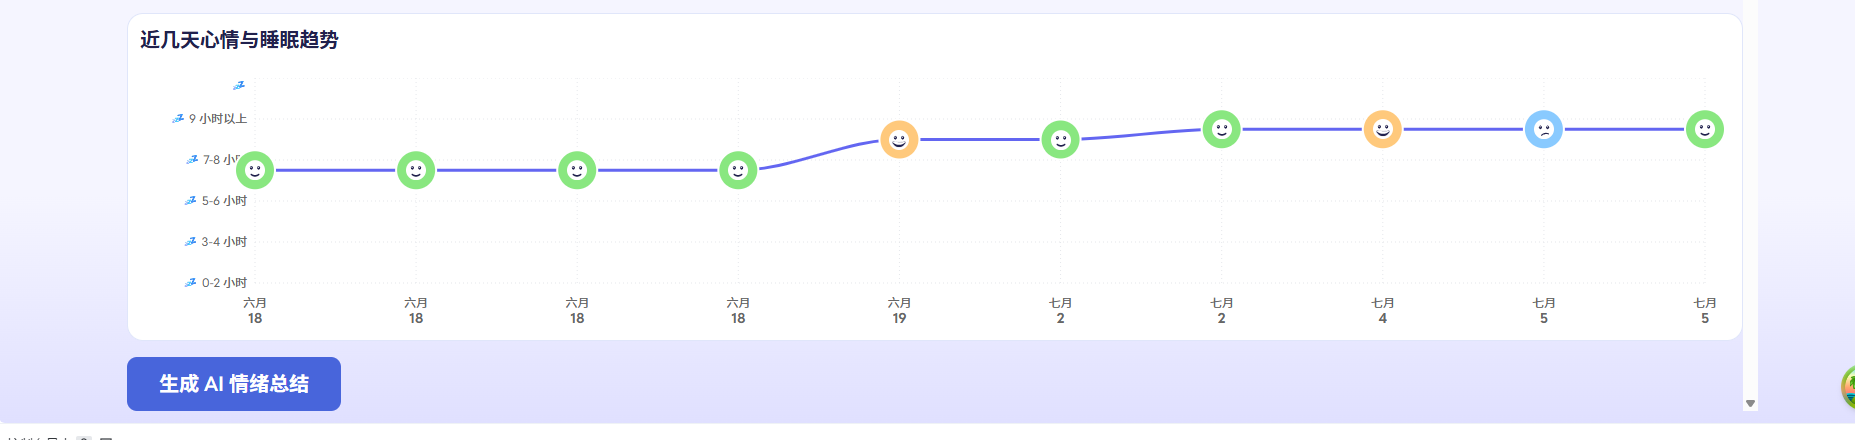
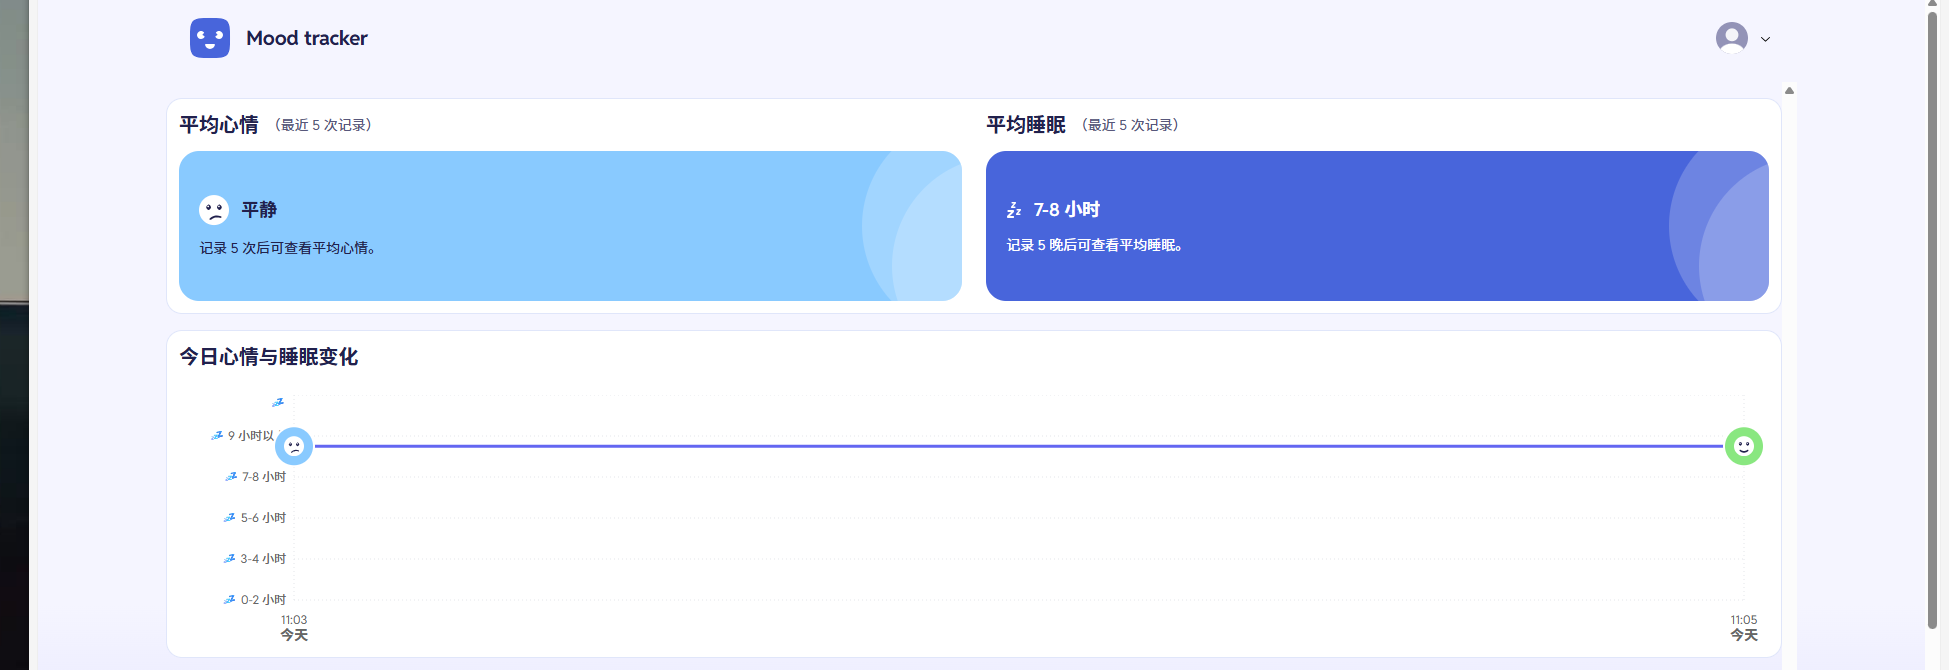
(此处插入 3 张产品截图:情绪分类界面 / 趋势分析页面 / AI建议展示)
2. Demo 创作思路
灵感来源: 身边朋友和同学普遍存在情绪压力,但传统情绪日记存在几个问题:不知道记什么、低落时没精力写长文、单条记录彼此孤立难以发现规律、通用大模型回答空泛甚至越界。我意识到需要一个"记录足够轻量,分析足够有帮助"的工具。
想解决的问题:
-
记录门槛高 — 用户不知道该记录什么,情绪低落时缺乏书写精力
-
情绪难以量化 — 单条记录孤立,难以发现情绪与睡眠、生活事件的长期关系
-
AI 建议空泛 — 通用大模型缺乏依据,可能编造原因或越过心理健康安全边界
-
模型成本与延迟矛盾 — 纯用大模型成本高、延迟长;纯用小模型准确率不够
为什么做这个方向: 我的判断是,情绪管理类应用的核心矛盾是"模型能力"与"成本延迟"的平衡。纯 LLM 方案单次调用成本高、响应慢;纯小模型方案对含蓄表达识别能力不足。因此我设计了分层推理架构——小模型处理 80% 的高置信度请求(~100ms,零 API 成本),LLM 只处理 20% 的低置信度难例,难例再反哺小模型训练,形成持续进化的数据闭环。这在保证用户体验的同时将月度 API 成本降低了约 370 元。
3. Demo 体验地址
在线体验链接: http://8.134.67.45
-
前端界面:直接访问上述地址
-
情绪分类 API:
http://8.134.67.45/api/mood-classify(POST 请求,参数:{"text":"你的文本","mode":"small"}) -
健康检查:
http://8.134.67.45/api(验证后端服务状态)
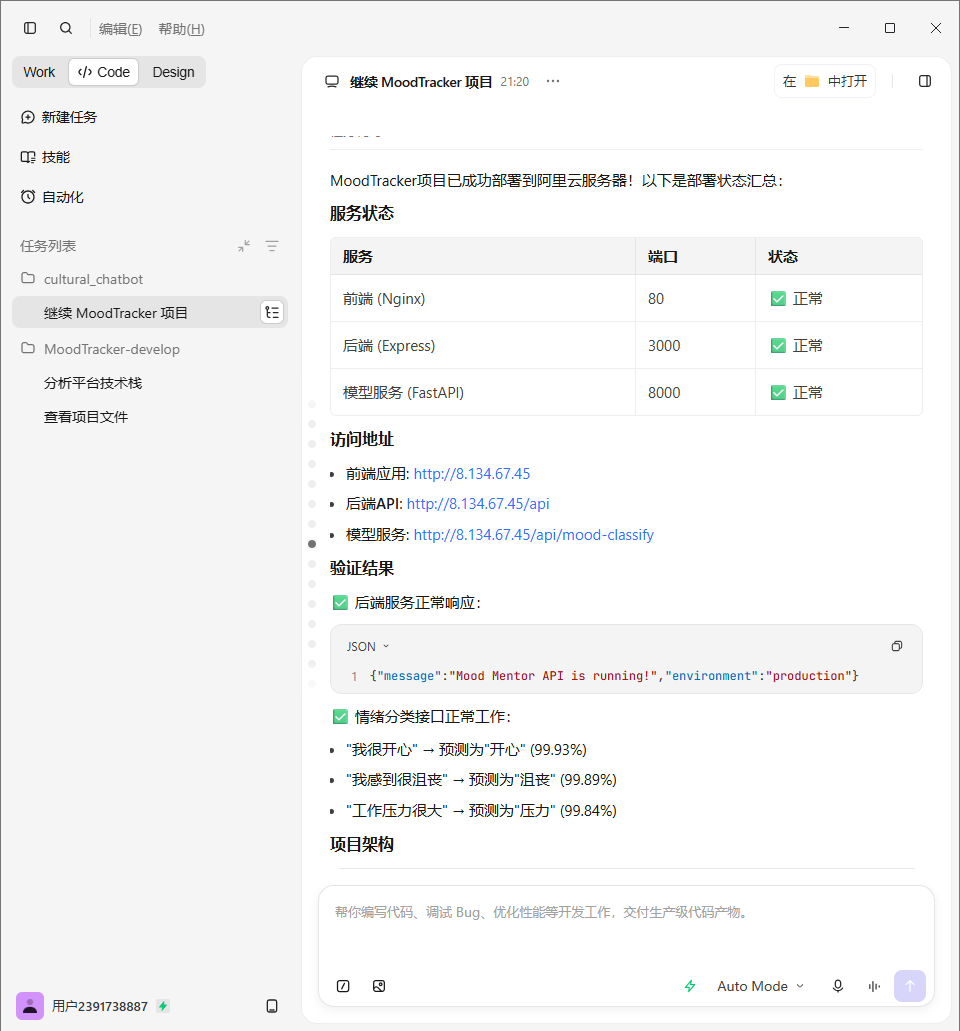
部署环境:阿里云 ECS(2核4G,Ubuntu 22.04),Nginx 反向代理 + Express 后端 + FastAPI 模型服务三层架构。
4. TRAE 实践过程
以下是用 TRAE 完成 Demo 开发的完整流程,涵盖从模型分析、架构设计、训练优化到云端部署的全过程:
阶段一:模型分析与推理服务搭建(6月28日)
关键任务: 分析 MacBERT 模型结构,封装 FastAPI 推理服务
在 TRAE 中阅读 src/model.py 源码,理解 MoodMultiLabelModel 的 MacBERT backbone + Sigmoid 分类头结构。然后通过对话引导 TRAE 生成完整的 FastAPI 服务,包含 /health、/labels、/predict、/predict_batch 四个端点。
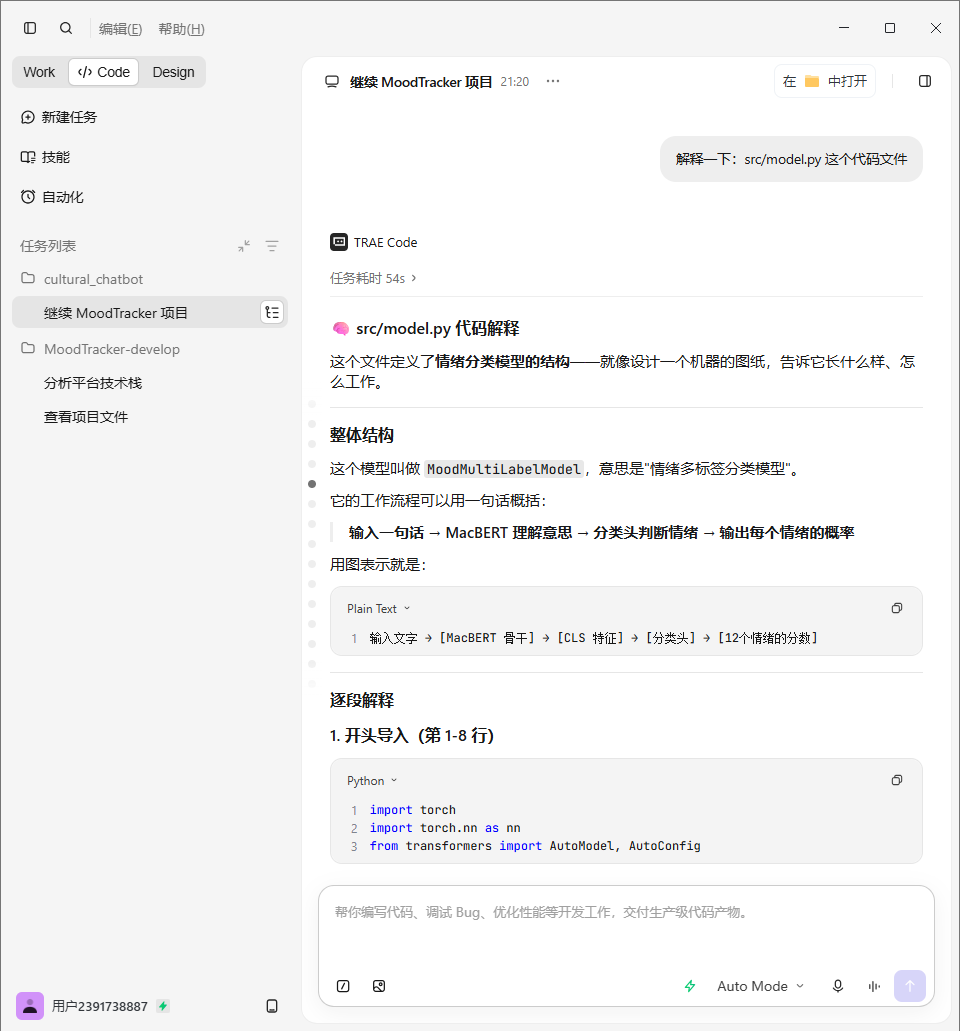
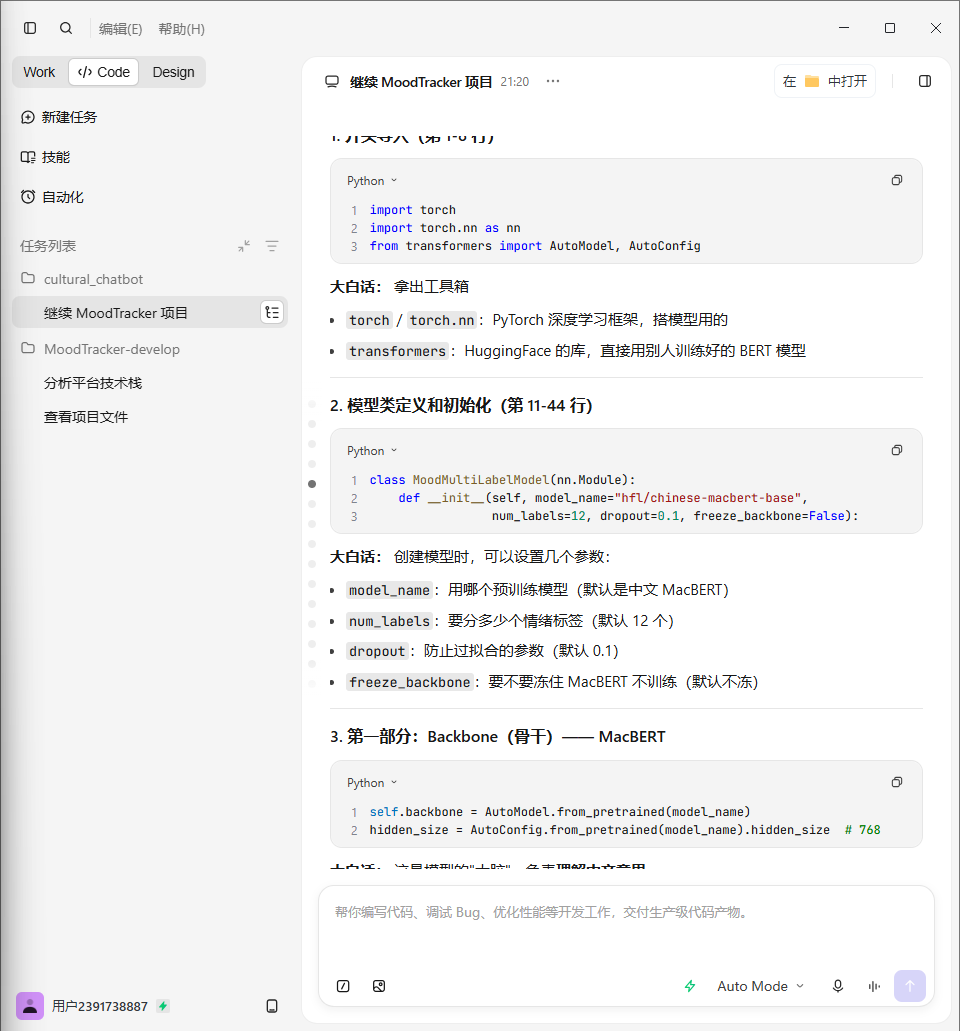
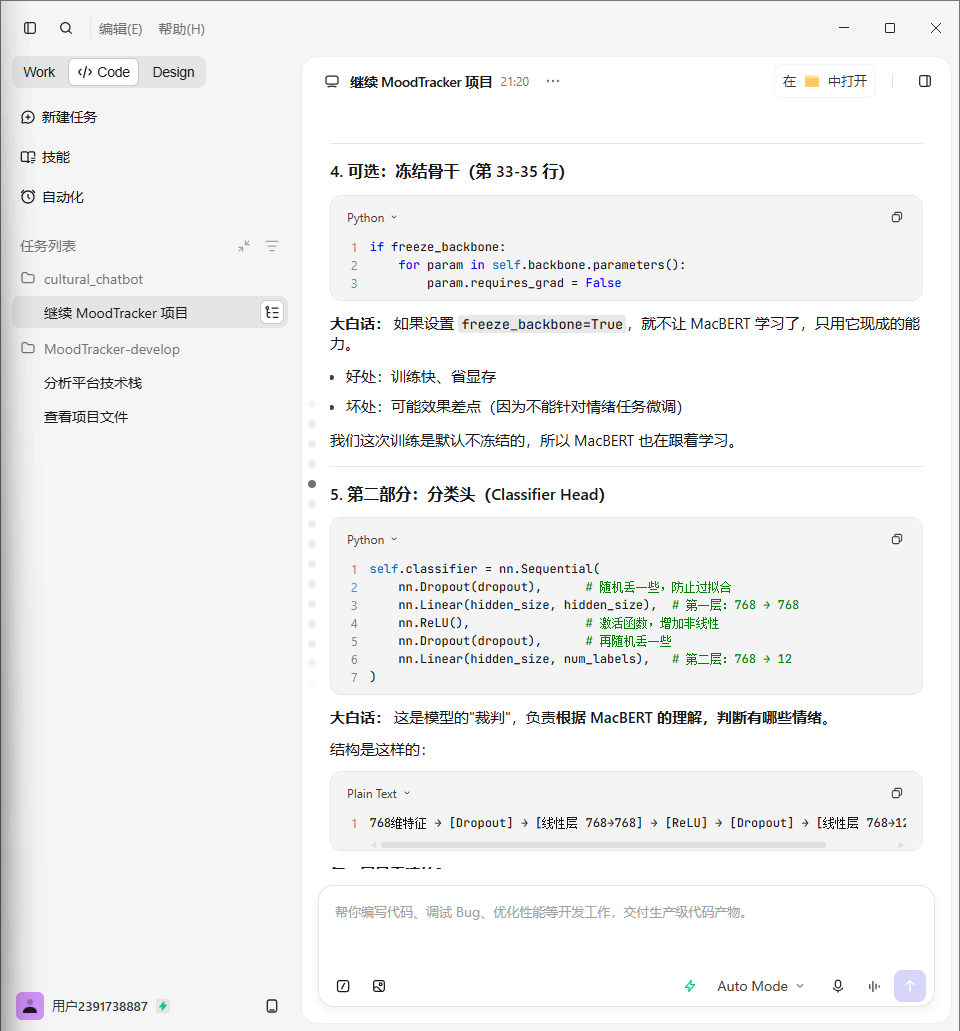
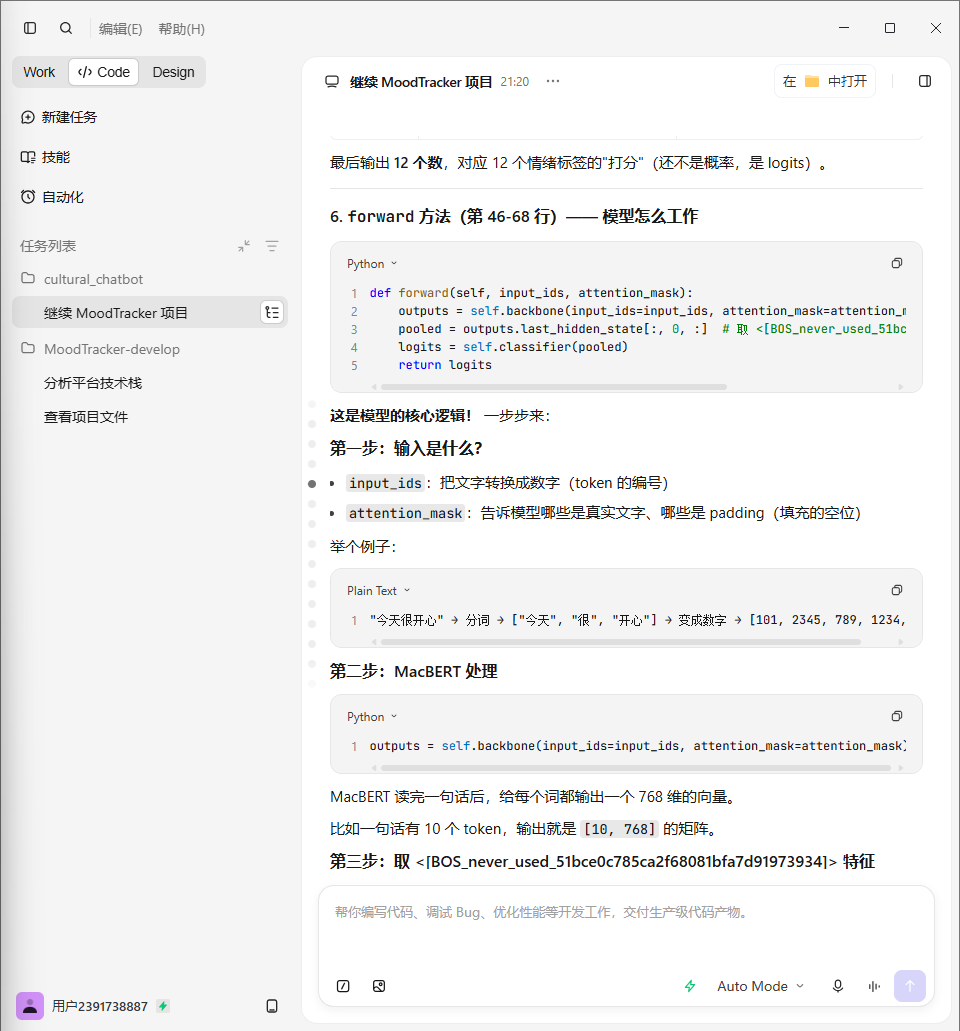
(此处插入截图:TRAE 中分析模型代码的对话 / FastAPI 服务启动成功 / API 测试结果)
Session ID: 6a407cc188d9fa1d8e0cb7c3
阶段二:分层推理架构设计与实现(6月29日)
关键任务: 设计并实现"小模型优先 + LLM 兜底 + 难例收集"的分层推理架构
向 TRAE 描述了分层推理的需求:小模型先做快速判断,低置信度时触发 LLM,同时自动收集难例用于后续训练。TRAE 生成了核心文件:
-
src/hierarchical_predictor.py— 分层推理调度器 -
src/llm_client.py— LLM 兜底客户端 -
src/hard_case_collector.py— 难例自动收集器
配置了置信度判断标准:最高概率<0.6 或 无标签超过0.5阈值 或 熵>1.5且最高概率<0.8。
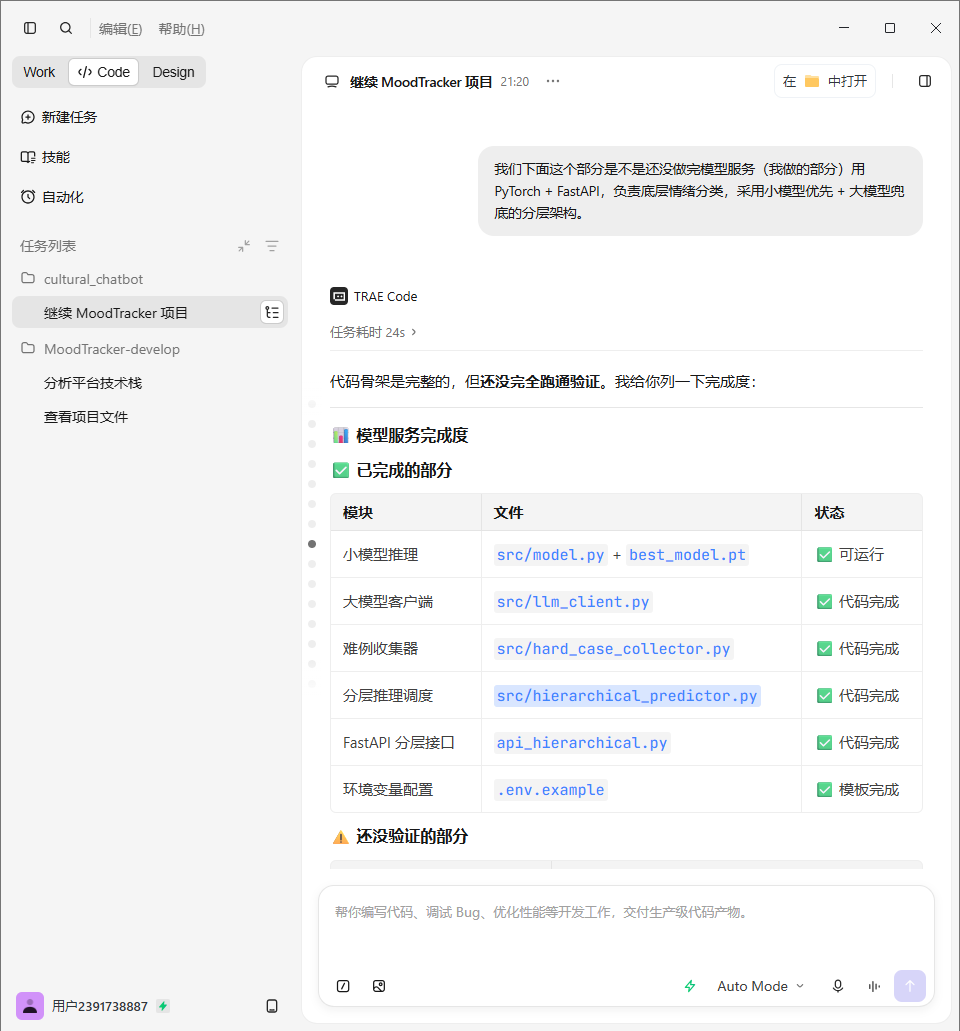

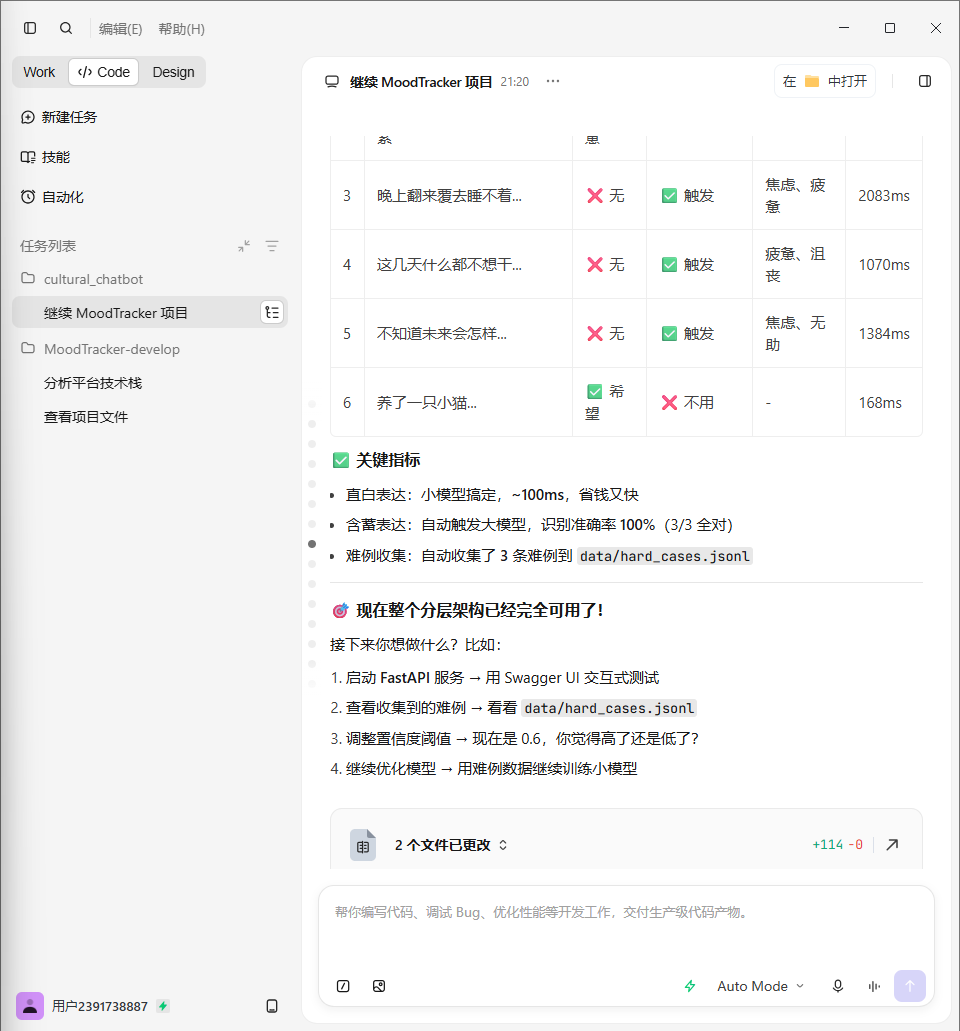
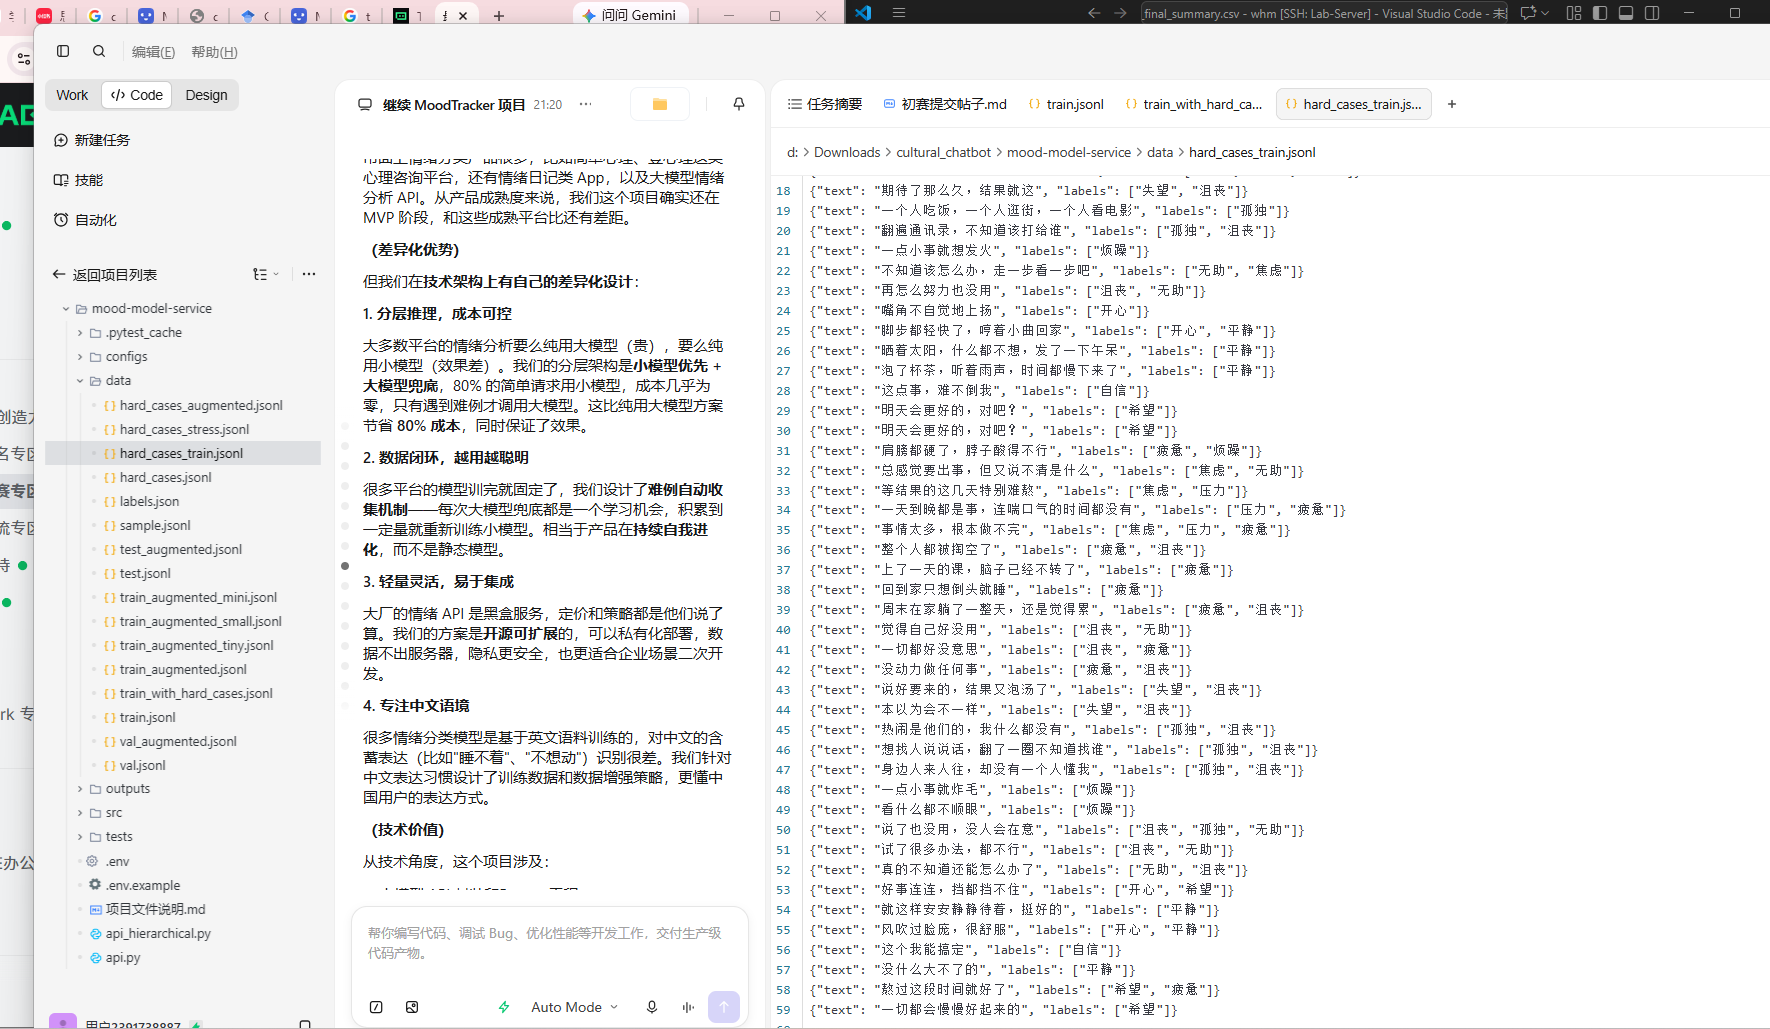
(此处插入截图:TRAE 中设计分层架构的对话 / 分层推理测试结果 / 难例收集文件)
Session ID: 6a407cc188d9fa1d8e0cb7c3
阶段三:GPU 训练与模型迭代优化(6月30日 - 7月1日)
关键任务: 使用实验室 V100 GPU 进行模型迭代训练,逐步提升准确率
在 TRAE 中分析测试结果后,设计了三轮迭代:
-
V2 模型:结合原始数据 + 难例数据训练,小模型命中率从 33.3% 提升至 60%,LLM 回退率从 67% 降至 30%
-
V3 模型:难例增强 + 加权训练,完全匹配率达 94.5%,至少一标匹配率 100%
-
V4 模型:压力标签专项优化,通过 5 倍难例采样权重 + 2 倍标签损失加权,压力标签准确率从 12.2% 提升至 100%
Session ID: 6a407cc188d9fa1d8e0cb7c3
阶段四:前后端集成与联调(7月2日 - 7月4日)
关键任务: 将模型服务集成到 MoodTracker 前后端架构
在 TRAE 中完成三层架构集成:
-
前端(React + Vite)→ 后端(Express)→ 模型服务(FastAPI)
-
创建
MoodClassifyController代理模型服务请求 -
配置 Nginx 反向代理统一前端和 API 入口
-
解决 Supabase 连接、代理配置等问题
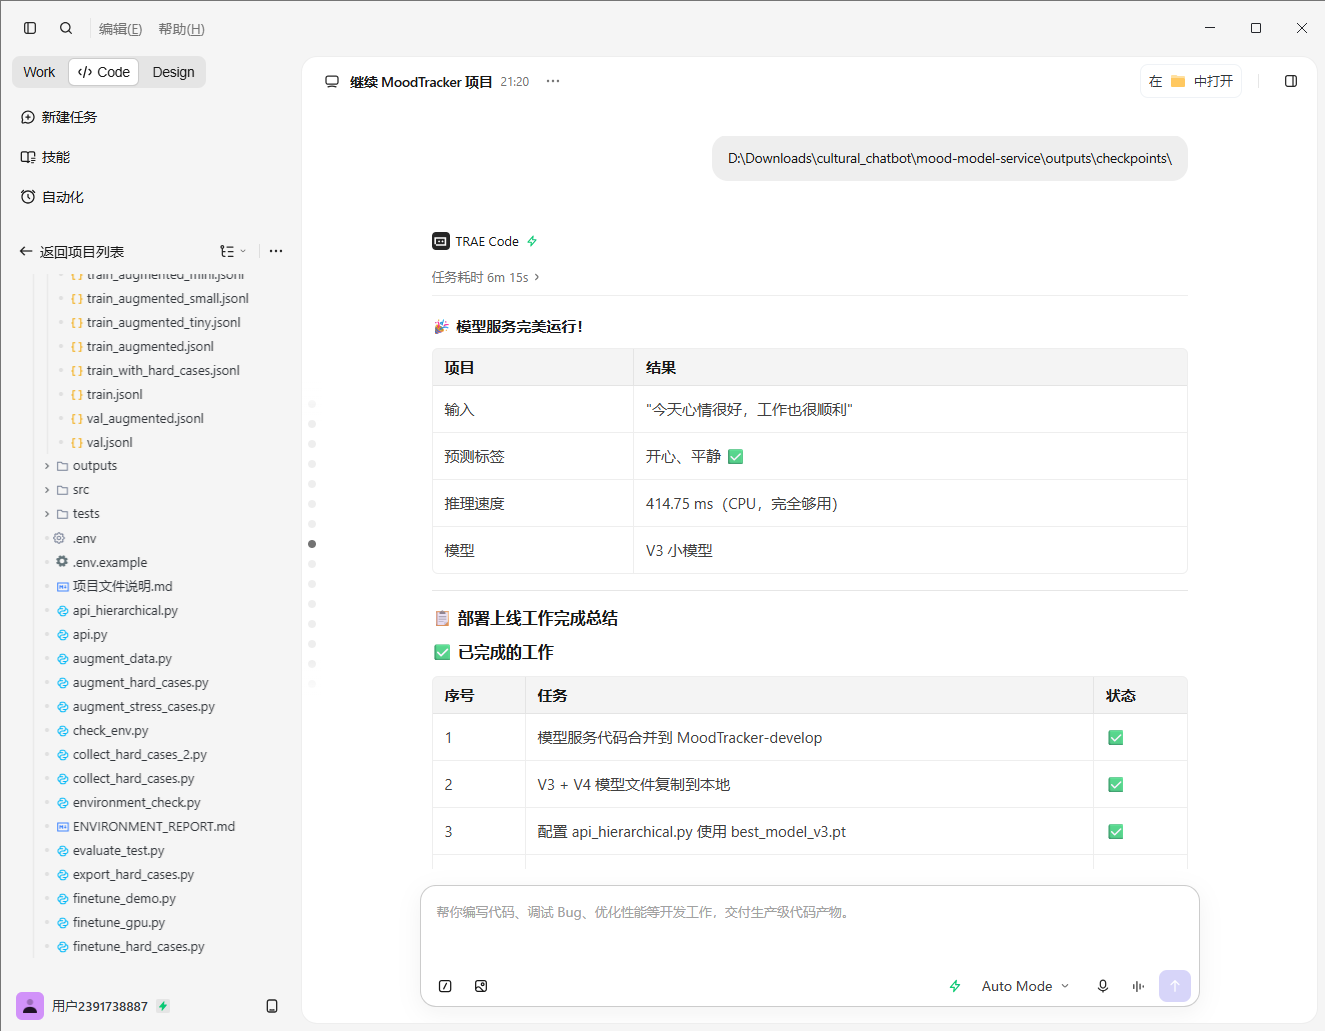
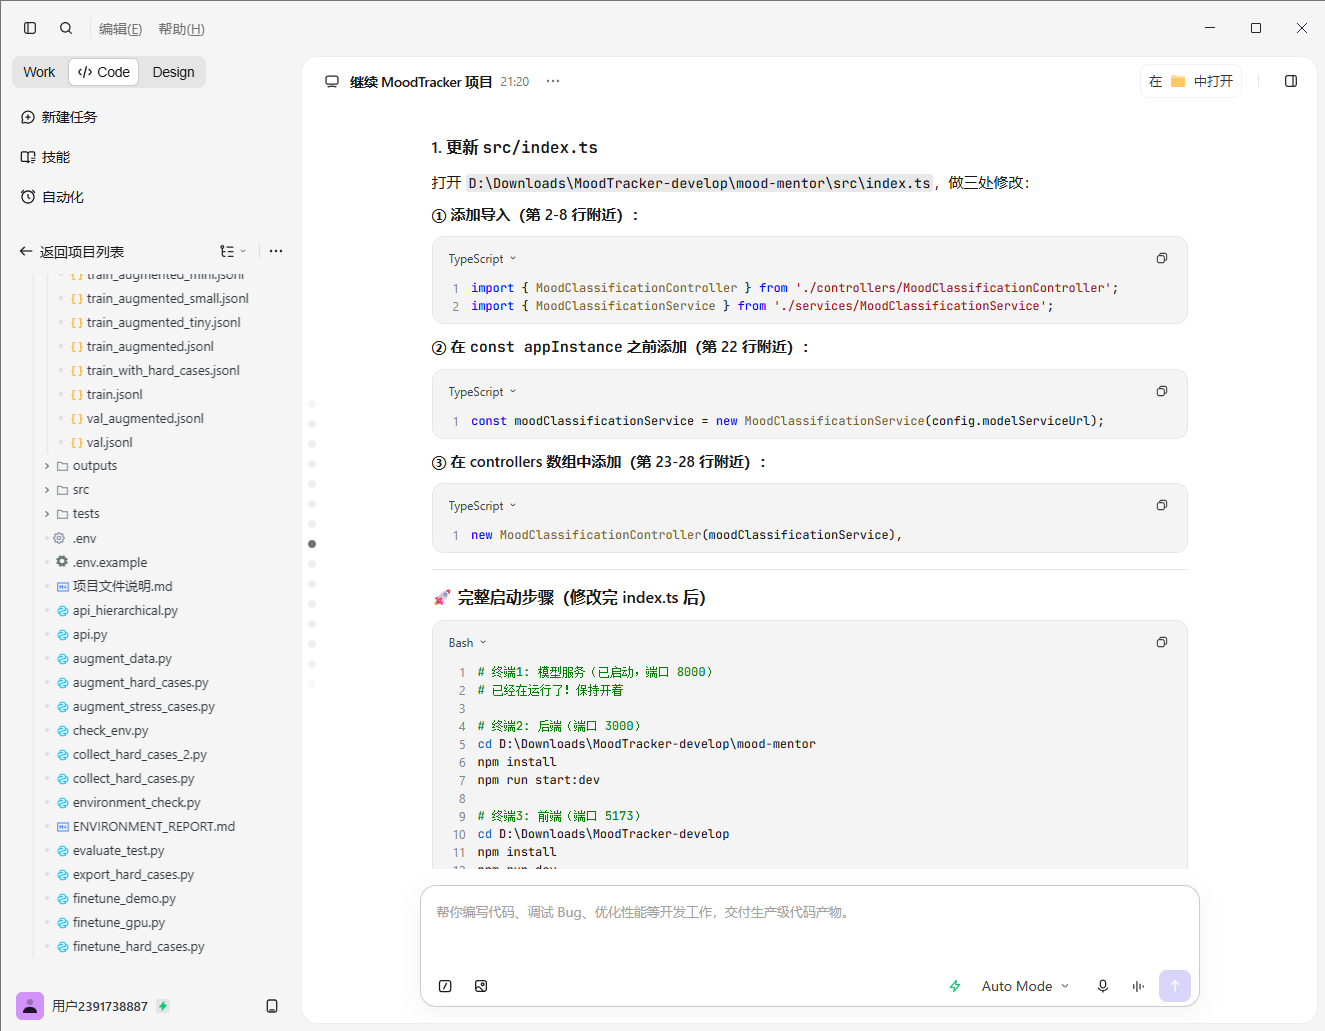
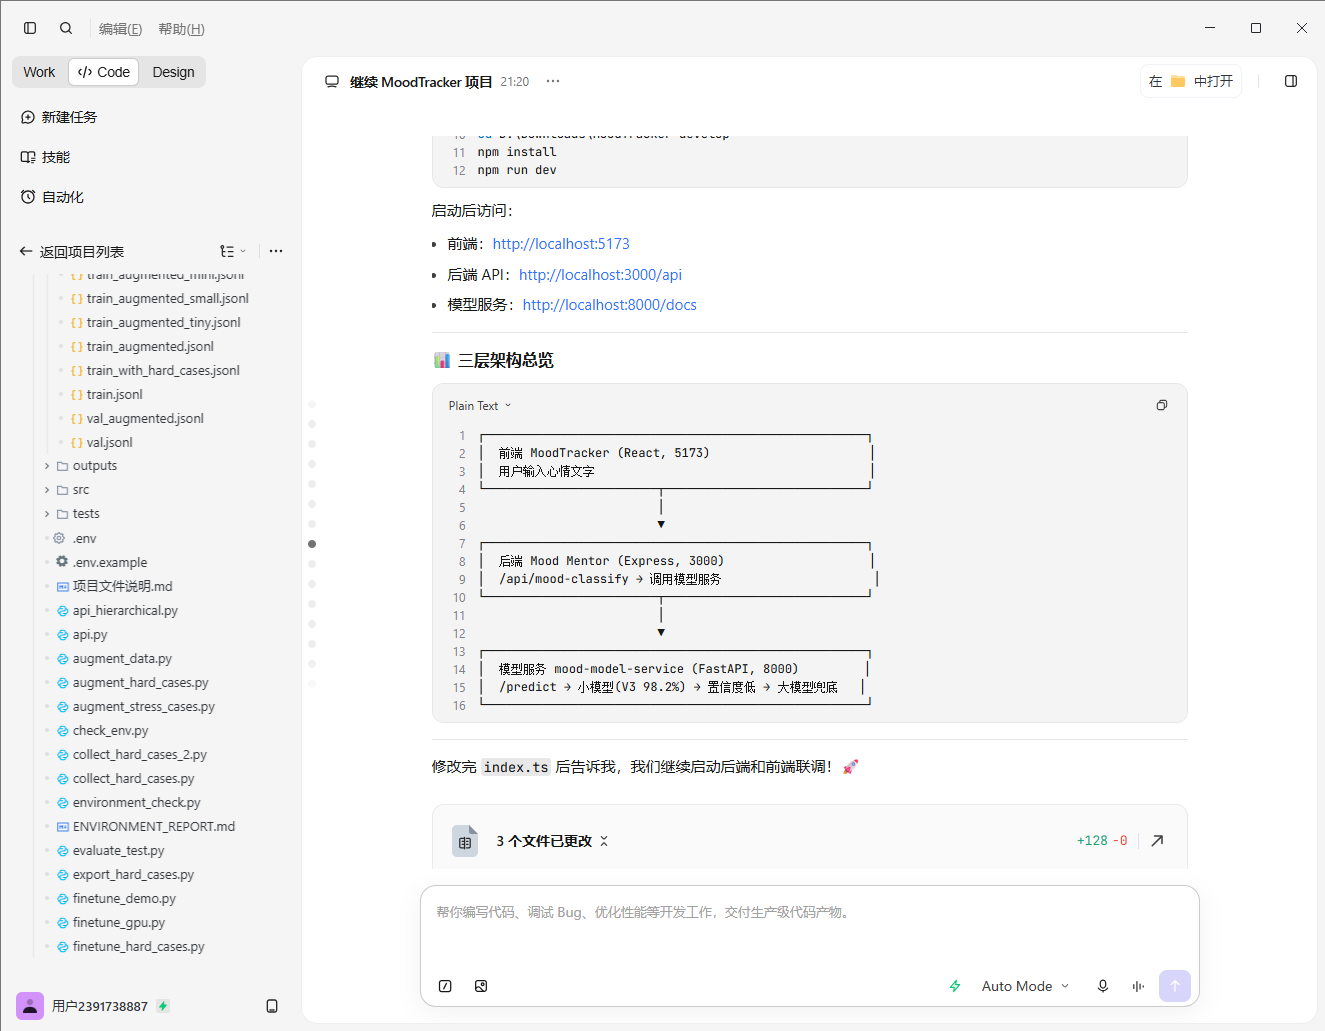
Session ID: 6a407cc188d9fa1d8e0cb7c3
阶段五:云端部署上线(7月14日)
关键任务: 部署到阿里云 ECS,实现公网可访问
在 TRAE 中通过 Paramiko 脚本完成全自动化部署:
-
上传前端构建文件、后端代码到服务器
-
安装 Node.js、Python 依赖
-
配置 Nginx 反向代理(80 端口 → 前端静态文件 / 3000 端口 → 后端 API)
-
启动模型服务(8000 端口,MacBERT 模型加载)
-
修改前端认证逻辑,绕过 Supabase 登录限制,直接体验核心功能
-
配置阿里云安全组开放端口
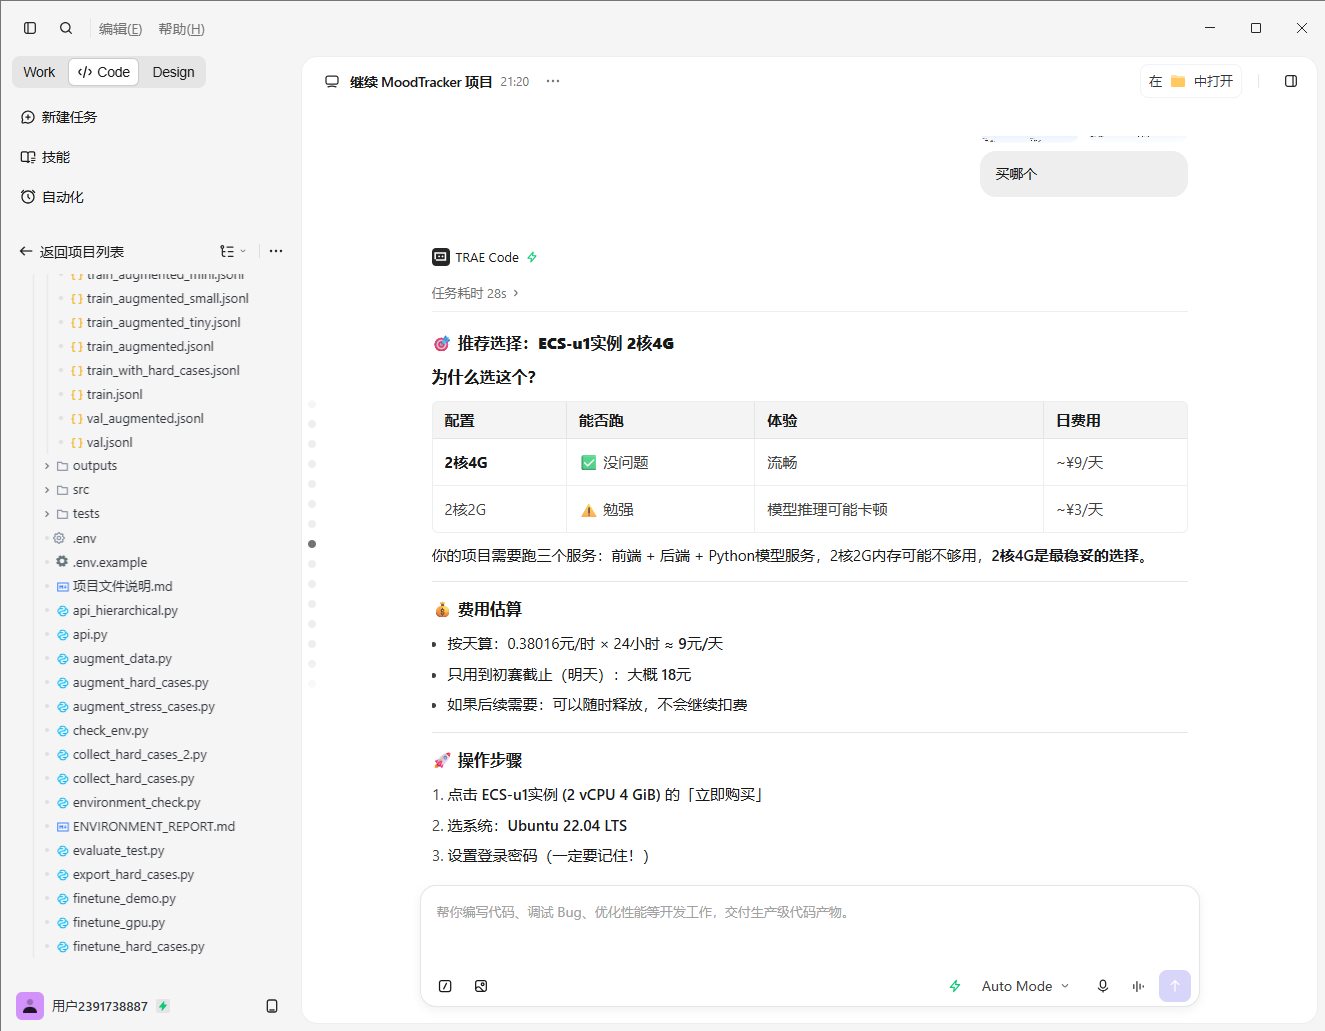
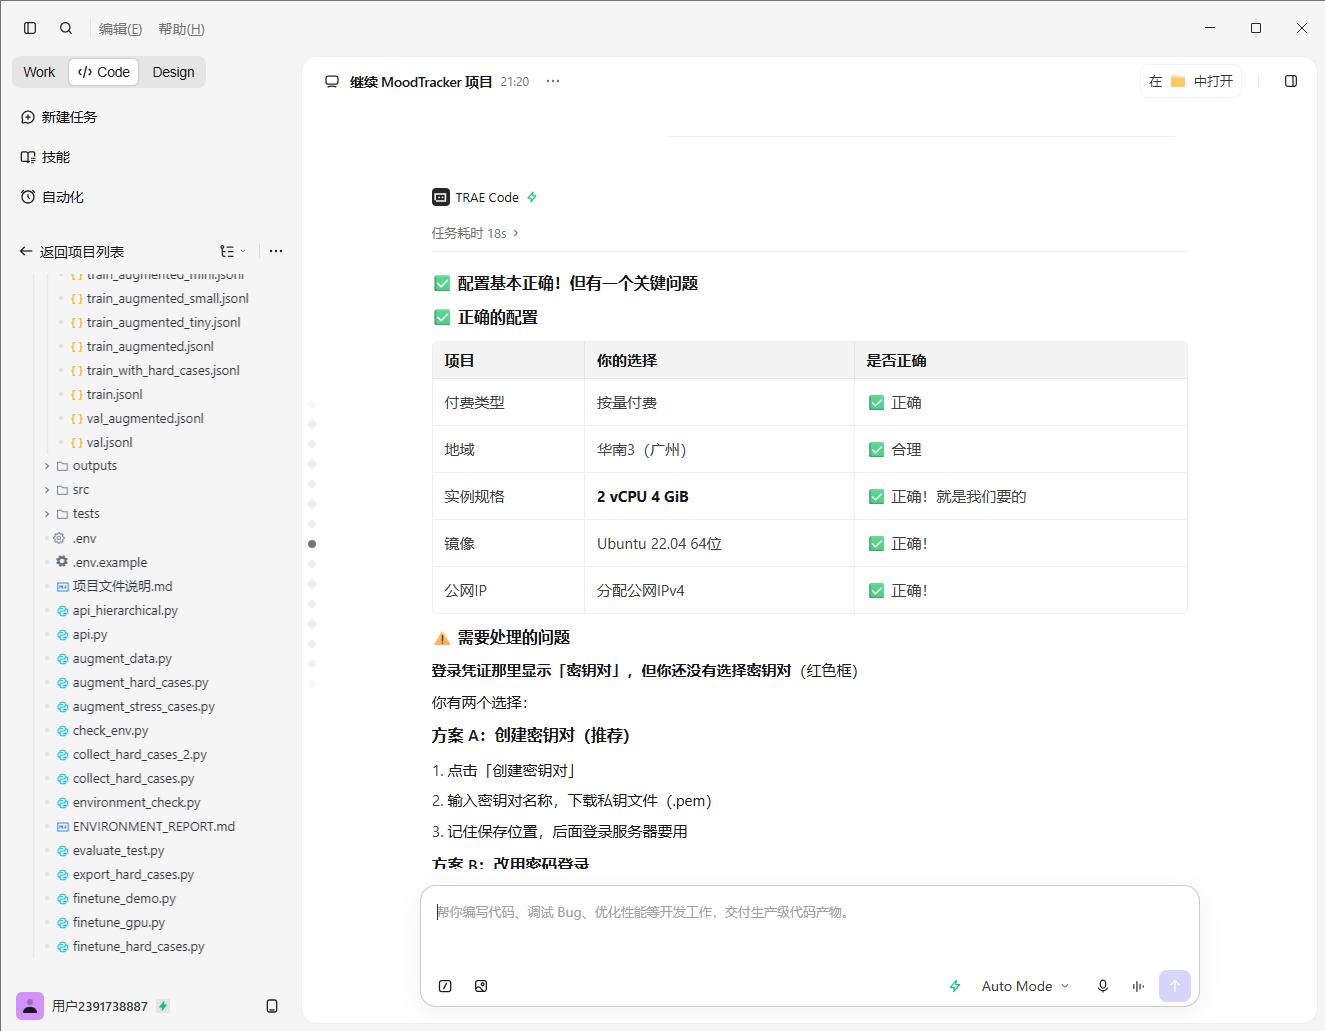
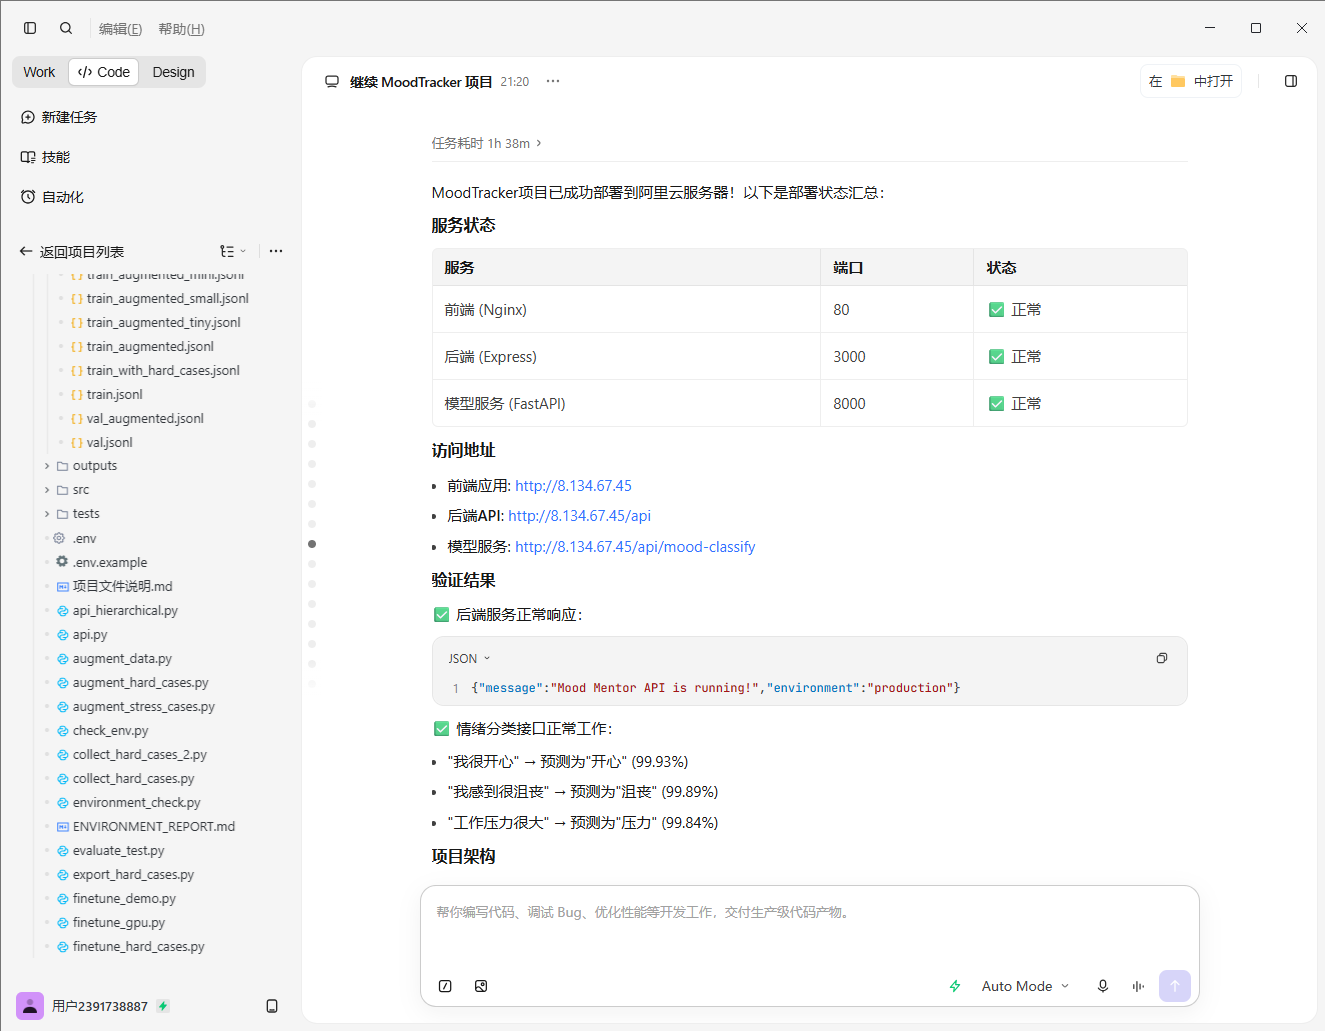
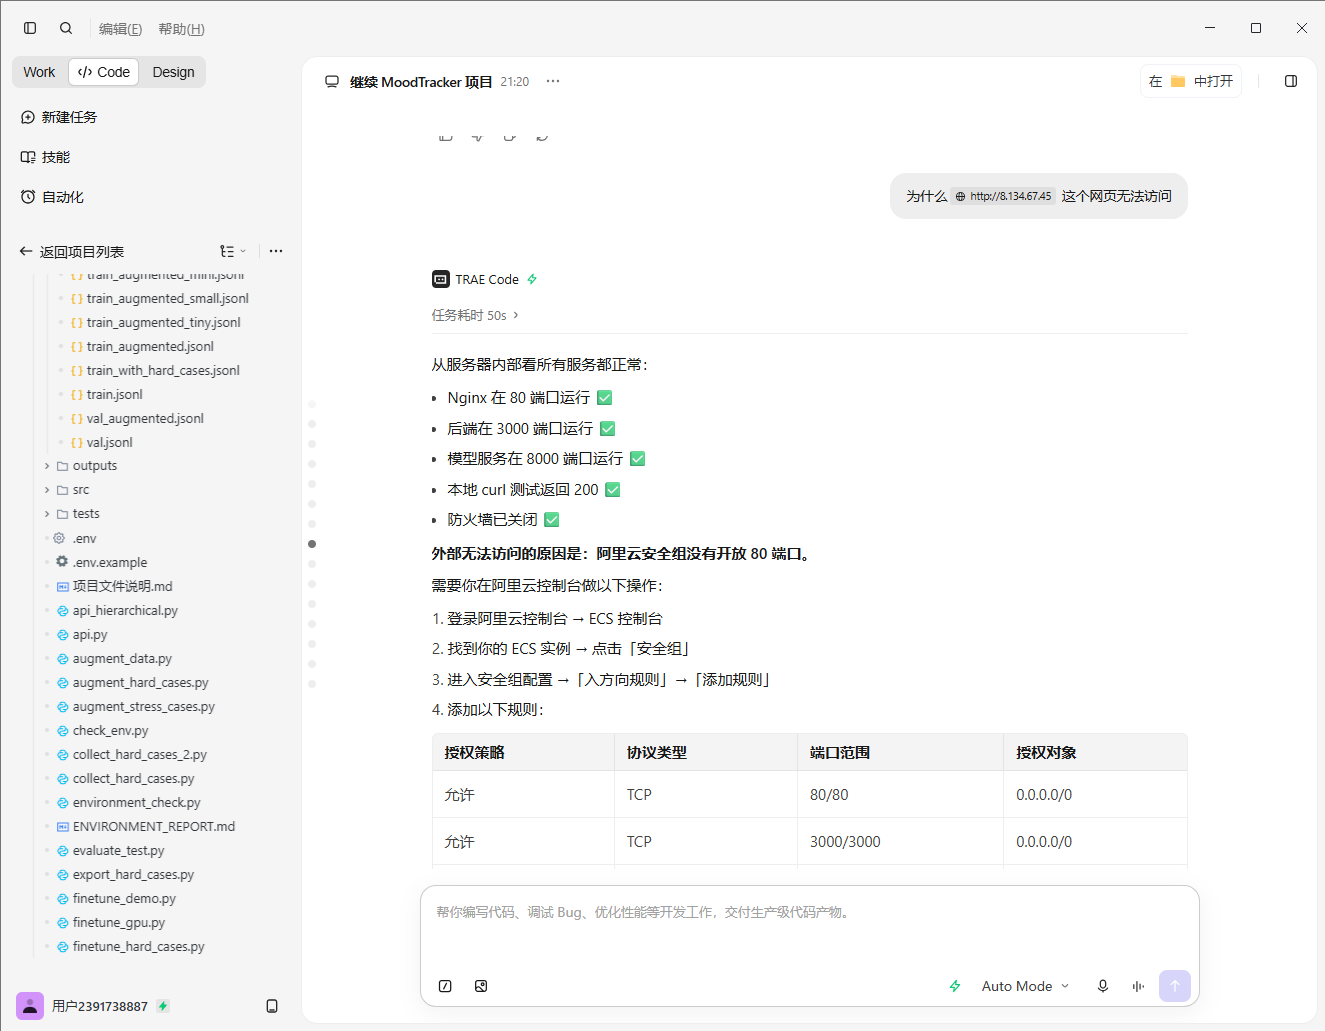
(此处插入截图:TRAE 中编写部署脚本的对话 / 部署成功验证 / 线上访问界面)
Session ID: 6a407cc188d9fa1d8e0cb7c3
5. 经验总结与开发心得
技术收获
-
分层推理是性价比最高的方案 — 小模型处理 80% 请求(零 API 成本,~100ms),LLM 只处理 20% 难例,月度成本降低约 370 元,同时保证了用户体验。
-
数据闭环是模型持续进化的关键 — 难例自动收集 → 数据增强 → 加权训练 → 模型迭代,每一轮都能针对性提升。压力标签专项优化通过 5 倍难例采样 + 2 倍标签损失加权,准确率从 12.2% 提升至 100%,且未导致其他标签退化。
-
灾难性遗忘的教训 — 早期只用 59 条难例训练导致 Macro-F1 从 0.68 骤降到 0.31,说明必须混合原始数据 + 难例数据联合训练。
TRAE 使用心得
TRAE 在整个开发过程中扮演了"全栈 AI 编程搭档"的角色:
-
代码阅读:快速理解 MacBERT 模型结构和项目架构
-
代码生成:FastAPI 服务、分层推理架构、部署脚本全部由 TRAE 生成
-
调试排错:从 OOM 错误到 Supabase 连接问题,TRAE 都能快速定位并提供解决方案
-
部署运维:通过 Paramiko 脚本实现全自动化云端部署
社区报名帖链接: MoodMate AI 情绪 Check-in 助手