【学习工作赛道】聪明钱动线追踪器:非金融散户的每日复盘助手
标签:
学习工作报名帖链接:【报名】非金融小白的"聪明钱"追踪器
一、Demo 简介
是什么
每天下午 3 点收盘后,无数散户打开股票软件,面对红绿数字发呆:今天大盘怎么样?哪些板块有资金在流入?我的持仓该走该留?
我就是其中之一。非金融专业,白天上班,只有晚上有时间研究。打开各种数据平台,大盘指数、北向资金、融资融券、板块资金流向……数据倒是一大堆,但全部分散在十几个页面里,每个数字看着都挺重要,放在一起却完全不知道该先看什么、怎么判断、得出什么结论。 所以我用 TRAE 做了一个"5 分钟出报告"的方案——自动拉数据、做分析、生成 HTML 报告,打开浏览器就知道今天市场发生了什么。包含一份**《每日复盘 SOP》和一个Python 自动化脚本**,每日收盘后运行 5 分钟,自动输出大盘情绪诊断 + 主线板块定位 + 个股候选池,并生成可视化 HTML 报告。
不是帮你选股,是帮你建立数据化投资思维——从抄博主作业,到自己看懂资金流向。
面向谁
- 非金融专业的散户投资者(程序员、设计师、产品经理等)
- 对技术面和资金面感兴趣,但缺乏系统方法论的新手
- 白天上班、晚上才有时间看盘的理财人
核心功能
功能 1:一键获取多源资金数据
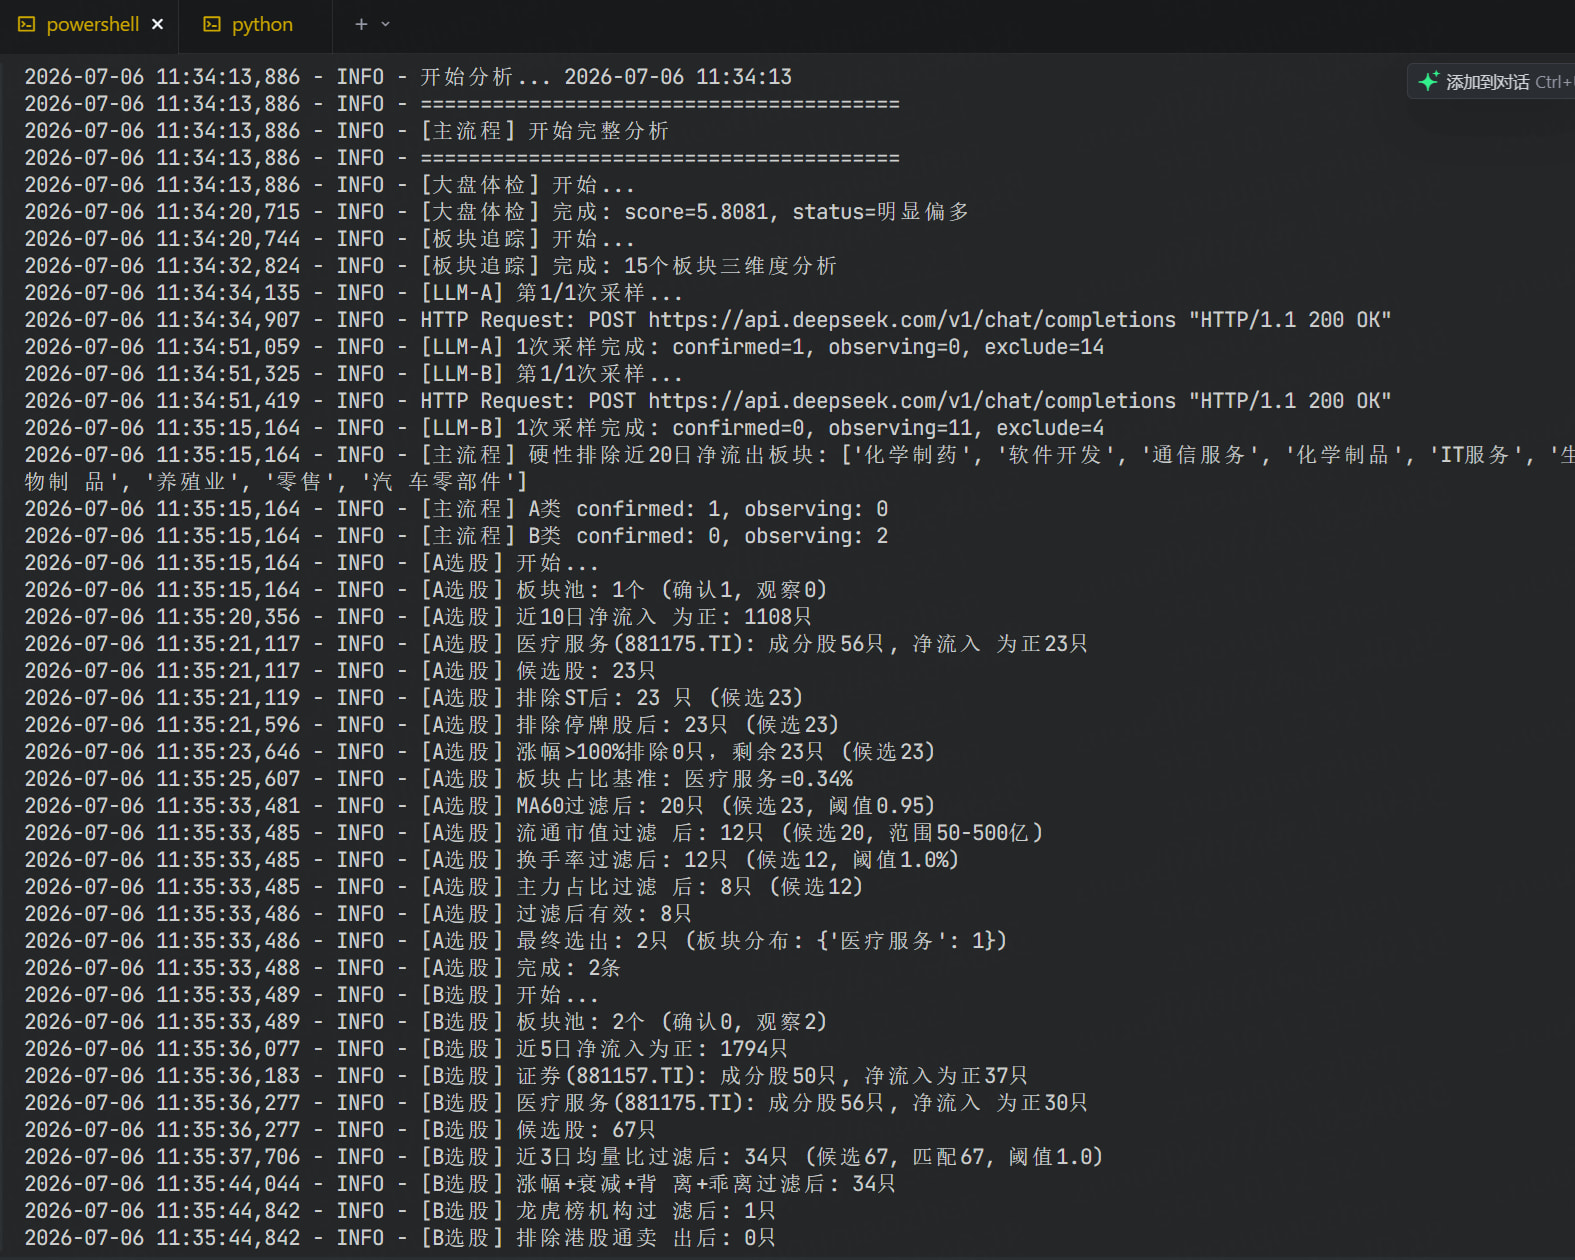
自动从 Tushare 拉取大盘指数、板块资金、个股行情、融资融券、北向资金等多维度数据,解决"数据分散在十几个接口"的痛点。运行脚本后,终端输出数据获取日志:
功能 2:三层漏斗分析
从"面"到"点"层层过滤,避免盲目选股:
- 第一层 · 大盘情绪诊断:选取 11 个指标(上证主力净流入、涨跌幅、融资融券余额、北向资金、汇率等),先做双窗口标准化(20 日短期 + 60 日长期取均值,兼顾短期波动和长期趋势),再做 StandardScaler 标准化,最后用 PCA 降维到主成分,输出一个综合情绪得分。历史数据不足时自动降级到子集指标,保证脚本能跑
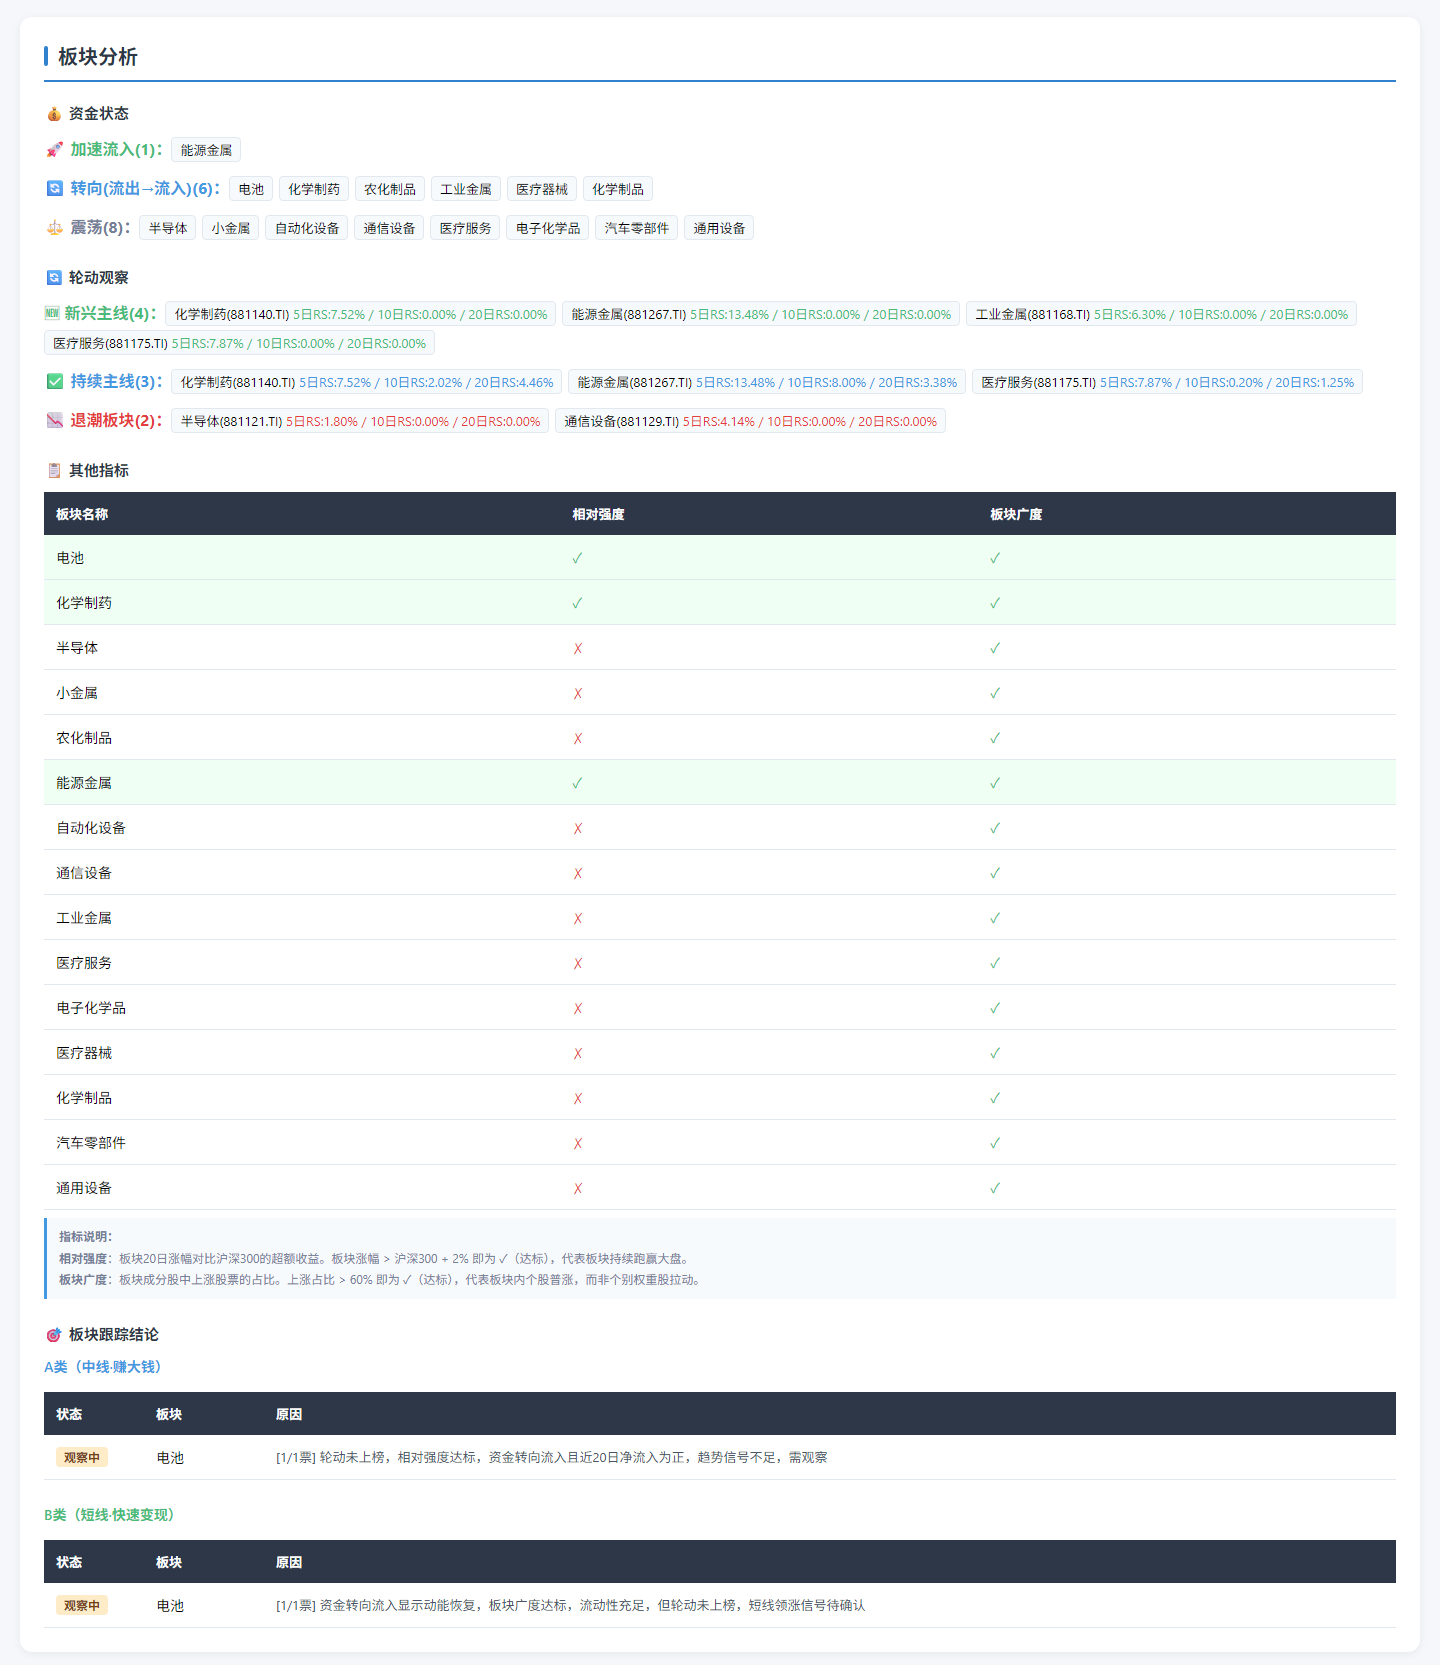
- 第二层 · 主线板块定位:从三个维度对每个板块进行独立判断——连续资金流入(T/F)、相对强度(T/F)、板块广度(T/F),三个维度全部满足才进入 confirmed 状态。板块状态遵循路径约束:exclude 不能直接跳到 confirmed(必须先经过 observing 观察期),confirmed 状态减弱时最多降级到 observing(保护期机制),避免单日资金脉冲导致的误判
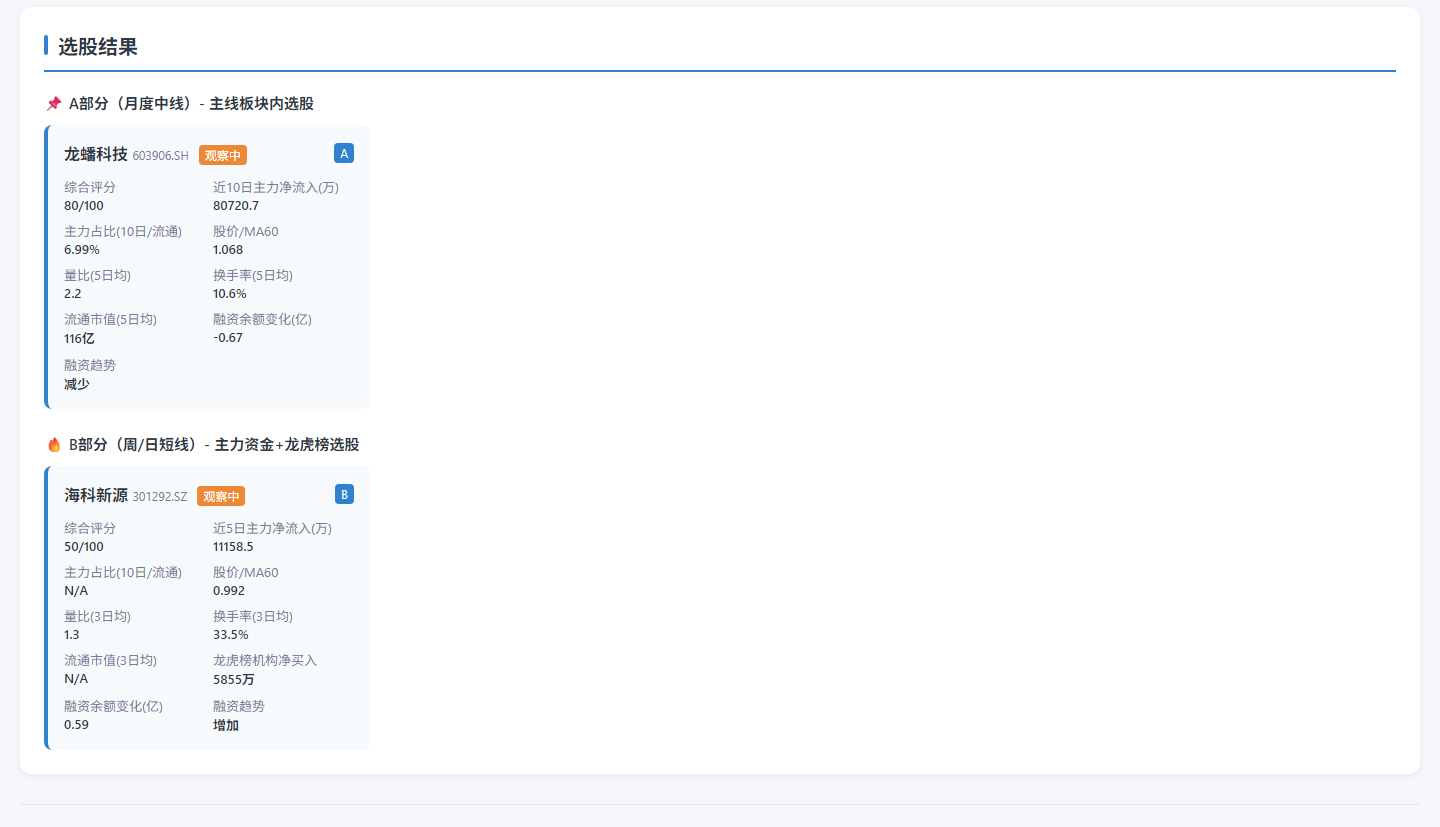
- 第三层 · 个股候选池:通过 A/B 双策略筛选候选标的
- A 类策略(中线趋势):缩量回调 + 收盘价 ≥ MA20,观察期 10 个交易日
- B 类策略(短线动能):次日开盘价 > MA5,目标持仓 3-7 天,10% 收益止盈 50% 仓位

功能 3:自动生成可视化 HTML 报告
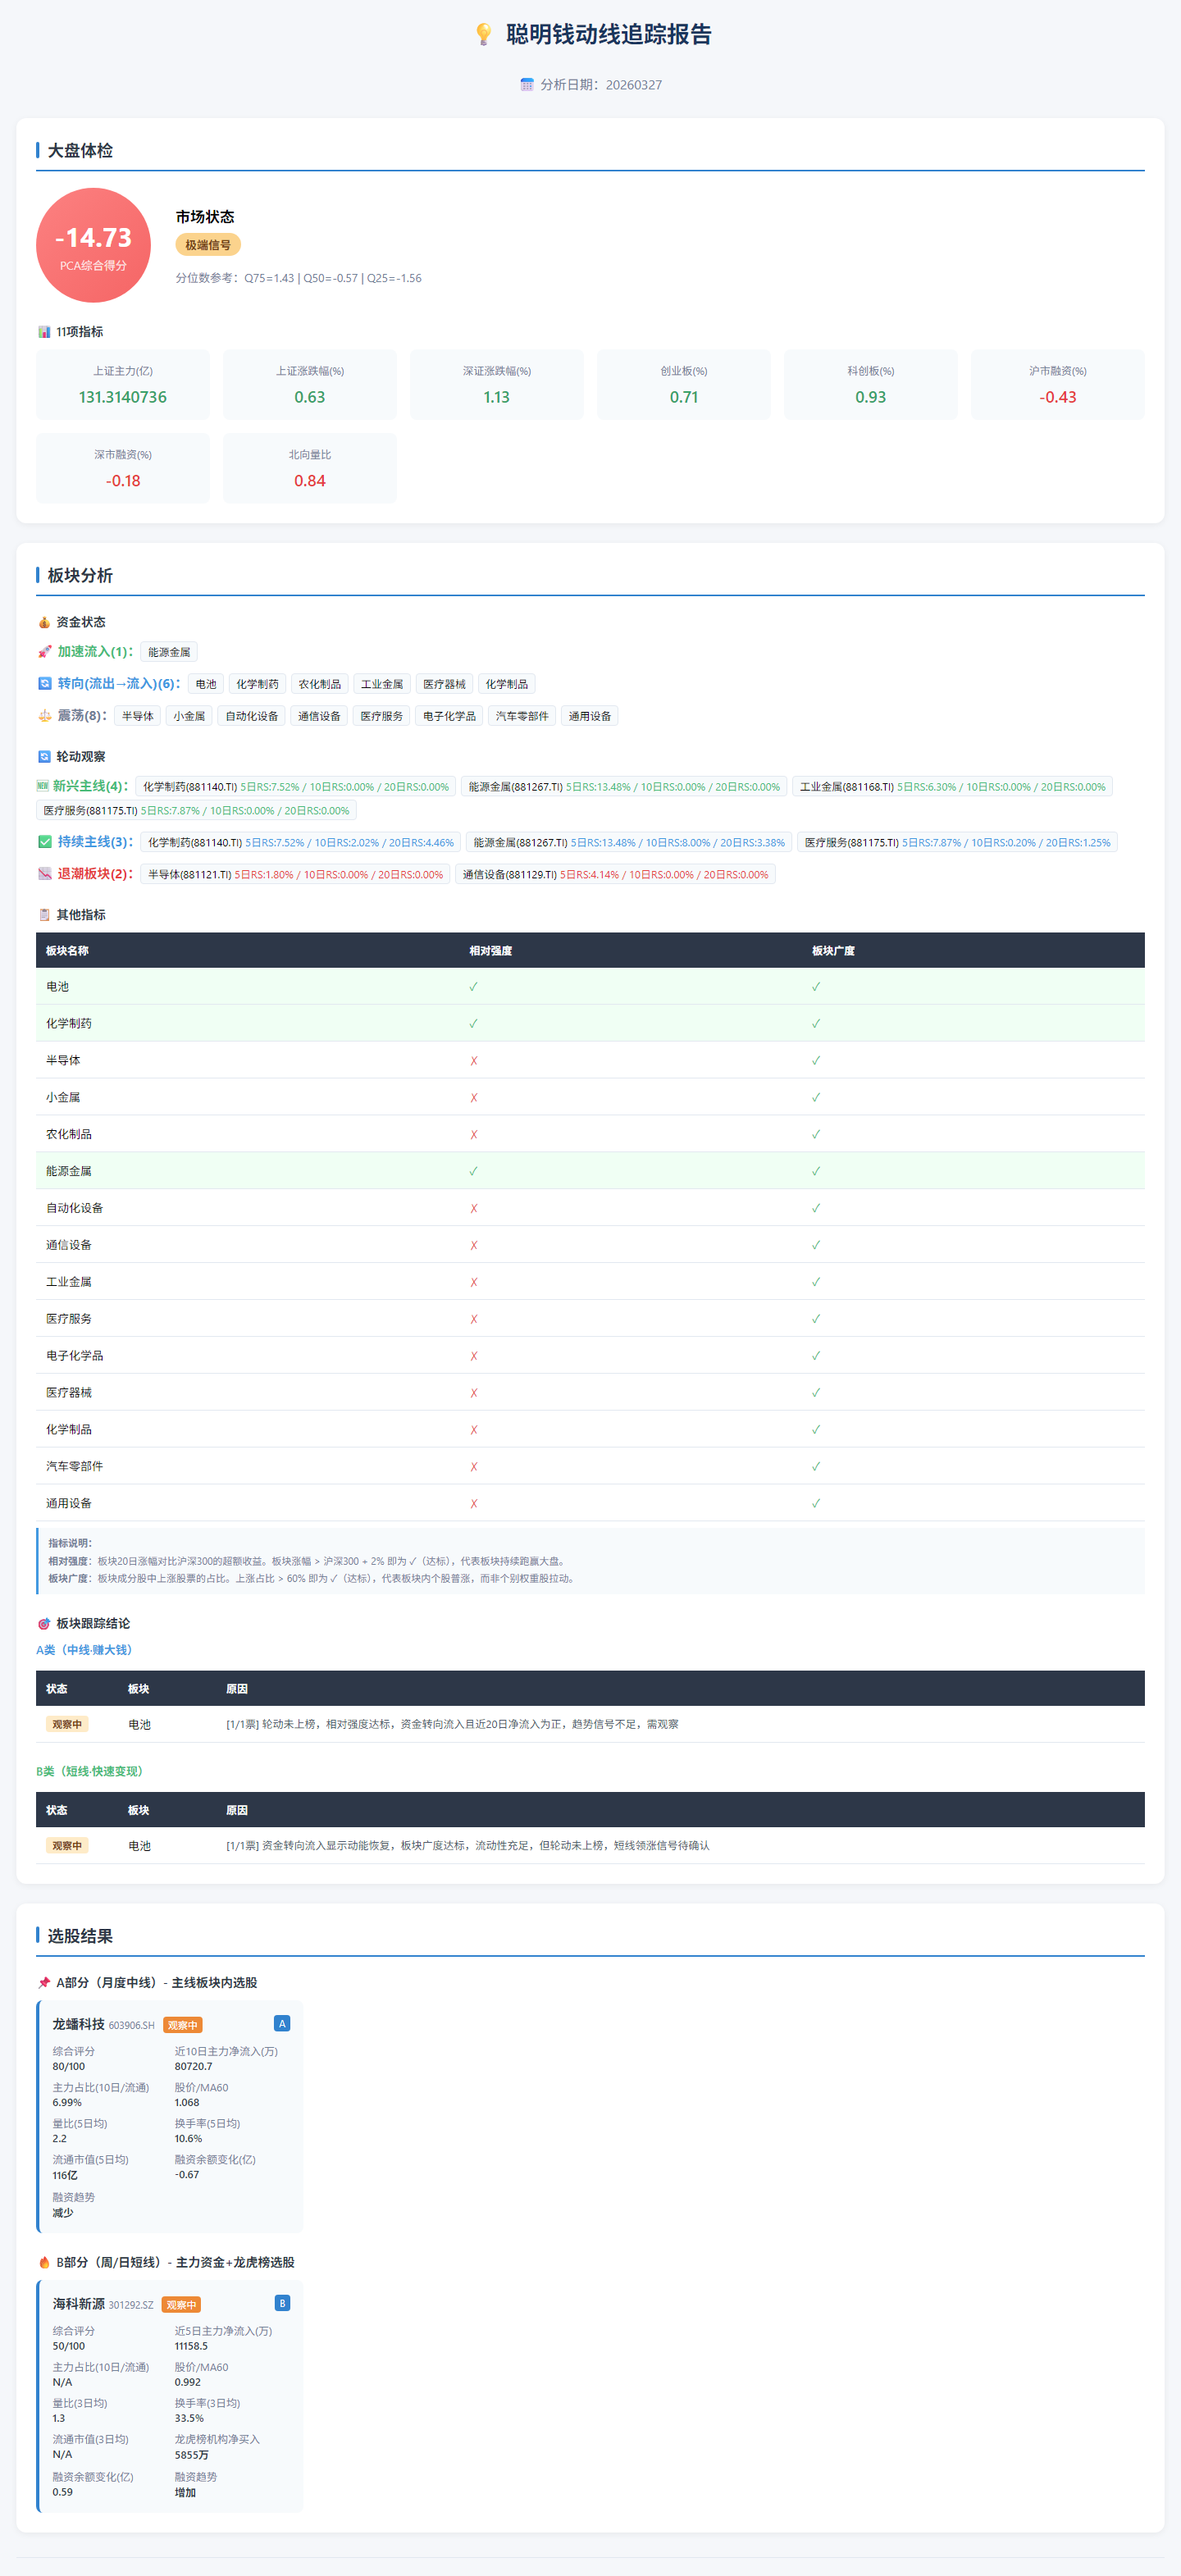
脚本运行完毕后,自动生成一份结构清晰的 HTML 报告,包含大盘评分、板块资金流向、个股候选列表等,用浏览器即可打开查看。
二、Demo 创作思路
灵感来源
小红书上每天有无数新股民发帖求助:“抄了博主的作业亏了怎么办”“被套了要不要割肉”“看不懂财报怎么选股”。另一边,2026 年 315 晚会曝光了"AI 投毒 + 荐股分成"骗局——不法分子用 AI 生成虚假股票分析报告,冒充"股神"荐股。
散户一方面看不懂基本面,一方面只能依赖博主荐股。与其依赖别人,不如自己学会看数据。 这套系统不输出"买哪只"的结论,而是输出"怎么看市场"的能力——这也是对抗 AI 荐股骗局最好的方式。
想解决的问题
| 痛点 | 具体表现 | 本方案的解决方式 |
|---|---|---|
| 信息不对称 | 资金数据分散在十几个接口,口径混乱 | 一键整合多源数据,统一输出 |
| 决策主观化 | 凭感觉买卖,容易被情绪左右 | 基于规则的量化分析,减少人为判断 |
| 策略不可复现 | 今天这样明天那样,没有标准流程 | SOP 文档 + 自动化脚本,确保流程一致 |
| 工具门槛高 | 需要懂 Python、懂金融、懂统计 | 封装为"一键运行",非金融人员也能用 |
为什么做这个方向
我相信"资金是不会骗人的"——观点可以造假,交易行为造不了假。机构的信息优势往往领先于股价反映,追踪聪明钱的流向,就是追踪信息差。
市面上大多数工具直接给"买这只",但用户亏了不知道为什么。我的想法是输出一套"每日复盘 SOP",教用户怎么看大盘情绪、怎么找主线板块、什么时候该买卖——让普通人也能建立自己的决策框架。
三、Demo 体验地址
在线体验
 GitHub Pages 样例报告:在线体验
收录了多份历史报告(如 2026-03-27、2026-04-28、2026-05-06 等),点击日期即可查看当日的完整分析结果。
本地体验
如果在线访问较慢,也可以下载 Zip 包后用浏览器打开:
 样例报告下载:
smart-money-tracker-demo.zip (45.1 KB)
GitHub 仓库展示
 仓库链接:查看仓库
(包含项目介绍、复盘方法论 SOP 及效果截图)
后台运行视频
四、TRAE 实践过程
本项目全程使用 TRAE 生态完成,采用 “Work 出思想,IDE 出代码” 的策略。
阶段一:TRAE Work —— 梳理分析框架与 SOP
目标:与 AI 共同探讨"哪些指标代表聪明钱入场"“如何量化市场主线”,最终沉淀为可执行的每日复盘 SOP。
核心提示词策略:
“不要急着直接生成解决方案,我们可以一点点讨论,然后梳理出一整套适合本人特点的分析思路。”
关键步骤:
- 思路探索:与 AI 讨论聪明钱的定义、可追踪的指标、如何区分"真流入"和"假突破"
- 工作流设计:明确三层漏斗(大盘 → 板块 → 个股),确定每层需要看什么指标、怎么判断
- SOP 沉淀:把讨论成果整理为一份操作手册,告诉用户每天看什么、怎么判断、怎么操作
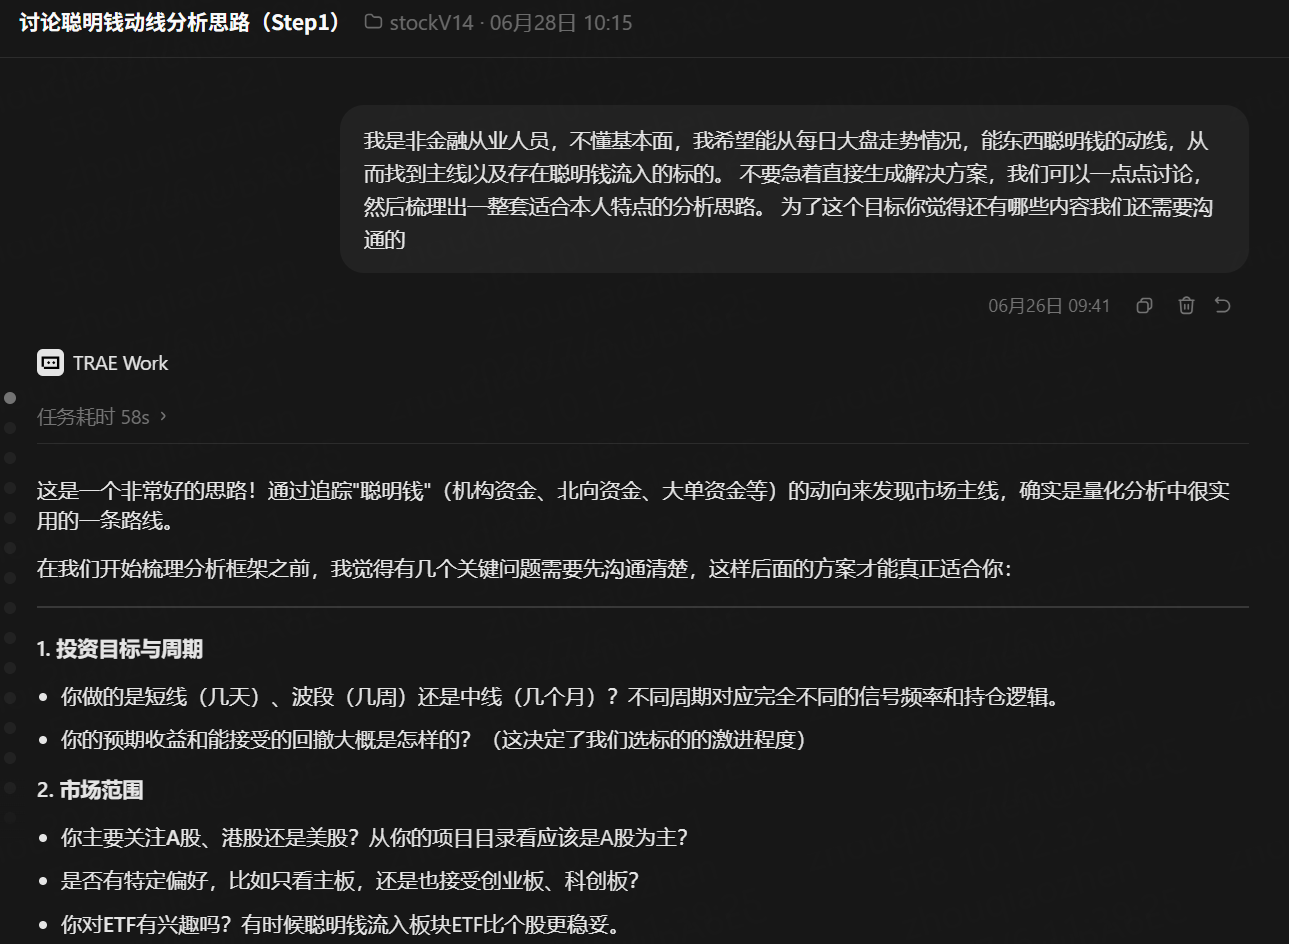
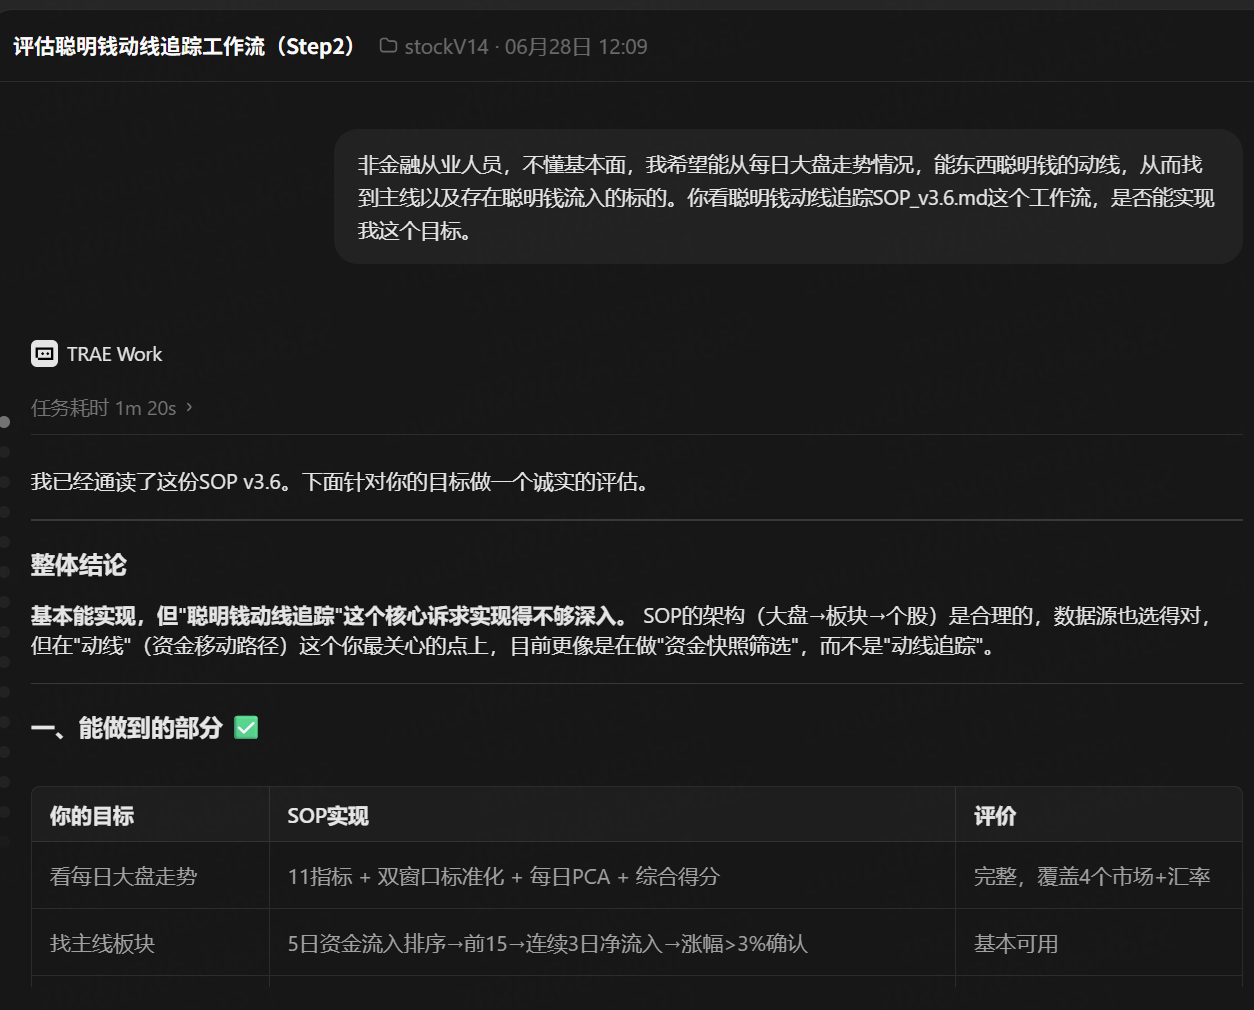
Session ID:
4378702115509868:fc5614a99063b7f6b2fc628c946d0ae1_6a3dd8c54360bb59c48d917c.6a40838a6d2158bedeebefa7.6a4083896d2158bedeebefa5—— 讨论聪明钱动线分析思路(2026/6/28)4378702115509868:a65c5a906edc23ac0772e4a3b065a70e_6a40843b6d2158bedeebefb0.6a409e4d6d2158bedeebf21d.6a409e4d6d2158bedeebf21b—— 评估聪明钱动线追踪工作流(2026/6/28)
阶段二:TRAE IDE —— 代码实现与调试
目标:将 SOP 中的分析逻辑转化为可运行的 Python 脚本,在 Solo 模式下逐模块实现。
模块拆分:
| 模块 | 功能 | 开发方式 |
|---|---|---|
data.py |
Tushare 数据获取与清洗 | TRAE IDE Solo 模式,AI 辅助编写 |
analysis.py |
PCA 大盘体检、板块分析、A/B 选股策略 | 按 SOP 逻辑逐条转化为代码 |
report.py |
HTML 报告生成 | AI 辅助生成可视化模板 |
config.py |
参数配置(Tushare Token、策略参数等) | 手动调整 + AI 建议 |
main.py |
主流程调度 | 整合各模块,一键运行 |
关键步骤:
- 核心编码:用 TRAE IDE 的 AI 助手实现数据获取、PCA 分析、A/B 双策略选股等核心模块
- 代码与 SOP 对齐:反复核对代码逻辑是否与 SOP 文档一致,确保"文档说怎么做,代码就怎么做"
- 调试优化:遇到报错直接选中代码片段让 AI 诊断修复,优化参数提升策略效果
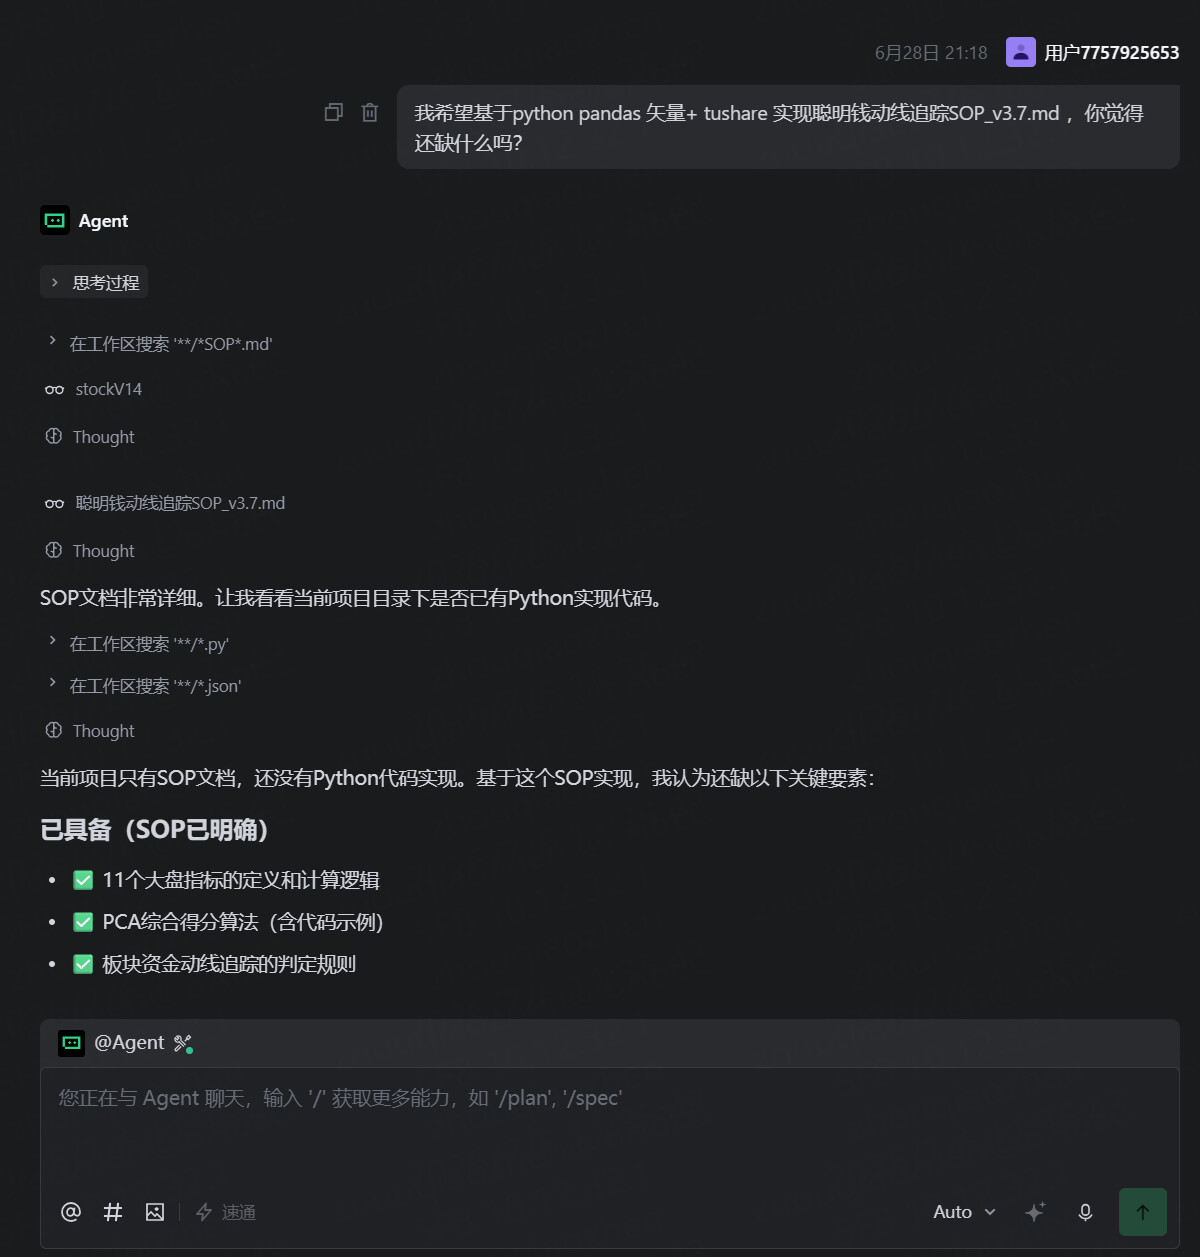

Session ID:
4378702115509868:d7ed4f1f612eb1d79af94700b0152e4f_6a411e52f3af39741e74e681.6a426f8026d5cf1867400f13.6a426f802bdb49a61dda6cba—— Python Pandas Tushare 聪明钱动线追踪代码实现(2026/6/29)4378702115509868:7284a3dc3d5c4cc3e36f0fc74ed97c34_6a426ffc26d5cf1867400f25.6a42747c26d5cf1867400fc0.6a42747c2bdb49a61dda6cbf—— 分析代码与 SOP V3.7 一致性(2026/6/29)
开发心得
1. 规则兜底,不依赖 AI 实时判断
报告中的"大盘情绪评分""板块资金流向"等结论,都是基于明确的计算规则得出,而非 AI 实时生成。这样即使 AI 服务不可用,脚本依然能输出可靠结论。
2. 双策略设计源于真实交易反思
A 类策略(中线趋势)和 B 类策略(短线动能)不是拍脑袋想的,而是我在 TRAE Work 中与 AI 反复讨论后确定:中线看趋势(缩量 + MA20),短线看动能(MA5 突破),两套逻辑独立运行,适应不同市场状态。
五、开发踩坑记录
坑 1:直接让 AI 生成代码,结果逻辑偏差大
最开始我直接跟 TRAE 说"帮我写一个股票分析脚本",它很快就写出来了一版。但我跑完一看,逻辑和我想的完全不一样——它用了自己的"默认思路"来选股,根本没按我的分析方法来。后来我改了策略:先在 TRAE Work 里花几天时间跟 AI 讨论分析框架,把每个指标的定义、判断条件、输出格式全部写在 SOP 文档里,然后再切到 TRAE IDE 说"按这个文档写代码"。返工次数大幅减少。
坑 2:SOP 和代码"双轨运行"
开发到第三天发现一个诡异的问题:回测结果和我的预期完全对不上。排查了半天,发现是 config.py 里的参数还是旧版本的值——SOP 文档已经更新到 v4.3 了,但代码里的止损线、止盈比例、换手率阈值还停在 v3.7 的设定。更离谱的是,backtest.py 里有个变量名改了但 import 没更新,直接 NameError。从那以后我养成了一个习惯:每次改 SOP 必须同步检查 config.py,用 TRAE 的"对照 SOP 核对代码"功能逐条比对。
坑 3:Tushare 交易日历返回日期未排序
第一次跑完整流程时,结果数据和预期对不上——有些日期的数据完全错位。排查了一圈,最终发现是 Tushare 的 trade_cal(交易日历)接口返回的日期不是按时间排序的,直接拿来做关联就会串行。这个坑很隐蔽,因为单独看每个接口的数据都是对的,只有当多个接口的数据按日期关联时才会暴露问题。修起来倒简单,加一行排序就行,但找原因花了挺久。
坑 4:调试文件堆积
早期开发阶段,每次调试我都喜欢新建一个脚本(debug_api.py、run.py、test_xxx.py……),结果到后来目录里一堆 py 文件,连我自己都分不清哪个是正式入口、哪个是调试残留。最后花了时间统一清理:只保留 main.py 作为唯一入口,其他调试脚本全删,py 文件移到 src/ 目录下,输出放到 report/。
六、效果验证
板块状态分类有效性回测
为了验证板块分析逻辑是否真的有效,我对历史数据做了回测:统计不同状态板块在未来一段时间内的涨幅分布,看 confirmed 状态是否真的比 exclude 状态更值得关注。
数据样本:630 条板块记录(A 类看未来 20 个交易日,B 类看未来 5 个交易日)
| 类型 | 状态 | >20% 涨幅占比 | 关键结论 |
|---|---|---|---|
| A 类(中线) | confirmed | 41.7% | 精确率 100%,选出的板块确实更强 |
| A 类(中线) | observing | 33% | 介于 confirmed 和 exclude 之间,有参考价值 |
| A 类(中线) | exclude | 9% | 成功过滤掉弱势板块 |
| B 类(短线) | confirmed | 13.3%(>10%) | 短线动能有效 |
| B 类(短线) | exclude | 2%(>10%) | 排除的板块确实弱 |
最重要的发现:直接跳到 confirmed(跳过 observing)的板块全部失败,平均涨幅 -5.2%;而经过 observing → confirmed 路径的板块,67% 大涨,平均涨幅 +17.3%。这说明 observing 观察期是必要的——它能过滤掉单日资金脉冲的虚假信号,只有资金持续关注后才进入 confirmed。
这个发现直接促使我修改了 SOP v4.4:新增板块状态路径约束,禁止 exclude 直接跳到 confirmed,confirmed 减弱时最多降级到 observing。
七、附录
项目结构
smart-money-tracker/
├── src/                    # Python 脚本
│   ├── main.py             # 主流程
│   ├── data.py             # 数据获取
│   ├── analysis.py         # 分析引擎(PCA + 板块 + A/B 选股)
│   ├── report.py           # HTML 报告生成
│   └── config.py           # 配置参数
├── report/                 # 生成的 HTML 报告
└── sop/                    # 每日复盘 SOP 文档
技术栈
- 数据来源:Tushare Pro API
- 分析框架:Pandas + NumPy + Scikit-learn(PCA)
- 报告生成:纯 HTML + CSS(内嵌样式,无需外部依赖)
- 开发工具:TRAE Work(思路梳理)+ TRAE IDE(代码实现)
本作品由 TRAE Work 与 TRAE IDE 共同开发完成,感谢 TRAE AI 创造力大赛提供的学习与展示机会。