1. Demo 简介
-
是什么: 剧库是一款基于 Flask + HTML 构建的本地网页版追剧管理工具,帮助用户系统化管理在追、想看和已看完的剧集,并通过 AI 自动生成精准的剧集简介与分集剧情。
-
面向谁: 核心用户是影视爱好者,尤其是同时追多部剧、需要记录观看进度的人群。
-
主要功能:
-
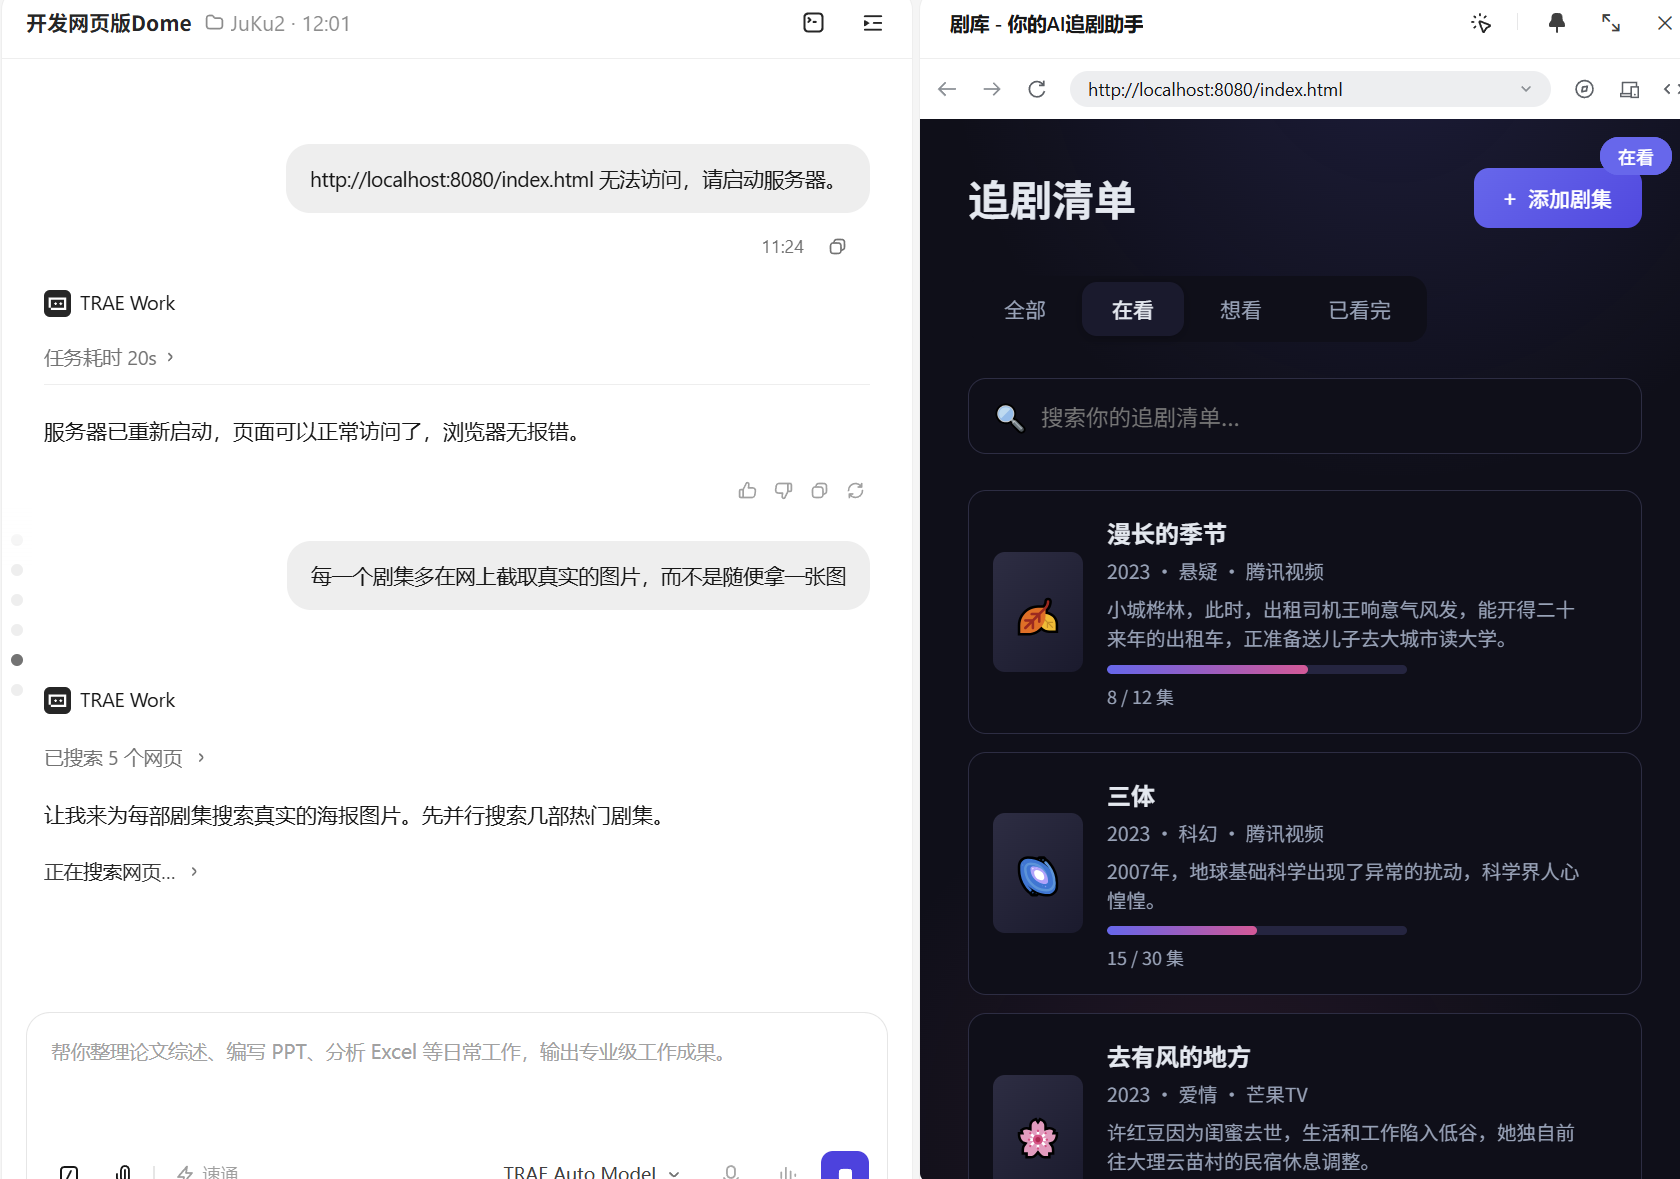
智能剧集搜索与添加: 输入剧名即可通过百度搜索建议自动匹配真实影视作品,一键获取海报、年份、平台、集数等信息。
-
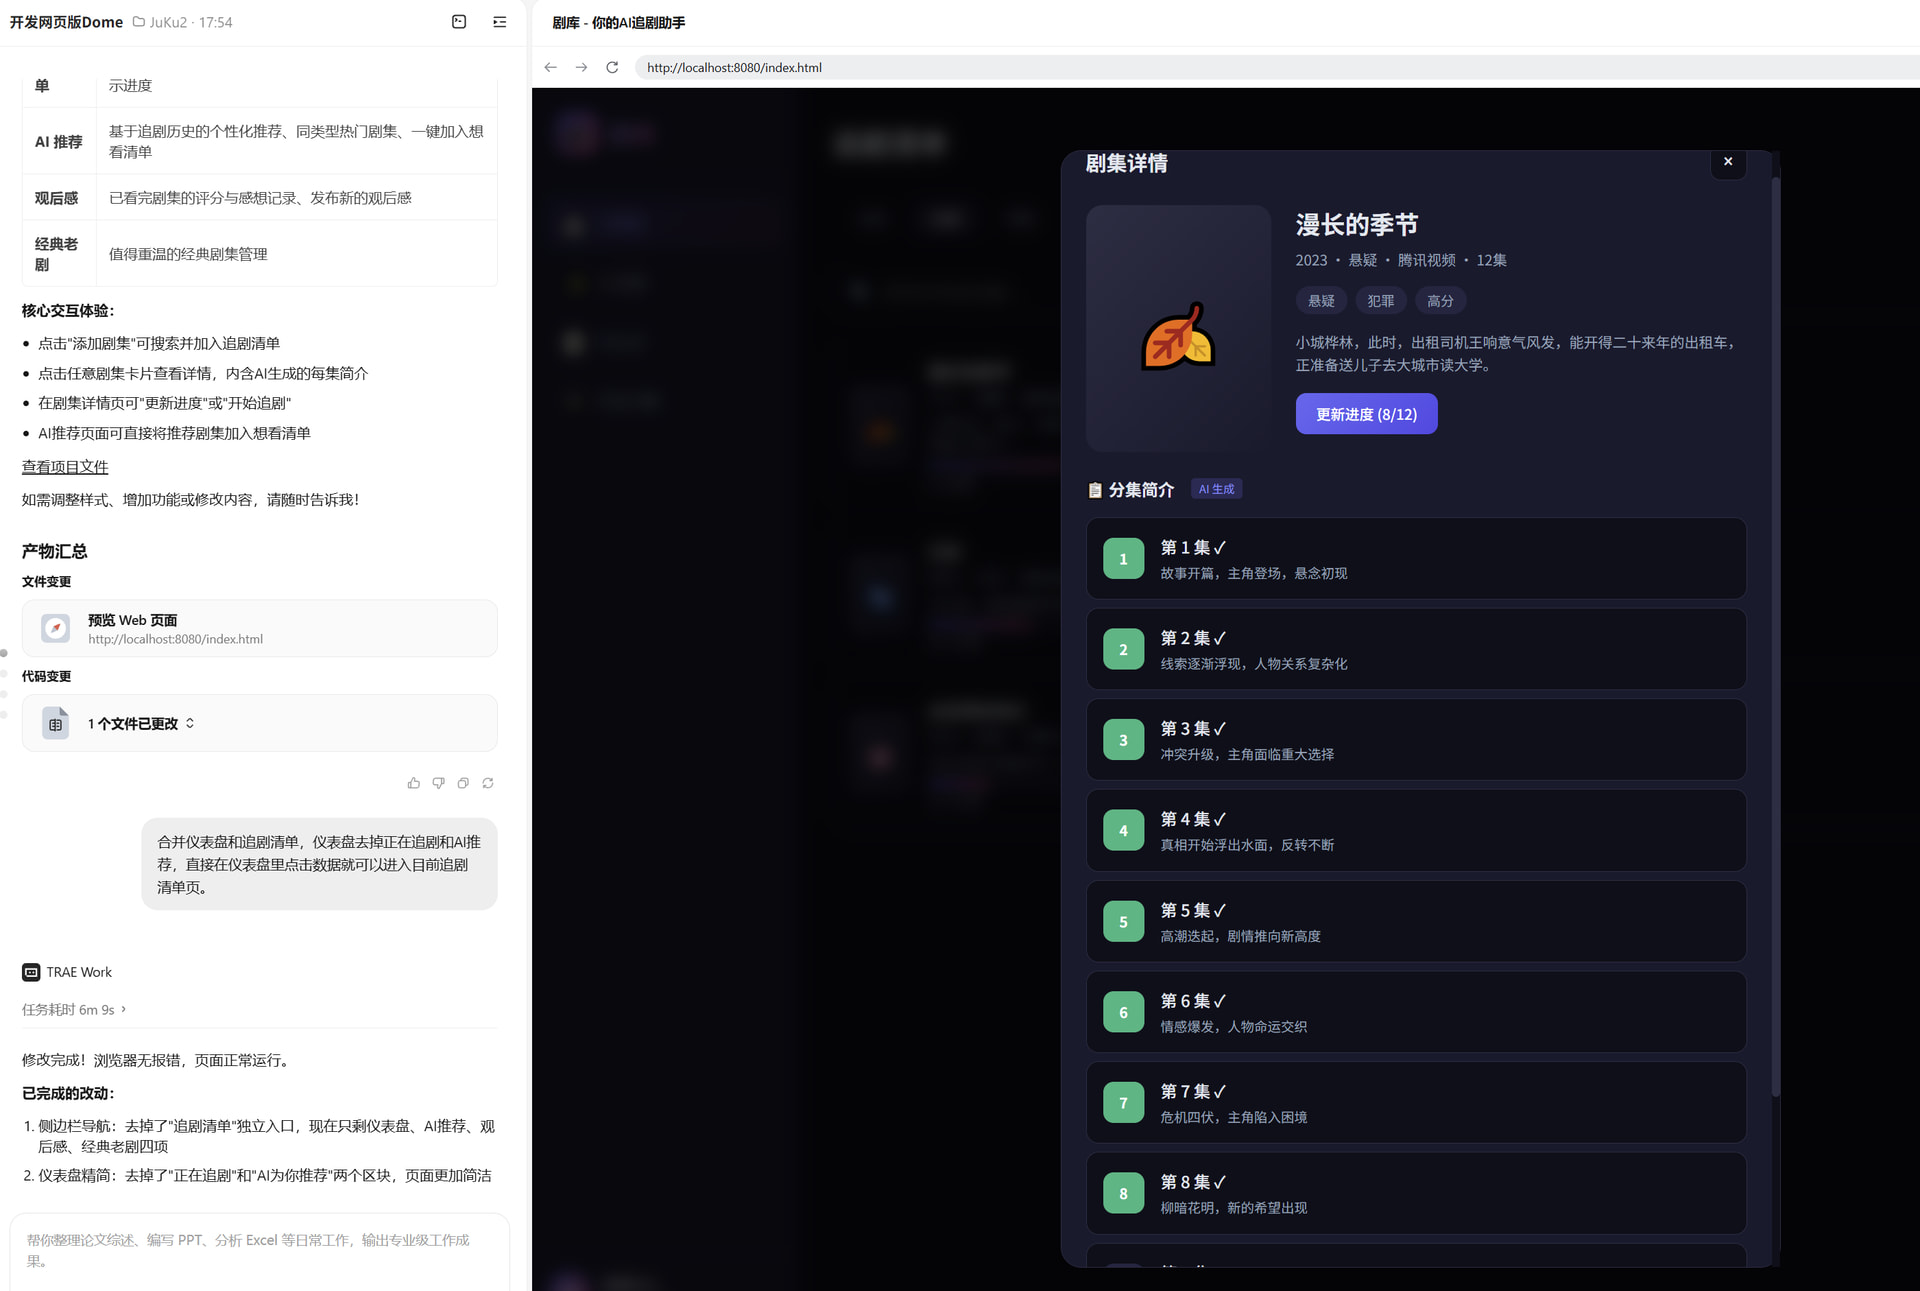
观看进度管理: 支持按集标记已看/未看,自动统计进度,全部看完自动标记"已看完",并支持随时修改总集数(适应连载剧集)。
-
AI 智能简介: 提供两种简介获取方式——默认通过360搜索+百度百科获取真实简介;配置本地 Ollama 大模型后,可自动生成精准的剧情梗概和每集分集简介。
-
2. Demo 创作思路
-
灵感来源: 平时追剧时经常遇到几个问题:同时追多部剧容易忘记看到哪一集;想记录看完的感受但没有地方;新剧刚开播集数未知需要灵活调整。市面上的追剧 App 要么功能臃肿,要么需要注册登录,于是想做一个轻量、本地、完全属于自己的追剧工具。
-
想解决的问题:
-
忘记观看进度,重复看或漏看
-
手动记录每集简介太麻烦,网上的分集剧情质量参差不齐
-
剧集在播中需要随时调整总集数
-
-
为什么做这个方向: 个人工具类应用开发周期短、需求明确,适合在 TRAE 中快速迭代验证。同时结合了 AI 能力(大模型生成简介),符合本次大赛鼓励的技术创新方向。
3. Demo 体验地址
-
本地体验: 下载项目后运行
python api.py,访问 http://localhost:8081 即可使用 -
项目文件:
JuKu2.zip (5.2 MB)
(包含
api.py、index.html和数据文件) -
交互文件:
index.html(前端交互页面,支持完整功能体验)
4. TRAE 实践过程
开发流程:
-
需求构思阶段: 在 TRAE 中描述追剧工具的核心需求,快速生成 Flask 后端框架和 HTML 前端骨架。
-
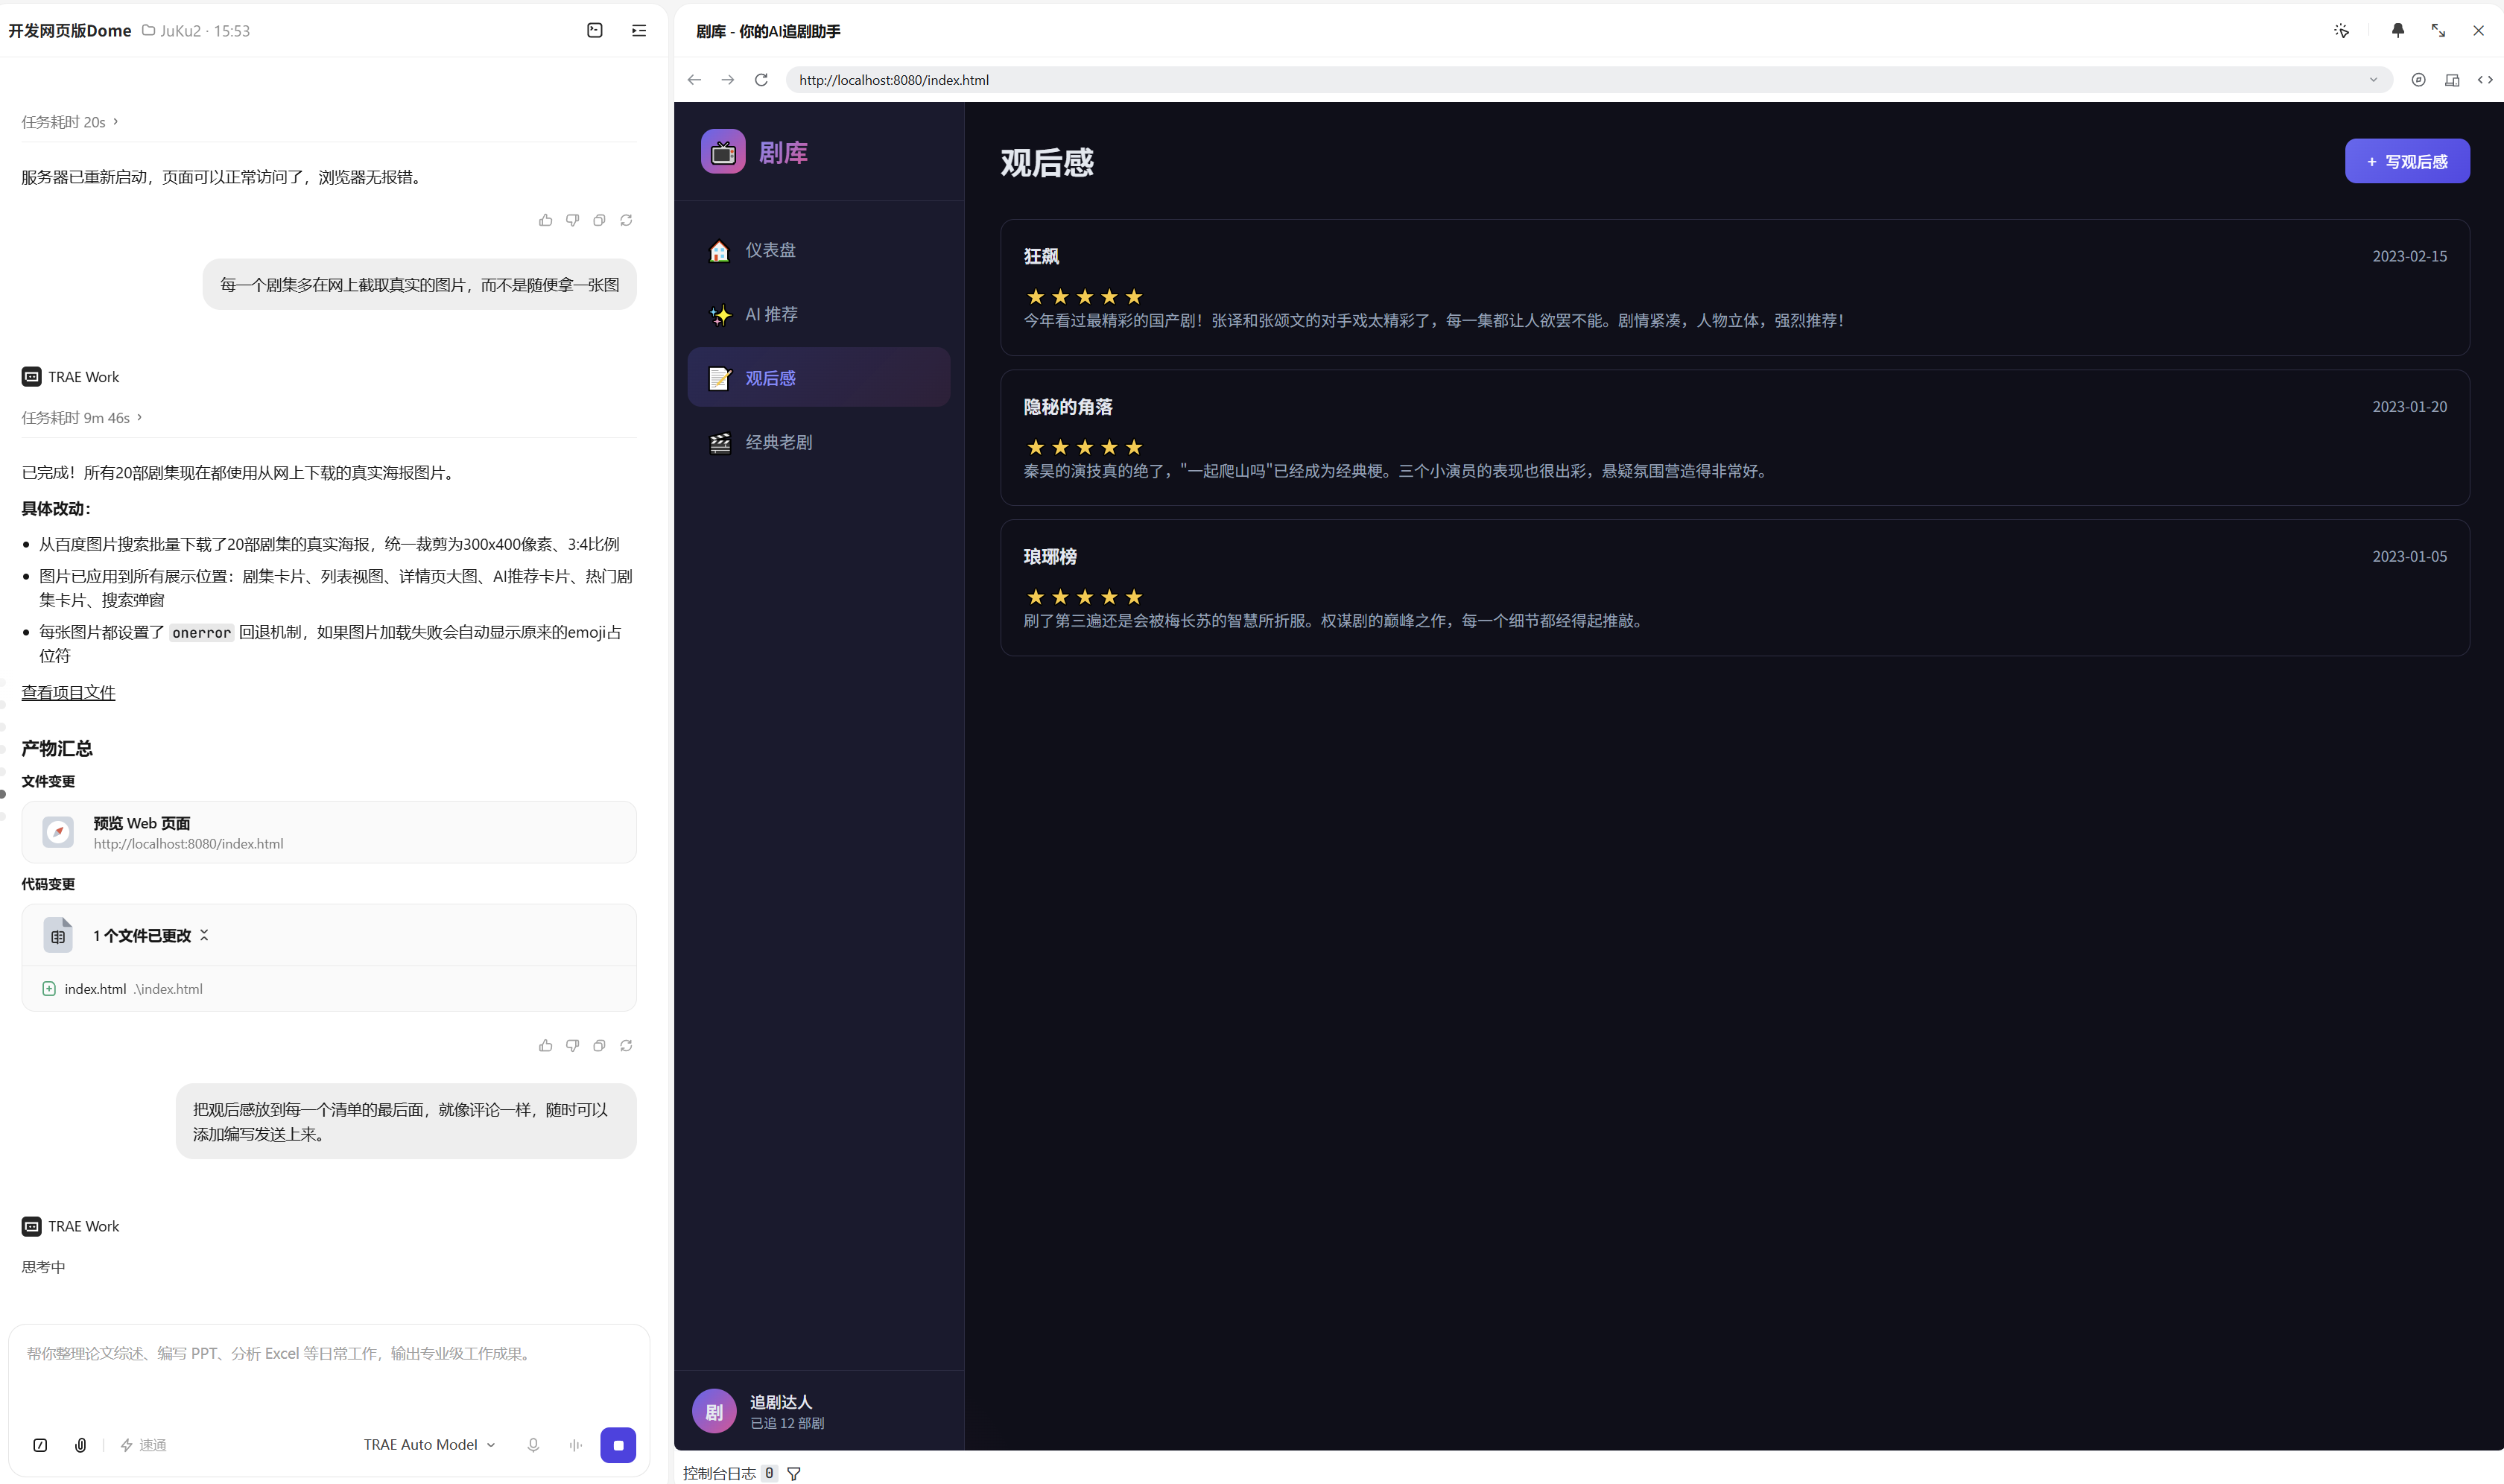
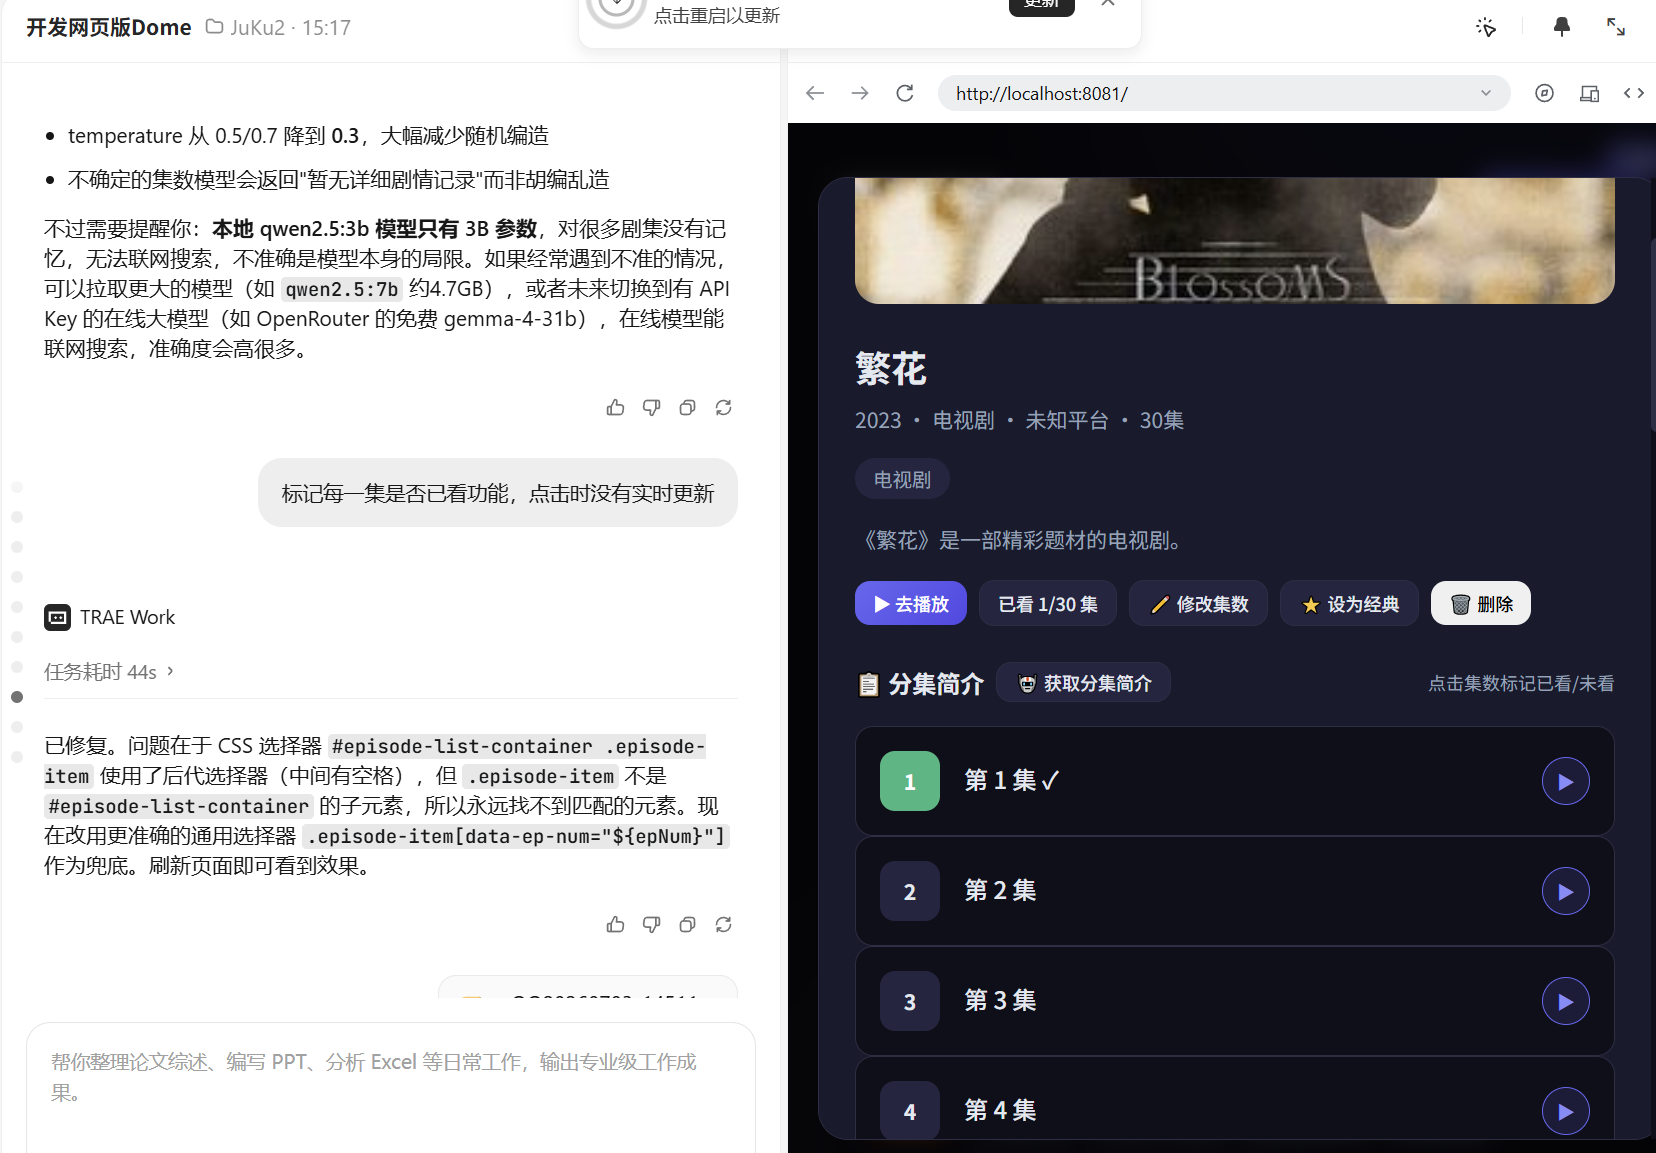
功能迭代阶段: 通过多轮对话逐步添加搜索添加、进度标记、数据统计、经典老剧分类、修改集数等功能。
-
AI 集成阶段: 接入大模型能力,先通过搜索引擎获取简介,再配置 Ollama 本地大模型实现 AI 生成精准简介和分集剧情。
关键任务对话 Session ID:
- **Session ID:**745931683145449:592dbc1636aa66a9b9beb43aed25694b_6a3ce72ee18e57ce4b7a4347.6a3cf423e18e57ce4b7a4476.6a3cf423e18e57ce4b7a4474:TRAE Work CN.0.1.25.no_sid.no_ppe.T(2026/6/25 17:25:55)
- **Session ID:**745931683145449:183721016469269fb1099a1241d54fcd_6a3ce72ee18e57ce4b7a4347.6a3df9a6227dcfe29c8f54e5.6a3df9a6227dcfe29c8f54e3:TRAE Work CN.0.1.25.no_sid.no_ppe.T(2026/6/26 12:01:42)
- **Session ID:**745931683145449:5550e74eee1307c3b81951ec74338dac_6a3ce72ee18e57ce4b7a4347.6a3e3013227dcfe29c8f5552.6a3e3013227dcfe29c8f5550:TRAE Work CN.0.1.25.no_sid.no_ppe.T(2026/6/26 15:53:55)
- **Session ID:**745931683145449:94b6564de68f48c4b43f04f2c736fb55_6a3ce72ee18e57ce4b7a4347.6a4736dd9b6d53c1642b73ed.6a4736dd9b6d53c1642b73eb:TRAE Work CN.0.1.25.no_sid.no_ppe.T(2026/7/3 12:13:17)
踩坑经历与解决方案:
-
Bug: 标记集数已看后会跳回顶部,用户体验差。解决: 改为局部 DOM 更新,只修改对应集数的 class 和文字,不重新渲染整个弹窗。
-
Bug: 百度搜索建议 API 返回 GBK 编码,直接解析会乱码。解决: 设置
resp.encoding = 'gbk',并用正则匹配无引号的s:键名。 -
Bug:
LLM_API_KEY是后端环境变量,前端模板中直接引用导致永远为 undefined。解决: 新增/api/config端点让后端判断 LLM 是否可用,前端不再直接引用环境变量。 -
心得: TRAE 的上下文保持能力很强,在长达几十轮的对话中依然能准确理解项目结构。对于复杂功能(如分集简介的批量 LLM 调用),拆成后端 API + 前端缓存的策略最稳妥。