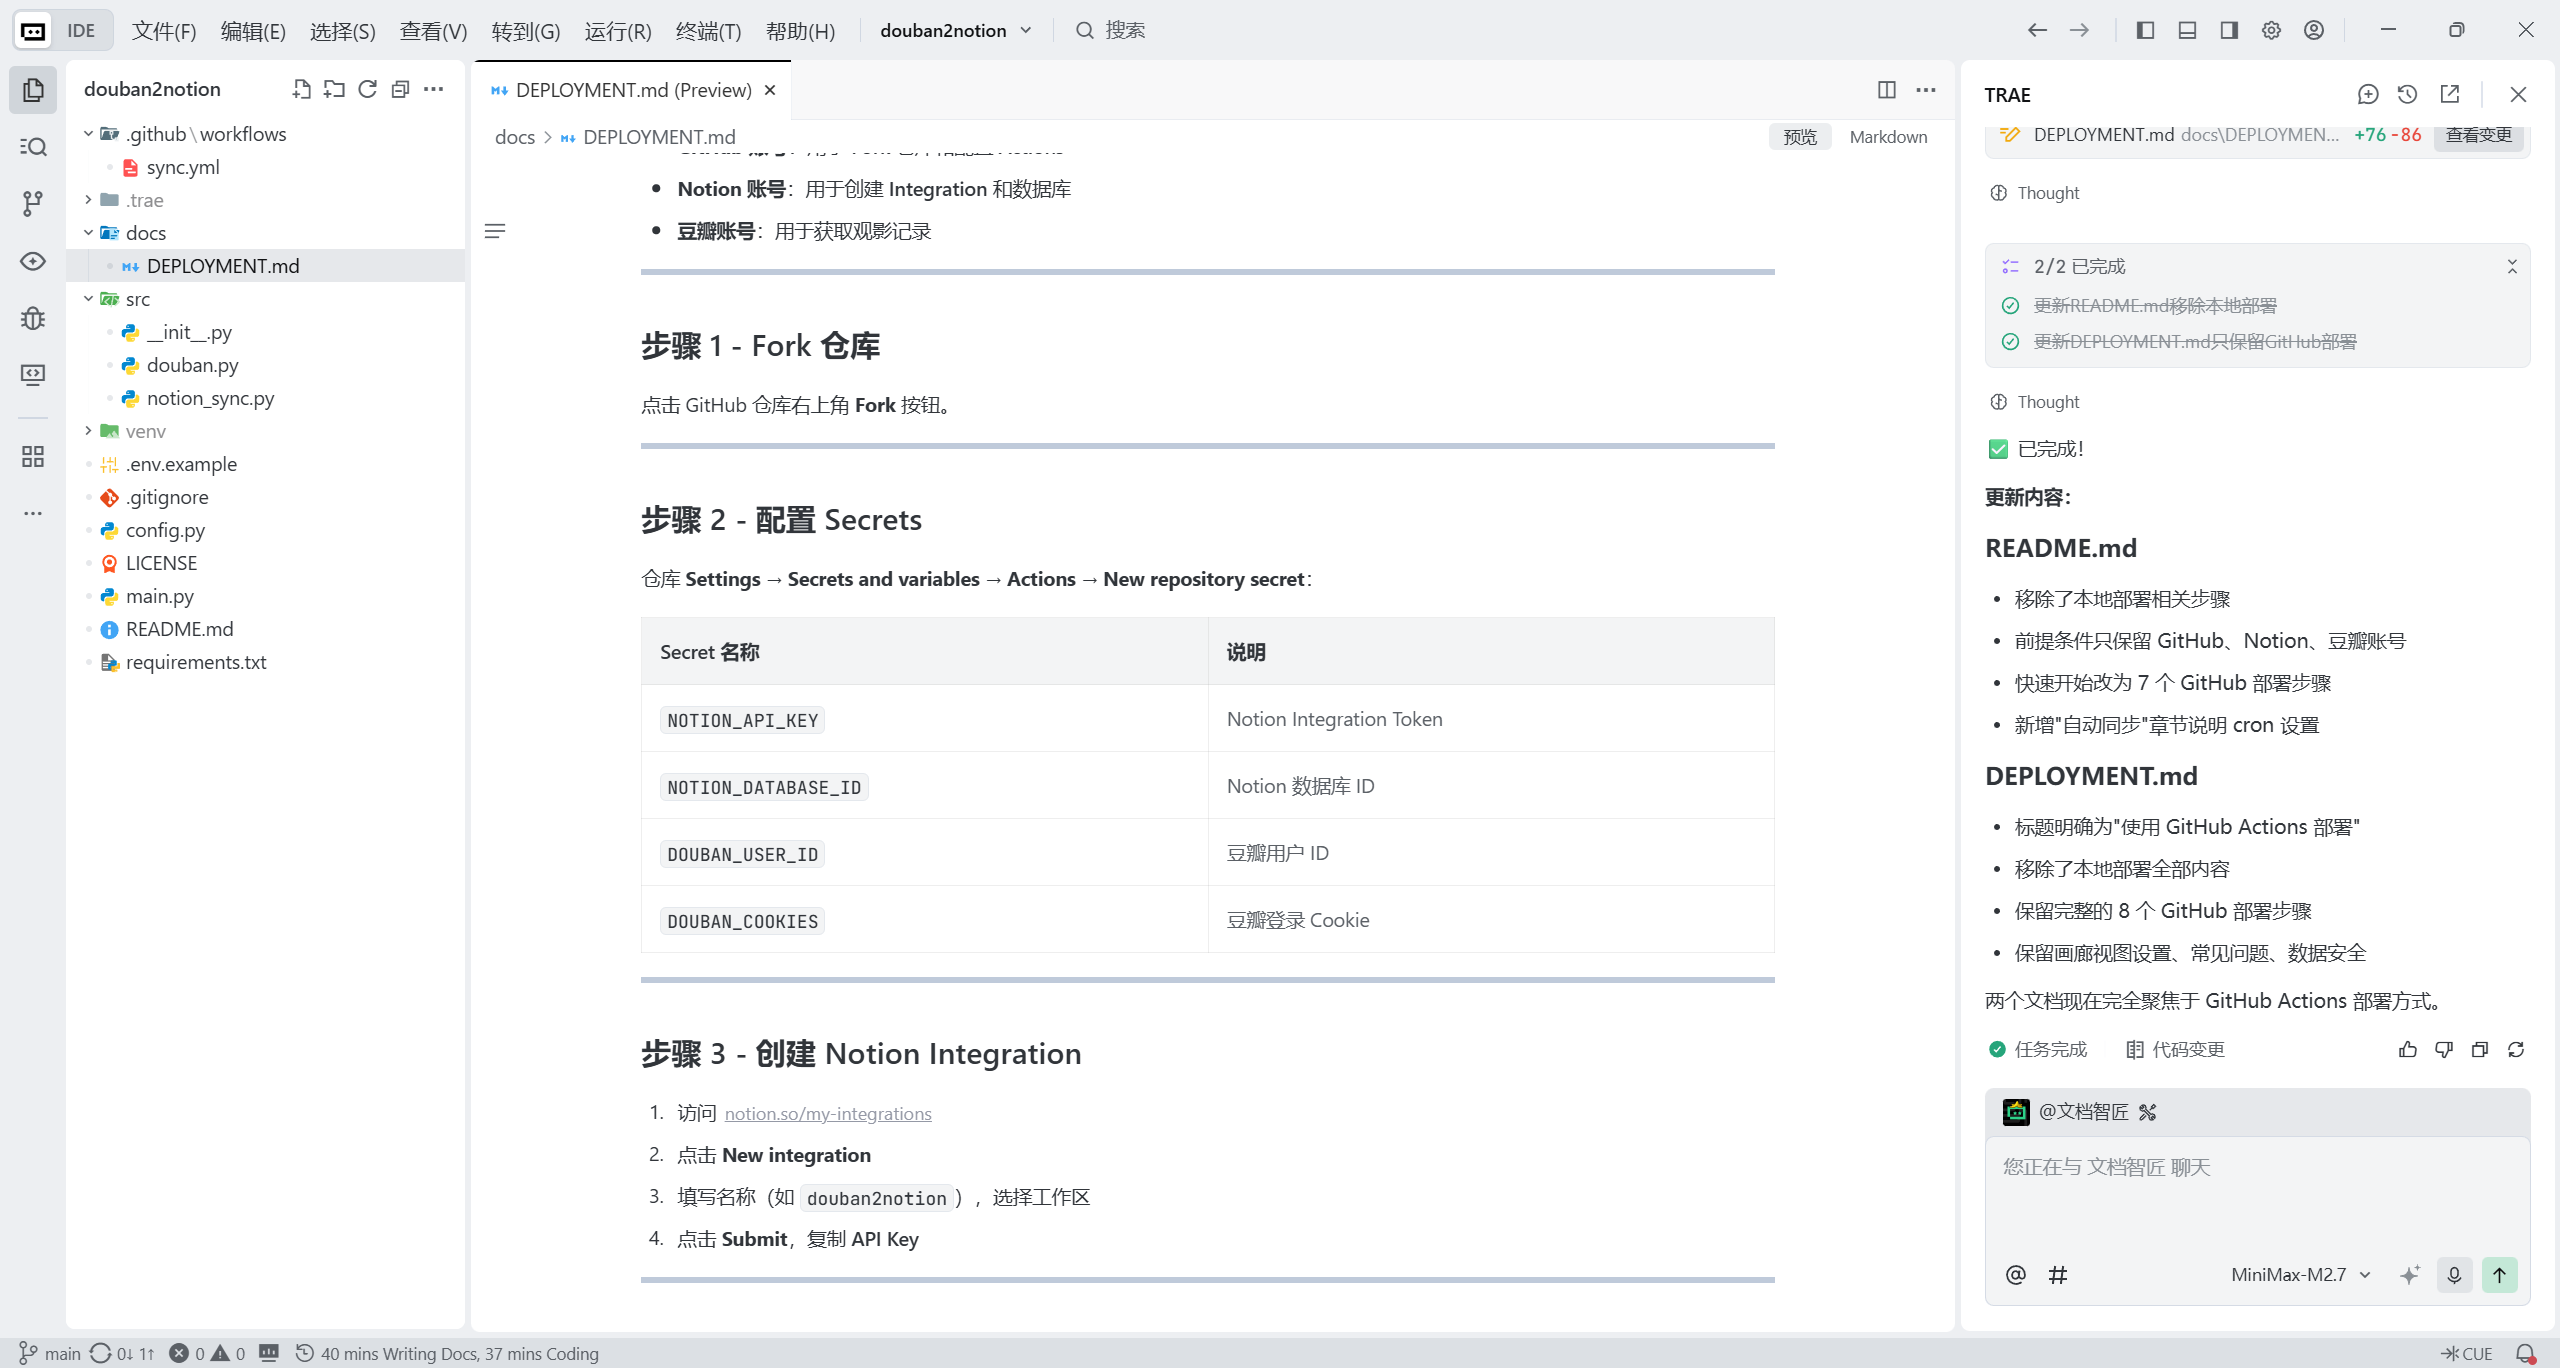
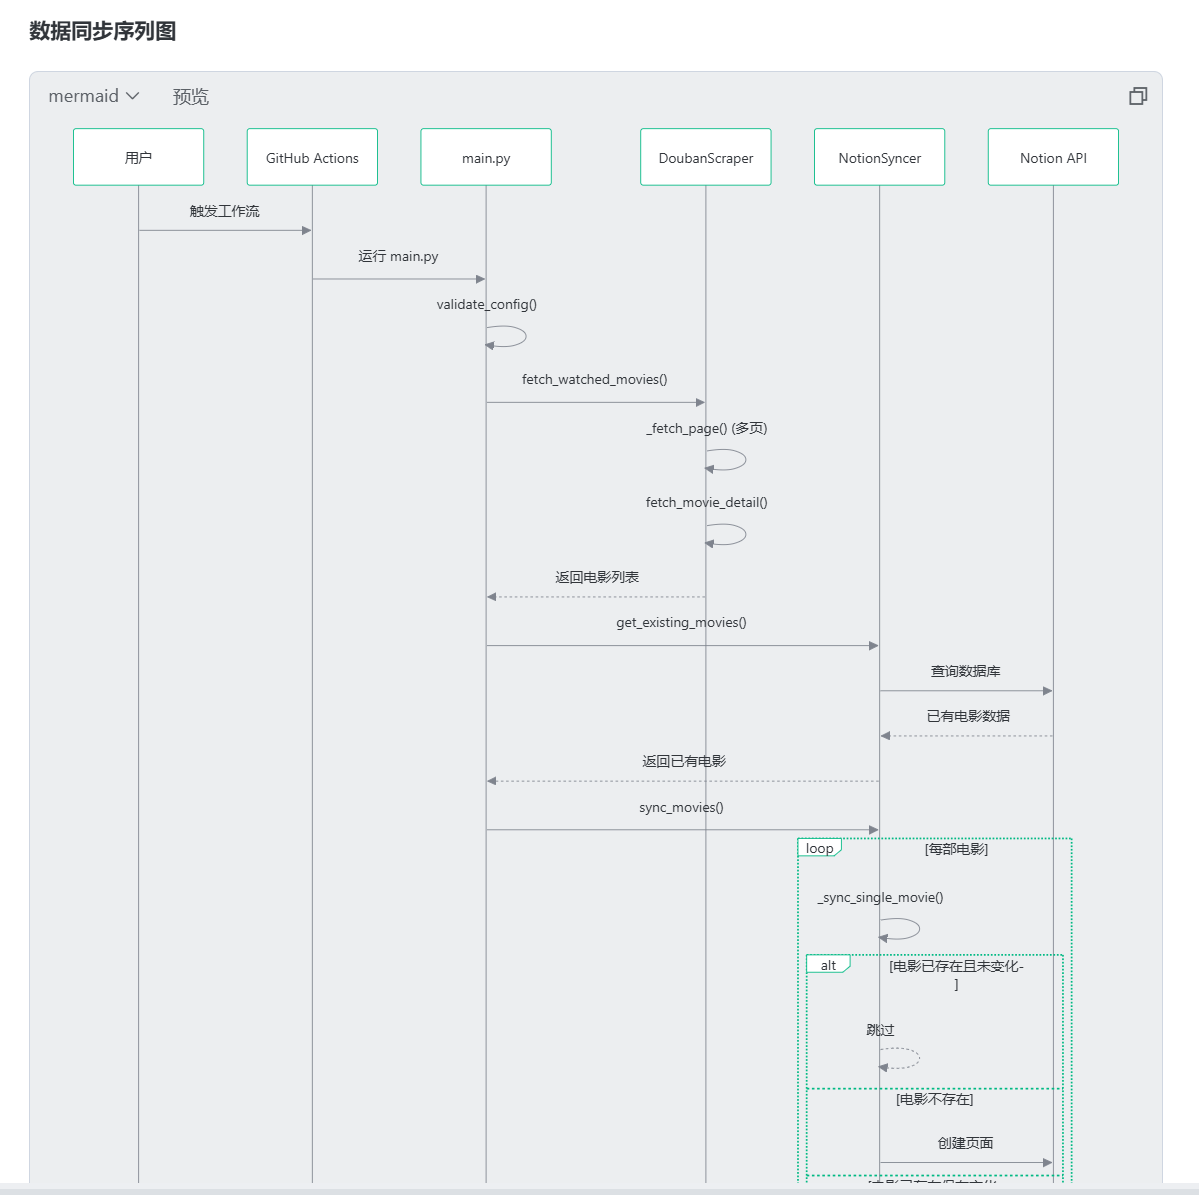
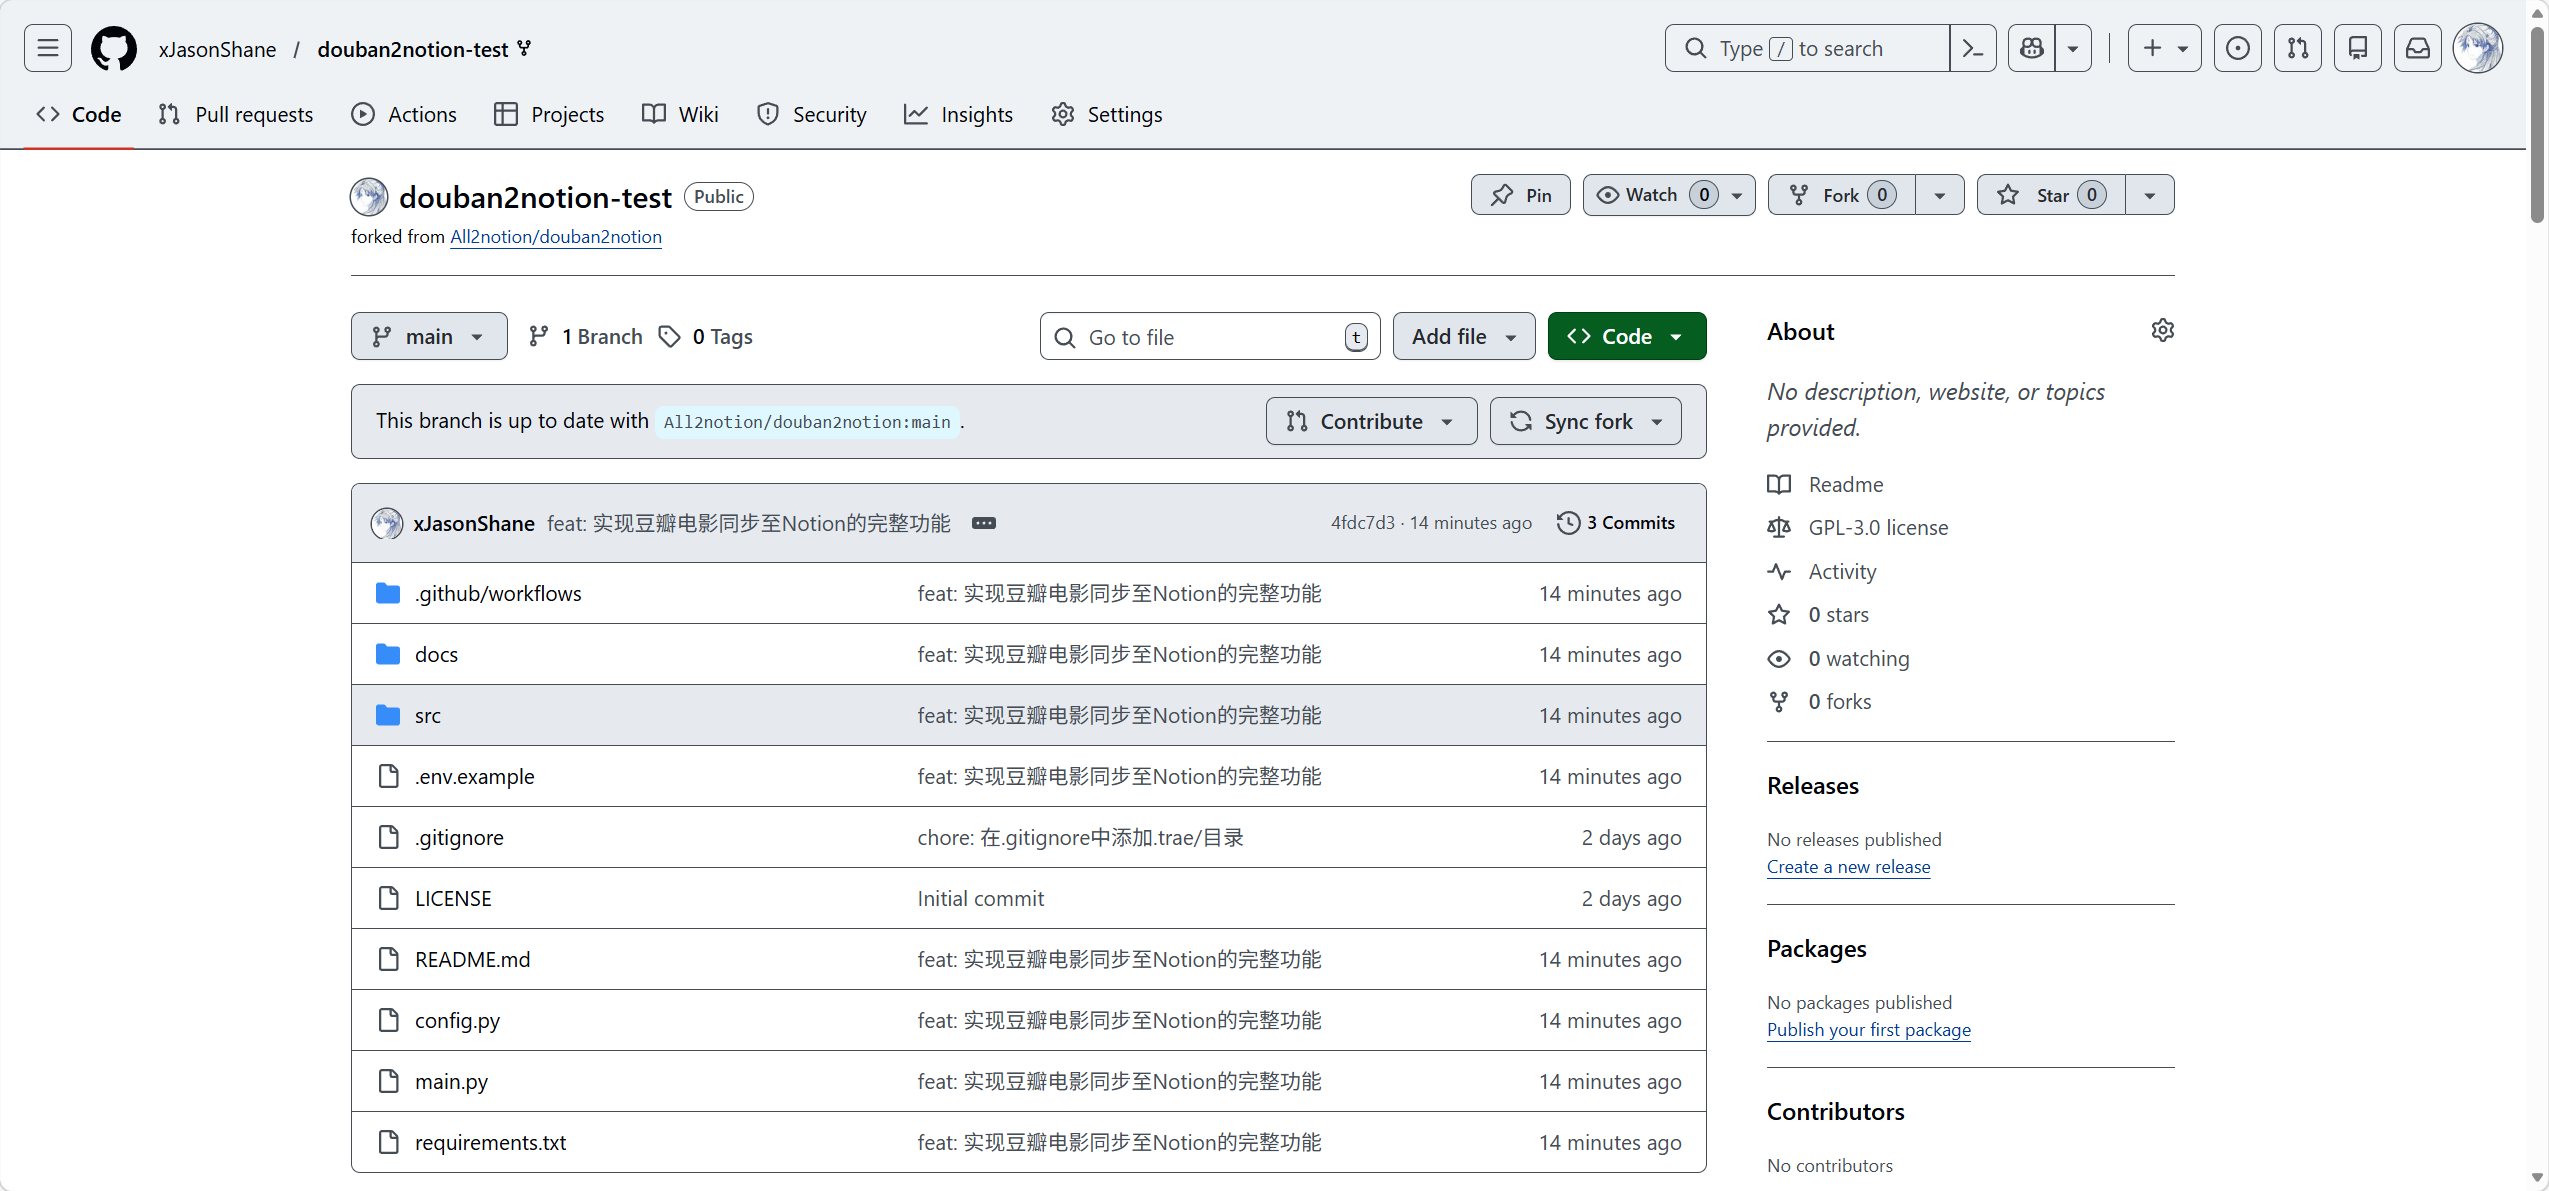
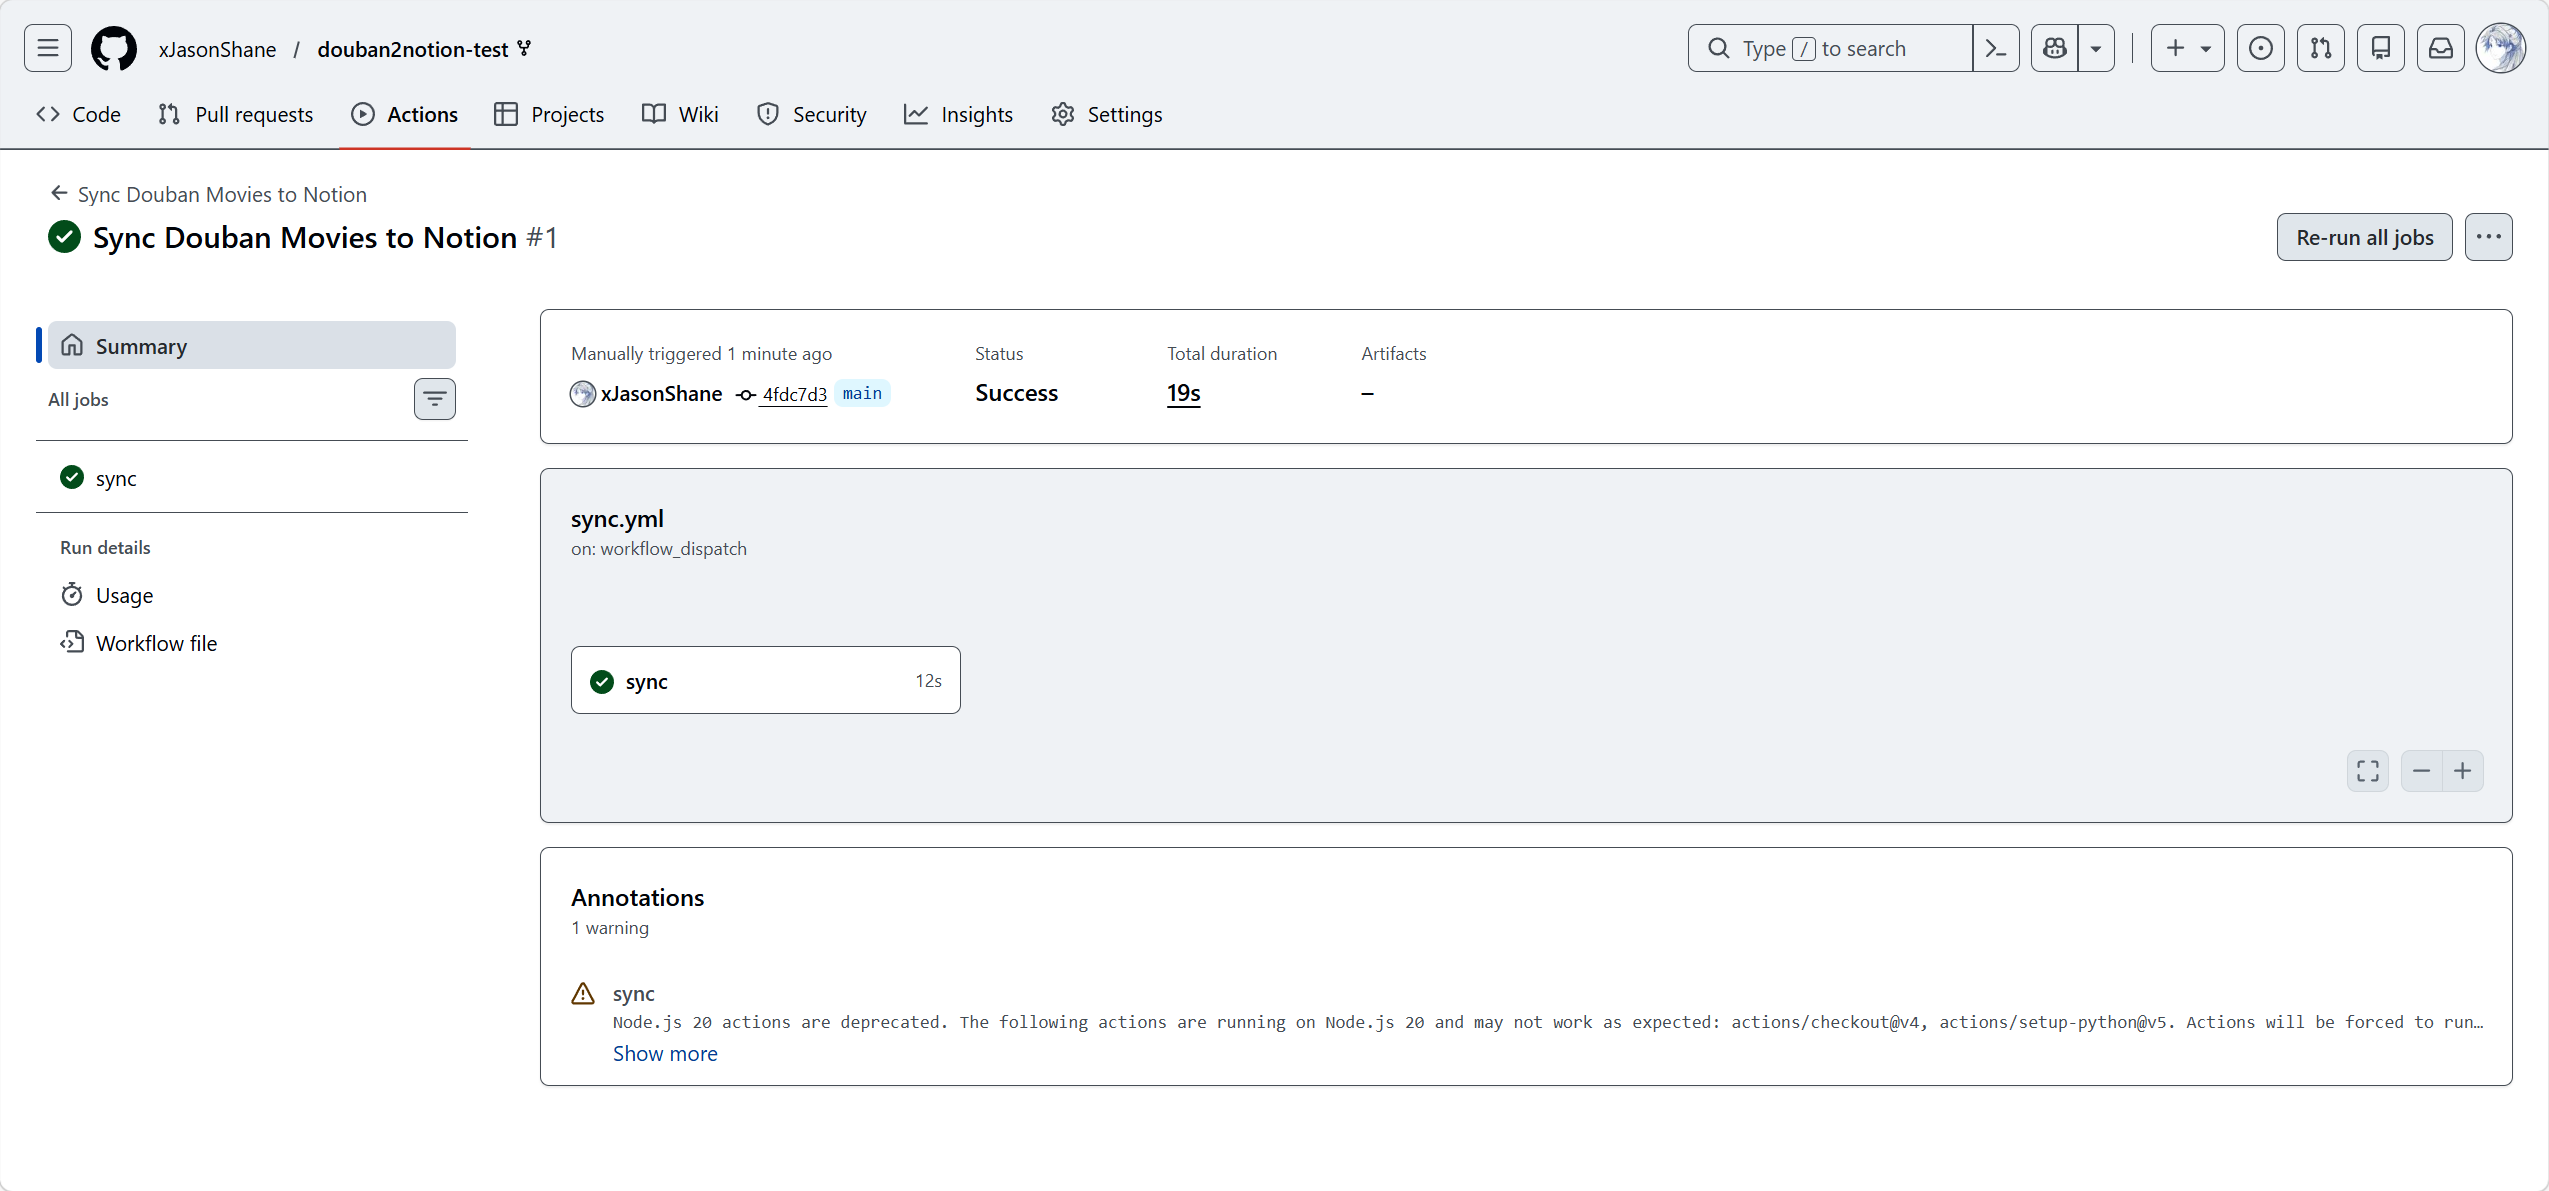
今天开一个“直播帖”,也是第一次记录一个项目从零开始开发的全过程,除平台账号注册、网页资料搜索等和开发过程核心相关性不大的步骤会省略外,整体开发过程将在本帖内“直播”可惜这个论坛没有办法和贴吧一样只看楼主~,当然也有可能失败。
项目核心需求:开发一个可以连通豆瓣平台与Notion平台的工具,使用户能够将自己豆瓣账号的观影记录一键复制到Notion的画廊数据库中。
涉及平台:
- Github
- Notion
- 豆瓣
今天开一个“直播帖”,也是第一次记录一个项目从零开始开发的全过程,除平台账号注册、网页资料搜索等和开发过程核心相关性不大的步骤会省略外,整体开发过程将在本帖内“直播”可惜这个论坛没有办法和贴吧一样只看楼主~,当然也有可能失败。
项目核心需求:开发一个可以连通豆瓣平台与Notion平台的工具,使用户能够将自己豆瓣账号的观影记录一键复制到Notion的画廊数据库中。
涉及平台:
豆瓣吗,有点意思
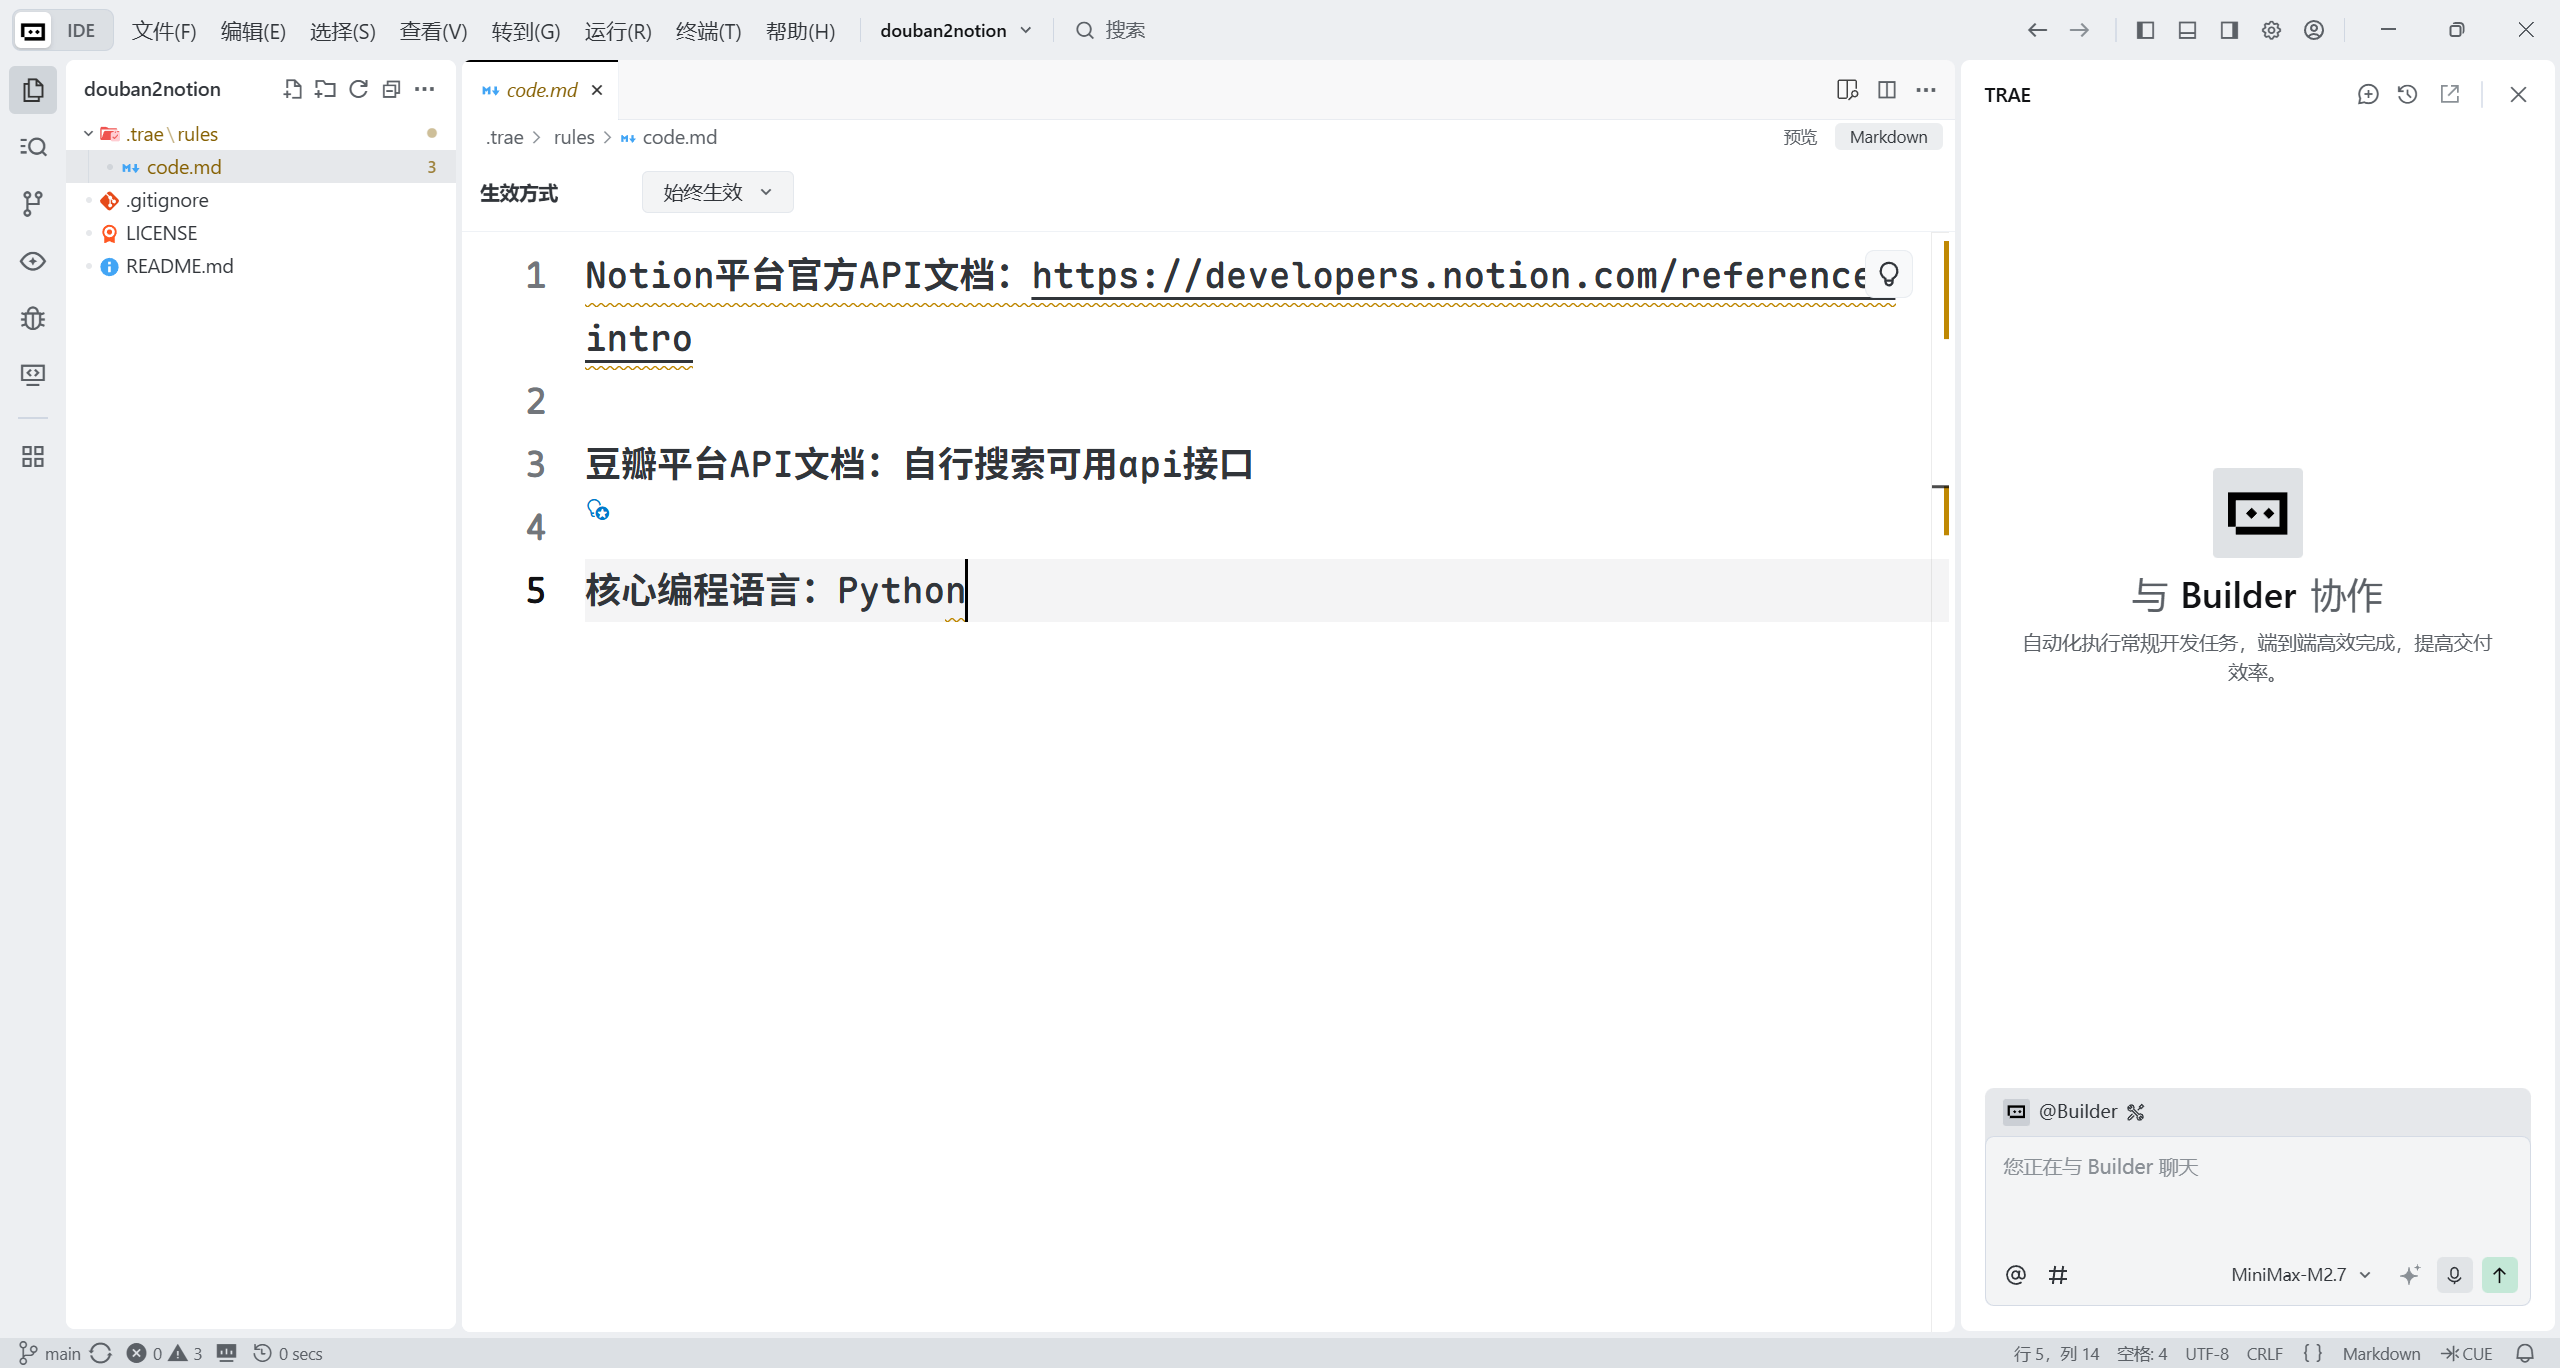
准备工作:
资料补充:
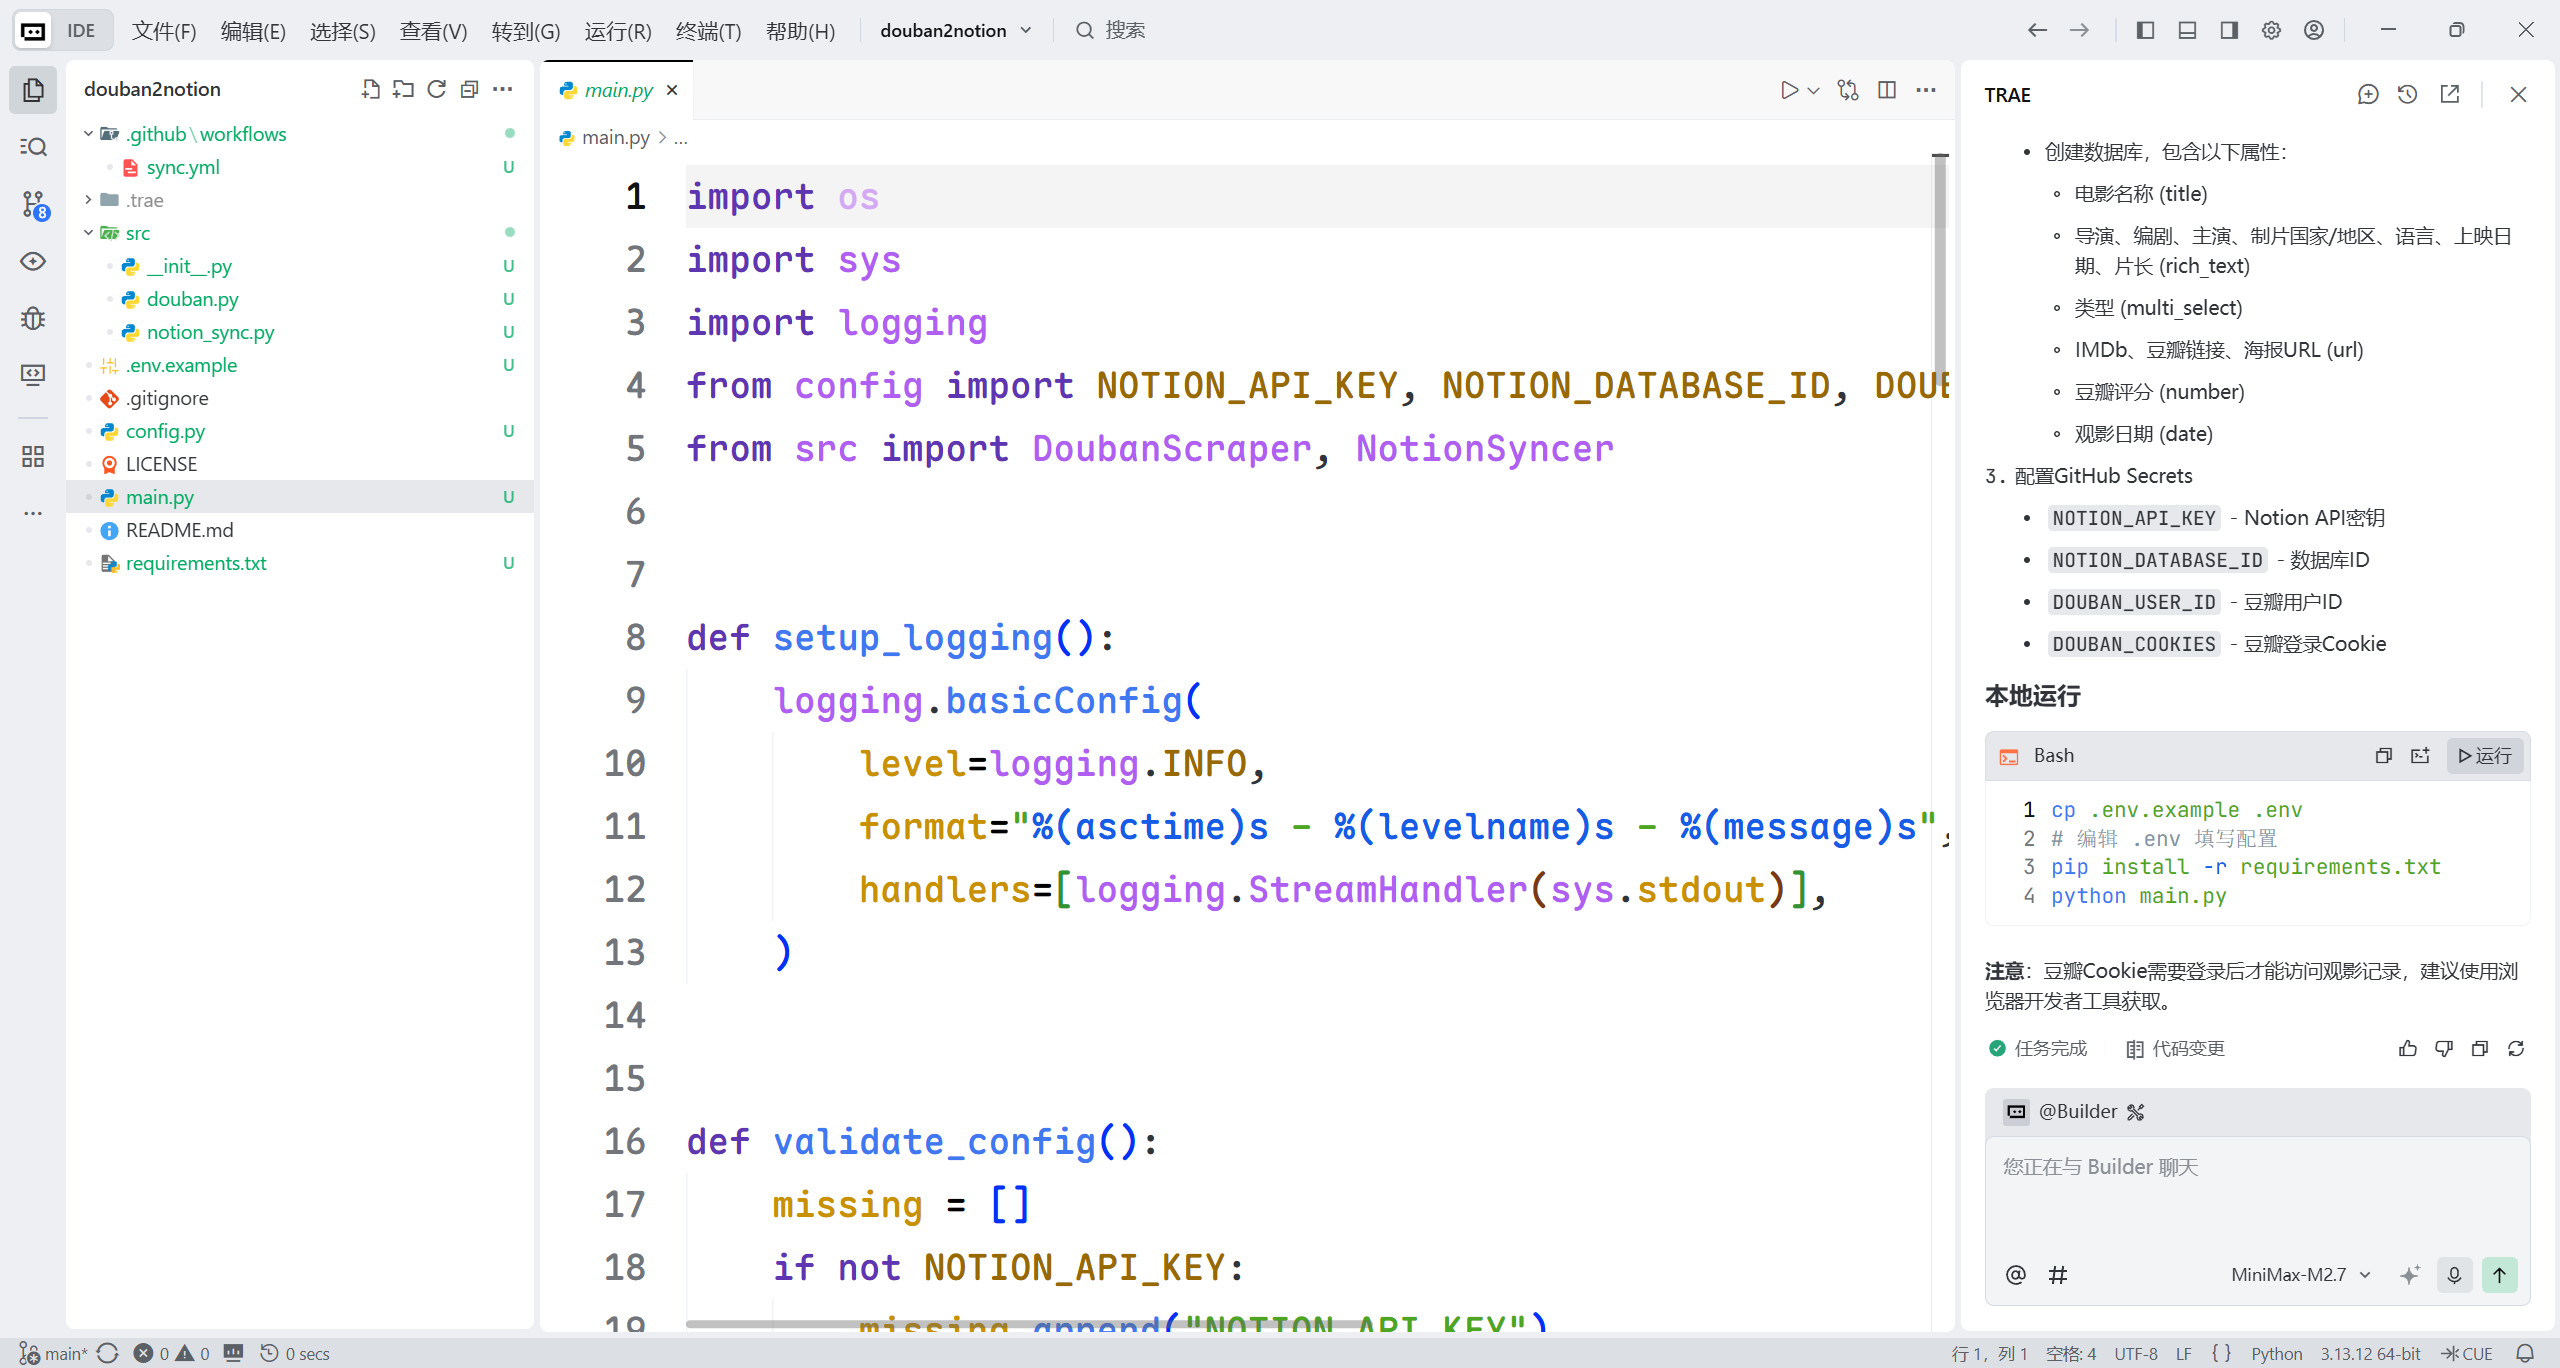
开发起步提示词
开发一个基于Python的豆瓣电影观影信息至Notion画廊数据库同步程序,具体要求如下:

1. 核心功能实现:
   - 开发Python程序,实现从用户豆瓣账号获取观影信息的功能
   - 实现将获取的电影信息同步至Notion画廊数据库的功能
   - 支持通过GitHub Actions实现自动化同步机制

2. 数据同步范围:
   - 必须包含的电影信息字段:电影名称、导演、编剧、主演、类型、制片国家/地区、语言、上映日期、片长、IMDb链接、豆瓣评分
   - 确保所有字段在Notion画廊视图中正确显示,并为每个字段选择最合适的Notion属性类型

3. 视觉呈现要求:
   - 配置Notion画廊视图,将卡片预览设置为页面封面
   - 实现自动抓取豆瓣电影海报URL并设置为Notion页面封面

4. 用户使用流程:
   - 用户Fork项目GitHub仓库后,通过填写环境变量配置个人账号信息
   - 环境变量应包括但不限于:豆瓣账号凭证、Notion API密钥、Notion数据库ID等敏感信息
   - 配置GitHub Actions工作流,实现定期或触发式同步机制

5. 技术实现要求:
   - 核心开发语言为Python,可根据需要使用其他辅助语言
   - 充分利用项目规则中提供的相关API文档
   - 合理调用可用的skill辅助开发过程
   - 代码结构清晰,包含必要的注释和文档

6. 开发优先级:
   - 优先实现完整的功能流程,确保数据能够正确同步
   - 功能稳定后,可根据后续需求进行优化调整和功能扩展

7. 质量保障:
   - 实现必要的错误处理机制,确保程序稳定性
   - 添加日志记录功能,便于问题排查
   - 确保用户凭证等敏感信息的安全处理
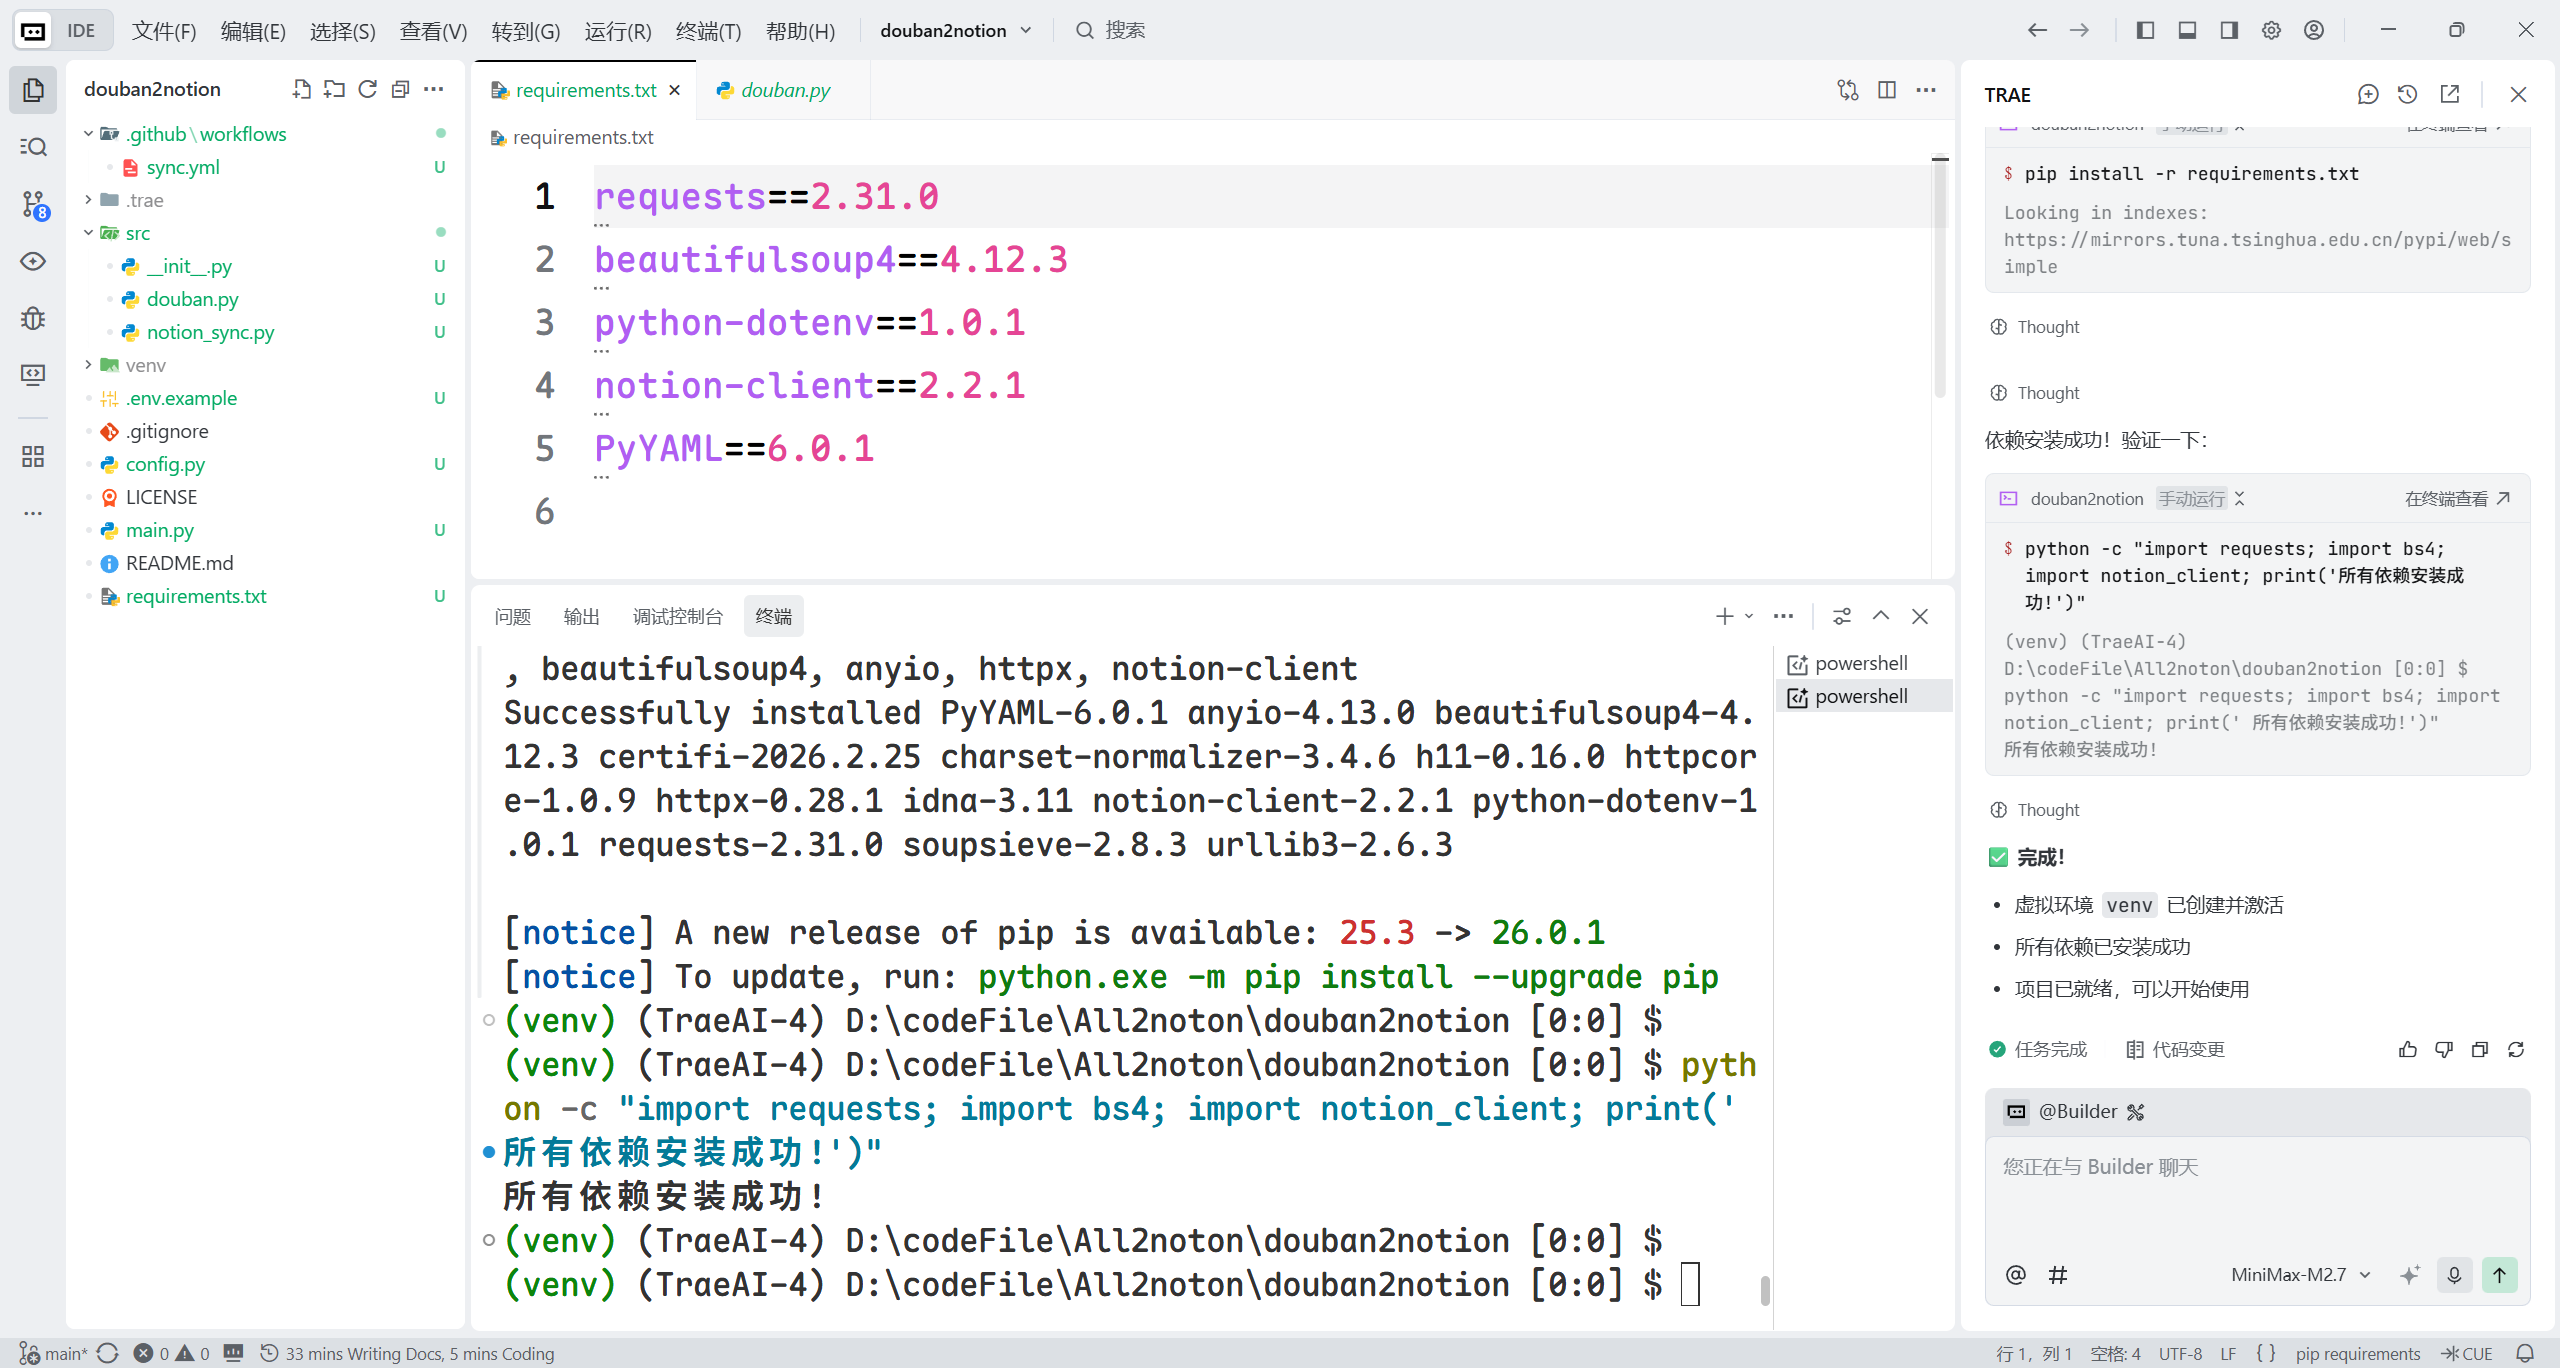
把自己当做小白,让AI撰写README和部署说明书文档,检查逻辑步骤是否正确,把不对的地方继续交给AI处理,最终形成当前状态下项目的说明文档
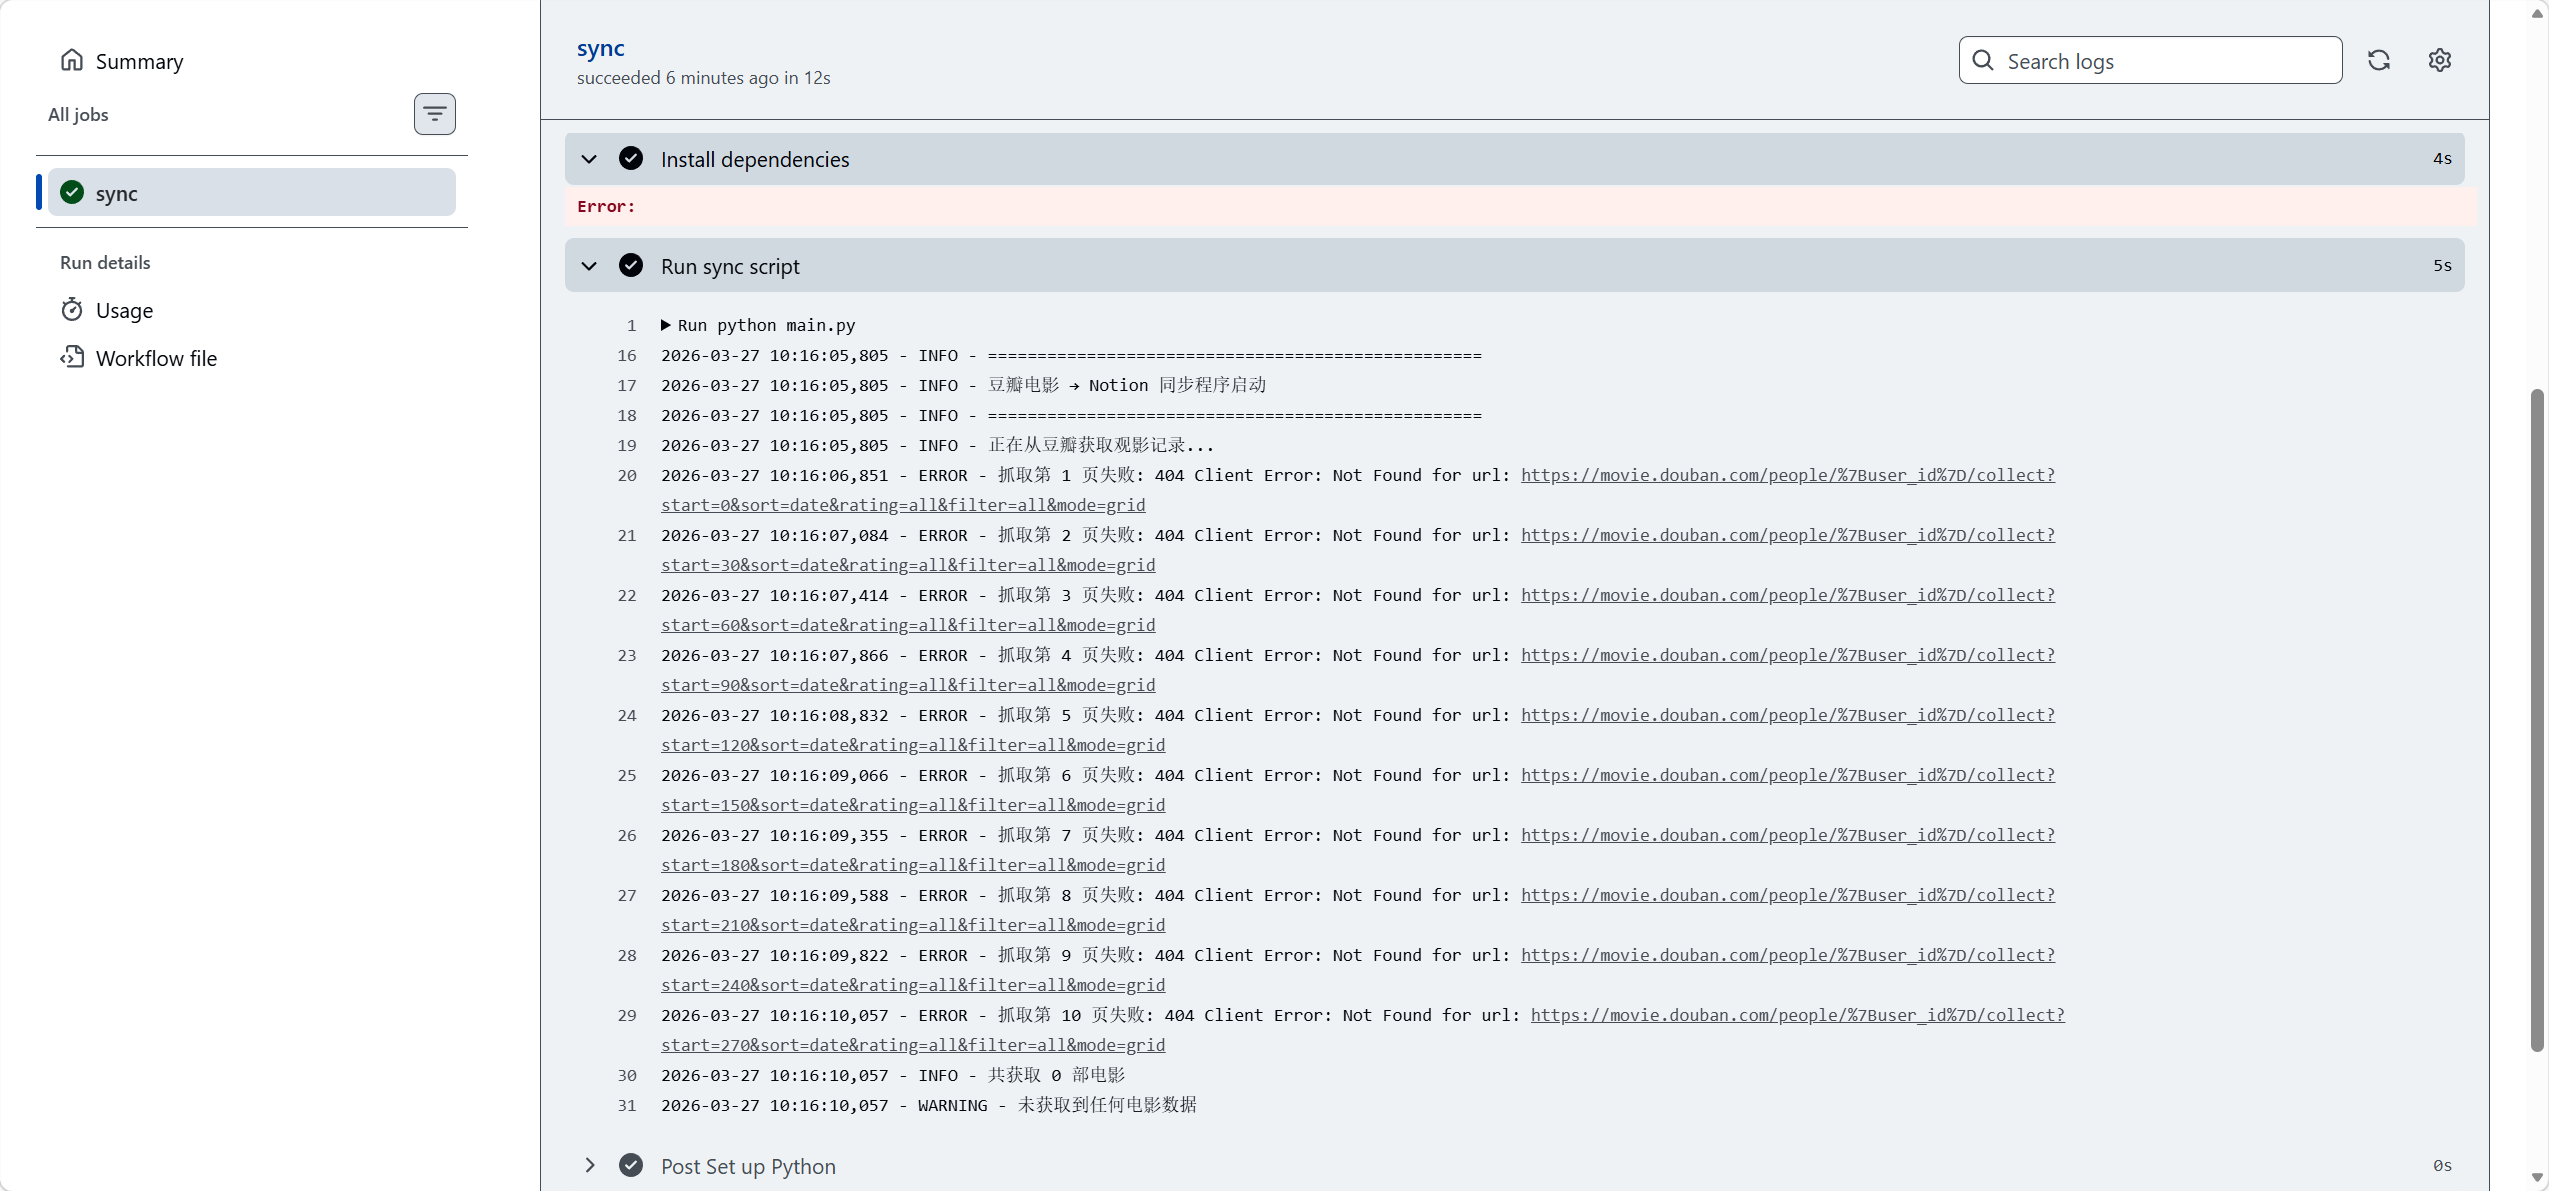
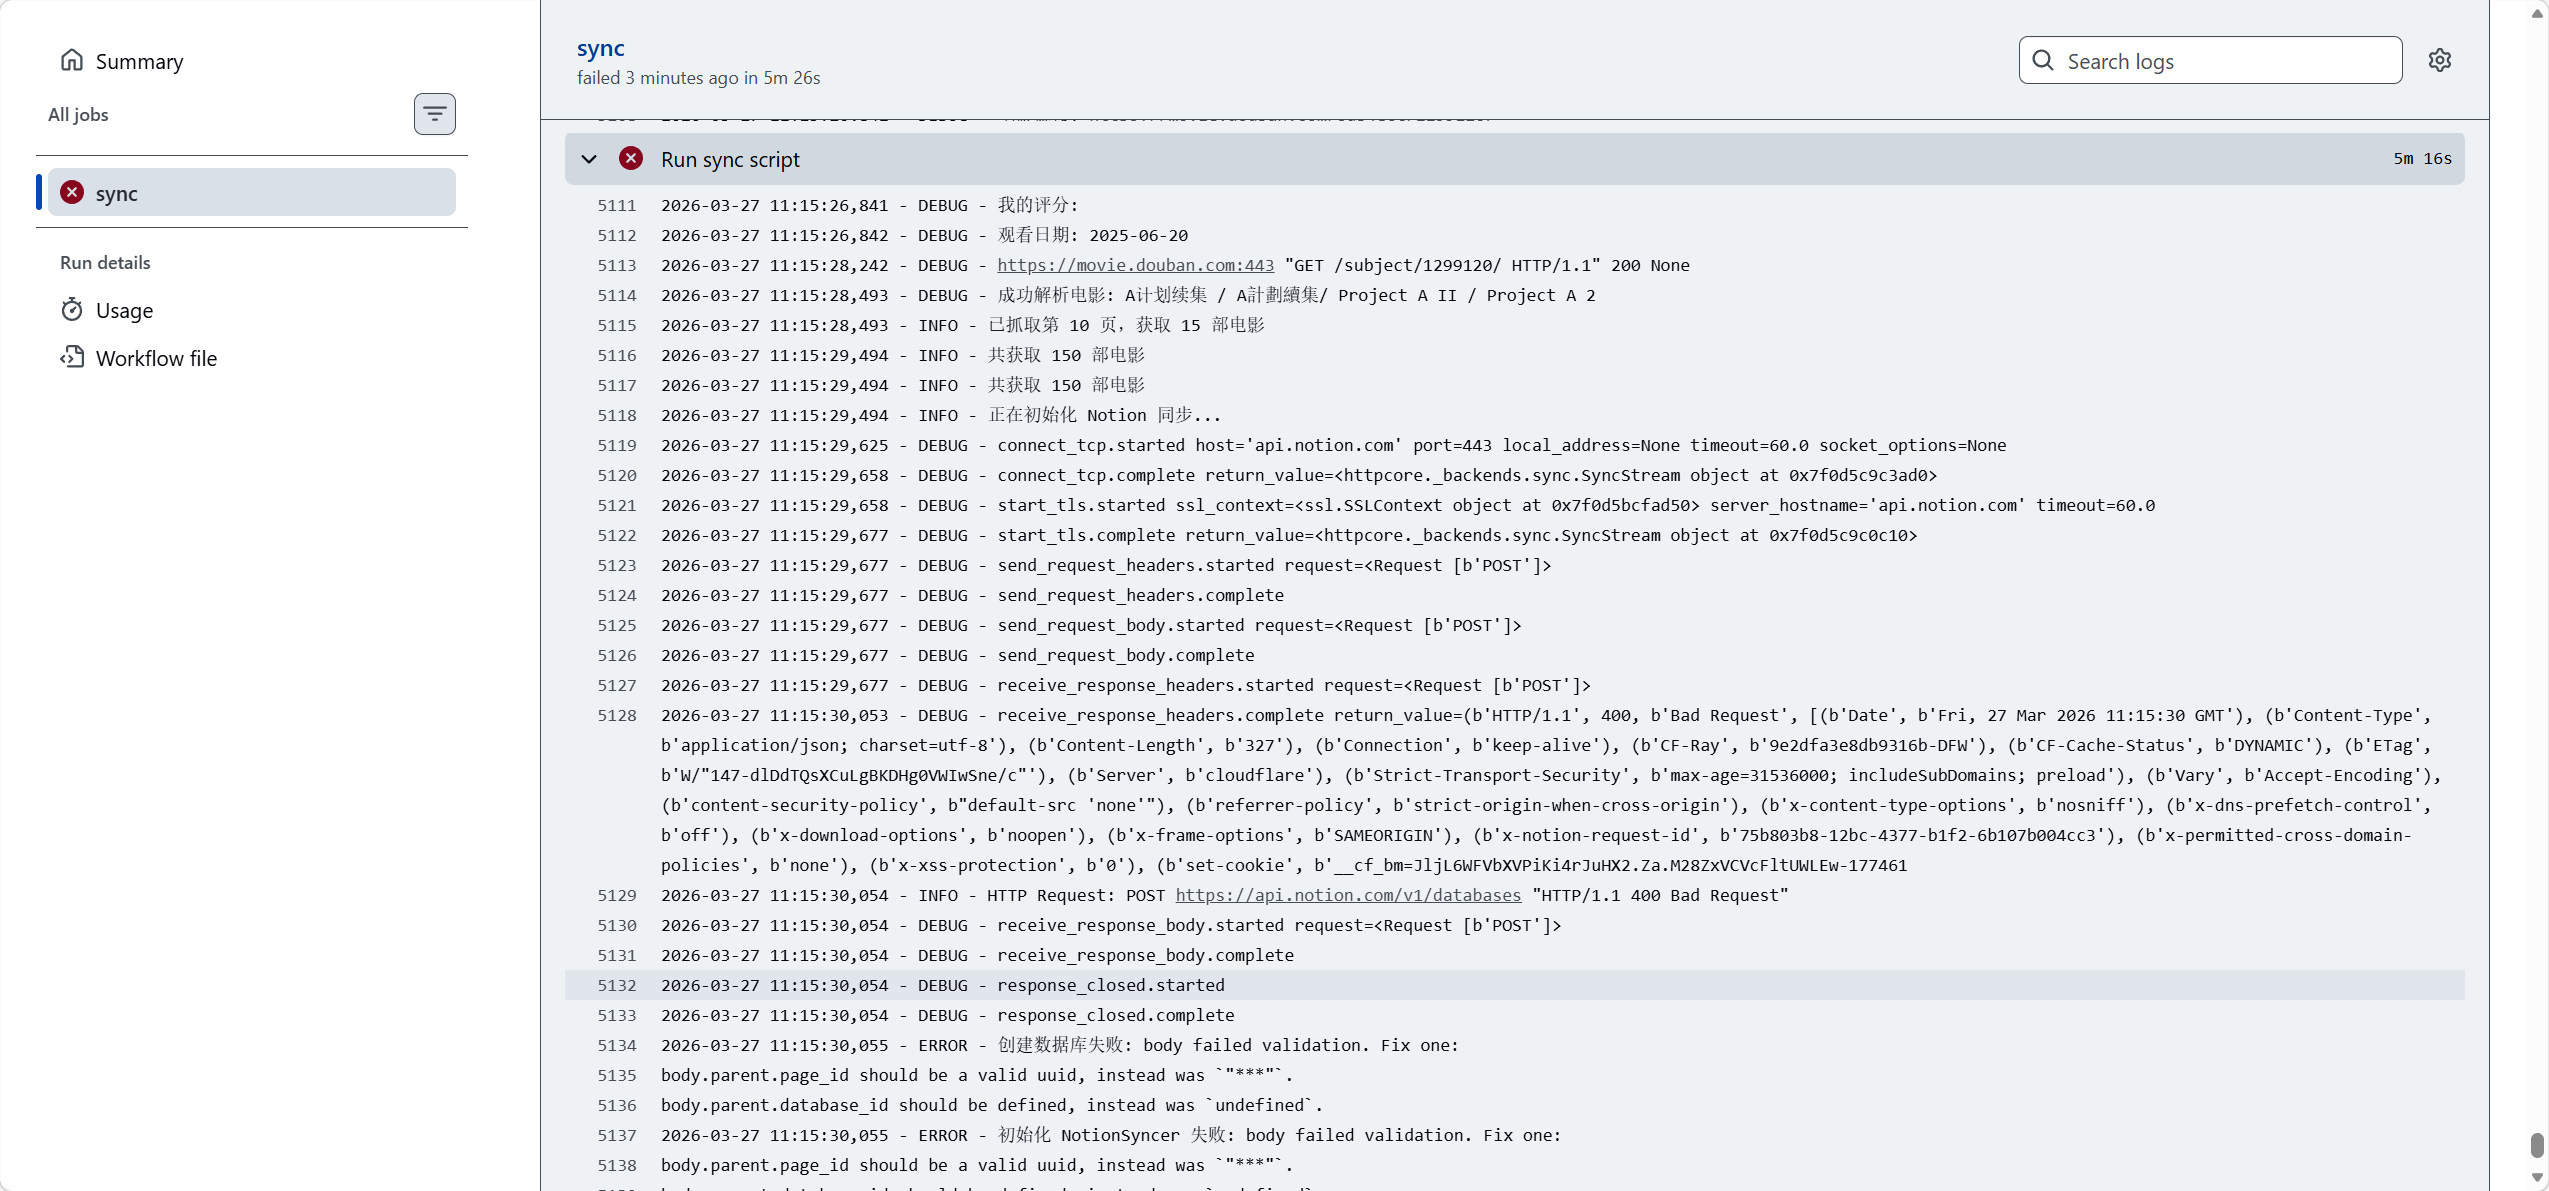
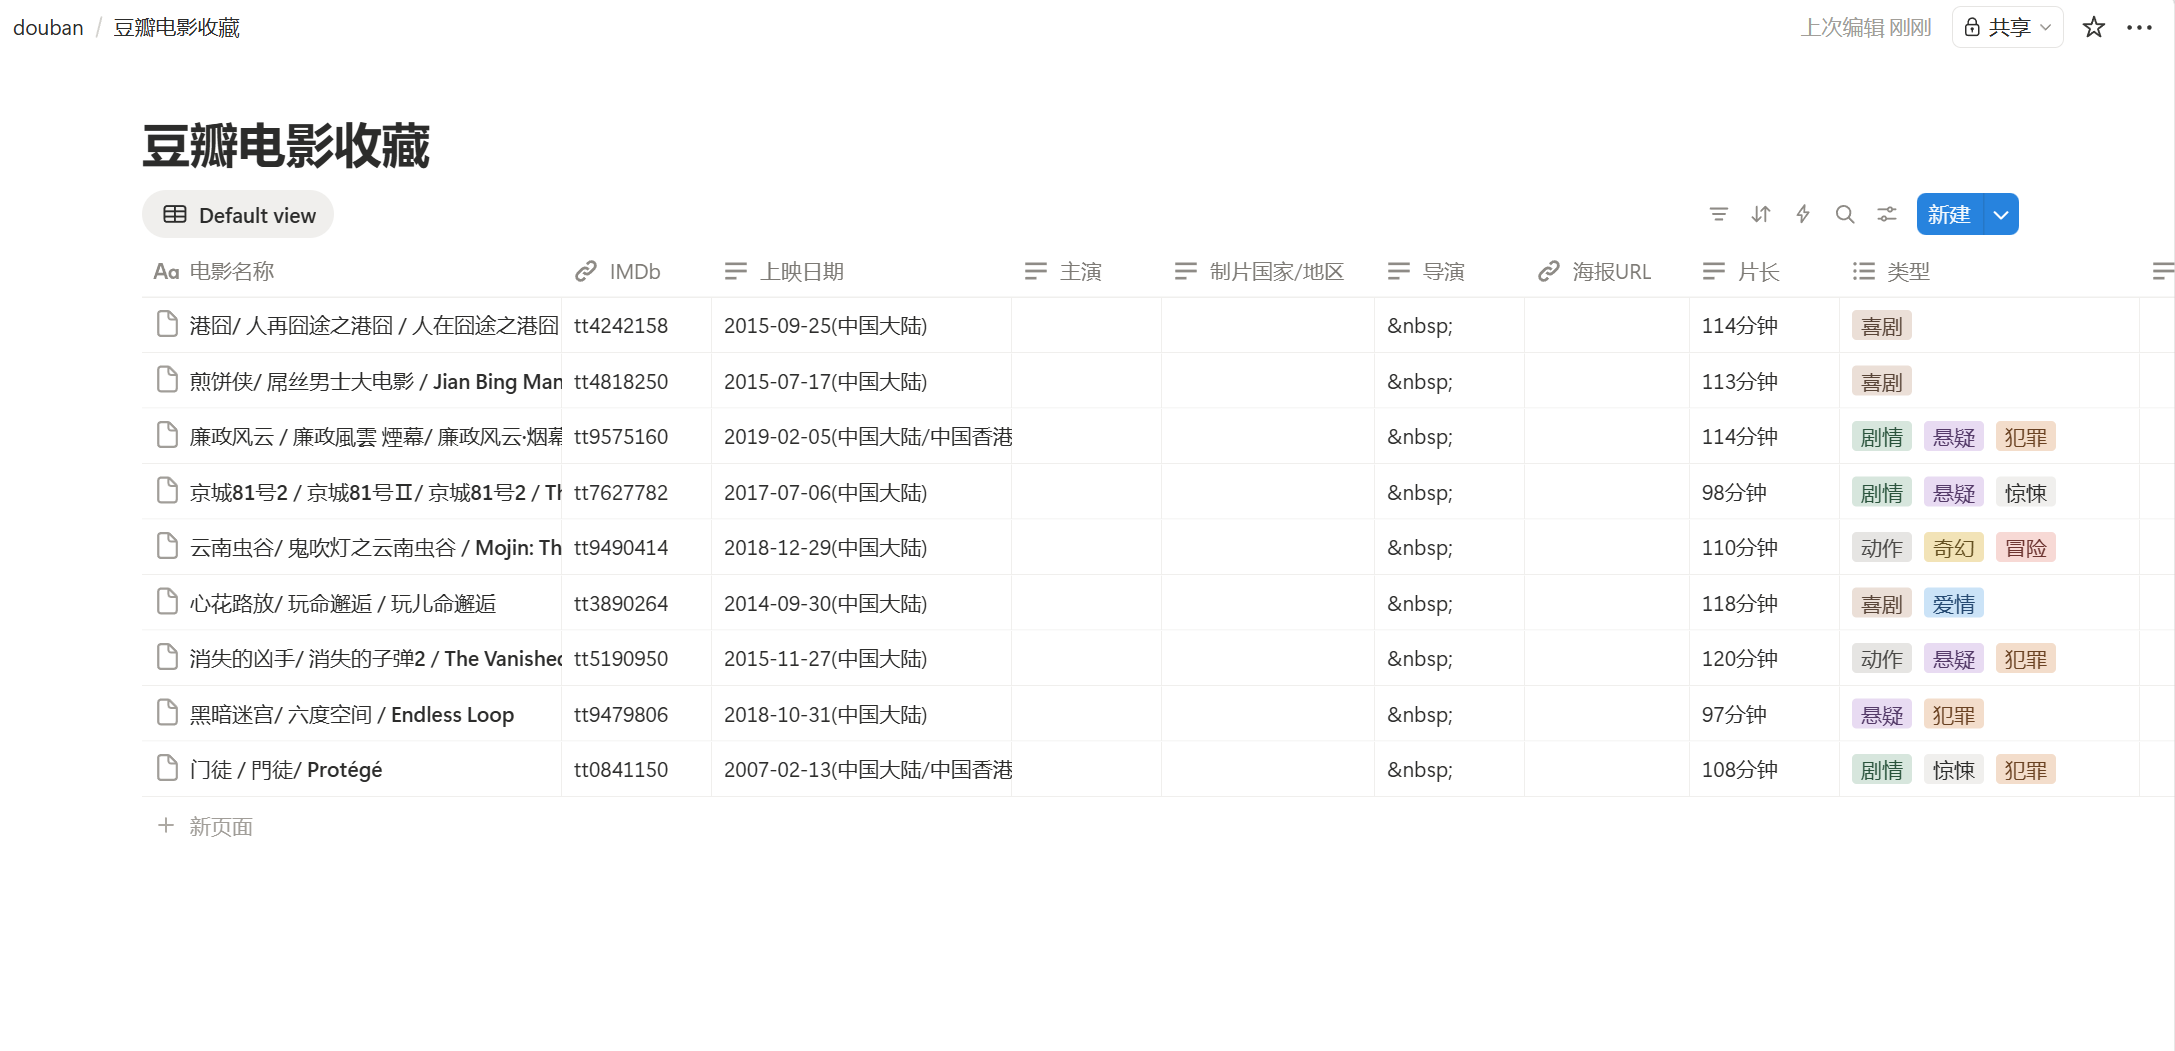
经过排查,目前核心问题在豆瓣端,由于没有官方的API接口,数据获取存在大问题,并且整个流程需要用户操作地方过多,目前集中修复该问题
学到了 学到了 大佬