本手册面向三类读者:使用者(第 1–6 章)、产品/运营(第 7–8 章)、部署运维(第 9–10 章)。
1. 这是什么
费曼实验课 —— 每天 10 个话题,随机抽一个,裸讲一遍,让 AI 当那个"听不懂的外行"给你打分。
它不是知识学习 App,不给你上课,不推送文章,不让你划重点。它是一个输出倒逼输入的理解力训练器:你以为你懂了,那就讲一遍;讲不明白的地方,就是你没真懂的地方。
1.1 一句话区分
| 它是 | 它不是 |
|---|---|
| 一面照出"理解缺口"的镜子 | 一个装知识的容器 |
| 每天 10 分钟的口头输出训练 | 打卡签到工具 |
| 让 AI 扮演外行听众挑刺 | 让 AI 当老师讲给你听 |
1.2 适合谁
-
备考学生:每天碎片时间练一个概念,治"解释性深度错觉"——看书全懂,合上书讲不出。
-
职场新人:快速上手新业务、新领域,检验自己能不能用大白话给客户讲清楚。
-
内容创作者:找选题、练表达,建立"讲给外行听"的高频反馈回路。
-
任何"学过就忘"的人:如果你学完一个东西三天后只剩模糊印象,那不是记忆力问题,是从来没真正讲通过。
1.3 产品名与调性
为什么叫"实验课":讲错不是失败,是拿到了实验数据。修正后再来一轮,这是实验的正常流程。命名刻意回避了"考试"“测验”“打卡”,降低挫败感。
Slogan:讲不明白,就是没搞懂。
全站 UI 隐喻统一,界面文案不出现"学习"“课程”"答题"等字眼:
| 通用说法 | 本产品叫法 |
|---|---|
| 首页 | 实验台 |
| 题目列表 | 今日课题 |
| 答题输入 | 裸讲 / 第 N 轮讲述 |
| 评分结果 | 实验报告 |
| 练习历史 | 实验记录本 |
| 结业成果 | 实验产出 |
2. 核心理念:为什么这么设计
2.1 费曼四步
产品流程严格对应费曼学习法的四个动作:
-
选定目标 → 从今日课题里挑一个概念
-
讲给小孩 → 不查资料,用大白话裸讲一遍
-
定位卡点 → AI 以外行视角圈出讲不通的地方
-
简化打磨 → 针对卡点补课后重讲,直到流畅
2.2 底层规律:合意困难 + 生成效应
-
生成效应:自己从记忆里"生成"出来的内容, retention 远高于重复阅读。所以产品逼你先讲,再给反馈。
-
合意困难:学习过程必须有一点费力,这种费力是"合意的"——它慢,但记得牢。所以产不给现成答案。
这两条不是玄学,是产品所有"反直觉设计"的总依据。当你觉得"直接告诉我答案不好吗"的时候,答案就是:不好,那样你会忘得更快。
2.3 铁律:不给答案(以及它的精确含义)
这是产品最容易被误解的一条设计。它不是"什么都不给",而是把"给不给答案"变成了"什么时候给、给到哪一层"——详见第 5 章《分层提示机制》。
3. 五分钟上手
-
打开 http://58.87.96.207:83/ ,进入实验台
-
点击琥珀色按钮 「开始随机实验 →」,系统从今日 10 条里随机抽一个课题
(也可以从下方编号列表里自己挑一条,点击即可)
-
进入裸讲页。看到课题和一句话背景后,不要查资料,凭现有理解把它讲明白
- 键盘直接打字,或点麦克风用语音说(Chrome / Edge 支持,说完可编辑转写结果)
-
点 「提交 · 交给外行打分」,等待约 10–30 秒
-
拿到实验报告:总分、等级、四维雷达图、卡点清单
-
若等级是 中 / 差,对着卡点补一课,点 「修正重讲」 再来一轮(最多 5 轮)
-
拿到 良 / 优 → 进入结业产出页,导出你的 300 字小科普
第一次用建议:别挑最难的课题。选一个你"大概懂"的,你会更真实地感受到卡点在哪。
3.1 一次完整实验长什么样
以「复利」为例,走一遍真实流程:
第 1 轮(裸讲):“复利就是长期坚持一件事就会有结果。比如每天存 20 块钱,十年后会变很多钱,因为它会复利。”
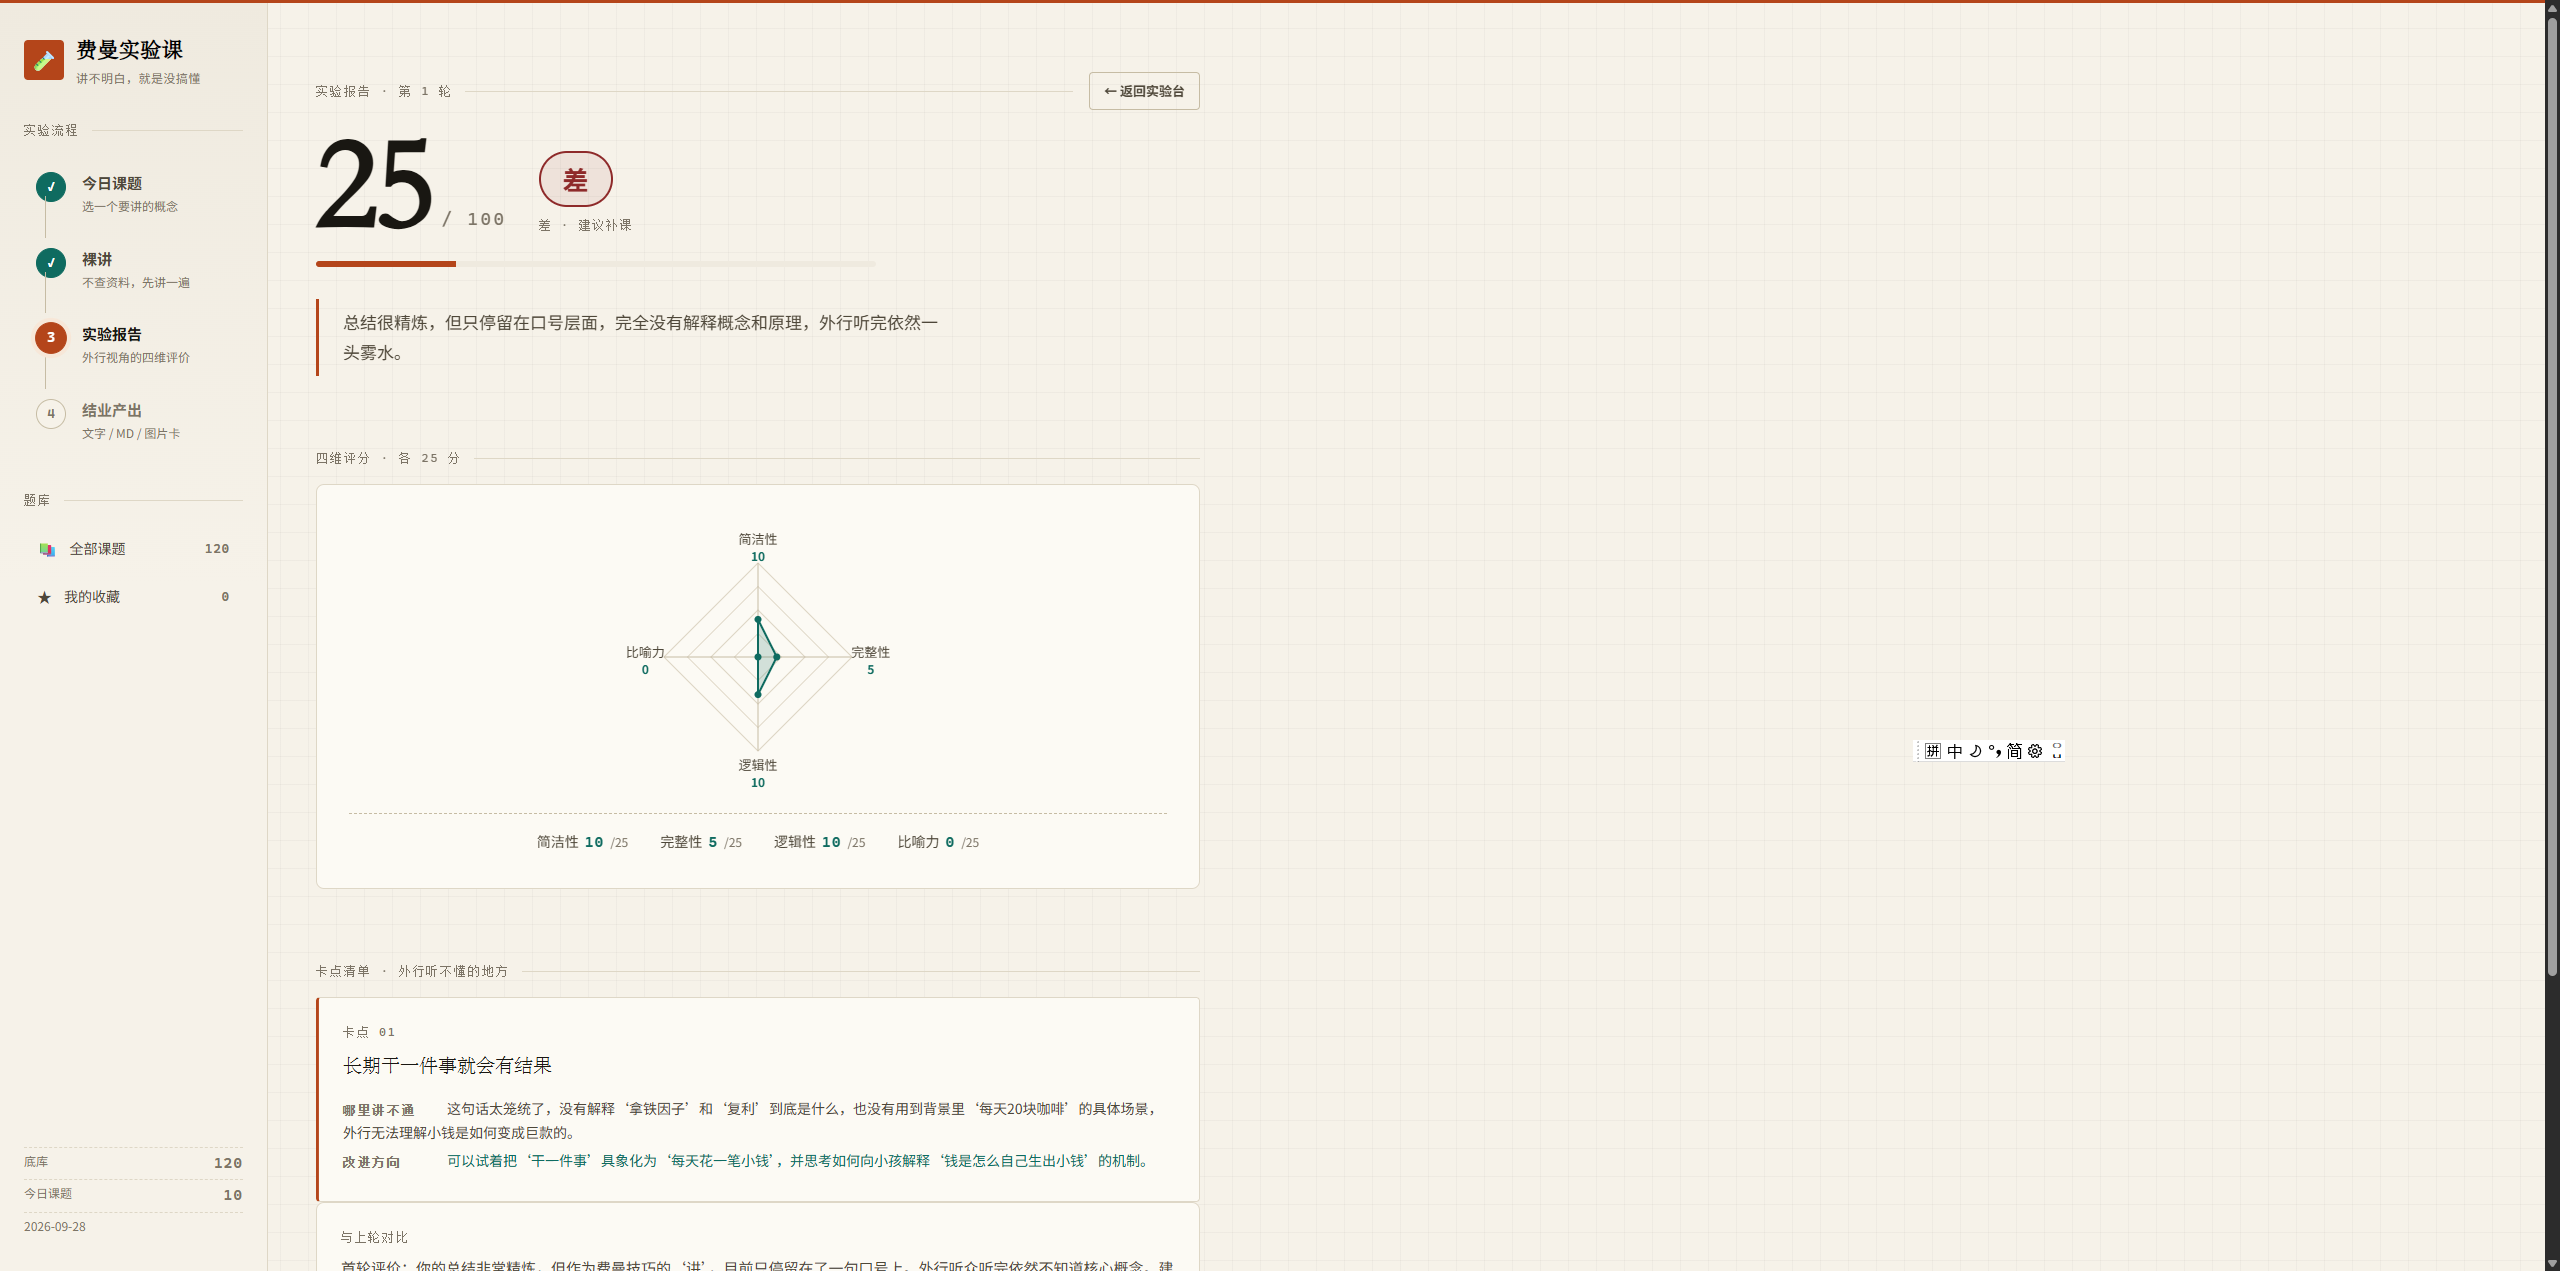
第 1 轮报告:25 分 / 差。标出 2 个卡点——
-
卡点 01:把"复利"等同于"长期坚持",没点出"利息生利息"的核心机制
- L2 结构提示:① 点出复利和普通简单累加的核心区别 ② 解释多出来的那部分收益是怎么产生的
-
卡点 02:用"因为它会复利"解释"为什么变很多钱",是循环论证
-
L2 结构提示:① 说明本金如何产生第一笔利息 ② 解释利息如何变成新本金继续生息
第 2 轮(补课重讲):补了"利滚利"的说法,加了滚雪球类比 → 68 分 / 中(触发边界分二次评价,复评后取中)。
第 3 轮:卡点仍在,点开 L3 一句起头 「想象一下,你的钱不仅自己会下崽,它下的崽长大了还会继续下崽……」,顺着讲透 → 79 分 / 良,结业。
结业产出:300 字小科普 + 四维雷达图卡片;点开 L4 标准示范对照,发现自己漏讲了"收益必须再投入"这个前提。
从差到良用了三轮,全程约 12 分钟。这就是一个完整实验。
4. 界面导览
页面左侧是固定的导航轨,从上到下分为四块:
-
品牌区(
 费曼实验课):任何时候点击它 = 回到实验台
-
实验流程:今日课题 → 裸讲 → 实验报告 → 实验产出,四步指示器,当前步高亮,已完成打勾
-
题库:全部课题(显示底库总数)、我的收藏(显示收藏数)
-
底部统计:底库条数(可点击,直接进题库)、今日课题数、当天日期
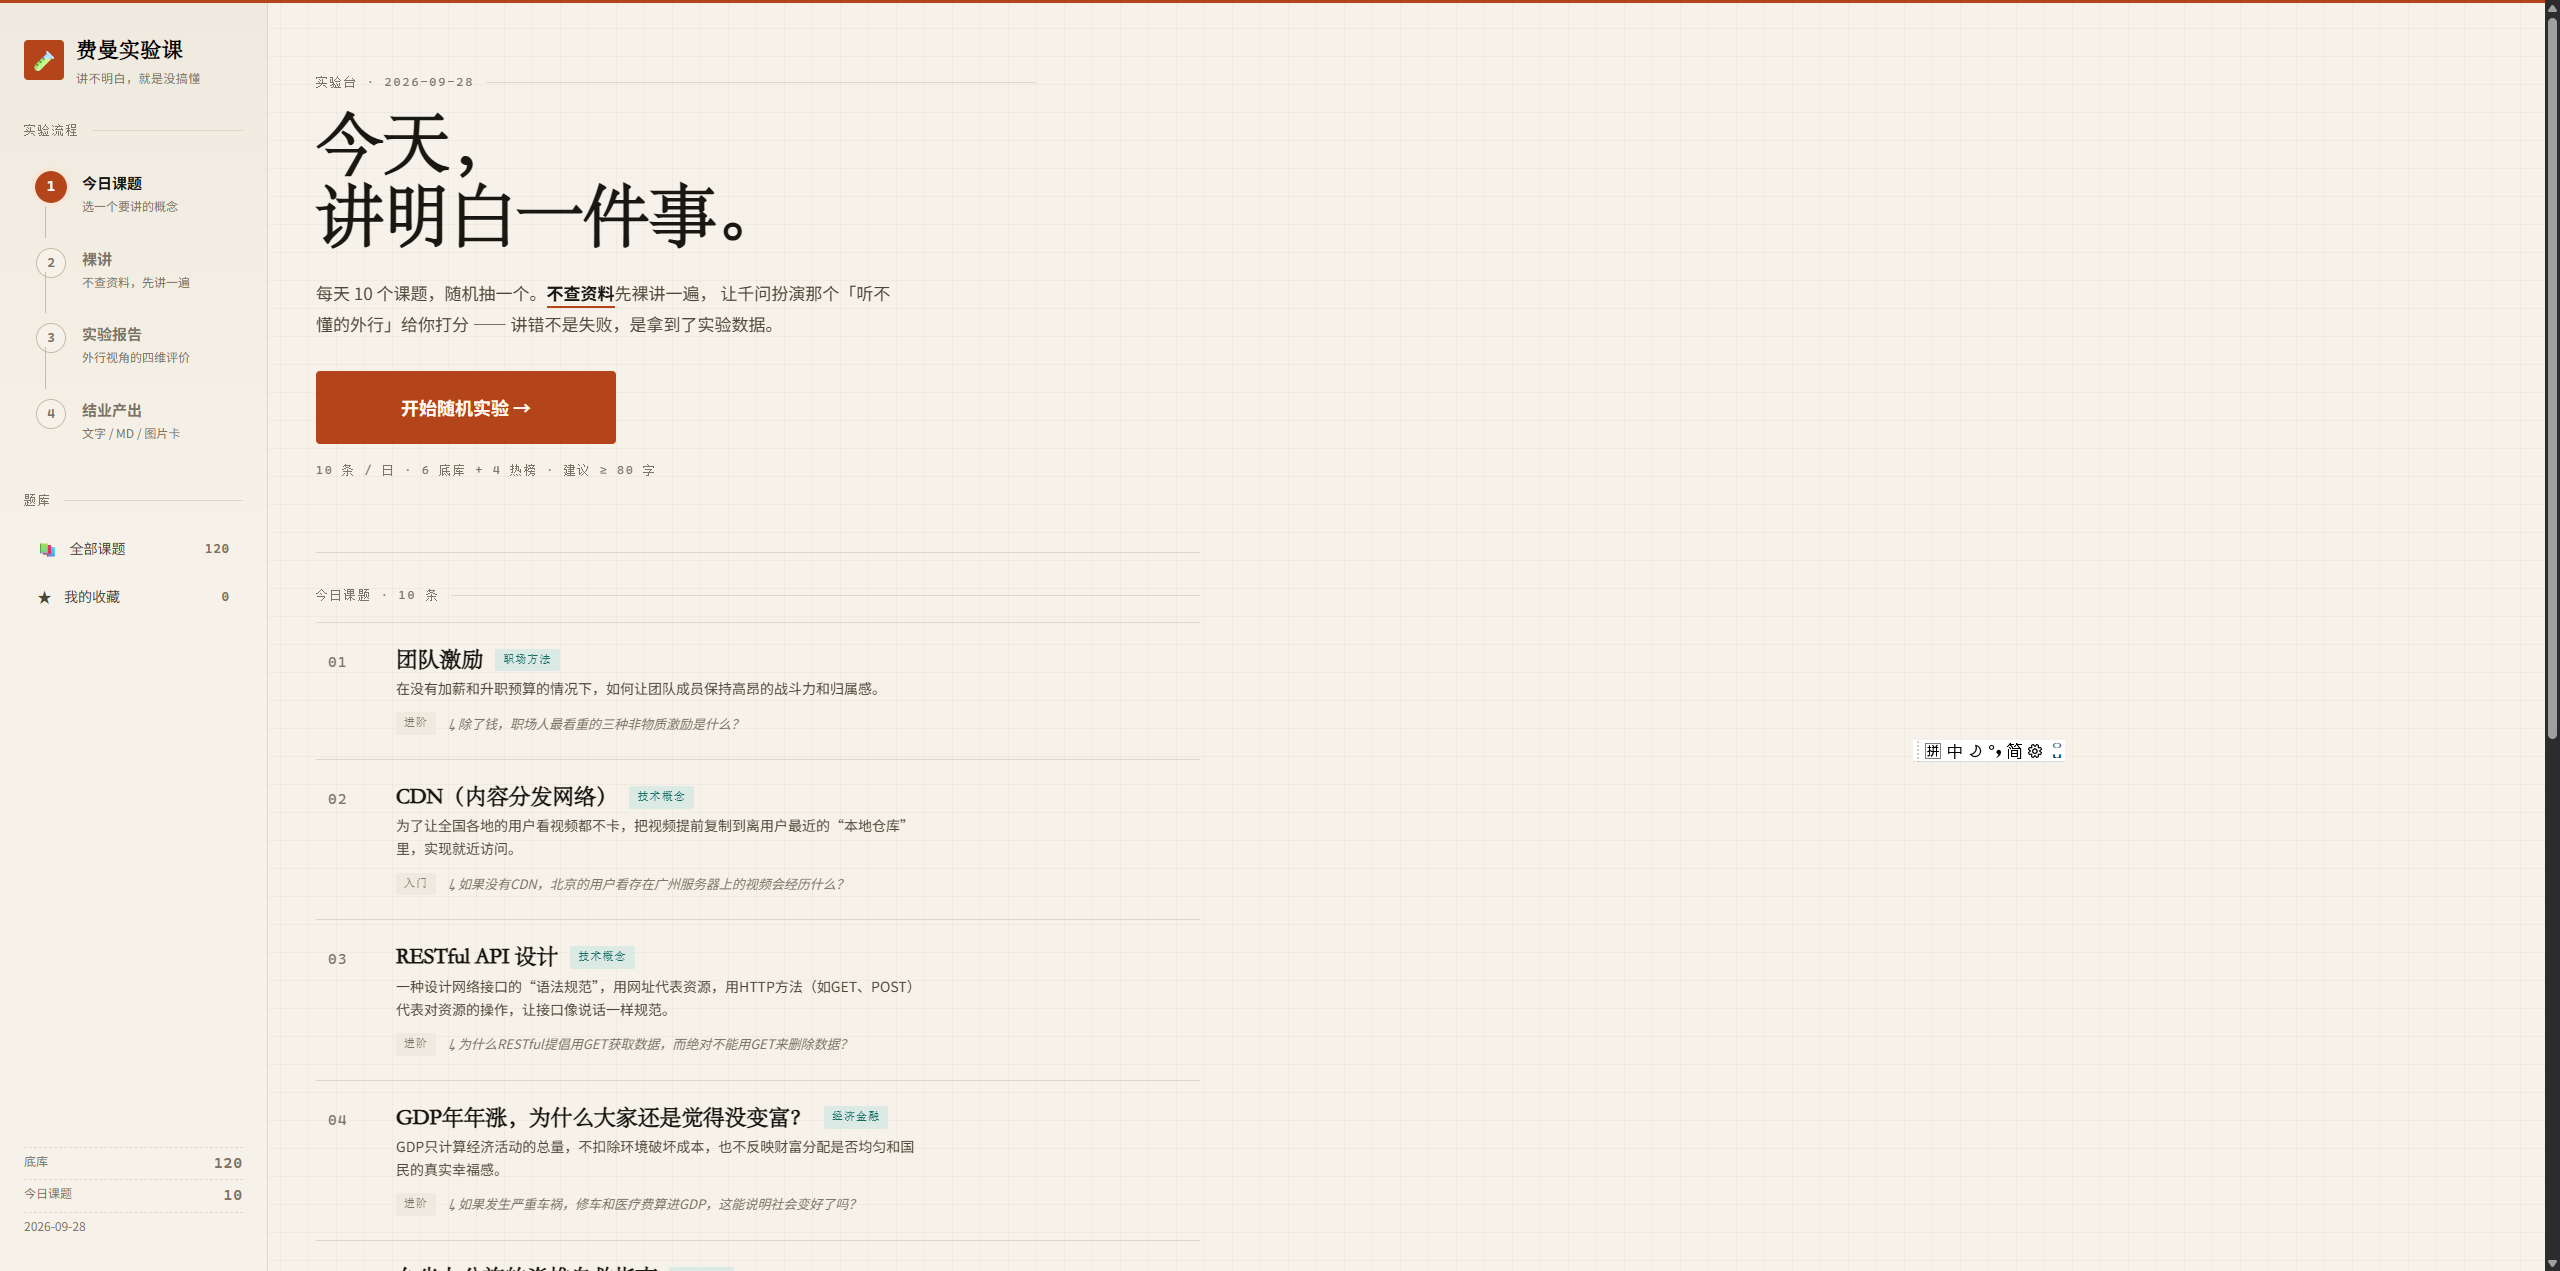
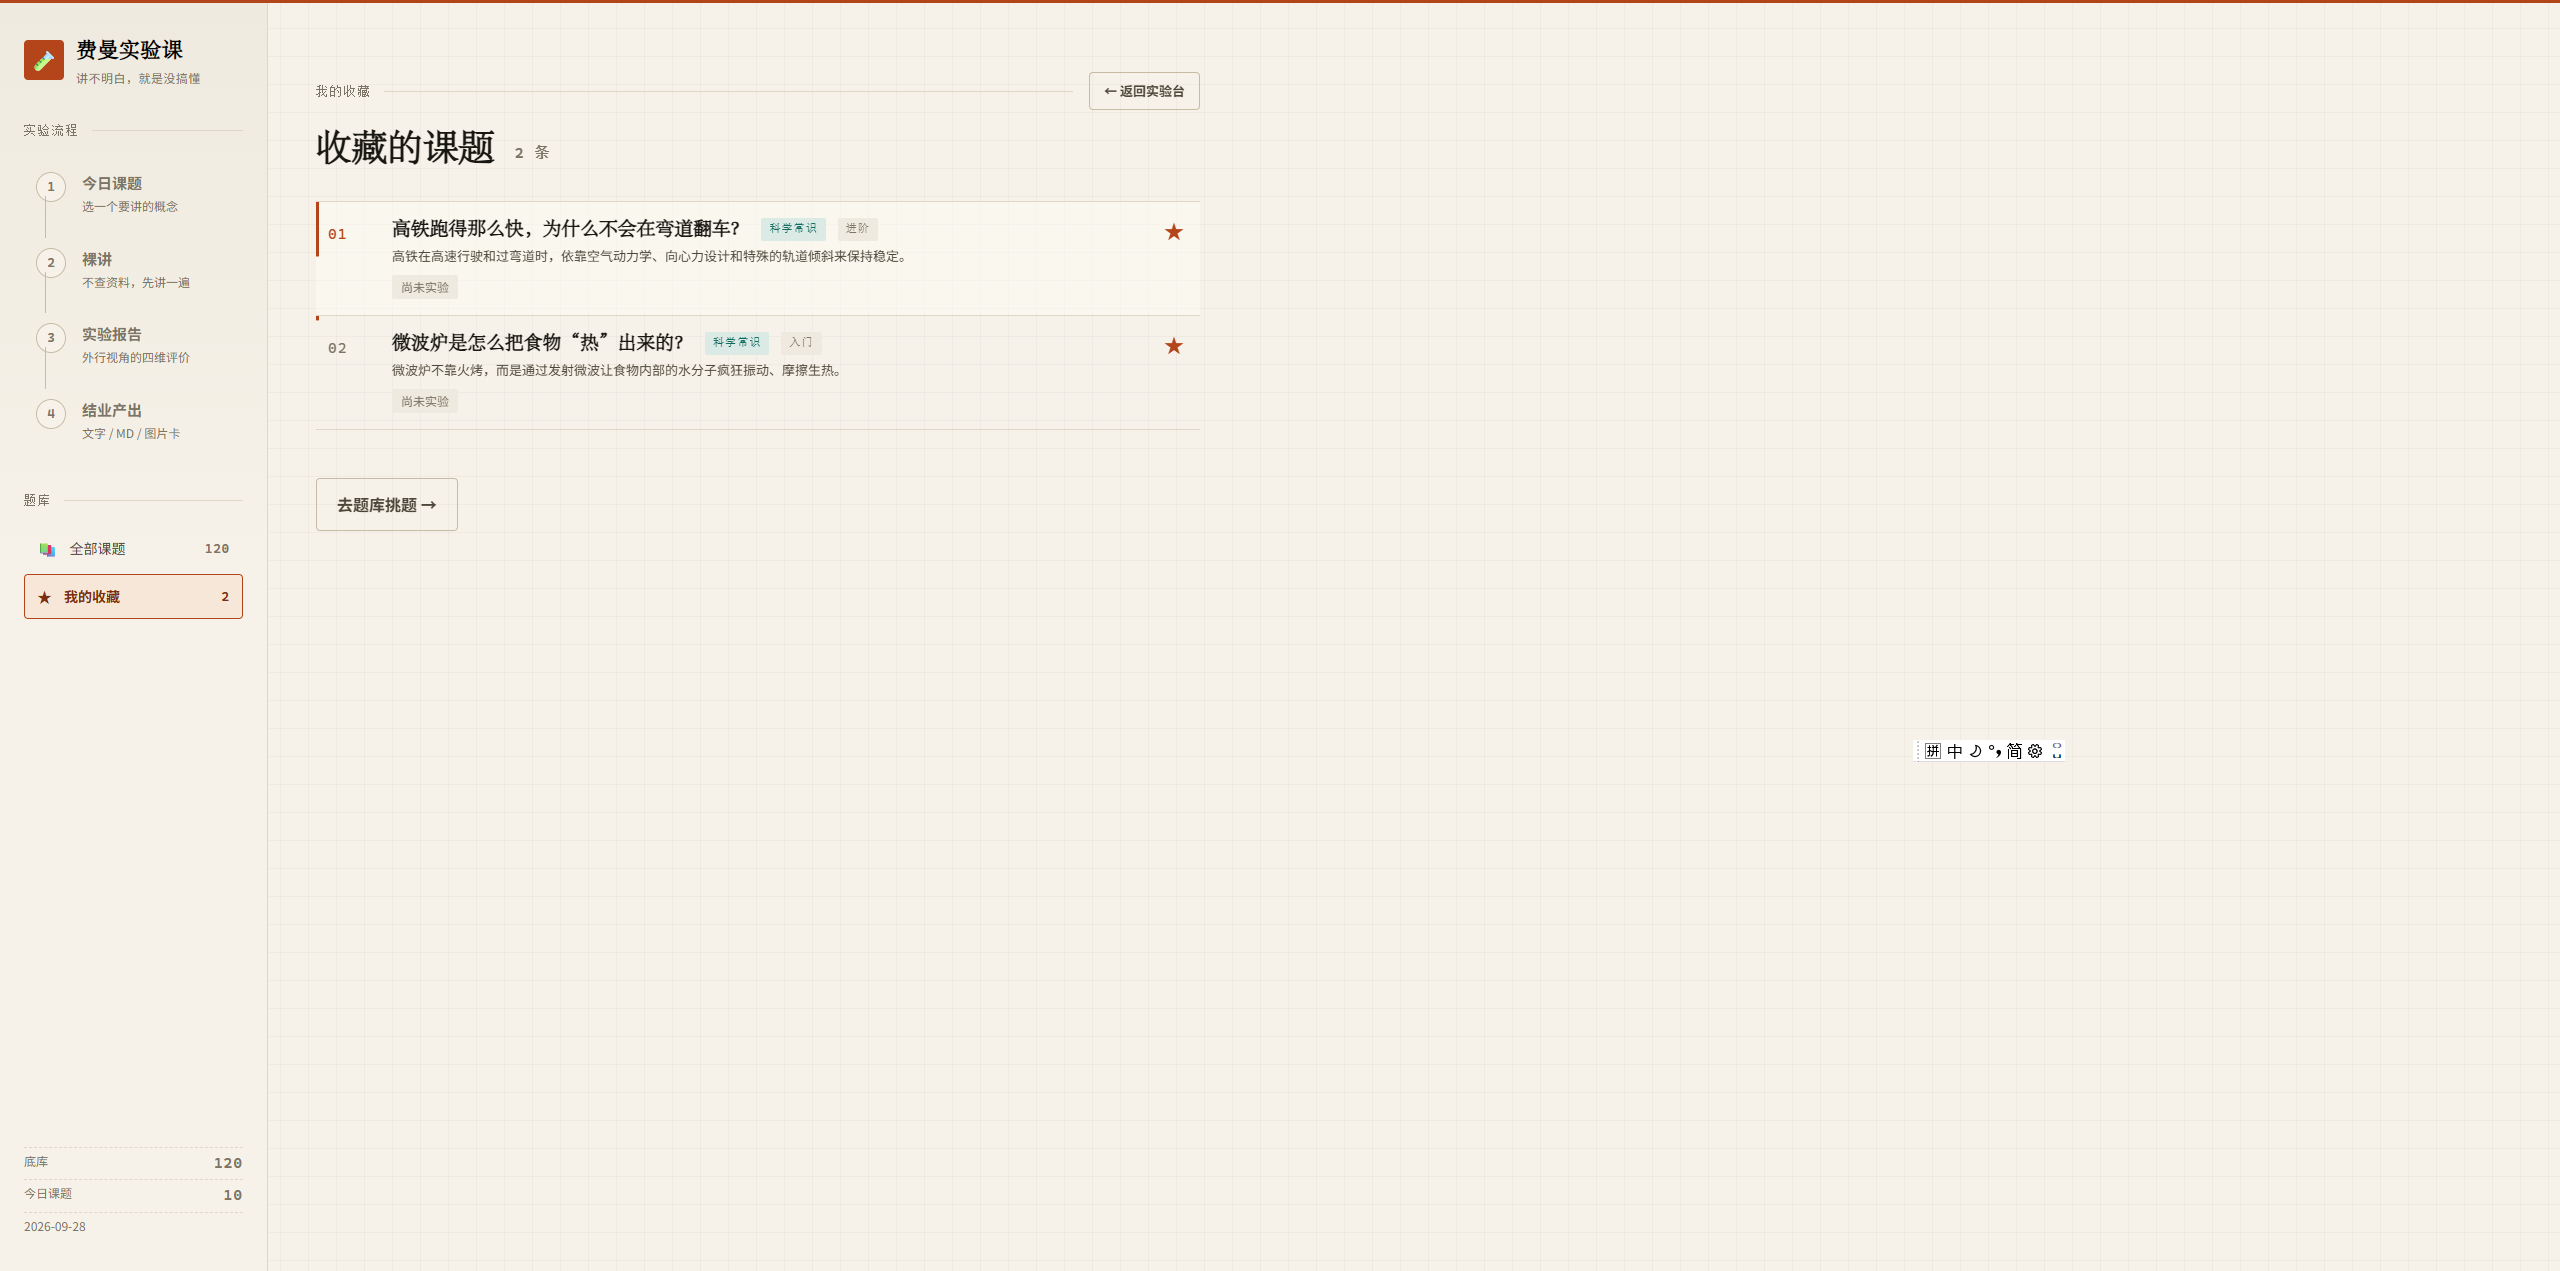
主区随流程切换,共六个页面:
| 页面 | 作用 |
|---|---|
| 实验台 | 首页。一句话主张 + 随机开讲 CTA + 今日 10 条编号索引 |
| 裸讲 | 输入页。课题、背景、引导问题、大输入框、语音按钮 |
| 实验报告 | 评价页。总分、等级、雷达图、卡点清单、修正入口 |
| 实验产出 | 结业页。你的正文预览 + 四种导出 + 标准示范 |
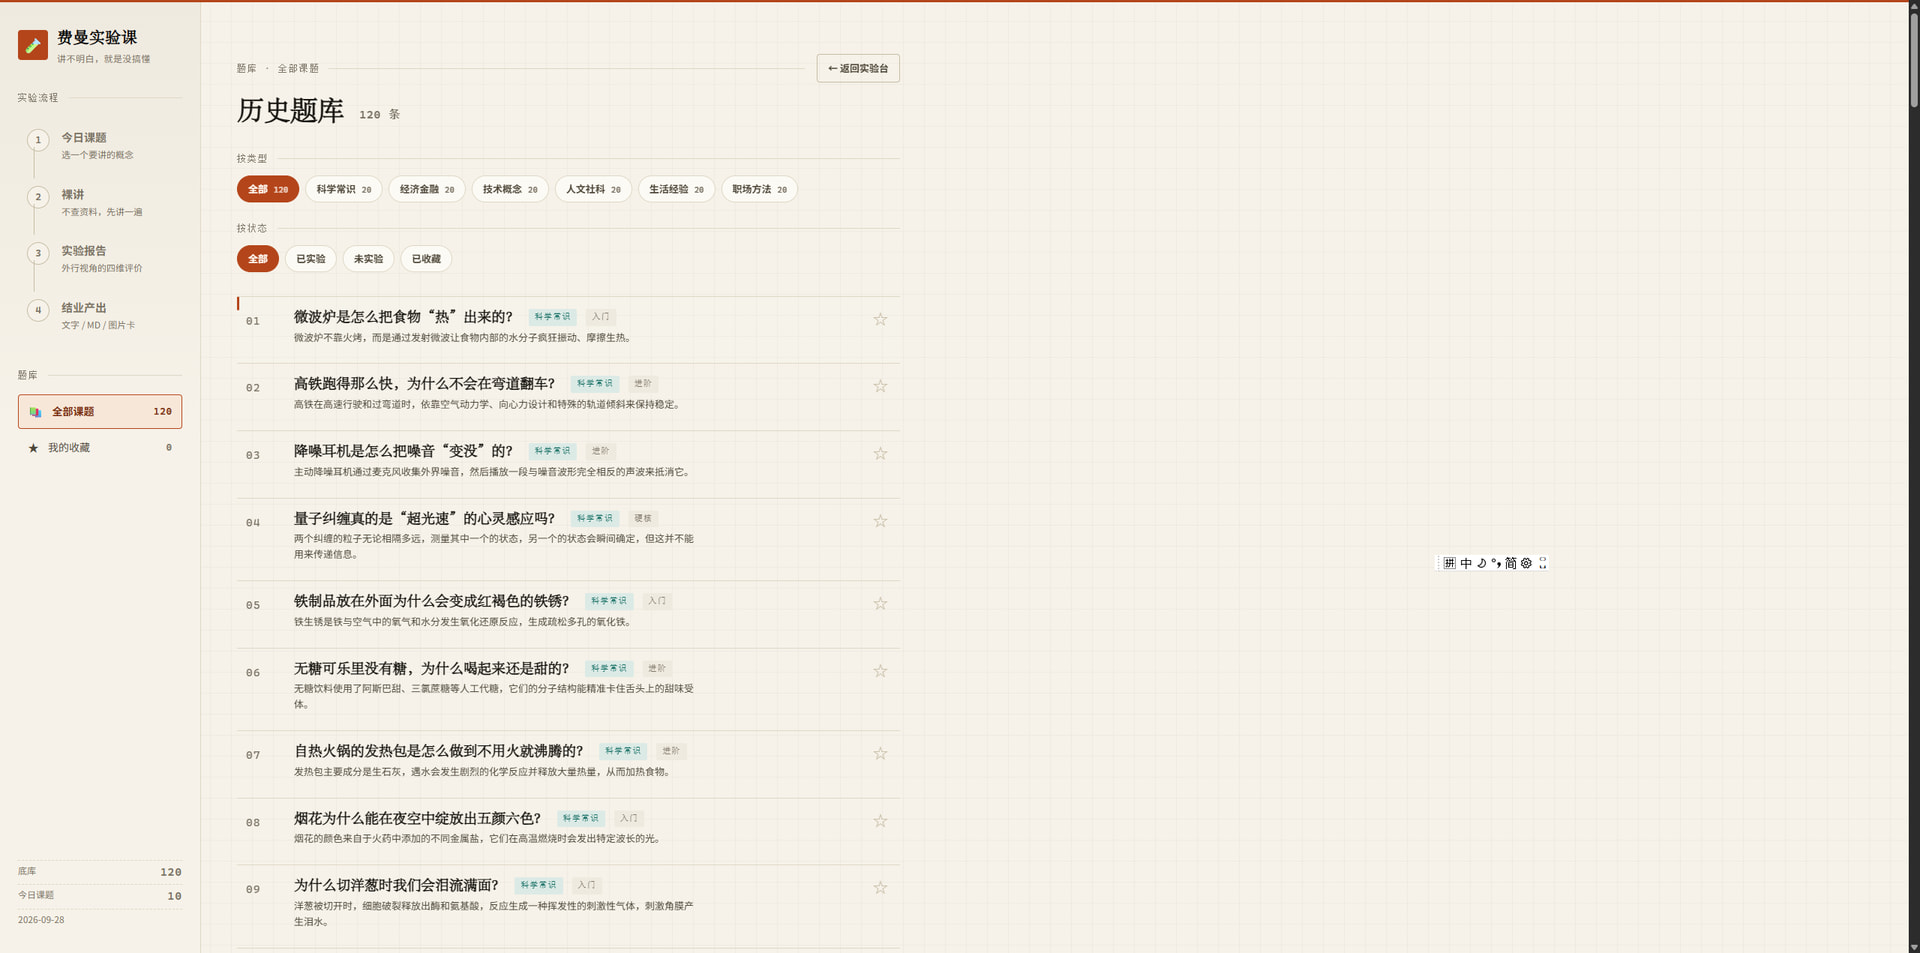
| 全部课题 | 题库页。120 条底库,按类型和状态筛选 |
| 我的收藏 | 收藏页。已收藏课题,可直接开讲 |
4.1 视觉语言
“实验记录本 · 暖白纸感”:暖白纸底 + 极细网格纹理 + 墨黑衬线大字 + 单一琥珀强调色 + 非对称排版。动效是"中等强度"编排:分数滚动、雷达图绘制、卡点依次浮现、页面元素错峰入场。系统开启「减少动态效果」时全部动效自动关闭。
5. 评价体系与分层提示
5.1 四维评分(各 25 分,共 100)
| 维度 | 问的问题 |
|---|---|
| 简洁性 | 讲给小孩听得懂吗?有没有未解释的术语? |
| 完整性 | 说清了「是什么 / 为什么 / 怎么用」吗? |
| 逻辑性 | 有没有自相矛盾、循环论证、因果倒置? |
| 比喻力 | 有没有原创、贴切、外行能秒懂的类比? |
5.2 等级
| 等级 | 分数 | 含义 |
|---|---|---|
| 优 | 85–100 | 及格,直接结业 |
| 良 | 70–84 | 及格线,结业;70–74 会提示"再修一轮可冲优" |
| 中 | 50–69 | 不及格,继续修正 |
| 差 | 0–49 | 不及格,建议先补课后重来 |
5.3 评分一致性保障
AI 评分天然有波动,产品用四道手段压住:
-
固定 rubric 写进 System Prompt**,`temperature = 0.2`
-
边界分二次评价:总分落在 68–72 时自动用更强模型复评,四维取平均,避免"一次评差就劝退"
-
Prompt 版本号:每次评价都记录(当前 `fe-rubric@1.1`),便于回归对比与调优
-
JSON 解析失败自动重试一次,仍失败则降级提示"评价服务繁忙,你的讲述已保存"
5.4 分层提示机制(本产品最核心的设计)
用户天然会想要"推荐回答"。但直接给答案,产品就退化成"看答案学习机",前面所有理论依据全部作废。解法不是拒绝,是分级:
| 层级 | 触发时机 | 给你什么 | 绝不给你什么 |
|---|---|---|---|
| L1 改进方向 | 每轮报告都有 | 去哪找、补什么方向 | 定义、机制、结论 |
| L2 结构提示 | 每轮报告都有 | 「及格的重讲至少要说清这几点」(2–3 条骨架) | 具体内容、数据、例子 |
| L3 一句起头 | 改到第 3 轮还卡着,你主动点开才显示 | 一句话开头(≤40 字) | 第二句、完整解释 |
| L4 标准示范 | 只有结业(良/优)后,在产出页主动点开 | 250–350 字完整示范 + 生活类比 + 避坑提醒 | ——此时训练目标已达成 |
实测样例(课题「复利」,用户裸讲"复利就是长期坚持一件事就会有结果"):
-
L2 结构提示:① 点出复利和普通简单累加的核心区别 ② 解释多出来的那部分收益是怎么产生的
-
L3 一句起头:「想象一下,你的钱不仅自己会下崽,它下的崽长大了还会继续下崽……」
-
L4 标准示范:滚雪球类比 + 268 字正文 + 避坑「把单纯坚持等同于复利是最常见的错」
三层都没有泄露答案——给的是骨架、起头、对照。
硬性约束:
-
L1–L3 在 System Prompt 层面被明确禁止写出正确定义
-
L4 由服务端二次校验等级,非「良/优」直接拒绝,防止前端绕过
-
L4 默认不自动加载,必须点击才请求(省成本,也避免过早剧透)
-
每轮重讲后 L3 展开态自动重置,不继承上一轮提示
6. 题库与收藏
6.1 全部课题
底库 120 条常青话题,六大类各 20 条:
| 分类 | 条数 |
|---|---|
| 科学常识 | 20 |
| 经济金融 | 20 |
| 技术概念 | 20 |
| 人文社科 | 20 |
| 生活经验 | 20 |
| 职场方法 | 20 |
难度分布:入门 40 / 进阶 52 / 硬核 28。每条含一句话背景和 3 个引导问题(引导问题只做热身,不给答案)。
题库页支持双维度筛选:
-
按类型:全部 / 六大类
-
按状态:全部 / 已实验 / 未实验 / 已收藏
列表每行显示:课题名、分类标签、难度、「✓ 已实验 · 等级 · 分数 · N 轮」标记、「★ 已收藏」标记。右侧 ☆ 可一键收藏/取消。点击整行直接开讲。
6.2 我的收藏
收藏页列出所有加星课题,显示各自的实验状态,可取消收藏或直接开讲。适合攒一个"我想练但今天没轮到"的清单。
6.3 每日 10 条怎么来
每日课题 = 6 条底库 + 4 条热榜。底库按日期取确定性子集(同一天刷新结果一致);热榜当前为静态占位(AI Agent、新质生产力、直播带货算法、15 分钟生活圈),M3 阶段接真实爬取。
7. 结业产出与分享
拿到良/优后进入实验产出页。这里是你真正的资产:一份 300 字小科普。
| 产出 | 内容 | 说明 |
|---|---|---|
| 01 复制文字 | 科普正文 | 一键进剪贴板 |
| 02 下载 Markdown | `.md` 文件 | 含标题、等级、四维得分、日期 |
| 03 图片卡片 | 1080×1440 竖版 | 课题名 + 等级徽章 + 四维雷达图 + 品牌水印 |
| 04 系统分享 | 调起原生面板 | 移动端优先;不支持时自动降级为下载 |
分享内容只含科普正文与等级,不含原始裸讲稿——你的试错过程不必示人。
7.1 标准示范(L4)
产出页中下部有「标准示范 · 讲给外行听」板块,默认收起。点击「看看 AI 会怎么讲 →」才生成,展示一句话定义、生活类比、完整示范正文、避坑提醒,可一键复制。设计意图是对照,不是抄。
8. 数据与隐私
-
练习记录与收藏存在浏览器 `localStorage`(键 `feynman.practiced.v1` / `feynman.favorites.v1`),不出本机。
-
练习记录保留历史最好成绩,轮次累加,日期更新为最近一次。
-
AI Key 仅后端持有,写在服务端环境变量里,绝不进前端、不入库明文。
-
用户输入与 AI 输出做双向内容安全过滤;热榜源屏蔽时政类话题。
-
清除浏览器数据会清空练习记录与收藏——当前版本无账号体系,M2 阶段补云端同步。
9. 部署与运维
9.1 本地启动
# 方式一:一键启动(推荐)

.start.ps1

# 提示输入千问 API Key(仅存在于当前会话,不落盘)

# 打开 http://localhost:8000


# 方式二:手动

cd server

$env:DASHSCOPE_API_KEY = "sk-..."

python app.py
后端单进程同时提供 API 与前端静态资源(托管 `web/dist`),所以只需访问 8000 一个端口。前端改代码后需 `cd web && npm run build`。
9.2 线上部署(腾讯云轻量,端口 83)
| 项 | 值 |
|---|---|
| 实例 | `lhins-gpai56uk`(ap-beijing,58.87.96.207) |
| 访问 | http://58.87.96.207:83/ |
| 代码目录 | `/opt/feynman/`(server + web/dist) |
| 密钥 | `/etc/feynman.env`,权限 600 |
| 服务 | systemd `feynman.service`,`Restart=always`,开机自启 |
| 防火墙 | 仅新增 TCP 83 一条,原有 7 条规则未动 |
常用运维命令:
systemctl restart feynman      # 重启

systemctl status feynman       # 查看状态

journalctl -u feynman -f       # 实时日志

ss -lntp | grep :83            # 确认端口监听
健康检查: `GET /api/health` → `{“status”:“ok”,“topics”:120}`
更新发布流程: 本地 `npm run build` 打包 → 生成 tar.gz → 传输到服务器 → sha256 校验 → 解包覆盖 `/opt/feynman` → `systemctl restart feynman`。全程不影响 80/81/82/8848 上的既有服务。
9.3 接口一览
| 方法 | 路径 | 用途 |
|---|---|---|
| GET | `/api/health` | 健康检查 |
| GET | `/api/topics/daily` | 每日 10 条 |
| GET | `/api/topics/all` | 全量 120 条底库 + 分类统计 |
| POST | `/api/topics/random` | 随机 1 条 |
| POST | `/api/evaluate` | 千问四维评价(服务端持 Key) |
| POST | `/api/export/markdown` | 生成 Markdown |
| POST | `/api/demonstrate` | 结业标准示范(服务端校验等级) |
10. 技术方案
| 层 | 选型 | 理由 |
|---|---|---|
| 前端 | Vue 3 + Vite,零 UI 框架 | 体积小(构建产物 ~99 KB JS / 26 KB CSS),加载快 |
| 后端 | Python 标准库 `http.server` | 零依赖,免 pip 安装,部署到任何有 Python 的机器即可 |
| 并发 | `ThreadingHTTPServer` | 评价请求最长 40 s,不阻塞静态资源与其他 API |
| AI | 通义千问 MaaS 私有网关 | 主评 `qwen3.7-plus`,边界复评 `qwen3.7-max` |
| 语音 | Web Speech API | 浏览器原生,零成本;转写结果可编辑 |
| 持久化 | localStorage | MVP 无账号,本机会话足够 |
11. 常见问题
Q:为什么 AI 不直接告诉我正确答案?
A:这是刻意设计。直接看答案的"流畅感"是假的,三天后你会忘。产品要的是你自己在脑子里把知识重新组织一遍——慢,但记得住。结业后(良/优)可以看标准示范。
Q:语音按钮点了没反应?
A:语音识别依赖浏览器原生能力,仅 Chrome / Edge 完整支持,且需要授权麦克风。Safari / Firefox 请直接用键盘输入。
Q:停止语音后又自动开始了?
A:已知历史问题,已修复。当前逻辑是「用户意图」与「UI 状态」分离,点停止会真正中止识别。
Q:评分忽高忽低是不是不准?
A:已用固定 rubric + 低温度 + 边界分二次评价压住波动。若仍觉得某次偏差大,用「修正重讲」再讲一轮看趋势,单轮分数不必过度解读。
Q:最多能讲几轮?
A:5 轮。5 轮仍未到良,建议换个课题——说明这个概念的课前知识还没补上,硬磨性价比低。
Q:换了浏览器/清了缓存,记录还在吗?
A:不在。当前版本记录存在浏览器本地,无账号同步。M2 会补。
Q:为什么热榜话题看起来是固定的几条?
A:MVP 阶段是静态占位,M3 接真实热榜爬取。
Q:我可以只打字不说话吗?
A:完全可以。语音只是输入方式之一,打字输入的评价标准和语音完全一致。语音的价值在于——说出来更容易暴露"其实讲不下去"的地方。
Q:底库会更新吗?
A:会。当前 120 条,M3 阶段扩容到 1000 条常青底库,仍按六大类组织。
Q:手机上能用吗?
A:浏览器可用(含语音)。原生 Android App 在 M2,届时支持系统级分享与每日推送。
Q:评价要等很久?
A:通常 10–30 秒。评价是真实调用大模型做四维分析,不是本地规则匹配,所以需要时间。等待期间讲述内容已本地保存,不会丢。
12. 我们刻意不做的事
产品边界和它做什么同样重要。以下都是被明确否决的需求:
| 不做什么 | 为什么不做 |
|---|---|
| 评价环节直接给标准答案 | 摧毁生成效应,产品退化为"看答案学习机"。改用第 5.4 节的分层提示 |
| 做成知识课程 / 文章推送 | 我们检验"你有没有真懂",不讲给你听。那是另一类产品 |
| 打卡签到与连续天数激励 | 打卡记录的是"你有没有来",不是"你有没有懂",与定位冲突 |
| 把讲述字数/时长算进分数 | 长短不等于好坏。啰嗦同样扣分(简洁性维度就是干这个的) |
| 公开排行榜 | 引入表演动机,用户会为了分数写"像教科书"的话,而不是"讲得懂"的话 |
| 无限制轮次 | 5 轮封顶。超 5 轮仍不及格说明课前知识没补上,硬磨性价比低,应当换课题 |
判断一个新需求该不该做的标准只有一条:它是在逼用户多输出,还是在替用户少输出? 后者一律不做。
13. 路线图
| 里程碑 | 内容 | 状态 |
|---|---|---|
| M1 | 后端骨架 + 千问评价 + 120 条底库 + Web 全流程(含题库、收藏、分层提示、四种导出)+ 云端部署 |  已完成并上线 |
| M2 | Android 端(uni-app,复用 Vue3)+ 账号体系 + 云端同步 + 进步曲线 + 卡点地图 | 待启动 |
| M3 | 真实热榜爬取 + 运营后台 + 公开作品广场 + 底库扩容至 1000 条 | 规划中 |
附录 A:术语表
| 术语 | 含义 |
|---|---|
| 裸讲 | 不查资料,凭现有理解把概念讲一遍 |
| 卡点 | 讲述中讲不通、含糊、绕圈子的地方 |
| 外行听众 | AI 扮演的角色,“完全不懂该领域” |
| 及格线 | 等级"良"(70 分),达到即结业 |
| 分层提示 | L1 方向 / L2 骨架 / L3 起头 / L4 示范 四级闸门 |
| 边界分 | 68–72 分区间,触发二次评价取中 |
附录 B:文档索引
| 文档 | 路径 |
|---|---|
| PRD v1.1(权威) | `费曼实验课-PRD-v1.1.md` |
| 历史版本 | `docs/archive/` |
| 评价 rubric | `evaluation/rubric.md` |
| 评价 System Prompt | `evaluation/system_prompt.md` |
| 验证报告 | `evaluation/VALIDATION.md` |