(本文由trae code使用 /头脑风暴 SKILL辅助编写~(glm5.3flash,牛来!))
这次我是谁?
我是百度贴吧某个小吧的吧主。这个身份听着有点权限,实际上干的全是苦力活——每天删广告、封广告号、处理申诉,循环往复。
贴吧的广告号治理有个死结:查一个账号在吧内的发言要点很多次、逐条删效率低;封禁最多 10 天,到期自动放出来,对方换个马甲继续发。官方后台做的奇差,试过几个第三方工具都不够满意。所以这次我决定自己做一个吧务管理面板,把"查发言 → 批量删 → 封禁 → 循环封禁 → 追溯"压缩成几次点击的事。
预算有限,积分不多。于是这次我认真试了 TraeCode,想看看它能不能在低成本下把这件事跑通。
结果跑通了,大约花了 400 积分。顺带,我也想明白了一个问题:TraeWork 是怎么被"优化"的。
一、为什么选 TraeCode
选它的第一个理由很现实:有低倍率、高性价比的模型可用。
我这次全程用 GLM-5.3 Flash,0.06x倍率非常有性价比。400 积分做完一个有 7 个功能模块、前后端分离、带数据库和后台轮询的完整项目,期间还有两次多Agent同步在线找茬排错,在使用前就寻找出了很多bug(大概额外100积分左右)。如果你的需求清晰、提示词到位,便宜模型完全够用,没必要一上来就挂顶配。

(这个统计图工具是什么?)
第二个理由是第一印象带来的:系统提示词工具里没有多余的图片/视频生成工具。这听起来不像优点,但实际用起来很重要——上下文窗口没有被一堆用不上的能力描述挤占,模型对代码任务的专注度更高。我之前用过一些"全能型"Agent,光是系统提示词里介绍生图能力就占了好几百 token,写代码的时候反而注意力分散。同时还会意外导致额外浪费大量积分…说你呢!
二、我是怎么把它用顺的
这部分是全文的重点。我把过程中几个关键转折写出来,供后来的人参考。
1. 先用 /brainstorming 把想法收敛成功能清单
我一开始只有一个模糊的念头:“做个贴吧管理工具”。如果直接让 AI 开写,大概率会得到一个大而全、哪都不精的东西。
所以我先调了 TraeCode 自带的 SKILL:/brainstorming(头脑风暴)。它会一步步问你:要解决什么、面向谁、哪些功能必须有、哪些可以先不做。几轮对话下来,我的想法被收敛成了清晰的功能边界:
-
用户发言查询 + 批量删除
-
删帖 + 封禁 + 加黑名单的"三连"一键处置
-
循环封禁(半自动永久封禁,打开面板检测到期者一键重封)
-
广告监控预警(后台轮询新帖,命中关键词进待处理列表)
-
误删恢复、申诉批量处理、完整操作日志
明确不做的也列出来了:相似广告聚类、多吧支持、24 小时无人值守。这一步砍掉的东西,省下的不止是开发积分,更是后期维护的心智负担。
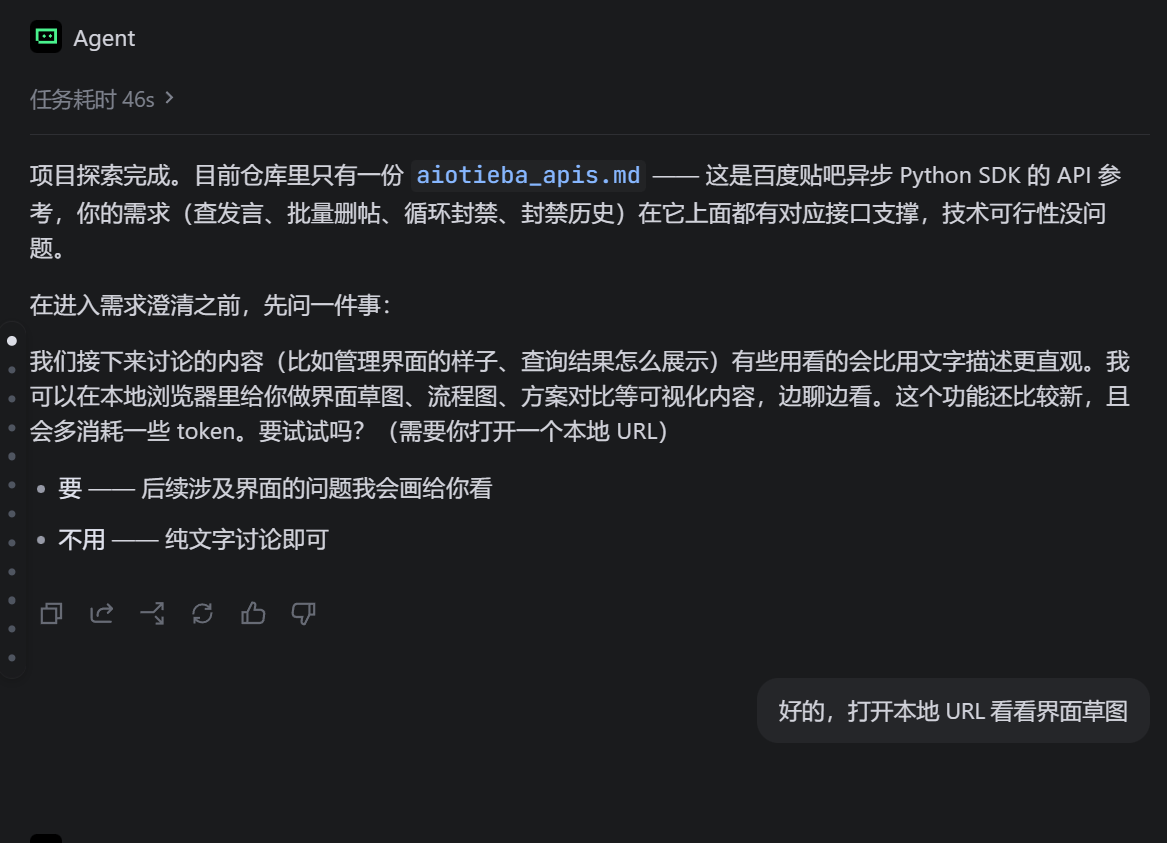
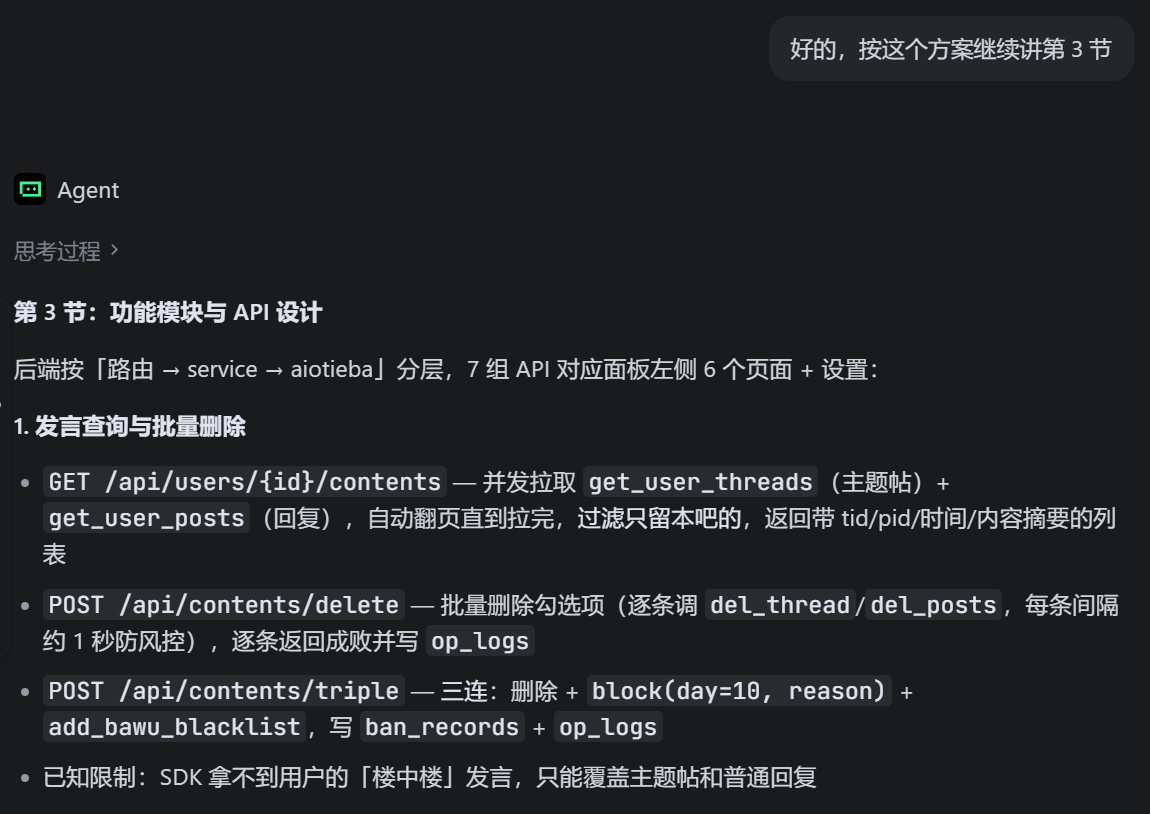
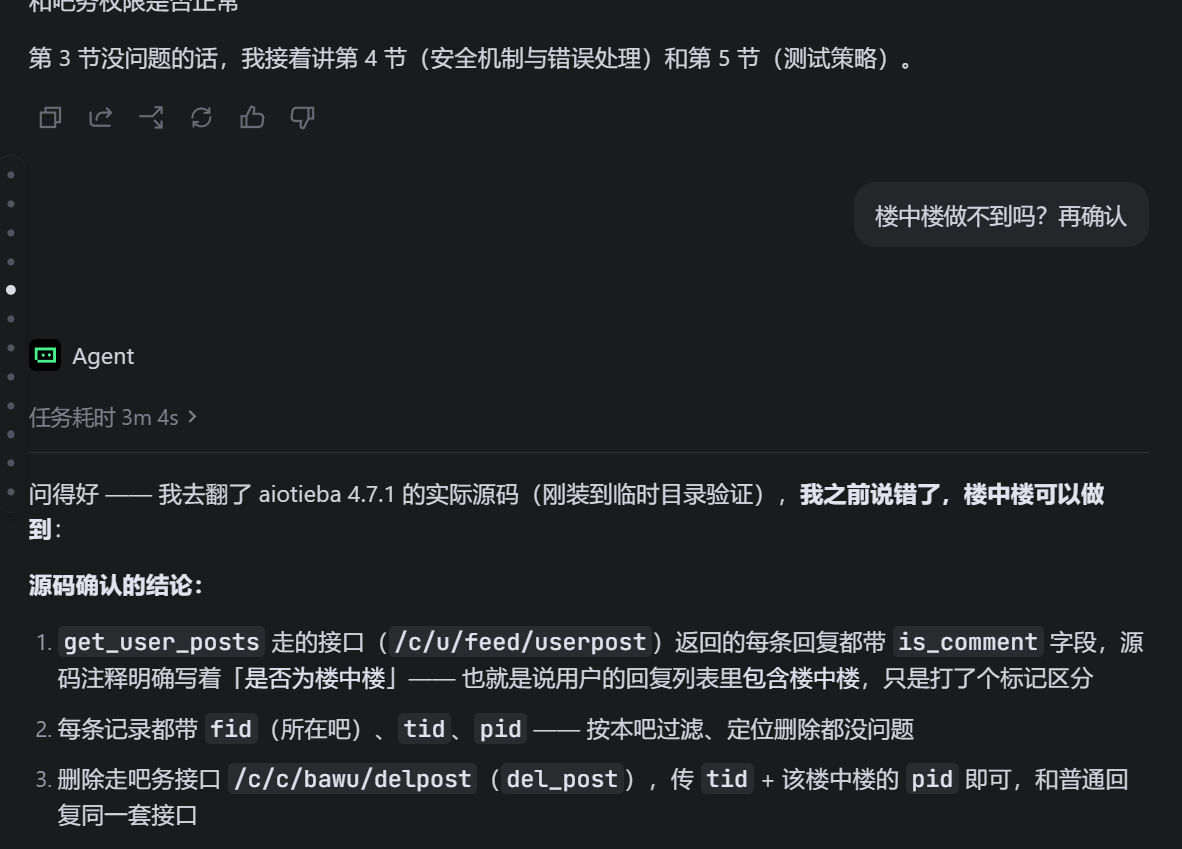
一个好的 SKILL,胜过十句提示词。强烈建议上手先翻一遍 SKILL 列表,找几个好用的配上。
2. Browser:让 AI 自己动手操作浏览器,分析问题
这是我这次体验里最惊艳的功能。它不是"帮你打开一个网页",而是 AI 会自动操作浏览器:自己点击、输入、翻页,观察页面实际表现,再把看到的现象带回来分析问题。
做吧务面板时我用它解决了一个很典型的场景:前端面板上某个操作表现不对,光靠对话描述,模型只能猜。我把面板地址丢给 Browser,它自己打开页面、点按钮、触发操作、盯着实际结果,然后直接定位到是前端逻辑还是后端接口的问题,接着改代码验证——整个过程不需要我当"人肉传话筒"在浏览器和 IDE 之间来回倒腾。
让 AI 亲眼看,比用文字向它描述靠谱得多。 尤其是调试 UI 和交互问题时,这一项直接把来回沟通的成本砍掉了一大半。
3. FORK:继承上下文开分支,互不污染
项目做到中期,我同时要处理两件事:一是调风控限速逻辑(写操作全局串行队列、间隔抖动、连续失败冷却),二是调前端面板的交互。如果在一个对话里来回切,上下文会被两边的信息互相稀释。
TraeCode 的 FORK 功能这时候很关键:基于当前对话开两个分支,一个继承前面的项目上下文继续调限速,另一个同起点去改 UI。两边各自的修改记录互不干扰,但共享同一份项目认知。这在传统单线程对话里是做不到的——你要么开新对话从头交代背景,要么在原对话里忍着上下文被稀释。
4. 三个小技巧
-
上下文非常重要:同样的问题,有没有项目上下文,回答的速度和质量完全是两个东西。有上下文时模型能直接定位到对应文件改;没上下文时它会从通用方案讲起,你得反复纠正。
-
子 Agent 能有效避免上下文污染导致的认知偏差:这是"换个角度思考"的真实写照。主对话里我已经有了一套实现思路,模型容易顺着我的思路走;派一个子 Agent 用干净上下文重新审视同一个问题,反而能跳出我设的思维框架,给出更直接的方案。
-
遇到卡壳先别硬刚,把卡点描述清楚交给 AI 拆:把报错整段丢给它,让它翻译成人话、拆成步骤,比自己翻文档快得多。
三、我最后做成了什么
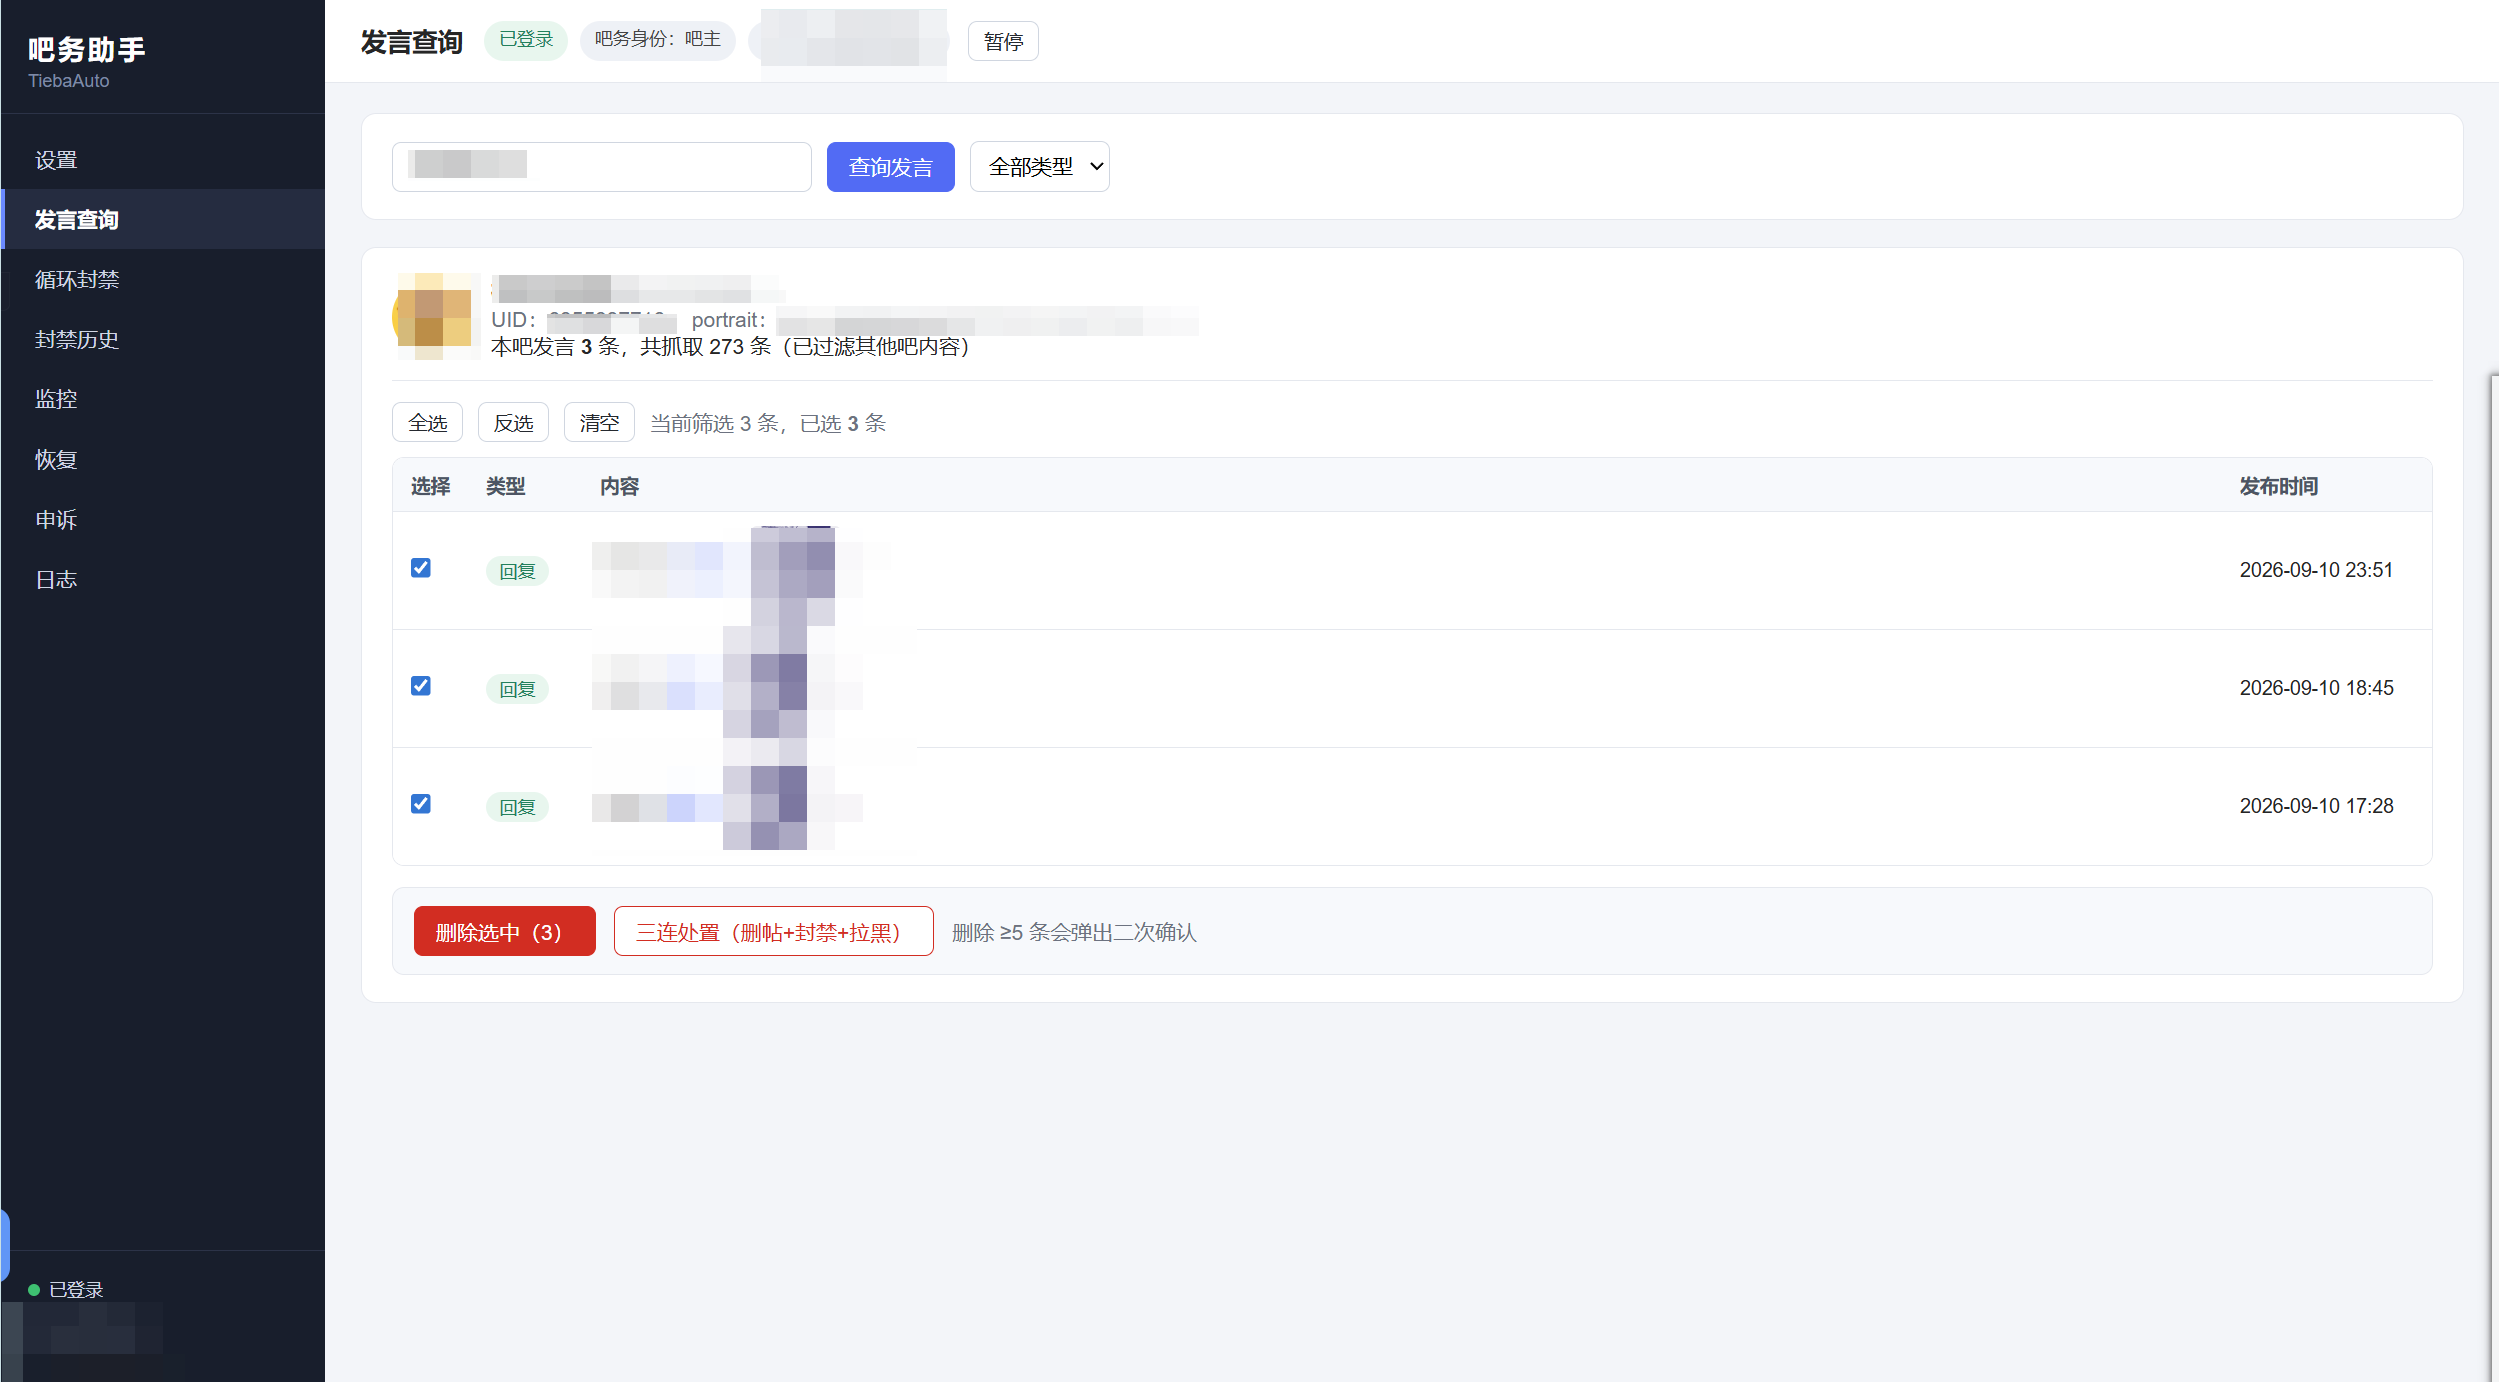
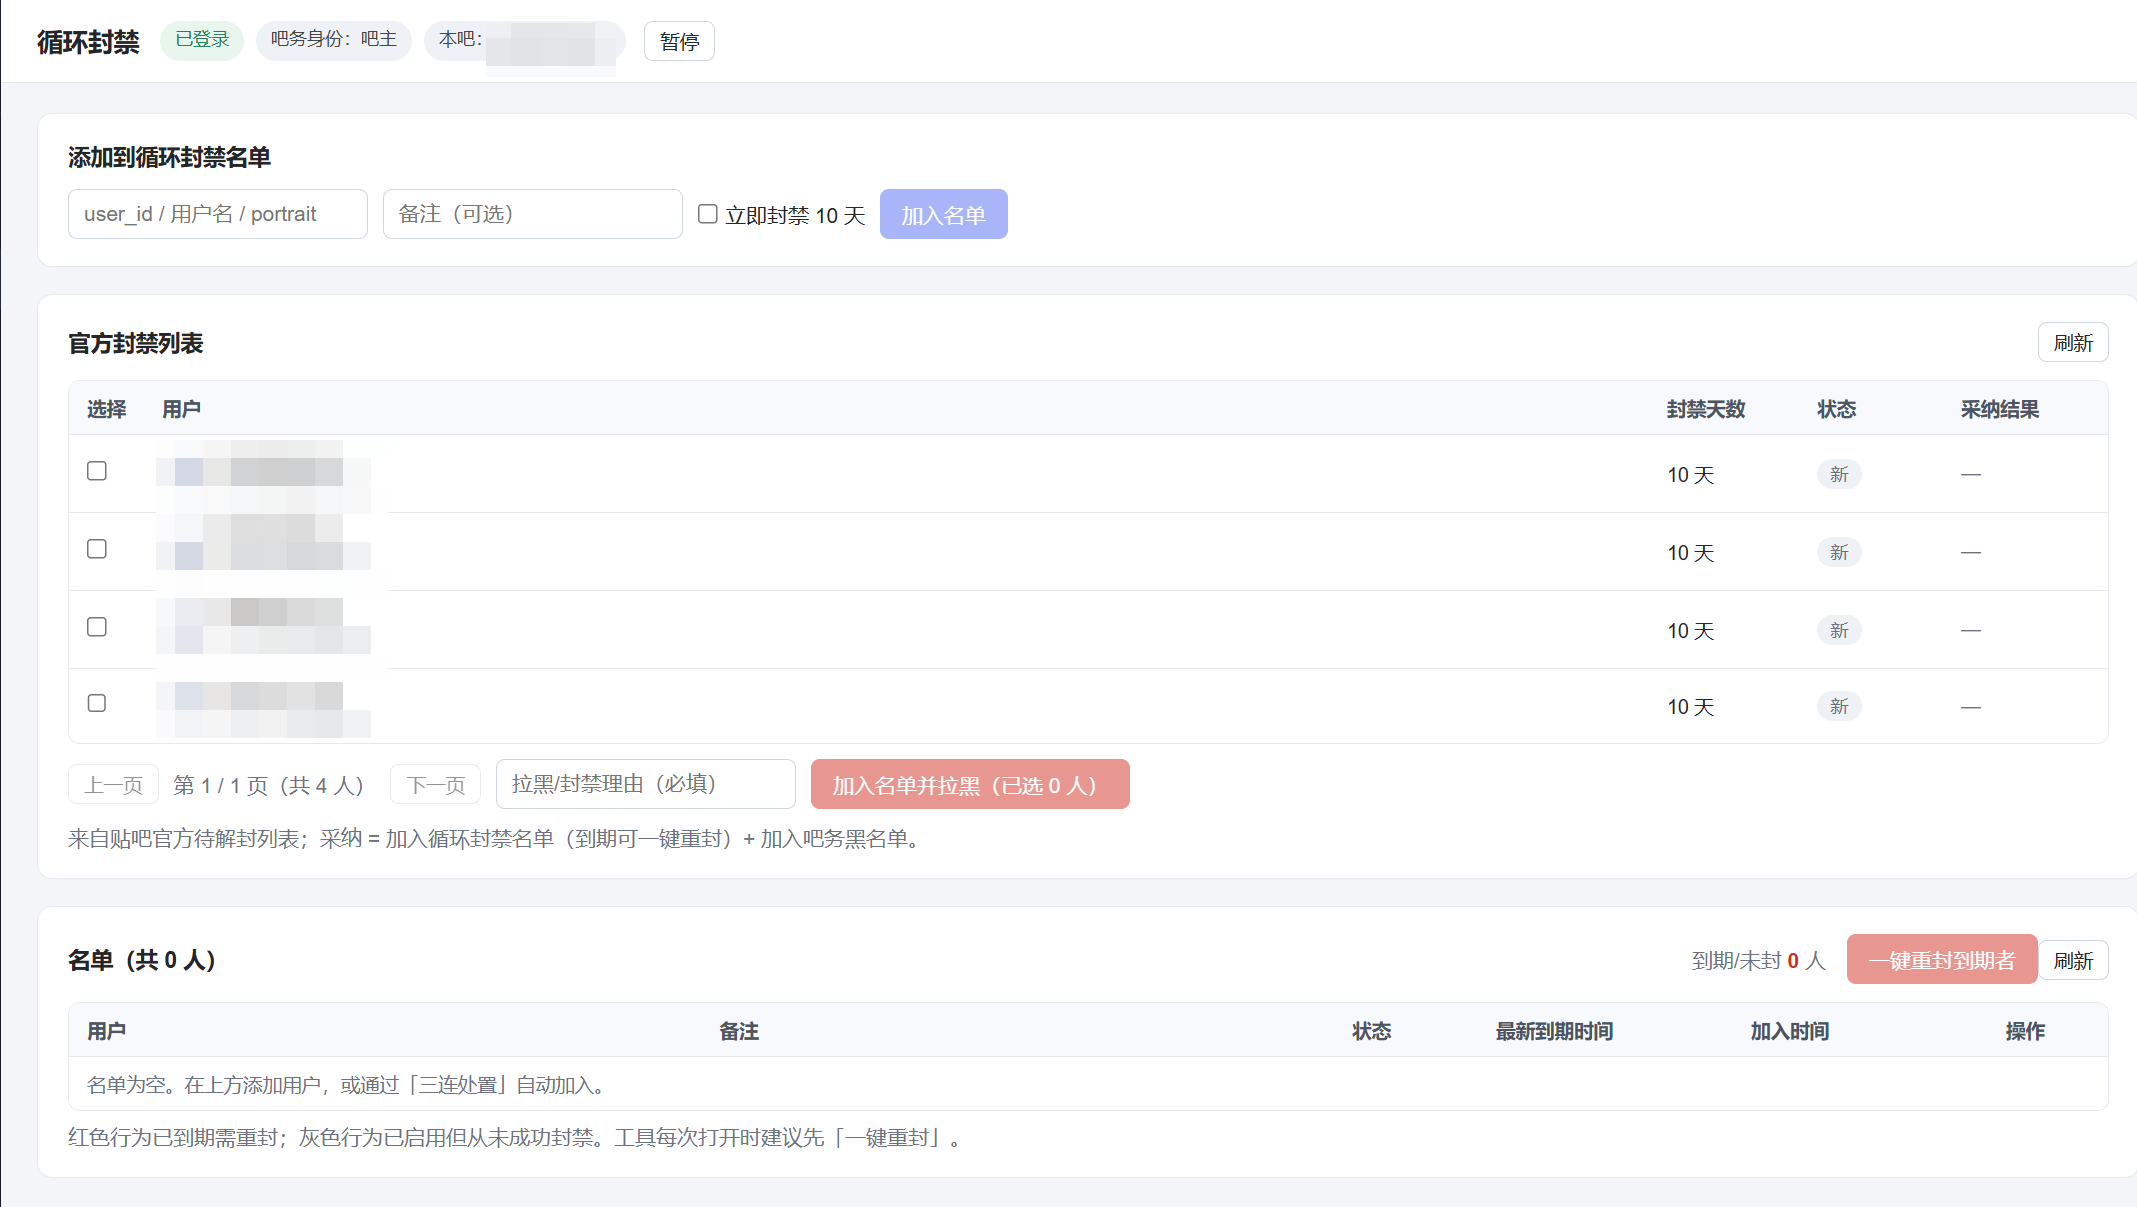
但比起我做了什么,更重要的是,你能做什么?
四、几点不足
试用下来也有几个不舒服的地方,挑能说的说。
第一是敏感内容判定。这个问题我之前说过,不细说了
第二是由于 TraeCode 基于 VSCode,太重了。这算历史遗留问题——VSCode 本身就是一个完整的编辑器生态,对于一个"只想用 AI 对话+生成代码"的场景,启动体积和资源占用都偏高。而更轻的新解决方案 TraeWork 又更新缓慢、功能被 Code 压着。
这正好引出开头那个钩子的答案——TraeWork 是怎么被"优化"的?
试用完 TraeCode 我明白了:Code 把 Work 的精华都吸走了——Browser、SKILL、干净的系统上下文、FORK 分支——Work 本体能给的体验,Code 都能给,还更全。Work 的定位被自家 Code 挤到了墙角。这不是谁的恶意,是产品路线自然演进的结果。但对用户来说,一个更轻的 Work 如果能被认真对待,反而是更舒服的选择。
五、给后来人的一句话
先想清楚要解决什么,再让 AI 拆;一个好 SKILL 胜过十句提示词;上下文是效率,FORK 是专注,子 Agent 是换视角——把这三样用起来,400 积分也能做出完整工具。
