我这次想解决什么
我是做新能源汽车 BMS(电池管理系统)的嵌入式工程师,日常一半时间写 C 代码,另一半时间对着一堆 CAN 总线日志做"人肉解 frame"——把测试报文的每个十六进制字节,对照着固件里的组包函数,一个 bit 一个 bit 翻译成工程含义。
这次的任务是排查一个均衡电阻短路故障的上报问题:【补充一句你当时的任务背景,比如问题现象/客户反馈】。手头是一份 6 万多帧的 CAN 故障日志,涉及 4 条测试报文、8 个芯片、每条报文 8 个字节的诊断信息。
传统做法是把日志拖进 Excel 分列、按 ID 筛选、逐芯片统计取值范围,一份日志至少半天,而且很容易看走眼。
我是谁,为什么这件事对我重要
【汽车BMS嵌入式软件开发工程师】。对汽车行业来说,一次实车问题的闭环周期很长,日志解析是其中最耗时也最容易出错的一环——解析错了,后面所有排查方向都是错的。
说实话,一开始我并不觉得 AI 能干这个活。CAN 报文的字节含义是纯私有的:哪个字节是故障位图、哪个是电压原始值、大端还是位序,全靠读固件源码里的组包函数才知道。我把日志丢给 TraeCode 的时候,心态更接近"看它能猜成什么样"。
我是怎么把 TraeCode 慢慢用顺的
第一步是教它"字典"。我没直接让它解析日志,而是先把组包函数的源码给它,让它逐字节解读出每个 Byte 对应什么变量、什么编码。它给出的字段说明我人工核对了一遍——这一步它读得比我快,也没读错。
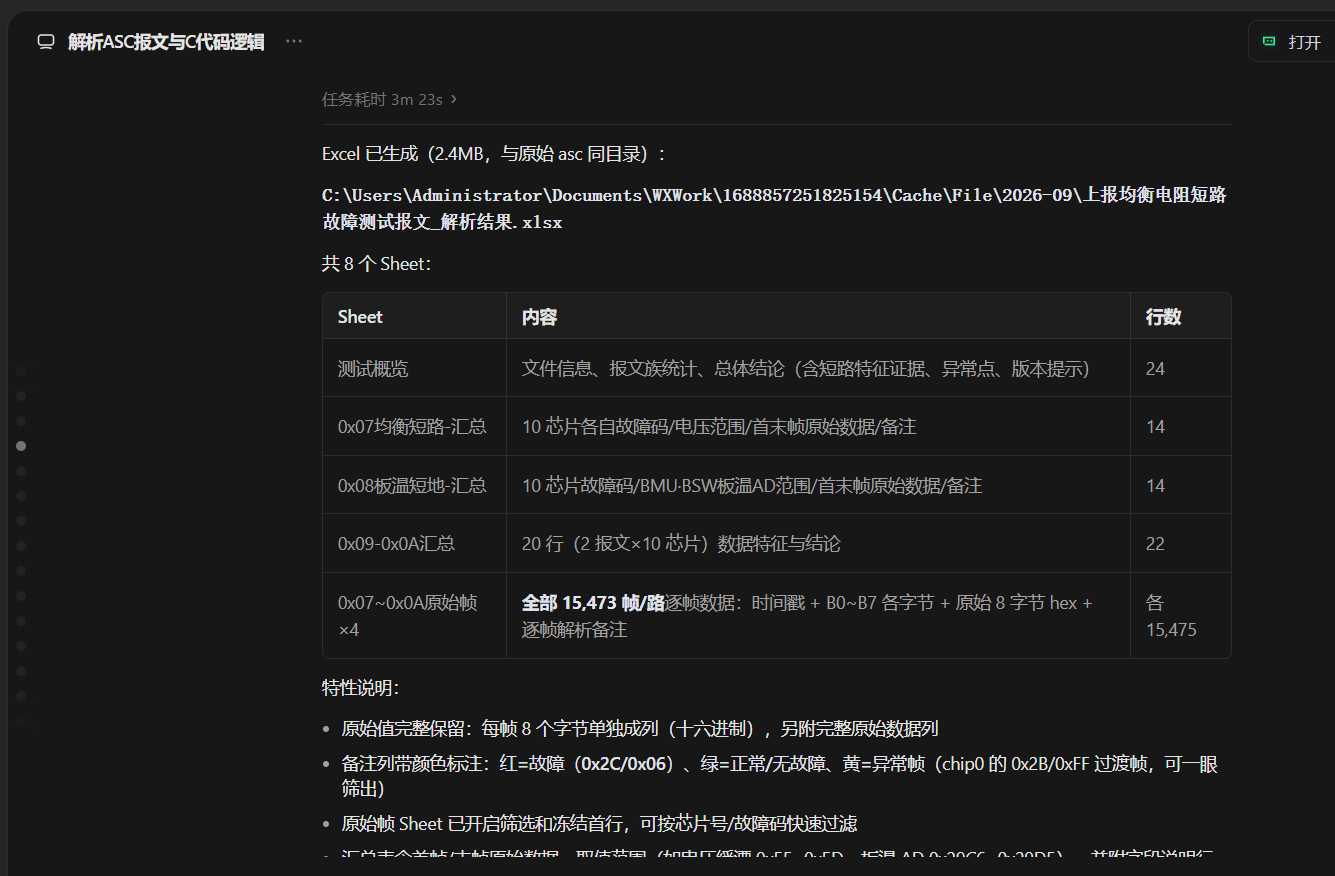
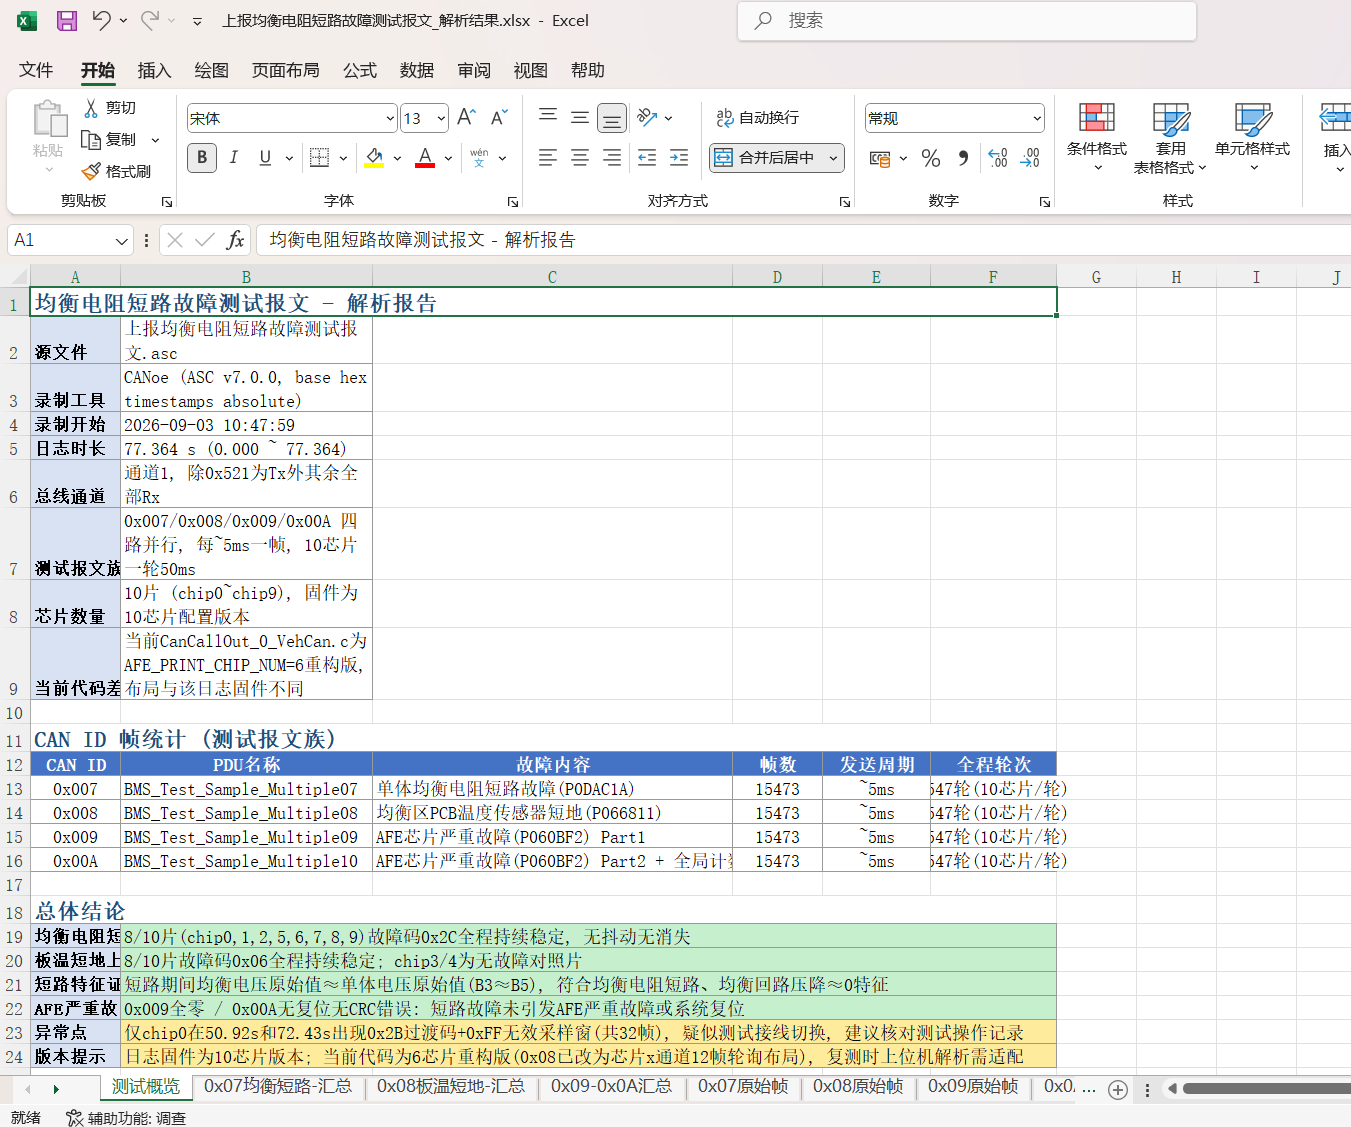
第二步才是解日志。让它写脚本统计报文族、按芯片汇总故障码和原始值、输出带标注的 Excel 报告。脚本一次跑通。
真正的转折在第三步:解析结果看着头头是道,但拿去和另一个测试版本的数据一对,发现对不上。这时候有两个可能:要么解析错了,要么——日志本身就不是这份代码跑出来的。
我让它拿着报文特征(轮询的芯片数、字节映射关系)去反查另一份存档的测试软件源码。逐字段验证后它确认:这份日志来自另一个固件版本,报文布局和当前代码库完全不同。也就是说,我最初按当前代码解读的整个结论都是错的——这个错误是我自己引入的,而发现它的却是 AI。
用顺的分水岭在这里:我开始把"验证假设"也交给它。之后每次解析,我都会让它反查一遍"日志特征和代码版本是否匹配",这一步后来成了固定流程。
我最后做成了什么,想给后来的人留一句什么建议
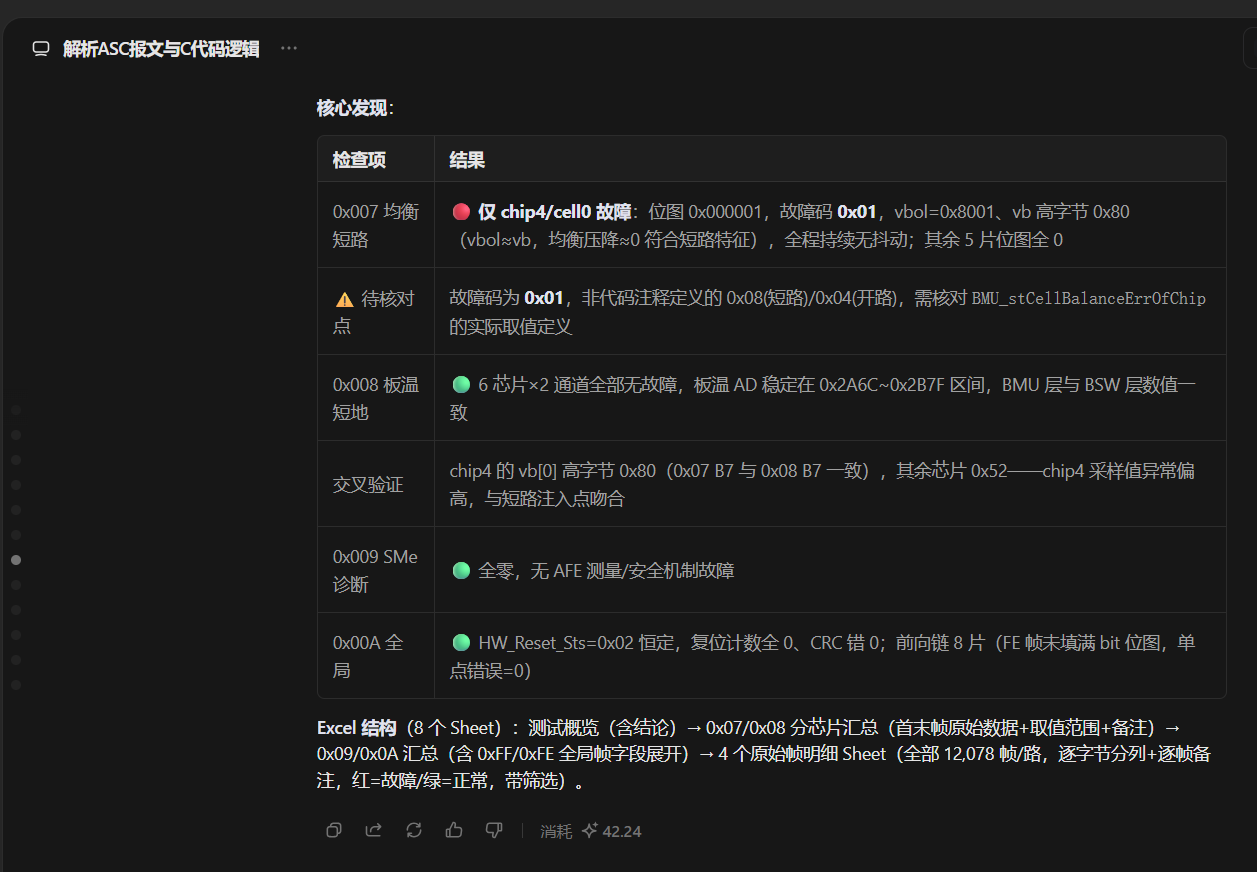
重新解析后,问题根本原因非常直观的展现出来,表格梳理的也非常到位,不管是软件工程师,还是系统工程师,还是质量工程师,都能清晰的看出来,问题是什么。更重要的是那次翻案——如果不是交叉验证,我就带着一份错误的解析结论去推进问题闭环了。
给后来的人一句建议:AI 最有价值的时刻不是它替你干活的时候,而是它不带任何立场帮你验证"你以为对的东西"的时候。
用 AI 的正确姿势分三层:先给它上下文(源码、协议),再让它干活,最后——也是大多数人会漏掉的——让它质疑你的假设。