我是谁,以及我遇到了什么问题
我是新能源汽车行业的嵌入式软件工程师,负责 BMS(电池管理系统)ECU 开发,日常和 AUTOSAR 架构的 C 代码、MC33774/BQ7971X 这类 AFE 采集芯片、整车 CAN 总线打交道。
这次遇到的明确任务是:排查"均衡电阻短路故障上报"问题,拿到一份 CANoe 抓的 77 秒、91,494 帧 的 ASC 测试日志。里面有 4 条按芯片轮询的测试报文(0x007~0x0A),每条 8 个字节,每个 Byte 的含义由固件里对应的组包函数(ComIPdu_BMS_Test_Sample_Multiple0X_CallOut)决定。
难点有三个:
- 人工对 9 万帧十六进制数据做逐字节解析,按芯片汇总统计,通常要 2~4 小时;
- 更隐蔽的坑:这份日志是另一个固件版本跑出来的,报文布局和当前代码库不一样(一边按芯片轮询、一边按温感序号轮询),一开始按当前代码解读,整个结论全错;
- 解析结果要给测试同事看,得整理成带故障标注、能筛选的表格。
我是怎么用 TraeCode 解决这件事的
使用模式:IDE 模式(Chat 里配合 @Codebase 检索代码)。
第一步:让 AI 建立代码侧的"报文字段词典"
把组包函数文件(CanCallOut_0_VehCan.c)喂给 TraeCode,让它逐字节解读 SduDataPtr[0]~[7] 各自对应什么观测量、什么编码(大端/位图/故障码)。AI 给出字段说明后,我再对照注释核对了一遍——这一步它读得比我自己翻快得多。
第二步:写脚本解析 ASC 日志
直接描述需求:“解析这份 ASC,统计报文族,按芯片分组汇总每路的故障码、原始值范围、首末帧,逐帧标注故障/正常/异常,输出带颜色标注的 Excel”。TraeCode 写出 Python 脚本(openpyxl),一次跑通,生成了 8 个 Sheet 的报告:测试概览、分报文汇总表、4 个原始帧明细表(每帧 8 字节单独成列 + 解析备注列,红=故障/绿=正常/黄=异常帧,带筛选和冻结行)。
第三步:交叉验证——这一步最关键
怀疑日志固件版本对不上时,我让 AI 去比对另一份存档的测试软件源码(温感采集修改点版本),逐字段验证 B0/B1 的映射关系、取值范围是否符合那边的组包逻辑。AI 确认 B0→B1 的芯片映射与代码里的 AFE_TempSensorMap 完全一致,证实日志来自温感测试版本而非当前代码库版本——直接推翻了第一版解析结论,避免了带着错误结论去做问题闭环。
成果展示
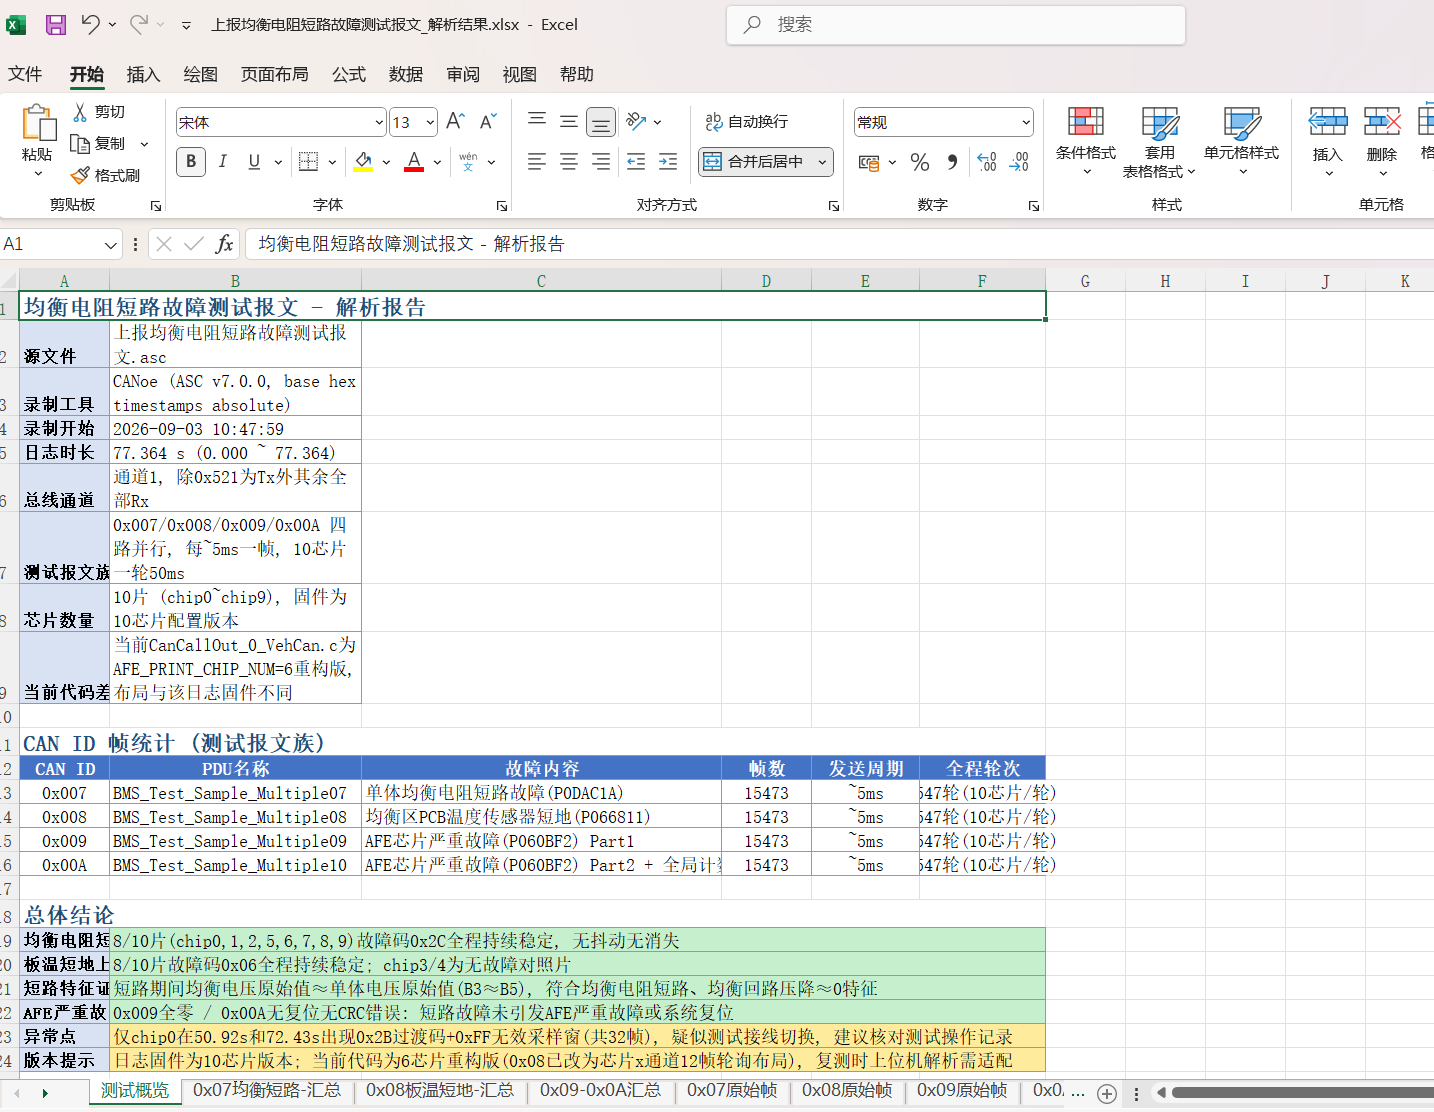
- 交付了一份 8 Sheet、2.4MB 的 Excel 诊断报告:全部 15,473 帧 × 4 路报文的原始字节 + 逐帧解析备注 + 分芯片汇总(故障码取值范围、电压/温度原始值缓漂区间)
- 定位到真实故障现象:chip3 数据全零、通信状态 0x02(内部不更新)、单点故障位置位,但软件三态未报错——这就是要闭环的问题本身
- 解析结论已同步给测试同事,Excel 可按芯片号/故障码直接筛选,作为后续复测的比对基线
效率对比
- 以前怎么做:人工把 ASC 拖进 Excel 分列、按 ID 筛选、逐芯片统计取值范围、手写字段对照表——一份日志至少半天,而且版本对不上时白干一轮
- 现在怎么做:AI 读组包代码建字段词典 + 写解析脚本 + 多版本固件交叉验证,从拿到日志到出带标注的报告约 10 分钟,版本误判也是在验证环节直接被拦下
- 唯一的人工介入:核对 AI 的字段解读(这一步不能省,嵌入式场景 AI 拿不准的字节语义必须人对着代码和注释确认)
经验和技巧总结
- 先给代码上下文,再丢数据:解析二进制/总线报文前,先把组包函数给 AI 建立字段词典,比直接让它猜字节含义靠谱得多
- 多版本固件是嵌入式解析的隐形坑:让 AI 拿日志特征反查代码(如 B0/B1 映射关系、轮询粒度),可以快速证伪"日志来自当前版本"的假设
- 让 AI 输出"原始值+解析列"双份结果:解析结论可能有偏差,但原始字节永远保留,同事可以按自己的理解复核