① 这次想解决什么
线上一个跑了俩月的 Java 服务,突然开始随机 OOM。说随机是真随机:有时隔三天炸一次,有时一天炸两次,都在业务低峰期,重启就恢复,本地怎么压都复现不了。领导只给了一句话:「这周内解决。」我的任务就是:找到它到底在哪儿漏内存,并且别用「加内存」糊弄过去——因为加过一次,从 2G 到 4G,只是把炸的间隔从三天拖到了五天。
② 我是谁,为什么这时候想试 TraeCode
Java 后端,第五年,CRUD 和常规调优都熟,但 OOM 排查属于「知道该干嘛、从没真干过」:jmap、heap dump、MAT 这些词都听过,一次没亲手走完过。以前遇到这种事的标准动作是复制报错去搜,但这次搜出来的全是八股文,跟我的场景对不上号。装了 TraeCode 一阵子,一直只拿来生成样板代码,这次想着:heap dump 这种一年遇不到一次的东西,正好让它陪我现场学一遍。
③ 我是怎么把它用顺的
第一轮问得很失败。我贴了报错,问「偶发 OOM 怎么排查」,它给了份标准方法论:看 GC 日志、jstat 观察、dump 分析。方法论没错,但跟我搜到的八股文没区别——因为它不知道我的现场。这步给我的教训是:问题越具体,越得先喂现场。
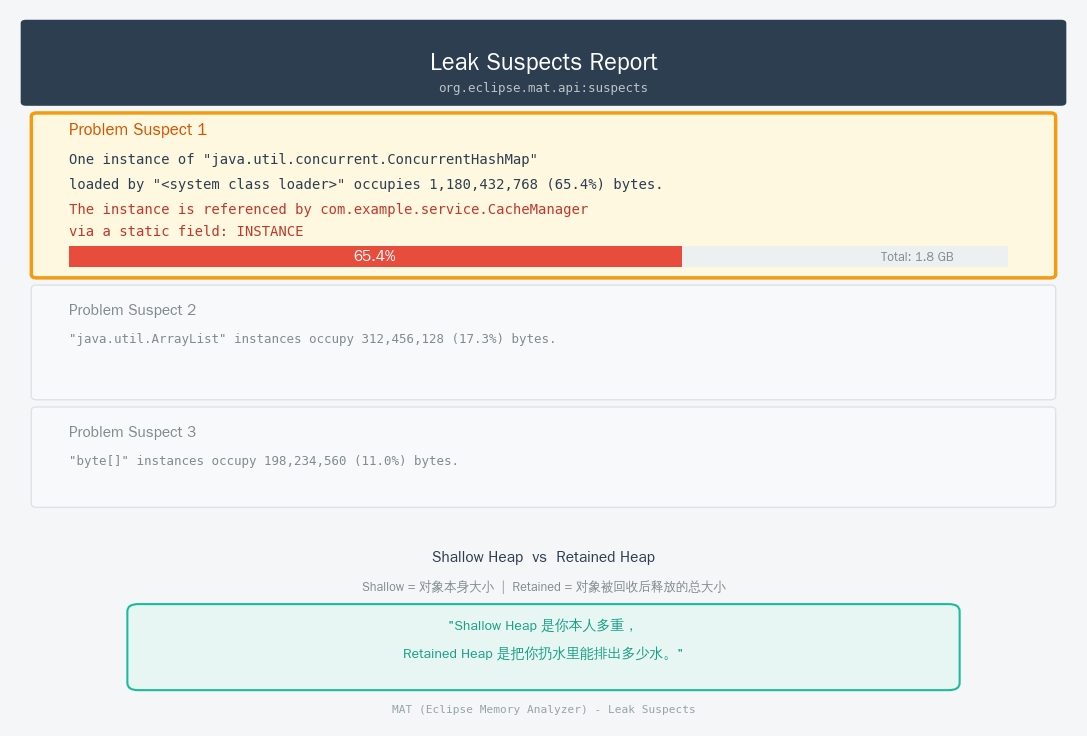
按它的清单先干实事:加上 -XX:+HeapDumpOnOutOfMemoryError 等下一次炸。两天后凌晨果然炸了,拿到一份 1.8G 的 hprof。打开 MAT 我直接懵了——Leak Suspects、Dominator Tree、Shallow Heap、Retained Size,每个词都见过,每个都不真懂。
转机是我把 MAT 的 Leak Suspects 报告文字整个贴进 TraeCode,让它当我的翻译。它逐段拆解,指出第一个嫌疑对象:一个 ConcurrentHashMap retained 了 65% 的堆,被某个 Cache 类的 static 字段持有。顺带把我一直分不清的两个概念一句话讲透了:Shallow Heap 是你本人多重,Retained Heap 是把你扔水里能排出多少水。这个比喻我以后大概忘不掉了。
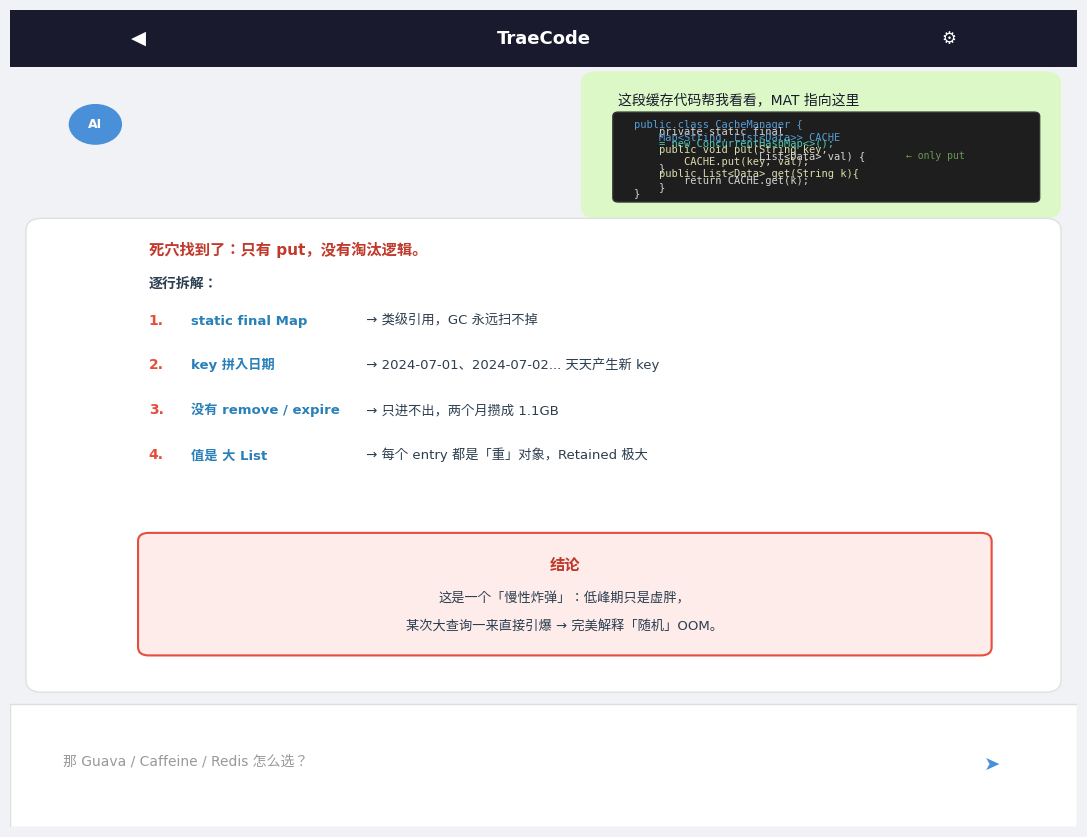
接着把那个缓存类的代码(60 来行)贴给它,它几秒就点了死穴:只有 put,没有任何淘汰逻辑,key 里拼了日期,等于天天新增、永不清理,值还是大 List。两个月攒下来,就是一颗慢性炸弹。压力小它只是虚胖,某次大查询一来直接引爆——这也完美解释了为什么「随机」炸、且总在低峰期之外的偶发时刻。
最后是选方案:我问它 Guava Cache、Caffeine、直接上 Redis 三条路的取舍,它给的对比没瞎推荐,结合我这是单体服务、缓存量不大,指了 Caffeine 的 maximumSize + expireAfterWrite。改造代码它生成的,我审了一遍,另外按它的建议加了一行缓存大小的日志——以后再漏,至少能提前看见。
④ 最后做成了什么,想留一句什么建议
修复上线三周,堆内存稳定在 45% 上下,没再炸过。更重要的是,我现在算「真会」OOM 排查了:从 GC 日志到 dump 到 MAT,整条链路亲手走完过一遍,下次不用慌。
想给后来的人一句:这种问题别指望 AI 直接给你答案,它给不了——但它能当你的陪审团。 heap dump 报告、线程栈、GC 日志这些「正常人一年读不了一次」的东西,贴给它,让它陪你逐段拆、讲名词、审代码,一晚上顶过去瞎搜一周。记住一个顺序就行:先给现场证据,再提问。
附:截图