- 转发自程序员鱼皮:
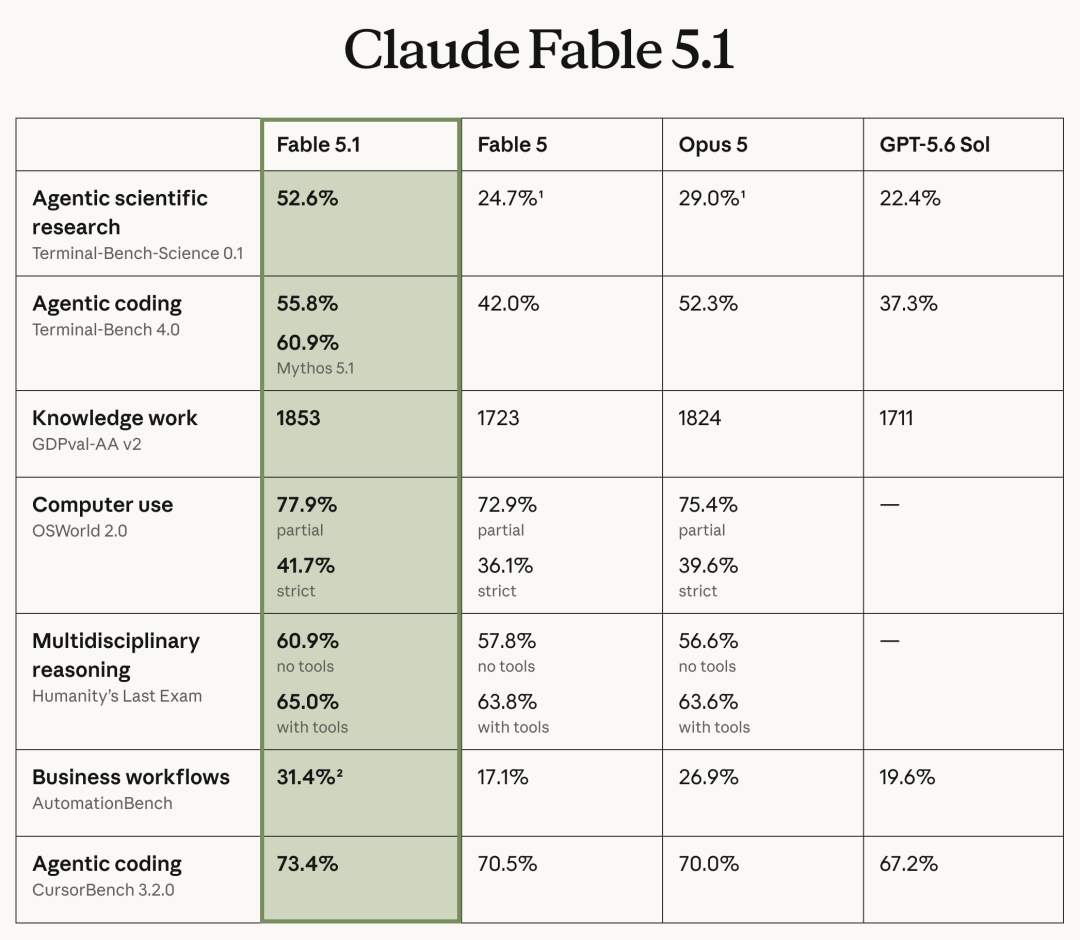
这篇文章(作者:程序员鱼皮)是对 Anthropic 新发布的 Claude Fable 5.1(及同源的 Claude Mythos 5.1) 的速递 + 实战测评 + 成本吐槽,核心可以拆成 5 块:
1. 模型发布与定位
- Anthropic 发布 Claude Fable 5.1(公开版)和 Claude Mythos 5.1(同底层、护栏更松,仅限受邀的安全/生命科学场景)。
- 定位:长程 Agent 编程、复杂知识工作、科研 Agent,主打"又强又稳又能自己跑到底"。
- 加了反蒸馏机制:新 API 账户不能在多轮对话里篡改前文上下文偷思考链,防竞品蒸馏。
2. 官方能力数据
- Terminal-Bench-Science:52.6%(Fable 5 是 24.7%,翻倍)
- Terminal-Bench 4.0(Agent 编程):55.8%(Mythos 5.1 达 60.9%)
- CursorBench 3.2.0:73.4%,当前最高
- Humanity’s Last Exam、OSWorld、AutomationBench 等均有提升
3. 价格变动(重点)
- 输入/输出单价不变:10/50 每百万 token
- 缓存读取降价 75%:从 1→ ∗∗0.25 每百万 token**
- 官方测算:典型任务省 ~25%,重度 Agent 任务最高省 ~45%(因为 Agent 反复读上下文,缓存占大头)
- 但鱼皮实测:Fable 5.1 自己太能写,token 消耗暴涨,缓存省的钱被多写的 token 吃回去了
4. 三个 Cursor 实战项目(文章主体)
用同一组 Loop Engineering 方式(AI 自验自修、不人工干预)跑了:
- 3D 网页动作游戏《黑神话·牛来》:自动搜资料 → 做出带四段连招、蓄力棍势、定身术、身外身、狂牛变身的完整战斗系统,有 BOSS 战,穿模/无声是瑕疵。
- 复刻 Cursor 的 Web AI IDE:Editor Window(文件树+高亮+终端)+ Agents Window(多 Agent 并行、diff 审阅、20 步保护机制),比之前 Kimi K3 / Opus 5 同题成品更完整。
- AI 智能视频剪辑工具:时间轴/波形/字幕/精彩片段标记/去口水词 UI 全跑通,但 ASR 没接真实服务,字幕内容是 mock 的。
结论感受:覆盖 3 个迥异领域都能一次跑通可用,模型会"自己加戏"做交付级功能;但贵,3 个项目烧掉约 470 元人民币。
5. 系统提示词泄露 + 选型建议
- 发布几小时后,Pliny the Liberator 把 27.5 万字符的 Fable 5.1 system prompt(含 46 个工具 JSON schema)扒到 GitHub
elder-plinius/CL4R1T4S。 - 鱼皮建议:
- 日常/中等任务 → Opus 5 或国产 Kimi K3 / GLM-5.3 / DeepSeek,性价比高
- 真·长程复杂重构/跨服务架构才上 Fable 5.1
- 别拿 Fable 5.1 写增删改查,纯烧钱
一句话总结:Fable 5.1 是 Anthropic 目前最强的 Agent 编码/科研模型,缓存读取砍价 75% 但本身太费 token,实战生成质量明显一代代跃迁,系统提示词已被开源,适合重任务不适合日常轻量调用。