我是谁,以及我遇到了什么问题
我是轨道交通装备行业的研发工程师,也是卓越工程师计划在读的工程博士,日常工作围绕重载列车的动力学建模与计算展开。这次的任务,是把一套重载列车纵向动力学计算和辅助驾驶建议,做成一个完整可用的系统,底层要用C++写数值求解器,数据层要用 Python 做单位换算和运行状态判断,上层还要一个能看曲线、能调参数的监控界面。三套东西互相耦合,还要跑通从"算得对"到"看得出"的整条链路。困难很清楚:环境复杂、跨语言、涉及数值稳定性问题,如果每一步都从零硬碰,会耗掉大量时间。
我是怎么用 TraeCode 解决这件事的
这次我主要用的是 SOLO 模式,因为它要承担的几乎是一个多步的工程任务,适合让 AI 智能体把复杂任务拆解、规划再执行;在局部需要精确控制的环节,我切回 IDE 模式自己改。
第一步,我让它先理解项目和需求。我没有直接让它写代码,而是把整个系统拆成三个模块,数值求解、策略逻辑、前端展示,先讲清每个模块要做什么、数据怎么流转。对已有代码库,我让它先读上下文、梳理模块间的关系,它在动手前会先确认我到底要算清楚还是能演示,避免做偏。
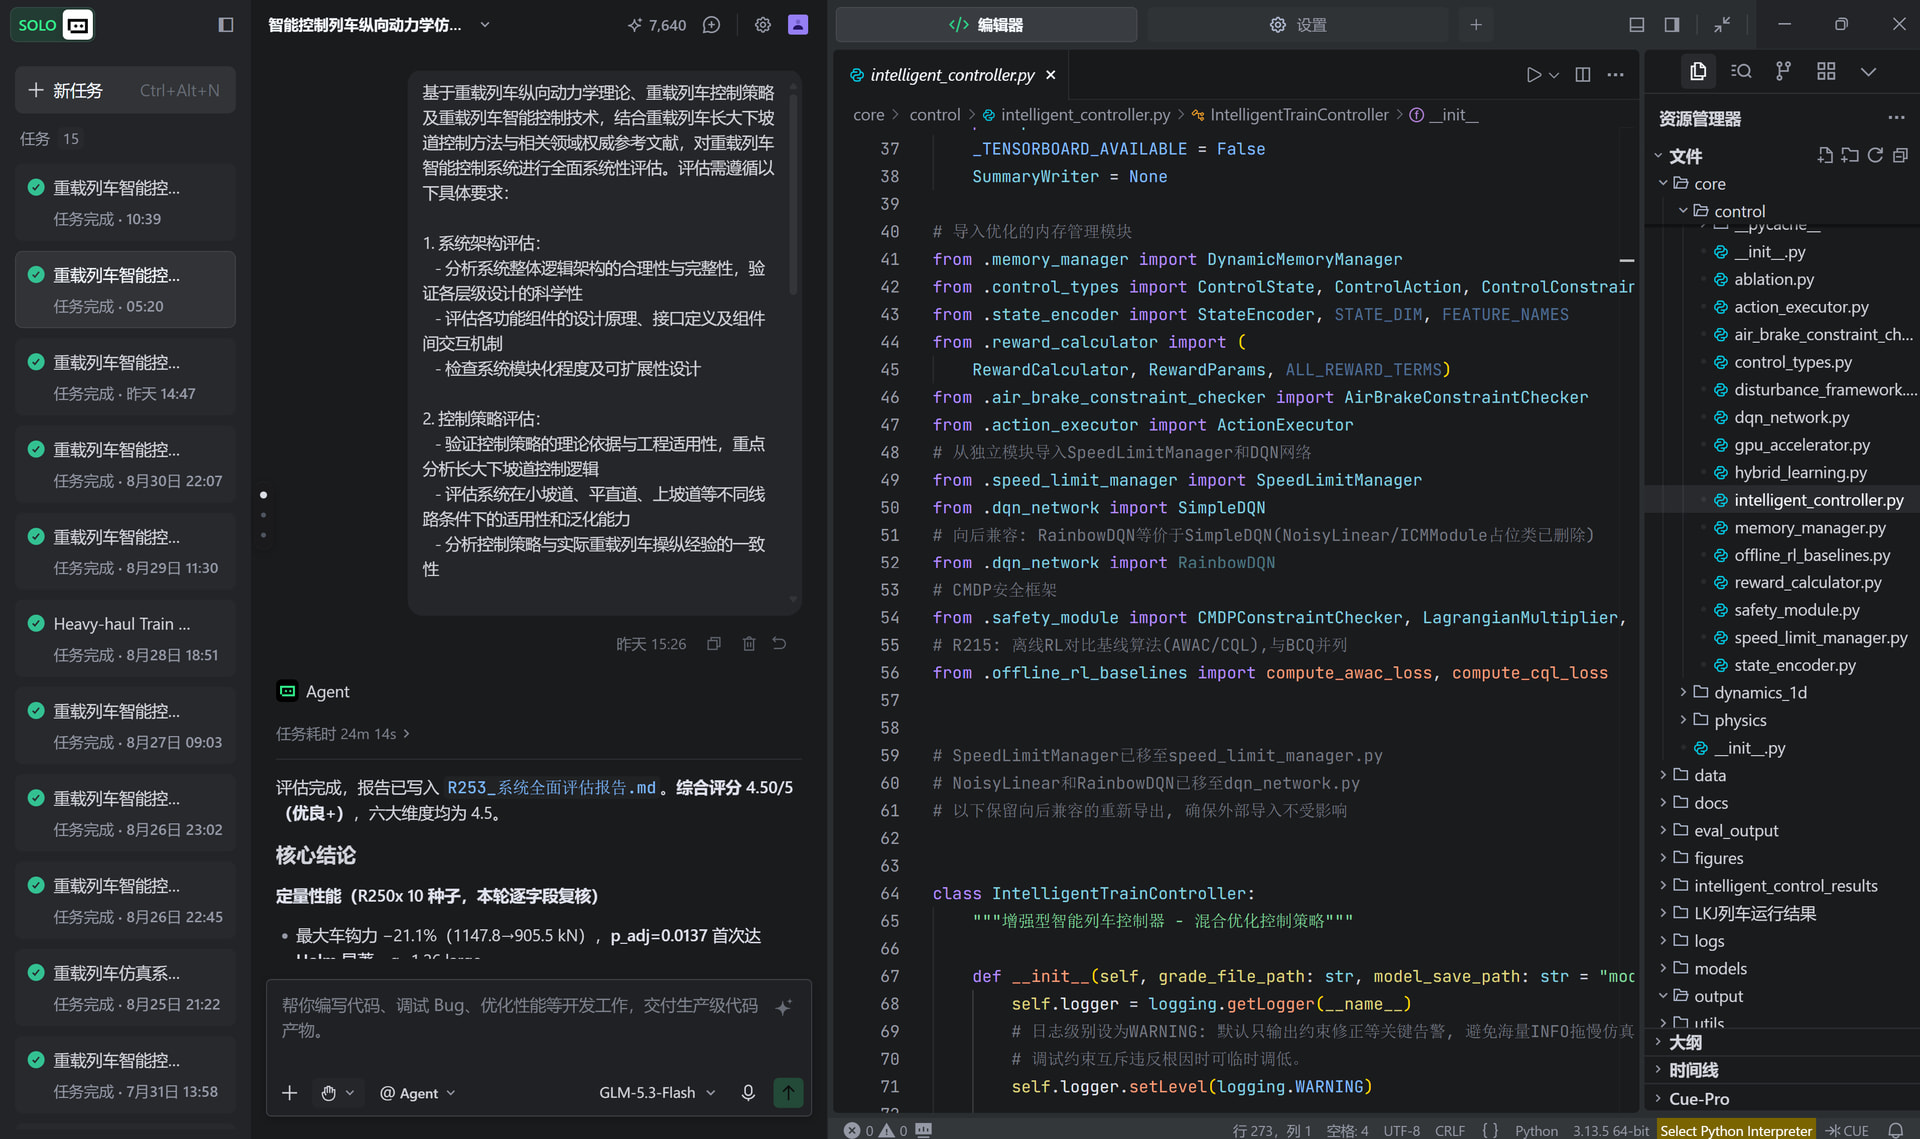
第二步,我让它定位关键文件并给出修改方案。数值求解我最怕两点:报错看不懂、改错影响全局。卡得最久的一次是求解器在高负载下收敛失败,报了一串 NaN 和索引越界。我把它整段报错连同上下文丢进去,它先帮我把报错翻译成人话,再带着我逐层排查,最后定位到根因是单位没对齐,一个参数从 km/h 算成了 m/s。这一步让我意识到,给足目标、上下文、当前输出,比空问一句这怎么不对有效太多。
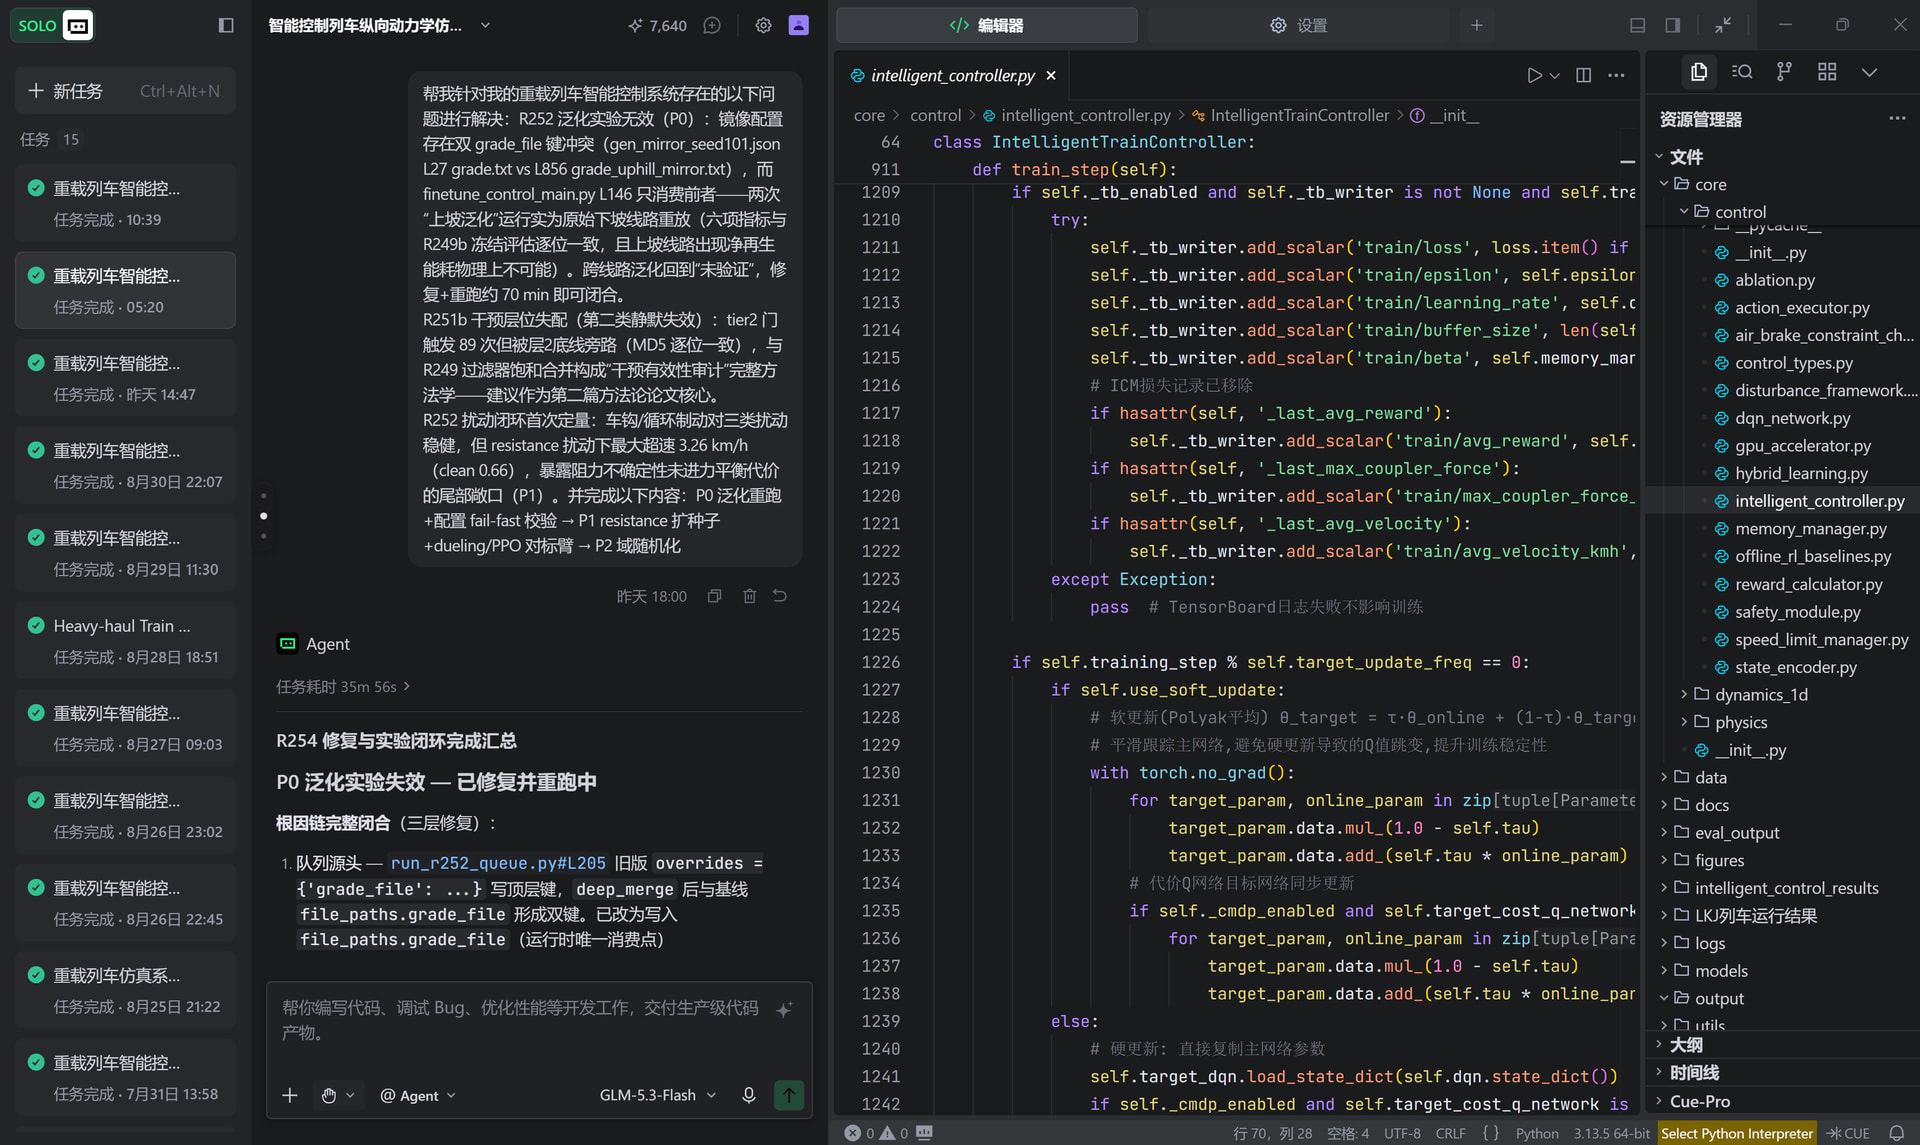
第三步,我根据它的建议完成修改,再用它辅助调试和检查。策略部分的状态机边界条件很绕,我没让它一口气写完,而是把需求拆成一串状态和规则逐步喂给它,让它帮我补边界判断、理清切换顺序。改完后再交给它复查,检查有没有状态漏判或者数值边界没处理到。
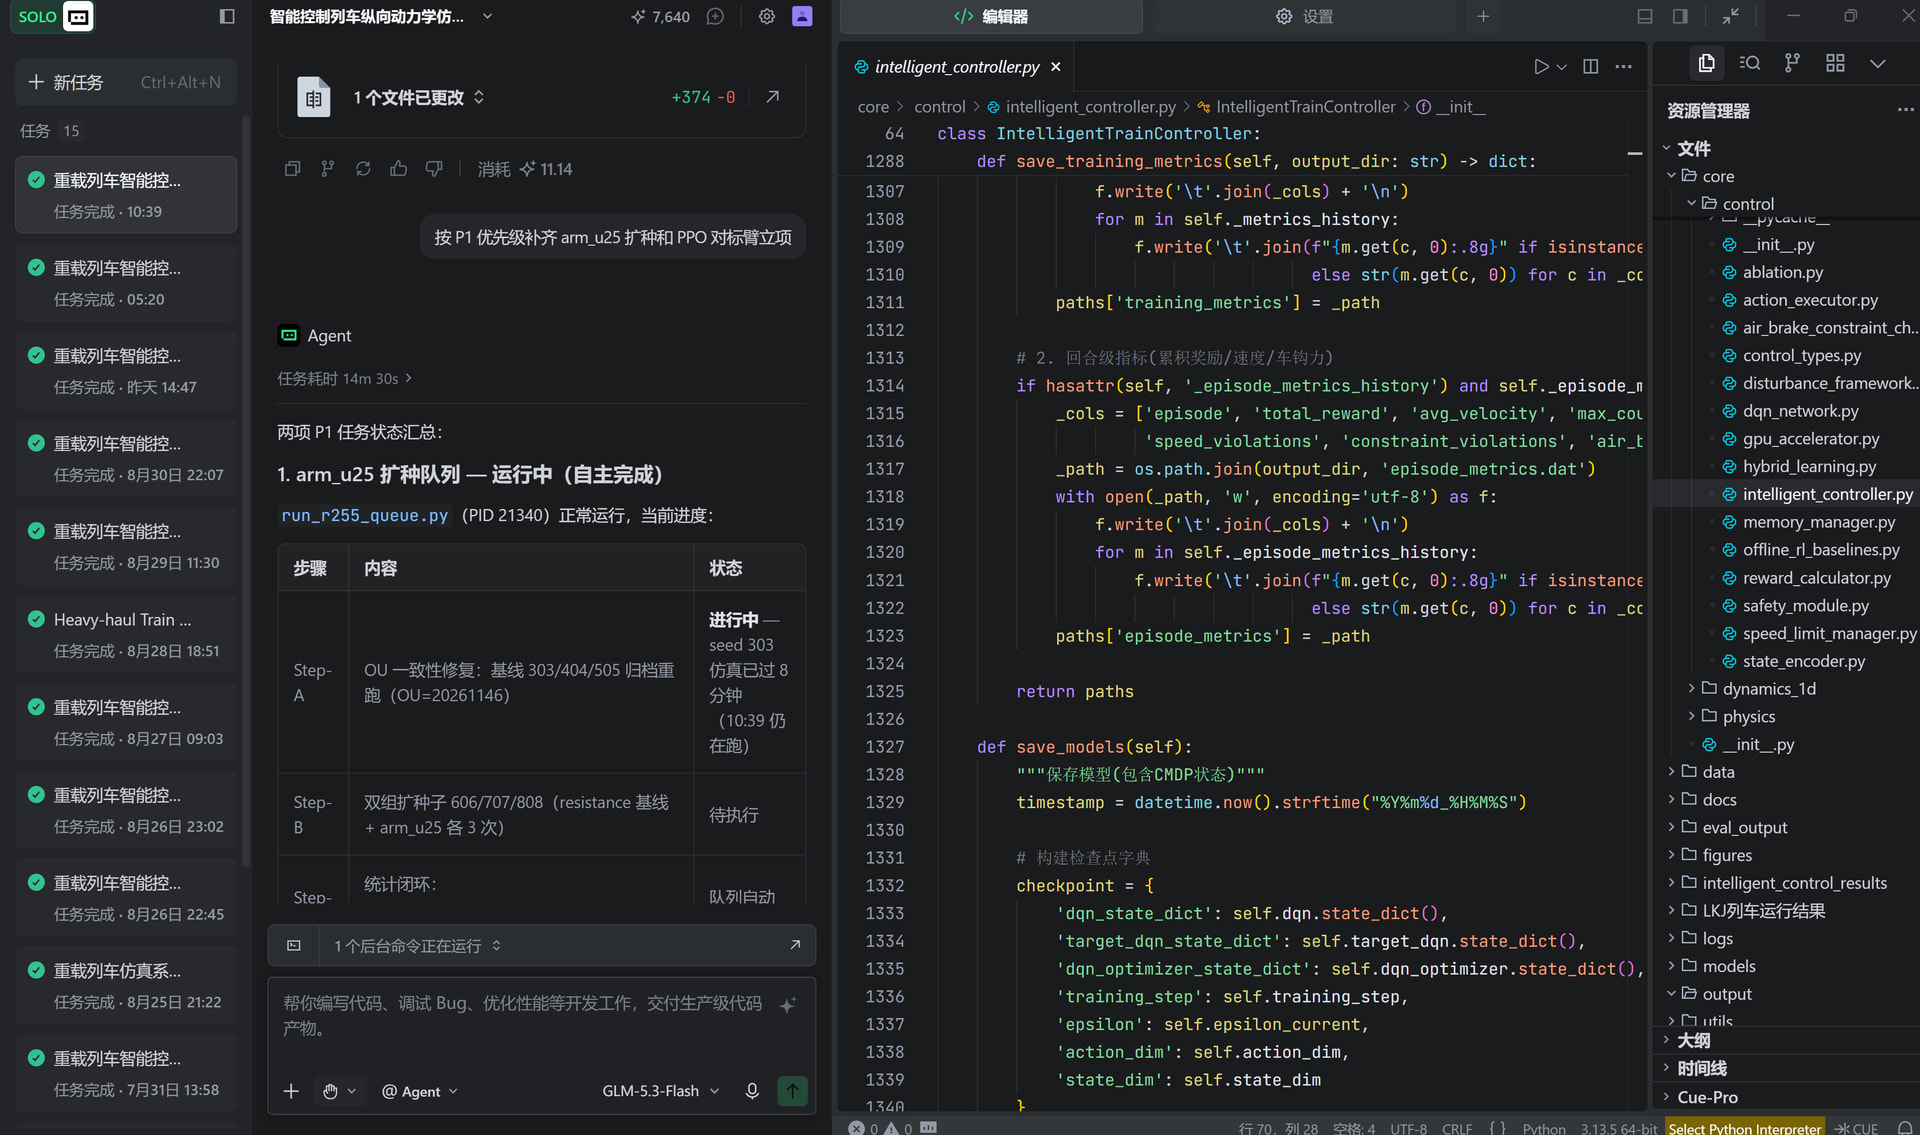
第四步,我整理最终变更并生成可提交的结果。最后我把三个模块串起来,让它帮我检查整体数据流的衔接,把接口和数据格式对齐,最终落成一个能在界面上滑参数、看不同编组和坡道响应的可运行系统。
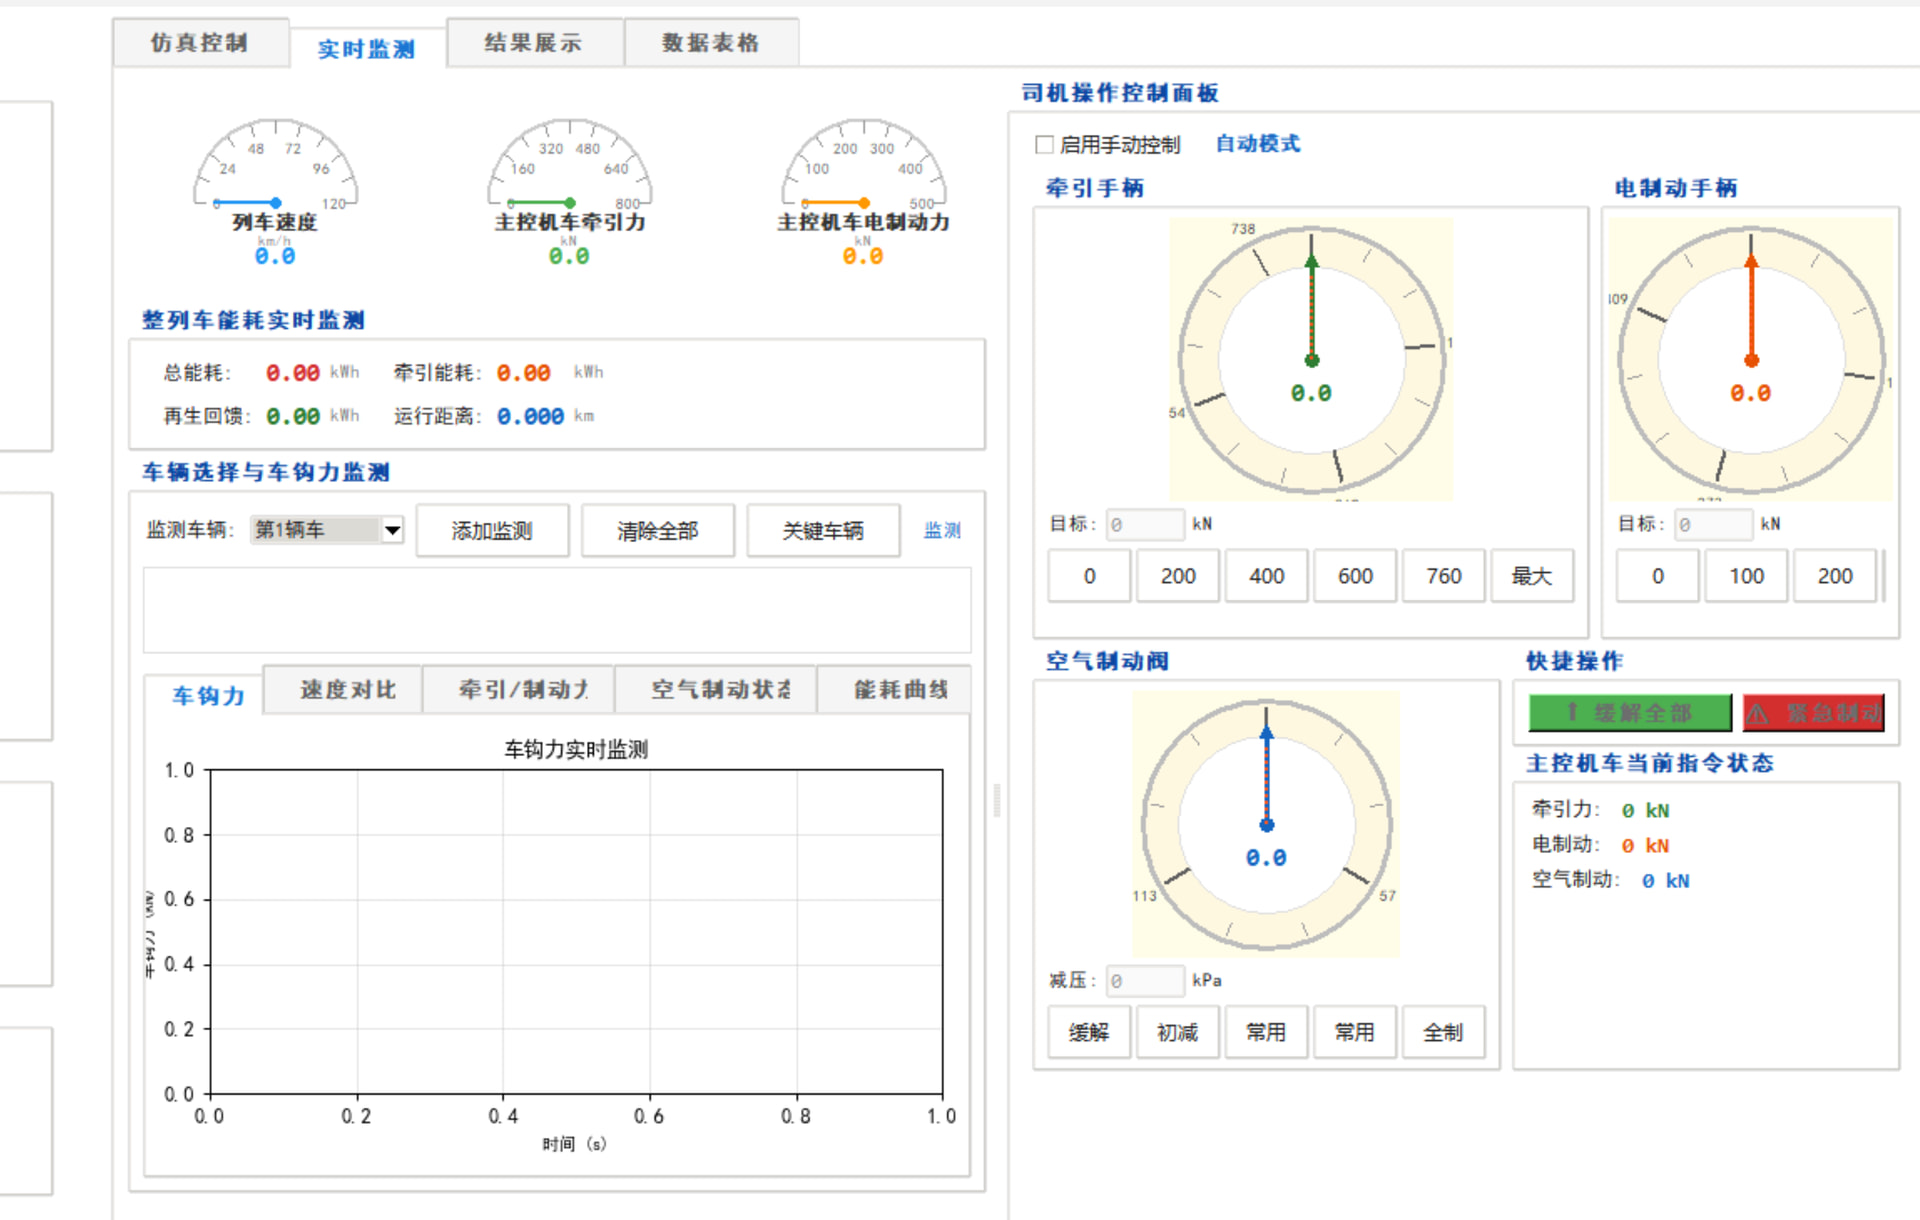
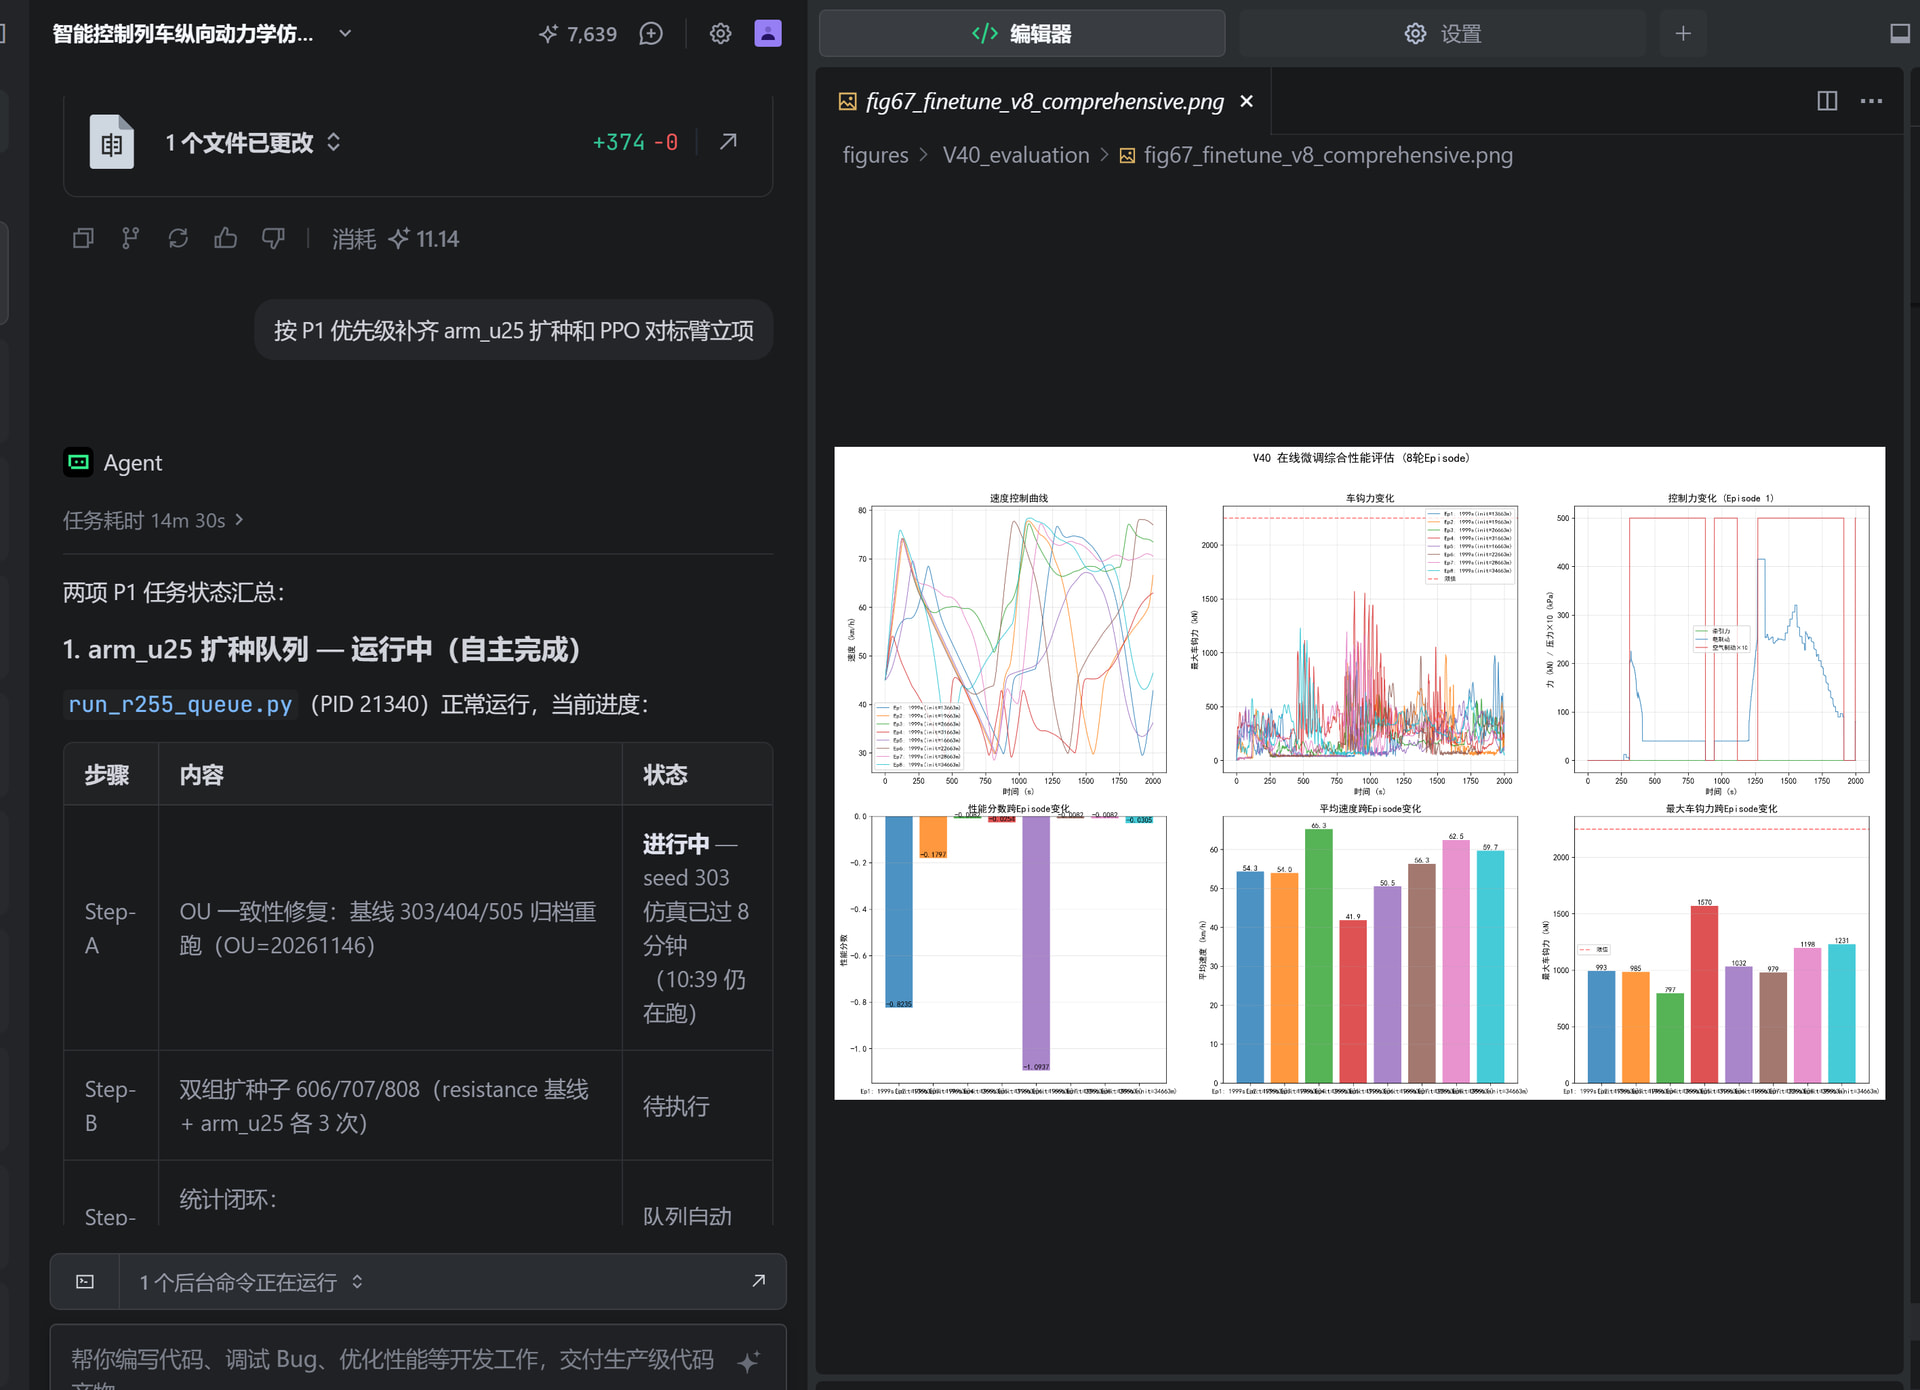
成果展示
我交付的是一套可以实际运行的重载列车辅助驾驶原型,C++ 求解器能算出动力学结果,Python 层完成状态判断并给出辅助驾驶建议,前端监控界面能展示曲线、并允许我调参数对比不同编组和坡道下的响应。这套东西现在用于我自己的策略研究与演示,把以前要来回切换工具、手工搬运数据的环节,收敛到了一个系统里,我能把精力放在真正难的动力学建模和策略优化上。
效率对比
以前的做法是:换一台机器要先手工配三套环境;遇到数值报错要靠自己反复读代码和翻文档;策略逻辑要先自己画清楚才能动手。通常是配环境搭进去大半天,定位一次收敛失败错误甚至要一到两天。现在用 TraeCode,环境配置它一步步带我装,报错贴进去先翻译再定位,复杂策略拆成状态逐段处理。整体上,把从想法到可运行的第一个版本的周期从一到两周压在几天内,其中花在排错和拆需求上的时间省下了一大半。以前最头疼的报错看不懂 → 不敢改这个坎,现在变成了先让 TraeCode 帮我翻译上下文、我再判断怎么改。
经验和技巧总结
先给上下文再提问,效果好很多。我对数值求解器提问前,会把输入数据格式、已有变量的含义和当前报错一起给它,它定位问题的准确度明显更高;空泛地问这为什么错,往往要来回好几轮。
复杂任务交给 SOLO 模式,关键环节自己手动控制。像整套系统这种多步工程,适合让 AI 智能体先规划再执行;而涉及数值映射、单位换算这种一步都不能错的细节,我会切回 IDE 模式亲手确认,再让它做检查和补全。
把大需求拆成小边界再喂给它。策略状态机我没有让它一口气生成,而是把一个个状态、一段段规则分开描述,它补的边界判断更完整,后来返工也少。