我希望 TraeCode 未来可以把每一个偶发 Bug 封装成可一键重放的「故障胶囊」
一句话愿景: 让测试或用户把 Bug 发生瞬间的操作、日志、网络、环境和代码版本封装成一个可分享、可脱敏、可一键重放的“故障胶囊”,再由 TraeCode 自动完成复现、定位、修复与回归验证。
活动:我对 TraeCode 的未来愿景|分享你对产品的期待
一、介绍自己
我是一名独立开发者和技术爱好者,平时会使用 TraeCode 开发个人项目、自动化工具,也会借助它理解陌生代码、排查错误和完成需求修改。
AI 已经让“写出代码”变得越来越快,但在真实开发中,我发现最耗时间的往往不是写代码,而是先回答一个看似简单的问题:
这个问题到底是怎么发生的?
测试人员发来一张截图,说:“刚才这里白屏了。”用户说:“偶尔点两下就会卡住。”同事给出半段日志,但忘了当时使用的分支和环境。等我在自己的电脑上打开项目,一切正常。
接下来只能反复追问:点了什么、先后顺序是什么、接口返回了什么、浏览器是什么版本、当时网络是否波动、使用的是哪一次构建……最后大家最常听到的还是那句话:
“我这里复现不了。”
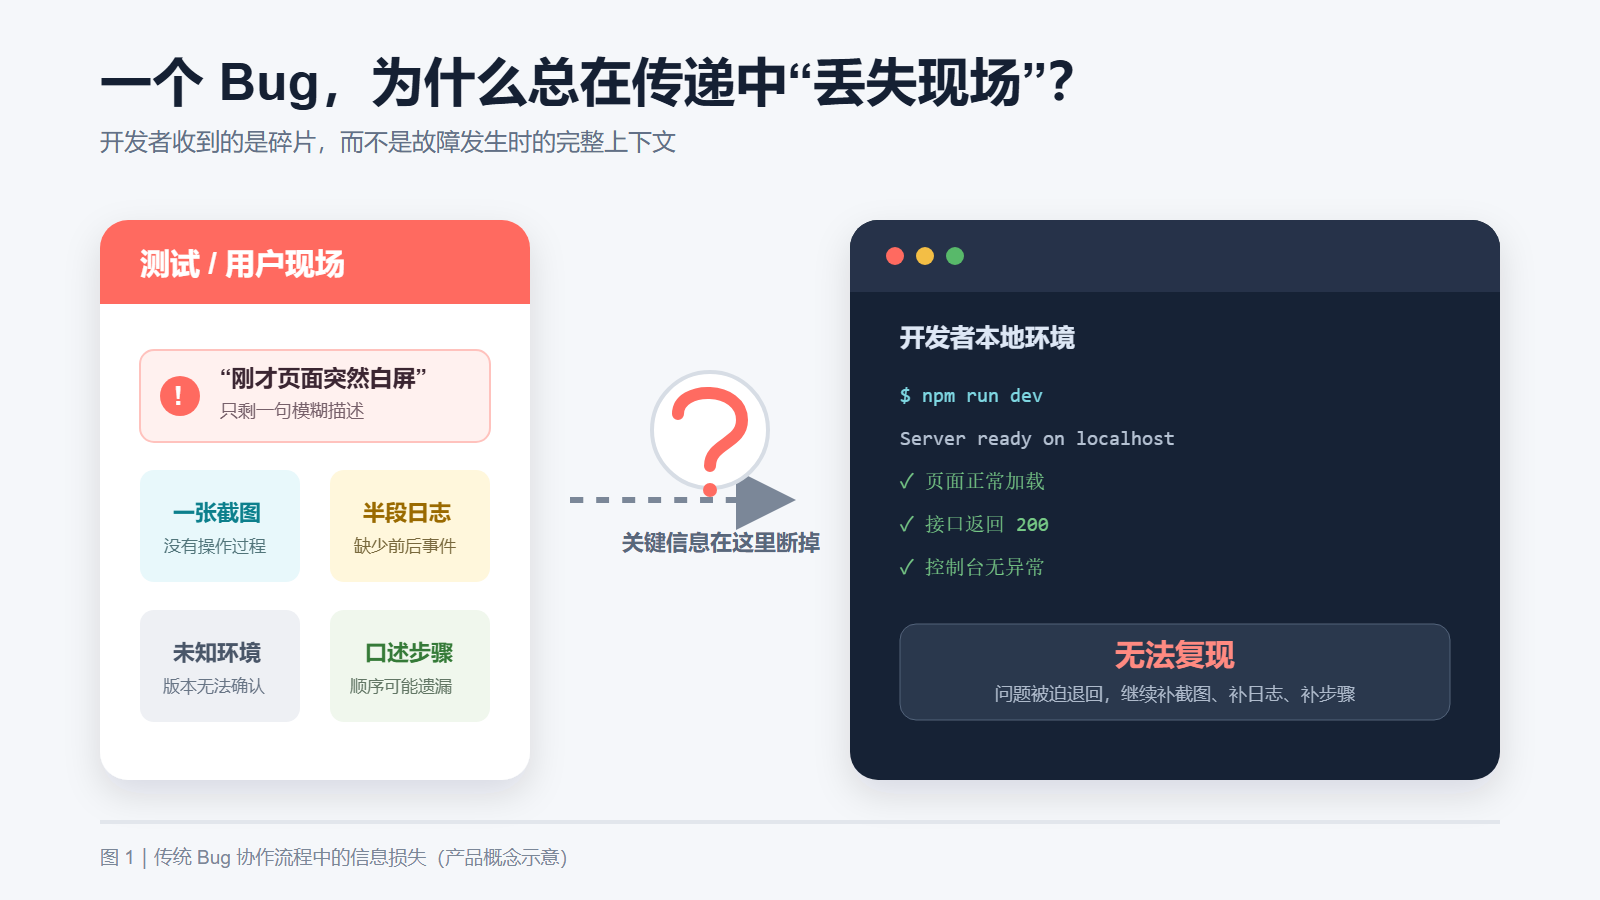
图 1:传统 Bug 协作中,截图、日志、环境和操作步骤彼此分离,真正的故障现场在传递中不断丢失。
二、当前场景中的核心卡点
1. 截图能证明“坏过”,却不能说明“怎么坏的”
截图只能保存最后一帧。它无法告诉开发者用户此前点击了什么、状态如何变化、哪个请求最先异常,也无法还原问题发生时的时序关系。
2. 日志与操作不在同一条时间线上
控制台日志、接口请求、页面录屏和用户描述通常来自不同工具。开发者需要凭经验手动拼接这些碎片,还可能把“结果”误判为“原因”。
3. 偶发问题高度依赖环境
弱网、旧缓存、特定浏览器、灰度配置、依赖版本、窗口尺寸和并发时序,都可能成为触发条件。只复制一段错误信息,很难恢复这些条件。
4. 修复之后缺少同条件验证
很多 Bug 最终以“我改了一处代码,试了一下好像没问题”结束。由于最初的现场无法重现,团队也无法证明修复确实覆盖了原问题,更难防止以后再次回归。
三、我的愿景:Bug 可复现胶囊
我希望 TraeCode 新增一项项目级能力:故障胶囊(Bug Replay Capsule)。
它不是普通录屏,也不是把所有日志粗暴压缩到一起,而是一份可以被 TraeCode 理解并重新执行的“最小故障现场”。
测试或用户只需点击一次“记录问题”,TraeCode 就会在授权范围内采集复现所需的上下文,自动脱敏并生成一个 .trae-bug 文件或安全分享链接。
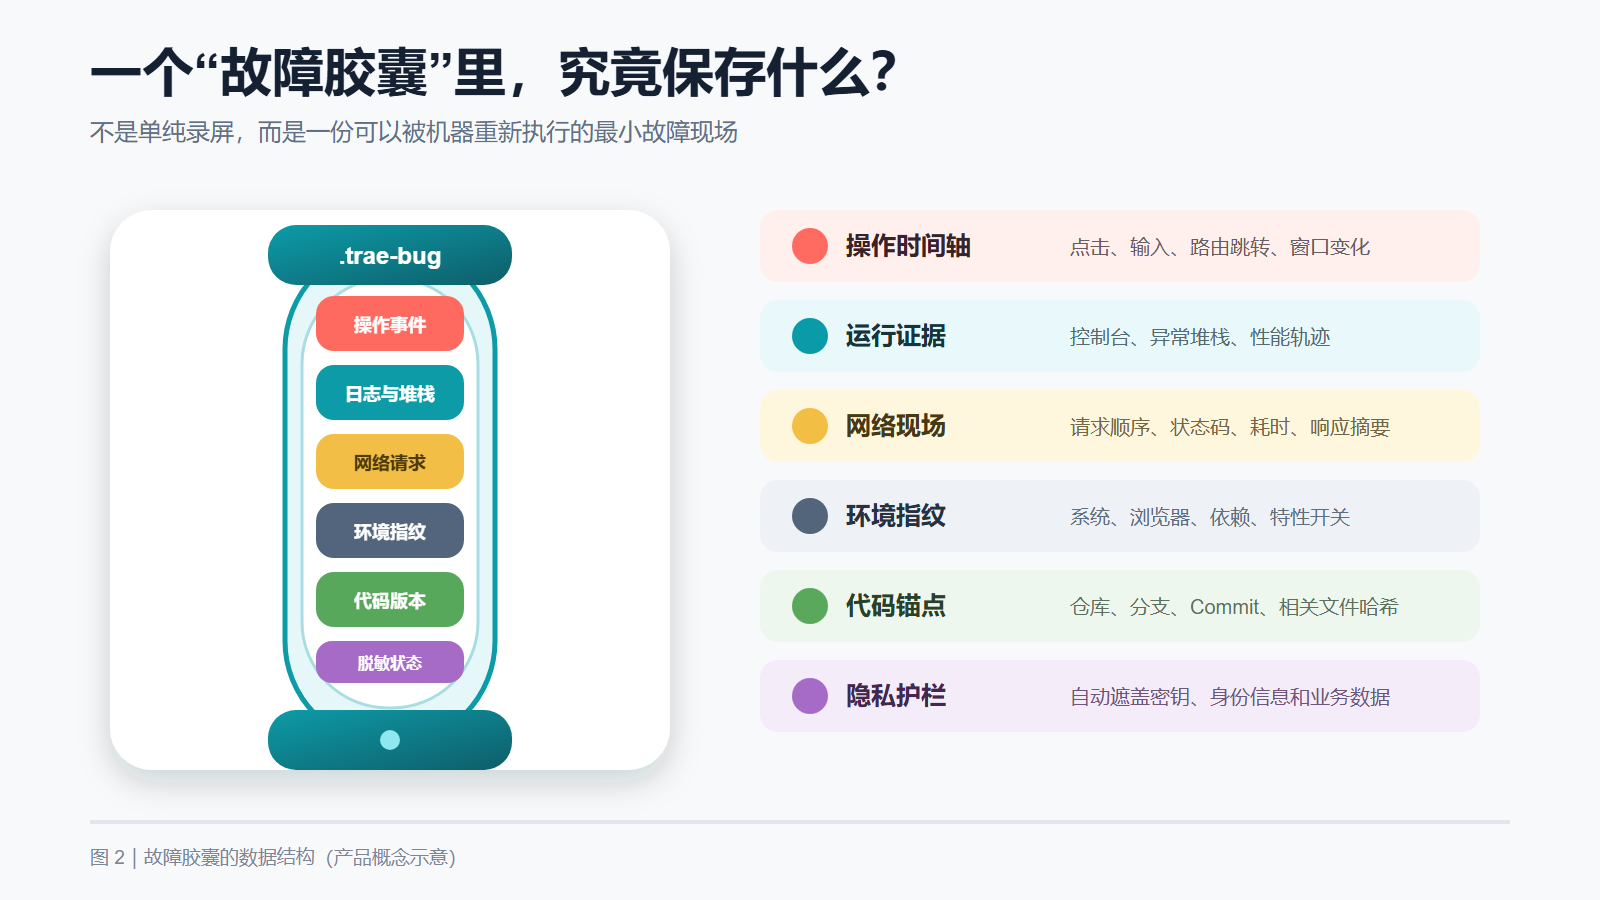
图 2:胶囊同时保存操作、运行证据、网络现场、环境指纹和代码锚点,并在分享之前经过隐私脱敏。
胶囊中可以包含
- 操作时间轴: 点击、输入、滚动、路由跳转、窗口变化,以及每个事件的精确时间。
- 运行证据: 控制台日志、异常堆栈、性能轨迹和关键状态变化。
- 网络现场: 请求顺序、状态码、耗时及经过脱敏的请求与响应摘要。
- 环境指纹: 操作系统、浏览器、运行时、依赖版本、设备特征和功能开关。
- 代码锚点: 仓库、分支、Commit、构建编号以及相关文件哈希。
- 页面状态: 必要的截图、DOM 快照、本地状态和最小测试数据。
- 隐私规则: 自动遮盖 Token、Cookie、手机号、身份证号、客户数据及内部地址。
四、它如何完成一次 Bug 闭环
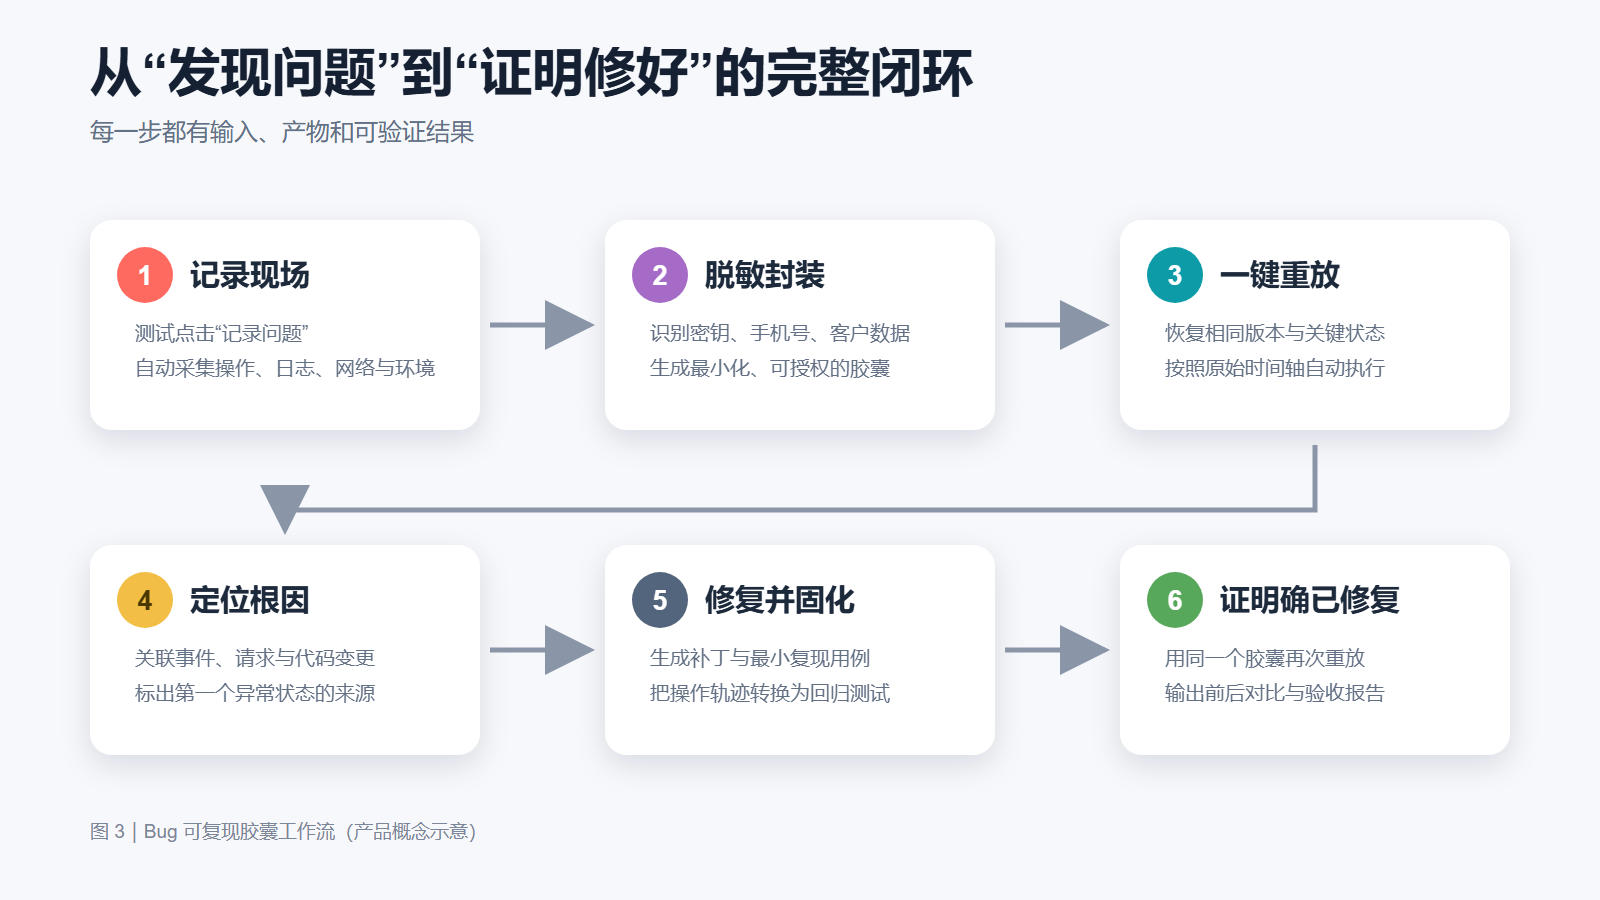
图 3:从记录现场到再次重放验证,整个流程围绕同一个故障胶囊展开。
第一步:一键记录现场
在 TraeCode 的浏览器预览、终端运行面板或测试工具中增加“记录问题”按钮。测试人员复现问题后停止记录,系统自动保留异常前后必要的时间窗口。
为了避免录制内容过大,TraeCode 可以利用代码和运行上下文,只提取与故障有关的最小信息。例如页面白屏时,优先保留此前的路由、组件异常、接口响应和状态更新,而不是上传整段无关录像。
第二步:自动脱敏与授权
胶囊生成前,TraeCode 先扫描敏感内容,提示哪些字段将被删除、替换或仅在本地保留。分享者可以选择:
- 仅团队成员可访问;
- 链接在指定时间后失效;
- 禁止下载原始响应,只允许在受控沙箱中重放;
- 只分享问题相关片段,不分享完整业务数据。
第三步:在隔离环境中一键重放
开发者收到胶囊后,点击“在 TraeCode 中重放”。TraeCode 根据代码锚点切换到对应版本,恢复必要环境,并按照原始时间轴重新执行操作。
如果第一次没有稳定触发,TraeCode 可以围绕已记录条件进行受控探索,例如改变网络延迟、窗口尺寸、缓存状态或操作间隔,寻找问题的真正触发边界。
第四步:把事件、请求与代码对齐
重放过程中,TraeCode 将用户操作、页面状态、网络请求、控制台日志和代码执行位置放到同一条时间线上,并标记“第一个异常状态”,避免只追着最后一个报错修补。
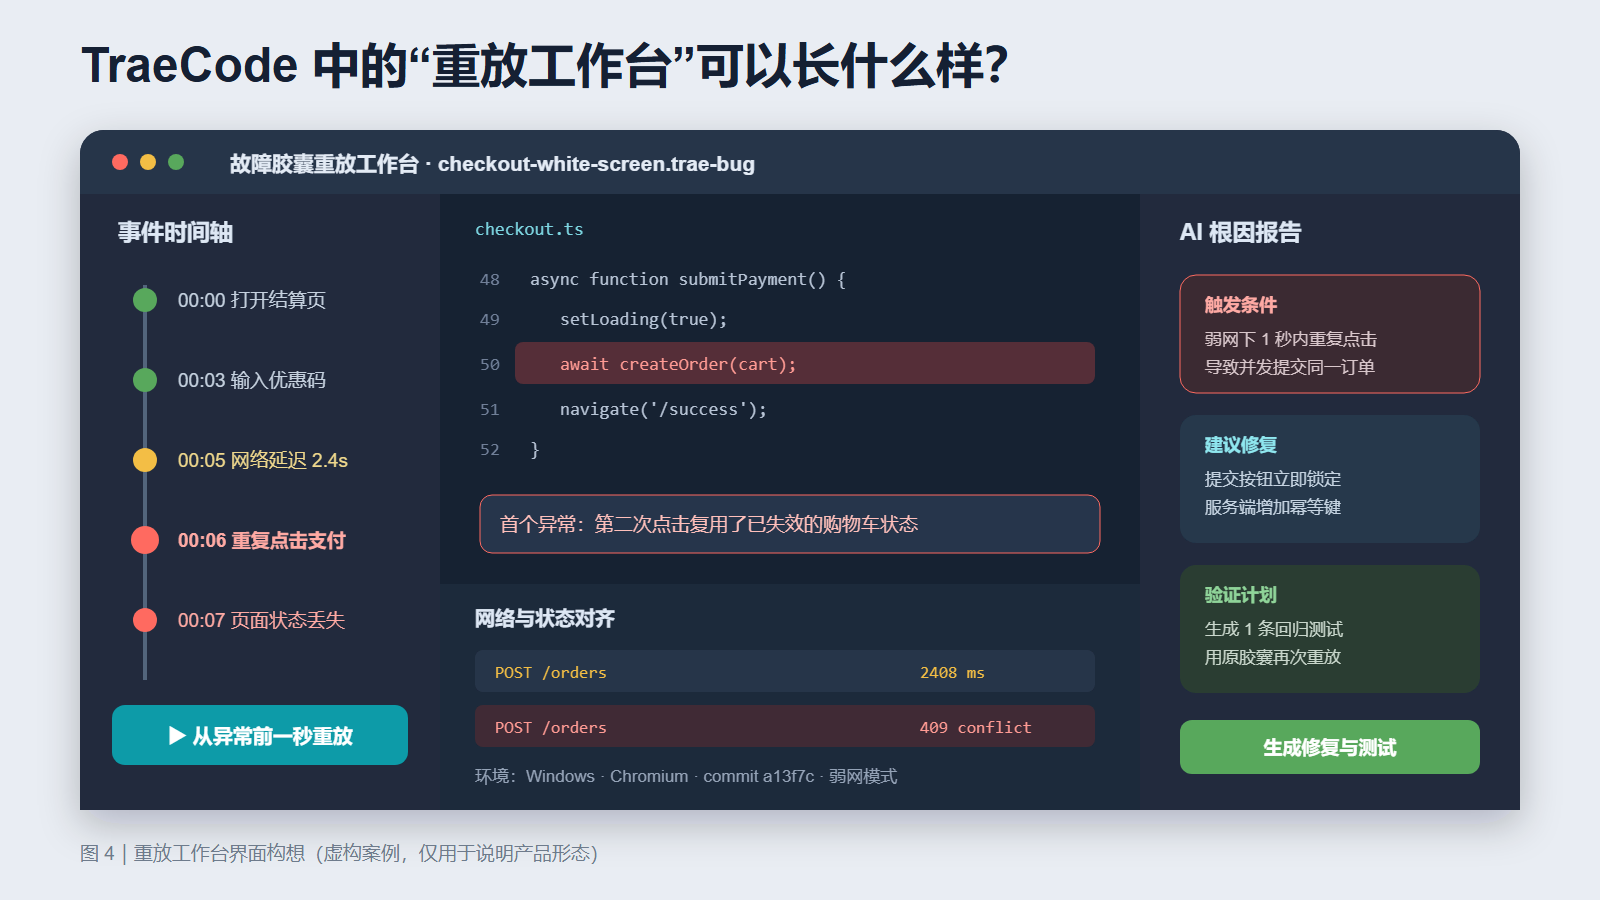
图 4:左侧是原始操作时间轴,中间关联代码与网络状态,右侧给出触发条件、根因和验证计划。图中为虚构案例。
第五步:生成修复和最小回归测试
在定位根因后,TraeCode 输出的不应只有补丁,还应包括:
- 最小复现条件;
- 根因与触发链路;
- 建议修复及可能影响范围;
- 由原始操作轨迹转换而来的自动化回归测试;
- 需要人工确认的业务假设。
第六步:用同一个胶囊证明“真的修好了”
应用修复后,TraeCode 再次重放原胶囊。如果同样环境、同样操作和同样时序下不再出现问题,且回归测试通过,系统才生成一份结构化验证报告。
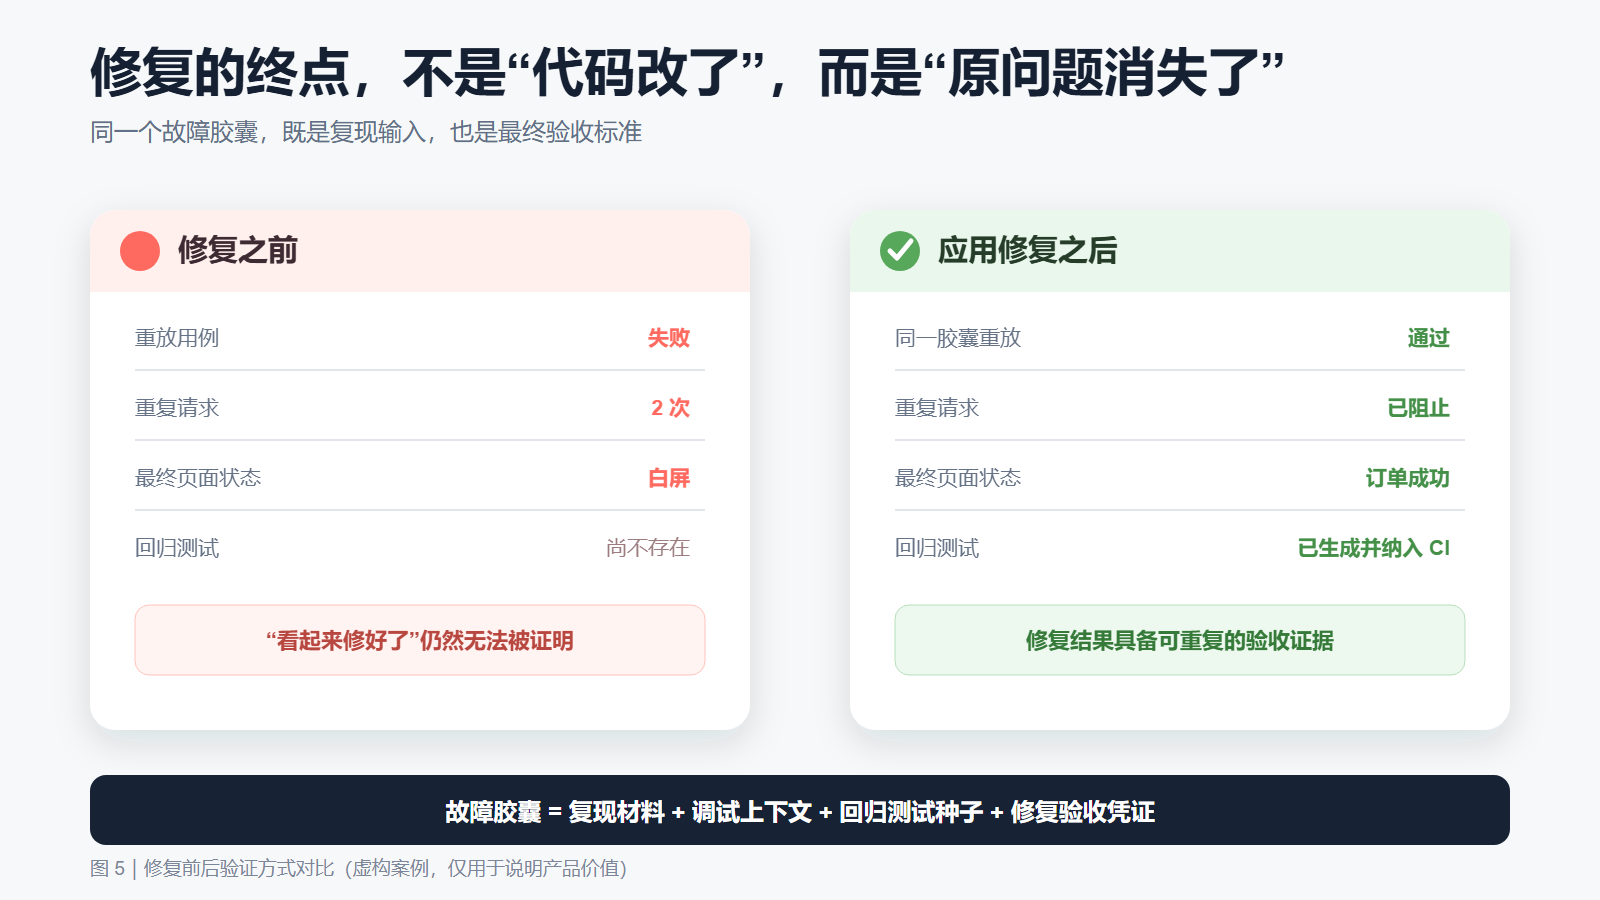
图 5:同一个胶囊既用于重现问题,也用于修复后的验收,最终沉淀为可持续运行的回归测试。图中数据为虚构示例。
五、希望它以什么产品形态出现
1. “记录问题”按钮
出现在浏览器预览、移动端调试、终端运行和测试面板中。点击即可开始或结束故障捕获,录制时始终显示明确状态。
2. 故障胶囊侧边栏
按项目展示胶囊列表,包括问题状态、对应代码版本、触发环境、权限和最近一次重放结果。
3. 重放工作台
以时间轴为核心,将操作、截图、网络、日志、代码和状态变化对齐。开发者可以暂停、单步执行,或者从异常前一秒重新开始。
4. /replay-bug 命令
允许开发者在对话中直接说:
/replay-bug checkout-white-screen.trae-bug
TraeCode 自动分析胶囊、制定复现计划,并在执行可能影响环境的操作前请求确认。
5. 工具链联动
胶囊可以作为 Issue 或任务附件,与 GitHub、GitLab、Jira、飞书等协作工具关联;修复完成后,自动把复现条件、补丁摘要、测试结果和前后对比写入 PR。
六、它能为不同角色带来什么价值
| 角色 | 当前困扰 | 故障胶囊带来的变化 |
|---|---|---|
| 用户 / 测试 | 不知道怎样准确描述问题 | 通过一次录制保存必要现场 |
| 开发者 | 反复询问环境和操作步骤 | 一键恢复并重放真实条件 |
| AI Agent | 只有零散日志,容易误判根因 | 获得结构化、时间对齐的调试上下文 |
| 项目负责人 | 无法确认问题是否真正修复 | 获得可审计的前后对比报告 |
| 团队 | 同类问题不断重复出现 | 将真实故障直接沉淀为回归测试 |
七、我认为必须守住的边界
故障胶囊会接触运行日志、网络请求和用户状态,因此这项能力不能只追求“采得多”,还必须坚持最小化与可控原则:
- 默认不采集密码、密钥和完整 Cookie;
- 敏感字段在离开设备之前完成本地脱敏;
- 用户可以预览、删除和修改即将分享的内容;
- 胶囊具有权限、有效期和访问记录;
- 生产数据只允许在授权沙箱中使用;
- AI 生成的修复必须经过测试与人工确认,不能直接操作生产环境。
我希望它成为一种可信的调试协作协议,而不是另一种不透明的数据采集工具。
八、最后想说
今天的 AI 已经很擅长“看着报错修改代码”,但真实世界里最困难的 Bug,往往连稳定的报错都没有。
当用户的操作结束、页面刷新、日志滚走、环境升级之后,那个真正有价值的故障现场也随之消失。开发者和 AI 只能根据残留的碎片猜测发生了什么。
所以我希望未来的 TraeCode 能够再向前一步:
让每一个 Bug 都可以被重放,让每一次修复都能够被证明。
当“我这里复现不了”不再是排查工作的起点,AI 编程工具才真正从代码生成器,走向理解并守护软件运行过程的工程伙伴。
文中所有产品界面、工作流和案例图片均为愿景示意,不代表 TraeCode 已上线功能。主视觉由 AI 生成,其余信息图为可编辑矢量图。