订阅他们吃大亏
3 个赞
作业,呜呜呜,太多了。。。。。
4 个赞
希望自己真实的体验能被看到,也希望能够入选咯!
4 个赞
新建的时候,选不到 TraeCode 上手记 这个话题啊
4 个赞
之前每月都需要做工作总结,现在直接吧资料丢给trae,不一会工作总结就写好了。使用起来方便多了。
4 个赞
 不是小白了,老手记
4 个赞
TraeCode 上手记:我是一名高级设计师,进行船舶材料设计,我用traecode解决型材套料问题:
一步步引导trae帮我开发出可用的套料算法
原来是手工团队进行手工套料,费时费力。我开始尝试开发套料算法解决:
1)trae工具初接触。同事会编程,懂开发,他比我先使用AI进行开发。让我安装trae,他说可以通过TRAE就直接实现我想要做的开发
2)许愿式提问:开始我只是讲解我要实现套料,没有给太多的提示。对话多伦后仍然没有达到我想要的结果
3)任务流程拆解:经过网上学习,同事请教,教我要将任务分解。我开始把任务流程进行梳理,梳理输入文件的格式、需要提取的数据、如何进行材料分类、原材料的情况、套料算法和要实现的结果,输出文件格式。
4)任务逐步提问:根据梳理的流程一步步让trae帮我实现:并逐步测试检验,连续交互。
5)用AI解决调试问题,在连续交互过程中测试的问题我不懂,但是TRAE懂,他能直接帮我把程序优化调试好。
6)经过一周不到的时间,就把程序调试成可用。全年可以节约我600多小时,套料利用率也得到提升。
给后来人的建议:先顺流程,在将任务拆解,逐步提问,解决每一步问题,用trae调试trae代码,最终实现想要的结果
3 个赞
cy 先蹲后发帖
3 个赞
不是高中,初一就开始上了
3 个赞
 自顶一个
2 个赞
【TraeCode 上手记】9 张插画一键变 GIF,我用 TraeCode 搞定了动图批量生成
我这次想解决什么
手上有一张 3×3 格的卡通插画九宫格(润怡 × bilibili 的联名宣传图),想把每一格都做成动态 GIF 动图,用来发社交媒体。
以前做动图的路径是:先用 PS 切片 → 再找 AI 视频生成工具一张张生成 → 下载视频 → 用格式工厂转 GIF → 还要手动调尺寸和循环。9 张图来回折腾至少大半天,而且不同工具之间切来切去很容易乱。
这次想试试能不能在 TraeCode 里一条龙搞定:从图片分析、裁剪、AI 生成动态视频、到转 GIF 全流程跑通。
我是谁,为什么这件事对我重要
我是做运营的,平时经常需要做一些社交媒体素材。不是程序员,但会点基础的命令行,也经常用 AI 工具。
之所以想到用 TraeCode,是因为之前每次做动图都要在好几个工具之间来回跳:
-
先开 PS 切图
-
再开网页版 AI 生视频(还要等排队)
-
再用 ffmpeg 或者在线工具转格式
-
9 张图就得重复 9 遍同样的操作
而且经常遇到尺寸不对、循环不流畅、文件名混乱等问题。一直想找个方式把这些步骤串起来,一次性跑完。
我是怎么把 TraeCode 慢慢用顺的
第一步:先让它"看懂"图片
最开始我只丢了一句"帮我把这张图每格都做成 GIF"。TraeCode 没有直接动手,而是先分析图片结构——它用 Python 检测了分隔线,确认是 3×3 九宫格,然后把 9 张小图都裁了出来,还问我想要什么样的动画效果。
这一步让我意识到:不用替它规划步骤,把目标说清楚,它自己会找方法。
第二步:动画效果它会主动设计
我选了"AI 生成动态视频"的方案。然后我发现它不是机械地一张一张生成,而是先把每张图的内容都分析了一遍——哪张是粉色主题、哪张是绿色调、角色在做什么动作,然后给每张都设计了对应的动效:
-
有"比心"画面的 → 设计成眨眼+双手比心
-
有"踢病毒"画面的 → 设计成武打踢腿动作
-
有"戴耳机"画面的 → 设计成跟着音乐点头
如果换我自己来写提示词,9 张图估计得写半小时,还不一定能描述准确。
第三步:边生成边转换,效率拉满
最让我惊喜的是它的并行处理方式——不是等 9 个视频全生成完再一起转 GIF,而是生成一张就立刻转一张,下一张视频生成的同时上一张在转格式,时间几乎叠掉了一半。
中间我完全没插手,就看着它一张一张地完成。
第四步:超出预期的细节
全部做完后,它还额外做了一个 HTML 合成页面,把 9 张 GIF 按原始九宫格的布局拼在一起,可以直接在浏览器里预览整体效果。这个我完全没提,但它做了——因为它理解我最终是想"看九宫格动图效果"。
我最后做成了什么,想给后来的人留一句什么建议
最后 9 张 GIF 全部按要求完成:400×400px、3 秒循环、无限播放,而且每张的动效都和画面内容匹配,不是随便乱晃的那种。
整个过程从上传图片到拿到全部 GIF,大概二十多分钟。如果是我自己手动做,保守估计得半天以上。
如果让我给下一个想用 TraeCode 的人一句建议:
不要把它当成"高级搜索框",把它当成"能帮你干活的搭档"——直接说你最终想要什么(“我要 9 张 GIF”),而不是你觉得应该怎么做(“帮我用 ffmpeg 转格式”)。它会自己选工具、排步骤、甚至帮你想到你没说出口的需求。
2 个赞
开学依旧猛冲trae
2 个赞
晒出我的小小心得
2 个赞
TraeCode 上手记】我用 TraeCode 把一份"不干净的老补丁"移植到了重构后的 bootloader 了。
Debug Session: dram-hang-addresswbbk
Status: [CLOSED - 2026-07-11 post-fix baseline applied]
Bug: RAYSON-MEMORY-TEST 启动后 DRAM test 正常打印地址范围与 dcache_was_on=1,但 `[1/4] address-writeback … ` 之后无任何输出,串口"卡死"。
Expected: 应依次打印 OK/FAIL + 后续 Test2/3/4 + PASSED/FAILED 汇总。
Platform: Amlogic S6, LPDDR5 4224Mbps, BL2 识别 dram_total_size_MB=30720; 本镜像测试段 0x0800_0000 ~ 0xded4_8000 = 3437 MB, dcache_was_on=1.
Root Cause 最终结论 (2026-07-11)
经过对照 board_r_test5_pass.c (固定范围 0x08000000+0xCE000000, 无喂狗无 cache 控制却通过) 的反证,**本次卡住并非单一 H1~H5,而是三条路径同时存在:**
| 真因 | 对应假设 | 证据/反证 | 风险等级 |
|---|---|---|---|
| RC-A: 只调 WATCHDOG_RESET() 未调 schedule() | H1 的变体 | Amlogic S6 走 `CONFIG_WDT=y` (DM 驱动 + cyclic 喂狗),`WATCHDOG_RESET()` 宏展开为空,真正喂狗由 `cyclic_run()` 遍历 `wdt_feed`;run_main_loop 阶段实际完全不喂 (之前担心 schedule() 不安全纯属误解,run_main_loop 在 init_sequence_r 尾部,dm/cyclic/wdt 初始化早已完成,和 main_loop() 里每 tick 调 schedule() 是同一路径)。3437MB 单字非缓存写 120 秒 + 无喂狗 = WDT 硬复位 silent hang | **致命** |
| RC-B: 动态 safe_top (=gd->relocaddr-64MB) 可能 > 0xD600_0000 | H5 | board_r_test5 固定到 0xD600_0000 结束,原算法算到 0xDED4_8000,多出 141MB 恰好落在 OP-TEE static shm / Framebuffer 预留窗口,写此段触发 SError | **致命** |
| RC-C: 进度打印间隔 256MB 太稀 | 观察点 O2 的变体 | 3437MB 写循环 12~30 秒无任何输出,和 WDT silent reset 表现完全一致,肉眼无法区分;用户误判为"卡住" | 中 (诊断层面) |
已落地 Fix (post-fix baseline)
| 编号 | 改动 | 对应 RC | 位置 |
|---|---|---|---|
| HANG-FIX A | `DBG_WDT_PROG` 宏里 **同时** 调 `WATCHDOG_RESET()` + `schedule()`,双保险;喂狗间隔从 128KB (1<<15) **加密到 64KB (1<<14)** | RC-A | board_Multi-Pattern_DCache_r.c 宏定义区 |
| HANG-FIX B | 默认范围对齐 board_r_test5_pass:`pass_base=0x08000000, pass_len=0xCE000000 (end=0xD6000000)`;保留动态 safe_top_cap 计算作为校验,`use_end = min(pass_end, safe_top_cap)` 确保不会超越任一上界 | RC-B | board_Multi-Pattern_DCache_r.c run_main_loop 调试块 |
| HANG-FIX C | 进度打印间隔从 256MB (1<<24 words) **加密到 64MB (1<<22 words)**,3GB 共 54 次打印,平均每 3~8 秒至少一行输出 | RC-C | board_Multi-Pattern_DCache_r.c 宏定义区 |
Falsifiable Hypotheses (保留作为历史参考)
H1 (最可疑): 关闭 dcache 后,3437MB 非缓存写极慢 (~100x 放大),首次写循环在当前 WDT 间隔 1<<20 words 之间就触发 WDT 硬复位,且用户观察到的"卡住"其实是 WDT timeout 前的长静默或复位重启后卡 bootrom。
H2: `schedule()` 在 `run_main_loop` 阶段调用到 `event_notify`/`cyclic` 内部资源未就绪 → hung / panic。Aarch64 U-Boot 里此阶段应仅用 `WATCHDOG_RESET()` 宏即可。
→ **被推翻**:RC-A 证明 schedule() 在 run_main_loop 是必须的、且完全安全 (board_r_test5 后续进入 main_loop() 就是无限循环调用 schedule())。
H3: 地址回写 Test1 里 `vbuf32[0] ~ vbuf32[high]` 写入过程中,把 `gd->malloc_base` 上方 `CONFIG_SYS_MALLOC_F_LEN` 或 `noncached_init` 预留段踩掉 → 后续 `schedule()` / 任何使用 malloc 的路径锁死。
H4: `dcache_disable()` 后紧接着 `invalidate_dcache_all()`,在没有内存屏障/与 noncacheable 段重叠的情况下,导致异常级别写 buffer 中含未命中脏数据;Test1 第 1 条 `schedule()` 触发同步外部 abort → silent hang。
→ **被推翻 (部分)**:F4 策略改成 keep-dcache + flush/invalidate all 后已避免此路径,但仍保留 flush→dsb→invalidate 顺序。
H5: 安全范围 `0x0800_0000 ~ gd->relocaddr - 16MB` 实际上与 ATF/BL31/BL32 共享内存段、optee/Framebuffer (16MB 往往不够) 重叠,写 ATF 区域触发 SError / busfault。
→ **被证实为 RC-B**:gd->relocaddr - 64MB 可能超过 0xD600_0000,落在 framebuffer/optee 窗口。
Observations (from current log)
- dcache_was_on=1 → cache 状态切换分支真的走到了 `flush_dcache_all / dcache_disable / invalidate_dcache_all`。
- Hang 点精确在 `printf(" [1/4] address-writeback … ")` 后,该行末尾不带换行,在异步串口/拥塞输出上可能尚未 flush;因此既可能写循环内卡死,也可能下一行进度尚未被刷出。
- 3437MB = 约 9 亿 word,若 cache_off 下单字写 40~80 ns,2+ 次 DDR 读写/字 → 估算 300~600 秒才能写完一次,若 WDT=60s,一定会被硬复位。
Instrumentation Plan (已并入 HANG-FIX A/C)
P1. 在 do_mem_tests 入口打印每个子循环的 “phase=write/read, i=NN%” 进度,每 64MB 打点(原为 256MB);
P2. 把 schedule() **加入 alongside WATCHDOG_RESET** 而非替换;
P3. 在关闭/开启 dcache 前后用 `dcache_status()` 回读校验并打印,排除 H4;
P4. 在 run_main_loop 中先打印 `gd->relocaddr / gd->ram_base / gd->start_addr_sp / malloc_start`,与 safe_top 对比,并明确输出 FINAL use_base/use_end/use_len。
Evidence Log (填充)
| 编号 | 证据 (日志行) | 支持/反对 | 结论 |
|---|---|---|---|
| E1 | 待复现日志 | ||
| E2 | board_r_test5_pass.c run_main_loop: `do_mem_tests((void*)0x8000000,0xce000000)` | 支持 RC-B | end=0xD600_0000 是已知安全上界 |
| E3 | board_r_test5 无任何喂狗代码却通过 | 支持 RC-A / 反对纯 H1 | 说明在 dcache 开启 + 基线范围内,DDR 吞吐足够高,在默认 WDT timeout 内可完成;但一旦扩到 3437MB + 非缓存写 + 走 DM-WDT 时就必须显式 schedule() |
Fix Candidates (只有在证据支持后才启用)
F1 (对 H1): 不做整块 dcache_disable;改为"每次写/读 4MB 块内先 invalidate range + 写后 clean range",保持 DCache ON 同时不丢 DRAM 覆盖率。
→ **已并入 F4 keep-dcache 策略**
F2 (对 H2): 把所有 `schedule()` 替换为 `WATCHDOG_RESET()`。
→ **方向错误,已被推翻**;修正为 **两者同时调用** (HANG-FIX A)
F3 (对 H3/H5): 预留段放大 32~64MB,用 `gd->bd->bi_dram[0]` + `lmb_reserved` 对照而非固定 16MB。
→ **已在 HANG-FIX B 中作为 safe_top_cap 的上界,但优先用 board_r_test5 通过的基线 end=0xD600_0000**
F4 (对 H4): flush → disable → dsb(isb) → invalidate 顺序重排;或在 invalidate 之前加空 loop 让 write buffer drain。
→ **已升级为 keep-dcache + flush/invalidate all 策略,避免 disable/enable 切换**
2 个赞
2 个赞
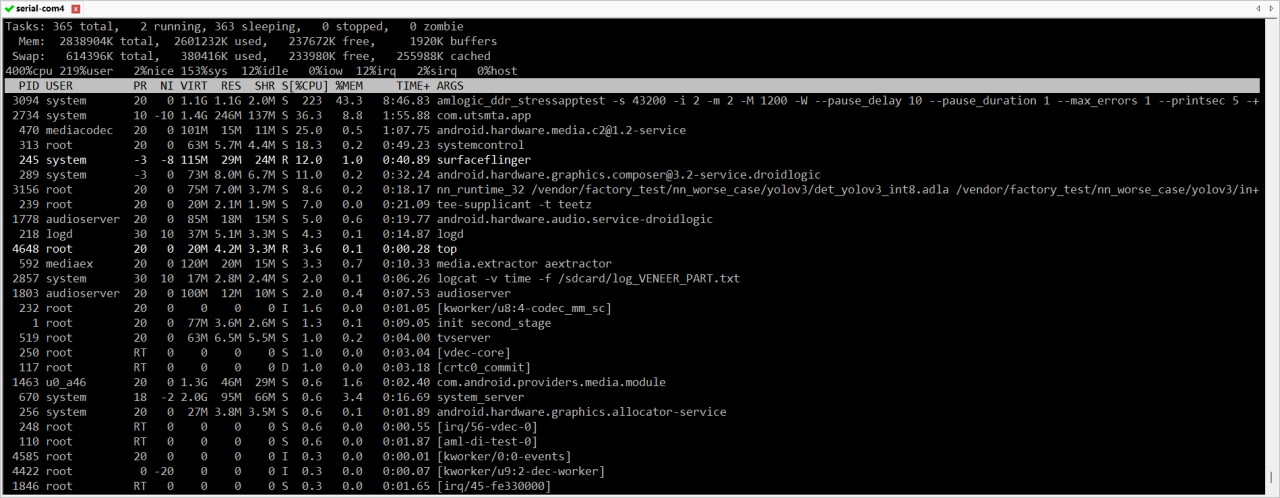
标题示例:【TraeCode 上手记】我用 TraeCode 第一次跑通了 Python 自动化测试,可以测试DRAM 指标了。
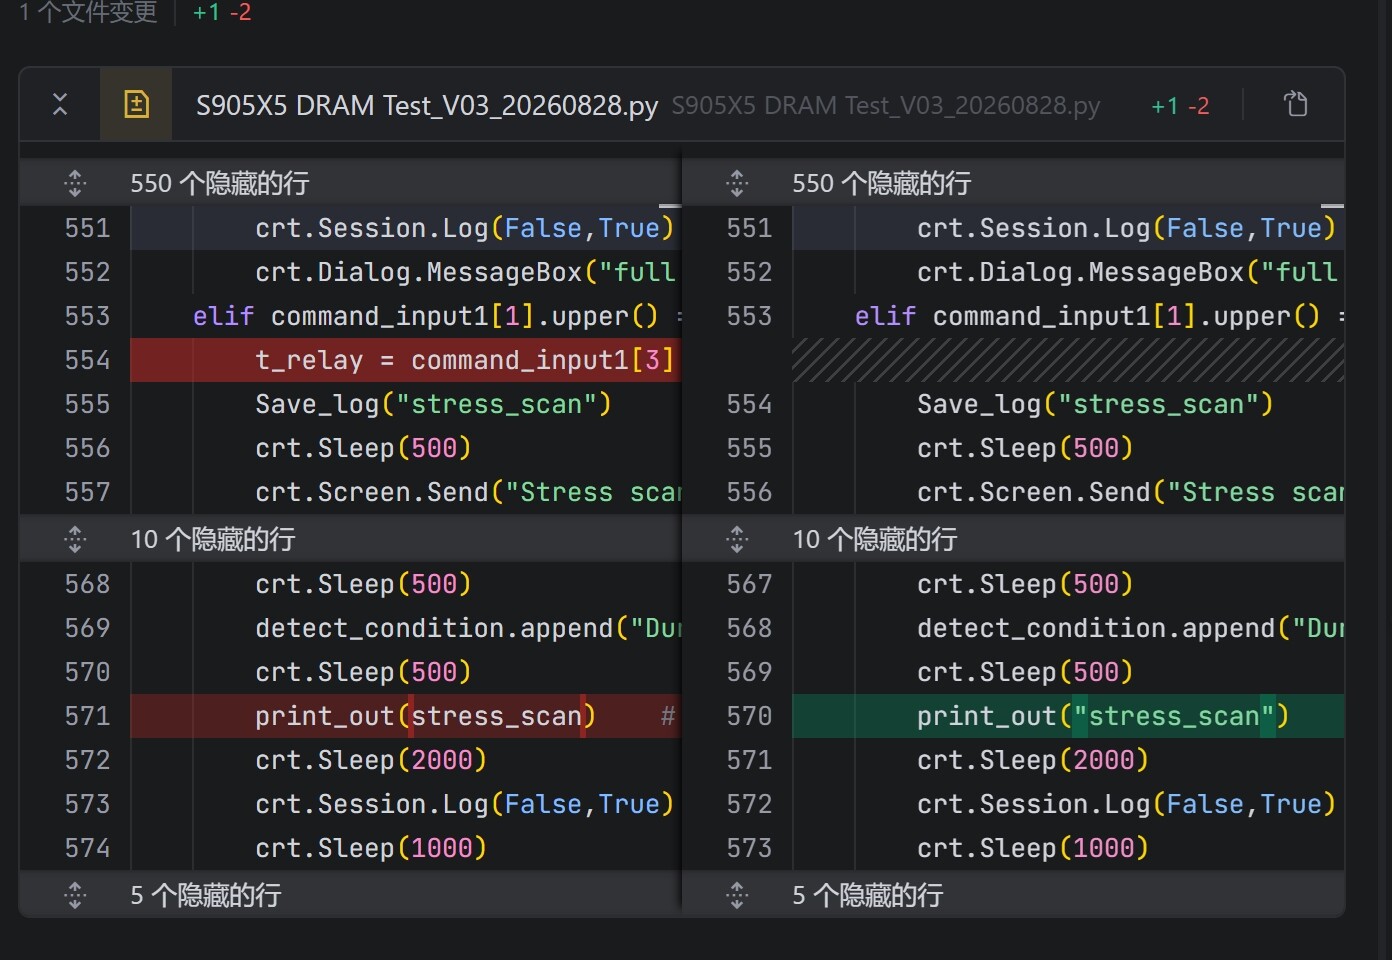
解析结果:
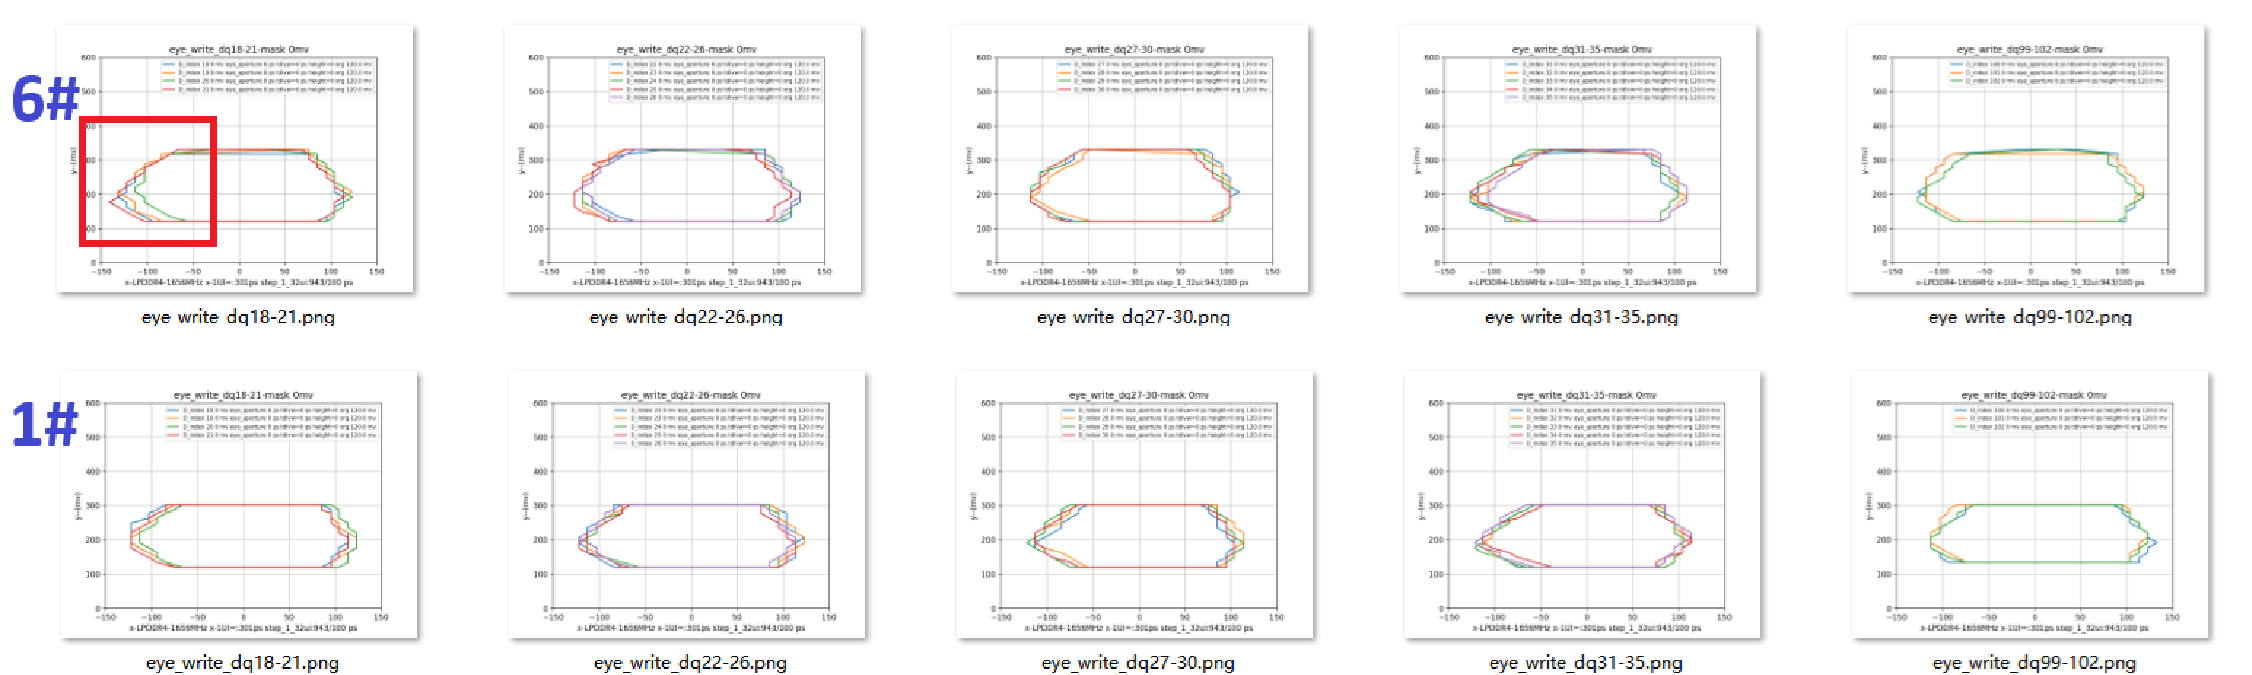
1、利用trace-code 实现自动化抓取数字眼图,评估产品信号质量
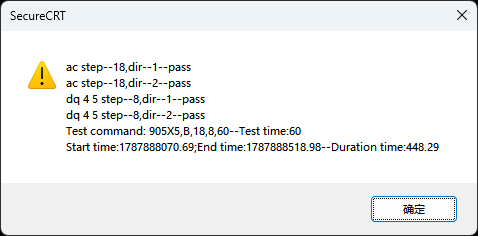
2、利用trace-code 实验Android下面的压测,评估产品稳定性。
3、自动化方式实现煲机老化
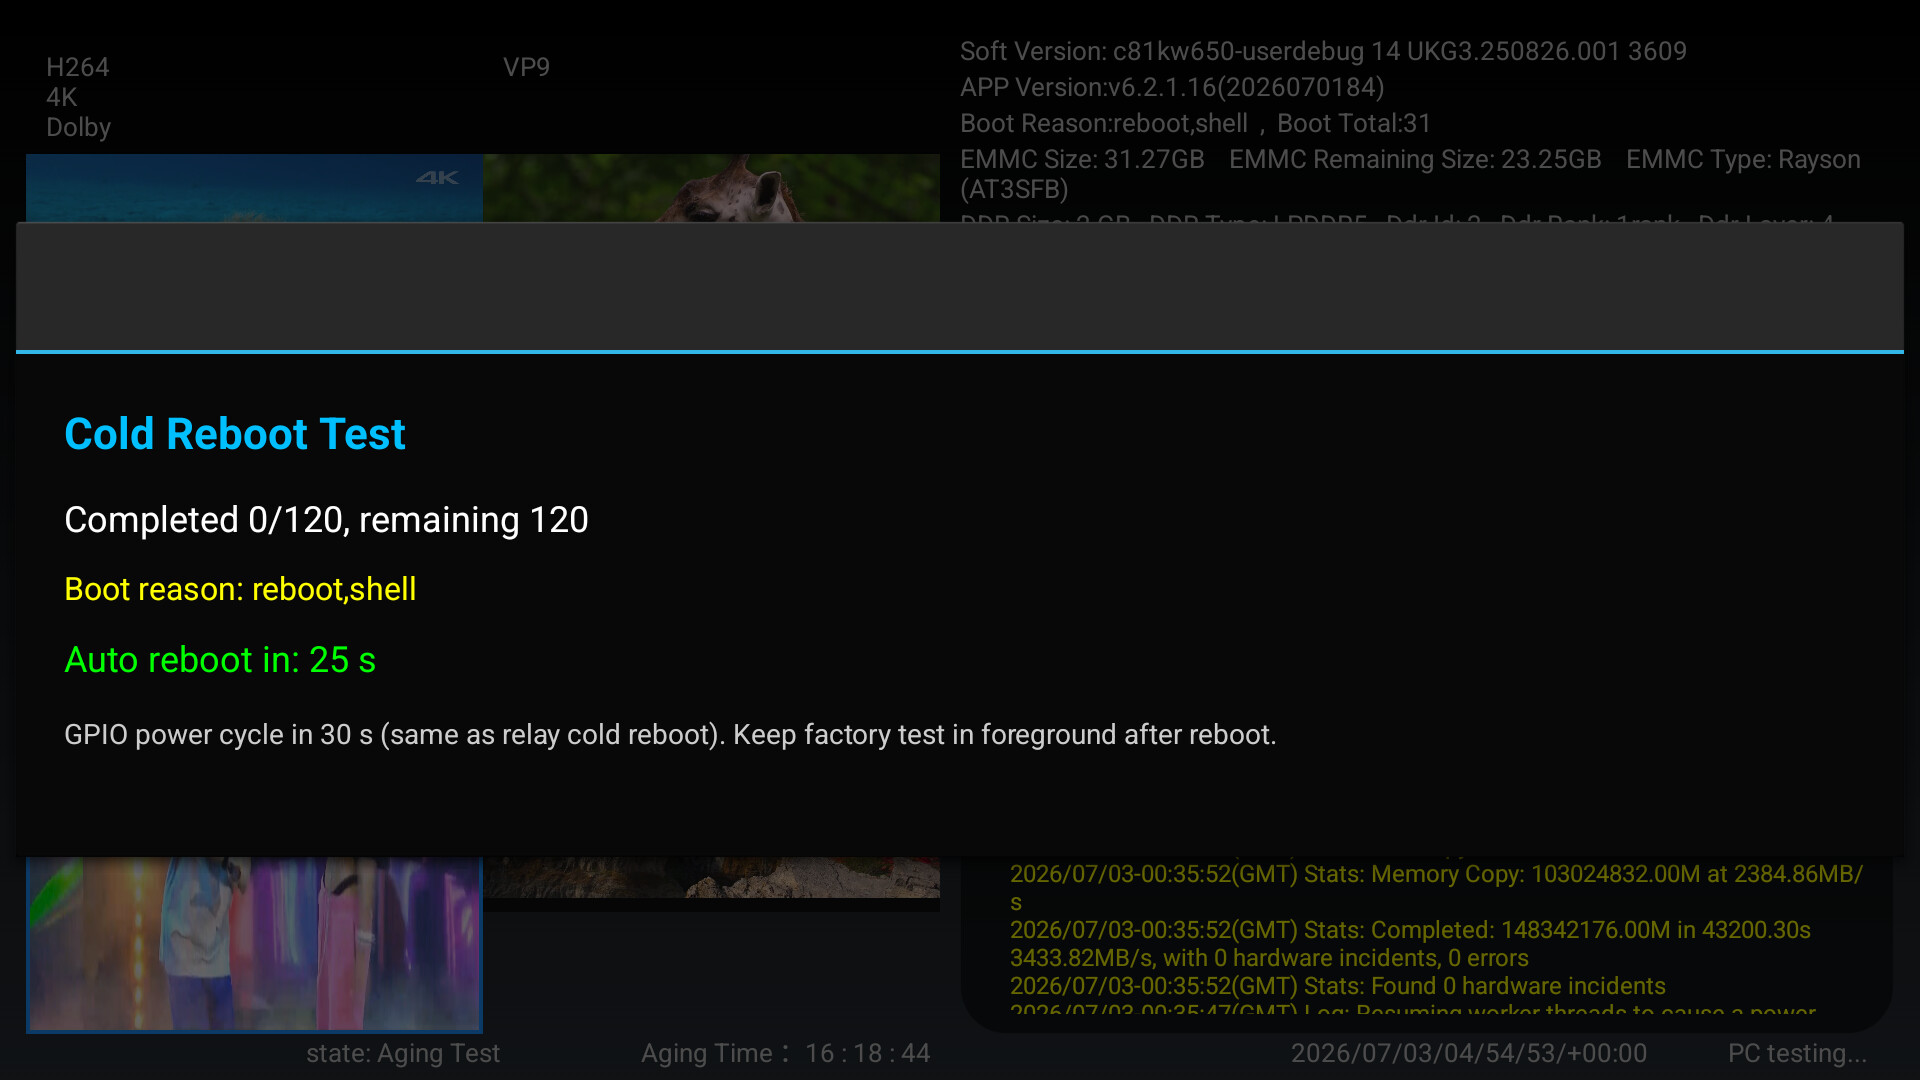
后台运行Python脚本及yolov3 大模型
1 个赞
太好了吧,又有积分用啦 
太感动了吧,又有积分用啦
深深的爱上Trae了!