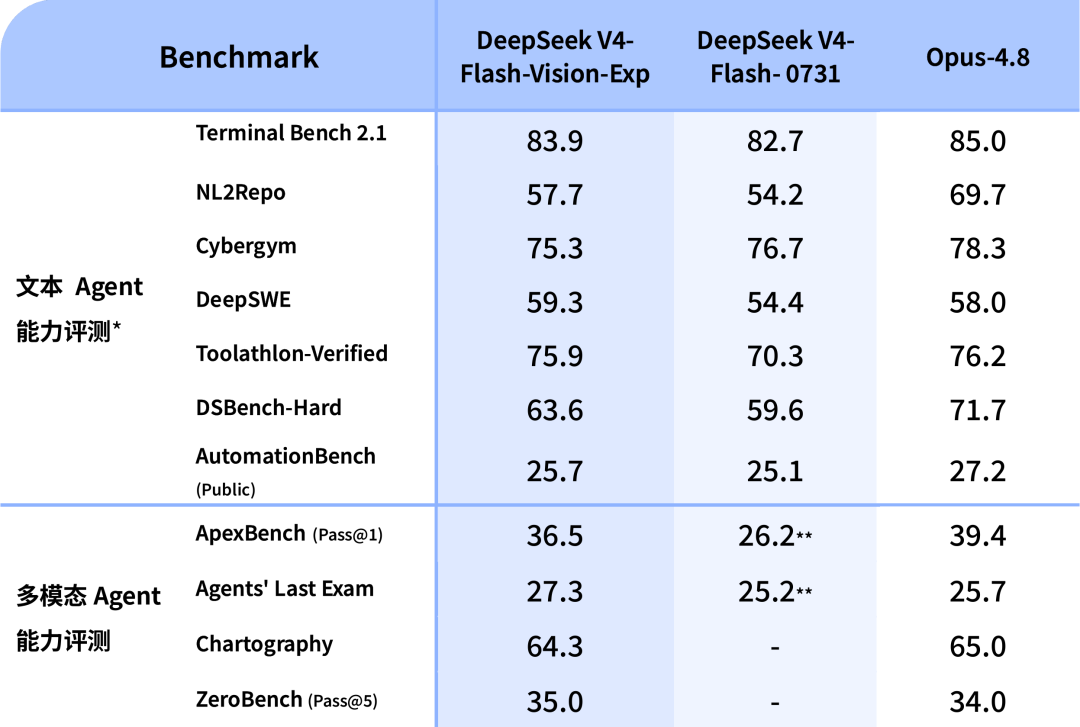
这篇文章的核心内容是 DeepSeek-V4-Flash-Vision-Exp 多模态视觉理解模型上线 DeepSeek API 平台,并配套推出 Files API。可归纳为以下四点:
1. 模型定位与能力
- 实验性多模态模型,在
DeepSeek-V4-Flash基础上加入视觉模块,纯文本 Agent/推理/知识能力与 V4-Flash 正式版持平。 - 多模态 Agent 能力大幅跃升:在 Agents’ Last Exam、ApexBench、Chartography、ZeroBench 等带图的 Benchmark 上明显超过纯文本版 V4-Flash,整体接近 Claude Opus-4.8。
- 定位偏「视觉 Agent」:能读截图、UI、图表、网页图,再结合工具调用继续执行任务。
2. 典型场景
文章给出三个示例说明落地方式:
- Agent 框架内生成「西藏高端自驾游」商业 PPT(含路线、海拔、定价、实拍风配图)
- 对 DeepSeek Harness 官网做黑蓝深海+玻璃 UI+ASCII 像素风的二次创作
- 用「黏土小怪物舞池派对」灵感做前端 Mini Demo
→ 重点指向:多模态输入 + Agent 工具链 + 设计/前端/文档生成。
3. API 调用方式
- 模型名:
deepseek-v4-flash-vision-exp - 支持 Chat Completions / Messages / Responses 三种格式,图文混合输入
- 图片传入三选一:base64 内联、外部 URL、Files API 的 file_id
- DeepSeek Harness 0.1.1 同日加入原生支持,可直连各类 Agent 框架
4. 计费与 Files API
- 图片按尺寸转 token,单张最多 384 token,与 V4-Flash 文本 token 同价计费(无视觉溢价),峰谷分时计价
- Files API 免费:图片先上传拿
file_id,多请求复用,省带宽;同一图不必重复上传
补一句时间线:该模型 2026-08-21 先上 API,2026-08-31 又以 MIT 协议在 Hugging Face 开源权重,支持本地部署与二次开发。
