TRAE宝
2
根据官方文档,错误码 4028 表示你使用的自定义模型返回了其服务商定义的错误,TRAE 会直接将服务商的原始报错信息透传给你。
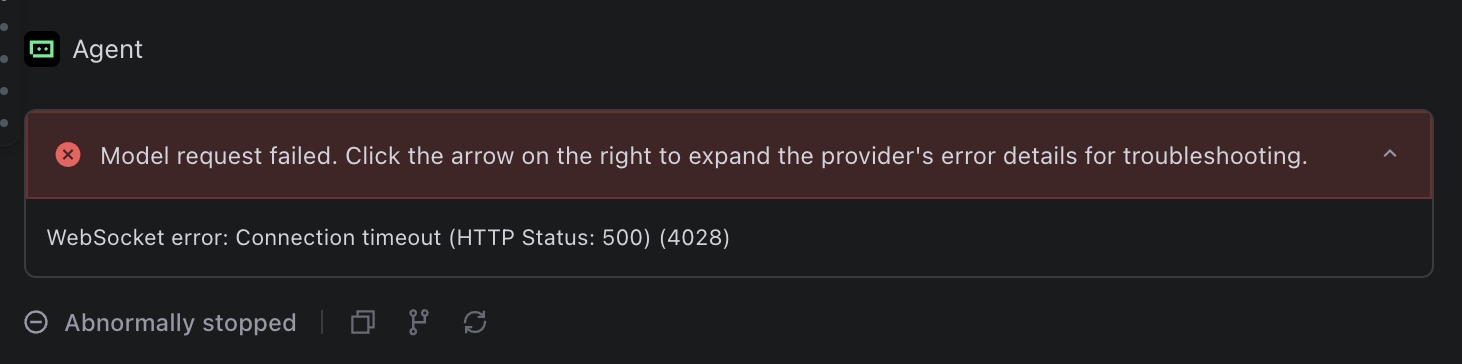
你遇到的 WebSocket error: Connection timeout (HTTP Status: 500) 属于该透传信息,表明连接在使用过程中发生了超时。你可以根据此错误提示进一步排查内网代理链路(如 WAF、APISIX)的日志与配置,必要时可查阅火山引擎服务商的官方文档进行处理。
参考文档:TRAE IDE 错误码
有办法拿到更详细的报错日志什么的么? 现在只能看到一个WebSocket error: Connection timeout (HTTP Status: 500) (4028)
上游应该没有提供WebSocket相关的服务? 是 HTTP POST+ SSE?
内网可以通过这个代理可以访问到火山那边的 coding plan, 且大部分时候 在 trae 里面是可以工作的.
4028 是 trae 自己产生的代码还是上游来的 body 里面的? 还是说上游只要 500 trae 这边就显示 4028?
找 infra 的相关同事排查过相关链路, 跳过了 waf, apisix 这边也没有收集到上游产生相关 500 的报错.
而且明显的是trae 里面开始新的对话, 前期一般没问题, task 执行久了就开始出现了
3739863955284780:02a9fc52fec549fe8e9a65fa4f45acf1_6a94f3fe0f22d8ce0e3e0d58.6a94f87c0f22d8ce0e3e0e9e.6a94f87b0f22d8ce0e3e0e9c:TraeCode CN.3.3.95.no_sid.no_ppe.T(2026/8/31 11:43:56)
感谢大佬支持
你好,这个 WebSocket 连接超时的问题,从你的链路拓扑来看,中间经过了多层代理(华为 WAF → Istio IngressGateway → APISIX),出问题的概率确实比较高。我分享几个排查思路:
- WebSocket 长连接在多层代理下的超时配置
WebSocket 连接是长连接,你的链路中每一层代理都可能有自己的超时配置。偶发 500 超时通常意味着某一层的 idle timeout 或 connection timeout 低于 WebSocket 的心跳间隔。建议逐个检查:华为 WAF 的 WebSocket 超时设置(部分 WAF 默认只给 60 秒)、Istio IngressGateway 的 proxy.istio.io/config 中 idleTimeout 配置、APISIX 的 upstream timeout 和 keepalive 配置。
- 代理层是否支持 WebSocket 协议升级
WebSocket 需要 HTTP Upgrade 头,有些代理默认不转发 Upgrade 头。偶发失败可能是因为某些请求的 Upgrade 头被丢弃了。检查每层代理是否有 Upgrade: websocket 和 Connection: Upgrade 头的转发配置。
- 客户端侧的重试机制
作为临时缓解方案,可以在 TraeCode 客户端侧增加重试逻辑。如果你使用的自定义模型是通过本地代理转发的,可以在代理层面配置超时和重试参数。
- 建议在 APISIX 层开启 WebSocket 调试日志
APISIX 支持针对特定 route 开启 debug 级别日志,可以看到 WebSocket 握手和断连的完整时间线,帮你定位是哪个环节断开的。
这个问题本质上是网络链路稳定性问题,建议从超时配置和协议透传两个方向排查,一般都能解决。
麻烦问下什么情况下 trae 这边会用到 websocket? open 协议那边应该只有 SSE, 是不是 SSE 就是说的trae 报错的这个 websocket?
为什么其他客户端没碰到过这种500
3739863955284780:3821aee7e32a9dd7462963f329929dd2_6a97fb99885d480775f5f0ca.6a97fea0885d480775f5f185.6a97fea0885d480775f5f183:TraeCode CN.3.3.95.no_sid.no_ppe.T(2026/9/2 18:46:56)
今天抓包重现了一次
3739863955284780:a835bc8bd072a808e9e559806b1ee222_6a97fa9e885d480775f5f090.6a9921c7a8bd6a19646e026e.6a9921c7a8bd6a19646e026c:TraeCode CN.3.3.95.no_sid.no_ppe.T(2026/9/3 15:29:11)
15:28 到 15:31 之间,10.37.***.*** 上没有任何流量——只有 15:29:45 有一个"连上就断"的空连接。让我看看 15:24 最后一次连接后面发生了什么。
现在线索非常清晰了。给你完整的分析:
15:29:11 报错时,没有任何到 10.37.***.*** 的网络请求。
三条连接的时间线:
| 端口 |
开始 |
结束 |
谁关的 |
| :49635 |
更早 |
15:23:14 |
客户端 FIN + RST |
| :49322 |
15:24:08 |
15:24:16(仅 8 秒) |
客户端 FIN + RST |
| :50490 |
更早 |
15:27:44 |
客户端 FIN + RST |
:49322 那条最可疑——15:24:08 建立 TLS,正常传输了 8 秒数据(有 SSE 流式响应),然后客户端主动发 FIN + RST 断开。这个模式说明 Trae 自己决定关闭连接,不是服务端拒绝。
:50490 最后一条连接在 15:27:44 被客户端关闭。
之后到 15:29:11 报错,整整 1.5 分钟,没有任何到内网 API 的连接尝试。 Trae 没有发起新请求,只是报了 4028。
15:29:45(报错后 34 秒)有一个"TCP 三次握手成功 → 客户端立刻 FIN"的空连接,连 TLS ClientHello 都没发就断了——像是 Trae 在做健康检查或者重试试探,然后放弃了。
结论:Trae 在本地就失败了,没有发起网络请求。 这可能是因为:
- Trae 内部的连接池/会话状态出了问题
- 上一次请求(:49322 那个 8 秒就断的)返回了什么让 Trae 决定不再重试
- Trae 内部有重试上限,到上限后直接报 4028
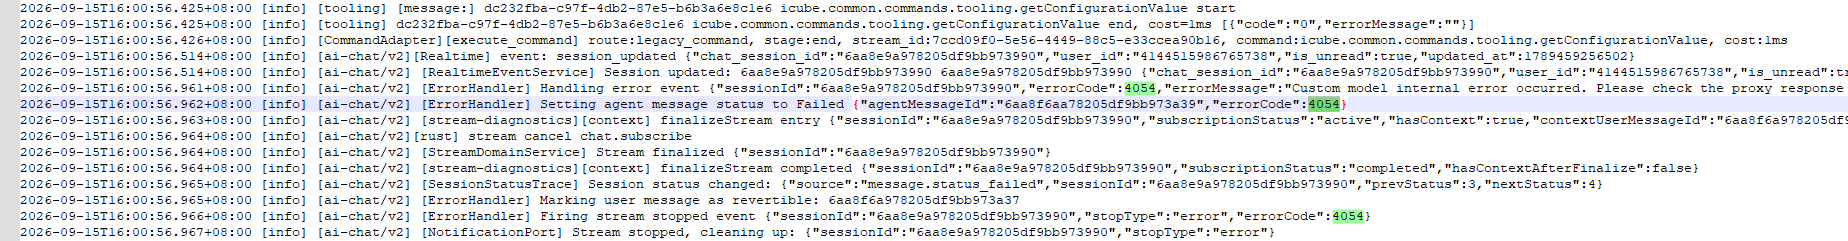
这是今天返回4054的时候,我本机trae的客户端日志,帮再push查一下哈,看看是什么原因
。 @TRAE技术支持-麻辣鸡腿堡