【缺陷报告】自定义模型 prompt 超过 ~256K tokens 必报 4054,与 prompt_max_tokens 配置矛盾

问题概述

通过"自定义模型"(OpenAI 兼容接口)接入的模型,只要单轮 prompt 超过约 262,144 tokens(256K),必然报错:

模型请求失败,请稍后重试。(4054)

而此时:上游服务正常返回了完整响应、用户配置的 prompt_max_tokens(如 936000)已正确下发到客户端原生层。这是客户端原生模块对自定义模型的硬性 prompt 上限,与产品自身的配置字段矛盾。

环境信息

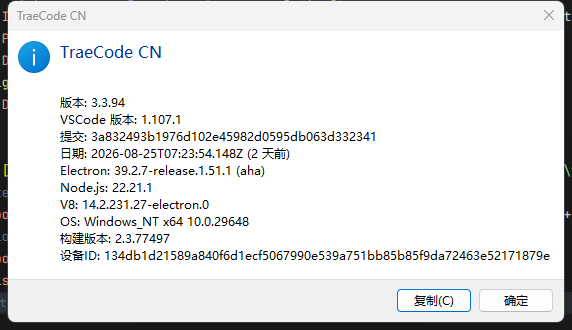
客户端 Trae CN(Windows x64)
appVersion 3.3.91
buildVersion 2.3.73737
模型接入方式 自定义模型(custom_openai_compatible,client_connect)
上游 OpenAI 兼容中转(kimi-k3,1M 上下文)

复现步骤

  1. 设置 → 自定义模型,接入一个支持长上下文(≥512K)的 OpenAI 兼容端点,prompt_max_tokens 设为 936000(或 1048576)
  2. 在 Agent(solo_agent)会话中持续对话,使累积上下文超过 256K tokens
  3. 发送下一条消息 → 必现 4054

证据链

1. 上游完全正常(直连测试)

绕过 Trae,用同一 API key 直接请求上游(流式模式):

prompt tokens 结果
198,464 / 258,406 / 317,597(随机文本,无缓存) :white_check_mark: 全部成功
376,479 / 470,571 / 658,756 / 846,941 :white_check_mark: 全部成功
故意超限 1,488,811 :cross_mark: 上游明确报错 Your request exceeded model token limit: 1048576 (requested: 1488811)

上游硬上限为 1,048,576,且超过 256K 无任何限制。

2. 抓包证明:上游返回了完全正常的响应,Trae 仍报 4054

在自定义模型 base_url 与上游之间插入抓包代理,失败请求的完整响应为:

data: {"choices":[{"delta":{"tool_calls":[...]}}], ...}
data: {"choices":[{"delta":{},"finish_reason":"tool_calls",
  "usage":{"prompt_tokens":282638,"completion_tokens":111,"total_tokens":282749}}]}
data: [DONE]

响应体合法、完整、正常结束(HTTP 200, text/event-stream, 以 [DONE] 收尾)。Trae 在收到该正常响应后报出 4054。

3. Trae 自身日志

%APPDATA%\Trae CN\logs\<时间戳>\window1\renderer.log

[ai-chat/v2] [ErrorHandler] Handling error event
  {"sessionId":"...","errorCode":4054,
   "errorMessage":"Custom model internal error occurred. Please check the proxy response for details."}

4. 精确失败阈值

prompt_tokens(上游 usage) 结果
254,905 :white_check_mark: 成功
264,740 / 265,032 / 265,284 / 282,638 :cross_mark: 4054

阈值与 262,144(0x40000) 完全吻合。

5. 客户端原生层证据

  • ai_agent.dll 内存在字符串 [task] prompt token exceed limit:,与 4054 时序吻合

  • 原生层数据库(ModularData/ai-agent/database.dbchat_message.user_message_context)中,客户端下发给原生层的 model_info 为:

{
  "config_name": "custom_openai_compatible//kimi-k3",
  "config_source": 3,
  "prompt_max_tokens": 936000,
  "context_window_sizes": null,
  "max_tokens": 64000,
  "max_turn": 200
}

prompt_max_tokens: 936000 已正确送达原生层,但校验并未采用它context_window_sizes 为 null,疑似落入 ~262144 的默认分支。

6. 自定义模型代码路径中存在相关配置键

ai_agent.dll 字符串表中存在 customPromptTokenLimitcustomPromptTokenLimitM8 等配置键,但动态配置接口(/icube/api/v1/native/config/query)响应为加密数据,无法确认该限额的服务端设定值。

结论与诉求

  1. Bug:自定义模型的 prompt 上限被客户端原生层限制为 ~262,144 tokens,且:

    • 未采用用户配置的 prompt_max_tokens(936000 已送达仍无效)

    • context_window_sizes 为 null 时使用了过小的默认值

    • 错误信息(“Please check the proxy response”)具有误导性——代理/上游完全正常,问题在客户端自身校验

  2. 诉求

    • 自定义模型的 prompt 校验应尊重 prompt_max_tokens 配置(或 context_window_sizes

    • 若 256K 为产品有意限制,请在文档/设置页明确说明,并将错误码/错误信息改为明确提示(如"自定义模型 prompt 超出客户端限制 256K")

附:可提供的材料

  • 抓包代理捕获的完整请求/响应样本(含 282,638 prompt_tokens 的正常响应)

  • 直连上游的梯度测试脚本与结果

  • Trae 日志目录(renderer.log 中多次 4054 记录)

  • 原生层数据库中 model_info 的完整 dump

关于你反馈的自定义模型 prompt 超过 256K 报 4054 错误,以及与 prompt_max_tokens 配置冲突的问题,当前官方资料中没有相关的直接说明。

当前帖子里的信息还不足以形成可靠结论,请在本帖补充 TRAE IDE 版本、操作系统、复现步骤,以及可用的截图或日志。

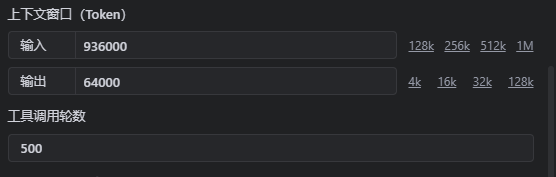
上文已经足够详细。能100%必现。 拿一个支持1M上下文的自定义模型,配置与内置k3一样的配置:
kimi-k3
936000
64000
200


当上写文到达256K的时候,trae界面显示上下文使用 25%,但百分百触发:4054。
确定不是上游问题,已经通过逆向和抓包分析了根据,见前文

已经收到你提供的详细排查过程和抓包分析。由于当前官方资料中没有关于自定义模型 256K 限制的具体说明,且我无法在对话中核实客户端原生层的机制,当前帖子里的信息还不足以形成可靠结论。如果还有其他相关的 TRAE IDE 版本、操作系统、复现步骤,以及可用的截图或日志,请继续在本帖补充。

辛苦发个对话ID哈

此问题,昨天在更新了


此版本之后,变成了,达到15% Token 下文触发。

cn.2425942561536713:df00f743743f666c5142879fa26fb5fd_6a90d5a502771aafc46d06d0.6a90d5a502771aafc46d06d3.6a90d5a502771aafc46d06d1:Trae CN.T(1970/1/22 00:37:56)

这个问题很严重,麻烦官方重视:cn.2425942561536713:3f5c675f25f34cafd84789e637bc0535_6a90d5a502771aafc46d06d0.6a913f47ae2b0676170675b5.6a913f47ae2b0676170675b4:Trae CN.T(1970/1/22 00:38:23)

你的 bug 报告写得太专业了,证据链非常完整!作为同样在做长上下文模型集成的开发者,我分享一些我的分析和临时绕过方案:

关于 262144 (0x40000) 这个阈值:
这个数字非常有意思——256K 刚好是很多浏览器和 Node.js 环境中某些缓冲区的默认大小。从你分析的 context_window_sizes 为 null 时落入默认分支的推断来看,很可能是:

// 伪代码推测
function getPromptLimit(modelInfo: ModelConfig): number {
  if (modelInfo.context_window_sizes?.prompt) {
    return modelInfo.context_window_sizes.prompt;
  }
  // 自定义模型的 fallback 路径
  if (modelInfo.config_source === 3 /* custom */) {
    return customPromptTokenLimit ?? 262144; // 硬编码默认值
  }
  return modelInfo.prompt_max_tokens;
}

你提到的 customPromptTokenLimitcustomPromptTokenLimitM8 配置键,应该就是控制这个上限的动态配置,但可能目前服务端下发的值就是 256K,或者客户端没有正确读取。

临时绕过方案(如果你想验证更长上下文是否可用):

  1. 会话分片策略:在 Agent 模式下,手动控制上下文长度,比如每 10 轮对话就开一个新会话,把前一个会话的关键结论摘要粘贴进去。虽然笨,但能绕过限制。

  2. 用 TraeWork 做预处理:如果你的场景是处理大文档,可以先用 TraeWork 的文件处理能力把长文本做摘要提取、分块处理,再把处理后的内容喂给 TraeCode。

  3. 自建中转服务做截断/摘要

import express from 'express';
import axios from 'axios';

const app = express();
app.use(express.json());

const MAX_PROMPT_CHARS = 800000; // 大约对应 200K tokens

app.post('/v1/chat/completions', async (req, res) => {
  let messages = req.body.messages;
  
  // 简单策略:如果超长,保留系统提示 + 最近 N 条消息
  const totalChars = JSON.stringify(messages).length;
  if (totalChars > MAX_PROMPT_CHARS) {
    const systemMsg = messages.find((m: any) => m.role === 'system');
    const recentMsgs = messages.filter((m: any) => m.role !== 'system').slice(-8);
    messages = systemMsg ? [systemMsg, ...recentMsgs] : recentMsgs;
    console.log(`Prompt truncated from ${totalChars} to ${JSON.stringify(messages).length} chars`);
  }
  
  try {
    const response = await axios.post(
      'http://your-upstream/v1/chat/completions',
      { ...req.body, messages },
      { 
        responseType: 'stream',
        headers: { 'Content-Type': 'application/json' }
      }
    );
    res.setHeader('Content-Type', 'text/event-stream');
    response.data.pipe(res);
  } catch (err: any) {
    res.status(err.response?.status || 500).json(err.response?.data || { error: err.message });
  }
});

app.listen(4000);

当然,这只是临时方案。根本解决还是要等官方修复 prompt_max_tokens 不生效的问题。你的 bug 报告这么详细,相信官方很快就能定位到问题所在!

收到,我们先看下

最新出问题的对话:
cn.2425942561536713:00a28b572d93d598c9ad9faec286e057_6a9684d0d264bd99d3339f3e.6a96c0a3d264bd99d333a71f.6a96c0a3d264bd99d333a71d:Trae CN.T(1970/1/22 00:44:24)

cn.2425942561536713:d7dbfdee072f5c63ae5d745cca0f8311_6a9684d0d264bd99d3339f3e.6a96d2dad264bd99d333a904.6a96d2dad264bd99d333a902:Trae CN.T(1970/1/22 00:44:29)

遇到了一模一样的问题,场景基本和楼主一致,并且频繁出现,请官方尽快修复