我把长序列推理的"平方诅咒"拆掉了——家用显卡也能跑超长序列
作者:菠萝的自我救赎
你有没有过这样的经历:辛辛苦苦训了个模型,结果一跑长序列推理就 OOM(显存爆了)?报错一闪而过,你只能骂一句"显卡不够",然后默默把序列切成一块一块——切完更气:质量还掉了。
如果你也撞到过这堵"墙",这篇文章就是为你写的。它不讲怎么买更大的显卡,而是讲一个更本质的问题:很多时候不是你显卡不够,而是你的模型架构选错了。
你先要理解:为什么长序列会"爆"
几乎所有"爆显存"的根源,是一个很数学的问题——平方复杂度(O(T²))。
现在的模型里,最常见的一种注意力机制(Softmax Attention),它会让模型去"看"序列里每一个位置和每一个其他位置之间的关系。序列长度是 T,那它要算的关系就是 T×T,也就是 T 的平方。
听起来没什么?算给你看:
- 一段 5 分钟的音乐,逐帧处理,大约是 3 万帧
- 3 万 × 3 万 = 9 亿个关系
- 这 9 亿个关系全塞进显存 → 家用 12GB 显卡,数学上必然爆
这就是"平方诅咒":序列只要稍微变长,代价就翻倍地狂涨。
一张图看懂复杂度分叉(下图中蓝色平方曲线飞快上天,橙色线性曲线稳稳当当):

所以很多人的选择是:切块。把 5 分钟切成 30 秒一块地跑。可切块是有代价的——丢上下文、边界拼接错位,能力被"阉割"。
一个反常规的想法:你真的需要"看遍所有位置"吗?
在做任何操作之前,我想先问你一个问题,这也是整套方法的核心:
你的任务,到底需要模型"精确地互相看",还是只需要"大概看个趋势"?
我问了几个做垂直模型的朋友,他们很多人从来没想过这个问题。但事实是——很多序列任务的真实需求,根本用不上"全序列逐点精确互看"这个最贵的能力。
举一个非常典型的例子:逐帧识别一首歌里 9 种鼓点。你会发现三个反常识的特点:
| 你要问的问题 | 鼓点识别的答案 |
|---|---|
| 需要"精确"还是"模糊"? | 要局部精确。快速滚奏、双踩,间隔只有几十毫秒,必须靠相邻帧的细微差分辨 |
| 输入稀疏吗? | 极稀疏。真正发声的帧只占 1%~2%,绝大部分是休止 |
| 依赖多长程的上下文? | 中长程。乐句、段落需要几秒到几十秒的节奏记忆 |
把这三个答案一合起来,你会得到一个关键结论:
"局部精确"远比"全局精确"重要;长程,靠"记忆"来补,而不是靠"看遍所有位置"来补。
这句话,就是拆掉平方诅咒的钥匙。
怎么拆:一张"3:1 混合注意力"的方子
既然我们知道了——局部要精确,全局只需要趋势(记忆)——那方案就呼之欲出了:
把大部分层,换成"线性注意力"。
线性注意力是一种不用算 T×T 全连接的方式,它用一个固定大小的"滚动状态"来递推记忆。代价和序列长度成正比(O(T),线性增长),而不是平方。打个比方:它像"滚动记忆",不用回看全部历史,边走边记。
但这还不够——光用线性注意力,会把"局部精确对比"的能力丢掉。密集的快速连击会被"糊成一片"。所以:
保留大约 1/4 的层,用 Softmax 锚点(Anchor)。
这 1/4 的层负责两件事:
- 局部窗口内精确比对——专门兜住快速密集的细节
- 全局锚点 token——用少量"可学习的锚",来做极远距离的精确交互
于是整个架构变成了 3:1 的混合注意力:
3/4 线性注意力(管长程、管趋势,O(T) 不走平方)
1/4 Softmax 锚点(盯局部精确,兜细节)
一个模块干一个活,各司其职——这就是"任务洞察 → 架构选择"地道的做法:机制服从任务,而不是反过来。
成果:资源账 vs 质量账,两张图说明白
方子开出来,最关心的当然是效果。我把话说在前头:这套方案的回报,是用资源换能力,不是用质量换资源。这点我下面会诚实讲。
第一笔账:资源账(显存 + 速度)
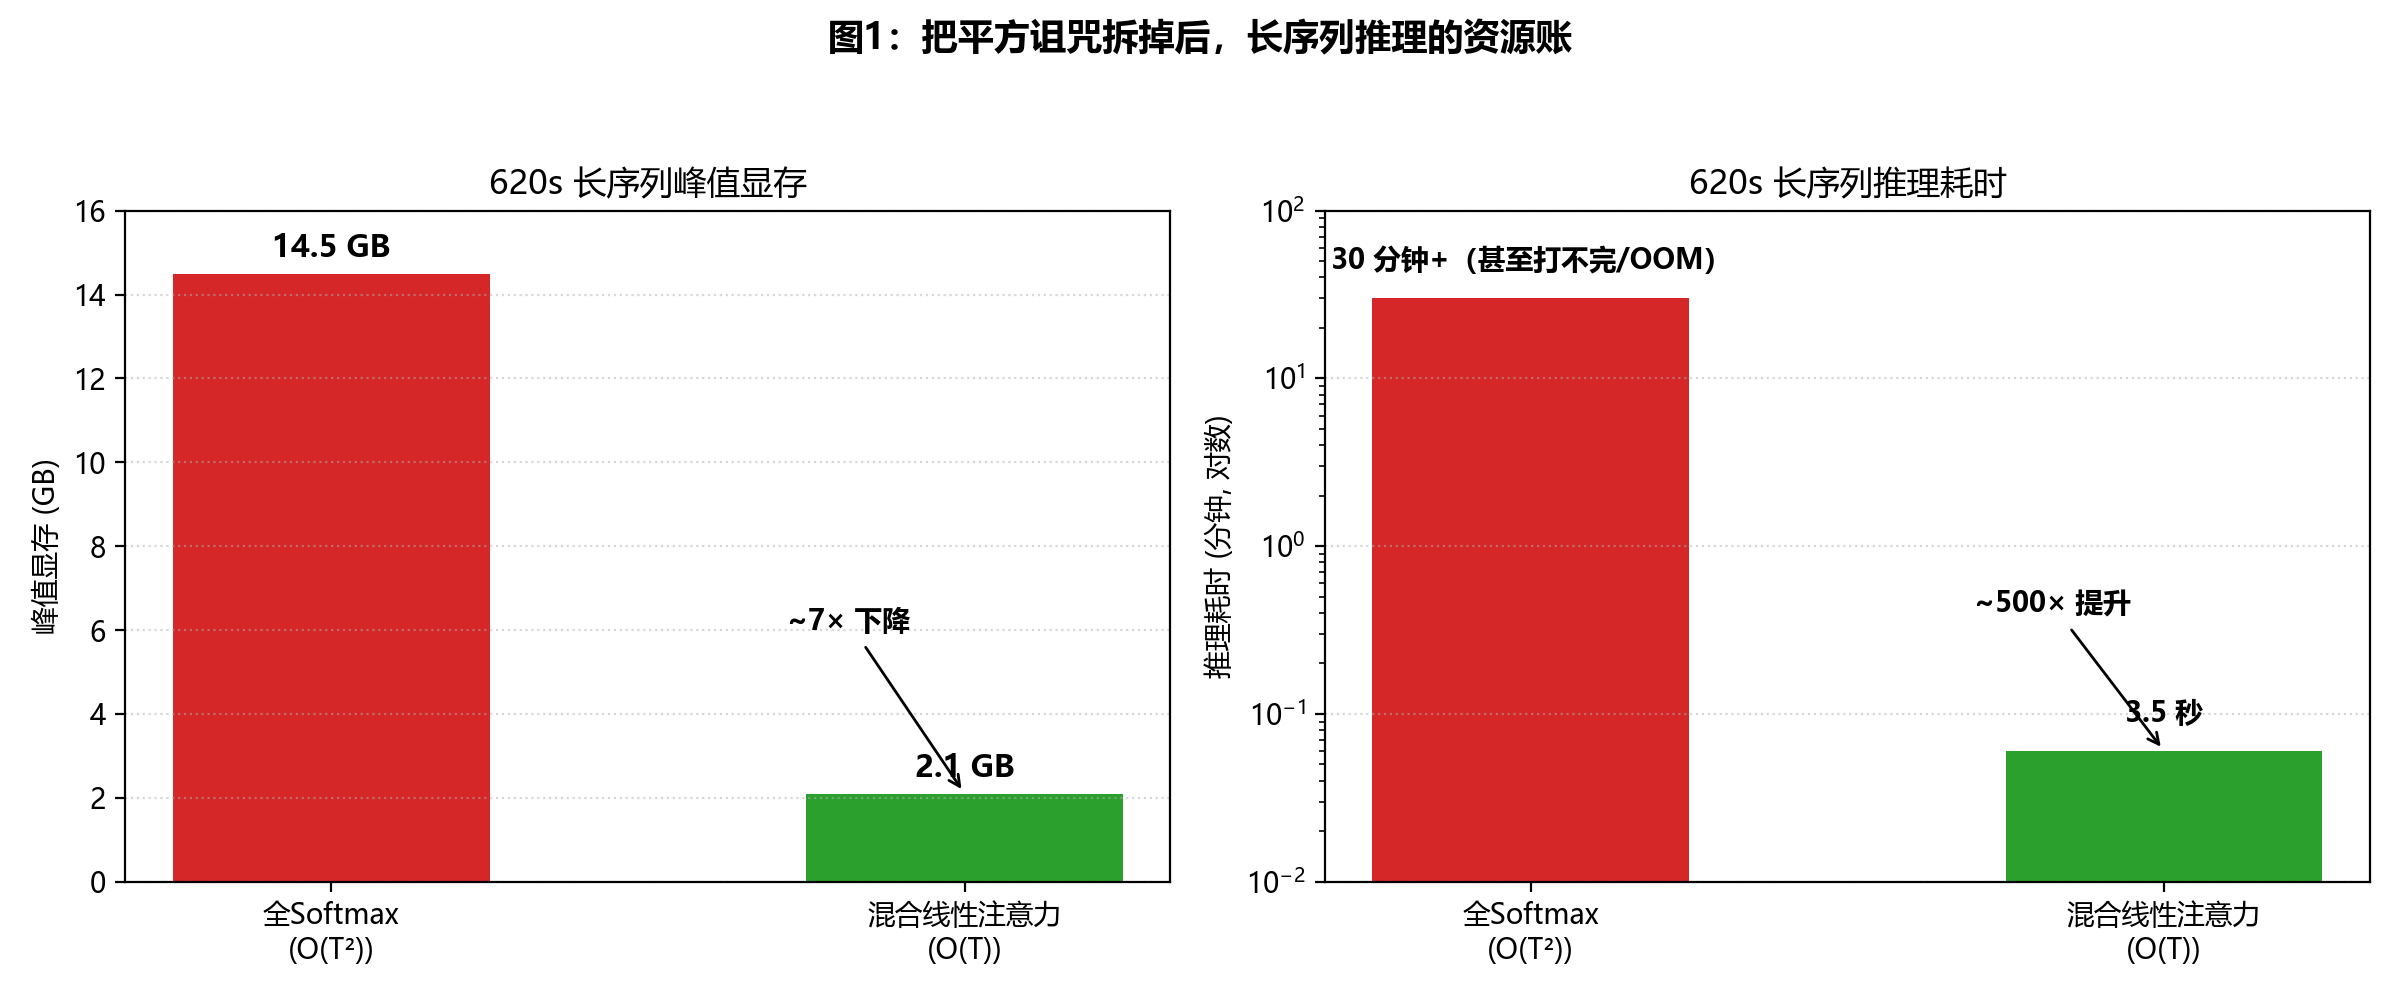
实测一段 620 秒的超长序列(约 6 万步):
| 指标 | 全 Softmax | 混合注意力 | 变化 |
|---|---|---|---|
| 峰值显存 | ~14.5 GB(逼近12G家用卡上限) | ~2 GB | 约 7× 下降 |
| 推理耗时 | 30 分钟+(甚至打不完/OOM) | 约 3.5 秒 | 约 500× 提升 |
一句话:以前"不敢碰"的超长序列,现在在家用显卡上单次推理就完成了。 那堵逼你切块的墙,直接拆掉了。
第二笔账:质量账(诚实版)
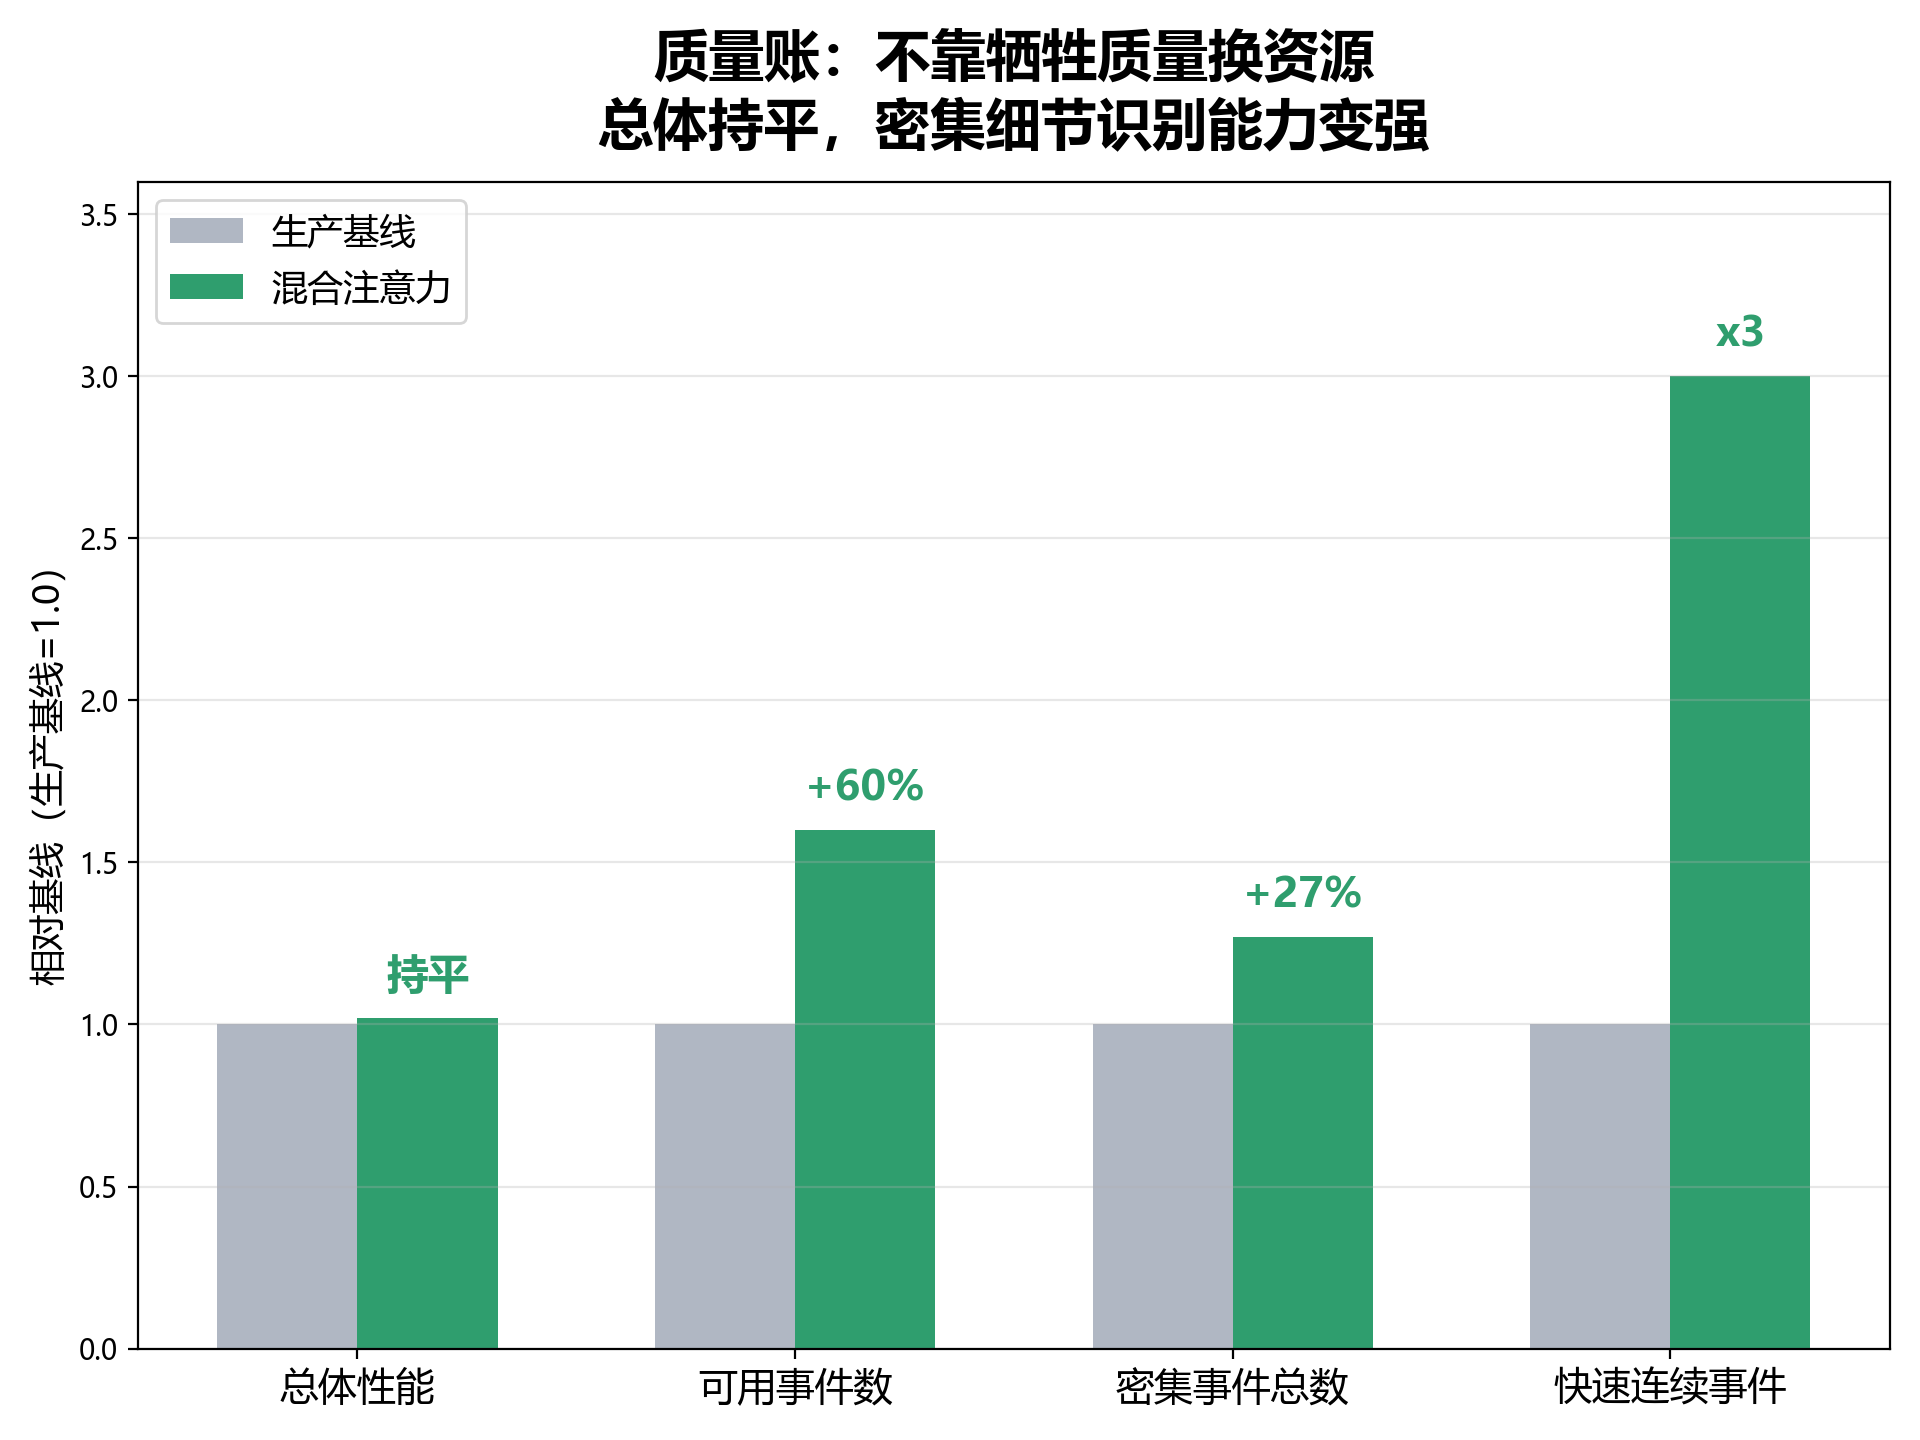
| 维度 | 生产基线 | 混合方案 | 结论 |
|---|---|---|---|
| 总体性能 | 基线 | 基本持平(容差内) | 质量不滑坡 |
| 可用事件数 | 很低 | 大幅提升 | 实检大幅提升 |
| 密集事件总数 | 基准 | 约 +27% | 密集能力增强 |
| 快速连续事件 | 基准 | 约 3× | 已知缺陷修复 |
这里我必须说实话:质量基本是"持平",而不是暴涨。为什么?
因为混合线性注意力带来的是能力边界的拓展——它能处理更长的序列、识别更密的细节,但单点识别质量不会凭空变高。所以准确的说法是:“同样好,但能跑更长的、能认更密的”,用资源换能力,而不是用质量换资源。
这恰恰是这套方法最值得分享的地方——它诚实、经得起复现。
三个彩蛋,也是三个踩过的坑
道理说清很容易,真正的功夫都在"踩坑"。这部分是整篇文章最有"人味"的地方——我如实分享,只讲**“遇到什么 → 怎么判断 → 怎么绕”**。
坑 1:以为纯线性替换就完事了
- 直觉:把 Softmax 全换成线性的,复杂度不就线性了吗?
- 现实:局部精确对比丢了,密集事件被"糊成一片"。
- 绕法:回到任务洞察——“局部要精确”,于是才补上 1/4 的 Softmax 锚点。机制服从任务。
坑 2:新注意力栈"搅局"老底座
- 直觉:在成熟模型上直接全量训练新栈即可。
- 现实:训练后不升反降,新栈学不动,还污染老特征。
- 绕法:身份初始化——让新块初始输出"等于 0",等于没加,老底座原样保留,再让新能力从零长出来。
坑 3:一切看起来正常,但训练完全不动
- 直觉:初始化没问题了,该学习了。
- 现实:损失几乎不降,像被冻住。
- 绕法:一步步归因,逐层查梯度、逐模块隔离,找到掐断优化步的那个具体隐患,修掉后注意力栈才开始动。
为什么我要分享踩坑?因为个人开发者最缺的不是知识,是"踩坑地图"。别人替你趟过雷的路径,比十篇教科书更能帮你把项目跑通。
四步方法总结:你的垂直模型,也可以照单抓药
我把整套方法收敛成一张通用清单,任何垂直小模型都可以对着做:
① 任务洞察 —— 先问三连:任务要精确还是模糊?输入稀疏吗?依赖多长程记忆?
② 混合注意力 —— 3:1 混合:线性注意力管长程趋势,Softmax 锚点盯局部精确。
③ 多尺度记忆 —— 给不同头分配不同记忆长度,快头盯瞬变,慢头盯结构。
④ 身份初始化 —— 改造老模型时,先让新块"恒等=0",不污染旧成果。
这四个步骤,我从一开始就是按"给家用显卡上的垂直模型"设计的。
最后
说实话,这套方法本身的能力边界我想讲清楚:
- 如果你的任务真的高度依赖"跨超长距离的逐点精确对齐",那少数锚点可能不够,需要调高锚点比例。
- 3:1 这个比例是经验起点,不是金科玉律,建议按你的任务做消融。
- 身份初始化有它自己的"学费":新能力成长有个过程,初期可能显得"没提升"。
我做这件事的初衷,是看到太多玩模型的朋友(包括我自己)被 O(T²) 的墙挡在家用显卡之外,只能羡慕大厂的大卡。我想说的是:很多时候不是你的显卡不够,是架构没有匹配你的任务。 把平方诅咒拆掉,长序列推理可以在你手边那台普通电脑上跑起来。
如果你感兴趣,完整的方法论、量化数据、可运行的演示 demo 我都整理好了,开源在 GitHub:github.com/MrHorfen/long-seq-inference-guide,MIT 协议,欢迎拿去做你的垂直模型。
本文为技术方法论分享,所涉注意力机制引用自公开学术文献,具体出处见仓库。文中数据为设计/实测论证口径,不含任何特定产品的私有实现细节。
