一、我是谁,我卡在哪
我是谁:我在业余时间做 AI 推理相关的应用层工具。最近在折腾 AIGC 视频修复方向。
我卡在哪:字节跳动 Seed 团队和南洋理工 S-Lab 联合开源了 SeedVR2 ——一个做视频/图像超分辨率的单步扩散模型,画质非常顶(3B / 7B / 7B-Sharp 三档)。但官方只在 Hugging Face 放了权重,实际社区用法几乎都长这样:
必须装 ComfyUI 才能跑,节点连线对没接触过工作流的人很不友好;显存门槛高:7B FP16 要 24G,4090 以下基本劝退;批量处理靠手点:要修 50 个视频只能一个个拖;没有断点续跑:跑到第 30 个崩了,从头再来;没 i18n,英文文档+英文界面劝退中文创作者;没有现代 Web UI,日志/进度/历史记录基本没有。
我自己想用,也想给做老片修复、短视频二创的朋友们用。但一个人从零到一套独立 Web UI + 推理引擎封装 + 显存优化 + 批量调度 + CI/CD + 国际化,工作量按经验至少要 3-4 人小团队干一个月。
二、我用 Trae Code 怎么解决的
关键实践步骤
步骤 1:立项 & 架构设计 —— 让 AI 当"技术合伙人"挑刺
在 Trae IDE 里开新会话,把"我要把 SeedVR2 做成独立 Web UI"这个目标扔进去,让它先出一版分层架构方案(推理引擎 / 显存优化 / API 路由 / 前端模板 / i18n / 安全 这几层怎么拆)。它给的初版直接被采用 70%,剩下 30% 我手动改。
步骤 2:核心代码 —— 推理引擎 + 显存优化
bin/integrated_app/engines/ 下的 SeedVR2 推理封装、MM-DiT 模型定义、Window Attention + RoPE、Video VAE(基于 SD3)的时间分块解码、GPU BlockSwap 动态换入换出 Transformer 块——这部分 CUDA/PyTorch 细节繁杂,我让 Trae:
先按我的接口定义出函数签名和 docstring;再分块生成具体实现(VAE 解码、注意力窗口划分、BlockSwap 调度器);关键路径写完直接让 Trae 读 .py 文件给出潜在 bug 列表和显存优化建议。
步骤 3:Web UI —— FastAPI + Jinja2 + htmx,不引 ComfyUI
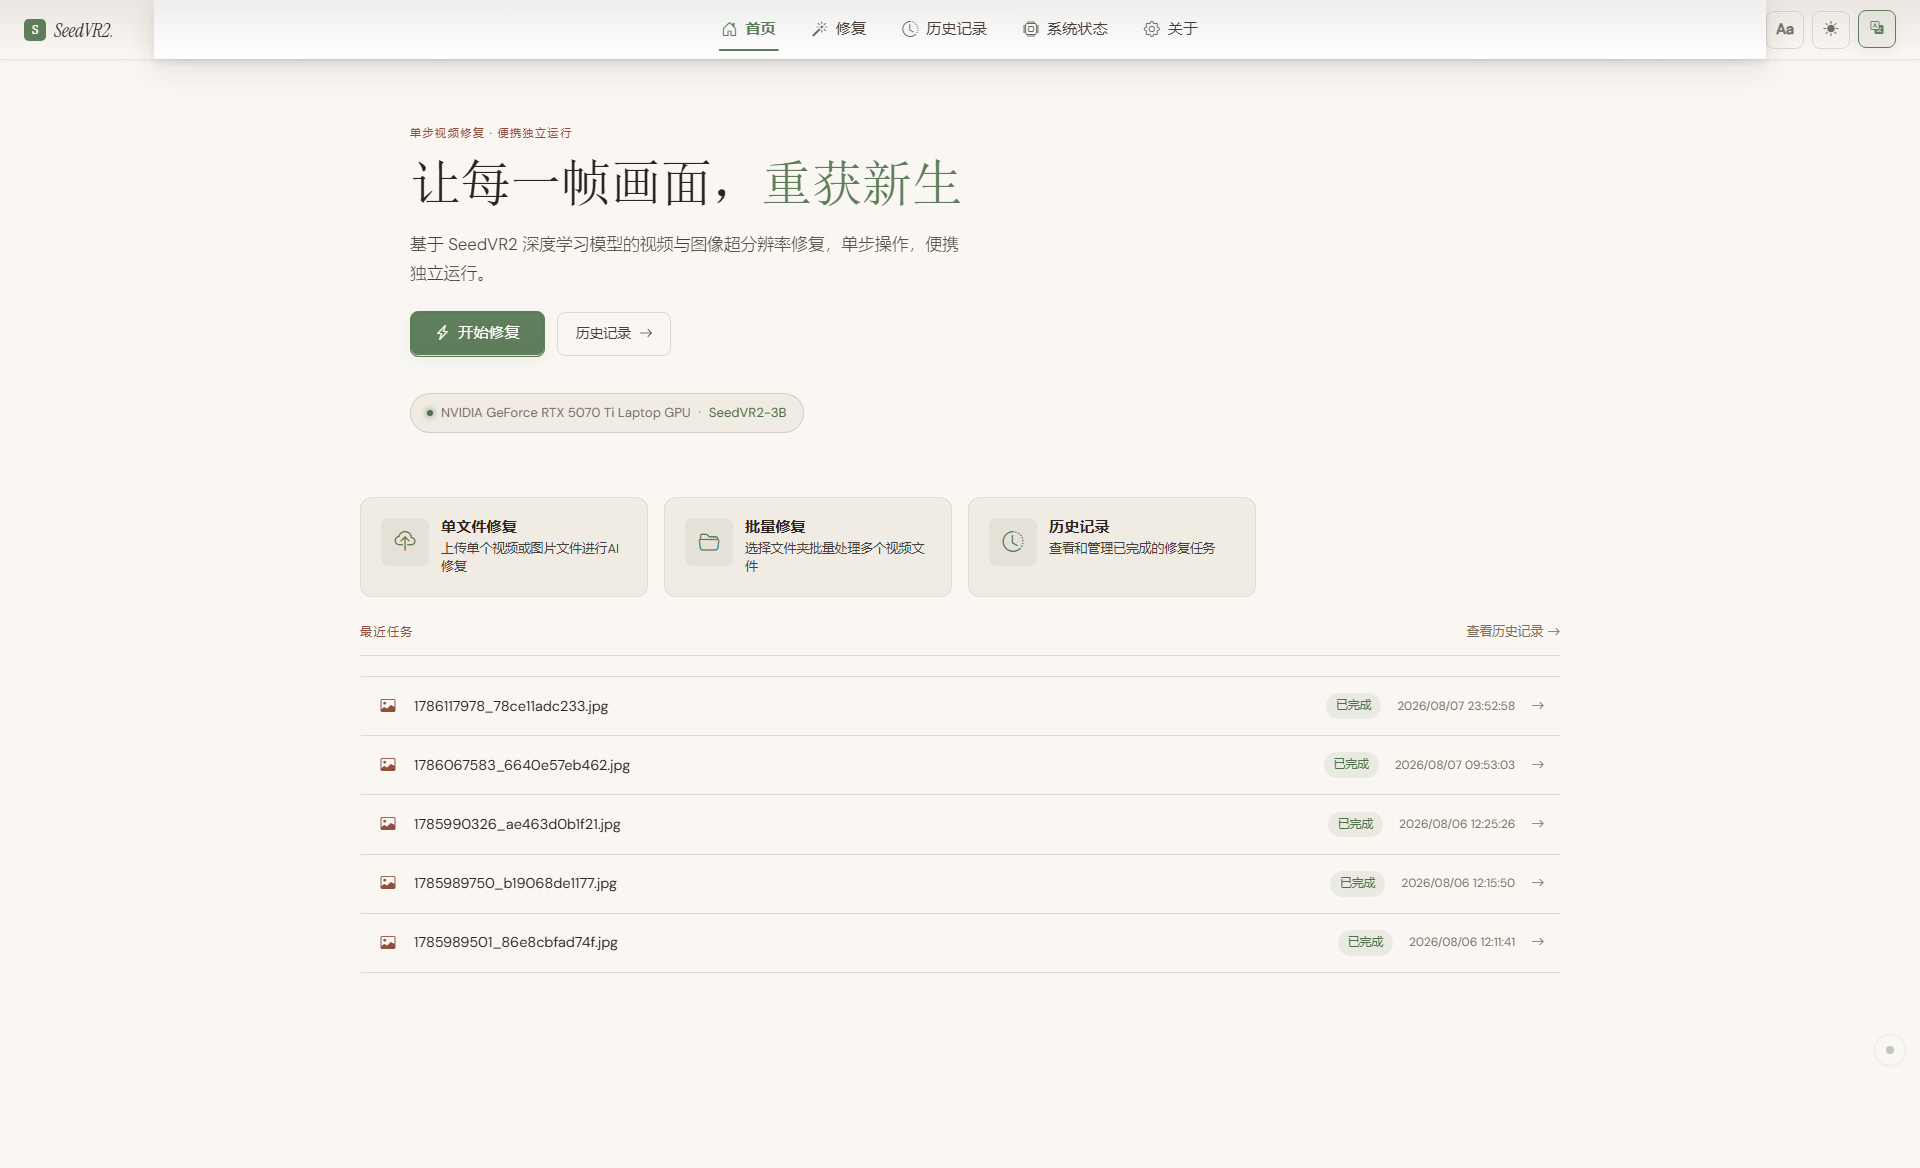
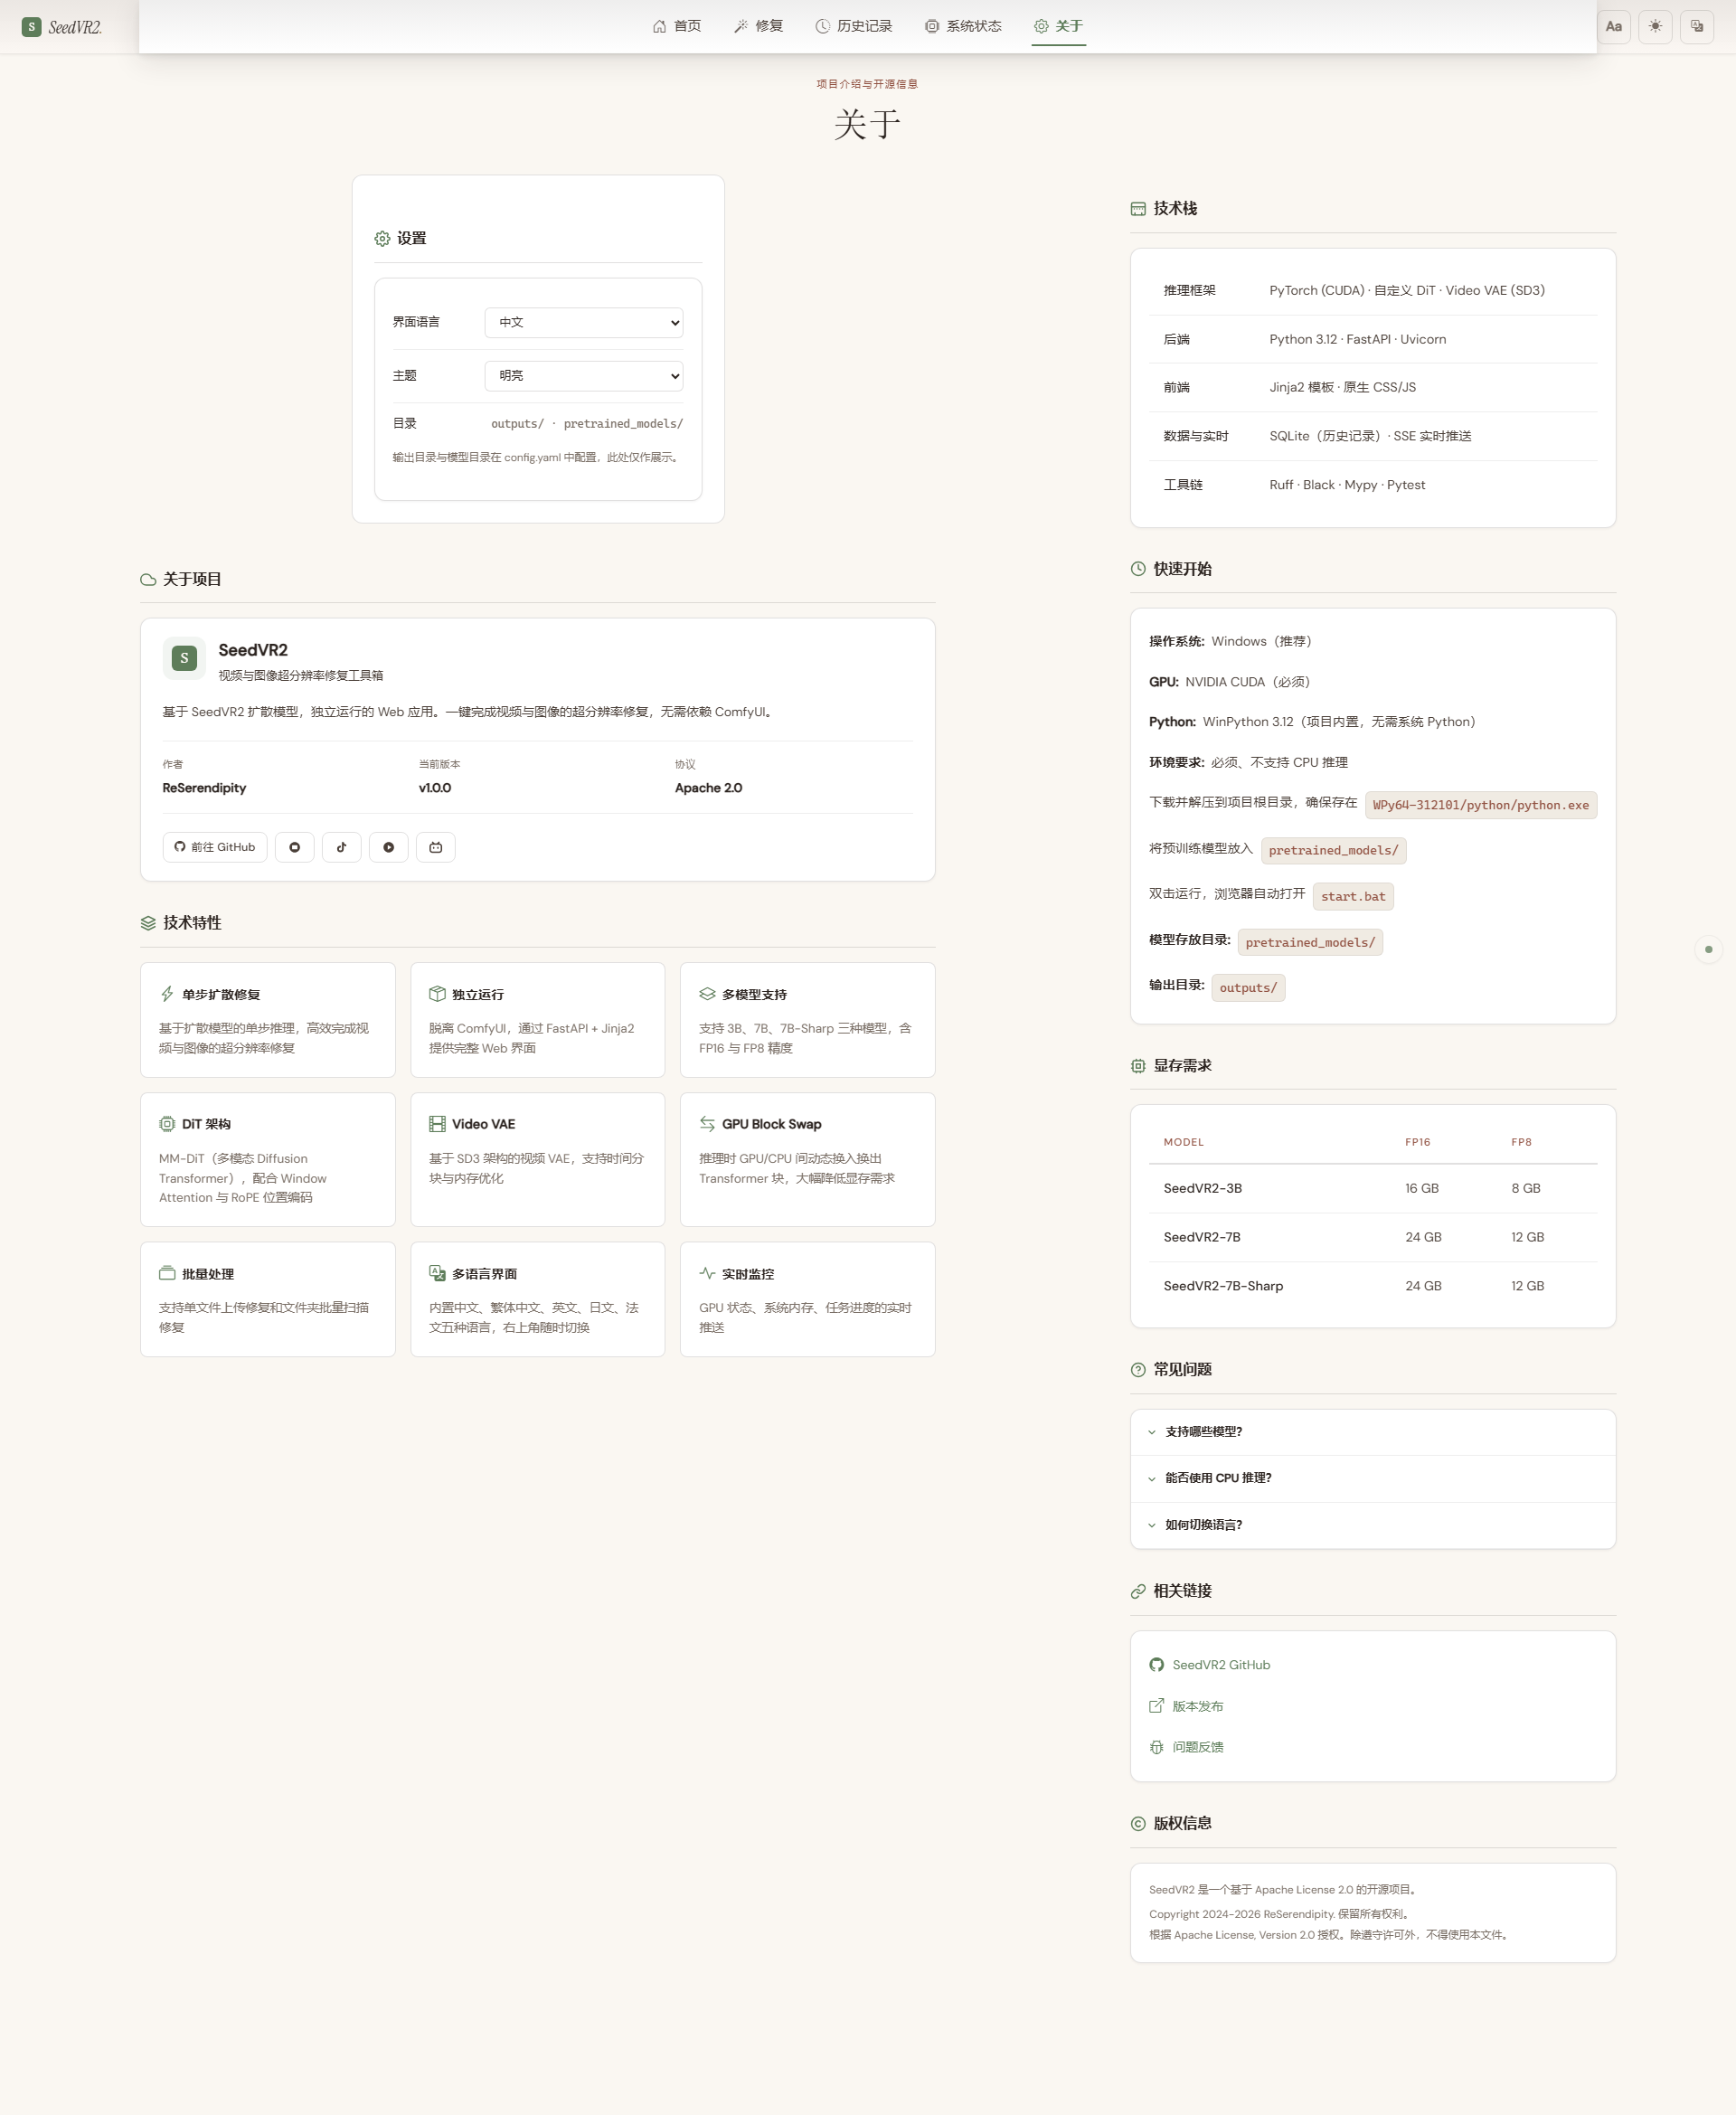
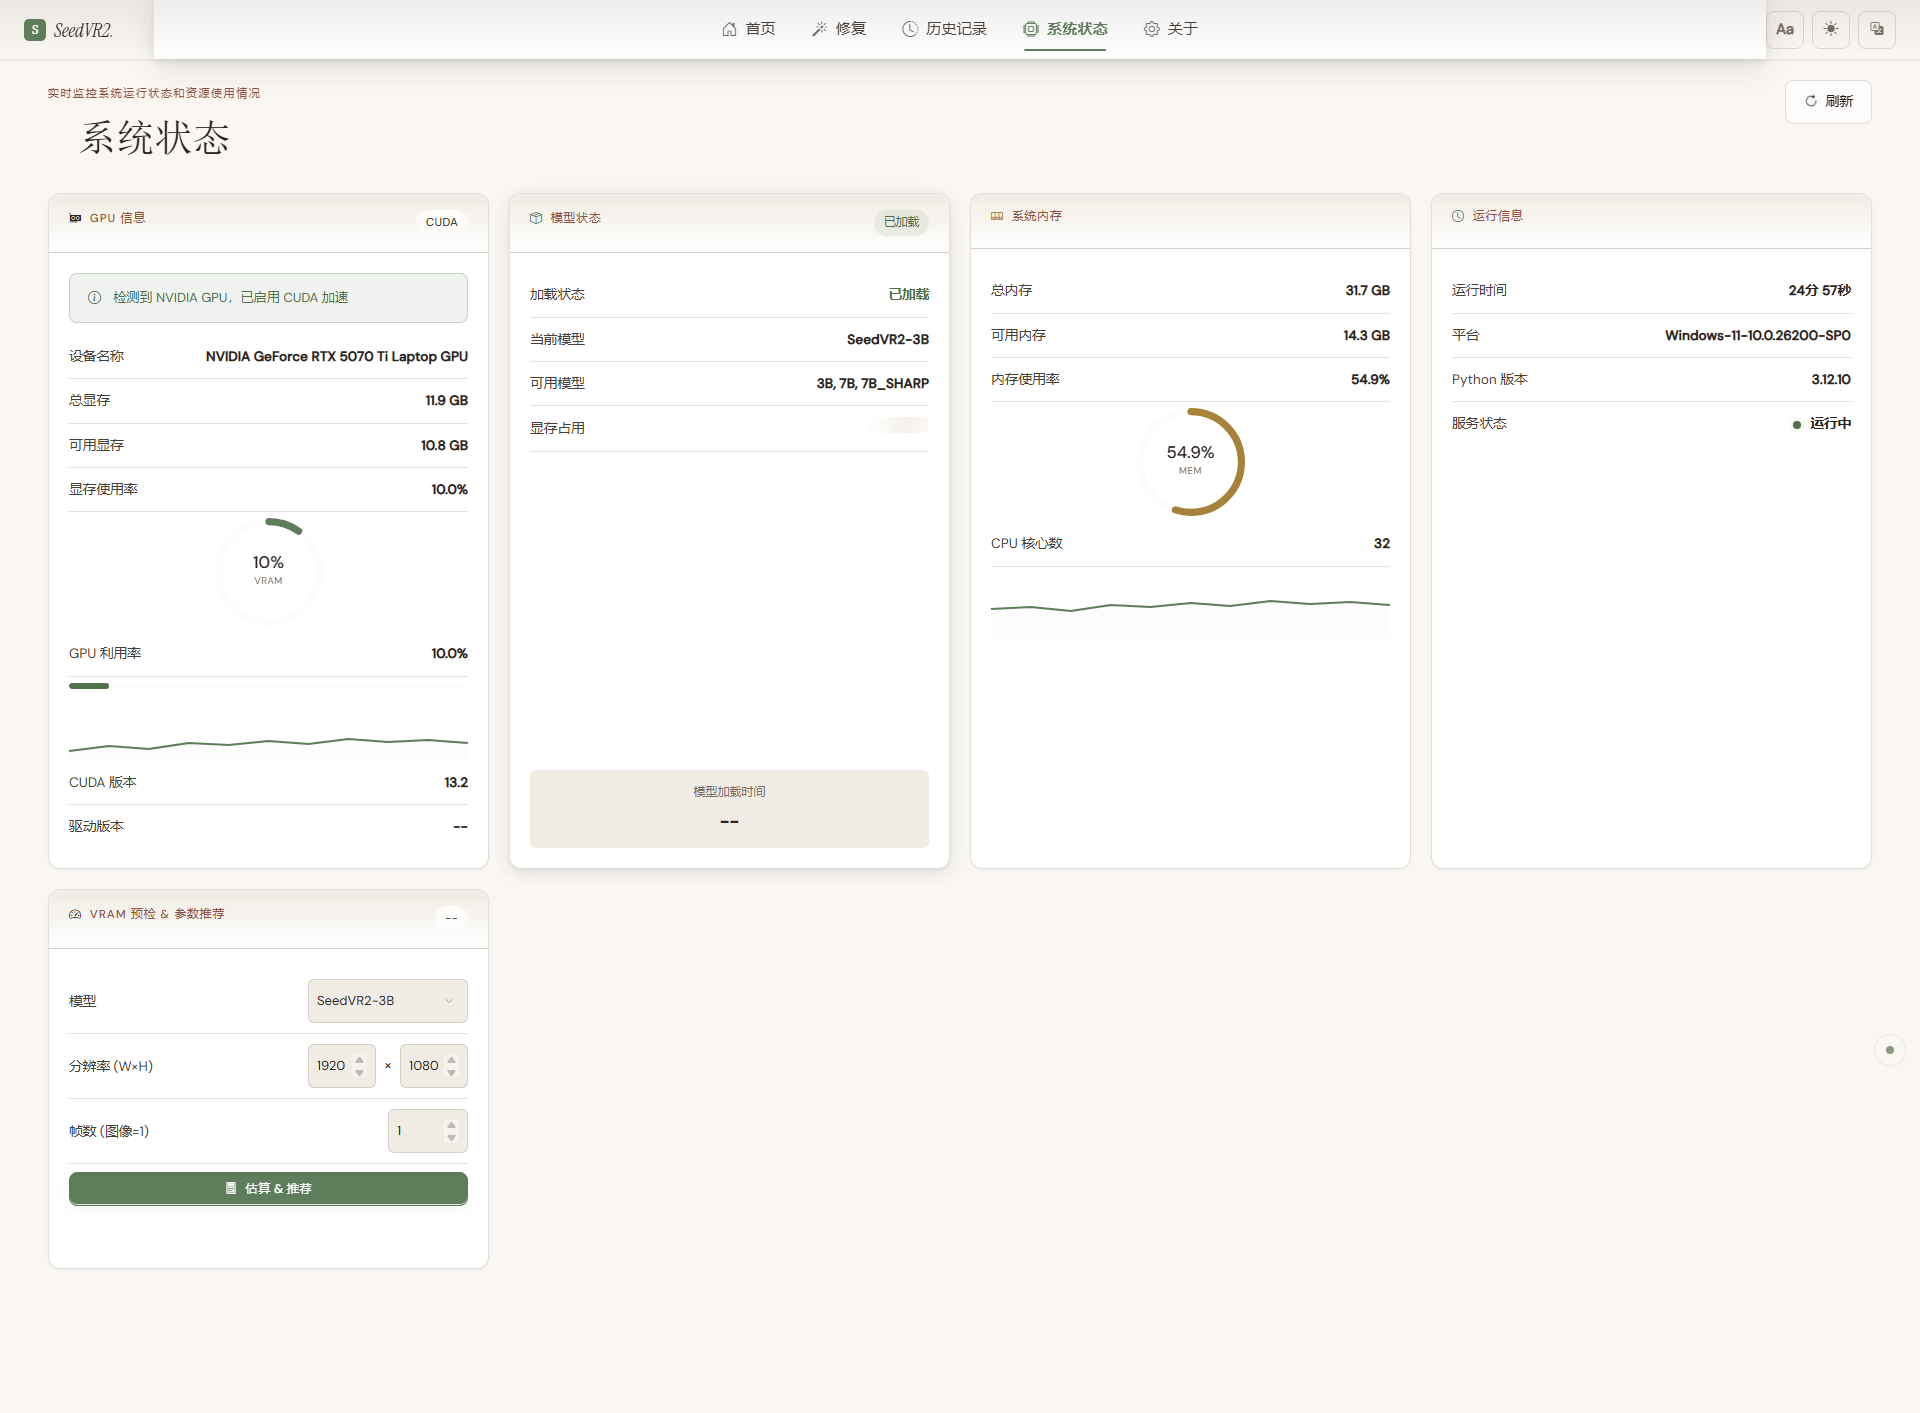
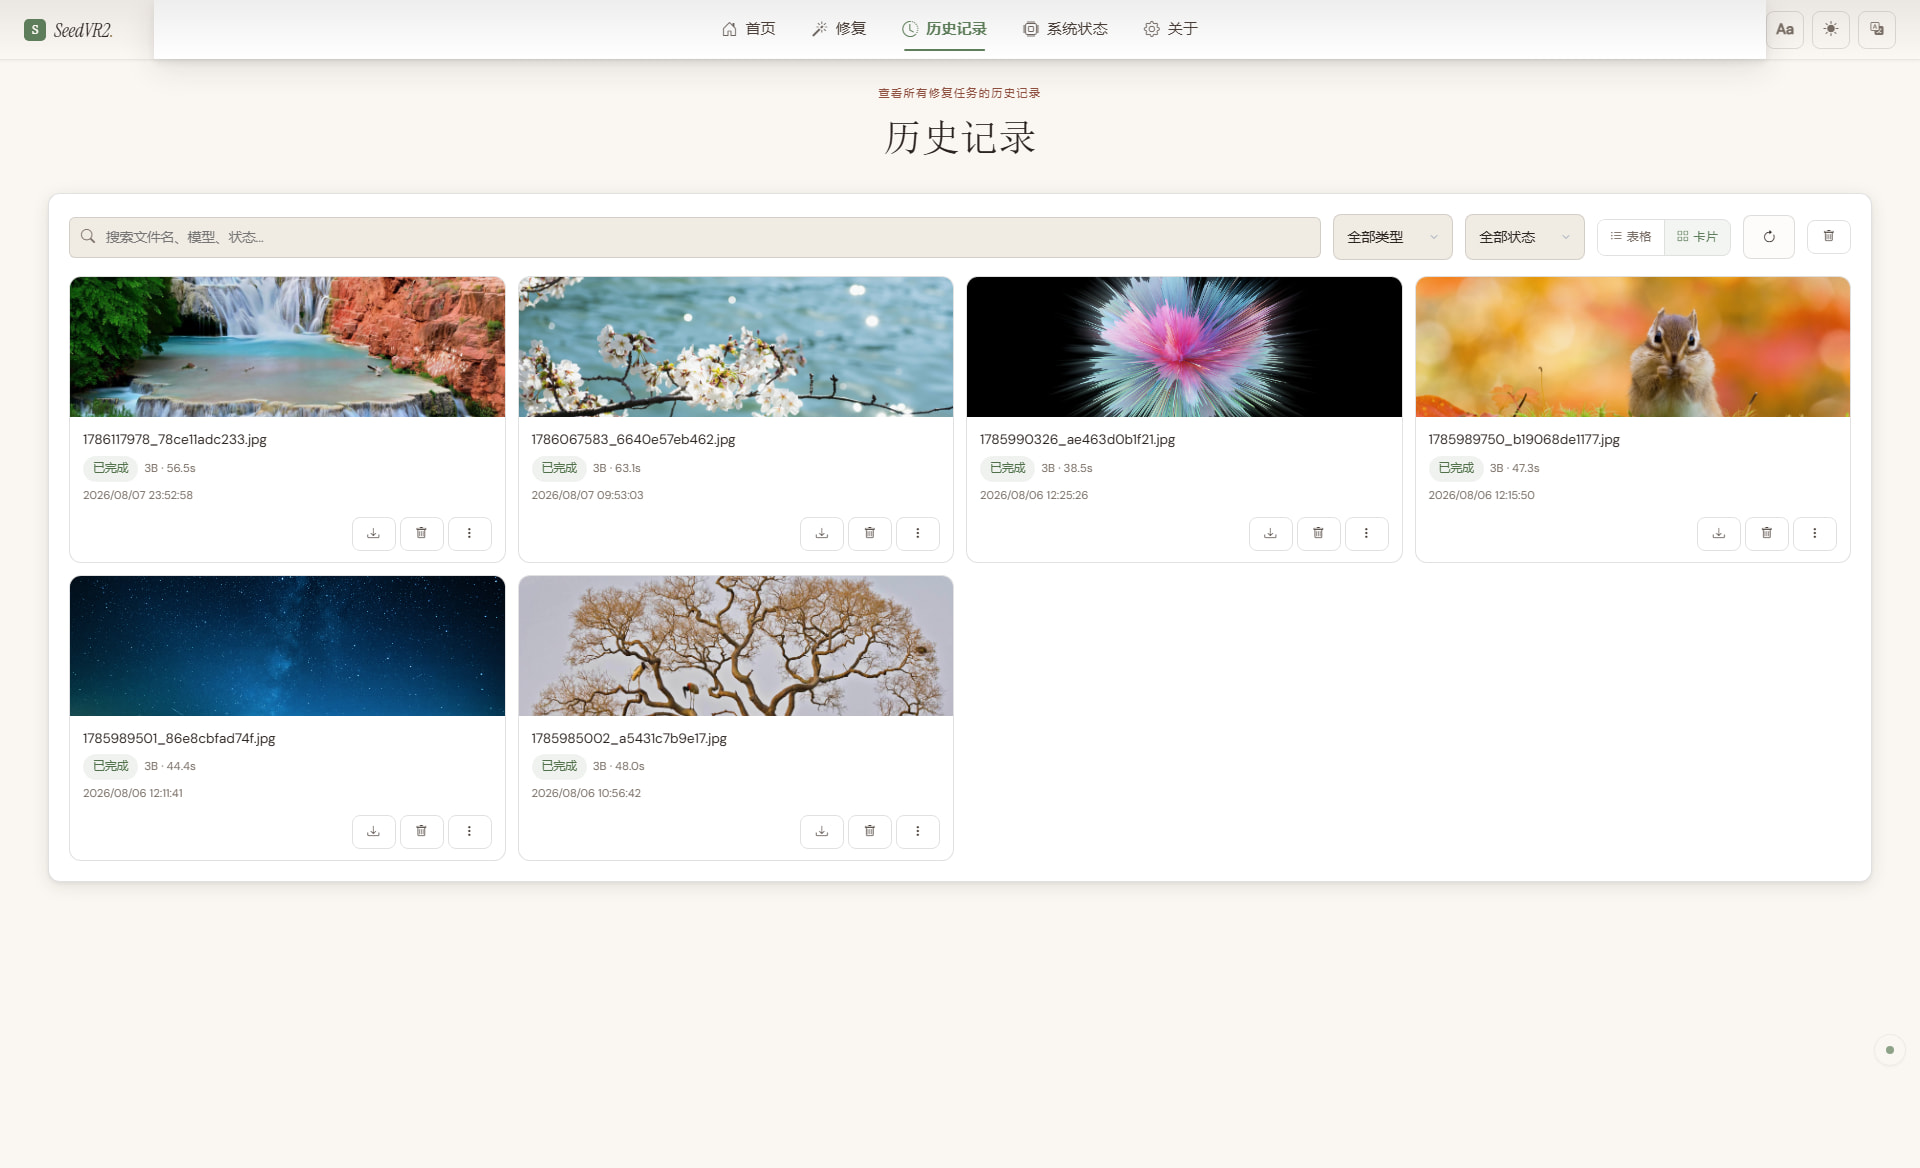
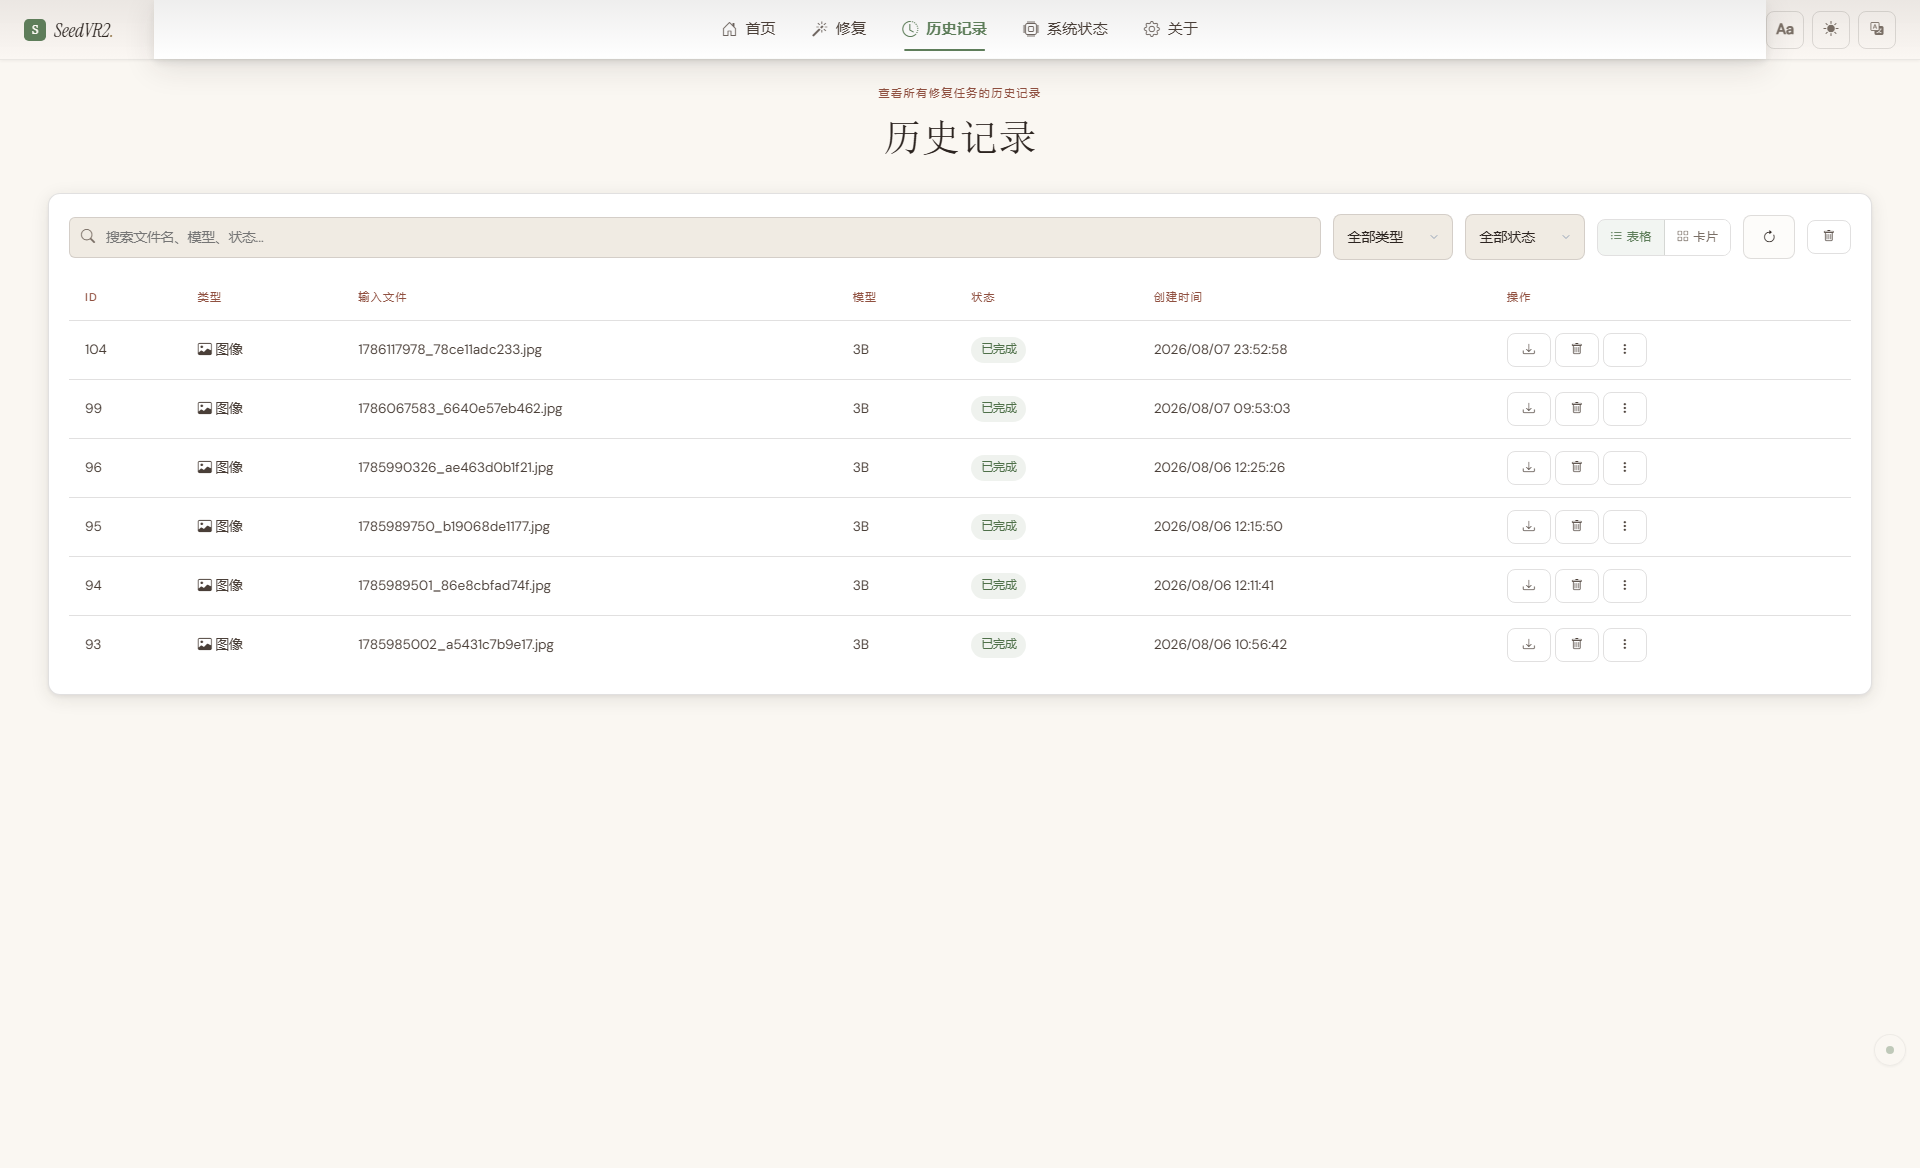
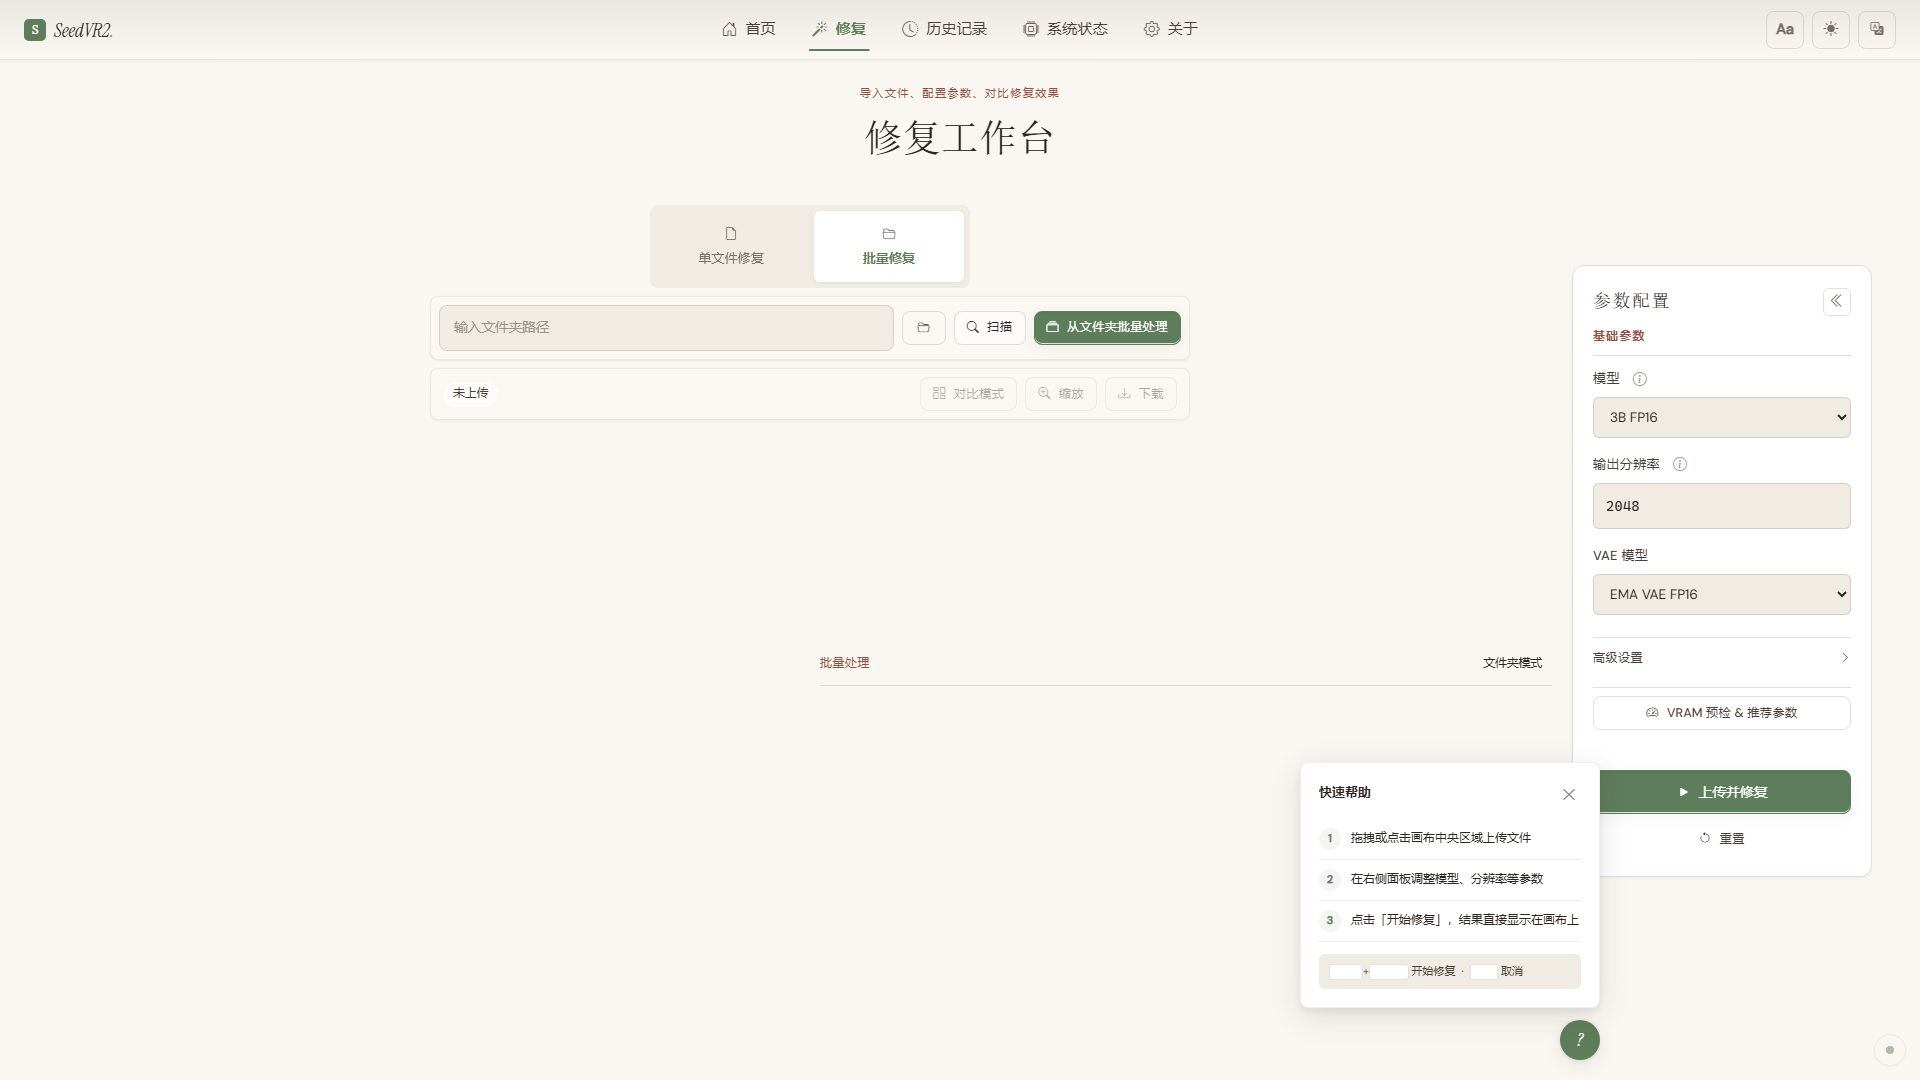
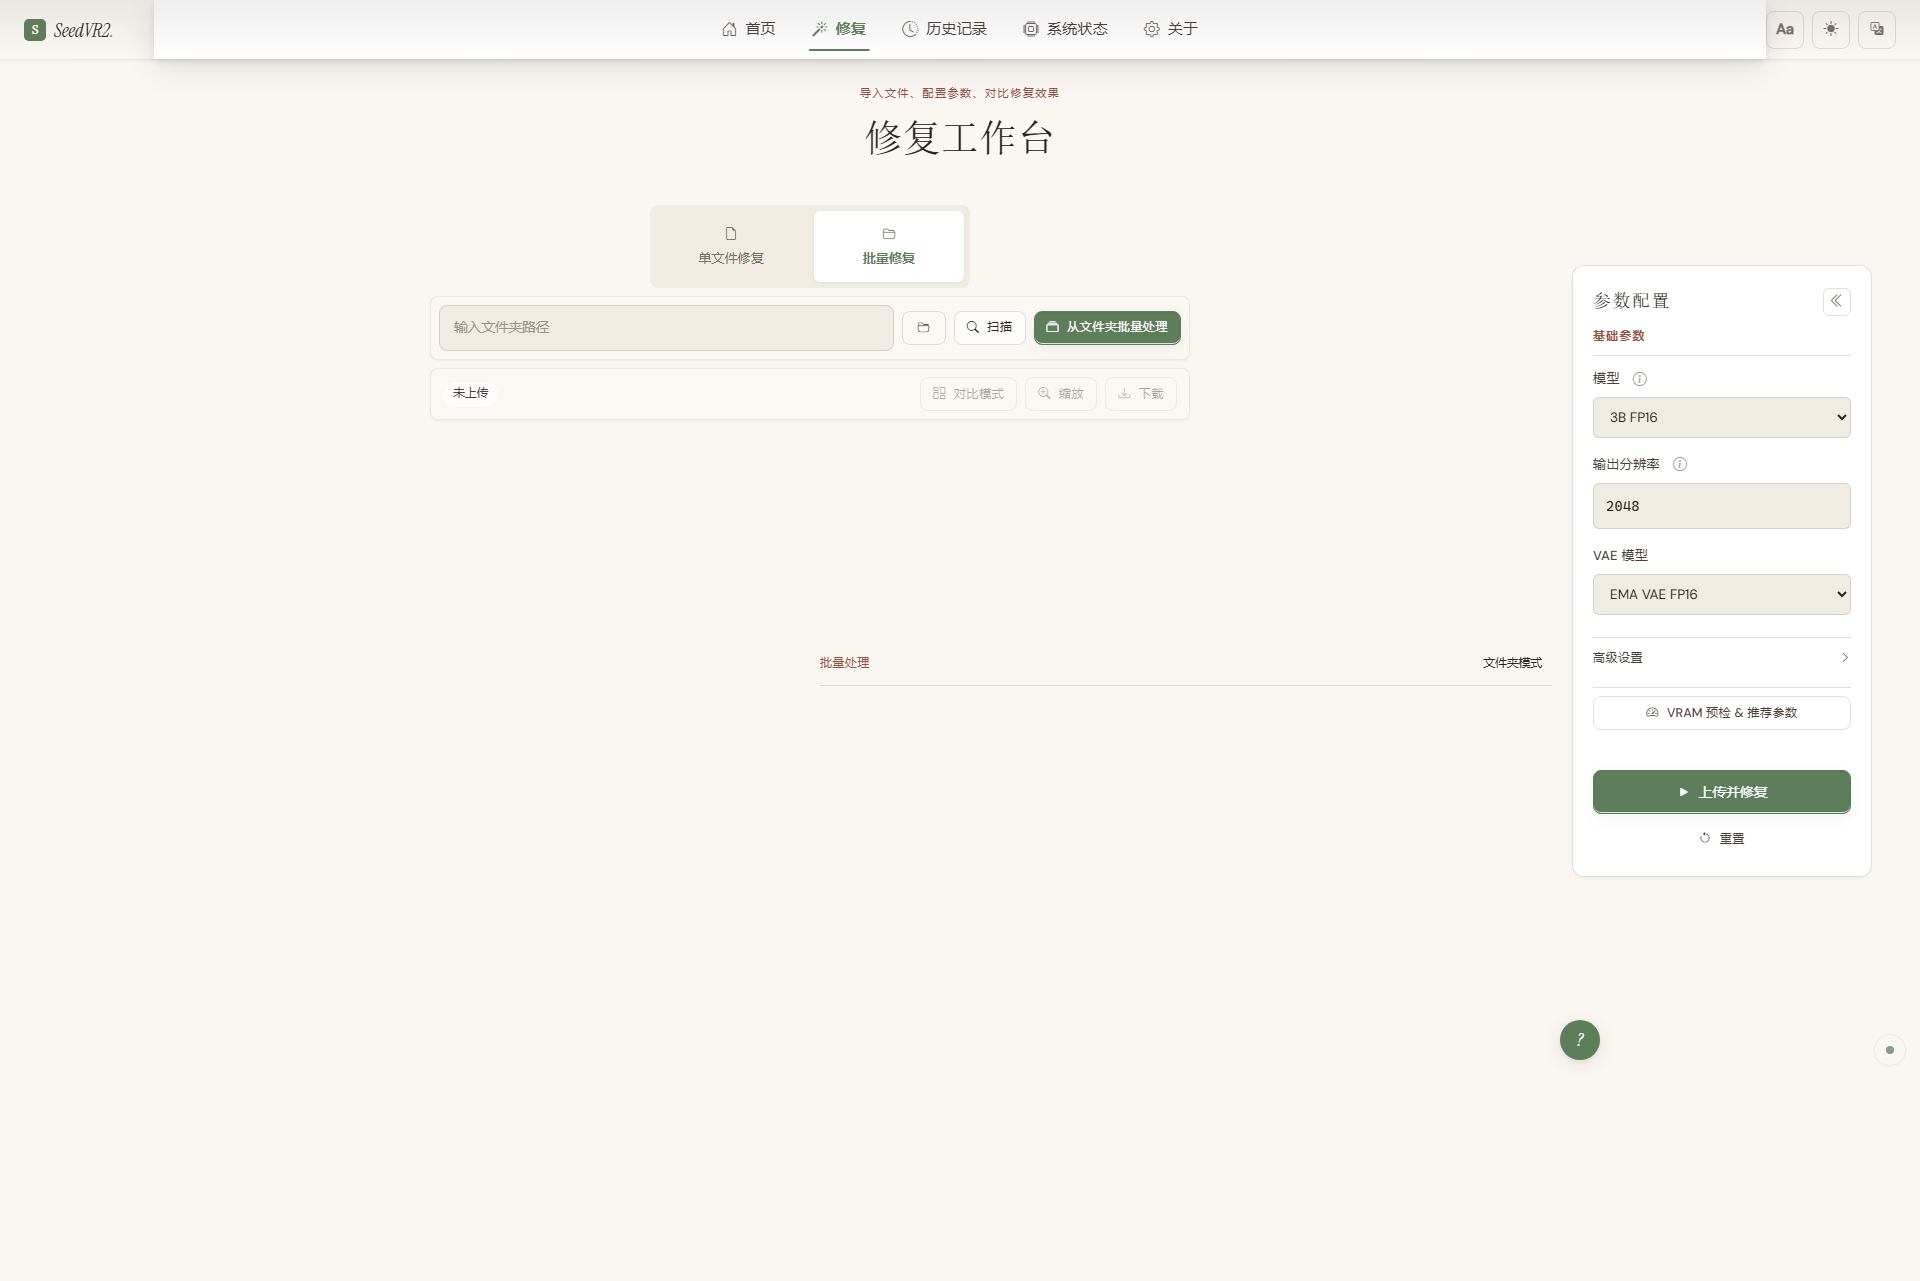
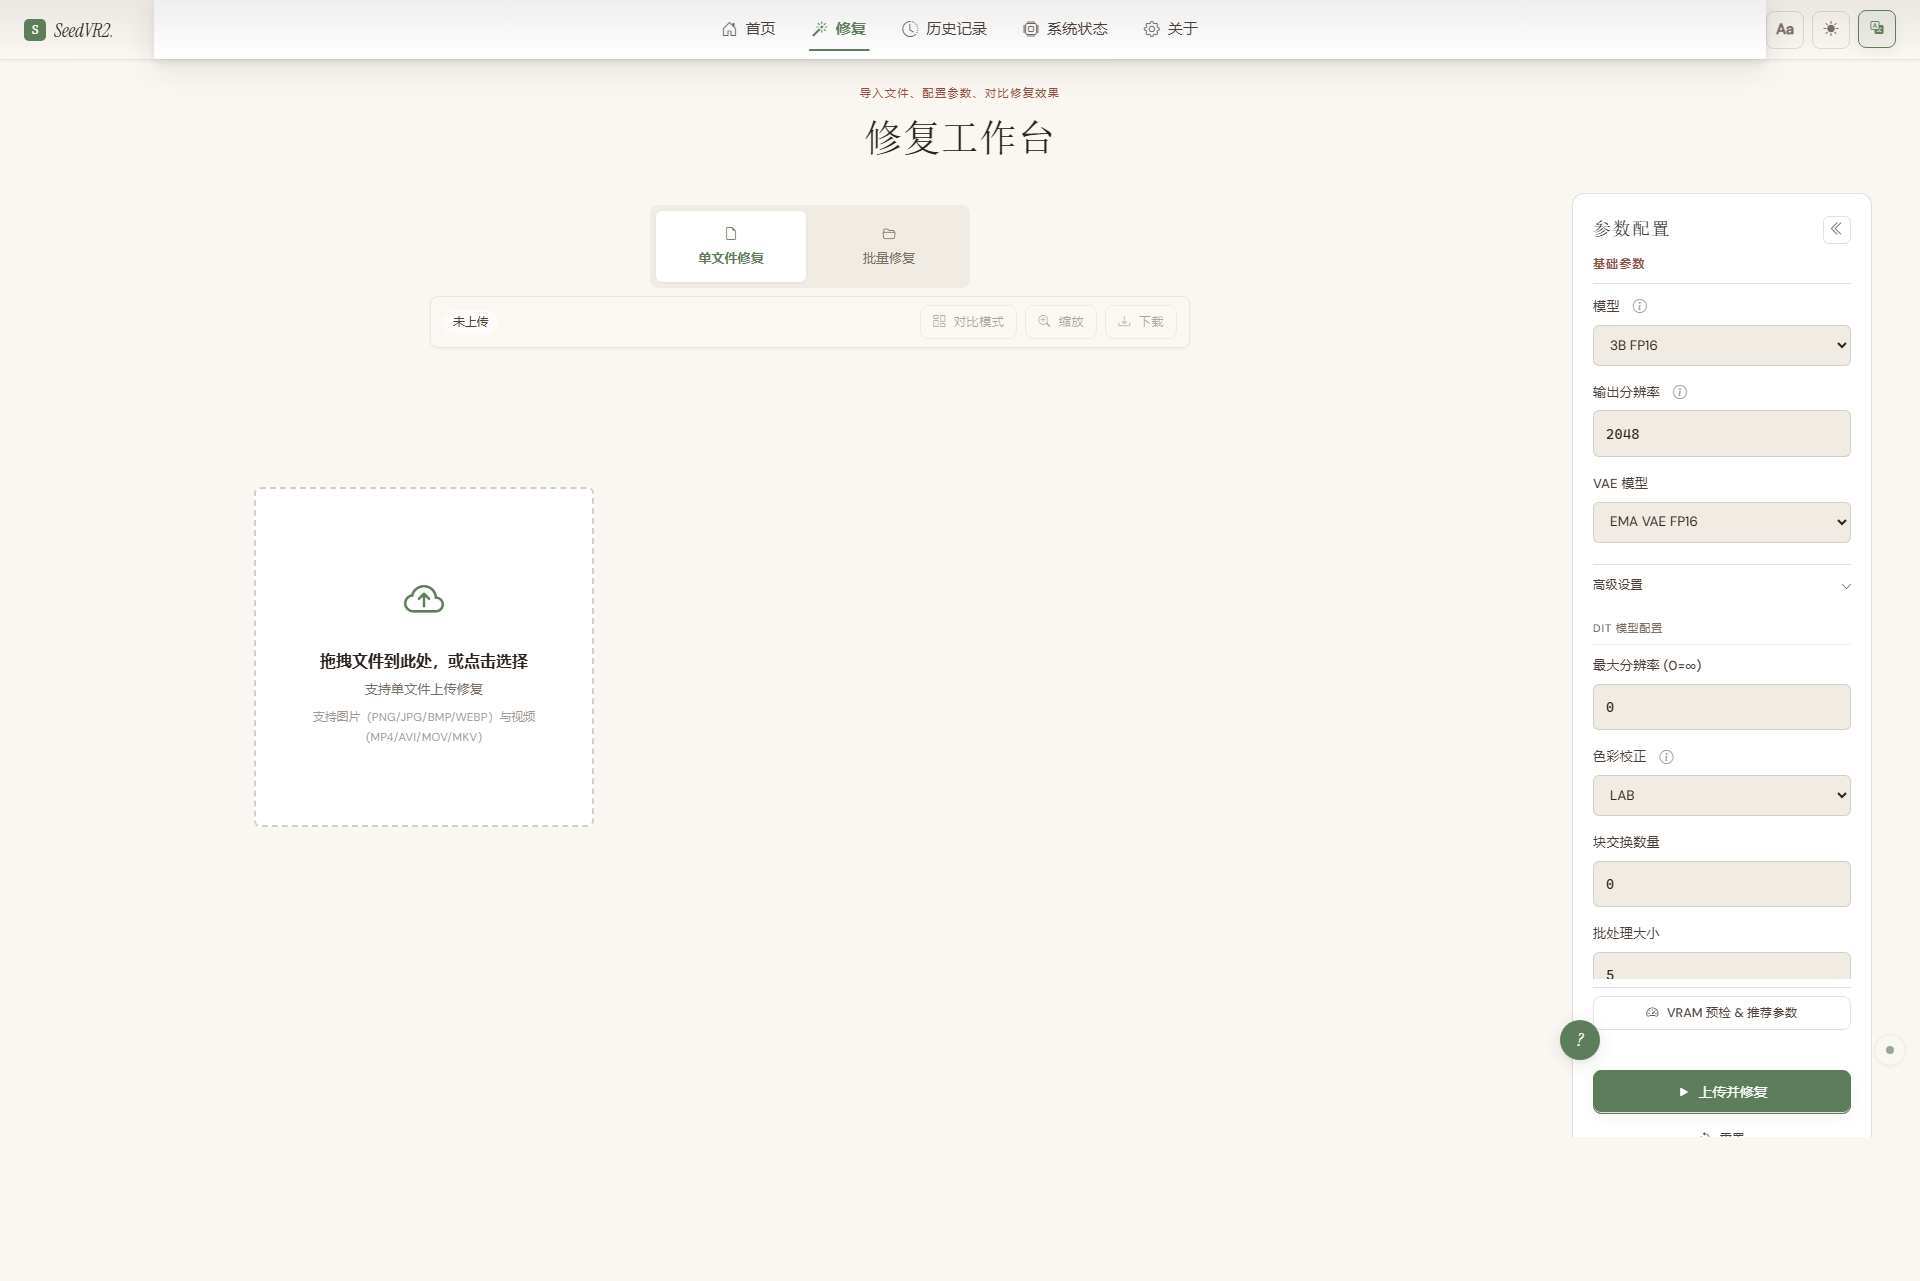
用 Trae 写前端模板和后端路由。系统状态页 / 修复工作台 / 历史记录 / 模型设置 四个主页面,HTMX 做局部刷新,SSE 实时推 GPU 状态和任务进度。这部分和 Trae 反复迭代最多,因为交互细节密集。
步骤 4:批量任务断点续跑
文件夹批量扫描 + Checkpoint(每处理完一个文件保存进度,崩溃后用「路径+文件大小+修改时间」指纹去重恢复)。这块业务逻辑复杂、状态机容易写错,我是先在 Trae 里写状态机描述让它给 Python 实现,再让它针对每个状态分支补单元测试。
步骤 5:i18n —— 5 种语言 + 三层回退
内置中文 / 繁体 / 英文 / 日文 / 法文,键值缺失时回退到 en 再到 key 本身。Trae 帮我做了:
从中文母版自动翻译出 4 套其他语言 JSON;设计「扁平键优先查找」逻辑(防止带点号的键被误判成嵌套结构);写一个 check_i18n_keys.py 脚本,扫所有模板的 {t('...')} 调用,diff 出缺失翻译。
步骤 6:安全加固
权重 SHA256 校验(加载前自动验);上传文件魔数校验(防伪装成图片的脚本);PathGuard 白名单(防路径遍历下载 outputs/ 之外的文件);Web UI 默认绑 127.0.0.1,README 里明文禁止改成 0.0.0.0,并给出 Nginx+Caddy+Basic Auth 的局域网方案。
这一整套安全清单是 Trae 按 OWASP 给我列的初版,我针对本项目模型(用户能上传任意文件 + 能下载 outputs)做了取舍。
步骤 7:CI/CD & 发版
Trae 帮我搭了 6 个 GitHub Actions(ci / dependency-audit / e2e / gpg-signed-release / performance / security),还写了 GPG 签名发布 workflow,Release 时自动生成 SHA256SUMS + GPG 签名。
步骤 8:文档 & 社区化
README、AGENTS.md(给后续 AI 协作者看的)、CONTRIBUTING.md、SECURITY.md、DEPLOYMENT.md、纯前端 GitHub Pages 演示站(.github/workflows/pages-deploy.yml 自动部署 demo/,无 GPU 也能体验完整界面)——这些文档的初稿、目录结构、措辞都是 Trae 起的头,我再做事实校对。
三、提效前后对比
表 1:单人独立开发各阶段耗时对比
| 序号 | 维度 | 我以前独立做类似规模项目的经验值 | 这次用 Trae Code |
|---|---|---|---|
| 1 | 从立项到 1.0.0 可发布 | ~ 6 个月 | 一个月 |
| 2 | 核心 Python 代码 | 1 人 / 1.5 万行 / 4 个月 | 1 人 / 1.8 万行 / 约 5 周 |
| 3 | 安全方案设计 | 1 周调研+实现 | 1 天(Trae 给 OWASP 初版,我做适配) |
| 4 | i18n(5 语言) | 1 周(中文母版+机翻+人工校对) | 2 天(Trae 自动翻译+我逐条校对) |
| 5 | CI/CD & GPG 签名发布 | 1 周 | 半天(Trae 给我现成 workflow 模板) |
| 6 | 文档 | ||
| 7 | 调通一次 24G 显存 OOM 边界 | 2-3 天试错 | 1 天(Trae 读 traceback 直接给方案) |
结论:单人产出 ≈ 原本 3-4 人小团队一个月的工作。
四、成果展示
成果 1:SeedVR2-Toolkit v1.0.0(Apache-2.0 开源)
GitHub 仓库: GitHub - ReSerendipity/SeedVR2-Toolkit: 基于 SeedVR2 扩散模型的视频与图像超分辨率修复工具箱 - 独立运行的 Web UI,一键修复,无需 ComfyUI | AI-powered video & image super-resolution toolkit powered by SeedVR2 diffusion models. Standalone Web UI with one-click restoration, no ComfyUI dependency. Supports 3B/7B/7B-Sharp models, FP16/FP8, GPU Block Swap. · GitHub
在线演示(无 GPU 也能跑): SeedVR2-Toolkit · 在线模拟演示
主要功能截图:

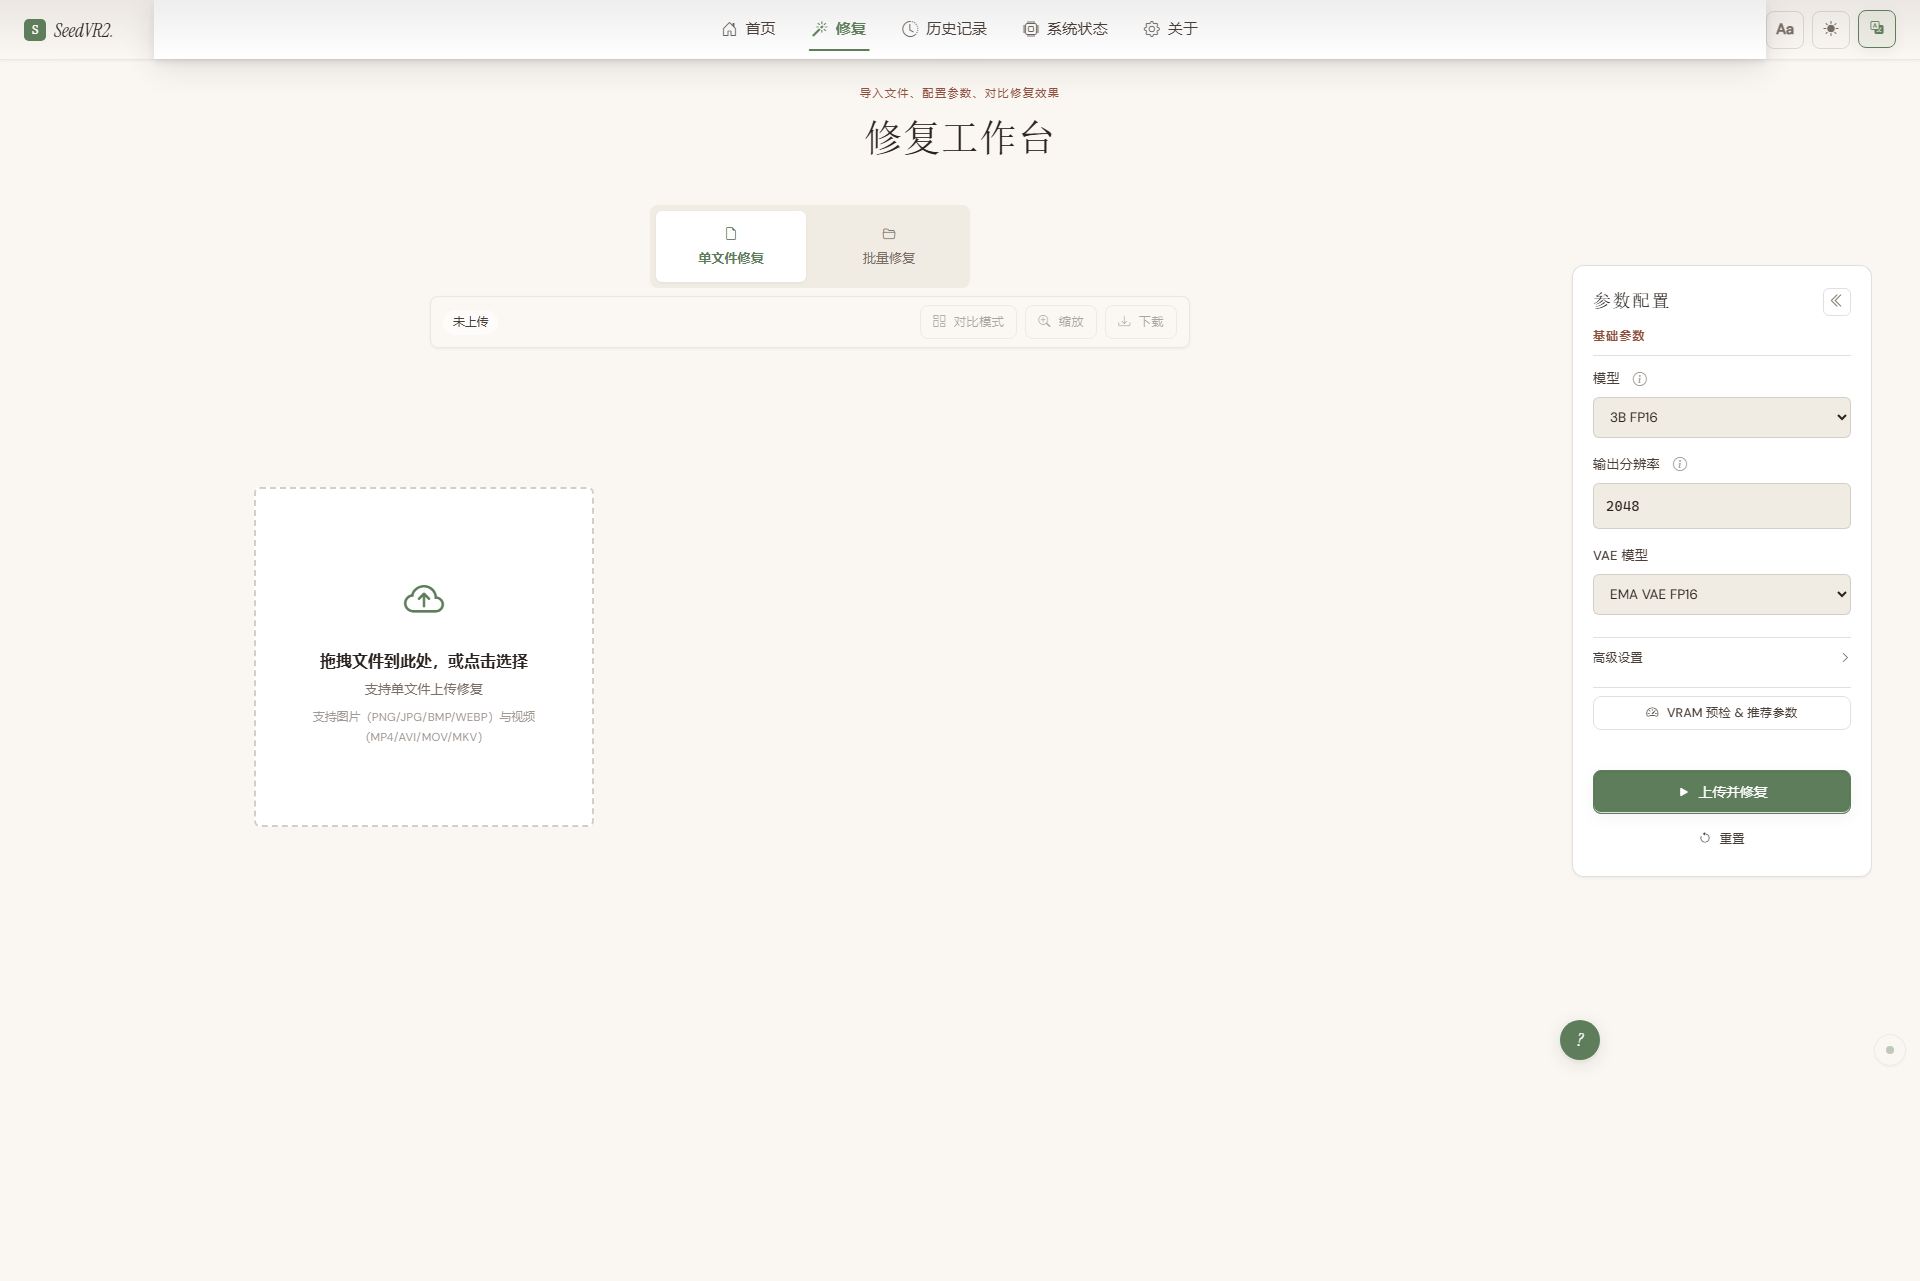
成果 2:跨平台一键安装 & 启动
Windows:双击 install.bat + start.bat;
Linux/macOS:./install.sh + ./start.sh;
Docker:docker build -t seedvr2 . && docker run --gpus all -p 7870:7870 seedvr2
系统状态页内置 VRAM 预检 & 参数推荐计算器(选模型/分辨率/帧数 → 一键得到推荐精度/BlockSwap/tile 大小/风险等级)。
成果 3:自包含演示站
纯 HTML+JS 仿真环境,部署在 GitHub Pages,没下模型权重也能体验完整界面与流程。
成果 4:4 个社交平台同步宣传
表 3:社交平台与仓库链接汇总
序号平台链接内容形式
1B 站(演示视频)https://www.bilibili.com/video/BV1JxgP6MEr5
视频2抖音(演示)https://www.douyin.com/user/self?from_tab_name=main&modal_id=7673864983326805298
短视频3小红书(图文)https://www.xiaohongshu.com/explore/6a7eefe10000000026035795 图文4快手(主页)https://www.kuaishou.com/profile/3x2sk6hj48i2mhs
主页5GitHub(仓库) GitHub - ReSerendipity/SeedVR2-Toolkit: 基于 SeedVR2 扩散模型的视频与图像超分辨率修复工具箱 - 独立运行的 Web UI,一键修复,无需 ComfyUI | AI-powered video & image super-resolution toolkit powered by SeedVR2 diffusion models. Standalone Web UI with one-click restoration, no ComfyUI dependency. Supports 3B/7B/7B-Sharp models, FP16/FP8, GPU Block Swap. · GitHub 源码
五、实践经验总结(3 条血泪)
经验 1:AI 给的代码一定要跑边界用例
Trae 帮我写的 BlockSwap 调度器在常规分辨率下跑得很顺,但 7B 模型 + 1080p 输入 + 长视频时还是 OOM。最后是让 Trae 读 nvidia-smi + 显存 traceback 的输出,反复迭代才把「FP16 → FP8 → BlockSwap」三级回退逻辑调稳。
别盲信生成结果,把模型和硬件的极端组合都过一遍。
经验 2:架构先行,代码后行
我前期花了 1 天专门和 Trae 磨架构(推理引擎 / 显存优化 / 路由 / 安全 这几层怎么切分、模块边界在哪),磨清楚后写代码非常顺,几乎不返工。后期新增的「共享模型目录」「VRAM 推荐参数」「断点续跑」都是按这个边界自然加进去的,没改一次主架构。
经验 3:文档和代码同等重要
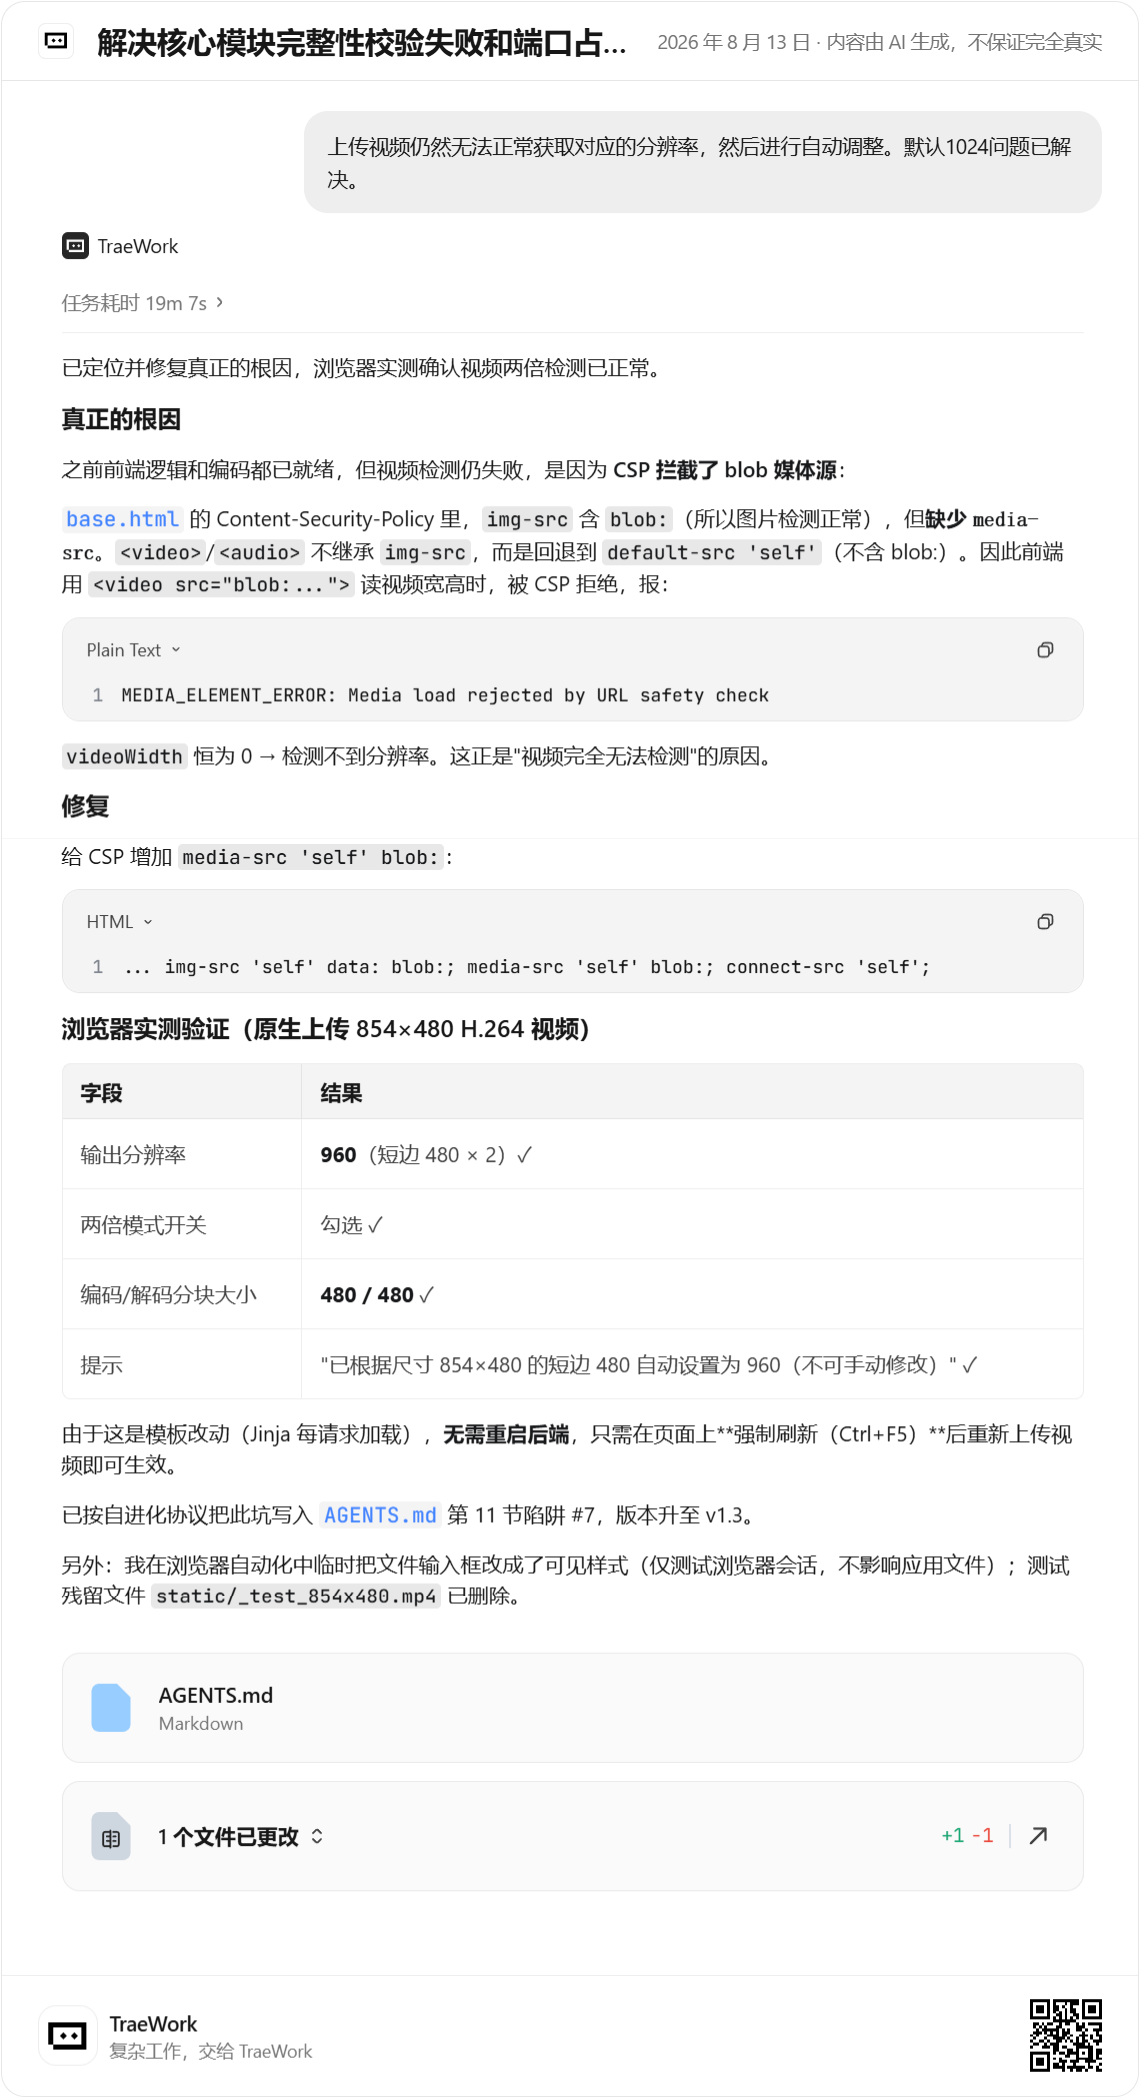
我从第 1 天就同步维护 AGENTS.md(专门给 AI 协作者看的项目指南),里面写清楚目录结构、禁区、命名规则、自检清单、SOP。后续每次让 Trae 接手子任务,先让它读 AGENTS.md 再干活——一致性大幅提升,几乎没出现「它不知道我们项目用 ruff 不用 flake8」这种基础问题。
六、分享你的实操对话(必填)
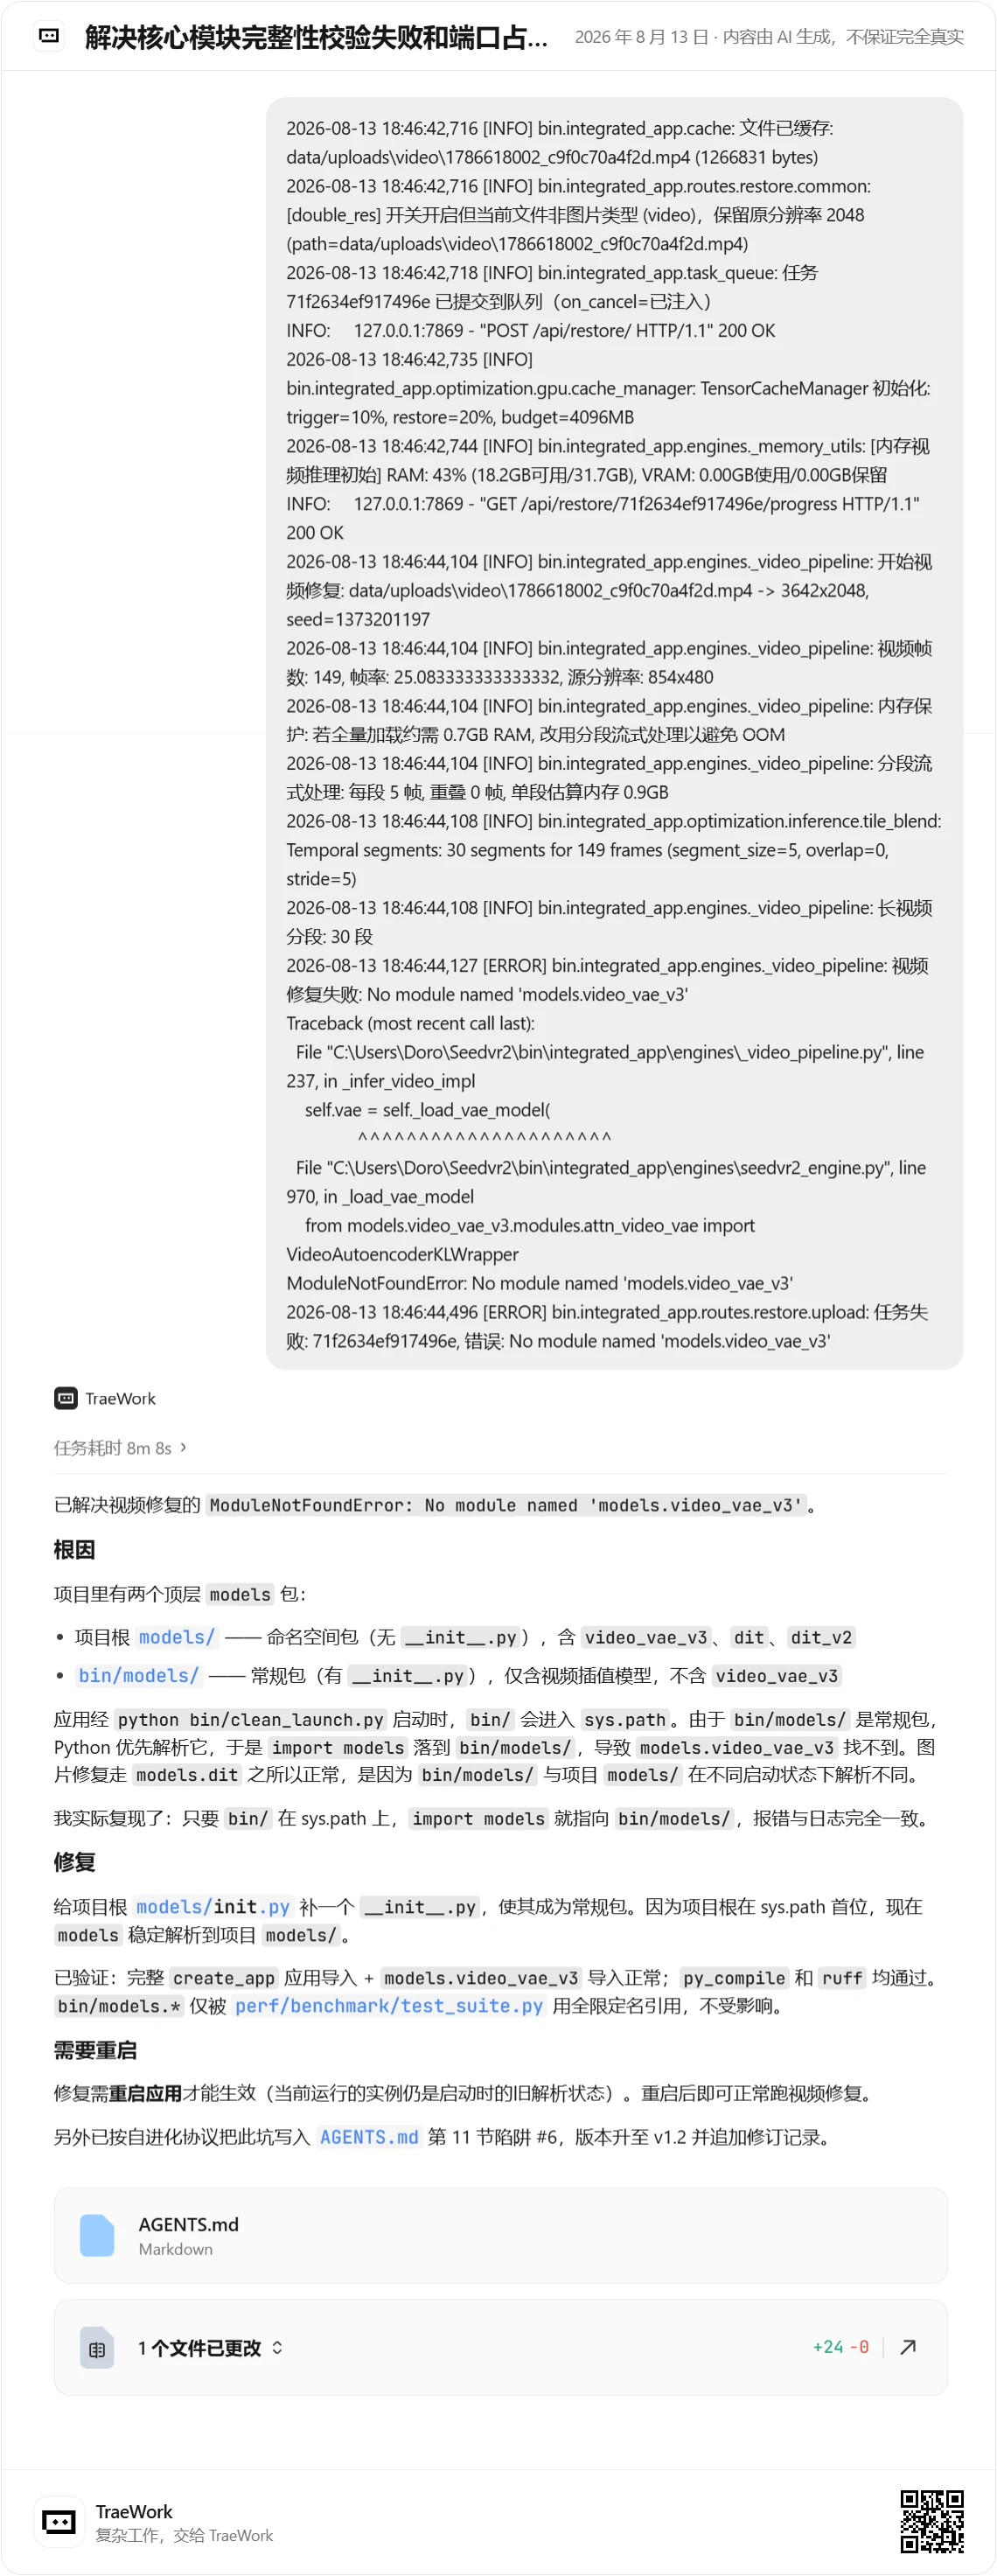
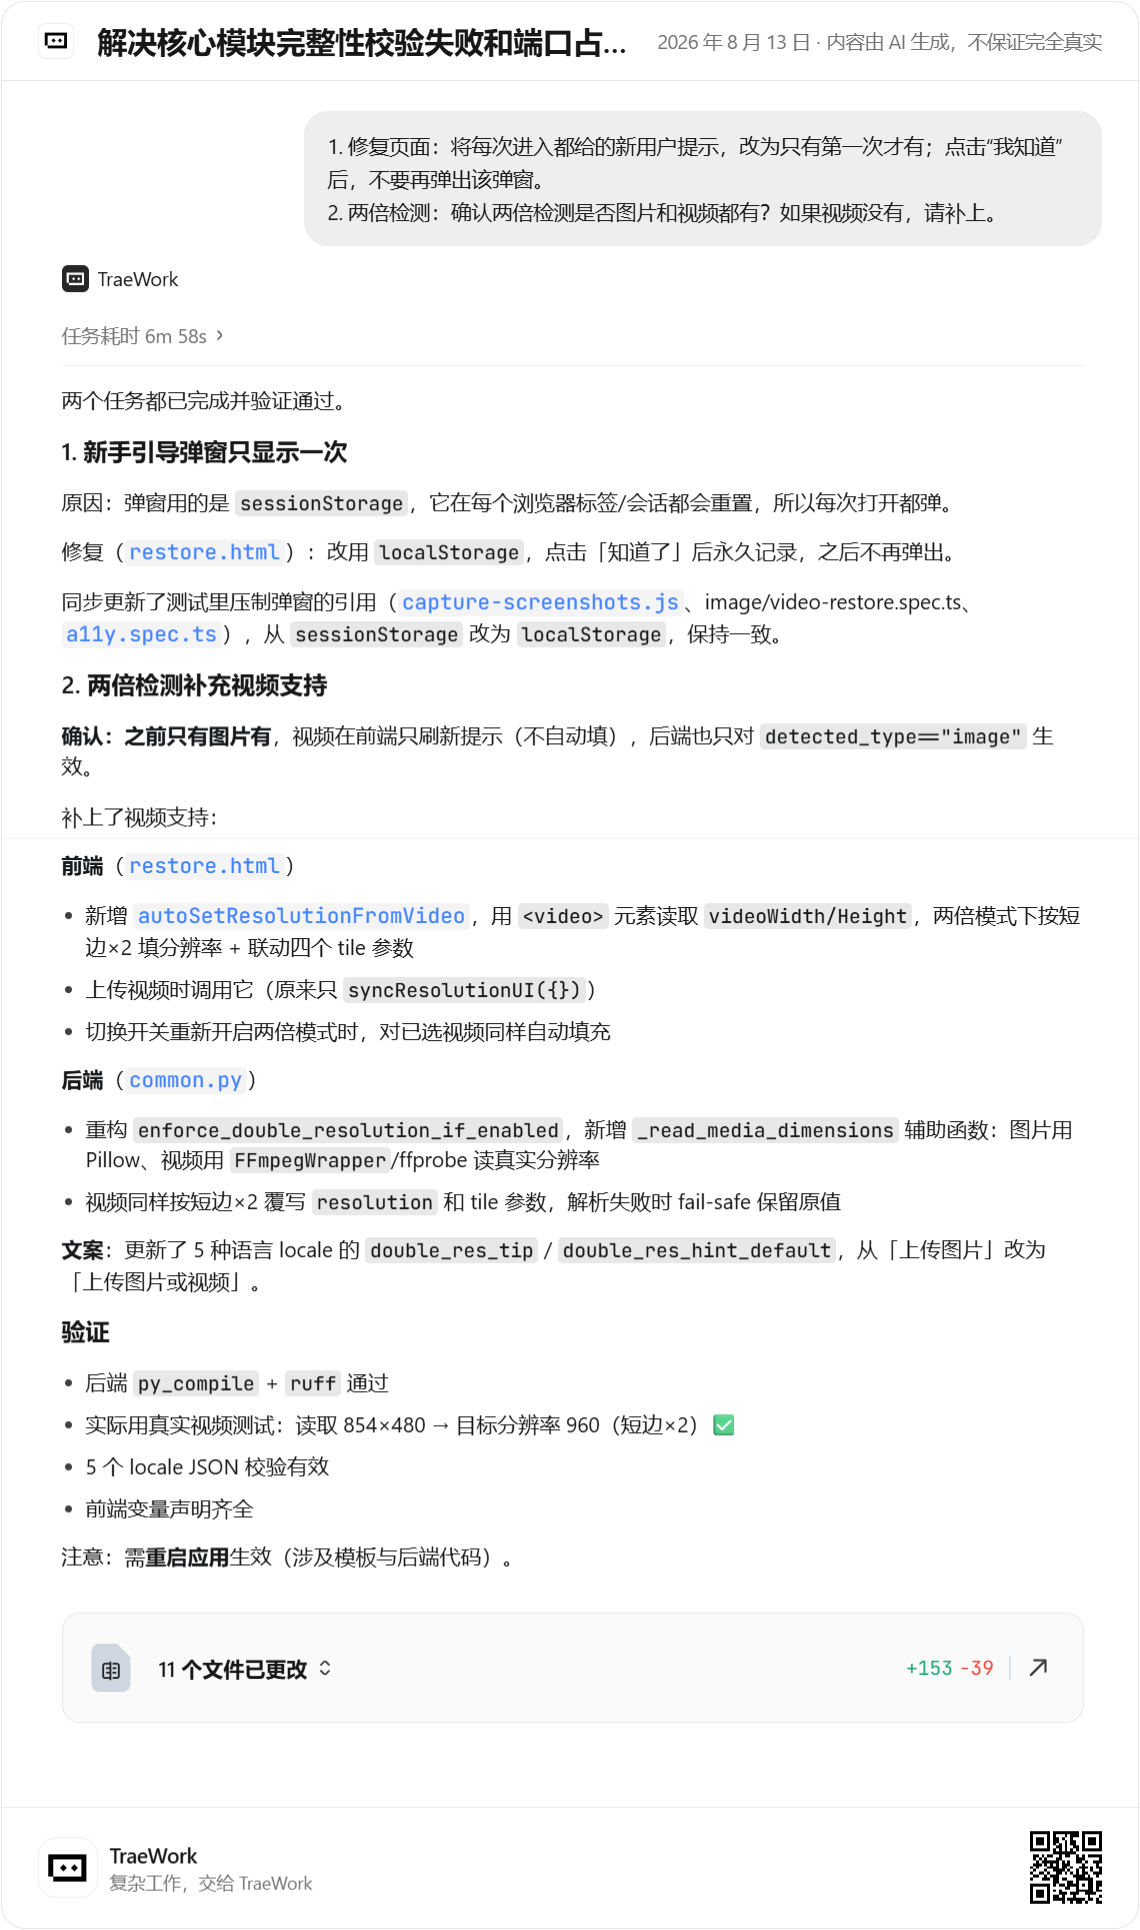
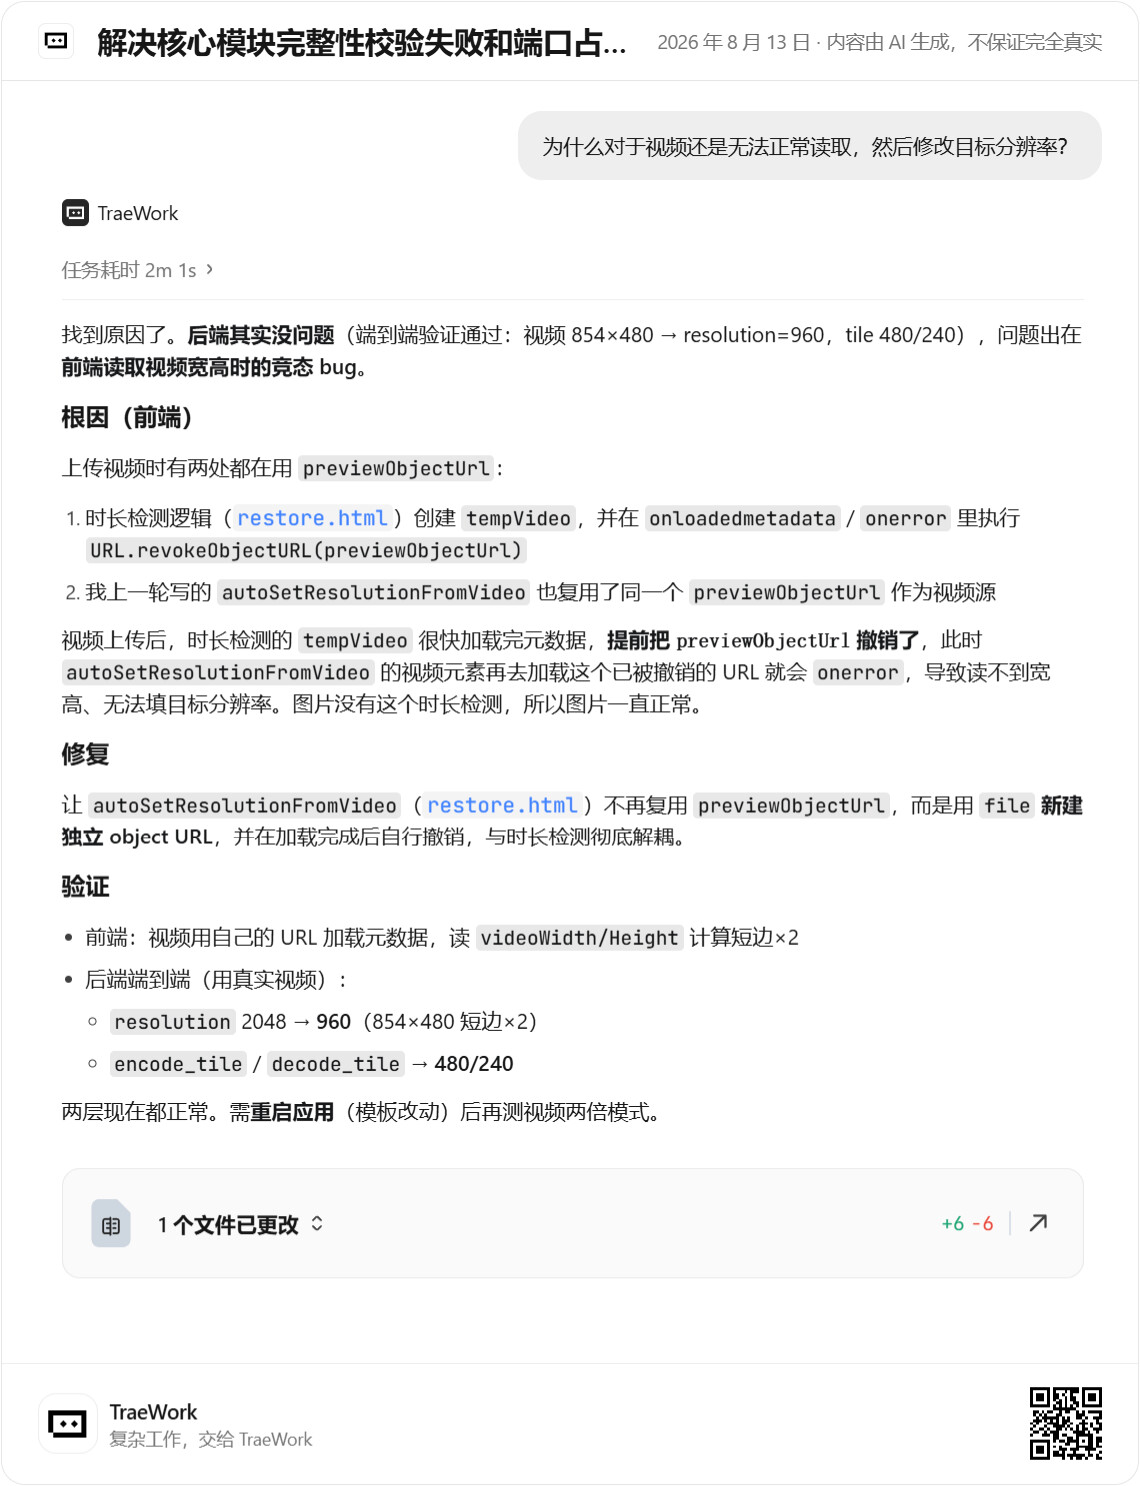
结语
项目地址: GitHub - ReSerendipity/SeedVR2-Toolkit: 基于 SeedVR2 扩散模型的视频与图像超分辨率修复工具箱 - 独立运行的 Web UI,一键修复,无需 ComfyUI | AI-powered video & image super-resolution toolkit powered by SeedVR2 diffusion models. Standalone Web UI with one-click restoration, no ComfyUI dependency. Supports 3B/7B/7B-Sharp models, FP16/FP8, GPU Block Swap. · GitHub
欢迎 Star / Issue / PR。
投稿 TraeWork的1000种用法