【学习工作赛道】中医古籍知识图谱——让千年医道连接现代生活
作品名称: 中医古籍知识图谱(医道图)
作品形态: Web 应用 / PWA
核心技术: AI 知识蒸馏 + 知识图谱 + GraphRAG + 多模态识别
参赛方向: 学习工作赛道
作品定位: 让传统中医古籍从“静态文本”变成可检索、可关联、可追溯、可与 AI 交互,并能够持续生长的知识网络。
01|先和大家打个招呼
大家好,我今年52岁,是一名长期从事信息化工作的开发者,也是一名中医传统文化爱好者。
这个项目最初源于一个非常朴素的问题。
家里人身体不舒服时,我经常想查一些中医资料,但真正开始查以后才发现:
古籍原文晦涩,普通人很难快速理解;
药材、方剂、证候、医案散落在不同典籍中,很难建立联系;
想从一个现代症状反查古籍,却不知道应该从哪一本书、哪个方剂开始;
网络上的中医资料很多,但来源不一,缺少原典依据和知识之间的关联。
于是我产生了一个想法:
能不能把散落在千年古籍中的知识重新连接起来,让普通人不仅“看见古籍”,还能够真正探索古籍?
2026 年 6 月 19 日,我在 TRAE 中创建了这个项目。
从最初的一张知识图谱,到今天能够自动读取名医资料、蒸馏知识、建立关联,再让 AI 从古籍和名医经验中检索证据进行回答,我越来越确定:
AI 对传统文化最有价值的地方,不是替代古籍,而是帮助人重新发现古籍之间原本隐藏的知识联系。
这就是“医道图”的由来。
02|医道图是什么?
医道图是一套基于 AI 知识蒸馏、知识图谱、GraphRAG 与多模态识别构建的中医古籍智能研习平台。
它尝试解决的不是“如何再做一个聊天机器人”,而是:
如何把古籍、药材、方剂、证候、医案和名医学术思想重新组织成一套可计算、可关联、可检索、可解释的知识体系。
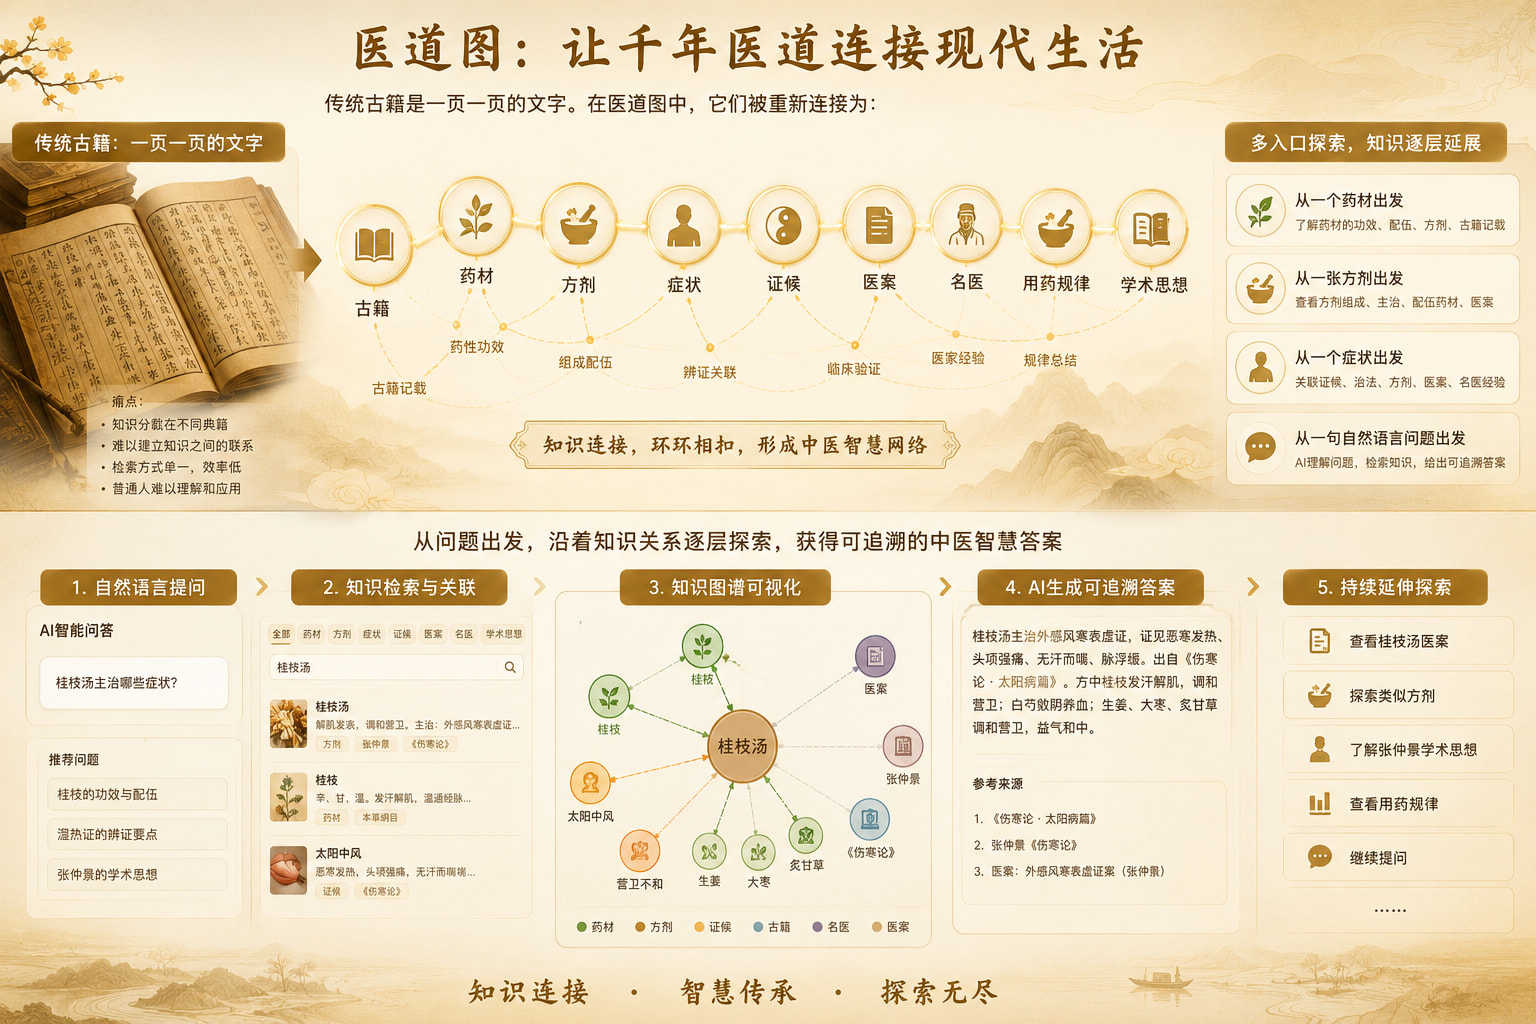
传统古籍是一页一页的文字。
在医道图中,它们被重新连接为:
古籍 ↔ 药材 ↔ 方剂 ↔ 症状 ↔ 证候 ↔ 医案 ↔ 名医 ↔ 用药规律 ↔ 学术思想
用户不再只能按照书名和目录逐页翻阅,而可以从一个药材、一张方剂、一个症状甚至一句自然语言问题出发,沿着知识关系逐层探索。
03|医道图面向谁?
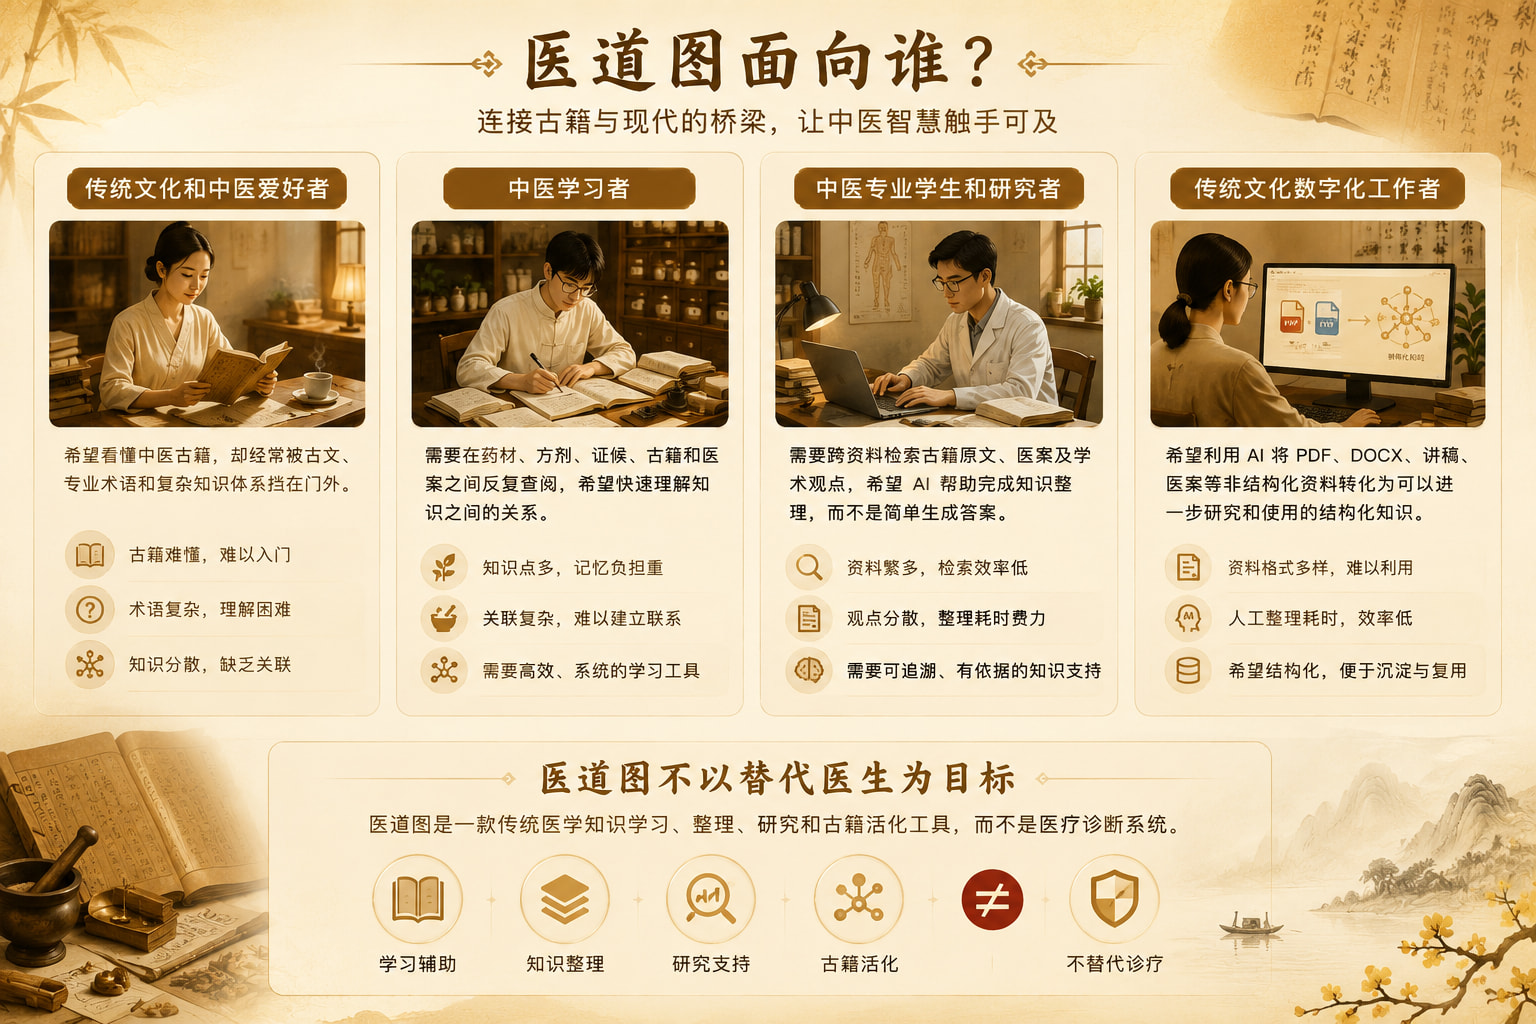
医道图主要面向四类用户。
传统文化和中医爱好者
希望看懂中医古籍,却经常被古文、专业术语和复杂知识体系挡在门外。
中医学习者
需要在药材、方剂、证候、古籍和医案之间反复查阅,希望快速理解知识之间的关系。
中医专业学生和研究者
需要跨资料检索古籍原文、医案及学术观点,希望 AI 帮助完成知识整理,而不是简单生成答案。
传统文化数字化工作者
希望利用 AI 将 PDF、DOCX、讲稿、医案等非结构化资料转化为可以进一步研究和使用的结构化知识。
医道图不以替代医生为目标。
它是一款传统医学知识学习、整理、研究和古籍活化工具,而不是医疗诊断系统。
04|从提出一个问题,到找到千年前的知识依据
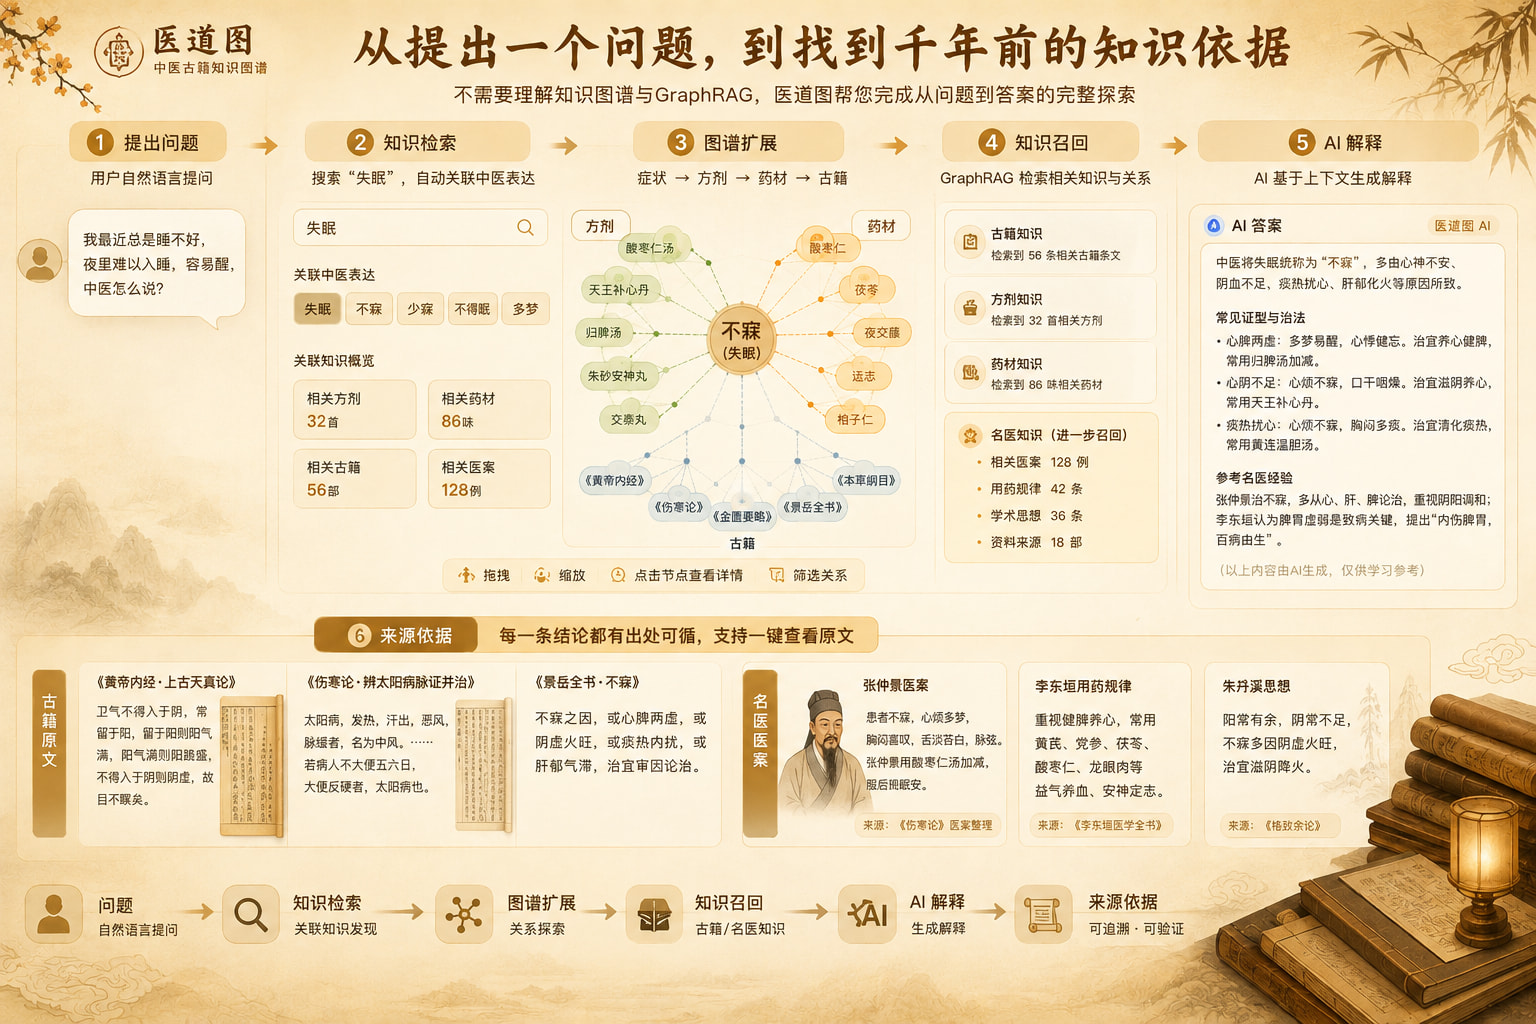
我希望用户使用医道图时,不需要理解什么叫知识图谱,也不需要知道 GraphRAG 是什么。
例如,一个用户对“不寐”相关知识感兴趣。
他可以先在知识检索中搜索“失眠”。
系统不仅检索“失眠”,还可以关联“不寐”“少寐”等中医表达,找到相关药材、方剂和古籍。
然后进入知识图谱。
原本散落在不同数据中的:
症状 → 方剂 → 药材 → 古籍
会变成可以拖拽、筛选、点击和探索的关系网络。
如果还有问题,可以继续询问 AI。
这时 AI 并不是脱离知识库直接生成答案,而是先通过 GraphRAG 检索相关古籍节点和知识关系,再把检索到的上下文交给模型组织回答。
当系统中存在相关名医知识时,还会进一步召回:
名医医案、用药规律、学术思想和资料来源。
最终形成:
问题 → 知识检索 → 图谱扩展 → 古籍/名医知识召回 → AI 解释 → 来源依据
这就是医道图最核心的使用逻辑。
05|复赛完整产品的六大核心能力
① 中医知识检索与知识图谱
这是医道图最初的核心,也是整个系统的数据基础。
初赛阶段,我已经完成药材、方剂、症状和古籍之间的知识建模,并构建了可交互的 D3.js 力导向图。
用户可以从一个知识节点进入网络:
药材 → 相关方剂 → 对应症状 → 古籍出处
也可以反向探索:
症状 → 方剂 → 组成药材 → 相关典籍
图谱支持节点筛选、拖拽、缩放、点击高亮和详情查看。
它解决的不是“有没有这条资料”,而是:
这些知识之间究竟有什么关系?
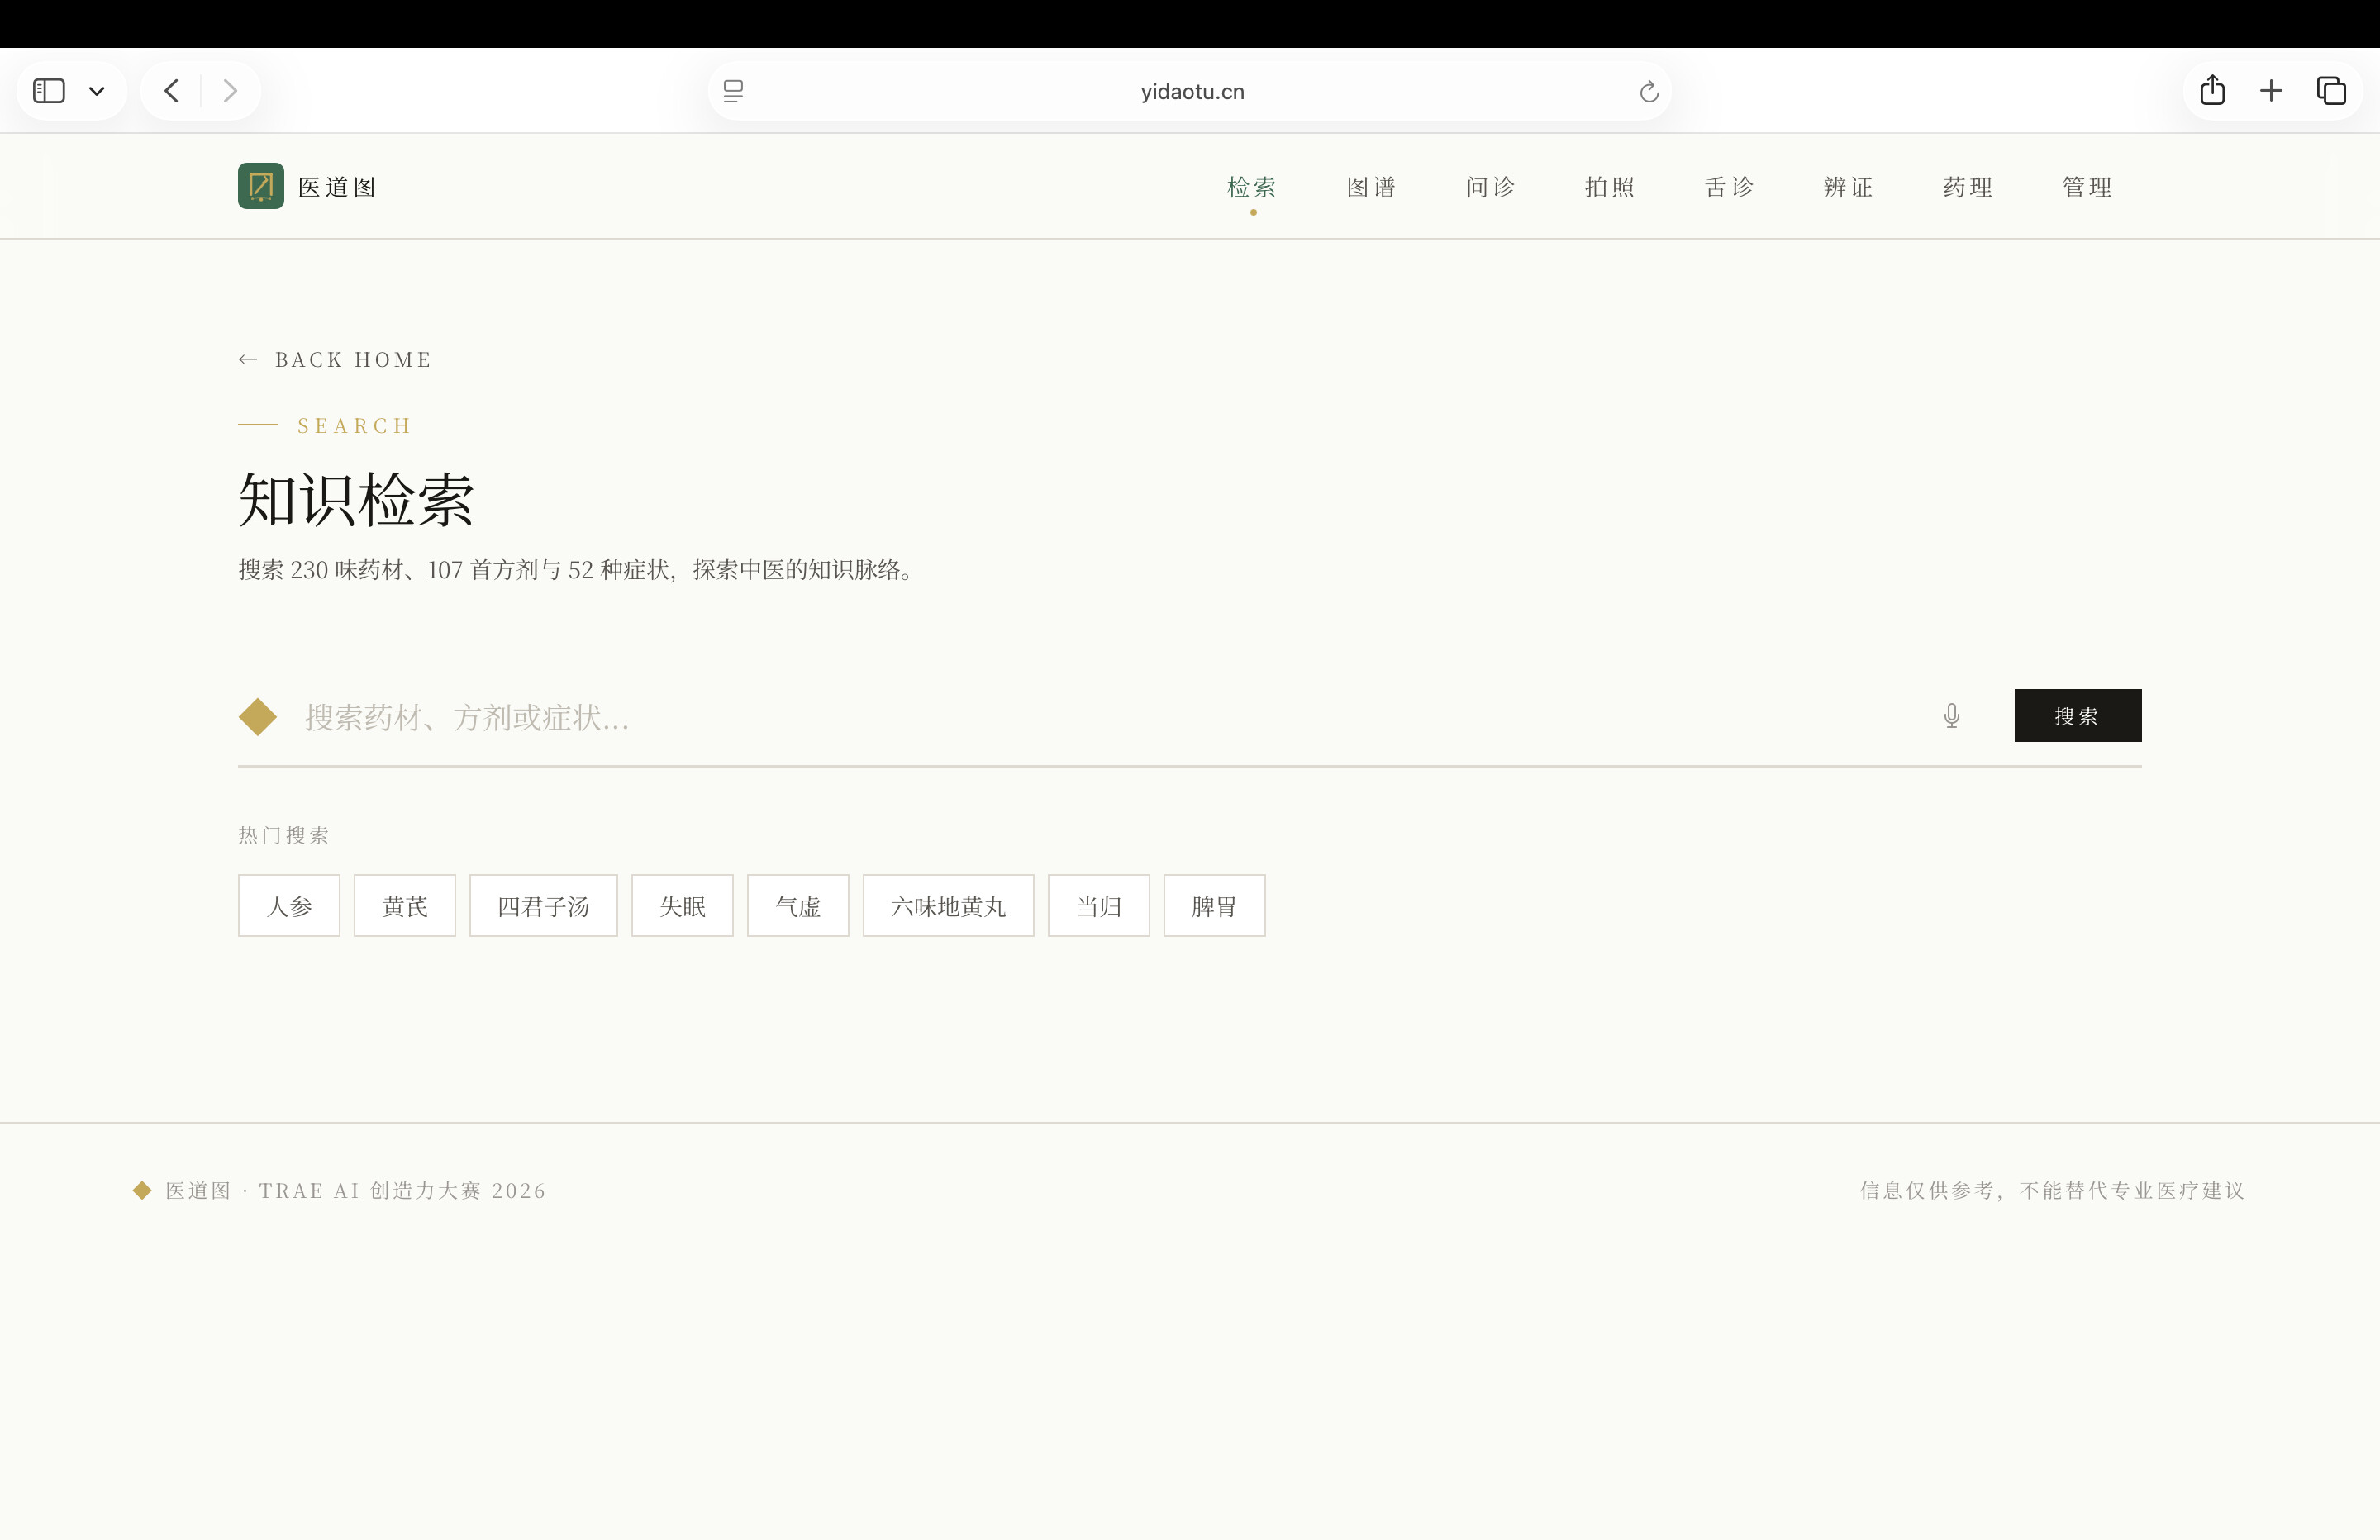
【插图 1:知识检索页面】
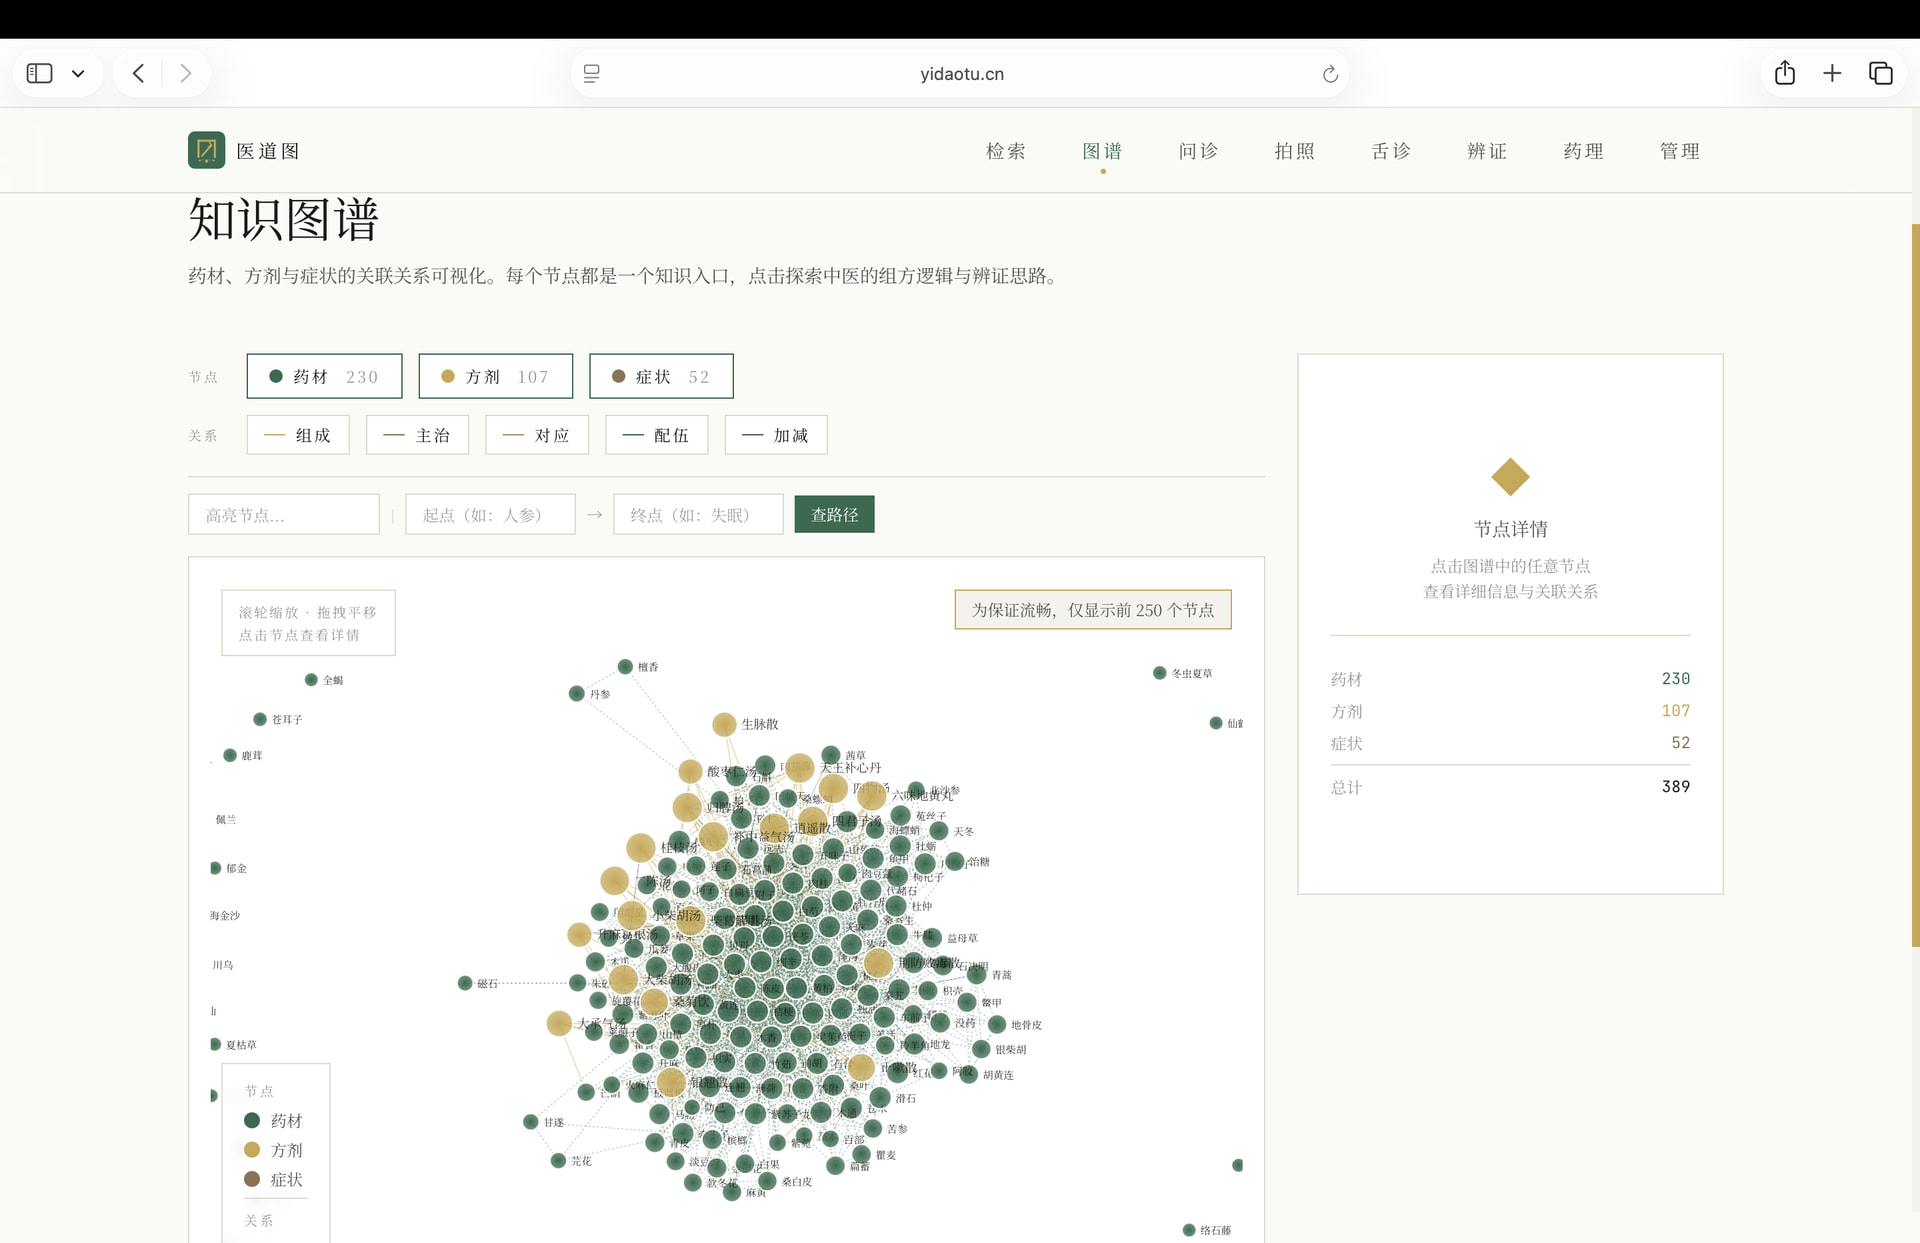
【插图 2:知识图谱筛选、高亮和节点详情】
② GraphRAG 古籍智能问答
普通 RAG 更擅长寻找“相似文本”。
而中医古籍中的很多知识并不是直接写在同一段文字里。
一个方剂与一个症状之间,往往还隔着药材、证候、医案甚至其他典籍。
因此医道图在初赛阶段就开始尝试 GraphRAG:
自然语言问题
↓
知识检索
↓
图关系扩展
↓
召回药材 / 方剂 / 症状 / 古籍
↓
构建上下文
↓
大模型生成解释
↓
显示参考来源
到了复赛,GraphRAG 又继续向前走了一步。
现在它不仅能够召回内置的古籍知识,还可以调用后来通过 AI 蒸馏进入系统的:
名医医案、用药规律和学术思想。
也就是说,知识库已经不再是一套“写死”的数据。
它开始能够持续学习新的资料。
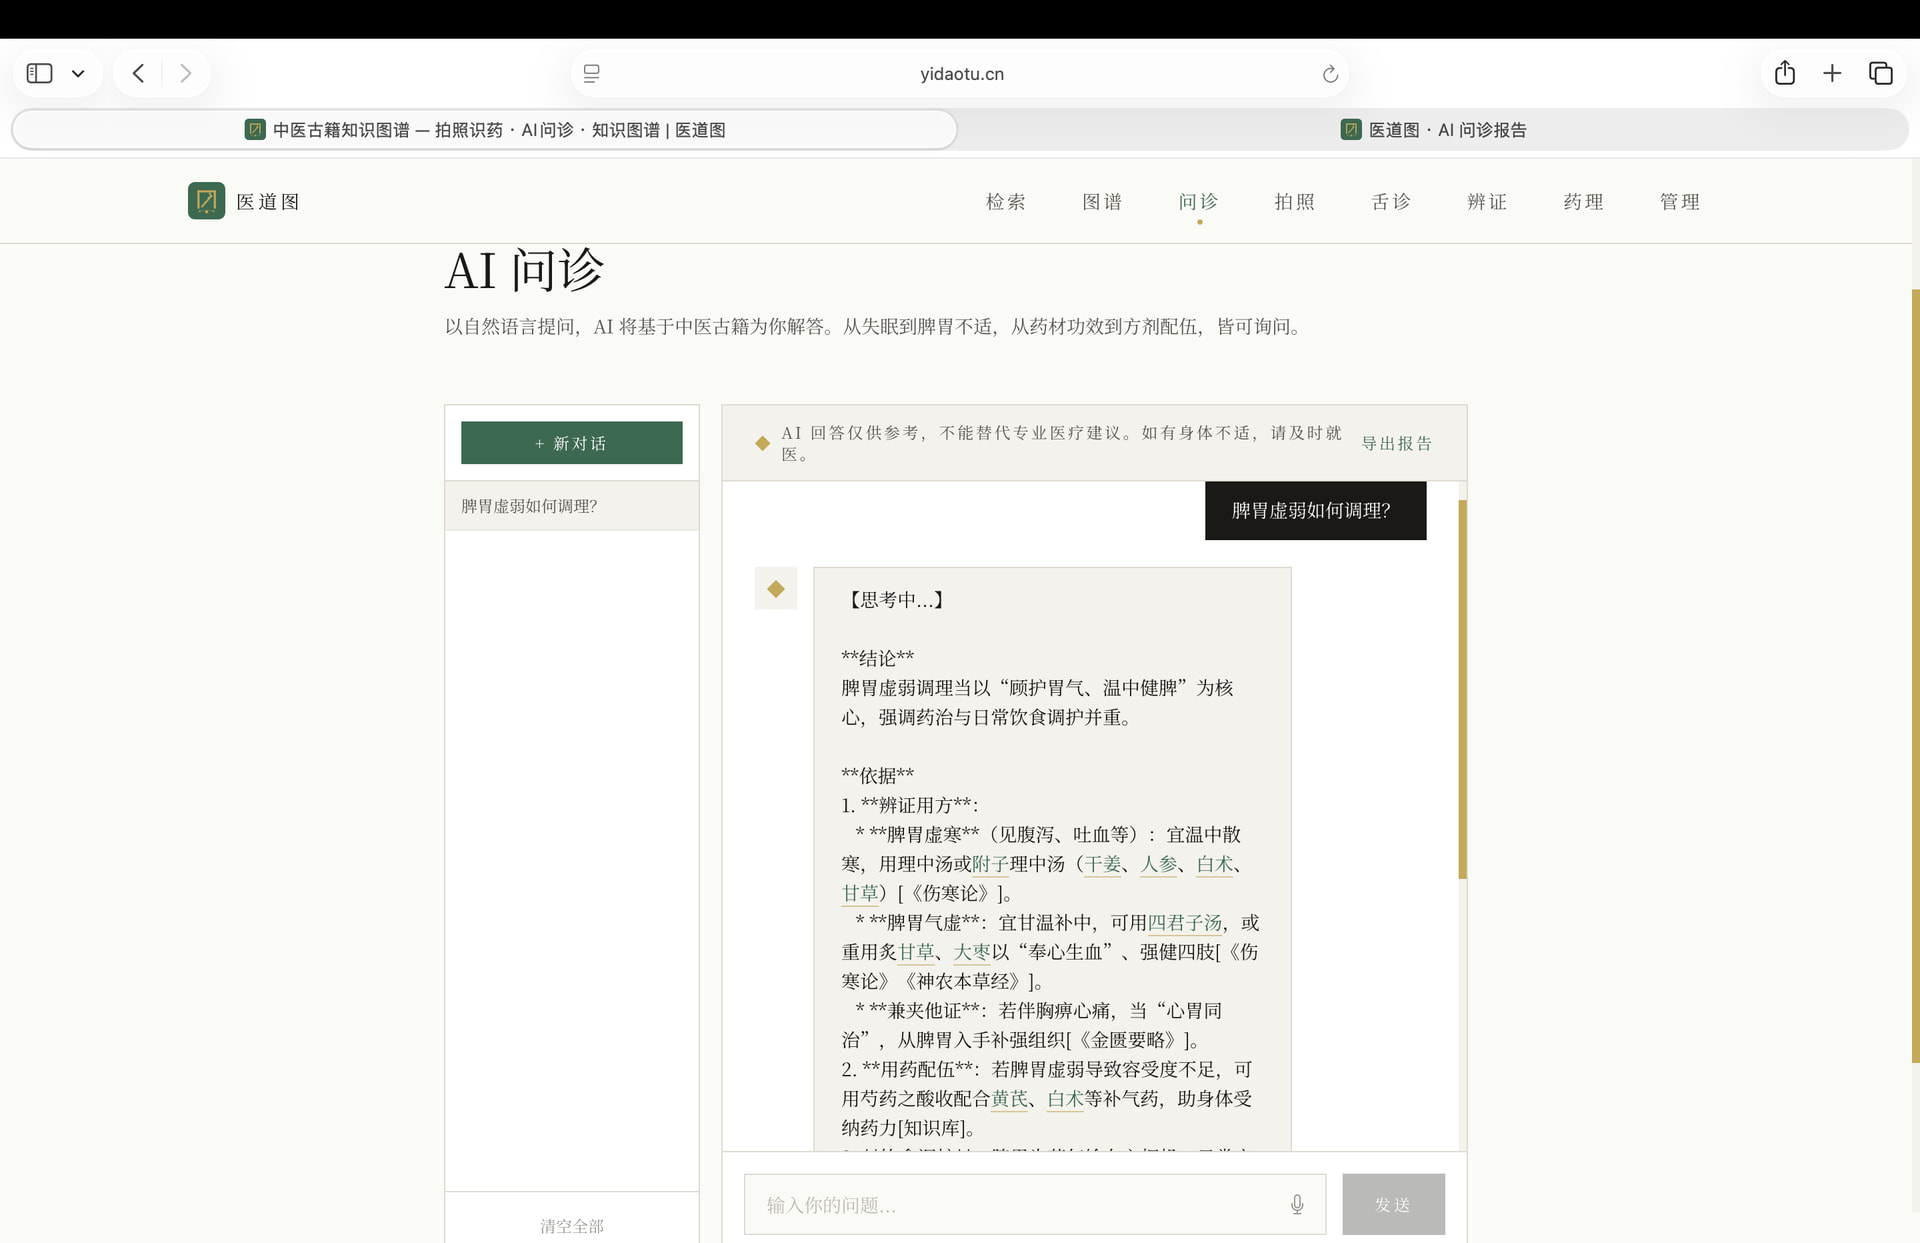
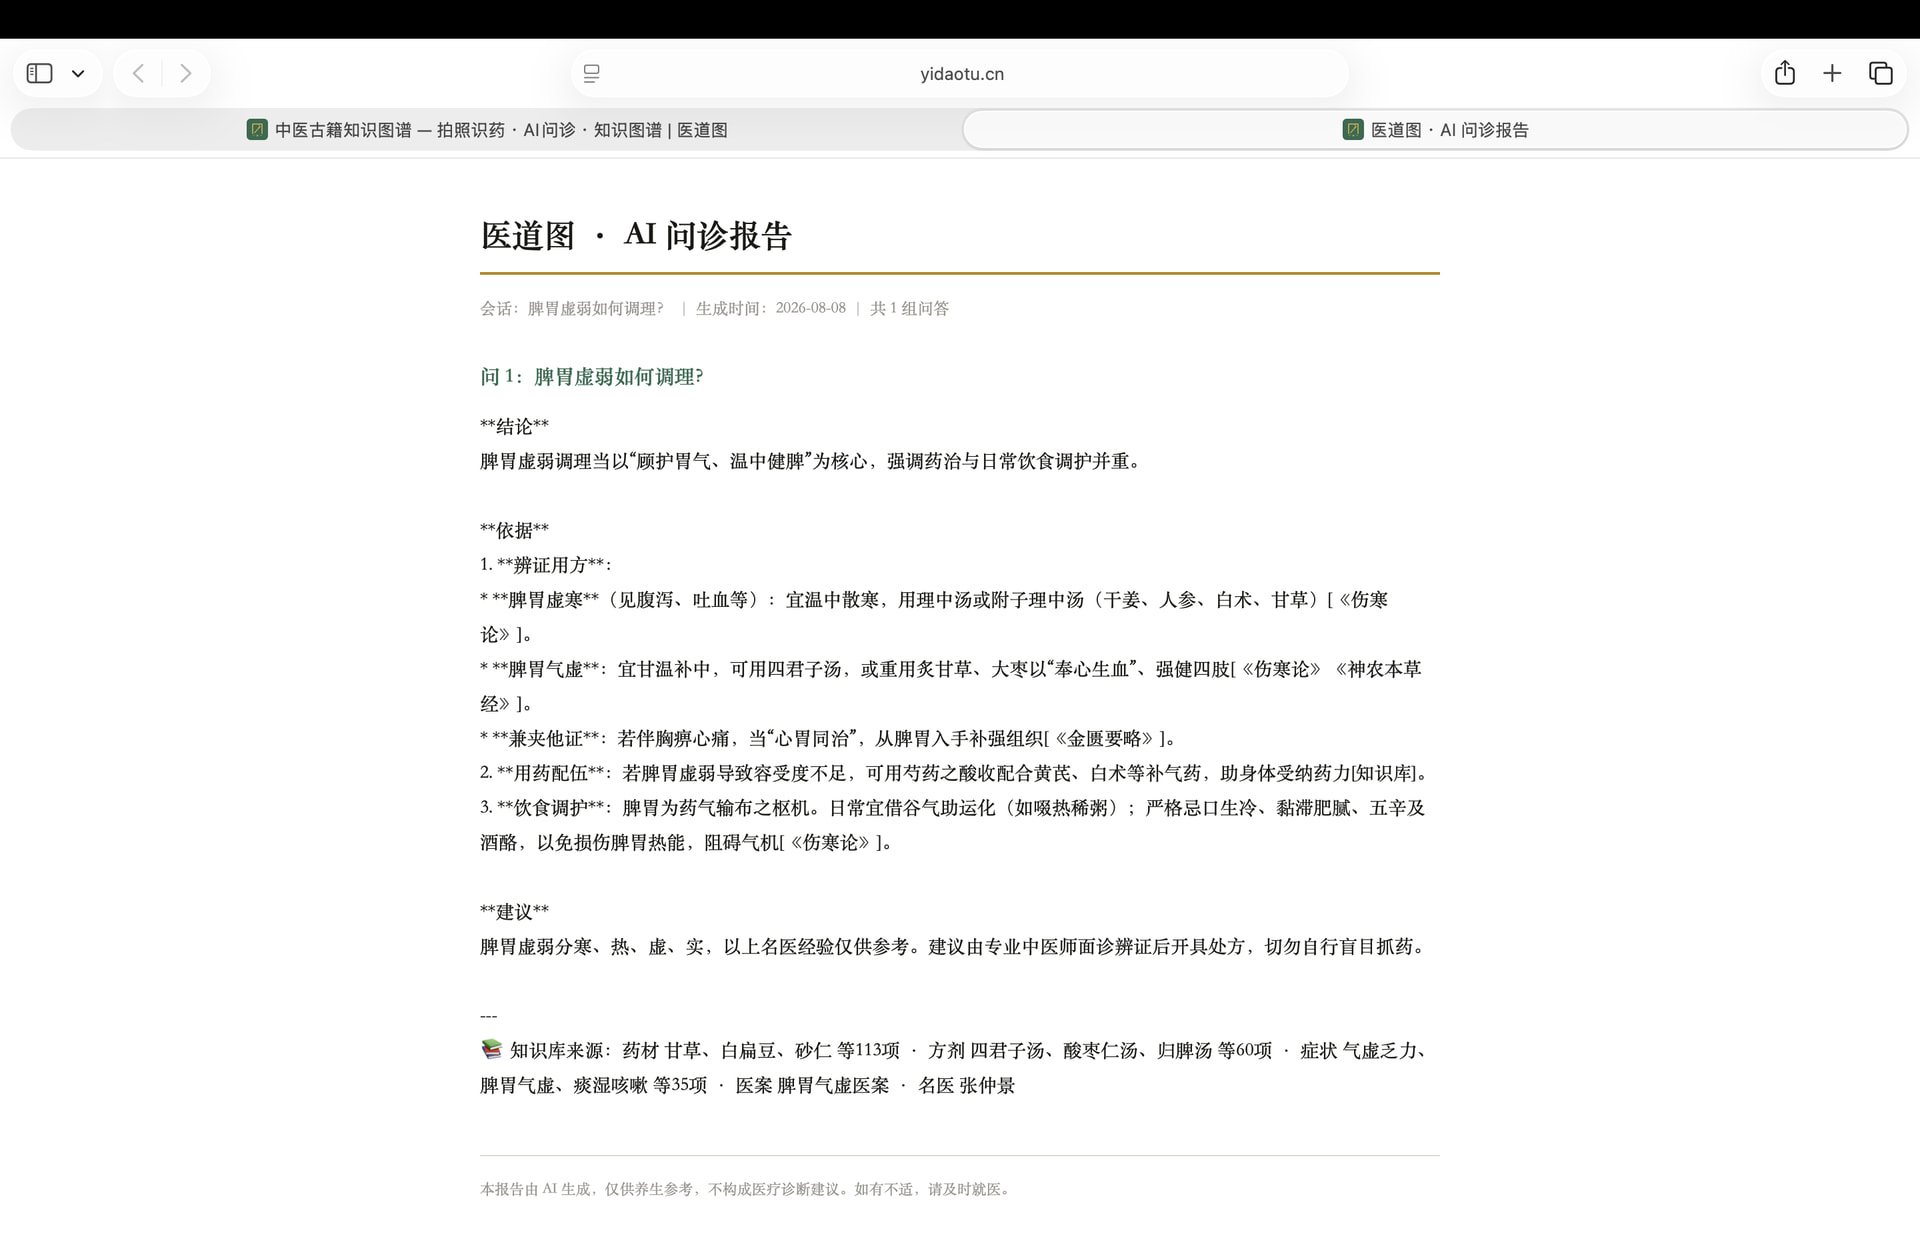
【插图 3:GraphRAG 回答及来源展示】
06|复赛最大升级:让知识库自己“长出来”
初赛结束以后,我一直在想一个问题:
如果所有知识都需要开发者手工整理,那么再漂亮的知识图谱,也很难真正覆盖浩如烟海的传统医学资料。
于是复赛阶段,我把主要精力放在了一个新的方向上:
名医知识蒸馏
用户可以向知识管理后台上传名医著作、医案、讲稿或整理后的文字资料。
AI 会从非结构化文本中自动识别和提取不同类型的知识。
医案
包括病例主题、症状、证候、辨证思路、治法、方剂、药材、效果、备注和资料来源。
用药规律
提取一位医家经常组合使用哪些药材、对应哪些方剂、主要应用于什么情况。
学术思想
提取作者的重要观点、理论认识和学术特色,并生成简要摘要。
这些结果不会只停留在一次 AI 回答里。
它们会进入医道图的结构化知识库,并继续参与 GraphRAG 检索。
于是形成:
上传一本资料
→ AI 阅读
→ 知识蒸馏
→ 结构化保存
→ 进入知识网络
→ GraphRAG 召回
→ AI 再利用
我认为这是医道图从初赛 Demo 走向复赛完整产品最重要的一步。
因为它让知识图谱开始拥有了持续生长的能力。
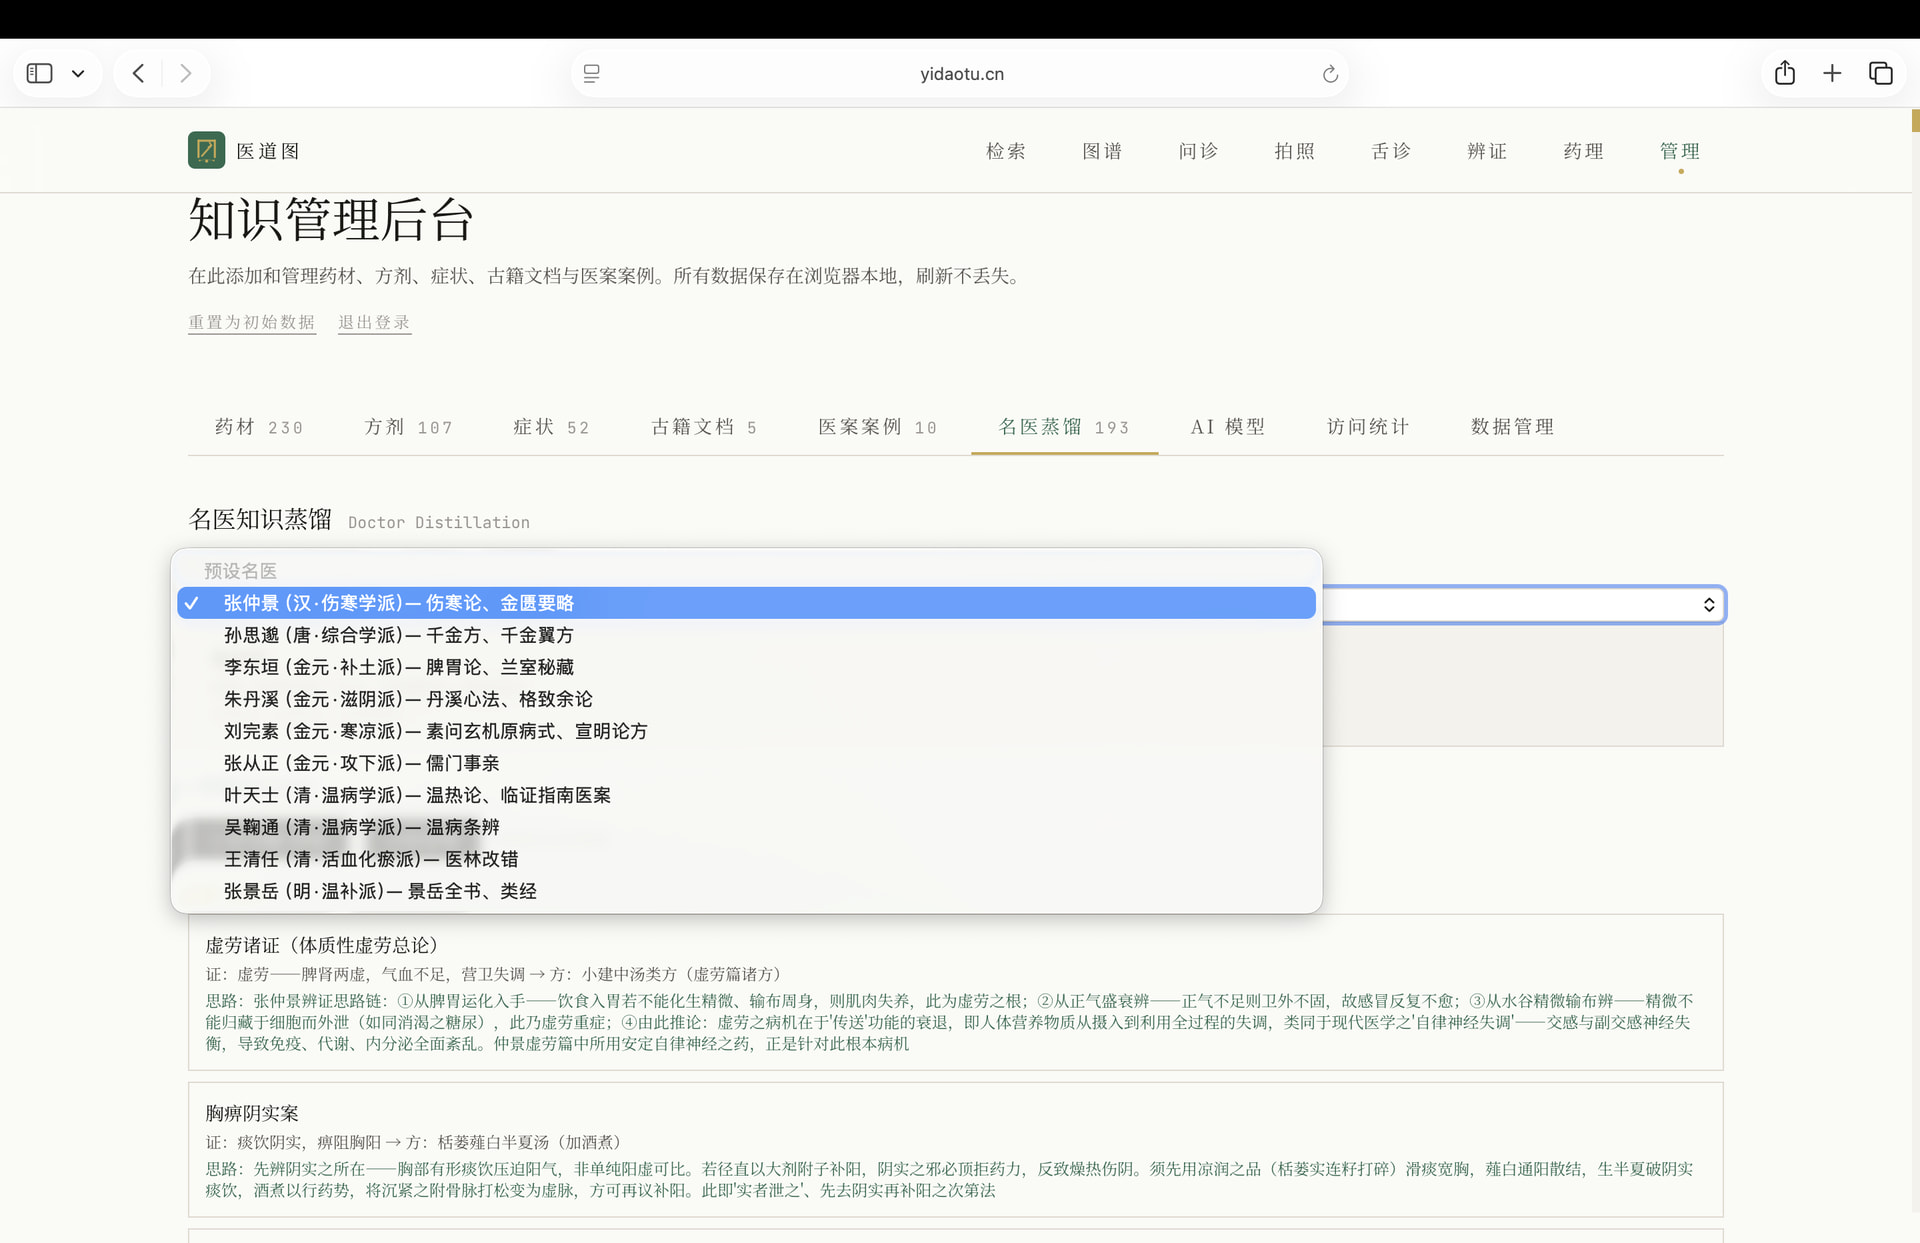
【插图 4:名医管理页面】
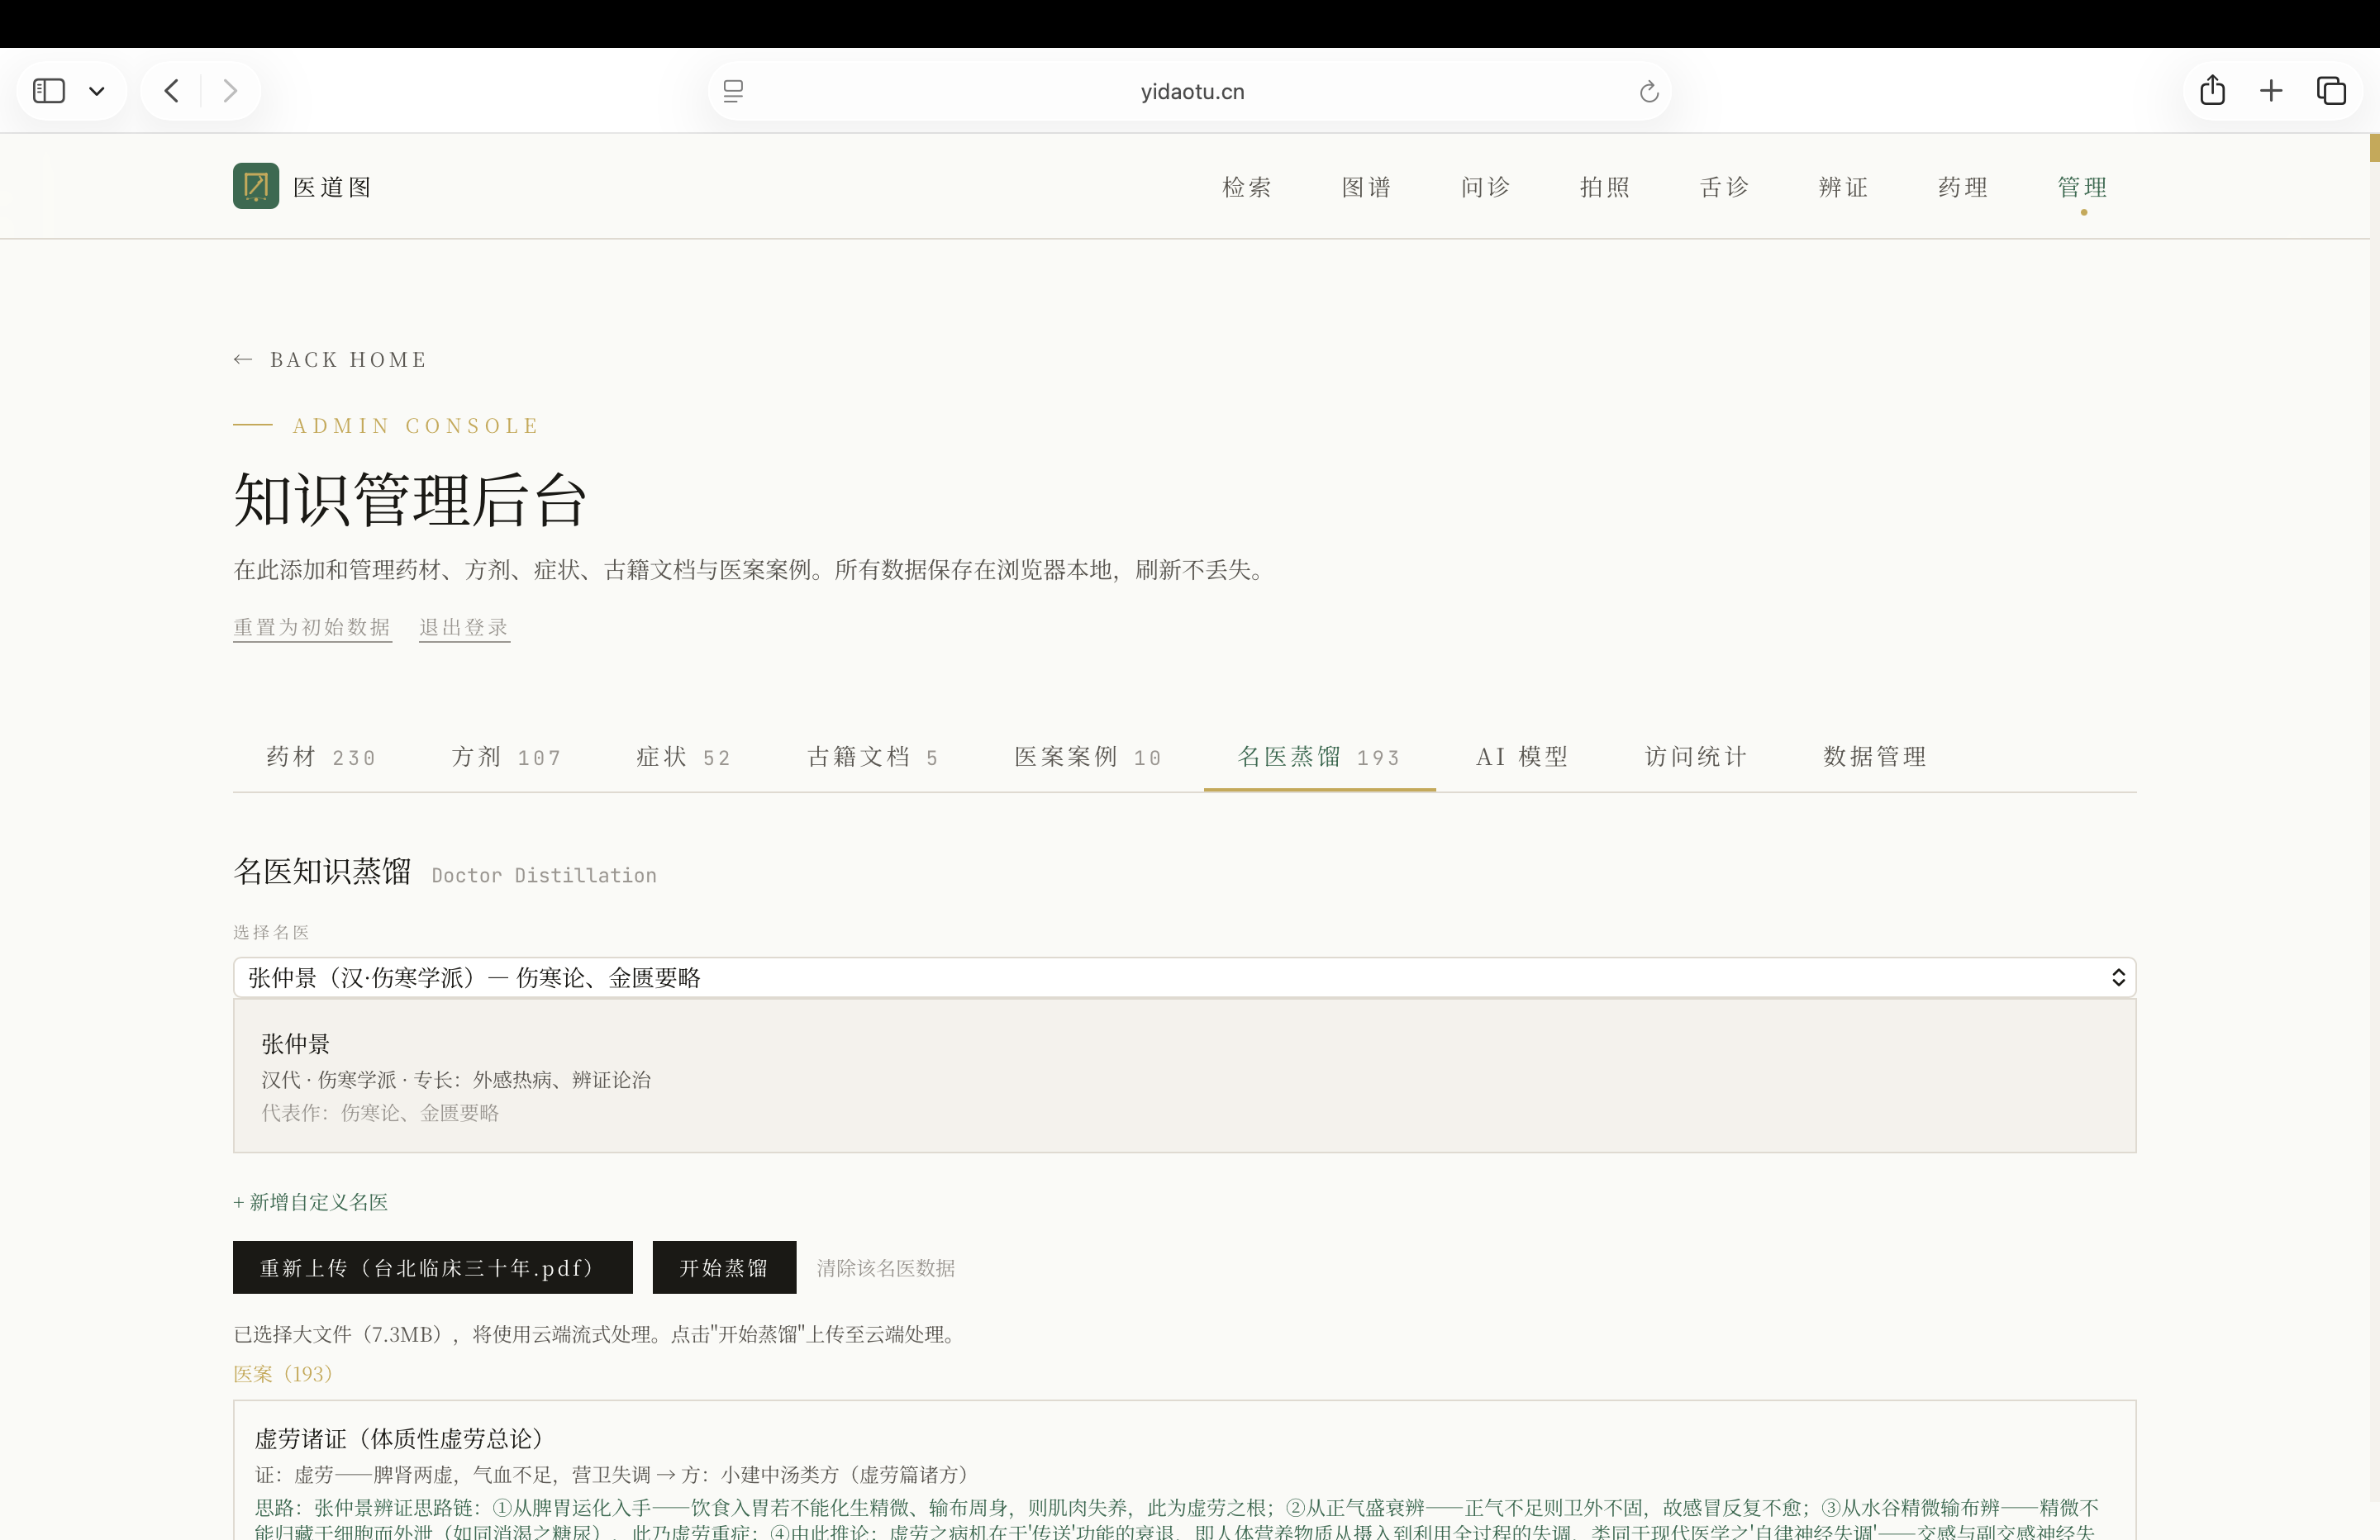
【插图 5:上传资料并进行知识蒸馏】
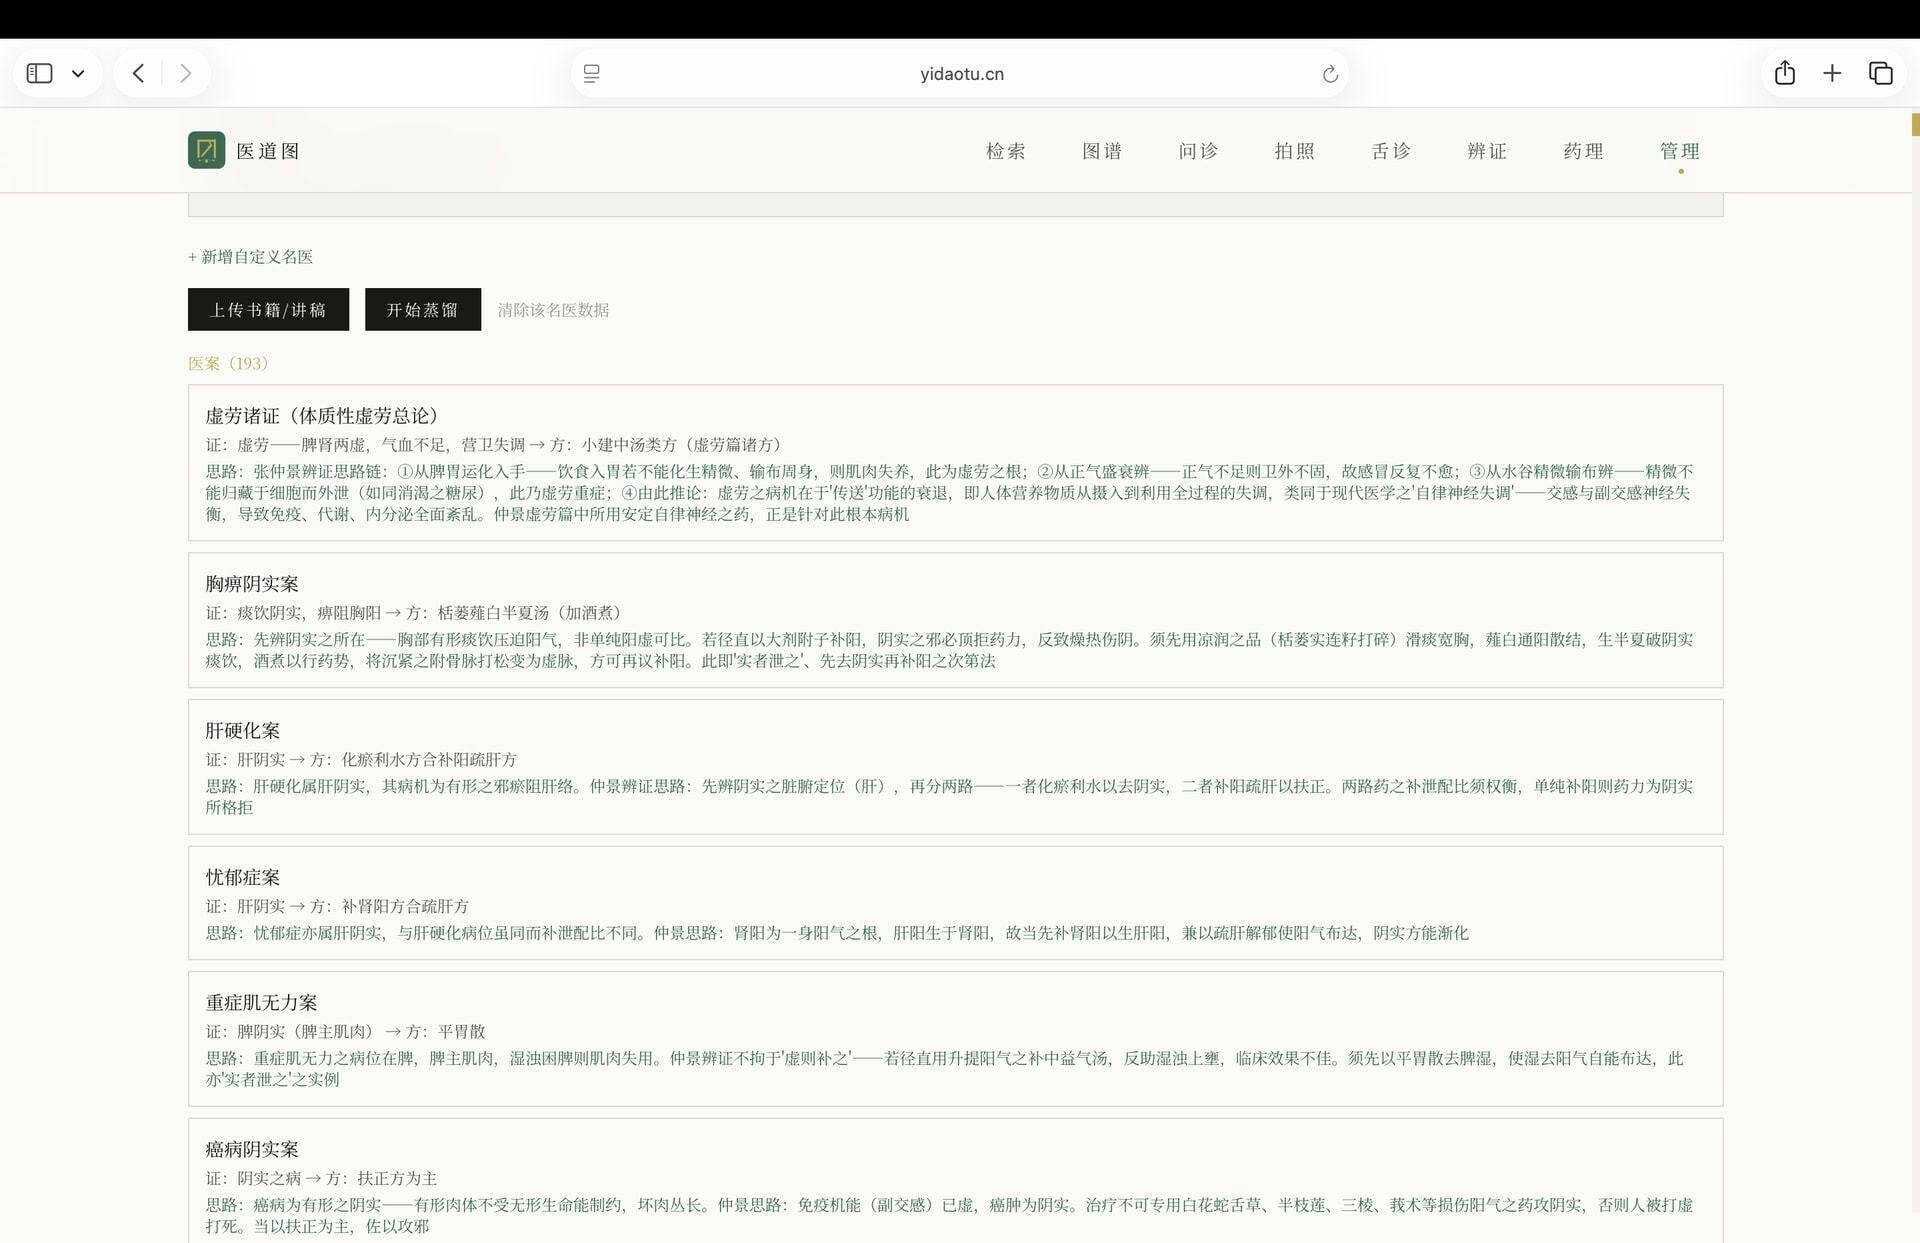
【插图 6:蒸馏出的医案 / 用药规律 / 学术思想】
07|为了真正“读完一本书”,重新做了一套大文件蒸馏链路
把几千字交给 AI 很容易。
真正困难的是:
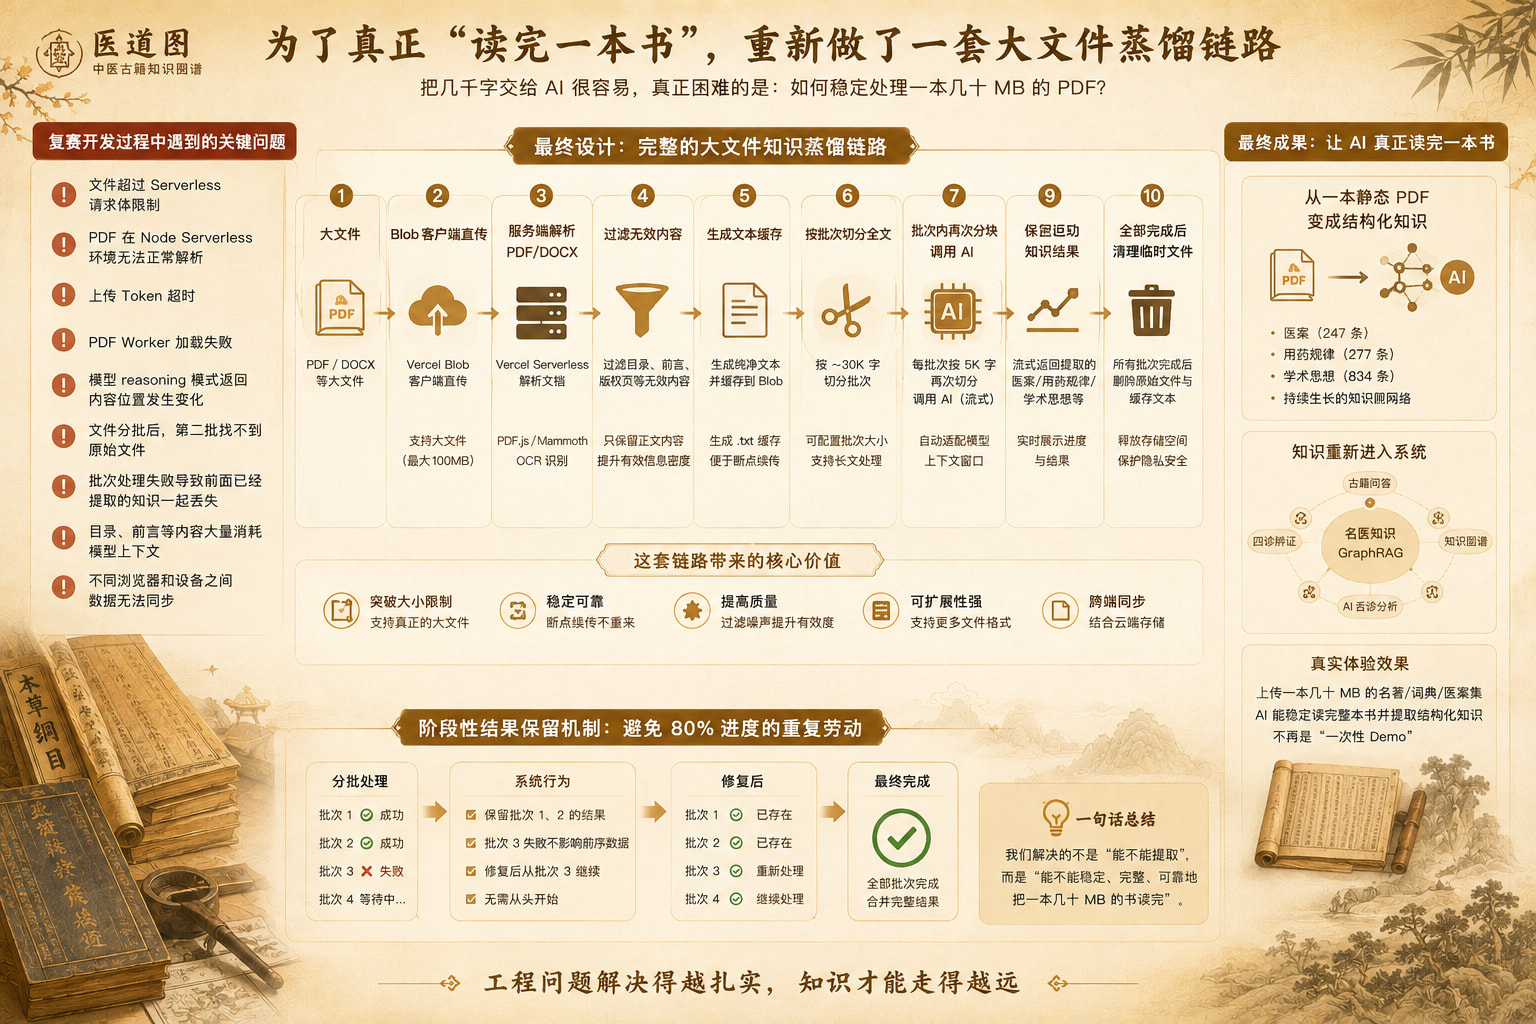
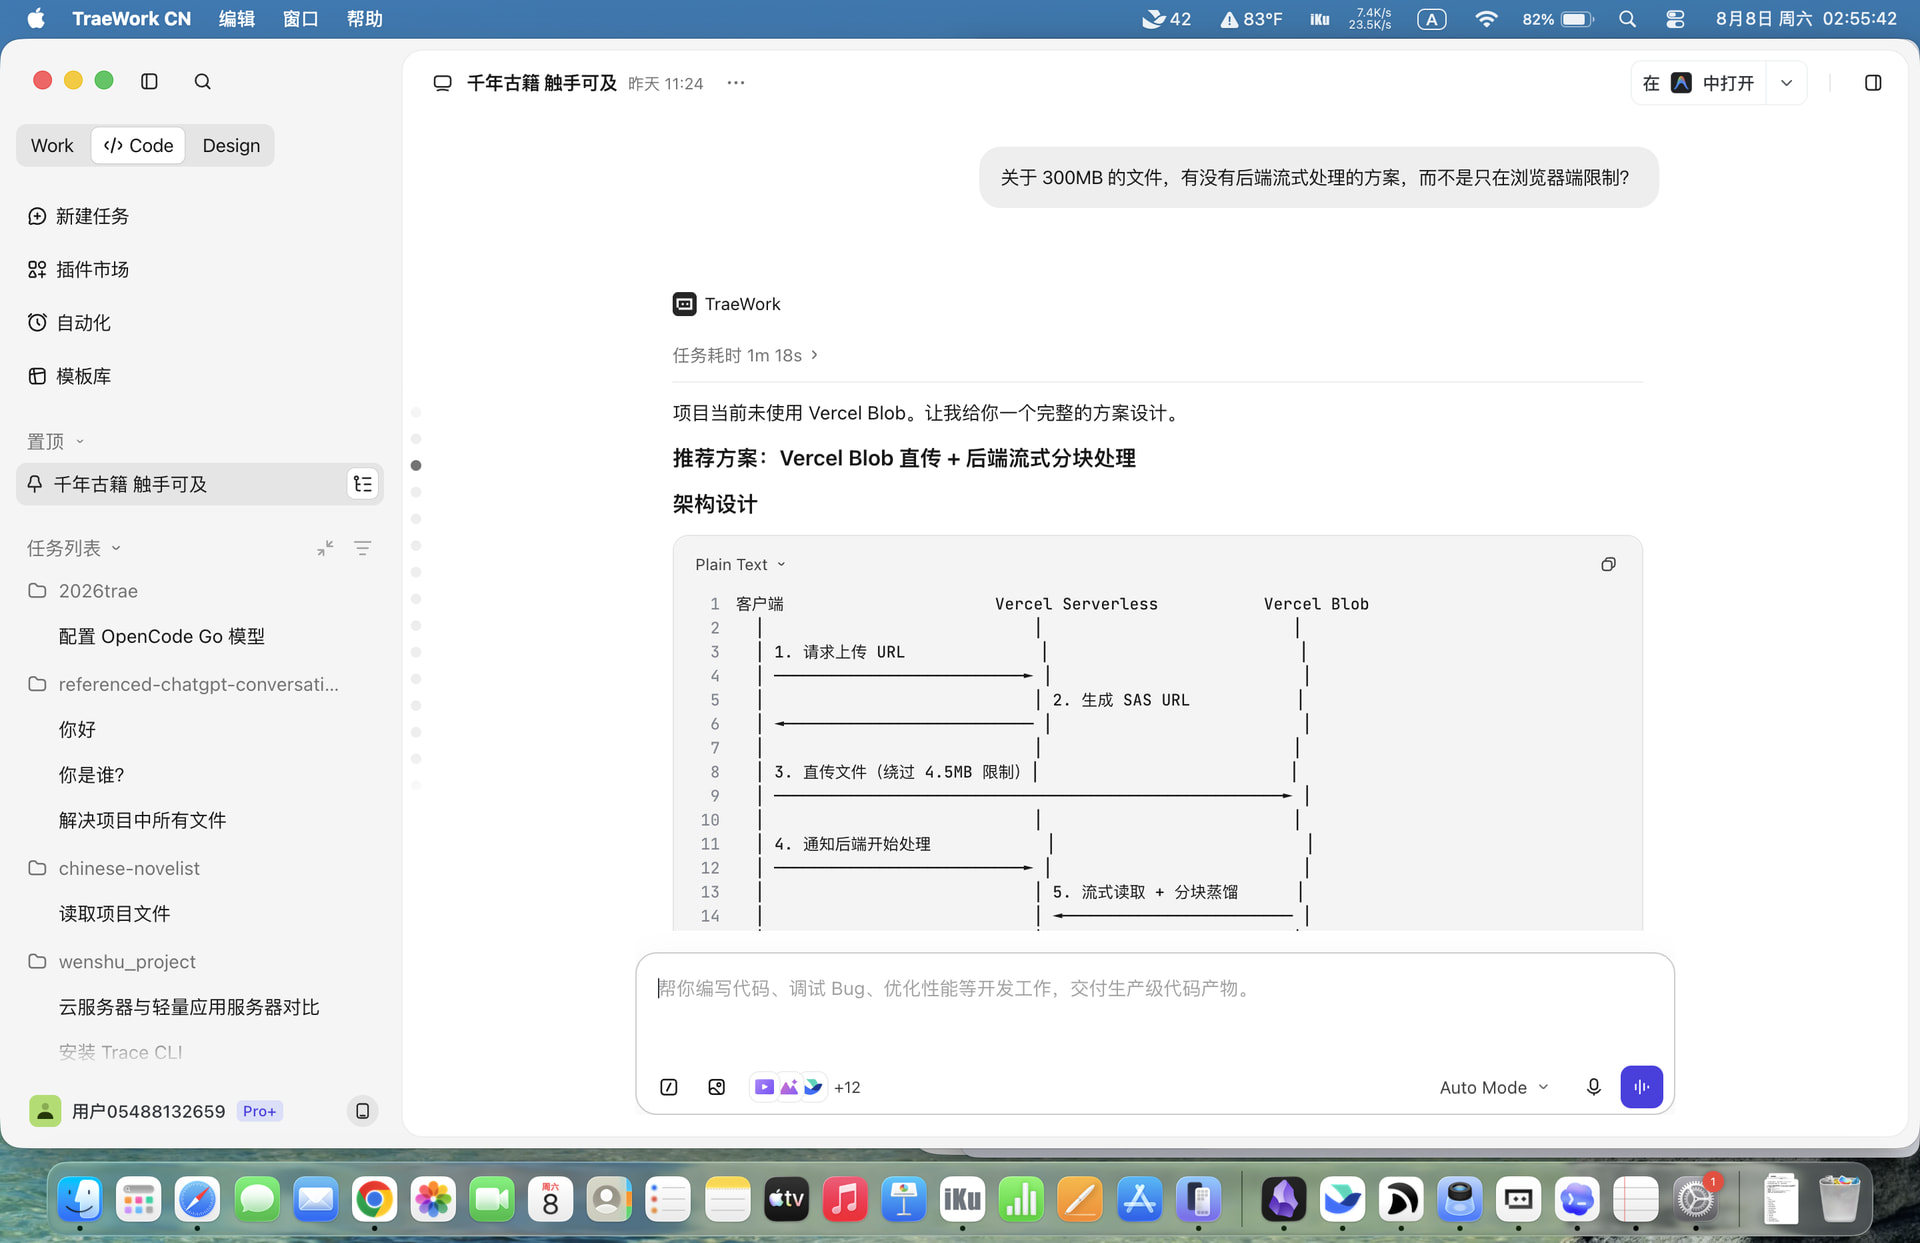
如何稳定处理一本几十 MB 的 PDF?
复赛开发过程中,我先后遇到了:
文件超过 Serverless 请求体限制;
PDF 在 Node Serverless 环境无法正常解析;
上传 Token 超时;
PDF Worker 加载失败;
模型 reasoning 模式返回内容位置发生变化;
文件分批以后,第二批找不到原始文件;
批次处理失败导致前面已经提取出来的知识一起丢失;
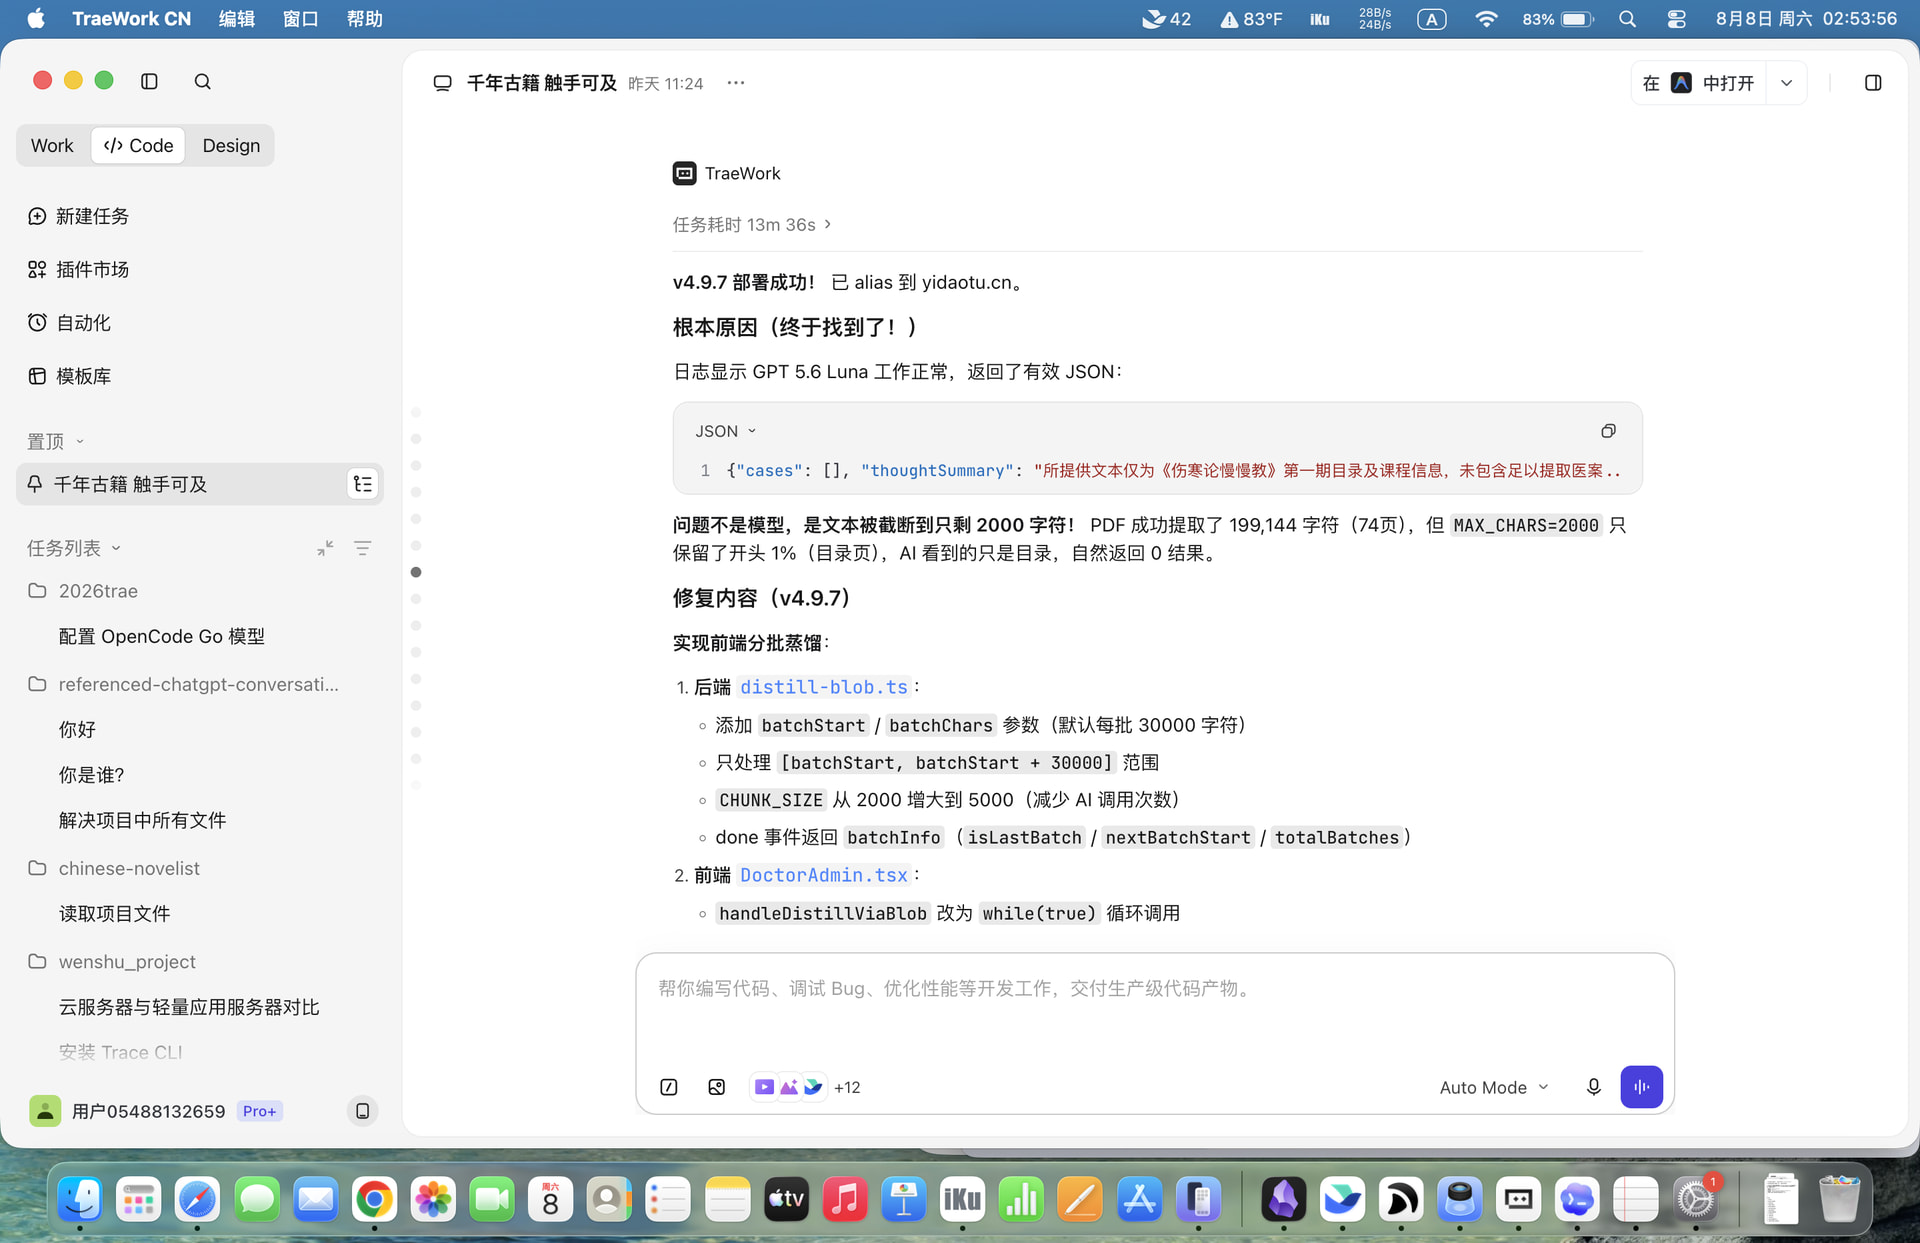
目录、前言等内容大量消耗模型上下文;
不同浏览器和设备之间数据无法同步等问题。
最终重新设计了一条完整的大文件处理链路:
大文件
↓
Vercel Blob 客户端直传
↓
服务端解析 PDF / DOCX
↓
过滤目录、前言等无效内容
↓
生成文本缓存
↓
按照批次切分全文
↓
批次内部再次分块调用 AI
↓
流式返回知识结果
↓
保留已经成功完成的批次
↓
全部完成后再清理临时文件
为了避免一本书处理到 80% 时因为某一批失败而全部重来,系统还加入了阶段性结果保留机制。
这些看起来不是产品首页最显眼的功能,却是我在复赛阶段投入最多时间解决的问题之一。
因为只有真正解决这些工程问题:
“上传一本书,让 AI 读完它”才不再是一句 Demo 演示词。
08|名医知识不只是存起来,还真正进入 AI 推理上下文
知识蒸馏完成以后,新的问题又出现了:
蒸馏出来几百条医案,如果只是放在后台列表里,又有什么意义?
因此在后续版本中,我继续改造 GraphRAG。
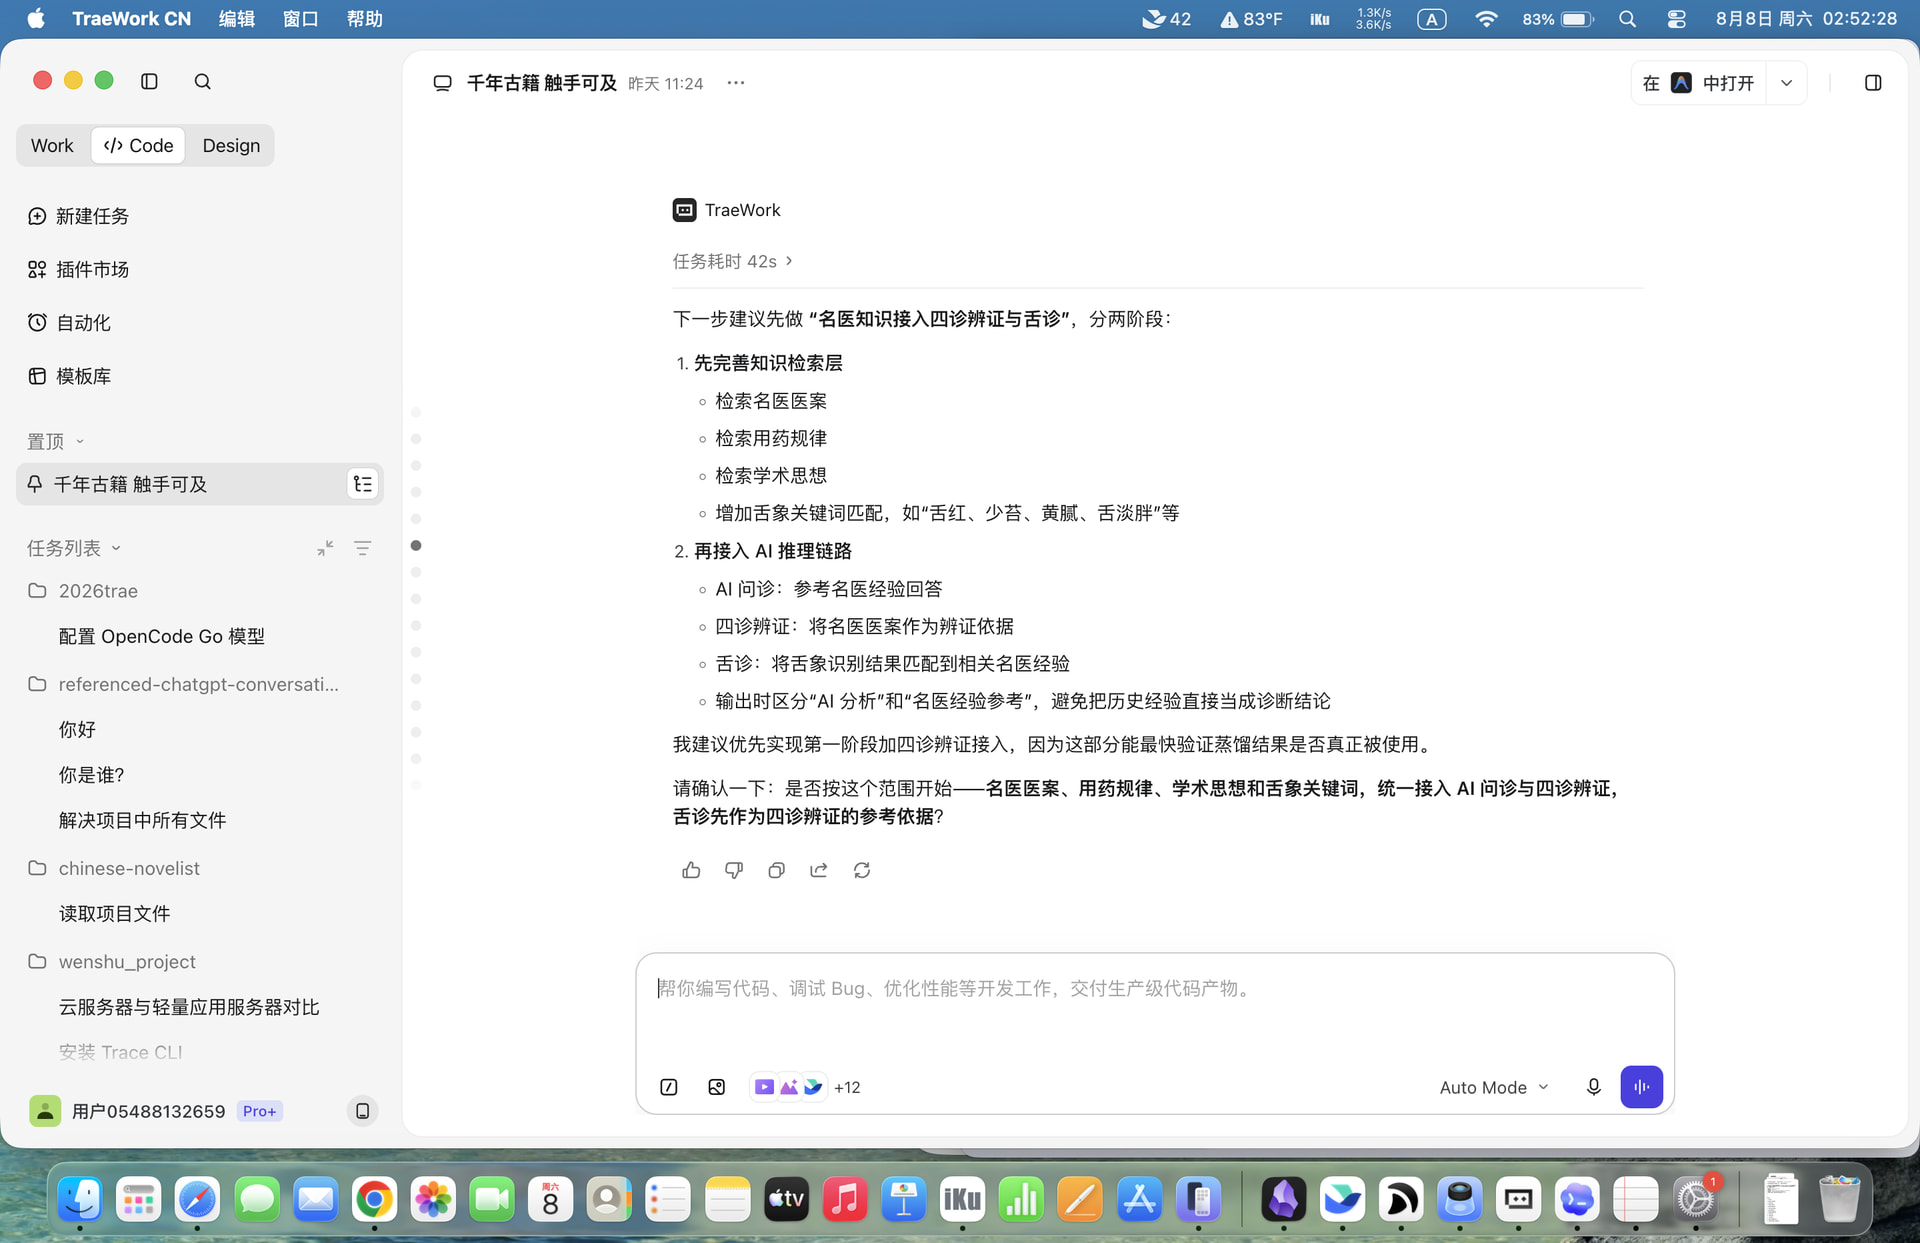
现在名医知识已经能够参与:
古籍智能问答
四诊辨证学习
舌象知识分析
GraphRAG 会根据当前问题召回相关名医知识,并在上下文中区分:
当前用户提供的信息
与
历史医案和名医经验
系统同时要求 AI 标注对应名医和资料来源,尽量避免把历史案例直接描述成当前用户的医学结论。
我希望它做到的不是:
“因为某位名医这么说,所以答案一定正确。”
而是:
“这里有一条相关的历史经验,你可以看到是谁提出的、来自什么资料,并结合古籍继续理解。”
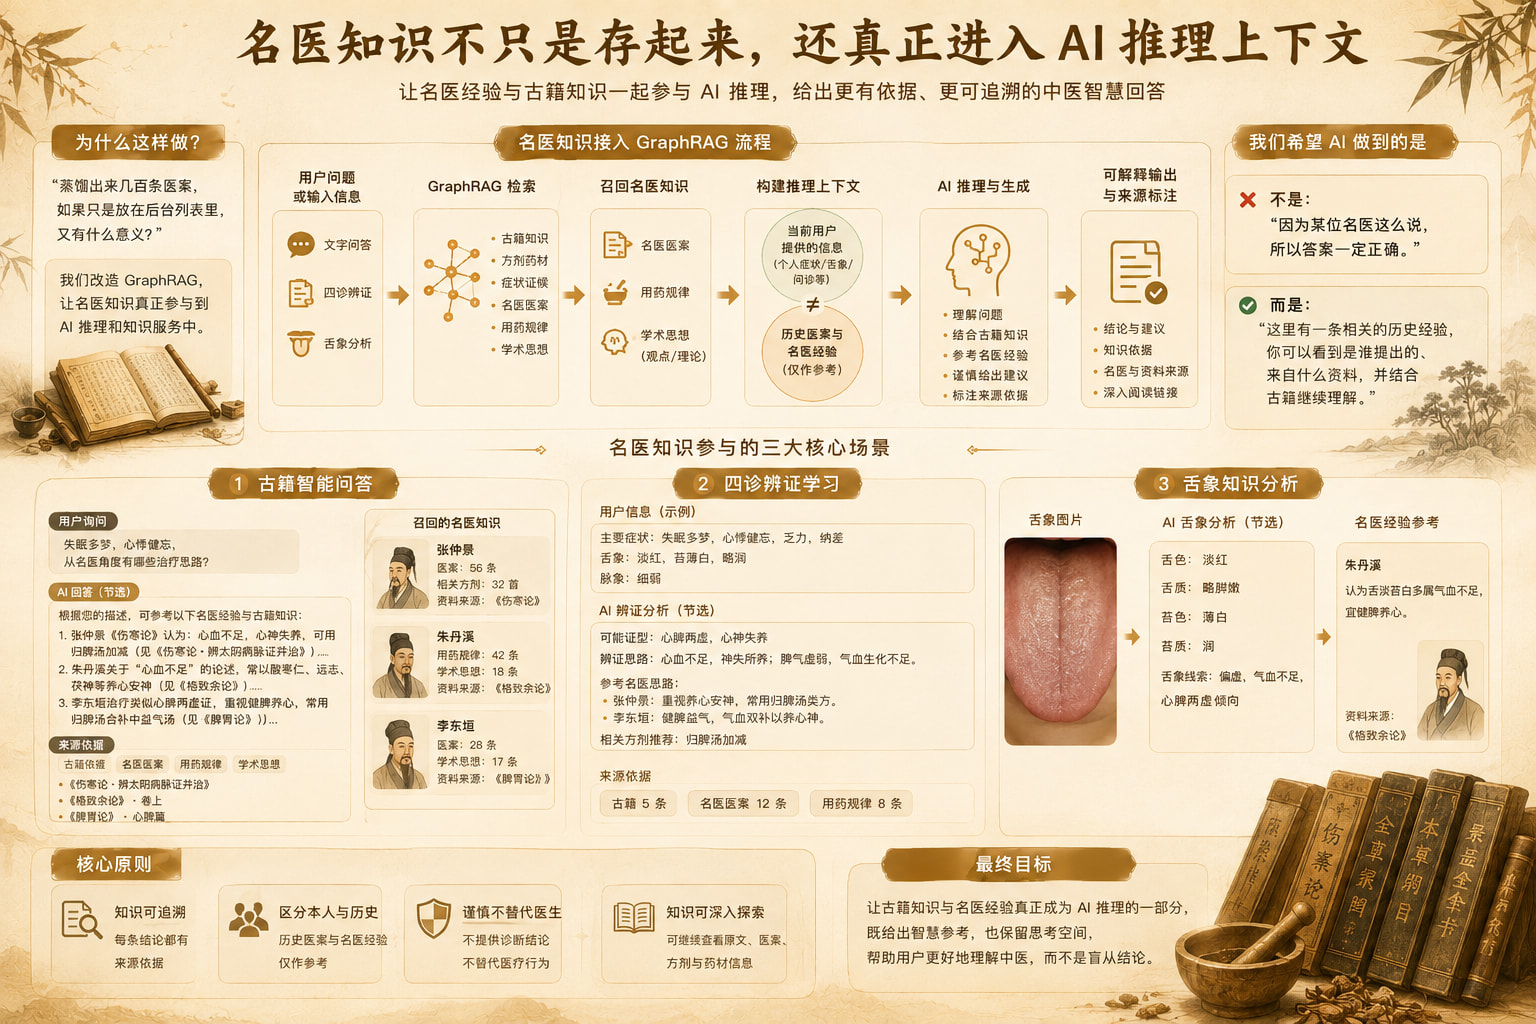
【插图 7:AI 回答中的名医知识来源】
09|AI 舌象知识分析:让多模态信息进入知识网络
复赛阶段还新增了 AI 舌象分析能力。
用户上传舌象图片后,视觉模型从多个维度进行结构化观察,包括:
舌色、舌形、苔色、苔质、润燥、舌神、苔分布、舌面分区及相关知识线索。
这些结果不会孤立存在。
系统可以把结构化后的舌象信息继续传给 GraphRAG,检索相关古籍知识与名医资料,再生成解释性内容。
于是医道图的 AI 输入开始从单一文本扩展为:
文字 + 图像 + 结构化信息 + 古籍知识 + 名医经验
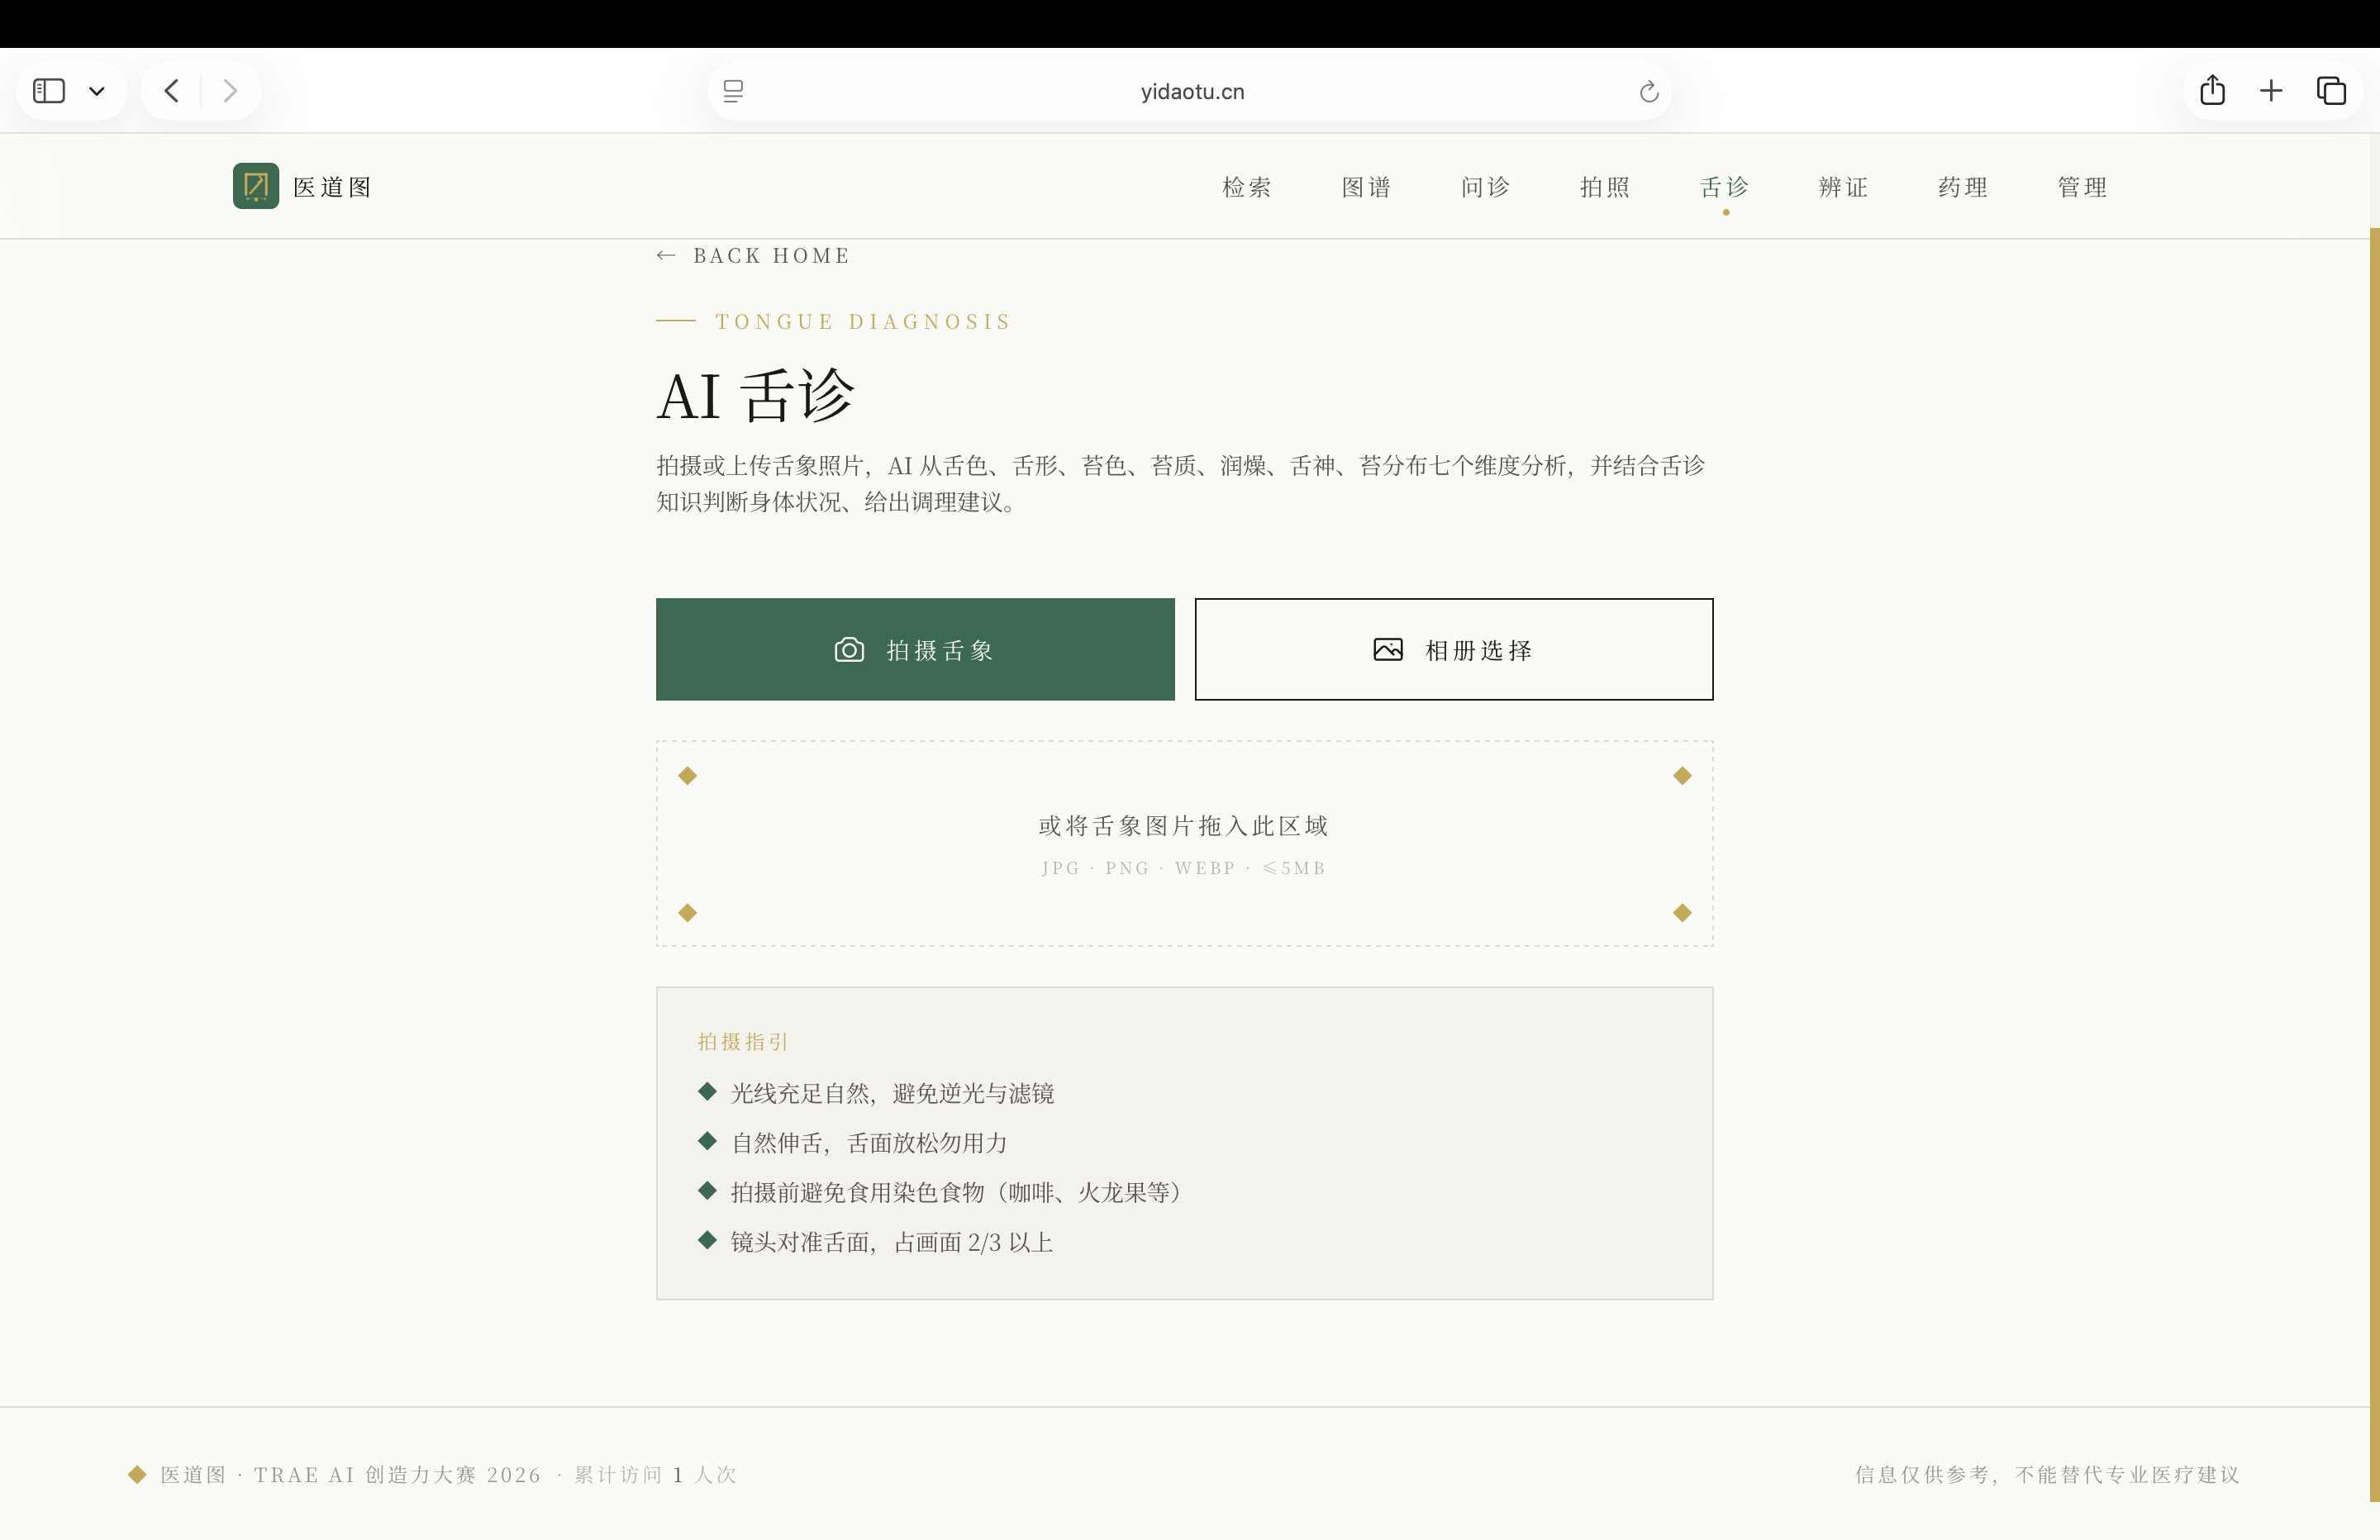
【插图 8:AI 舌象分析页面】
10|四诊辨证学习
初赛阶段我已经实现了四诊信息的结构化采集。
复赛继续优化以后,用户可以围绕寒热、汗出、饮食、睡眠、二便、疼痛、舌象、脉象等信息进行整理。
系统再通过知识检索和 AI 帮助梳理:
证候方向 → 辨证思路 → 相关治法 → 方证关联 → 古籍或名医参考
这里我特别强调:
这一功能用于中医知识学习和辨证思路展示,不替代医生诊疗。
我更希望通过这种方式让学习者理解:
为什么不同的信息之间会产生不同的中医辨证联系。
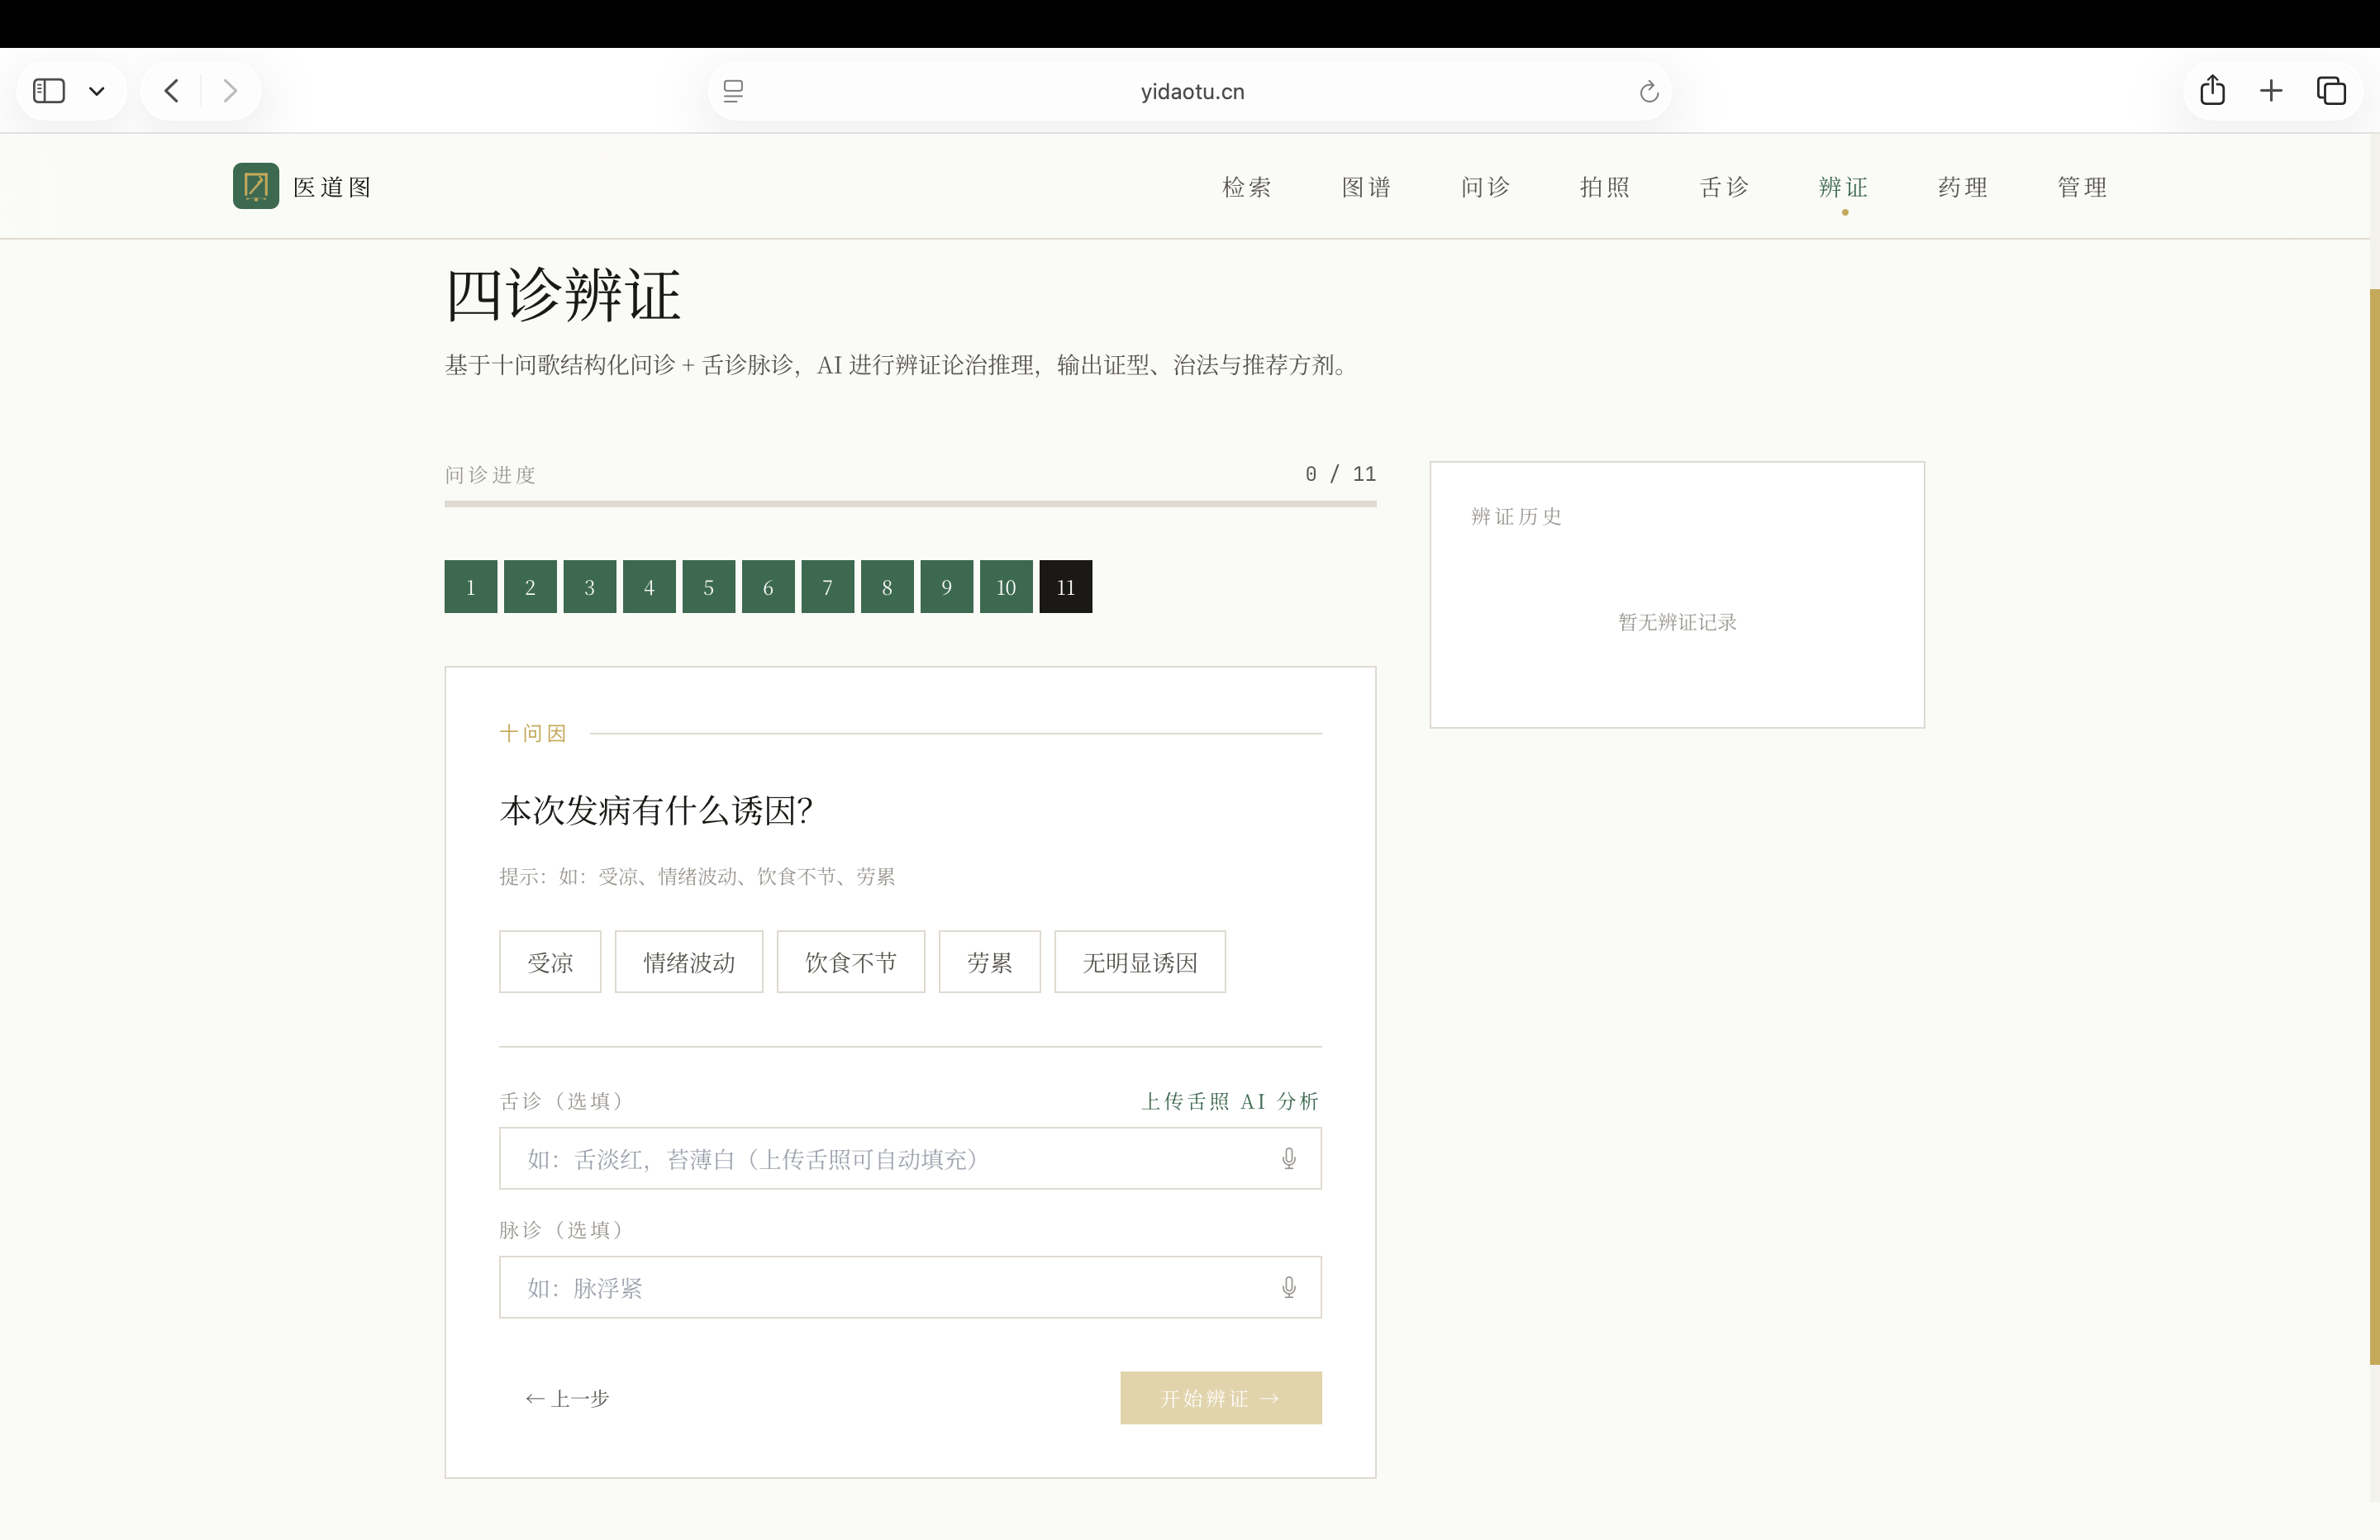
【插图 9:四诊信息采集】
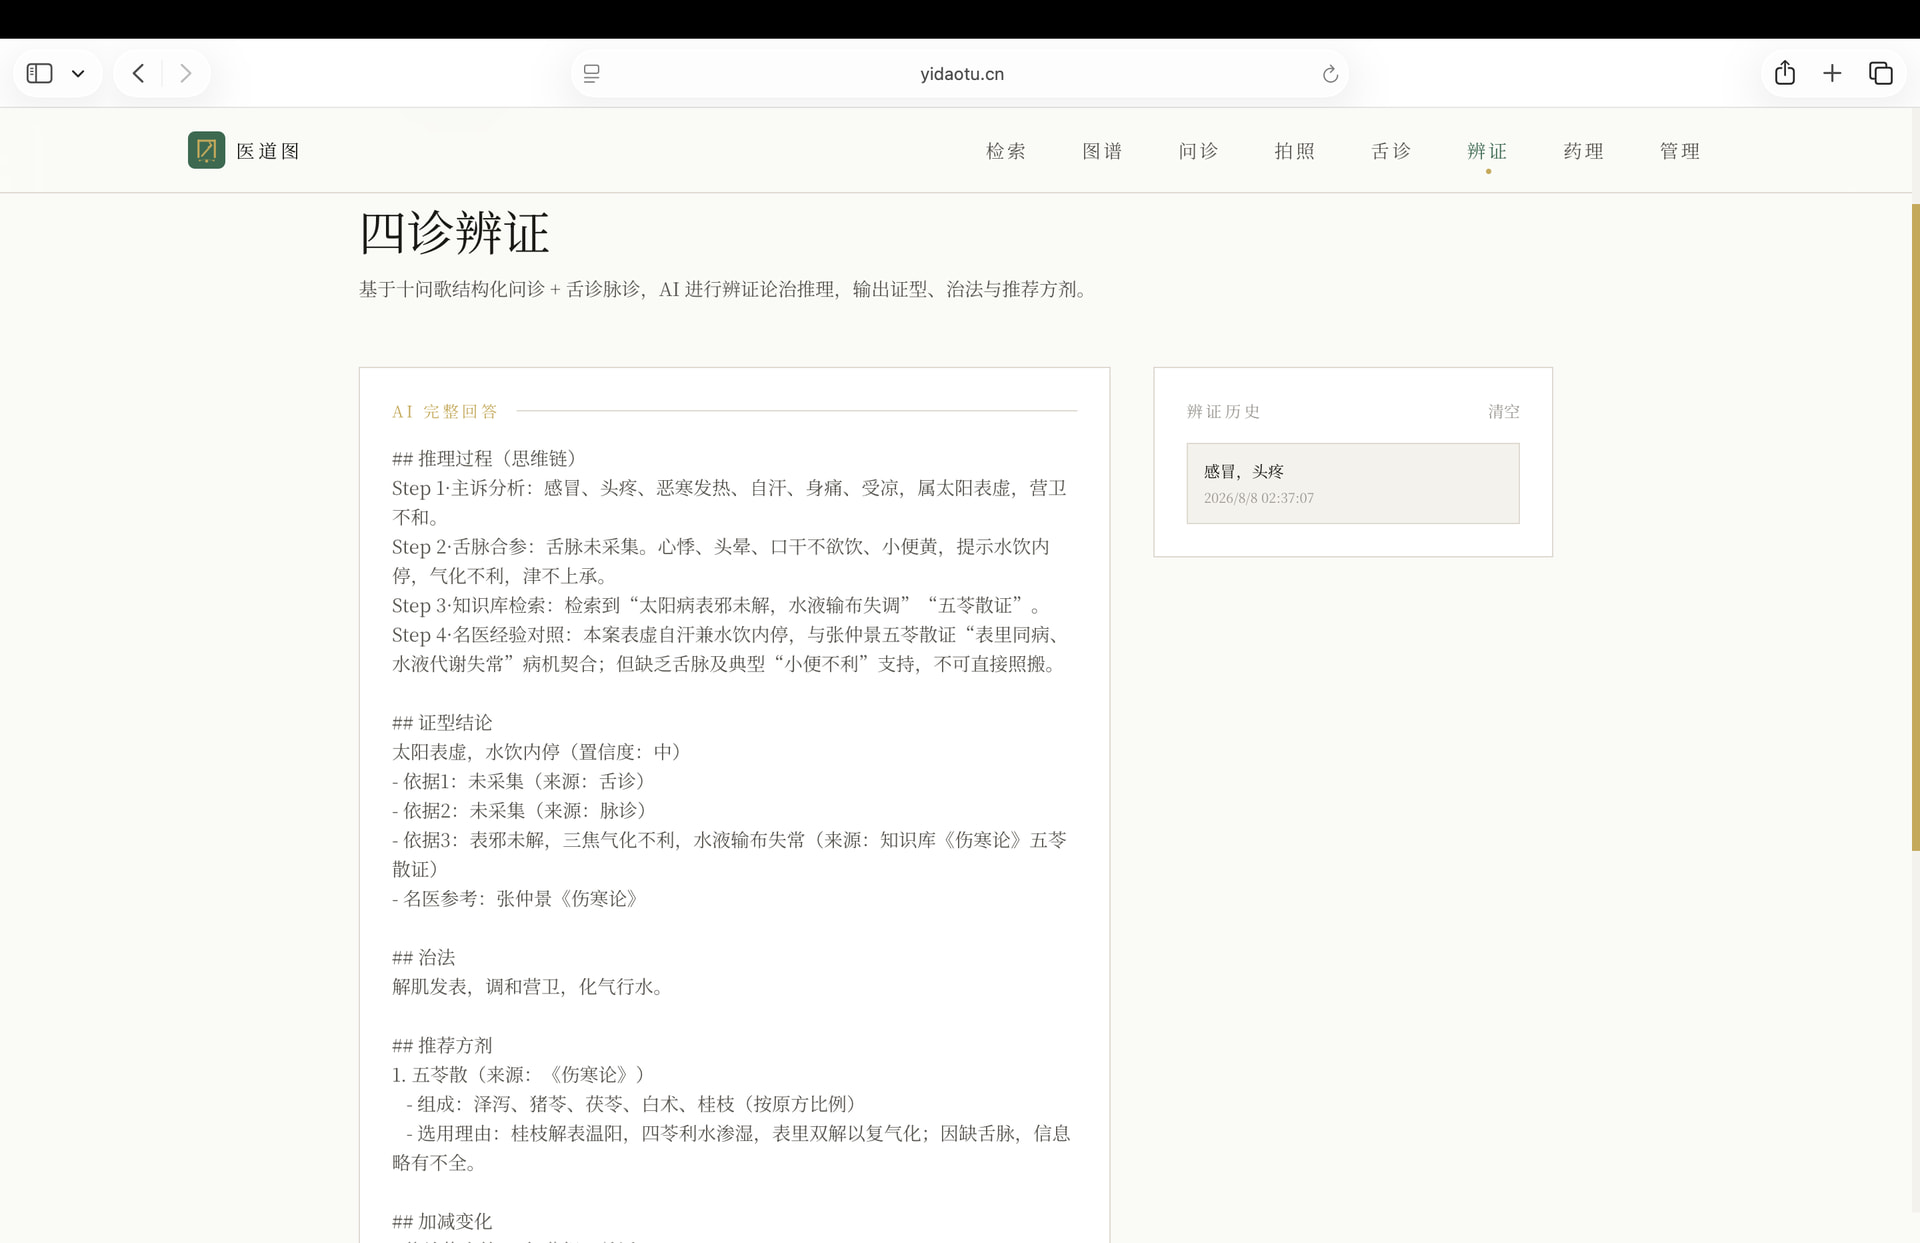
【插图 10:辨证学习结果及知识依据】
11|拍照识药材
用户可以直接上传或拍摄药材图片。
视觉模型识别后,系统进一步展示:
药材名称
性味归经
主要功效
相关方剂
古籍记载
知识图谱关联
它并不是一个孤立的“看图识物”功能。
识别结果可以继续进入知识图谱:
一张药材照片 → 一个药材节点 → 相关方剂 → 对应古籍 → 延伸知识
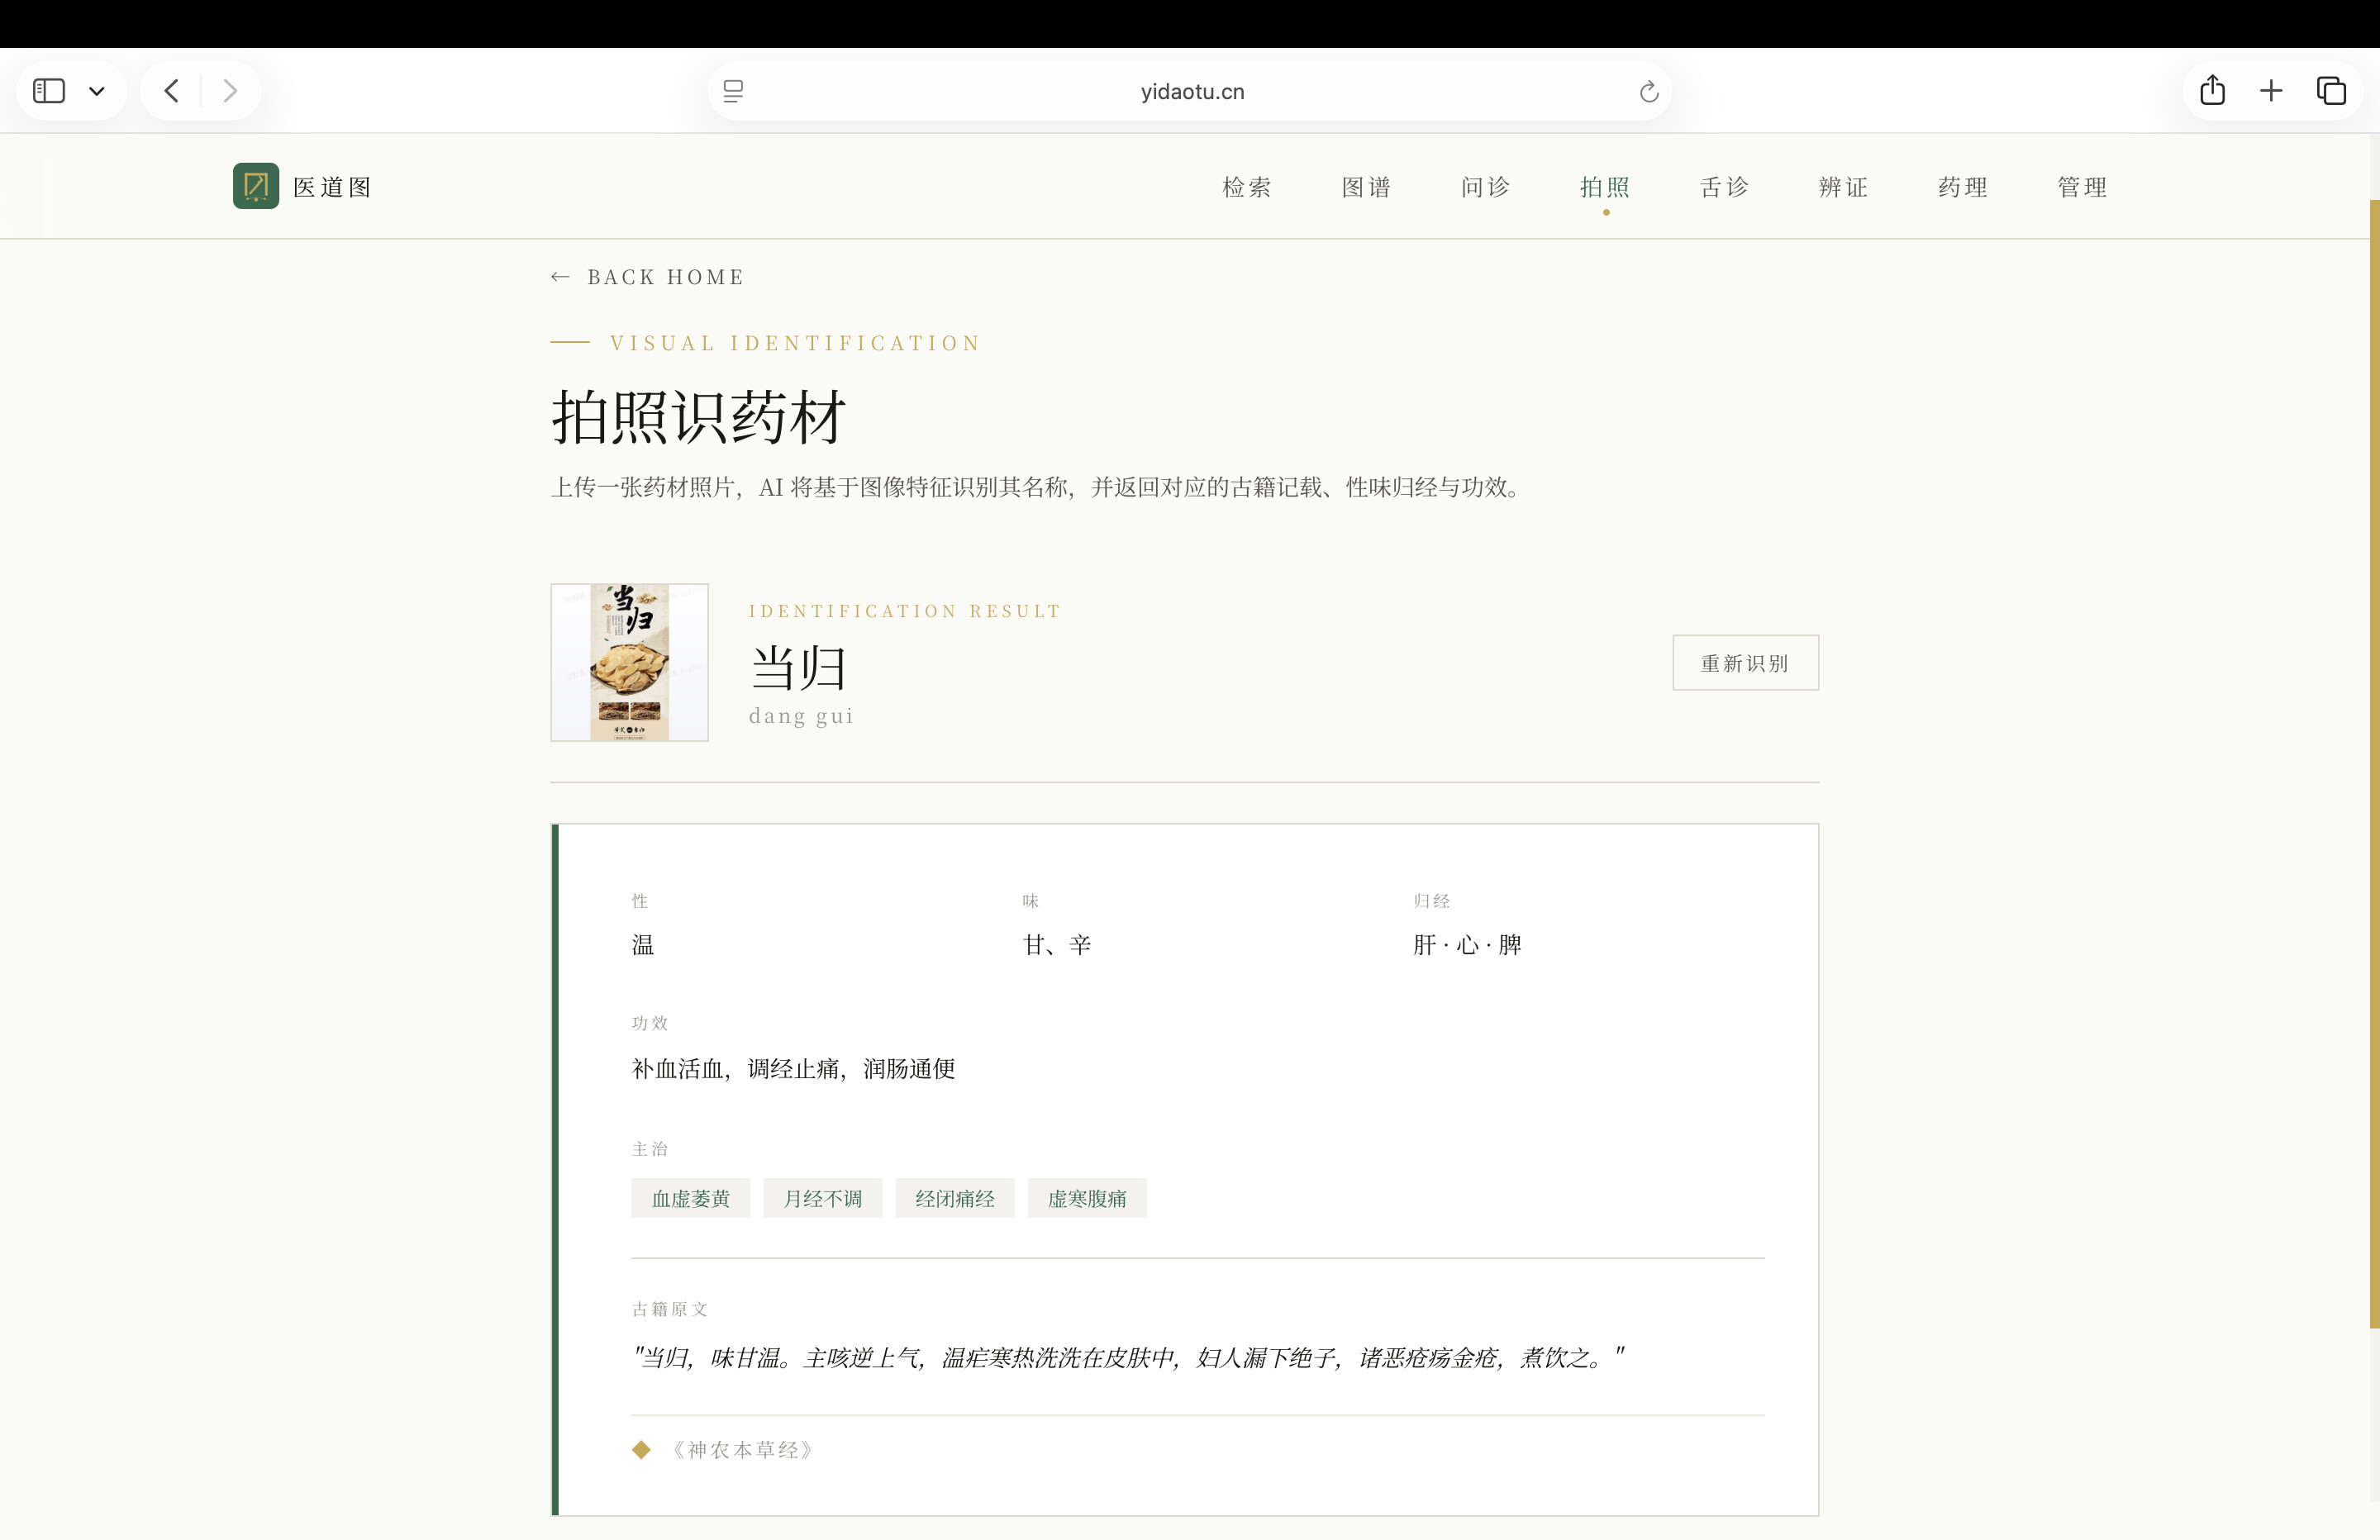
【插图 11:拍照识药材】
12|从初赛 Demo 到复赛完整产品,我到底做了什么?
初赛时,我给自己的目标是:
证明“知识图谱 + GraphRAG + 中医古籍”这条路能够跑通。
复赛阶段,我给自己的目标变成了:
让它成为一个真正能够持续使用、持续扩充知识的产品。
| 初赛 Demo | 复赛完整作品 |
|---|---|
| 药材、方剂、症状、古籍基础知识图谱 | 扩展到医案、名医、用药规律、学术思想、舌象知识 |
| GraphRAG 验证核心链路 | GraphRAG 接入古籍 + 名医知识 |
| 内置知识为主 | 支持用户上传资料持续扩充 |
| 普通知识管理 | AI 名医知识蒸馏 |
| 小文件结构化提取 | 大文件 Blob 直传 + 分批蒸馏 |
| 单设备本地数据为主 | 名医知识云端跨设备同步 |
| 基础文本交互 | 文本 + 图片 + 舌象等多模态信息 |
| AI 回答古籍问题 | AI 回答同时召回古籍和名医经验 |
| Demo 能运行 | 面向真实使用场景持续处理稳定性问题 |
项目也从初赛上线时的 v3.5.0,继续经历了 v4.8.x、v4.9.0 一直到当前 v4.9.12 的连续迭代。
复赛期间最密集的一系列更新几乎都围绕一个问题:
如何让知识真正持续进入系统,并可靠地留下来。
13|当前已经积累的动态知识
随着名医知识蒸馏和跨设备同步功能上线,目前系统云端已经实际保存了数百条结构化知识。
包括:
247 条名医医案
277 条用药规律
834 条学术思想
这些知识不是为了展示一个漂亮数字。
真正重要的是:
它们已经能够重新进入 GraphRAG,被古籍问答、辨证学习和舌象分析调用。
因此系统内部形成了一个闭环:
资料进入 → AI 提取 → 知识沉淀 → 图谱关联 → AI 再使用
这也是我认为医道图与普通“上传 PDF 然后聊天”的 AI 应用最大的区别之一。
14|技术架构
项目目前主要采用:
前端
React 18 + TypeScript + Vite 5 + Tailwind CSS
知识可视化
D3.js
AI 与知识检索
GraphRAG + 大模型 API + 多模态视觉模型
文档解析
PDF.js + Mammoth + OCR
云端架构
Vercel Serverless Functions + Vercel Blob
产品形态
Web + PWA
整体数据链路可以概括为:
古籍 / 名医著作 / 医案 / 图片 / 用户问题
                    ↓
             信息解析与结构化
                    ↓
              AI 知识蒸馏
                    ↓
        结构化知识库 + 知识图谱
                    ↓
                 GraphRAG
          ↙          ↓          ↘
       古籍        名医经验      关系节点
          ↘          ↓          ↙
               AI 上下文
                    ↓
         可解释、带来源的回答
我尽量把不同模块之间的边界保持清晰。
AI 不是整个系统唯一的“大脑”。
数据结构、知识关系、检索、来源和模型生成共同组成最终结果。
15|一个让我反复踩坑的功能:跨设备知识同步
名医资料蒸馏出来以后,最初只存在当前浏览器。
如果换一台电脑,知识就看不到了。
我尝试过使用 Serverless 内存存储,但上线以后发现多个 Serverless 实例之间并不共享数据。
随后改成云端持久化。
之后又遇到了更隐蔽的问题:
即使已经更新数据,CDN 和对象元数据缓存仍然可能返回旧文件。
最终采用:
不可变版本文件
doctor-sync/global-时间戳.json
每次同步生成一个新版本。
客户端再通过版本列表找到最新文件。
同时解决多个客户端同时修改数据时的合并策略。
这个问题连续经历了多轮排查。
但也正是在这些问题中,我越来越感受到 TRAE 对我的意义:
它不是替我按一次按钮生成整个项目,而是在一个真实的软件不断出问题、不断修改、不断上线的过程中,持续陪我解决问题。
16|产品演示视频
演示视频:
【这里插入 1–5 分钟公开视频链接】
https://www.douyin.com/video/7671919030952856878
https://www.bilibili.com/video/BV1Fbu16WEVe/?vd_source=7234c5511fc6e7e4a93c6899b05347b7
我建议评审按照以下路径理解医道图:
第一步:知识检索
从一个药材或症状开始,查看古籍和关联知识。
↓
第二步:知识图谱
进入关系网络,沿“药材—方剂—症状—古籍”继续探索。
↓
第三步:GraphRAG 问答
提出一个自然语言问题,观察 AI 如何调用古籍知识并显示来源。
↓
第四步:名医知识蒸馏
上传一份资料,展示 AI 如何提取医案、用药规律和学术思想。
↓
第五步:知识再次被 AI 使用
用一个与刚才资料有关的问题再次询问 AI,展示 GraphRAG 对新知识的召回。
↓
第六步:多模态能力
展示拍照识药或舌象知识分析。
如果只能用一句话概括这段演示:
上传一本书,医道图不仅能“读”它,还能让书里的知识成为知识网络的一部分。
17|从 6 月 19 日到今天:我的产品创作历程
这个项目并不是一次 Prompt 生成出来的。
从 6 月 19 日开始,它经历了多个阶段。
第一阶段:先把想法做出来
我向 TRAE 描述:
“我要一个知识图谱页面,能拖拽、能筛选、能点击高亮。”
于是开始建立数据模型和 D3.js 知识图谱。
第二阶段:让关系真正建立起来
开发中发现一个很典型的问题:
方剂组成数据保存的是药材 ID,而图谱索引却按照药材名称匹配。
结果就是:
明明有方剂和药材,图谱关系却是 0。
最后通过 TRAE 一步步排查,把问题定位到数据层与索引层约定不一致,并重新按 ID 建边。
第三阶段:从图谱走向 GraphRAG
我开始尝试:
文本检索 + 图遍历 + 大模型。
第一次看到 AI 回答以后还能指出《本草纲目》《伤寒论》等知识来源时,我第一次真正感受到:
这张图不只是为了“好看”。
它可以成为 AI 理解知识关系的一部分。
第四阶段:从 Demo 上线真实网站
随后继续解决:
路由拆包、性能、API 安全、PWA、Vercel 部署、DNS、SSL 和线上 Bug。
初赛时,产品已经可以真实访问和体验。
第五阶段:复赛重新思考“知识从哪里来”
如果知识图谱必须全部靠人工维护,就很难真正成长。
于是开始开发:
名医知识蒸馏。
这成为复赛版本最重要的产品方向。
第六阶段:真正处理大文件
之后很长一段时间都在与:
PDF、Serverless、Blob、Token、缓存、批处理和模型上下文打交道。
一遍遍失败,再一遍遍修。
最终让“大文件分批知识蒸馏”真正跑通。
第七阶段:让知识进入 GraphRAG
最后把蒸馏出的:
医案、用药规律、学术思想
接回问答、辨证学习和舌象分析。
系统第一次形成完整闭环:
AI 不只是消费知识,也开始帮助生产知识。
18|TRAE 是怎么参与这个项目的?
整个医道图项目持续使用 TRAE IDE / TRAE Work 开发。
它参与的不只是代码生成,而包括:
需求拆解
技术选型
数据建模
React 页面开发
D3.js 知识图谱
GraphRAG 架构
Bug 定位
AI API 调试
大文件上传与解析
Serverless 排错
云端同步
性能优化
部署上线
我印象很深的并不是 TRAE 第一次生成页面。
反而是项目越来越复杂以后,它依然能够跟着已有代码继续分析问题。
例如:
“为什么图谱关系是 0?”
“为什么第二批蒸馏以后文件 404?”
“为什么服务器明明写入了新数据,另一个浏览器还是看到旧数据?”
这些才是一个产品真正开发过程中每天会遇到的问题。
而 TRAE 帮我把很多原本不知道如何下手的问题,逐渐拆成:
现象 → 日志 → 假设 → 源码定位 → 修改 → 测试 → 部署验证
19|TRAE 关键开发过程与 Session ID
以下是初赛阶段已经公开并保留的部分关键开发会话。
Session 1|项目初始化、知识模型与整体架构
458914675570304:2dca4e2f1f939296c7be4f532724ad70_6a3565e53c29474d40ecd604.6a36a9ec21d1d71a0ff8cd36.6a36a9ec21d1d71a0ff8cd34:TRAE Work CN.0.1.39.no_sid.no_ppe.T(2026/6/20 07:55:40)
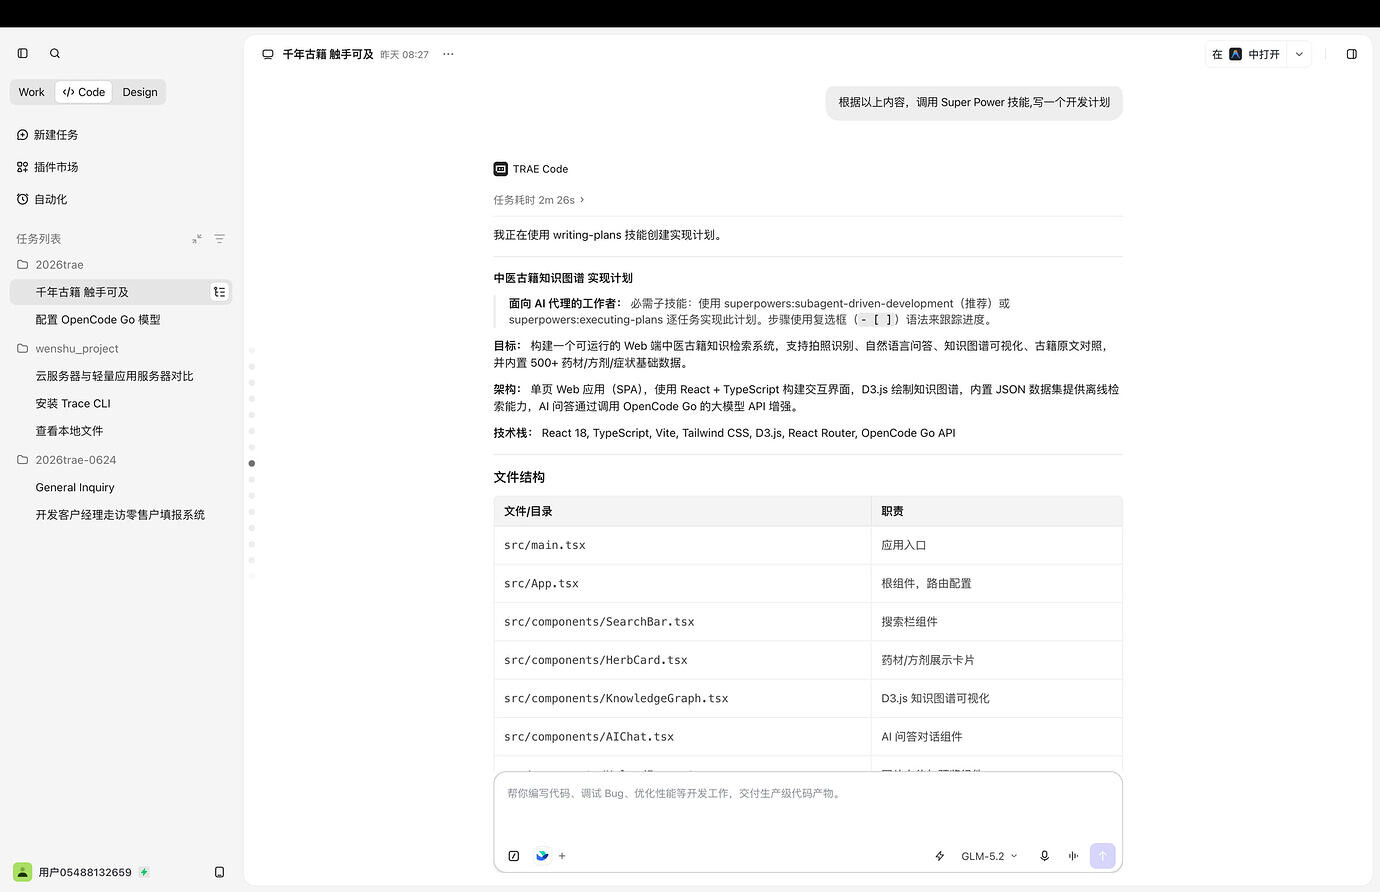
【TRAE 截图 A:项目初始化 / 数据模型设计】
Session 2|知识图谱与 GraphRAG 调试
458914675570304:c371aa89f534462aa8deba3b2aa9eb5d_6a3565e53c29474d40ecd604.6a3966c721d1d71a0ff94cf1.6a3966c721d1d71a0ff94cef:TRAE Work CN.0.1.39.no_sid.no_ppe.T(2026/6/22 09:45:59)
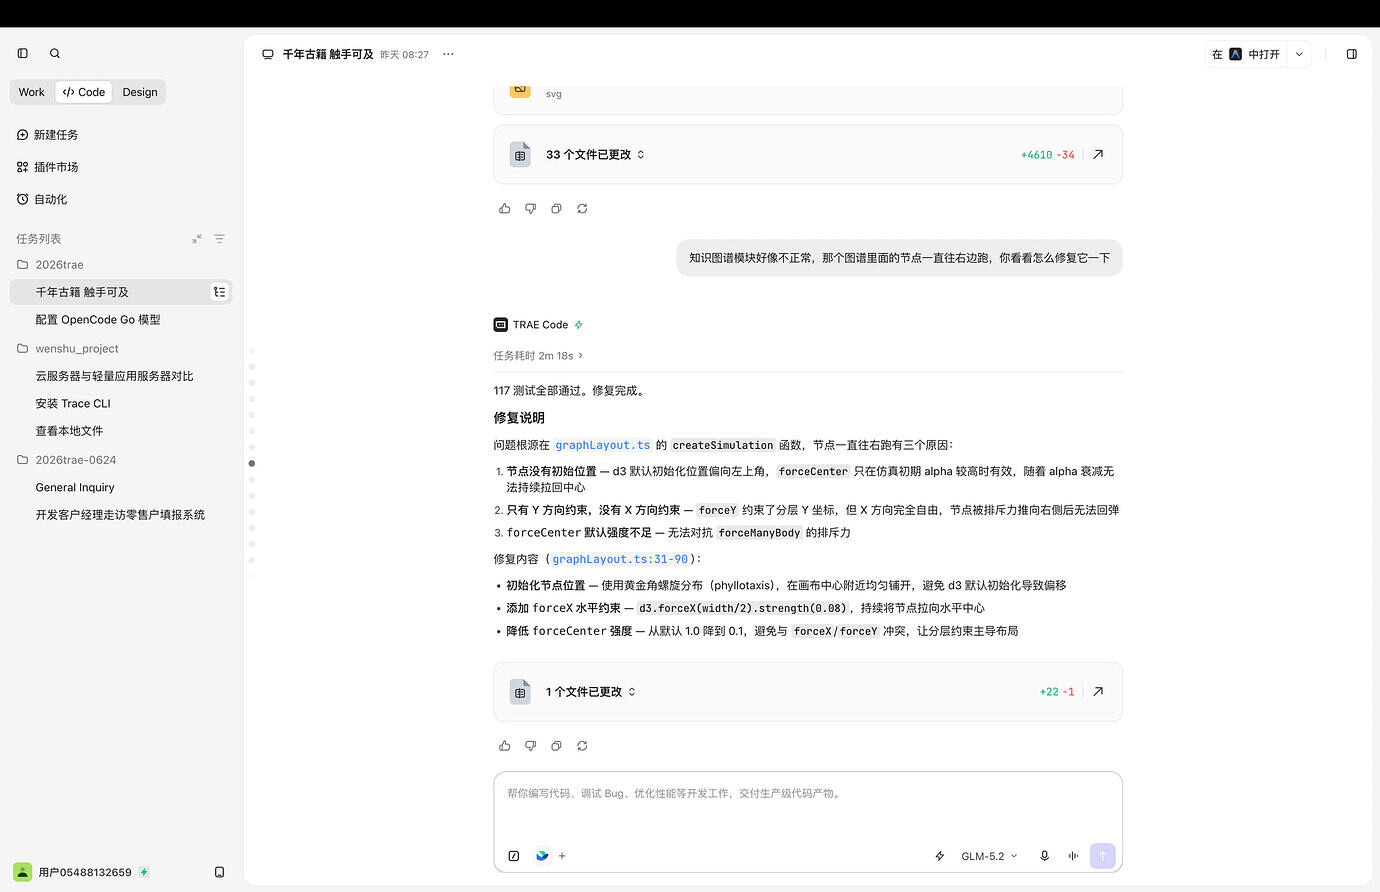
【TRAE 截图 B:D3.js 图谱 / GraphRAG 建边问题排查】
Session 3|模型配置与四诊功能
458914675570304:dcd75716bc38c59b9120a96578cb1227_6a3565e53c29474d40ecd604.6a3a88e621d1d71a0ff94d67.6a3a88e621d1d71a0ff94d65:TRAE Work CN.0.1.39.no_sid.no_ppe.T(2026/6/23 06:23:50)
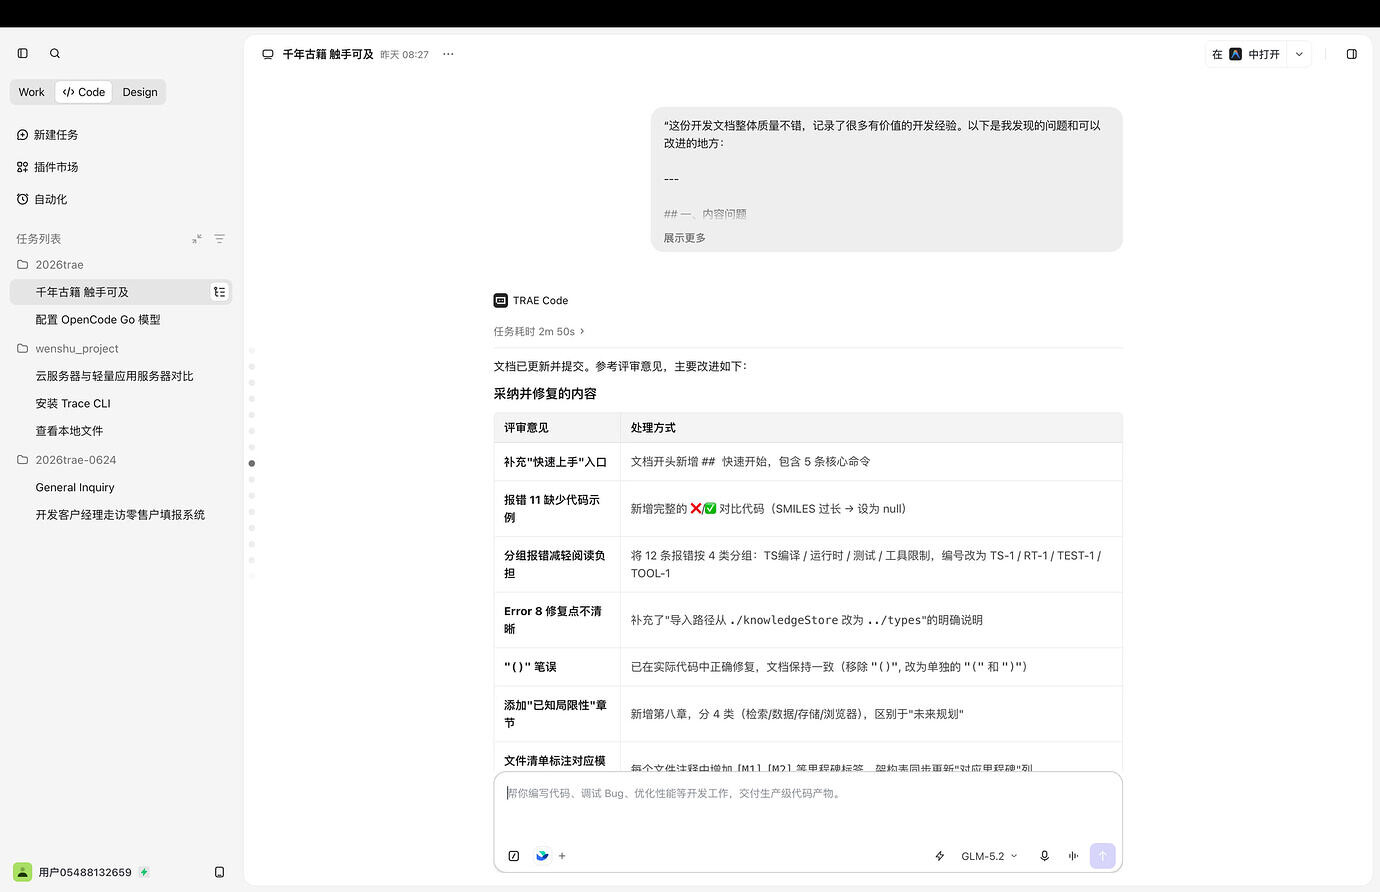
【TRAE 截图 C:四诊模块开发】
Session 4|Vercel 部署与线上环境
458914675570304:571ec4096a7419cb40d2cfa0727df5e4_6a3565e53c29474d40ecd604.6a519161d561daa6de13976a.6a519161d561daa6de139768:TRAE Work CN.0.1.39.no_sid.no_ppe.T(2026/7/10 17:42:09)

【TRAE 截图 D:Vercel 部署及问题排查】
复赛阶段建议补充的关键 Session
为了更完整体现从初赛到复赛的开发过程,正式提交前将在这里继续补充复赛阶段 TRAE Session:
Session 5|名医知识蒸馏与大文件处理
458914675570304:8a7beb0f6408ce5fea4c8cf0fe96a986_6a3565e53c29474d40ecd604.6a71c7a997bb6b8fdd2851f8.6a71c7a997bb6b8fdd2851f6:TraeWork CN.0.1.45.no_sid.no_ppe.T(2026/8/4 04:06:17)
【填写对应 TRAE Session ID】
【TRAE 截图 E】
Session 6|名医数据跨设备同步 / Blob 缓存问题排查
458914675570304:561e4fb9b1c35bec6b09724051d429df_6a3565e53c29474d40ecd604.6a72fbe997bb6b8fdd28570d.6a72fbe997bb6b8fdd28570b:TraeWork CN.0.1.45.no_sid.no_ppe.T(2026/8/5 02:01:29)
【填写对应 TRAE Session ID】
【TRAE 截图 F】
Session 7|名医知识接入 GraphRAG、AI 问答与舌象分析
458914675570304:559d68d39f39eba41a3be6af1ef6fa7a_6a3565e53c29474d40ecd604.6a74748697bb6b8fdd285f98.6a74748697bb6b8fdd285f96:TraeWork CN.0.1.45.no_sid.no_ppe.T(2026/8/6 04:48:22)
【填写对应 TRAE Session ID】
【TRAE 截图 G】
20|我认为医道图最大的创新,不是“用了 AI”
现在 AI 应用很多。
如果只是把大模型接到一个聊天窗口,我认为还不足以体现传统文化数字化的价值。
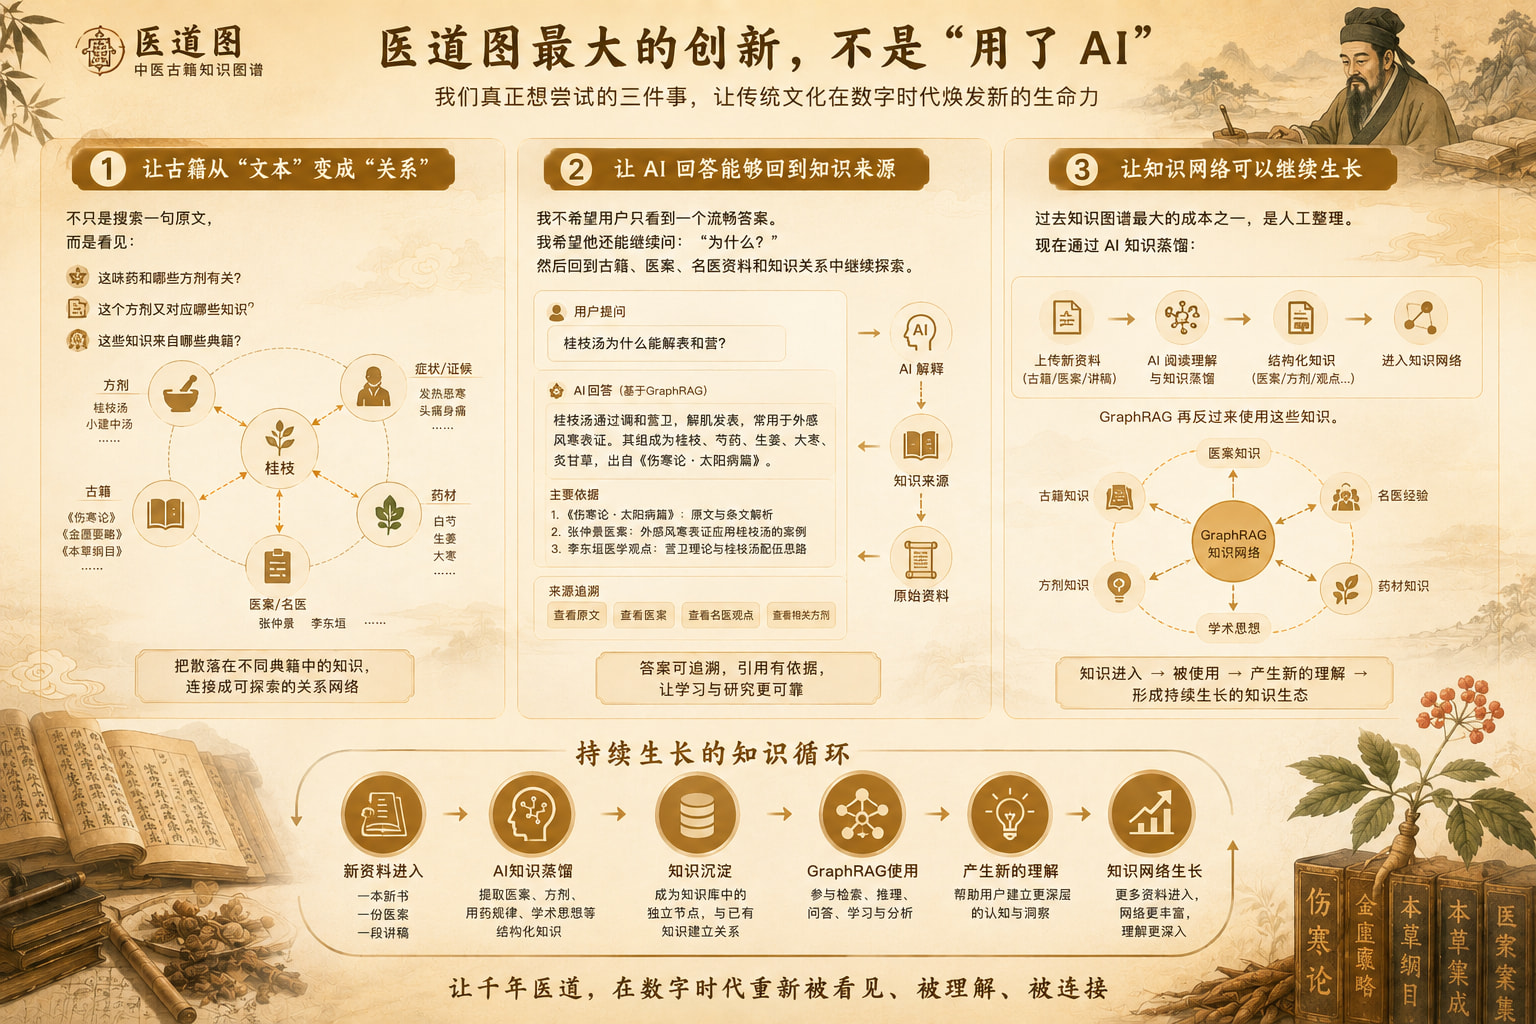
医道图真正想尝试的是三件事。
第一,让古籍从“文本”变成“关系”
不只是搜索一句原文。
而是看见:
这味药和哪些方剂有关?
这个方剂又对应哪些知识?
这些知识来自哪些典籍?
第二,让 AI 回答能够回到知识来源
我不希望用户只看到一个流畅答案。
我希望他还能继续问:
“为什么?”
然后回到古籍、医案、名医资料和知识关系中继续探索。
第三,让知识网络可以继续生长
过去知识图谱最大的成本之一,是人工整理。
现在通过 AI 知识蒸馏:
一本新资料进入系统以后,可以逐渐成为新的结构化知识。
GraphRAG 再反过来使用这些知识。
于是形成一个持续生长的循环。
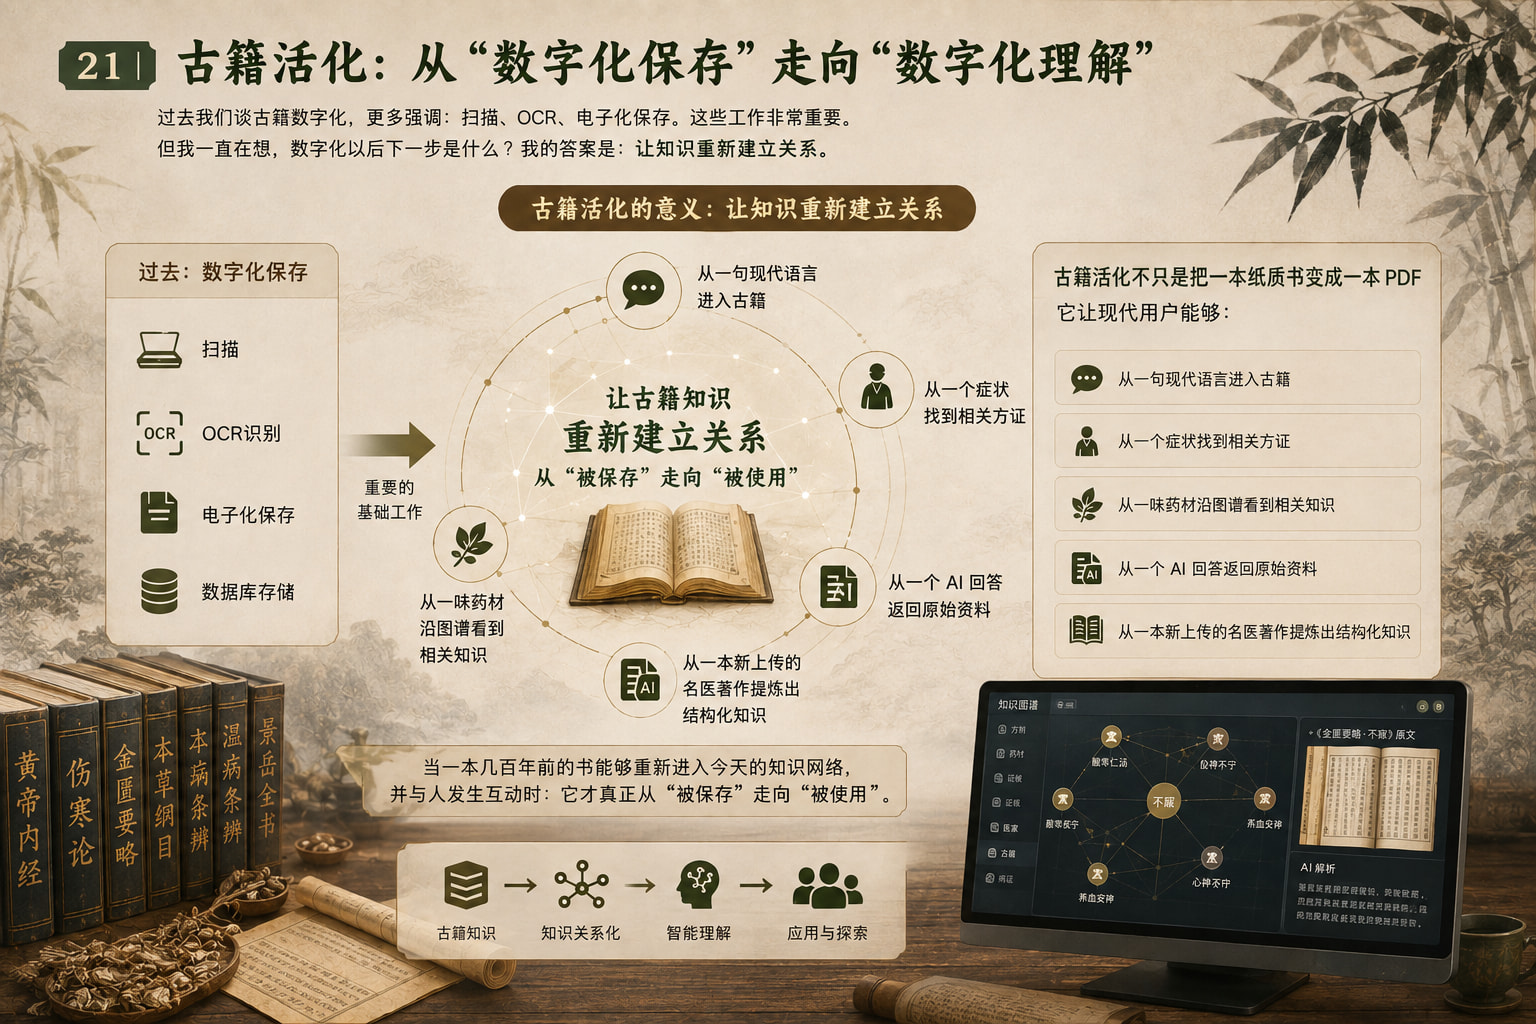
21|古籍活化:从“数字化保存”走向“数字化理解”
过去我们谈古籍数字化,更多强调:
扫描、OCR、电子化保存。
这些工作非常重要。
但我一直在想,数字化以后下一步是什么?
我的答案是:
让知识重新建立关系。
古籍活化不应该只是把一本纸质书变成一本 PDF。
它还可以让现代用户:
从一句现代语言进入古籍;
从一个症状找到相关方证;
从一味药材沿图谱看到相关知识;
从一个 AI 回答返回原始资料;
从一本新上传的名医著作提炼出结构化知识。
当一本几百年前的书能够重新进入今天的知识网络,并与人发生互动时:
它才真正从“被保存”走向“被使用”。
22|社会与文化价值
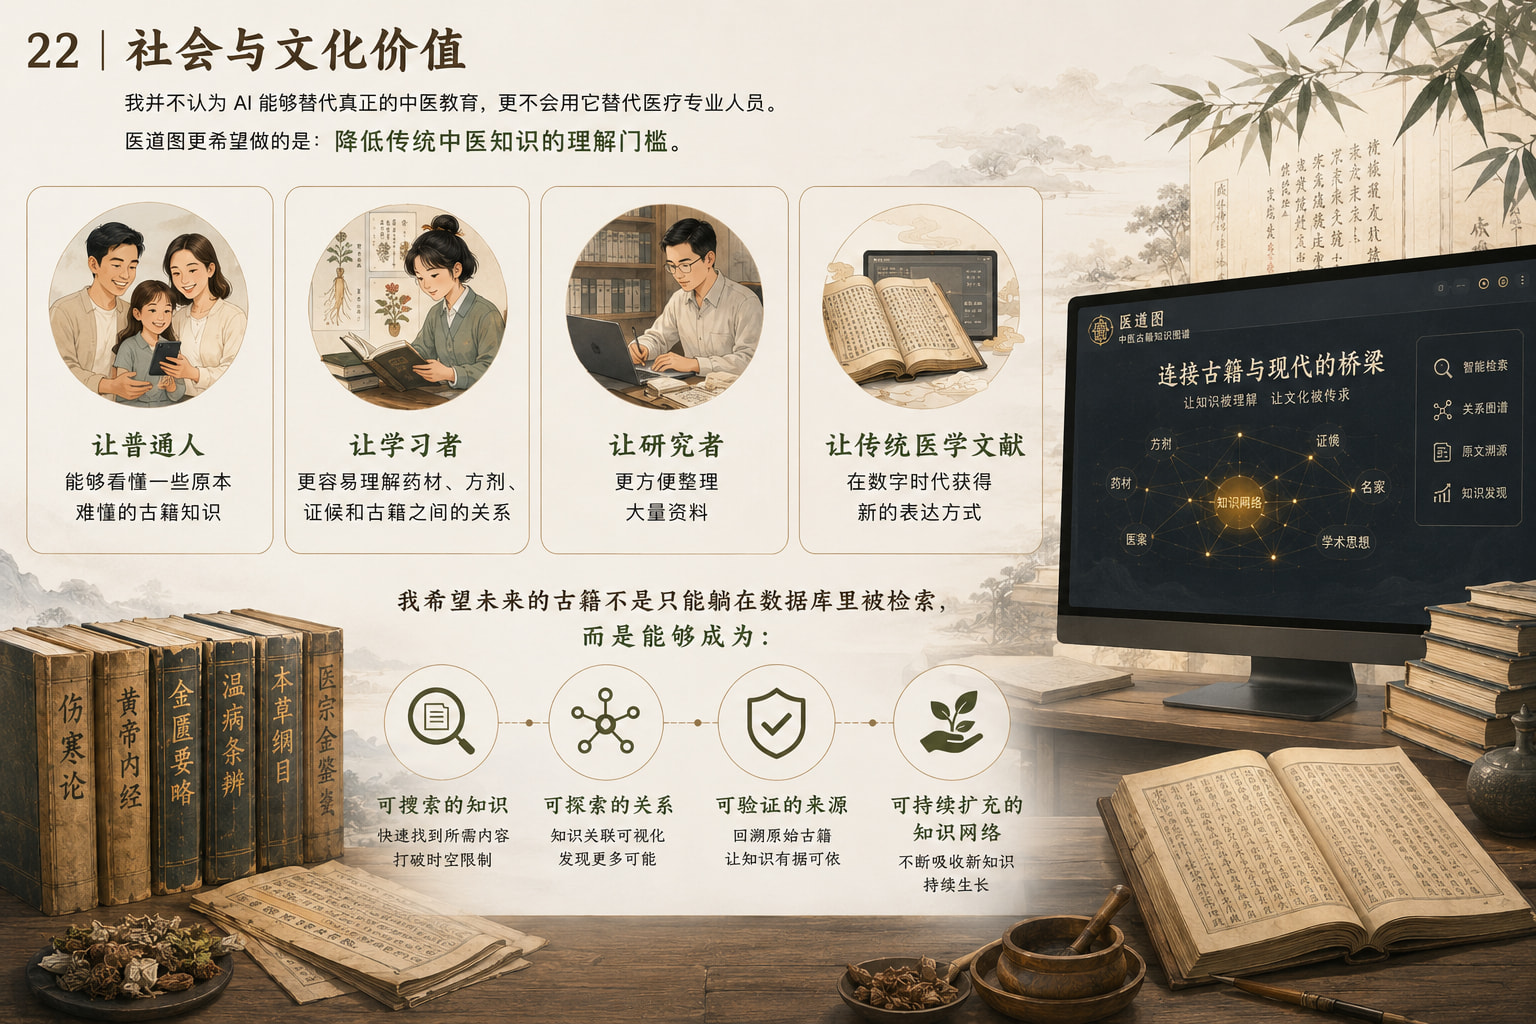
我并不认为 AI 能够替代真正的中医教育,更不会用它替代医疗专业人员。
医道图更希望做的是:
降低传统中医知识的理解门槛。
让普通人能够看懂一些原本难懂的古籍知识;
让学习者更容易理解药材、方剂、证候和古籍之间的关系;
让研究者更方便整理大量资料;
让传统医学文献在数字时代获得新的表达方式。
我希望未来的古籍不是只能躺在数据库里被检索。
而是能够成为:
可搜索的知识
可探索的关系
可验证的来源
可持续扩充的知识网络
23|下一步
医道图目前还远远没有完成。
未来希望继续完善:
古籍全文级知识抽取;
更多古籍和名医资料;
知识冲突与版本管理;
更精细的知识来源追踪;
跨古籍观点比较;
时间、流派、人物关系网络;
更完善的 GraphRAG 检索质量评估;
知识蒸馏人工审核机制;
以及更适合中医学习场景的个人知识空间。
我希望有一天:
一个用户提出问题以后,AI 不只是给他一句答案。
而是可以带着他穿过一张知识网络:
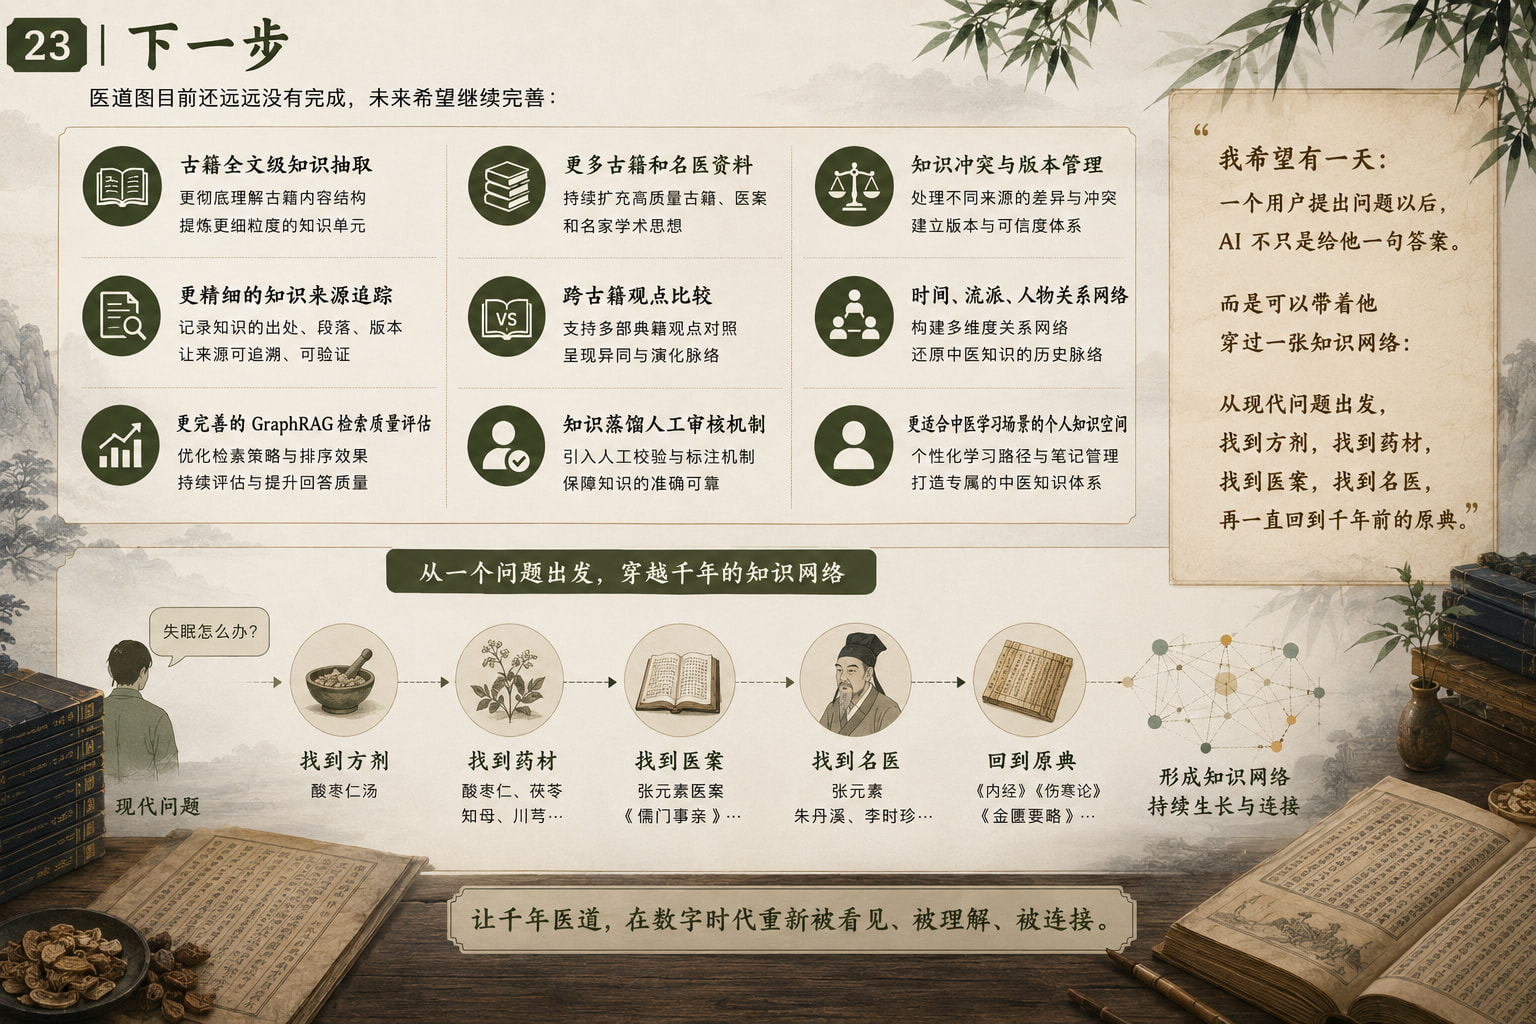
从现代问题出发,找到方剂,找到药材,找到医案,找到名医,再一直回到千年前的原典。
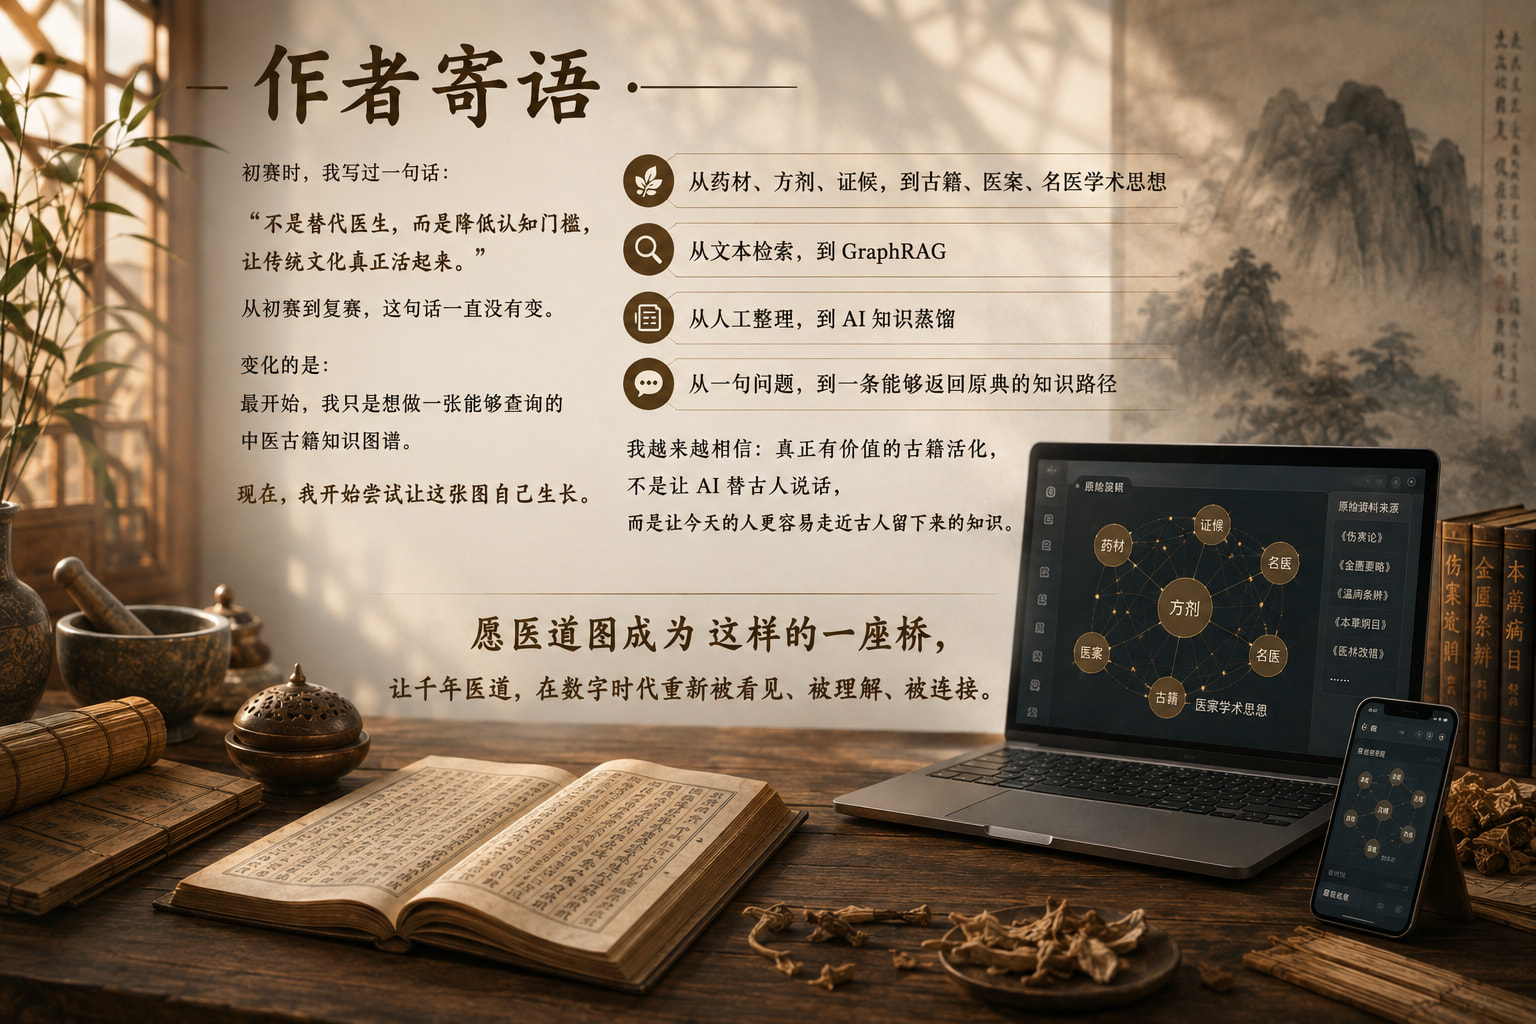
24|作者寄语
初赛时,我写过一句话:
“不是替代医生,而是降低认知门槛,让传统文化真正活起来。”
从初赛到复赛,这句话一直没有变。
变化的是:
最开始,我只是想做一张能够查询的中医古籍知识图谱。
现在,我开始尝试让这张图自己生长。
从药材、方剂、证候,到古籍、医案、名医学术思想;
从文本检索,到 GraphRAG;
从人工整理,到 AI 知识蒸馏;
从一句问题,到一条能够返回原典的知识路径。
我越来越相信:
真正有价值的古籍活化,不是让 AI 替古人说话,而是让今天的人更容易走近古人留下来的知识。
愿医道图成为这样的一座桥。
让千年医道,在数字时代重新被看见、被理解、被连接。